
Synchronized关键字底层理论以及内部锁升级
JAVA中JUC多线程并发编程
第三章 Synchronized关键字底层理论以及内部锁升级
一、JMM模型
synchronized 是 Java 语言提供的同步工具,而 JMM(Java 内存模型)是为 synchronized 这类工具提供语义保证和规范的理论基石。
具体来说,synchronized 通过遵守 JMM 定义的规则,来解决并发编程中的三大核心问题:原子性、可见性和有序性。
计算机存储结构:从本地磁盘到主存到CPU缓存,也就是从硬盘到内存,到CPU。
一般对应的程序的操作就是从数据库查数据到内存然后到CPU进行计算
JMM(Java内存模型Java Memory Model,简称JMM)本身是一种抽象的概念并不真实存在它仅仅描述的是一组约定或规范,通过这组规范定义了程序中(尤其是多线程)各个变量的读写访问方式并决定一个线程对共享变量的写入何时以及如何变成对另一个线程可见,关键技术点都是围绕多线程的原子性、可见性和有序性展开的。
能干嘛?
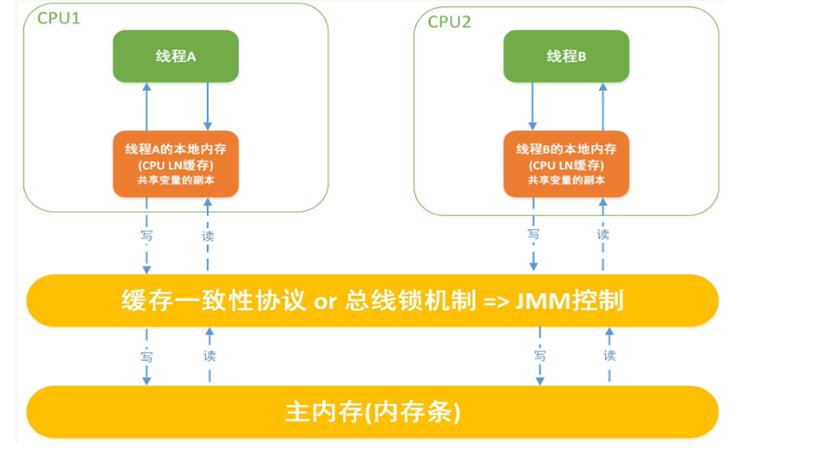
1 通过JMM来实现线程和主内存之间的抽象关系。
1)线程之间的共享变量存储在主内存中(从硬件角度来说就是内存条)
2) 每个线程都有一个私有的本地工作内存,本地工作内存中存储了该线程用来读/写共享变量的副本(从硬件角度来说就是CPU的缓存,比如寄存器、L1、L2、L3缓存等)
)
2 屏蔽各个硬件平台和操作系统的内存访问差异以实现让Java程序在各种平台下都能达到一致的内存访问效果。
JMM规范下,三大特性
- 可见性:是指当一个线程修改了某一个共享变量的值,其他线程是否能够立即知道该变更 ,JMM规定了所有的变量都存储在主内存中。
Java中普通的共享变量不保证可见性,因为数据修改被写入内存的时机是不确定的,多线程并发下很可能出现"脏读",所以每个线程都有自己的工作内存,线程自己的工作内存中保存了该线程使用到的变量的主内存副本拷贝,线程对变量的所有操作(读取,赋值等 )都必需在线程自己的工作内存中进行,而不能够直接读写主内存中的变量。不同线程之间也无法直接访问对方工作内存中的变量,线程间变量值的传递均需要通过主内存来完成 - 原子性:指一个操作是不可中断的,即多线程环境下,操作不能被其他线程干扰
- 有序性:对于一个线程的执行代码而言,我们总是习惯性认为代码的执行总是从上到下,有序执行。
但为了提供性能,编译器和处理器通常会对指令序列进行重新排序。
指令重排可以保证串行语义一致,但没有义务保证多线程间的语义也一致,即可能产生"脏读",简单说,两行以上不相干的代码在执行的时候有可能先执行的不是第一条,不见得是从上到下顺序执行,执行顺序会被优化。
JMM规范下,多线程对变量的读写过程
由于JVM运行程序的实体是线程,而每个线程创建时JVM都会为其创建一个工作内存(有些地方称为栈空间),工作内存是每个线程的私有数据区域,而Java内存模型中规定所有变量都存储在主内存,主内存是共享内存区域,所有线程都可以访问,但线程对变量的操作(读取赋值等)必须在工作内存中进行,首先要将变量从主内存拷贝到的线程自己的工作内存空间,然后对变量进行操作,操作完成后再将变量写回主内存,不能直接操作主内存中的变量,各个线程中的工作内存中存储着主内存中的变量副本拷贝,因此不同的线程间无法访问对方的工作内存,线程间的通信(传值)必须通过主内存来完成,其简要访问过程如下图:
JMM规范下,多线程先行发生原则之happens-before
这个原则非常重要:
它是判断数据是否存在竞争,线程是否安全的非常有用的手段。依赖这个原则,我们可以通过几条简单规则一揽子解决并发环境下两个操作之间是否可能存在冲突的所有问题,而不需要陷入Java内存模型苦涩难懂的底层编译原理之中。
happens-before总原则:
如果一个操作happens-before另一个操作,那么第一个操作的执行结果将对第二个操作可见,
而且第一个操作的执行顺序排在第二个操作之前。
两个操作之间存在happens-before关系,并不意味着一定要按照happens-before原则制定的顺序来执行。如果重排序之后的执行结果与按照happens-before关系来执行的结果一致,那么这种重排序并不非法。
在java中happens-before之8条
- 次序规则:一个线程内,按照代码顺序,写在前面的操作先行发生于写在后面的操作;讲白点就是前面一个操作把变量X赋值为1,那后面一个操作肯定能知道X已经变成了1。
- 锁定规则:一个unLock操作先行发生于后面((这里的“后面”是指时间上的先后))对同一个锁的lock操作;
- volatile变量规则:对一个volatile变量的写操作先行发生于后面对这个变量的读操作,
前面的写对后面的读是可见的,这里的“后面”同样是指时间上的先后。 - 传递规则: 如果操作A先行发生于操作B,而操作B又先行发生于操作C,则可以得出操作A先行发生于操作C;
- 线程启动规则:Thread对象的start()方法先行发生于此线程的每一个动作
- 线程中断规则:对线程interrupt()方法的调用先行发生于被中断线程的代码检测到中断事件的发生;
- 对象终结规则:一个对象的初始化完成(构造函数执行结束)先行发生于它的finalize()方法的开始
private int value;
pubilc void setValue (int value){this.value = value};
public int getValue(){
return value;
}

假设存在线程A和B,线程A先(时间上的先后)调用了setValue(1),然后线程B调用了同一个对象的getValue(),那么线程B收到的返回值
是什么?
我们就这段简单的代码一次分析happens-before的规则(规则5、6、7、8 可以忽略,因为他们和这段代码毫无关系):
1 由于两个方法是由不同的线程调用,不在同一个线程中,所以肯定不满足程序次序规则;
2 两个方法都没有使用锁,所以不满足锁定规则;
3 变量不是用volatile修饰的,所以volatile变量规则不满足;
4 传递规则肯定不满足;
所以我们无法通过happens-before原则推导出线程A happens-before线程B,虽然可以确认在时间上线程A优先于线程B指定,
但就是无法确认线程B获得的结果是什么,所以这段代码不是线程安全的。那么怎么修复这段代码呢?

private volatile int value;
pubilc synchronized  void setValue (int value){this.value = value};
public  synchronized  int  getValue(){
return value;
}
二、Java对象内存布局和对象头
为什么每一个对象都可以成为一个锁????
这个跟第一章提到的Monitor息息相关,Java对象是天生的Monitor,每一个Java对象都有成为Monitor的潜质,因为在Java的设计中 ,每一个Java对象自打娘胎里出来就带了一把看不见的锁,它叫做内部锁或者Monitor锁。Monitor的本质是依赖于底层操作系统的Mutex Lock实现,操作系统实现线程之间的切换需要从用户态到内核态的转换,成本非常高。
Synchronized锁又是如何跟对象相关的呢?
首先需要了解Object object = new Object()谈谈你对这句话的理解?
一般而言JDK8按照默认情况下,new一个对象占多少内存空间
对于HotSpot虚拟机来说,位置所在JVM里堆→新生区→伊甸园区
对象在堆内存中的存储布局
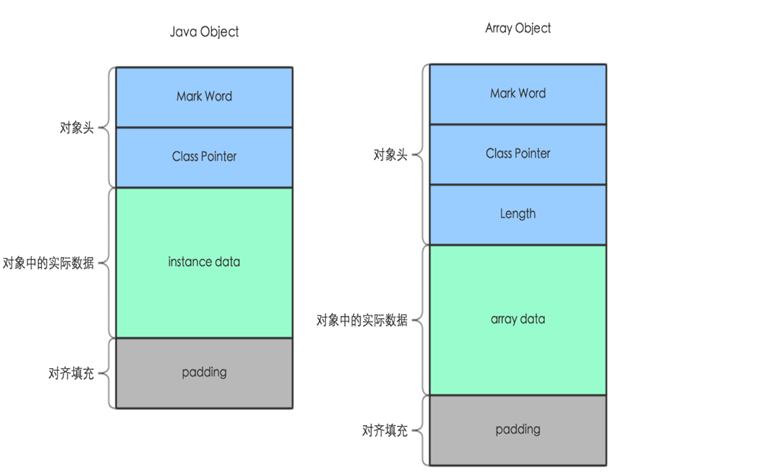
对象内部结构分为:对象头、实例数据、对齐填充(保证8个字节的倍数)。对象头分为对象标记(markOop)和类元信息(klassOop),类元信息存储的是指向该对象类元数据(klass)的首地址。其中对象头中存在跟锁相关的信息
对象头:对象头分为对象标记(markOop)和类型指针 (klassOop),在64位系统中,Mark Word占了8个字节(64位),类型指针占了8个字节,一共是16个字节。(64位 HotSpot 虚拟机在未开启指针压缩,开启了压缩对象指针类型指针 (4字节) )。其中对象标记MarkWord默认存储对象的HashCode、分代年龄和锁标志位等信息。这些信息都是与对象自身定义无关的数据,所以MarkWord被设计成一个非固定的数据结构以便在极小的空间内存存储尽量多的数据。
它会根据对象的状态复用自己的存储空间,也就是说在运行期间MarkWord里存储的数据会随着锁标志位的变化而变化。
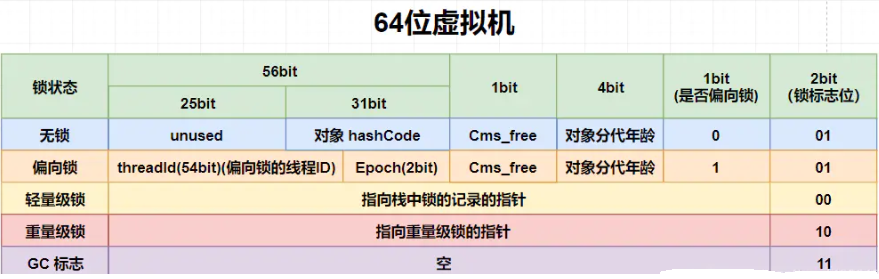
锁升级就是对象标记MarkWord里面标志位的变化
三、锁升级
Java 6之后,为了减少获得锁和释放锁所带来的性能消耗,引入了轻量级锁和偏向锁。
为啥不采用直接升级重量级锁呢?
synchronized属于重量级锁,效率低下,因为监视器锁(monitor)是依赖于底层的操作系统的Mutex Lock来实现的,挂起线程和恢复线程都需要转入内核态去完成,阻塞或唤醒一个Java线程需要操作系统切换CPU状态来完成,这种状态切换需要耗费处理器时间,如果同步代码块中内容过于简单,这种切换的时间可能比用户代码执行的时间还长”,时间成本相对较高.
为啥引入轻量级锁和偏向锁这两种?
多线程访问情况,3种
- 只有一个线程来访问,有且唯一Only One
- 有2个线程A、B来交替访问
- 竞争激烈,多个线程来访问
锁升级功能主要依赖MarkWord中锁标志位和释放偏向锁标志位
偏向锁
偏向锁:当一段同步代码一直被同一个线程多次访问,由于只有一个线程那么该线程在后续访问时便会自动获得锁,它的出现是为了解决只有在一个线程执行同步时提高性能。后续这个线程进入和退出这段加了同步锁的代码块时,不需要再次加锁和释放锁。而是直接比较对象头里面是否存储了指向当前线程的偏向锁?
如果相等表示偏向锁是偏向于当前线程的,就不需要再尝试获得锁了,直到竞争发生才释放锁。以后每次同步,检查锁的偏向线程ID与当前线程ID是否一致,如果一致直接进入同步。无需每次加锁解锁都去CAS更新对象头。如果自始至终使用锁的线程只有一个,很明显偏向锁几乎没有额外开销,性能极高。
假如不一致意味着发生了竞争,锁已经不是总是偏向于同一个线程了,这时候可能需要升级变为轻量级锁,才能保证线程间公平竞争锁。偏向锁只有遇到其他线程尝试竞争偏向锁时,持有偏向锁的线程才会释放锁,线程是不会主动释放偏向锁的。
技术实现:
一个synchronized方法被一个线程抢到了锁时,那这个方法所在的对象就会在其所在的Mark Word中将偏向锁修改状态位,同时还
会有占用前54位来存储线程指针作为标识。若该线程再次访问同一个synchronized方法时,该线程只需去对象头的Mark Word 中去判断一下是否有偏向锁指向本身的ID,无需再进入 Monitor 去竞争对象了。
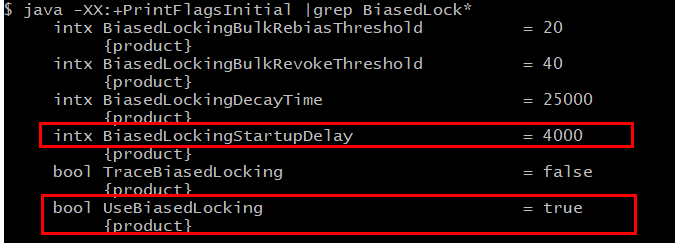
jvm参数
开启偏向锁:
-XX:+UseBiasedLocking -XX:BiasedLockingStartupDelay=0
关闭偏向锁:关闭之后程序默认会直接进入 轻量级锁状态。
- -XX:-UseBiasedLocking
现状:在 JDK 15 之前默认开启(如你的图所示),但在 JDK 15 及以后版本中已被废弃并默认禁用,因为在高并发场景下维护偏向锁的开销可能大于收益。所以在高并发场景可以关闭
竞争线程尝试CAS更新对象头失败,会等待到全局安全点(此时不会执行任何代码)撤销偏向锁。
轻量级锁
轻量级锁是为了在线程近乎交替执行同步块时提高性能。
主要目的: 在没有多线程竞争的前提下,通过CAS减少重量级锁使用操作系统互斥量产生的性能消耗,说白了先自旋再阻塞。
升级时机: 当关闭偏向锁功能或多线程竞争偏向锁会导致偏向锁升级为轻量级锁
假如线程A已经拿到锁,这时线程B又来抢该对象的锁,由于该对象的锁已经被线程A拿到,当前该锁已是偏向锁了。
而线程B在争抢时发现对象头Mark Word中的线程ID不是线程B自己的线程ID(而是线程A),那线程B就会进行CAS操作希望能获得锁。轻量级锁每次退出同步块都需要释放锁。
此时线程B操作中有两种情况:
如果锁获取成功,直接替换Mark Word中的线程ID为B自己的ID(A → B),重新偏向于其他线程(即将偏向锁交给其他线程,相当于当前线程"被"释放了锁),该锁会保持偏向锁状态,A线程Over,B线程上位;
如果锁获取失败,则偏向锁升级为轻量级锁,此时轻量级锁由原持有偏向锁的线程持有,继续执行其同步代码,而正在竞争的线程B会进入自旋等待获得该轻量级锁。
自旋到底达到什么样次数和程度才会升级呢?
java6之前默认启用,默认情况下自旋的次数是 10 次
Java6之后:同一个锁上一次自旋的时间。自旋的次数不再是固定的,而是由 JVM 根据前一次在同一个锁上的自旋时间和成功/失败历史来动态调整。如果自旋经常成功,JVM 就会允许更长的自旋;反之,则会减少甚至跳过自旋。无论是固定次数还是自适应自旋,一旦 JVM 判定自旋的代价已经超过了线程阻塞和唤醒的开销(例如,自旋了足够多的次数仍未成功),它就会触发锁膨胀。
重量级锁
有大量的线程参与锁的竞争,冲突性很高
锁升级流程图
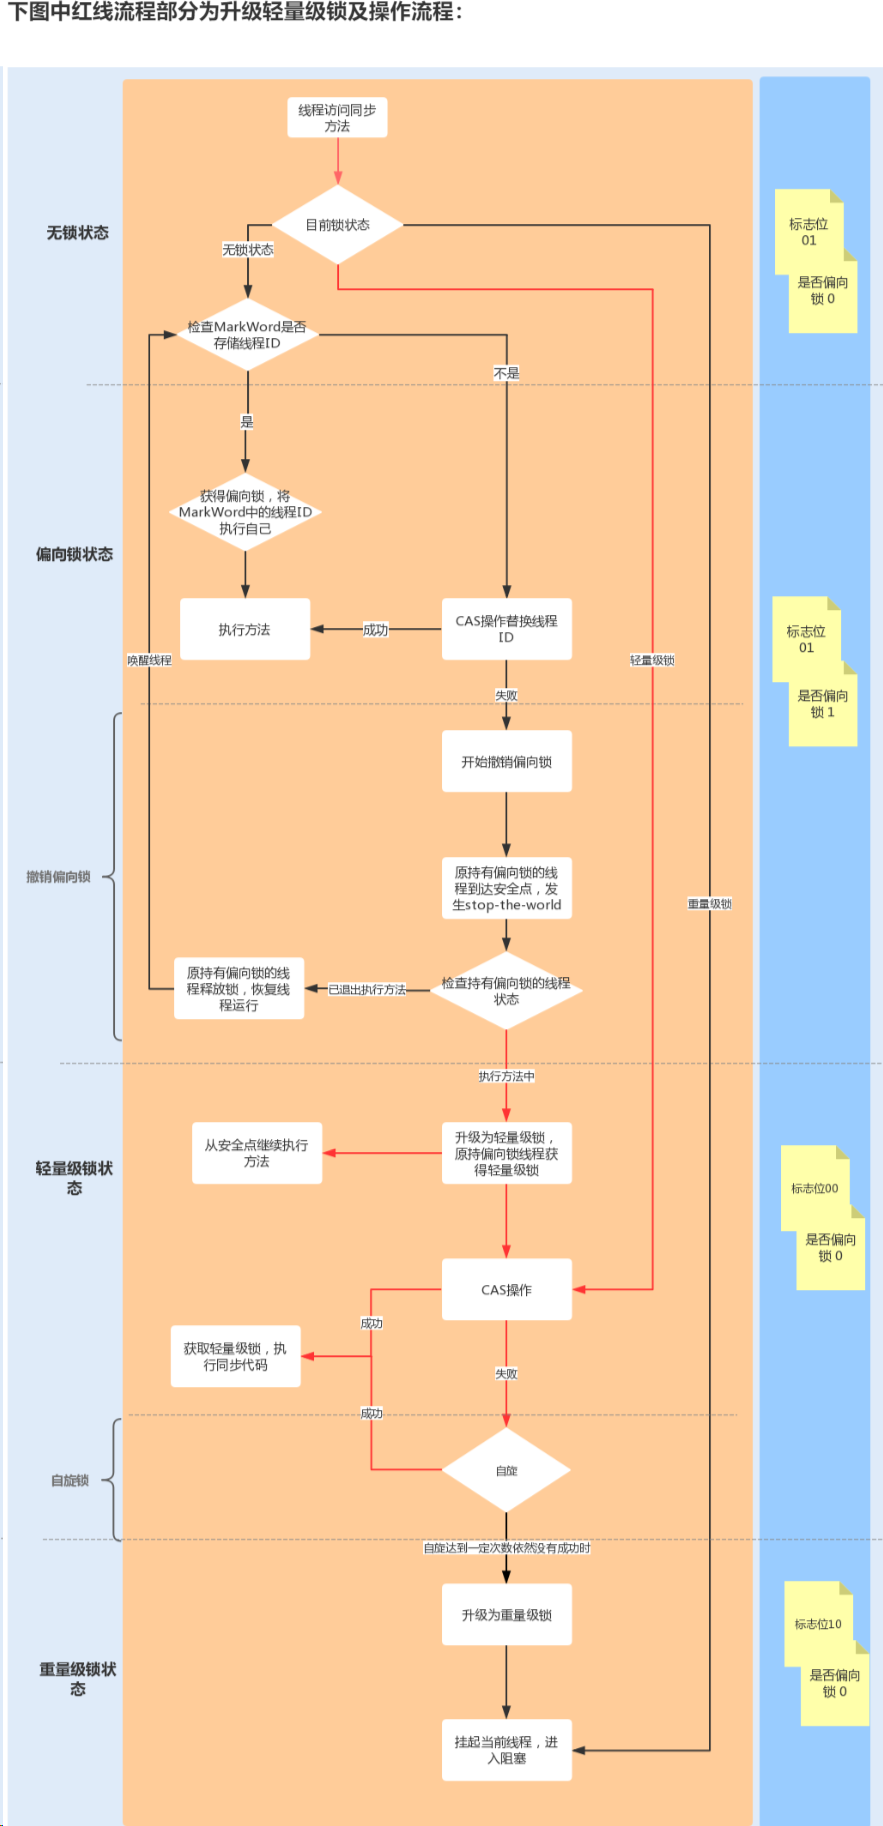
偏向锁:适用于单线程适用的情况,在不存在锁竞争的时候进入同步方法/代码块则使用偏向锁。
轻量级锁:适用于竞争较不激烈的情况(这和乐观锁的使用范围类似), 存在竞争时升级为轻量级锁,轻量级锁采用的是自旋锁,如果同步方法/代码块执行时间很短的话,采用轻量级锁虽然会占用cpu资源但是相对比使用重量级锁还是更高效。
重量级锁:适用于竞争激烈的情况,如果同步方法/代码块执行时间很长,那么使用轻量级锁自旋带来的性能消耗就比使用重量级锁更严重,这时候就需要升级为重量级锁。
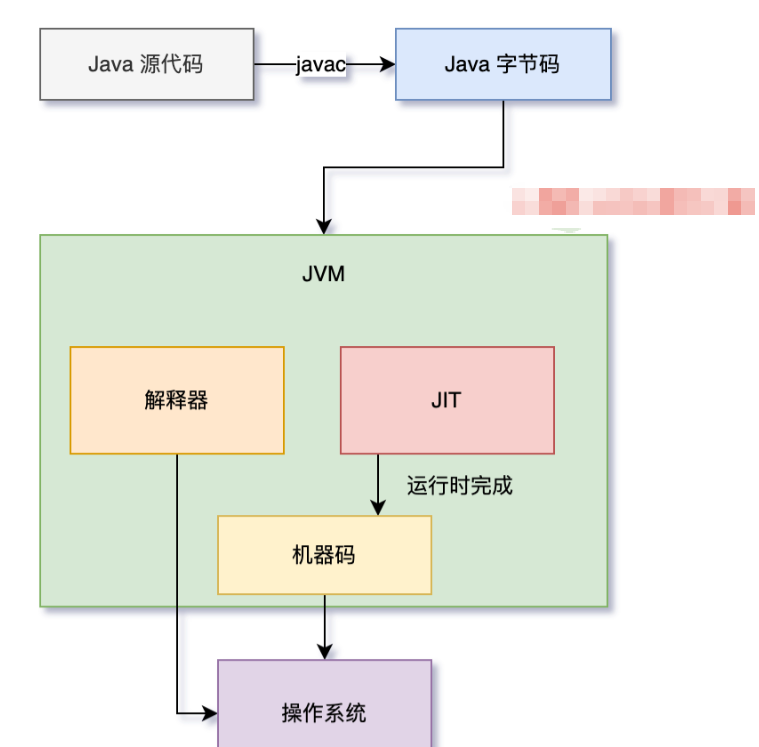
JIT编译器对锁的优化
锁消除:从JIT角度看相当于无视它,synchronized (o)不存在了,这个锁对象并没有被共用扩散到其它线程使用,极端的说就是根本没有加这个锁对象的底层机器码,消除了锁的使用
 class LockClearDemo
{
    static Object objectLock = new Object();//正常的

    public void m1()
    {
        //锁消除,JIT会无视它,synchronized(对象锁)不存在了。不正常的
        Object o = new Object();

        synchronized (o)
        {
            System.out.println("-----hello"+"\t"+o.hashCode()+"\t"+objectLock.hashCode());
        }
    }

    public static void main(String[] args)
    {
        LockClearUPDemo demo = new LockClearUPDemo();

        for (int i = 1; i <=10; i++) {
            new Thread(() -> {
                demo.m1();
            },String.valueOf(i)).start();
        }
    }
}
锁粗化
假如方法中首尾相接,前后相邻的都是同一个锁对象,那JIT编译器就会把这几个synchronized块合并成一个大块,加粗加大范围,一次申请锁使用即可,避免次次的申请和释放锁,提升了性能
 class LockBigDemo
{
    static Object objectLock = new Object();


    public static void main(String[] args)
    {
        new Thread(() -> {
        //这个就会优化成
         //synchronized (objectLock) {
          //System.out.println("11111");
          //System.out.println("22222");
           //System.out.println("33333");
         //}
            synchronized (objectLock) {
                System.out.println("11111");
            }
            synchronized (objectLock) {
                System.out.println("22222");
            }
            synchronized (objectLock) {
                System.out.println("33333");
            }
        },"a").start();

        new Thread(() -> {
            synchronized (objectLock) {
                System.out.println("44444");
            }
            synchronized (objectLock) {
                System.out.println("55555");
            }
            synchronized (objectLock) {
                System.out.println("66666");
            }
        },"b").start();

    }
}
volatile
语义:
当写一个volatile变量时,JMM会把该线程对应的本地内存中的共享变量值立即刷新回主内存中。
当读一个volatile变量时,JMM会把该线程对应的本地内存设置为无效,直接从主内存中读取共享变量
所以volatile的写内存语义是直接刷新到主内存中,读的内存语义是直接从主内存中读取。
只具备可见性,有序性,不具有原子性(volatile变量的复合操作(如i++)不具有原子性)
volatile为啥具备可见性,有序性?
内存屏障
内存屏障(也称内存栅栏,内存栅障,屏障指令等):是一类同步屏障指令,是CPU或编译器在对内存随机访问的操作中的一个同步点,使得此点之前的所有读写操作都执行后才可以开始执行此点之后的操作),避免代码重排序。内存屏障其实就是一种JVM指令,Java内存模型的重排规则会要求Java编译器在生成JVM指令时插入特定的内存屏障指令,通过这些内存屏障指令,volatile实现了Java内存模型中的可见性和有序性,
内存屏障之前的所有写操作都要回写到主内存,
内存屏障之后的所有读操作都能获得内存屏障之前的所有写操作的最新结果(实现了可见性)。
重排序时,不允许把内存屏障之后的指令重排序到内存屏障之前。
JVM中提供了四类内存屏障指令:
其实就是对JMM中的happens-before先行发生原则,类似接口规范,落地
happens-before 之 volatile 变量规则
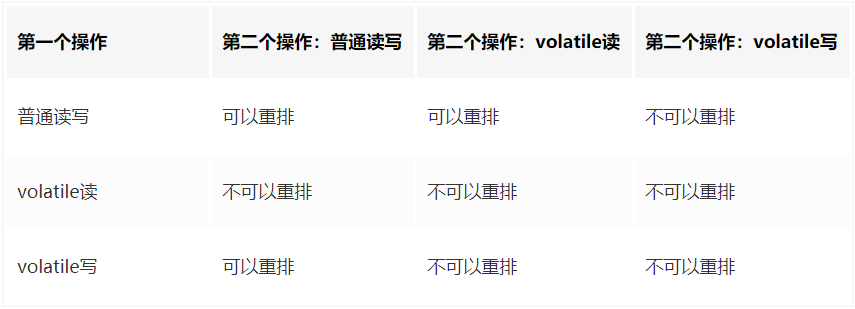
总结
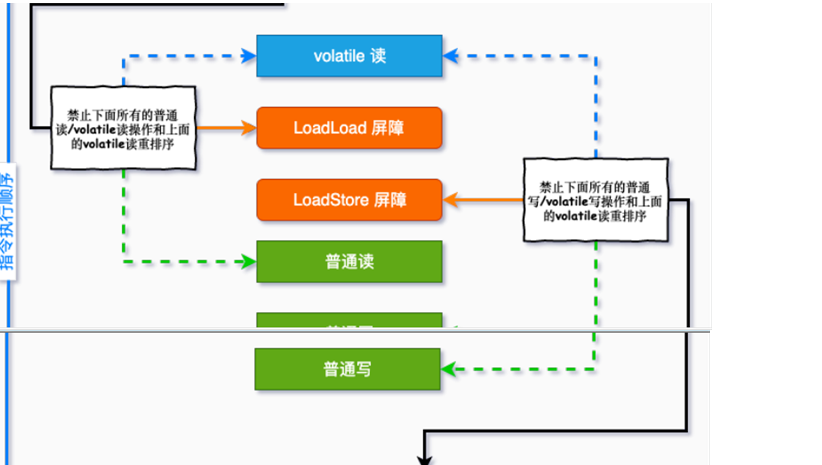
当第一个操作为volatile读时,不论第二个操作是什么,都不能重排序。这个操作保证了volatile读之后的操作不会被重排到volatile读之前。
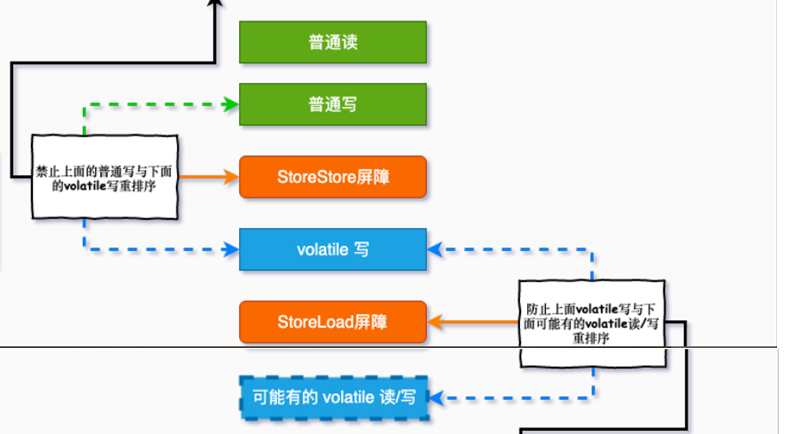
当第二个操作为volatile写时,不论第一个操作是什么,都不能重排序。这个操作保证了volatile写之前的操作不会被重排到volatile写之后。
当第一个操作为volatile写时,第二个操作为volatile读时,不能重排。
根据上面规则,其实就是在在每个 volatile 修饰变量在进行读写操作的前⾯或后面插⼊四大屏障之一
可以看Unsafe.java
四大屏障是什么
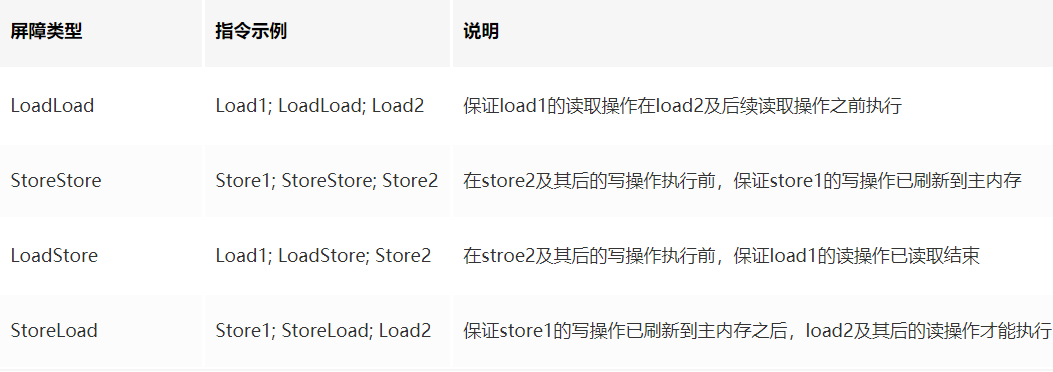
如何配合的呢?
- 在每个 volatile 写操作的前⾯插⼊⼀个 StoreStore 屏障:StoreStore屏障可以保证在volatile写之前,其前面的所有普通写操作都已经刷新到主内存中。
- 在每个 volatile 写操作的后⾯插⼊⼀个 StoreLoad 屏障:StoreLoad屏障的作用是避免volatile写与后面可能有的volatile读/写操作重排序
- 在每个 volatile 读操作的后⾯插⼊⼀个 LoadLoad 屏障:LoadLoad屏障用来禁止处理器把上面的volatile读与下面的普通读重排序。
- 在每个 volatile 读操作的后⾯插⼊⼀个 LoadStore 屏障:LoadStore屏障用来禁止处理器把上面的volatile读与下面的普通写重排序。
为什么不具有原子性?
volatile变量的复合操作(如i++)不具有原子性
- 从字节码角度看
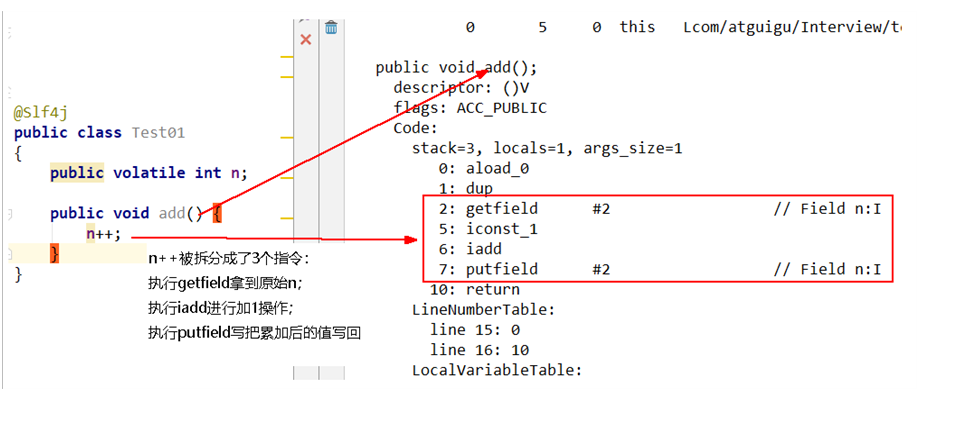
原子性指的是一个操作是不可中断的,即使是在多线程环境下,一个操作一旦开始就不会被其他线程影响。
public void add()
{
i++; //不具备原子性,该操作是先读取值,然后写回一个新值,相当于原来的值加上1,分3步完成
}
如果第二个线程在第一个线程读取旧值(可以从主存取,保证了可见性)和写回新值期间读取i的域值,那么第二个线程就会与第一个线程一起看到同一个值,
并执行相同值的加1操作,这也就造成了线程安全失败,因此对于add方法必须使用synchronized修饰,以便保证线程安全. - 从volatile变量的读写过程
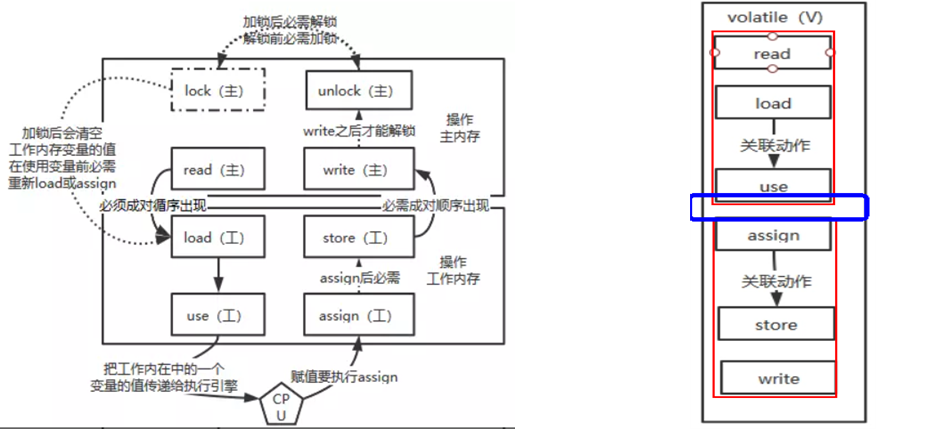
read-load-use 和 assign-store-write 成为了两个不可分割的原子操作,但是在use和assign之间依然有极小的一段真空期,有可能变量会被其他线程读取,导致写丢失一次,但是无论在哪一个时间点主内存的变量和任一工作内存的变量的值都是相等的

汇聚全球AI编程工具,助力开发者即刻编程。
更多推荐

 11
 0
- 0


 已为社区贡献1条内容

所有评论(0)