
Mysql日志演变过程Redo Log Undo Log Binlog Relay Log
一、核心日志全景图
在设计角度上,我们可以将日志分为两类:
- 存储引擎层日志(InnoDB 特有):关注事务的原子性(Atomicity)和持久性(Durability),即 ACID 中的 A 和 D。
- Redo Log(重做日志):保证事务持久性,崩溃恢复。
- Undo Log(回滚日志):保证事务原子性,支持回滚和 MVCC。
- Server 层日志(MySQL 通用):关注归档、复制和审计。
- Binlog(二进制日志):主从复制、数据恢复、审计。
- Relay Log(中继日志):主从复制中的中间环节。
- 其他:Error Log(错误)、Slow Query Log(慢查询)、General Log(全量查询)。
二、设计演变史:从“脆弱”到“坚不可摧”
这套系统不是第一天就设计好的,而是为了解决特定问题逐步演变的。我们可以将其演变过程分为四个阶段:
第一阶段:只有数据文件(无日志)—— “脆弱期”
- 设计状态:数据直接写入磁盘的数据文件(.ibd)。
- 痛点:
- 性能极差:每次修改都要随机写磁盘(Random I/O),速度受限于磁盘机械结构。
- 数据易丢失:如果写到一半断电,数据文件损坏,无法恢复。
- 结论:必须引入机制来解耦“内存修改”和“磁盘持久化”。
第二阶段:引入 Binlog(归档日志)—— “复制与恢复的萌芽”
- 背景:MySQL 早期需要主从复制和数据备份。
- 设计:
- 位置:Server 层(所有引擎通用)。
- 内容:逻辑日志。记录的是 SQL 语句的原文(Statement)或行变更逻辑(Row)。例如:“UPDATE t SET a=2 WHERE id=1”。
- 写入方式:追加写(Append Only),顺序 I/O,性能好。
- 解决的问题:
- 主从复制:从库重放 Binlog 即可同步数据。
- 时间点恢复:通过全量备份 + Binlog 恢复到任意时刻。
- 遗留缺陷(Crash-Safe 问题):
- Binlog 是在事务提交后才写入的。
- 如果发生“两阶段提交”前的崩溃,或者数据页还没刷盘就崩溃,仅靠 Binlog 无法保证已提交事务的数据一定在数据文件中(因为 Binlog 是逻辑的,重放成本高且无法精确还原物理页状态)。
- 核心矛盾:为了性能,我们希望数据先缓存在内存,定期刷盘;但为了安全,我们希望写完立刻落盘。Binlog 解决了“记录”,没完美解决“高效崩溃恢复”。
第三阶段:引入 Redo Log(重做日志)—— “崩溃恢复的终极方案”
- 背景:InnoDB 引擎诞生,急需解决 Crash-Safe 问题,并进一步提升写入性能。
- 设计:
- 位置:存储引擎层(InnoDB 特有)。
- 内容:物理日志。记录的是“在某个数据页上做了什么修改”(例如:在 Page X 的 Offset Y 处写入了值 Z)。
- 机制:WAL (Write-Ahead Logging) 技术。
- 修改数据时,先写内存(Buffer Pool)。
- 同时写 Redo Log(顺序写,极快)。
- 事务提交时,只要 Redo Log 落盘,就算成功。
- 数据页可以在后台慢慢刷入磁盘(Checkpoint 机制)。
- 演变意义:
- 变随机写为顺序写:极大提升了事务提交速度。
- 崩溃恢复:重启时,只需重放 Redo Log 即可将数据页恢复到崩溃前的状态,无需依赖昂贵的 Binlog 重放。
- 新挑战:有了 Redo Log,事务能恢复了,但如果用户执行了
ROLLBACK怎么办?Redo Log 只能“重做”,不能“撤销”。而且,并发读取时,如何看到未提交的历史版本?
第四阶段:引入 Undo Log(回滚日志)—— “原子性与多版本的拼图”
- 背景:完善事务的原子性(Atomicity)和隔离性(Isolation)。
- 设计:
- 位置:存储引擎层(InnoDB)。
- 内容:逻辑日志。记录的是相反的操作。
- Insert -> 记录 Delete 逻辑。
- Update -> 记录反向 Update 逻辑(旧值)。
- Delete -> 记录 Insert 逻辑。
- 演变意义:
- 事务回滚:如果事务失败,利用 Undo Log 反向操作,恢复数据原状。
- MVCC(多版本并发控制):配合 Read View,让事务能看到历史版本的数据,实现非阻塞读(快照读),大幅提升并发性能.
三、深度解析:各日志的核心设计与协作
1. Redo Log vs Binlog:为什么需要两份日志?
这是面试和架构设计中最经典的问题。既然 Redo Log 能崩溃恢复,为什么还要 Binlog?
表格
| 特性 | Redo Log (重做日志) | Binlog (归档日志) |
|---|---|---|
| 所属层级 | 存储引擎层 (InnoDB) | Server 层 (所有引擎) |
| 日志类型 | 物理日志 (记录页的修改) | 逻辑日志 (记录 SQL 或行变更) |
| 写入方式 | 循环写 (空间固定,写完覆盖) | 追加写 (文件写完切换新文件) |
| 核心作用 | Crash-Safe (崩溃恢复) | 主从复制、数据归档恢复 |
| 写入时机 | 事务进行中持续写入,提交时强制刷盘 | 事务提交时一次性写入 |
| 删除策略 | 自动覆盖,不保留历史 | 永久保留,除非手动清理 |
设计哲学上的互补:
- Redo Log 是为了“快”和“稳”:它让 InnoDB 可以随意地在内存修改数据,只要日志记下来就行,不用每次都刷数据页。它是短期的、循环的。
- Binlog 是为了“广”和“久”:它作为整个 MySQL 实例的“黑匣子”,记录了所有变更历史,用于跨实例复制和长期归档。它是长期的、累积的。
两阶段提交(2PC):
为了保证 Redo Log 和 Binlog 的一致性(避免主从数据不一致),MySQL 引入了两阶段提交:
- Prepare 阶段:写 Redo Log,标记为 prepare 状态。
- Write 阶段:写 Binlog。
- Commit 阶段:提交 Redo Log,标记为 commit 状态。
只有当 Binlog 写成功,Redo Log 才会最终提交。 这确保了:如果崩溃,重启时检查 Redo Log,若发现是 prepare 状态,则去查 Binlog,如果 Binlog 里有该事务,则重做;如果没有,则回滚。
2. Undo Log:隐藏的功臣
- 设计细节:Undo Log 也是随事务产生的。事务提交后,Undo Log 不会立即删除,而是根据是否需要用于 MVCC 快照读取来决定何时 purge(清理)。
- 价值:没有 Undo Log,就没有真正的在线热备和高并发读写分离。
3. Relay Log:主从复制的桥梁
- 场景:在主从架构中,从库(Slave)不能直接读主库(Master)的 Binlog(网络开销、锁竞争)。
- 设计:
- Master 将 Binlog 发送给 Slave 的 I/O 线程。
- Slave 将收到的 Binlog 写入本地的 Relay Log。
- Slave 的 SQL 线程读取 Relay Log 并重放执行。
- 意义:解耦了“网络接收”和“SQL 执行”,提高了从库的鲁棒性和性能。
四、总结:从设计角度的启示
MySQL 日志系统的演变告诉我们几个核心的系统设计原则:
- 空间换时间,顺序换随机:
- 通过引入 Log(Redo/Binlog),将随机的数据页写入变成了顺序的日志追加写,极大地利用了磁盘顺序 I/O 的高性能。
- 分层解耦:
- Server 层负责通用逻辑(Binlog),引擎层负责具体实现(Redo/Undo)。这使得 MySQL 可以支持多种存储引擎,同时保持复制功能通用。
- 冗余与一致性权衡:
- Redo Log 和 Binlog 看似冗余,实则职责分离。通过 2PC 机制,在保证数据强一致性的前提下,兼顾了恢复效率(Redo)和扩展能力(Binlog)。
- 以“恢复”为导向的设计:
- 所有的日志设计,本质上都是在回答一个问题:“如果现在断电了,我该怎么以最小的代价把数据恢复到正确状态?”
涉及日志:Undo Log、Redo Log、Binlog
Relay Log:不涉及(主库没有 Relay Log)
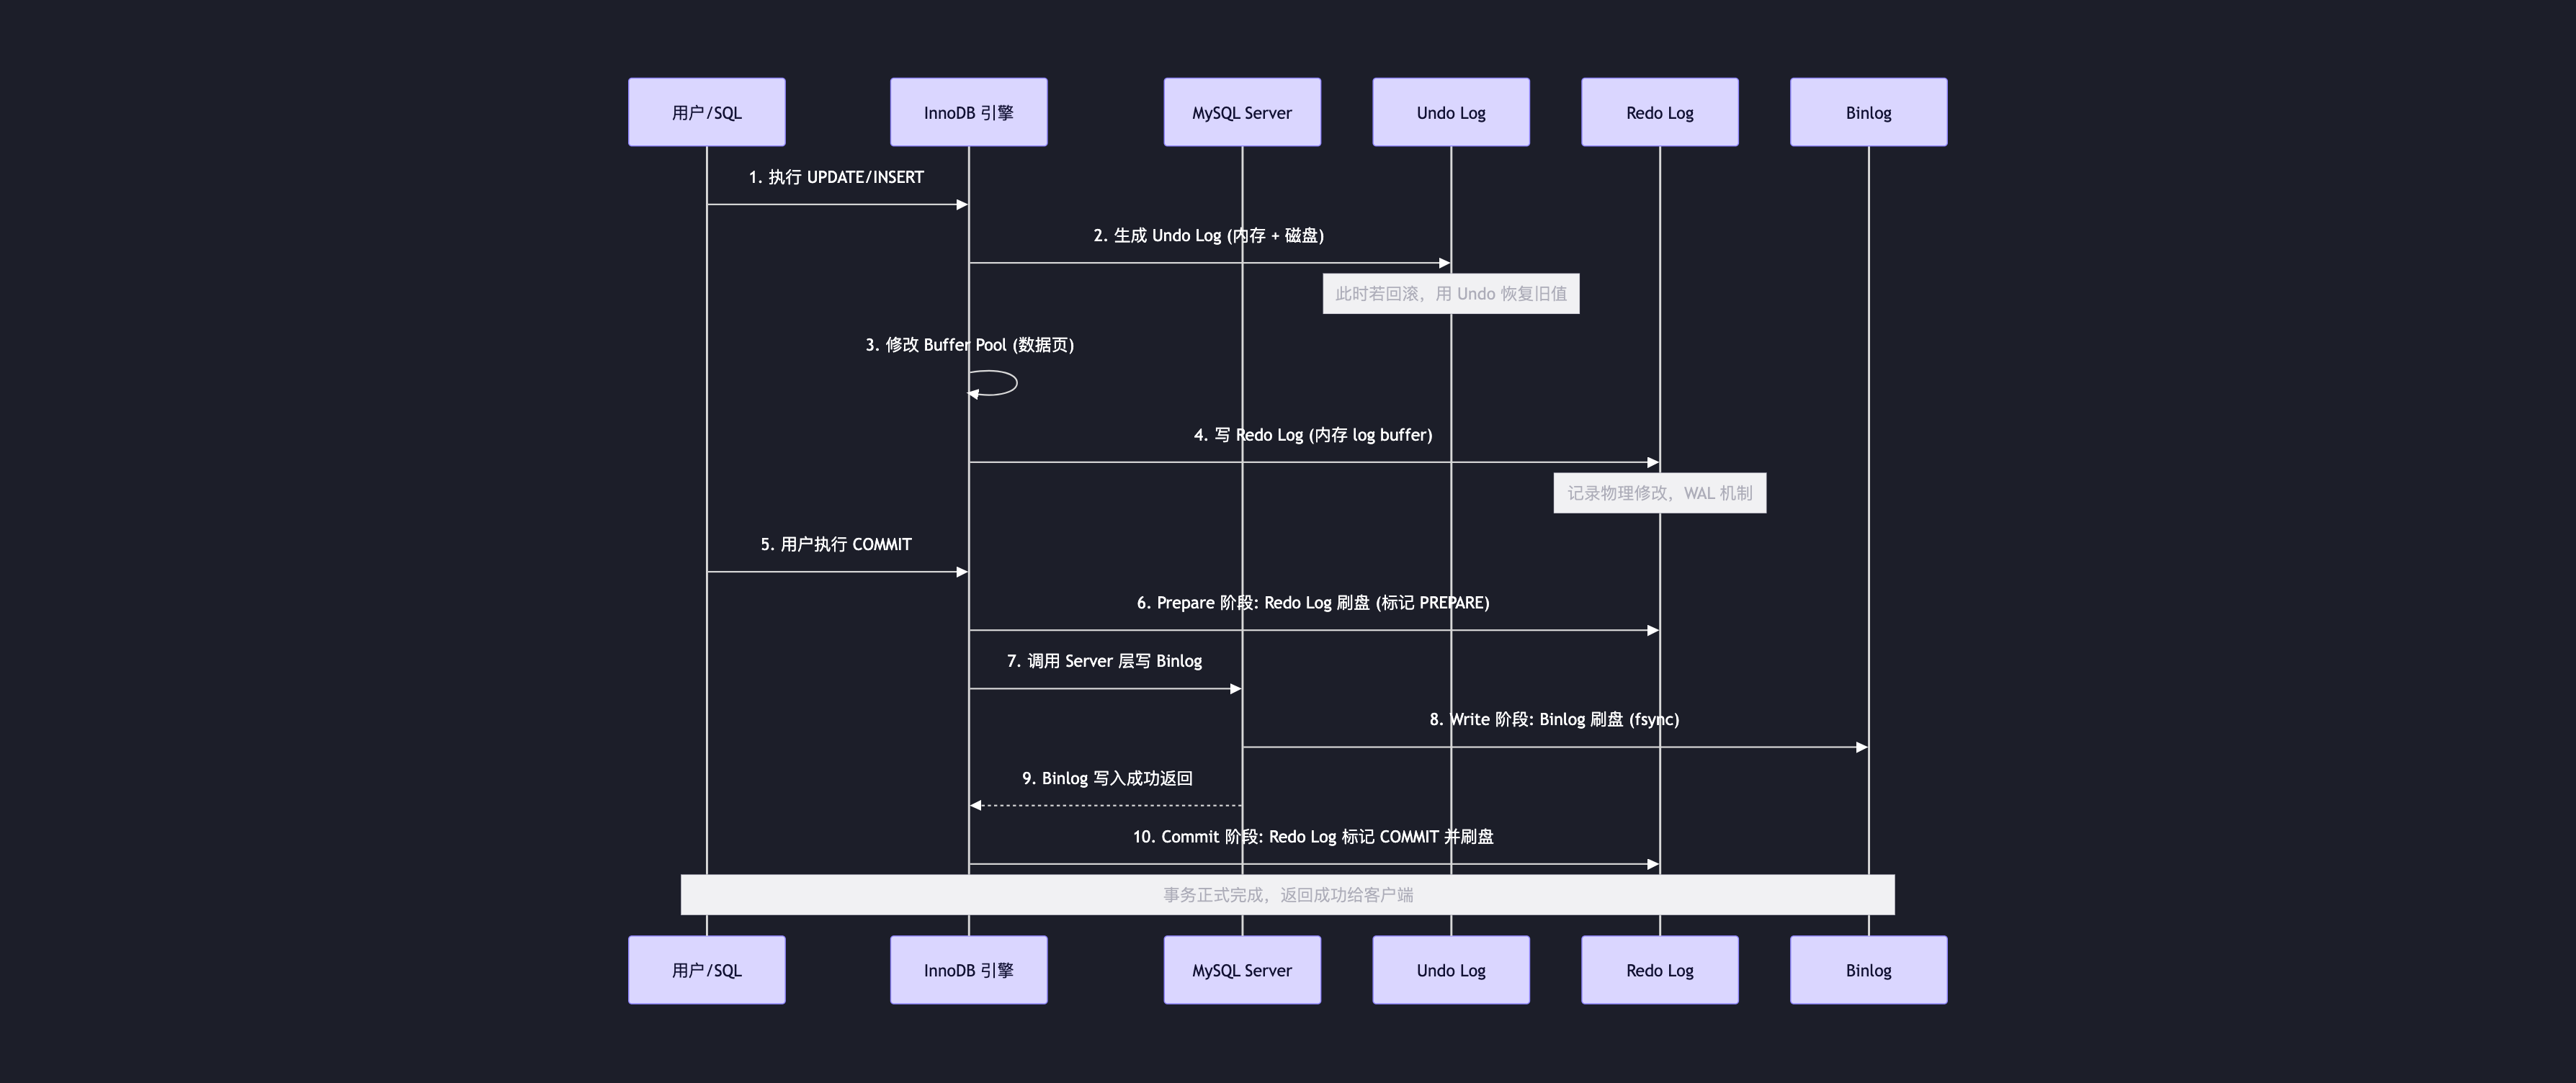
🟢 写入顺序全景图
📝 详细步骤解析
-
Undo Log 最先写入(伴随修改)
- 时机:在事务执行过程中,只要发生了数据修改(INSERT/UPDATE/DELETE),InnoDB 会立即生成 Undo Log。
- 原因:为了支持随时可能的
ROLLBACK和 MVCC 快照读。如果这时候不写,用户一回滚就无法恢复旧数据了。 - 位置:先写内存(Undo Log Buffer),通常随事务提交或后台线程刷入磁盘(ibdata1 或 undo 表空间)。
-
Redo Log 写入(WAL 机制)
- 时机:在修改内存中的数据页(Buffer Pool)时,同时生成 Redo Log 记录放入 Redo Log Buffer。
- 注意:此时只是内存操作,还没强制刷盘。
-
两阶段提交(2PC)—— 关键的刷盘顺序
当用户发出COMMIT指令时,严格的顺序如下:- Step A (Prepare):InnoDB 将 Redo Log Buffer 中的内容刷入磁盘,并将状态标记为
PREPARE。此时事务尚未真正提交。 - Step B (Write):InnoDB 通知 Server 层,Server 层将 Binlog 写入文件系统并执行
fsync刷入磁盘。 - Step C (Commit):只有当 Binlog 落盘成功后,InnoDB 才会将 Redo Log 的状态修改为
COMMIT并再次刷盘(或仅修改内存标记,取决于配置)。
- Step A (Prepare):InnoDB 将 Redo Log Buffer 中的内容刷入磁盘,并将状态标记为
核心结论(主库):
Undo Log (修改时) -> Redo Log (Prepare) -> Binlog -> Redo Log (Commit)
场景二:从库(Slave)同步事务
涉及日志:Relay Log、Redo Log、Undo Log、Binlog (从库通常不开启,若开启则最后写)
核心角色:Relay Log 是主角。
从库不直接接收主库的 Redo Log 或 Undo Log,它只接收主库的 Binlog。
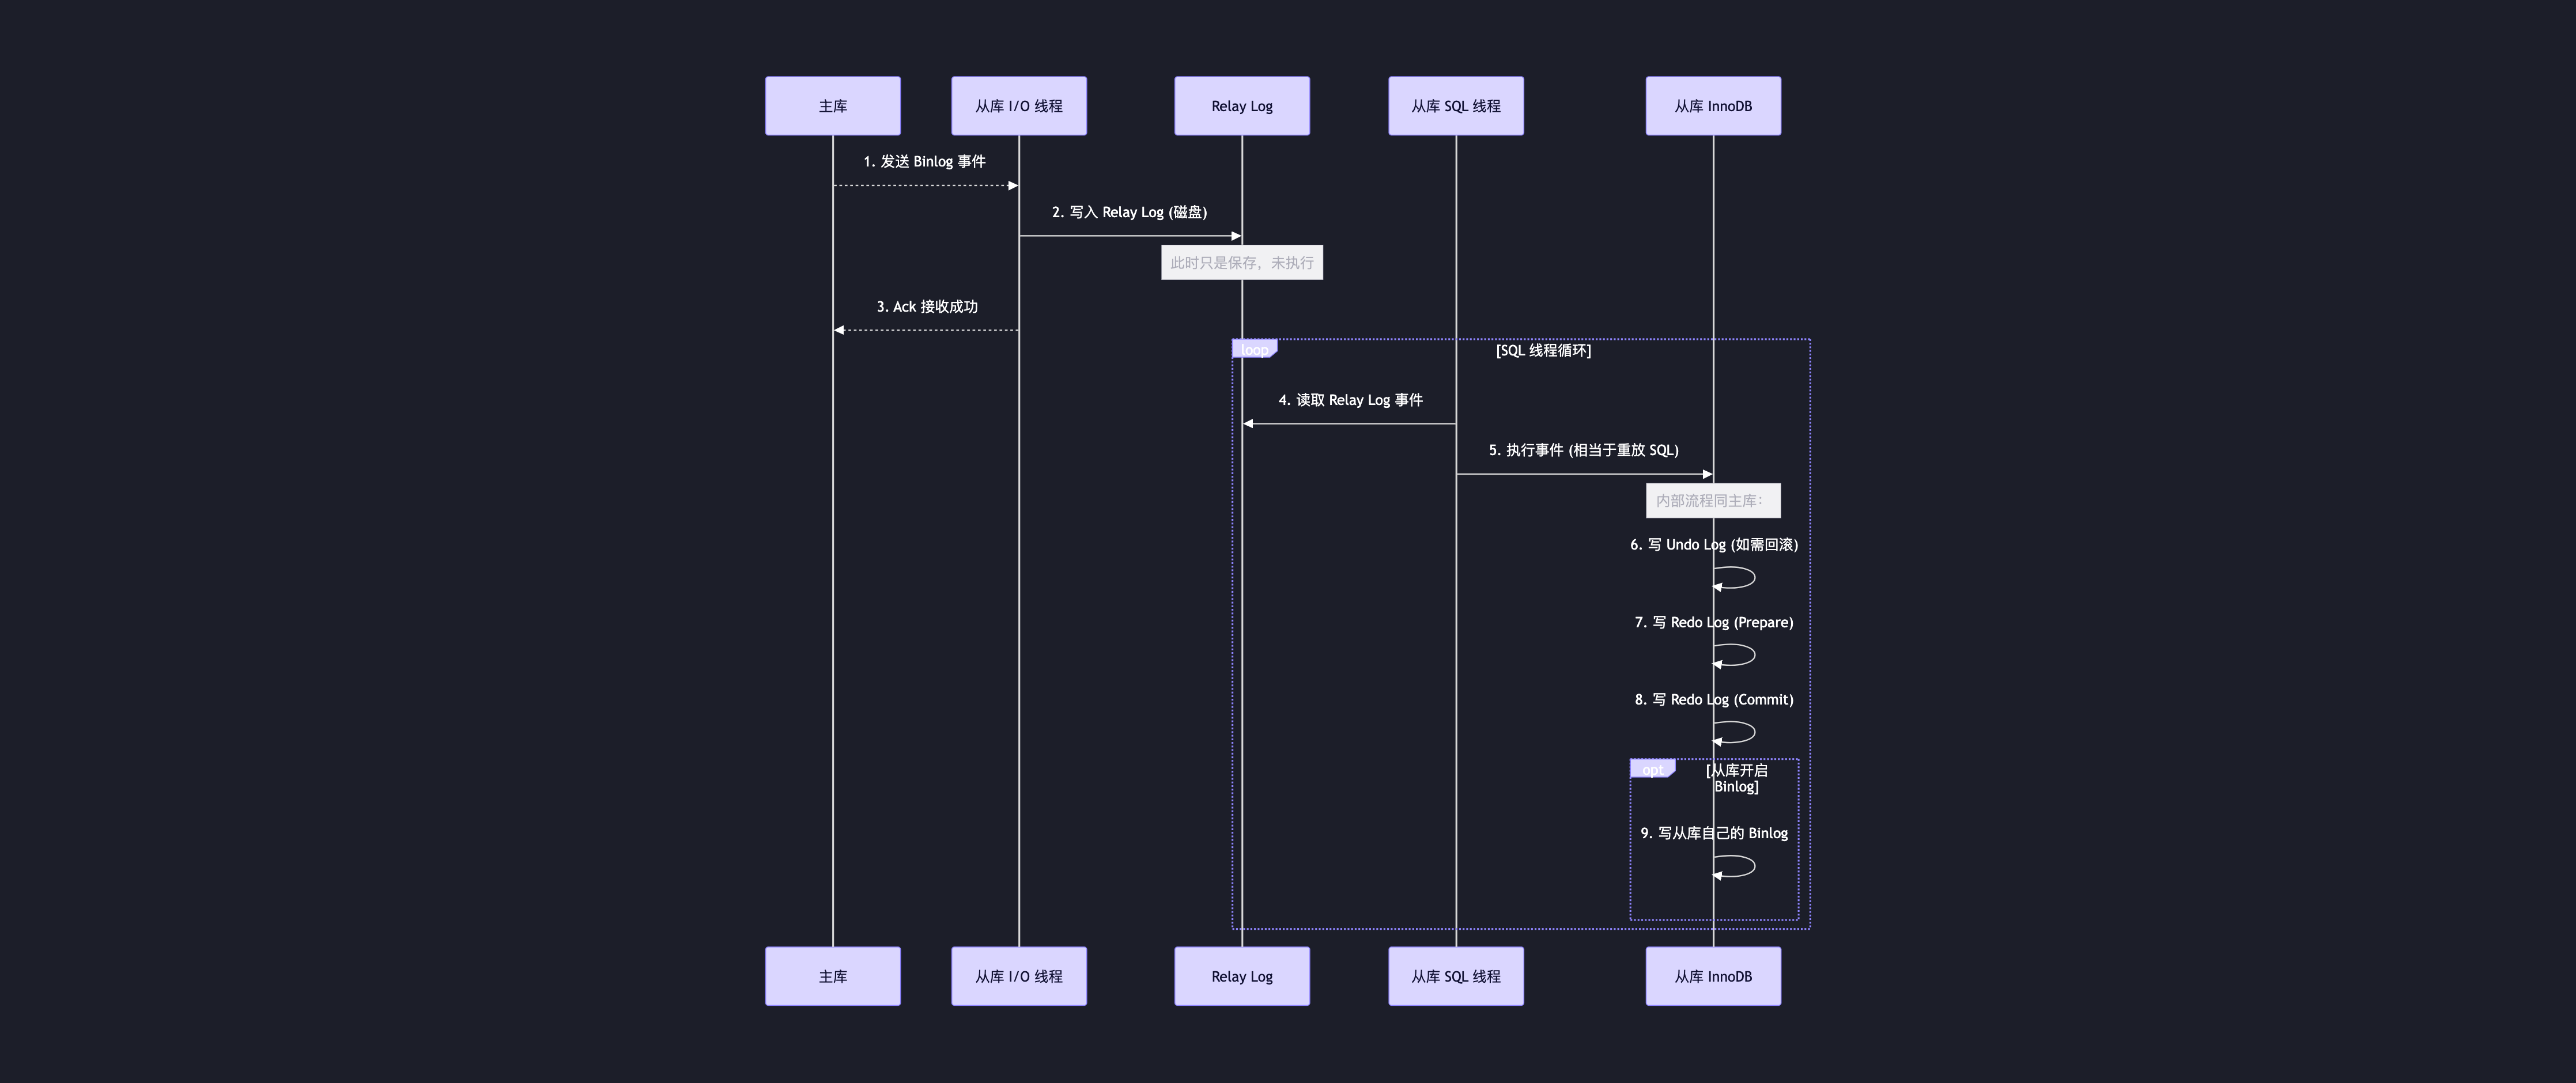
🔵 写入顺序全景图
图表
📝 详细步骤解析
-
Relay Log 写入(网络接收阶段)
- 时机:从库的 I/O 线程 连接到主库,拉取主库的 Binlog 事件。
- 动作:直接将收到的事件追加写入到本地的 Relay Log 文件中。
- 特点:此时不执行任何 SQL,也不生成 Redo/Undo。这只是单纯的“搬运”工作,速度极快。
-
Redo/Undo 写入(SQL 执行阶段)
- 时机:从库的 SQL 线程 读取 Relay Log 中的事件。
- 动作:在从库本地重放这些操作(就像有人在从库敲了一遍 SQL 一样)。
- 内部顺序:一旦开始重放,从库内部的 InnoDB 引擎会完全重复主库的逻辑:
- 先写 Undo Log(为了原子性)。
- 再写 Redo Log (Prepare)。
- 由于这是重放过程,通常不需要再写 Binlog(除非从库开启了
log_slave_updates,用于级联复制)。 - 最后写 Redo Log (Commit)。
核心结论(从库):
Relay Log (最先,由 I/O 线程写入) -> Undo Log (执行时) -> Redo Log (Prepare) -> Redo Log (Commit)
(注:从库默认不写 Binlog,若开启则在 Redo Commit 前后)
四者关系总结表
表格
| 日志类型 | 写入主体 | 写入时机 (相对顺序) | 核心目的 | 是否循环写 |
|---|---|---|---|---|
| Undo Log | InnoDB 引擎 | 最早 (数据修改发生时) | 事务回滚、MVCC | 否 (用完可清理) |
| Redo Log | InnoDB 引擎 | 中间 (COMMIT 时的 Prepare & Commit) | 崩溃恢复 (Crash-Safe) | 是 (固定大小循环写) |
| Binlog | MySQL Server | 中间偏后 (Redo Prepare 之后,Commit 之前) | 主从复制、归档 | 否 (追加写,文件切换) |
| Relay Log | 从库 I/O 线程 | 从库最先 (接收到主库 Binlog 时) | 缓冲主从网络差异 | 否 (追加写,执行后清理) |
关键设计点回顾
-
为什么 Undo Log 最早?
- 因为事务随时可能失败。如果在修改数据前不预留“后悔药”(Undo Log),一旦报错就无法原子性回滚了。
-
为什么 Redo Log 分两阶段,夹着 Binlog?
- 这是为了一致性。
- 如果先写 Redo Commit 再写 Binlog:断电导致 Binlog 没写上,重启后 Redo 已提交,主库有数据但从库没有 -> 主从不一致。
- 如果先写 Binlog 再写 Redo Prepare:断电导致 Redo 没写上,重启后 Binlog 有记录但 Redo 没印象,无法恢复 -> 数据丢失。
- 夹在中间(2PC) 确保了:要么两者都有,要么两者都无(通过恢复逻辑回滚)。
-
Relay Log 为什么独立存在?
- 它将“网络 IO”(慢、不稳定)与“磁盘执行”(快、稳定)解耦。I/O 线程只管把主库的 Binlog 搬到 Relay Log 就完工,剩下的交给 SQL 线程慢慢从 Relay Log 读出来执行(触发内部的 Undo/Redo 流程)。

汇聚全球AI编程工具,助力开发者即刻编程。
更多推荐

 11
 0
- 0


 已为社区贡献1条内容

所有评论(0)