
Java 量化系列(三十):2 种方案获取股票是否可融
在时序数据批量分析中,我们常需要为数据添加特定标签(如分类标签、属性标签),以便后续筛选和分析。比如从海量数据中识别出具备某类属性的标的,传统手动标注效率极低,而自动化爬取能大幅提升效率。
今天这篇系列第三十篇,就带大家实现两种 “目标标签数据获取方案”—— 重点拆解东方财富页面动态爬取(支持批量获取标签),补充同花顺问财文件导入方案(适合大规模数据),全程聚焦技术实现,泛化适用于各类标签爬取场景,不涉及具体金融交易,仅提供技术落地方案。
一、核心需求:为什么需要自动化标签爬取?
手动标注目标标签的痛点很明显:
效率低:海量数据逐一标注耗时耗力,容易出错;
更新难:标签属性可能动态变化,手动维护成本高;
规模化难:数据量突破千条后,手动标注几乎无法完成。
而自动化爬取的核心价值在于 “批量获取、自动更新、低维护成本”,两种方案各有适配场景:
东方财富页面爬取:适合中小规模数据(数百条),实时获取最新标签,无需手动下载文件;
同花顺问财文件导入:适合大规模数据(数千条 +),一次性批量导入,效率更高。
二、方案一:东方财富页面动态爬取(重点实战)
该方案通过htmlunit模拟浏览器执行 JS,jsoup解析页面元素,实时爬取目标标签状态,适合需要实时更新的场景。
2.1 第一步:依赖准备(pom.xml)
首先引入动态页面爬取和 HTML 解析依赖,支持 JS 渲染页面爬取(东方财富页面为动态渲染,需执行 JS 才能获取完整内容):
<!-- 动态页面爬取(模拟浏览器执行JS) -->
<dependency>
<groupId>net.sourceforge.htmlunit</groupId>
<artifactId>htmlunit</artifactId>
<version>2.70.0</version>
</dependency>
<!-- HTML解析工具 -->
<dependency>
<groupId>org.jsoup</groupId>
<artifactId>jsoup</artifactId>
<version>1.11.2</version>
</dependency>
htmlunit:模拟 Chrome 浏览器,执行页面 JS,获取动态渲染后的完整 HTML;
jsoup:轻量级 HTML 解析器,快速定位目标元素,提取标签信息。
2.2 第二步:核心工具类实现(DynamicHtmlUtil)
该工具类封装了动态页面爬取逻辑,支持设置超时时间、等待 JS 执行,单例模式避免重复创建浏览器实例,泛化后代码如下:、
/**
* 动态HTML爬取工具类(支持JS渲染页面)
* 适用于各类动态加载页面的数据爬取
*/
public class DynamicHtmlUtil {
/** 请求超时时间(默认20000ms) */
private static int timeout = 20000;
/** 等待异步JS执行时间(默认20000ms) */
private static int waitForBackgroundJavaScript = 20000;

private static DynamicHtmlUtil instance;

// 私有构造器,单例模式
private DynamicHtmlUtil() {}

/** 获取单例实例 */
public static DynamicHtmlUtil getInstance() {
if (instance == null) {
instance = new DynamicHtmlUtil();
}
return instance;
}

// getter/setter方法
public int getTimeout() { return timeout; }
public void setTimeout(int timeout) { this.timeout = timeout; }
public int getWaitForBackgroundJavaScript() { return waitForBackgroundJavaScript; }
public void setWaitForBackgroundJavaScript(int waitForBackgroundJavaScript) { this.waitForBackgroundJavaScript = waitForBackgroundJavaScript; }

/**
* 解析HTML字符串为Document对象(去除空格干扰)
* @param html 待解析的HTML字符串
* @return 解析后的Document
*/
public static Document parseHtmlToDoc(String html) {
return removeHtmlSpace(html);
}

/** 去除HTML中的 等空格字符 */
private static Document removeHtmlSpace(String str) {
Document doc = Jsoup.parse(str);
String result = doc.html().replace(" ", "");
return Jsoup.parse(result);
}

/**
* 获取动态页面的HTML字符串(执行JS后)
* @param url 目标页面URL
* @return 完整HTML字符串
* @throws Exception 爬取异常
*/
public static String getHtmlPageResponse(String url) throws Exception {
return getHtmlPageResponseAsHtmlPage(url).asXml();
}

/**
* 获取动态页面的Document对象(核心方法)
* @param url 目标页面URL
* @return 解析后的Document
* @throws Exception 爬取异常
*/
public static Document getHtmlPageResponseAsDocument(String url) throws Exception {
return parseHtmlToDoc(getHtmlPageResponse(url));
}

/**
* 核心:模拟浏览器爬取动态页面
* @param url 目标页面URL
* @return HtmlPage对象(包含执行JS后的完整内容)
* @throws Exception 爬取异常
*/
public static HtmlPage getHtmlPageResponseAsHtmlPage(String url) throws Exception {
// 模拟Chrome浏览器
final WebClient webClient = new WebClient(BrowserVersion.CHROME);

// 浏览器配置(关键)
webClient.getOptions().setCssEnabled(false); // 禁用CSS,提升爬取速度
webClient.getOptions().setJavaScriptEnabled(true); // 启用JS,解析动态内容
webClient.getOptions().setThrowExceptionOnScriptError(false); // 忽略JS执行错误
webClient.getOptions().setThrowExceptionOnFailingStatusCode(false); // 忽略非200状态码异常
webClient.setAjaxController(new NicelyResynchronizingAjaxController()); // 支持AJAX请求

// 超时设置
webClient.getOptions().setTimeout(timeout);
webClient.setJavaScriptTimeout(timeout);

// 缓存配置(优化性能)
webClient.getOptions().setRedirectEnabled(true);
webClient.getOptions().setDoNotTrackEnabled(true);
webClient.getCache().setMaxSize(300);

HtmlPage page;
try {
page = webClient.getPage(url); // 访问页面
} catch (Exception e) {
webClient.close();
throw e;
}

// 等待JS执行完成(关键:动态页面需等待渲染)
webClient.waitForBackgroundJavaScript(waitForBackgroundJavaScript);
return page;
}
}
2.3 第三步:标签爬取实战(东方财富页面)
核心方法hasTargetTag通过拼接 URL、爬取页面、解析元素,判断目标数据是否具备指定标签,泛化后代码如下:
/**
* 判断目标数据是否具备指定标签(东方财富页面爬取)
* @param dataCode 数据唯一标识(如编码)
* @return true=具备目标标签,false=不具备或爬取失败
*/
public boolean hasTargetTag(String dataCode) {
// 页面URL模板:替换占位符为数据编码
String url = MessageFormat.format("https://quote.eastmoney.com/{0}.html", dataCode);
try {
// 获取工具类实例
DynamicHtmlUtil dynamicHtmlUtil = DynamicHtmlUtil.getInstance();
// 设置超时和JS等待时间(适配页面加载速度)
dynamicHtmlUtil.setWaitForBackgroundJavaScript(6000);
dynamicHtmlUtil.setTimeout(6000);

// 爬取页面并解析为Document对象
Document document = dynamicHtmlUtil.getHtmlPageResponseAsDocument(url);

// 定位目标标签元素(通过CSS选择器,需根据页面结构调整)
// 注:元素选择器需通过浏览器开发者工具获取,下文有获取方法
Element targetElement = document.select("#app > div > div > div.quote_title.self_clearfix > div.quote_title_l > a:nth-child(4)").get(0);

// 提取元素文本,判断是否为目标标签
String tagText = targetElement.text().trim();
log.info("数据编码 {} 对应的标签文本:{}", dataCode, tagText);

// 此处"目标标签"需替换为实际要爬取的标签文本(如"标签A")
return "目标标签".equals(tagText);

} catch (Exception e) {
log.error("数据编码 {} 标签爬取异常:{}", dataCode, e.getMessage());
return false;
}
}
2.4 关键操作:获取元素选择器(新手必看)
爬取的核心是准确定位标签元素,需通过浏览器开发者工具获取 CSS 选择器:
打开目标页面(如https://quote.eastmoney.com/XXX.html);
按 F12 打开开发者工具,切换到「Elements」面板;
鼠标点击「选择元素」按钮(左上角箭头图标),点击页面上的目标标签;
右键选中的 HTML 元素,选择「Copy」→「Copy selector」,即可获取 CSS 选择器;
将选择器替换到代码中的select方法参数。
如爬取 000001
访问页面:
https://quote.eastmoney.com/sz000001.html
对这个 数据 文字 进行爬取
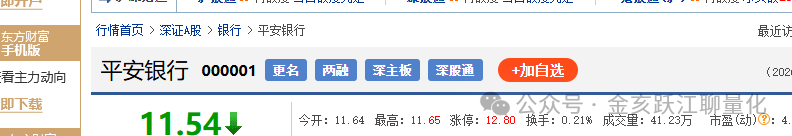
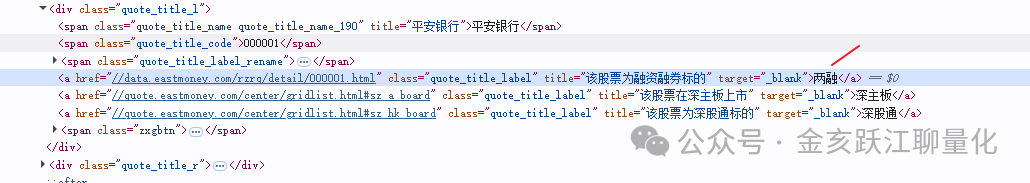
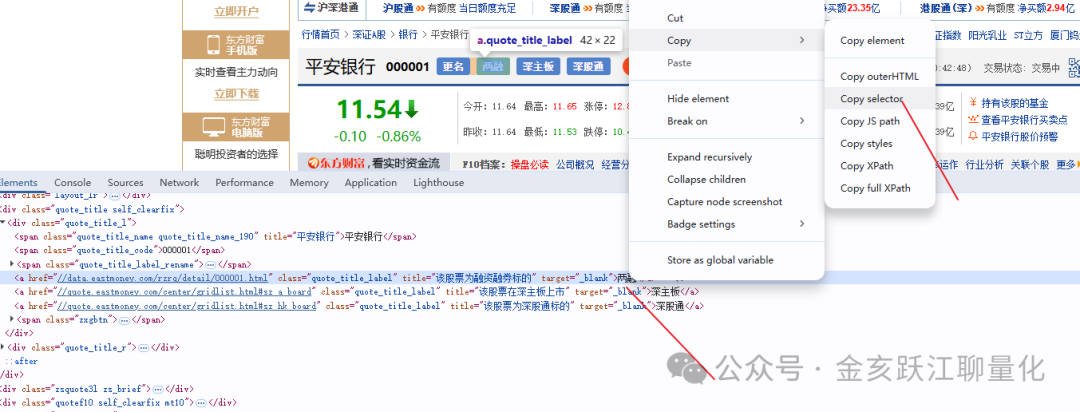
对应 css 为:
#app > div > div > div.quote_title.self_clearfix > div.quote_title_l > a:nth-child(4)
读取这个标签即可。
2.5 批量爬取示例
循环遍历数据编码列表,批量获取标签状态:
/**
* 批量爬取目标标签状态
* @param dataCodeList 数据编码列表
* @return 具备目标标签的数据编码列表
*/
public List<String> batchGetTargetTagData(List<String> dataCodeList) {
List<String> resultList = new ArrayList<>();
for (String dataCode : dataCodeList) {
if (hasTargetTag(dataCode)) {
resultList.add(dataCode);
}
}
log.info("批量爬取完成,具备目标标签的数据共 {} 个", resultList.size());
return resultList;
}
三、方案二:同花顺问财文件导入(大规模数据适配)
对于数千条以上的大规模数据,文件导入效率更高,步骤如下(泛化后):
3.1 第一步:下载标签数据文件
访问同花顺问财页面:
https://www.iwencai.com/unifiedwap/result?w=所属概念包含融资融券&querytype=stock
页面加载完成后,点击右侧「导出」按钮(通常为 Excel 格式);
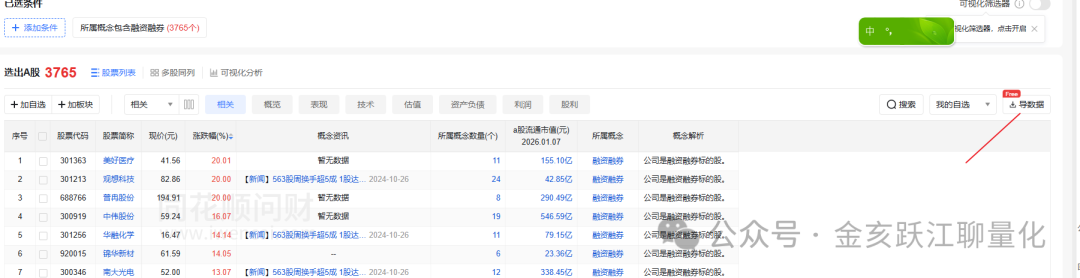
保存文件到本地指定路径(如 D:/data/target_tag.xlsx)。
3.2 第二步:文件解析与数据库导入
使用 EasyExcel 工具解析 Excel 文件,提取数据编码和标签状态,批量导入数据库 即可
四、避坑指南:爬取与导入的关键注意事项
反爬处理:东方财富页面爬取时,避免高频请求(可添加 1-2 秒间隔),否则可能被限制 IP;
元素选择器更新:若页面结构变化,需重新获取 CSS 选择器(通过开发者工具);
超时设置:动态页面加载速度受网络影响,建议设置≥5000ms 的 JS 等待时间;
文件格式兼容:问财导出文件可能为 CSV 格式,需调整解析逻辑(使用 CSVReader 工具);
异常兜底:爬取失败时返回默认状态(如 false),避免影响批量处理流程;
编码校验:数据编码需完整(如含市场标识),否则拼接的 URL 无效。
五、方案对比与场景适配
| 方案 | 优势 | 劣势 | 适配场景 |
|---|---|---|---|
| 东方财富页面爬取 | 实时获取最新标签,无需手动下载 | 单条请求耗时较长,高频受限 | 中小规模数据(≤500 条),需实时更新 |
| 同花顺问财文件导入 | 批量效率高,支持大规模数据 | 需手动下载文件,无法实时更新 | 大规模数据(≥1000 条),周期性更新 |
六、下期功能预告
下期主要讲解一下, 获取东方财富板块列表。
为了帮大家快速落地,我整理了完整代码包,包含:① DynamicHtmlUtil 工具类;② 东方财富爬取方法;
私信回复 “标签爬取”,即可获取完整代码包,直接导入项目就能使用,支持快速扩展到其他标签爬取场景!
最后留个小问题:你在爬取动态页面时遇到过哪些反爬限制?是否需要适配更多平台(如其他数据网站)的爬取方案?欢迎在评论区留言,后续将持续优化完善~

汇聚全球AI编程工具,助力开发者即刻编程。
更多推荐

 20
 0
- 0


 已为社区贡献4条内容

所有评论(0)