
JUC 并发编程深度探索
1. 前言
JUC,即Java Util Concurrent的缩写,指的是 Java 并发包 java.util.concurrent 及其子包。它提供了一套用于多线程编程的高级工具类,比如线程池(ExecutorService)、锁(Lock)、原子变量(AtomicInteger 等)、同步器(CountDownLatch、Semaphore、CyclicBarrier 等),简化了并发程序的开发。
在传统的 Java 多线程开发中,开发者主要依赖 synchronized 关键字和 Object 类的 wait()/notify() 机制来实现线程同步。虽然这些基础工具能够满足简单的并发需求,但在面对复杂、高性能或高可靠性的并发场景时,往往显得力不从心——例如难以实现公平锁、无法中断等待中的线程、缺乏灵活的线程协作机制等。而 JUC 正是在这样的背景下应运而生,它由并发大师 Doug Lea 主导设计,基于 CAS(Compare-And-Swap)等底层无锁技术,提供了更高效、更安全、更易用的并发编程模型,极大提升了 Java 在高并发领域的开发效率与系统稳定性。
2. 如何创建线程?
2.1 创建线程的三种方式
在Java中,总共有三种创建线程的方式,分别是:
- 继承Thread类,重写run方法
- 实现Runnable接口,作为参数传入Thread中
- 实现Callable接口,通过FutureTask接收
接下来我们通过简单的示例进行演示
2.2 继承Thread类创建线程
2.2.1 代码示例
/**
 * @author 王玉涛
 * @version 1.0
 * @since 2026/1/3
 */
public class MyThread extends Thread {
    /**
     * If this thread was constructed using a separate
     * {@code Runnable} run object, then that
     * {@code Runnable} object's {@code run} method is called;
     * otherwise, this method does nothing and returns.
     * <p>
     * Subclasses of {@code Thread} should override this method.
     *
     * @see #start()
     * @see #stop()
     */
    @Override
    public void run() {
        System.out.println("这是线程" + this.getName());
    }
}
/**
 * @author 王玉涛
 * @version 1.0
 * @since 2026/1/3
 */
@Slf4j
public class Main {

    public static void main(String[] args) {
        new MyThread().start();
    }
}
2.2.2 源码探索
我们通过源码,看看为什么继承Thread类,重写run方法可以实现创建线程
@Override
public void run() {
    if (target != null) {
        target.run();
    }
}
我们可以看到,这里调用的,是target的run方法, 而target的类型则是Runnable,因此,我们重写run方法后,调用start方法本质上会走我们重写的run方法逻辑。
2.2.3 start方法和run方法的区别
那么为什么我们需要通过start方法来启动线程,而不是run方法来启动呢?我们继续深入源码探索一下
public synchronized void start() {
    if (threadStatus != 0)
        throw new IllegalThreadStateException();

    group.add(this);
    boolean started = false;
    try {
        // 核心在这里
        start0();
        started = true;
    } finally {
        try {
            if (!started) {
                group.threadStartFailed(this);
            }
        } catch (Throwable ignore) {
            /* do nothing. If start0 threw a Throwable then
              it will be passed up the call stack */
        }
    }
}

// 本质上会调用这个方法来启动线程
private native void start0();
我们可以看到,这里的start方法,调用了start0()方法,而start0()方法,是由native修饰的。而native修饰的方法表示该方法的实现是由 非 Java 代码(通常是 C/C++)编写的,运行在 Java 虚拟机(JVM)底层。
而start() 方法(通过底层的 start0())会创建一个新的操作系统线程,并在该新线程中自动调用 run() 方法。而调用 start() 的主线程会立即返回,不等待 run() 执行完毕,因此 run() 是在新线程中异步执行的。
所以,start()方法和run()方法的区别就在于,start()方法会使得run()方法异步执行在一个新线程中,而run()方法则是直接同步执行在主线程中
2.2.4 wait方法和sleep方法有什么区别?
- 所属类不同:sleep是线程中的方法,但是wait是Object中的方法
- 语法不同:sleep方法不依赖于同步器synchronized,但是wait需要依赖synchronized关键字
- 参数不同:sleep必须设置睡眠时间,而wait可以不设置,不设置默认一直休眠
- 释放锁资源不同:sleep方法不会释放锁,而wait会释放,并且会加入到等待队列中
- 唤醒方式不同:sleep不需要被唤醒(休眠后自动退出阻塞),但是wait需要(不指定时间需要别人中断)
- 线程进入状态不同:sleep方法会让线程进入TIMED_WAITING有时限等待状态,而调用无参数的wait方法,线程会进入WAITING无时限等待状态
2.3 实现Runnable接口创建线程
2.3.1 代码示例
/**
 * @author 王玉涛
 * @version 1.0
 * @since 2026/1/3
 */
public class MyRunnable implements Runnable {
    /**
     * When an object implementing interface {@code Runnable} is used
     * to create a thread, starting the thread causes the object's
     * {@code run} method to be called in that separately executing
     * thread.
     * <p>
     * The general contract of the method {@code run} is that it may
     * take any action whatsoever.
     *
     * @see Thread#run()
     */
    @Override
    public void run() {
        System.out.println("这是线程" + Thread.currentThread().getName());
    }
}
/**
 * @author 王玉涛
 * @version 1.0
 * @since 2026/1/3
 */
@Slf4j
public class Main {

    public static void main(String[] args) {
        // 1. 新增类实现接口Runnable
        new Thread(new MyRunnable()).start();
        // 2. 通过lambda表达式简化开发
        new Thread(() -> System.out.println("这是线程" + Thread.currentThread().getName())).start();
    }
}
2.3.2 继承Thread vs 实现Runnable接口
既然二者都可以实现创建线程,那么一般情况下,更推荐使用什么方式?
更推荐实现
Runnable接口,原因:
1. 避免Java单继承限制(Thread已继承自Object)
2. 任务与线程解耦,便于复用(如线程池复用任务)
3. 与JUC线程池(ExecutorService)天然兼容
2.4 实现Callable接口创建线程
2.4.1 代码示例
/**
 * @author 王玉涛
 * @version 1.0
 * @since 2026/1/7
 */
public class MyCallable implements Callable<Integer> {

    private static final Random RANDOM = new Random();

    /**
     * Computes a result, or throws an exception if unable to do so.
     *
     * @return computed result
     * @throws Exception if unable to compute a result
     */
    @Override
    public Integer call() throws Exception {
        int nextInt = RANDOM.nextInt();
        System.out.println("这是线程" + Thread.currentThread().getName() + "的计算结果: " + nextInt);
        return nextInt;
    }
}
/**
 * @author 王玉涛
 * @version 1.0
 * @since 2026/1/3
 */
@Slf4j
public class Main {

    public static void main(String[] args) throws ExecutionException, InterruptedException {
        // 1. 通过实现Callable接口创建线程
        FutureTask<Integer> futureTask = new FutureTask<>(new MyCallable());
        // 2. 通过匿名内部类形式创建线程
        FutureTask<Integer> futureTask1 = new FutureTask<>(() -> {
            int nextInt = new Random().nextInt();
            System.out.println("这是FutureTask的任务:" + nextInt);
            return nextInt;
        });

        new Thread(futureTask).start();
        new Thread(futureTask1).start();

        log.info("这是futureTask的返回结果: {}", futureTask.get());
        log.info("这是futureTask1的返回结果: {}", futureTask1.get());
    }
}
2.2.2 为什么要这样创建线程?
我们可以继续查看相应的源码,查看为什么要以FutureTask接收Callable接口的实现类,再通过Thread类接受FutureTask来实现创建线程
// 这里FutureTask实现的是RunnableFuture的接口
public class FutureTask<V> implements RunnableFuture<V> {}

// 这里RunnableFuture是Runnable的子接口
public interface RunnableFuture<V> extends Runnable, Future<V> {
    /**
     * Sets this Future to the result of its computation
     * unless it has been cancelled.
     */
    void run();
}
我们可以看到,FutureTask本质上也是Runnable的实现类
public void run() {
    if (state != NEW ||
        !RUNNER.compareAndSet(this, null, Thread.currentThread()))
        return;
    try {
        Callable<V> c = callable;
        if (c != null && state == NEW) {
            V result;
            boolean ran;
            try {
                // 核心,通过这里的逻辑调用Callable的call方法
                result = c.call();
                ran = true;
            } catch (Throwable ex) {
                result = null;
                ran = false;
                setException(ex);
            }
            if (ran)
                // 在这里设置返回值,并通过get方法获取返回值
                set(result);
        }
    } finally {
        // runner must be non-null until state is settled to
        // prevent concurrent calls to run()
        runner = null;
        // state must be re-read after nulling runner to prevent
        // leaked interrupts
        int s = state;
        if (s >= INTERRUPTING)
            handlePossibleCancellationInterrupt(s);
    }
}
2.5 总结
1. 继承 Thread 类:简单直接,但 Java 不支持多继承,灵活性差,一般不推荐。
2. 实现 Runnable 接口:解耦任务与线程,支持资源共享,是创建线程的首选方式。
3. 实现 Callable 接口 + FutureTask:适用于需要返回结果或处理异常的异步任务,常用于配合线程池使用。
三者本质都是通过 Thread 启动新线程,最终执行的都是 run() 方法;而 Callable 能返回结果,是因为 FutureTask 在 run() 内部调用了 call() 并保存了结果。
3. 线程池
3.1 线程池简介
1. 线程池是Java并发编程(java.util.concurrent包)中非常核心且实用的组件。简单来说,它就像一个“线程的仓库”。
2. 如果不使用线程池,那么就需要手动管理任务和线程创建、销毁之间的关系,每遇到一个新任务就需要创建一个新线程,而任务完成后线程就会被销毁,效率极低且浪费资源。
3. 使用线程池有什么优势?
- 降低资源消耗: 通过复用线程,减少了创建和销毁线程的CPU和内存开销。
- 提高响应速度: 任务到达时,无需等待线程创建,直接由空闲线程执行。
- 提高线程的可管理性: 你可以统一控制线程的数量,防止无限制创建线程导致系统崩溃(如内存溢出 OOM)。
- 提供强大的功能: 支持定时执行、周期性执行等高级功能。
3.2 自定义线程池快速使用
3.2.1 使用示例
public class MyThreadPool {

    // 线程池默认线程数量
    private static final int CORE_POOL_SIZE = 10;
    // 线程池最大线程数量
    private static final int MAXIMUM_POOS_SIZE = 20;
    // 线程池线程空闲时间
    private static final long KEEP_ALIVE_TIME = 10L;
    // 线程池线程空闲时间单位
    private static final TimeUnit KEEP_ALIVE_TIME_UNIT = TimeUnit.SECONDS;
    // 线程池任务队列
    private static final BlockingQueue<Runnable> WORK_QUEUE = new LinkedBlockingQueue<>(5);
    // 线程工厂
    private static final ThreadFactory DEFAULT_THREAD_FACTORY = Executors.defaultThreadFactory();
    // 拒绝策略
    private static final RejectedExecutionHandler DEFAULT_POLICY = new ThreadPoolExecutor.DiscardOldestPolicy();

    /**
     * 创建默认参数线程池
     * @return
     */
    public static ExecutorService createDefaulExecutors() {
        return new ThreadPoolExecutor(
            CORE_POOL_SIZE,
            MAXIMUM_POOS_SIZE,
            KEEP_ALIVE_TIME,
            KEEP_ALIVE_TIME_UNIT,
            WORK_QUEUE,
            DEFAULT_THREAD_FACTORY,
            DEFAULT_POLICY);
    }
}

public class Main {

    public static void main(String[] args) {
        ExecutorService defaulExecutors = MyThreadPool.createDefaulExecutors();

        for (int i = 0; i < 10000; i++) {
            defaulExecutors.execute(() -> {
                System.out.println(Thread.currentThread().getName());
            });
        }
    }
}
3.2.2 参数说明
线程池的自定义参数类型以及解释如下:
- 核心线程数(corePoolSize): 线程池处于空闲状态下的最小线程数。任务提交时,如果当前线程数小于核心线程数,线程池也会创建新线程处理任务
- 最大线程数(maximumPoolSize): 线程池允许创建的最大线程数,当任务队列已满,并且当前线程数小于最大线程数时,线程池会创建新线程处理任务
- 空闲线程存活时间(keepAliveTime):当线程数超过核心线程数时候,在线程回收前等待新任务的最长时间。
- 时间单位(keepAliveTimeUnit):用于指定空闲线程存活时间的单位。例如秒(TimeUnit.SECONDS)、毫秒(TimeUnit.MILLISECONDS)等。
- 任务队列(workQueue):用于保存等待任务执行的阻塞队列(接口类型,为BlockingQueue<Runnable>),常见实现包括:
- LinkedBlockingQueue:基于链表的无界队列(默认容量为Integer.MAX_VALUE),可能导致内存溢出。
- ArrayBlockingQueue:基于数组的有界队列,需指定固定容量。
- SynchronousQueue:不存储元素的队列,每个插入操作必须等待另一个线程的移除操作。
- 线程工厂(threadFactory): 用于创还能新线程的工厂类,可以自定义线程名称、优先级、守护线程状态等属性。默认使用 Executors.defaultThreadFactory()。
- 拒绝策略(RejectedExecutionHandler):当任务队列已满且线程数达到最大值的时候,针对新提交的任务的拒绝策略,常见策略包括:
- AbortPolicy(默认):抛出
RejectedExecutionException异常。 - CallerRunsPolicy:由提交任务的线程直接执行该任务。
- DiscardPolicy:静默丢弃任务,不抛异常。
- DiscardOldestPolicy:丢弃队列中最旧的任务,然后尝试重新提交当前任务。
- AbortPolicy(默认):抛出
3.3.3 任务入池策略
由上述的参数说明,我们可以得出当任务不断进入线程池的核心调度逻辑,当调用execute(Runnable command)提交一个新任务时,ThreadPoolExecutor 会按照以下顺序判断,并执行不同的策略
- 当前线程数 < 核心线程数:会立即创建一个新线程(即使仍然有空闲线程)来执行该任务(这是预热阶段,优先保证核心线程被创建)
- 当前线程数 >= 核心线程数 且 阻塞队列未满:任务入队等待
- 当前线程数 < 最大线程数 且 阻塞队列已满:创建新线程(非核心)执行任务
- 线程数 >= 最大线程数 且 阻塞队列已满:执行拒绝策略
注意事项:
- 上述策略适用于有界队列,而无界队列(例如LinkedBlockingQueue无参构造,默认容量Integer.MAX_VALUE)新任务会一直入队,可能会导致OOM
- 合理设置core / max / queue size的三者关系
- 明确拒绝策略的业务含义(如记录日志、降级处理等)
3.3 Executors工具类
3.3.1 Executors简介
1. 什么是Executors
Executors是Java并发编程中用于管理线程池的核心工具类,属于java.util.concurrent包。它提供了一种简化多线程任务执行的机制,避免开发者直接操作线程的创建和销毁,提升资源利用率与性能。
2. 核心功能
- 线程池管理:通过预创建或动态调整线程数量,减少频繁创建/销毁线程的开销。
- 任务调度:支持立即执行、延迟执行或定期执行任务。
- 资源控制:限制并发线程数,防止系统过载。
3.3.2 常见线程池类型
Executors提供多种创建简化线程池的方法,其常见线程池有以下几种类型
- FixedThreadPool:固定大小的线程池,适用于负载稳定的场景。
- CachedThreadPool:动态调整线程数量,适合短时异步任务。
- SingleThreadExecutor:单线程池,保证任务顺序执行。
- ScheduledThreadPool:支持定时或周期性任务调度。
1. FixedThreadPool
- 线程数固定为n:其固定大小的特性,意味着corePoolSize == maximumPoolSize = n
- 使用无界队列(LinkedBlockingQueue,默认容量Integer.MAX_VALUE)来接受任务,可能会有OOM的风险
- 适用场景:负载稳定,且任务执行时间可控,吞吐量可预测的场景
使用示例
import java.util.concurrent.*;

public class FixedThreadPoolExample {
    public static void main(String[] args) throws InterruptedException {
        // 创建一个固定大小的线程池,参数2表示线程池中有2个工作线程
        // 这些线程会被重复利用来执行多个任务
        ExecutorService executor = Executors.newFixedThreadPool(2); // 固定2个线程

        // 循环创建5个任务并提交给线程池执行
        for (int i = 1; i <= 5; i++) {
            // 将循环变量i赋值给taskId,因为lambda表达式中只能使用有效的final变量
            final int taskId = i;
            // 提交任务到线程池,任务是一个lambda表达式实现的Runnable
            executor.submit(() -> {
                // 打印当前任务编号和正在执行它的线程名称
                System.out.println("FixedThreadPool - Task " + taskId +
                    " running on thread: " + Thread.currentThread().getName());
                try {
                    // 模拟任务执行,休眠1000毫秒,代表实际的工作负载
                    Thread.sleep(1000); // 模拟耗时操作
                } catch (InterruptedException e) {
                    // 如果线程被中断,则恢复中断状态
                    Thread.currentThread().interrupt();
                }
                // 任务完成时打印完成信息
                System.out.println("FixedThreadPool - Task " + taskId + " finished.");
            });
        }

        // 关闭线程池,不再接受新任务,但会继续执行已提交的任务
        executor.shutdown();
        // 等待最多10秒,直到所有任务完成执行
        executor.awaitTermination(10, TimeUnit.SECONDS);
        // 所有任务完成后打印示例结束信息
        System.out.println("FixedThreadPool example done.");
    }
}
2. CachedThreadPool
- 动态伸缩:意味着线程数会根据任务数动态调整,意味着corePooSize = 0,maximumPoolSize == Integer.MAX_VALUE
- 使用队列:直接使用SynchronousQueue(不存储元素的阻塞队列)
- 注意事项:
- 在这种线程池中,没有核心线程的概念,因为corePoolSize == 0,
- 所有线程都是临时线程
- 只要有空闲线程,新任务就会复用它
- 如果没有空闲线程,就会新建一个
- 空闲超过60s的线程会自动销毁
- 适用场景:大量短生命周期的异步任务(比如web处理请求)。
- 风险:如果任务运行时间长或者任务提交过快,可能会创建海量线程,导致系统资源耗尽。
使用示例
import java.util.concurrent.*;

public class CachedThreadPoolExample {
    public static void main(String[] args) throws InterruptedException {
        // 创建一个缓存线程池,它会根据需要创建新线程来处理提交的任务,
        // 并在适当的时候重用以前构造的线程。
        ExecutorService executor = Executors.newCachedThreadPool();

        // 循环创建5个任务并提交给线程池执行
        for (int i = 1; i <= 5; i++) {
            // 将循环变量i赋值给taskId,因为lambda表达式中只能使用有效的final变量
            final int taskId = i;
            // 提交任务到线程池,任务是一个lambda表达式实现的Runnable
            executor.submit(() -> {
                // 打印当前任务编号和正在执行它的线程名称
                System.out.println("CachedThreadPool - Task " + taskId +
                    " running on thread: " + Thread.currentThread().getName());
                try {
                    // 模拟任务执行,休眠200毫秒
                    Thread.sleep(200); // 短任务
                } catch (InterruptedException e) {
                    // 如果线程被中断,则恢复中断状态
                    Thread.currentThread().interrupt();
                }
                // 任务完成时打印完成信息
                System.out.println("CachedThreadPool - Task " + taskId + " finished.");
            });
        }

        // 关闭线程池,不再接受新任务,但会继续执行已提交的任务
        executor.shutdown();
        // 等待最多5秒,直到所有任务完成执行
        executor.awaitTermination(5, TimeUnit.SECONDS);
        // 所有任务完成后打印示例结束信息
        System.out.println("CachedThreadPool example done.");
    }
}
3. SingleThreadExecutor
- 固定单线程:内部是一个corePoolSize == maximumPoolSize = 1的ThreadPoolExecutor
- 使用队列:无界队列(LinkedBlockingQueue),保证任务按照顺序执行
- 异常处理:即使该线程异常终止,线程池会自动创建一个新线程替代它,保证“单线程”语义
- 适用场景:需要串行化执行、保证任务顺序、避免并发的场景(如日志写入、状态机更新)。
使用示例
import java.util.concurrent.*;

public class SingleThreadExecutorExample {

    public static void main(String[] args) throws InterruptedException {
        // 创建单线程执行器,它返回一个只有一个工作线程的ExecutorService
        // 这个线程池确保所有任务按照提交顺序依次执行
        // 线程名称通常为 "pool-X-thread-1" 格式
        ExecutorService executor = Executors.newSingleThreadExecutor();

        // 循环创建5个任务并提交给单线程执行器
        for (int i = 1; i <= 5; i++) {
            // 将循环变量i赋值给taskId,因为lambda表达式中只能使用有效的final变量
            // 或者在lambda中引用的局部变量必须是final或有效的final
            final int taskId = i;

            // 提交任务到单线程执行器,任务是一个lambda表达式实现的Runnable
            // 所有任务将在同一个线程中按顺序执行
            executor.submit(() -> {
                // 打印当前任务编号和正在执行它的线程名称
                // 由于是单线程执行器,所有任务都会显示相同的线程名称
                System.out.println("SingleThread - Task " + taskId +
                    " running on thread: " + Thread.currentThread().getName());

                try {
                    // 模拟任务执行,休眠500毫秒,代表实际的工作负载
                    // 这期间该线程被占用,无法执行其他任务
                    Thread.sleep(500);
                } catch (InterruptedException e) {
                    // 如果线程被中断,则恢复中断状态
                    // 这是处理InterruptedException的标准做法
                    Thread.currentThread().interrupt();
                }

                // 任务完成时打印完成信息
                // 由于串行执行,我们可以预期这些消息按顺序出现
                System.out.println("SingleThread - Task " + taskId + " finished.");
            });
        }

        // 关闭线程池,不再接受新任务,但会继续执行已提交的任务
        // 对于单线程执行器,这是安全的操作
        // shutdown()方法是非阻塞的,它只会将线程池状态改为SHUTDOWN
        executor.shutdown();

        // 等待最多10秒,直到所有任务完成执行
        // 这个方法会阻塞当前线程,直到所有任务完成或超时
        // 返回true表示所有任务都已完成,false表示超时仍有任务未完成
        executor.awaitTermination(10, TimeUnit.SECONDS);

        // 所有任务完成后打印示例结束信息
        // 在实际应用中,这里可以进行一些清理工作
        System.out.println("SingleThreadExecutor example done.");
    }
}
4. ScheduledThreadPool
- 基于
DelayedWorkQueue(内部优先级队列) - 支持:
schedule(Runnable, delay, unit):延迟执行一次scheduleAtFixedRate(...):固定频率执行(不管上次是否完成)scheduleWithFixedDelay(...):固定延迟执行(等上次完成后再等 delay)
- 多线程支持(
n > 1时可并行执行多个定时任务) - 异常不会导致整个调度器崩溃(而
Timer会) - 注意:即使
n=1,也不是单线程执行所有任务——它只是限制同时执行的任务数 ≤ 1,但调度逻辑本身是线程安全的。
使用示例
import java.util.concurrent.*;

public class ScheduledThreadPoolExample {
    public static void main(String[] args) throws InterruptedException {
        ScheduledExecutorService scheduler = Executors.newScheduledThreadPool(2);

        // 延迟2秒后执行一次
        scheduler.schedule(() -> {
            System.out.println("Scheduled once - runs after 2s on " + Thread.currentThread().getName());
        }, 2, TimeUnit.SECONDS);

        // 每隔1秒执行一次(固定频率,不管上次是否完成)
        ScheduledFuture<?> periodic = scheduler.scheduleAtFixedRate(() -> {
            System.out.println("Periodic task - " + System.currentTimeMillis() / 1000 % 60 + "s");
            try {
                Thread.sleep(300); // 模拟工作
            } catch (InterruptedException e) {
                Thread.currentThread().interrupt();
            }
        }, 0, 1, TimeUnit.SECONDS);

        // 运行5秒后取消周期任务
        scheduler.schedule(() -> {
            periodic.cancel(false);
            System.out.println("Periodic task cancelled.");
        }, 5, TimeUnit.SECONDS);

        // 主线程等待
        Thread.sleep(6000);
        scheduler.shutdownNow();
        System.out.println("ScheduledThreadPool example done.");
    }
}
线程池特性对比:
| 线程池类型 | 核心线程数 | 最大线程数 | 队列类型 | 是否扩容 | 是否回收线程 | 适用场景 |
|---|---|---|---|---|---|---|
FixedThreadPool | n | n | 无界队列 | ❌ | ❌(默认) | 稳定负载 |
CachedThreadPool | 0 | ∞ | SynchronousQueue | ✅ | ✅(60s空闲) | 短时异步任务 |
SingleThreadExecutor | 1 | 1 | 无界队列 | ❌ | ❌ | 串行任务 |
ScheduledThreadPool | n | ∞ | 延迟队列 | ✅(按需) | ✅(空闲超时) | 定时/周期任务 |
3.3.3 优势与注意事项
- 优势:降低线程生命周期开销,提供任务队列和拒绝策略等管理功能。提供简化创建线程池的方式
- 注意事项
- 需显式关闭线程池(
shutdown()),避免资源泄漏;根据场景选择合适线程池类型。推荐放在 final{} 代码块中执行,当执行shutdown方法后,并不会立刻关闭线程池,而是先等待执行完任务后再关闭,可以通过isTerminated()方法判断是否真正关闭 - 生产环境慎用
Executors.xxx工厂方法。因为它们隐藏了关键参数(如无界队列、无限线程),容易引发 OOM 或资源耗尽。 - 推荐手动创建
ThreadPoolExecutor,显式控制。
- 需显式关闭线程池(
- shutdown()与shutdownNow()方法的区别:shutdown()方法会等待所有已提交的任务执行完后才关闭线程池。而shutdownNow()会等待现在正在执行的任务执行完后直接关闭。
3.4 execute()和sumbit()
3.4.1 execute和sumbit的区别
| 方法 | 所属接口 | 签名 |
|---|---|---|
execute(Runnable command) | Executor(父接口) | void execute(Runnable) |
submit(...) | ExecutorService(子接口) | 多个重载: • Future<?> submit(Runnable task)• <T> Future<T> submit(Callable<T> task)• <T> Future<T> submit(Runnable task, T result) |
| 特性 | execute() | submit() |
|---|---|---|
| 返回值 | ❌ 无返回值(void) | ✅ 返回 Future<?> 对象 |
| 任务类型 | 只接受 Runnable | 接受 Runnable 或 Callable |
| 获取结果 | ❌ 无法获取任务执行结果 | ✅ 可通过 Future.get() 获取结果或异常 |
| 异常处理 | 异常被“吞掉”(除非自定义 ThreadFactory 捕获) | 异常会封装在 ExecutionException 中,调用 Future.get() 时抛出 |
| 适用场景 | 只关心“执行”,不关心结果或异常 | 需要结果、状态、取消任务或处理异常 |
3.4.2 代码示例对比
1. 使用 execute() —— 无返回、异常静默
ExecutorService executor = Executors.newFixedThreadPool(1);

executor.execute(() -> {
    System.out.println("Task started");
    throw new RuntimeException("Oops in execute!");
});

executor.shutdown();
// 输出:Task started
// 异常被记录到 UncaughtExceptionHandler(默认可能只打印到 stderr),但主线程无法感知
⚠️ 你无法知道任务是否失败,除非设置全局异常处理器。
2. 使用submit() + Runnable—— 可捕获异常
ExecutorService executor = Executors.newFixedThreadPool(1);

Future<?> future = executor.submit(() -> {
    System.out.println("Task started");
    throw new RuntimeException("Oops in submit!");
});

try {
    future.get(); // 会抛出 ExecutionException,包裹原始异常
} catch (ExecutionException e) {
    System.out.println("Caught exception: " + e.getCause().getMessage());
} catch (InterruptedException e) {
    Thread.currentThread().interrupt();
}

executor.shutdown();
// 输出:
// Task started
// Caught exception: Oops in submit!
✅ 主线程能明确知道任务失败,并处理异常。
3. 使用 submit() + Callable —— 获取返回值
ExecutorService executor = Executors.newFixedThreadPool(1);

Future<Integer> future = executor.submit(() -> {
    System.out.println("Computing...");
    return 42;
});

try {
    Integer result = future.get();
    System.out.println("Result: " + result); // Result: 42
} catch (Exception e) {
    e.printStackTrace();
}

executor.shutdown();
🔸
Callable支持返回值和抛出受检异常,Runnable不行。
4. 异常处理机制差异
| 方法 | 异常去哪了? |
|---|---|
execute() | 交给线程的 UncaughtExceptionHandler(默认行为:打印到 System.err,但调用方无法捕获) |
submit() | 异常被封装进 Future调用 future.get() 时以 ExecutionException 形式抛出 |
5. 如何选择?
| 场景 | 推荐方法 |
|---|---|
| 只需“触发”一个操作,不关心结果(如发通知、写日志) | execute() |
| 需要获取结果、判断是否完成、取消任务、处理异常 | submit() |
| 任务可能失败,且失败需要被主流程感知 | 必须用 submit() |
使用 Callable | 只能用 submit() |
6. 补充:submit(Runnable, T result) 的妙用
Future<String> future = executor.submit(() -> {
    // do something
}, "success"); // 无论 Runnable 做什么,get() 都返回 "success"

String result = future.get(); // "success"
可用于:标记任务成功/失败状态,或传递上下文。
在绝大多数需要可靠性的场景中,优先使用 submit(),哪怕你暂时不需要返回值——因为未来你可能需要处理异常或取消任务。
3.5 深入源码
3.5.1 JDK和Tomcat线程池区别
- 区别:Tomcat本质上是JDK源码的拷贝+微调版本,二者几乎无异。
- 构造方法:JDK不会在构造方法中创建线程,而Tomcat会在构造方法的最后额外调用prestartAllCoreThreads() 方法,提前启动所有核心线程。(这个方法就在JDK源码中有提供,Tomcat线程池则是额外调用)
3.5.2 线程池如何保活线程
正常来说,一个线程通过.start()方法来开启,但是并没有显式的关闭方法,当代码运行结束后,该线程会自行消失。那么在线程池中,是如何保证线程执行完,不立刻消失的?
核心在于阻塞队列,通过调用BlockingQueue.poll()方法,当前线程就会阻塞,直到当前线程拿到任务后继续执行。从而实现了线程的重复利用。伪代码如下
// 创建新县城
new Thread(new Runnable() {
    @Override
    public void run() {
        // 从传入的参数中获取到要首先执行的任务
        Runnable task = this.firstTask;
        // 优先执行第一个任务
        task.run();
        // 从阻塞队列中获取任务,通过poll()方法会阻塞等待。直到拿到新任务
        while ((task = blockingQueue.poll()) != null) {
            task.run();
        }
    }
});
因此,当线程池中的线程处于空闲状态时候,其本质上是在阻塞等待获取新任务,而当线程数小于核心线程数时,会优先创建新线程执行当前任务。反之则会尝试入队,并被空闲中的线程获取到。
3.5.3 线程池的任务执行顺序是否公平?
线程池的任务执行,会分别经过:核心线程创建 ——> 任务入队 ——> 临时线程创建 ——> 任务拒绝的流程,而临时线程创建并运行任务,其运行的顺序会优先于在阻塞队列中的任务。因此线程池的任务执行顺序本质是不公平的。
3.5.4 线程淘汰策略
在线程池中,当线程数超过核心线程数时候,需要额外淘汰多余线程。但是每个线程创建并执行完第一个任务后,都会尝试去阻塞队列中获取任务进行保活,如何精准控制淘汰线程?
关键在于如何控制多余的线程及时执行完代码,每个线程执行完第一个任务后,会从 getTask()方法中获取任务,在这个方法中,我们可以精准控制是返回 null 还是阻塞等待返回任务,从而让多余的线程结束while循环,从而让其消失。
而getTask的大致流程是:
1. 首次进入,会先阻塞等待keepAliveTime
2. 如果获取不到任务,则会进入第二轮循环
3. 在这一轮循环中,第一轮超时时间已过,且线程数大于核心线程数,此时会尝试进行竞争(假设多个线程同时执行),成功的线程会直接返回空,从而直接结束当前的while循环
4. 而其他竞争失败的线程则会开始新一轮循环。直到线程数等于核心线程数。
5. 随后会进行无限阻塞等待获取任务。
所以在淘汰线程中,并没有核心线程与临时线程的区分,竞争淘汰,只有留下来的才是核心线程。
3.5.5 线程池异常处理策略
线程池中的线程执行任务时,当遇到异常后,其会导致while循环的异常退出(因为后续代码直接中断,但是依旧会执行finally代码块,借助这个差异来决定后续逻辑)
当异常退出后,会新增一个线程,同时当前的线程销毁掉。
提问:为什么不直接重新进行新一轮循环,反而直接抛出异常,销毁当前线程并新建线程?
因为如果直接继续,就会导致setUncaughtExceptionHandler机制失效,这个机制的使用示例如下
ThreadFactory threadFactory = new ThreadFactory() {
            @Override
            public Thread newThread(Runnable r) {
                Thread t = new Thread(r);
                t.setUncaughtExceptionHandler(new Thread.UncaughtExceptionHandler() {
                    @Override
                    public void uncaughtException(Thread arg0, Throwable arg1) {
                        System.out.println("uncaughtException: " + arg1.getMessage());
                    }

                });
                return t;
            }
        };
将该ThreadFactory作为参数传入自定义线程池,即可实现线程的异常捕获处理。所以异常必须抛出,才能触发这一个机制。因此JDK选择保留这个机制,让线程异常退出后重新创建一个新的线程。
3.5.6 线程池如何shutdown?
1. 当调用shutdown()以及shutdownNow()的方法后,线程池的状态会被修改为STOP
2. 而线程通过getWork()获取任务的时候,会检查线程池状态,如果是shutdown()则会同时检查workQueue是否为空,如果是shutdownNow()则不会检查
3. 如果都满足,那么会直接返回null,从而跳出while循环,线程结束并销毁。
提问:这个机制针对的是尝试获取任务,并且还没有到阻塞等待新任务的状态的线程。那么针对阻塞等待的线程,如何让其退出销毁?
通过interrupted()中断方法,当调用到中断方法后,阻塞(睡眠)状态中的线程会抛出异常,通过抛出的异常,可以让这些线程进入新一轮循环。从而获取到空任务。结束并销毁。
4. 线程安全
4.1 线程安全简介
1. 什么是线程安全?
线程安全就是当多线程同时针对一个资源进行写操作的时候,会出现数据混乱的线程不安全现象。
2. 出现线程安全的三要素?
- 多个线程
- 操作同一资源
- 写操作
4.2 原子性
1. 要解决线程安全问题,核心之一就是实现核心写操作的“原子性”,即保证对应的操作是单一不可分割的一部分。同一时间只能有单个线程进行这个流程。
2. 在日常使用中,有很多看似是原子性的操作,实际上并不具备原子性,示例如下
i = 0; // 是原子性

i = j; // 不是原子性,需要先获取到j的值,再赋值给i

i++; // 不是原子性,需要先拿到i的值,再i + 1,再赋值给i

i = j + 1; // 不是原子性,需要先拿到j的值,再j + 1,再赋值给i
3. 而在宏观上,如何保证一段复杂的操作也实现线程安全?通过加锁,让同一时间内,只有单个线程执行这个操作,从而达到线程安全的目的。
示例代码:
/**
 * 线程安全的售票程序演示类
 * 使用同步方法实现多线程环境下的票务管理
 */
public class LockMain {

    /**
     * 静态内部类,实现Runnable接口用于多线程售票
     * 使用静态内部类是因为需要在静态方法(main)中直接实例化
     */
    static class MyRunnable implements Runnable {
        // 共享资源:票数,使用static保证所有线程共享同一份数据
        static int stock = 100;

        /**
         * 重写run方法,定义线程执行的具体逻辑
         * 使用synchronized关键字保证方法的原子性,防止多线程并发问题
         */
        @Override
        public synchronized void run() {
            // 判断是否有余票
            if (stock > 0) {
                // 打印当前线程名称及正在卖出的票号
                System.out.println(Thread.currentThread().getName() + "正在卖第" + stock + "张票");
                // 卖出一张票,票数减一
                stock--;
            }
        }
    }

    /**
     * 主方法,程序入口
     * 创建多个线程模拟售票过程
     */
    public static void main(String[] args) throws Exception {
        // 创建Runnable任务实例
        MyRunnable myRunnable = new MyRunnable();

        // 创建线程池,用于执行任务
        ExecutorService defaulExecutors = MyThreadPool.createDefaulExecutors();

        // 循环提交任务到线程池执行,模拟多线程售票场景
        for (int i = 0; i < 100; i++) {
            // 每次提交任务前暂停20毫秒,模拟任务到达的时间间隔
            Thread.sleep(20);
            // 将任务提交给线程池执行
            defaulExecutors.execute(myRunnable);
        }
    }
}
4.3 可见性
在并发编程中,线程安全不仅依赖于原子性(Atomicity),还依赖于可见性(Visibility)。
1. 什么是可见性
可见性指的是:当一个线程修改了共享变量的值,其他变量可以立刻看到修改后的最新值
2. 没有可见性,会有什么问题?
在多线程环境中,由于每个线程可能有自己的工作内存(如 CPU 缓存),它们并不总是直接从主内存读写数据。因此,一个线程对共享变量的修改,可能暂时只存在于它自己的缓存中,而没有及时刷新到主内存,导致其他线程读取到的是旧值,从而引发错误。
3. 可见性示例
举一个例子:
boolean flag = false;

// 线程A
new Thread(() -> {
    while (!flag) {
        // 等待 flag 变为 true
    }
    System.out.println("退出循环");
}).start();

// 主线程稍后设置 flag = true;
Thread.sleep(1000);
flag = true;
如果 flag 没有被声明为 volatile,那么线程A可能永远看不到主线程对 flag 的修改,因为它一直在读自己缓存中的 false 值,导致死循环。
解决方案:
- volatile 关键字(Java):确保变量的每次读写都直接访问主内存,且写操作对其他线程立即可见。
- synchronized 块/方法:进入和退出同步块时,会强制刷新和同步工作内存与主内存的数据。
- Lock 接口(如 ReentrantLock):加锁和释放锁时也会建立 happens-before 关系,保证可见性。
4.4 有序性
有序性(Ordering) 是并发编程中的第三个核心概念,与原子性和可见性并列,共同构成线程安全的基础。
1. 什么是有序性?
有序性指的是:程序代码在执行时,其指令的执行顺序是否与程序员编写的源代码顺序一致。
2. 没有有序性,会出现什么问题?
在单线程环境下,我们通常认为代码是“按顺序”执行的。但在多线程或现代处理器/编译器优化下,实际执行顺序可能被重排(reordering),只要这种重排不影响当前线程的执行结果(即保持“as-if-serial”语义)。然而,在多线程环境中,这种重排可能导致其他线程观察到违反直觉的执行顺序,从而引发错误。
3. 举个例子
// 线程1
a = 1;           // (1)
flag = true;     // (2)

// 线程2
if (flag) {      // (3)
    System.out.println(a); // (4)
}
正常情况下,我们期望如果flag == true,那么输出的a就一定是1,但是通过指令重排,flag = true可能会先发生在a = 1之前,而此时再输出a,就看是0(初始值)。输出结果错误。
解决方案:
- volatile 关键字(Java):volatile 写之前的所有操作,不能重排到它之后;它之后的操作也不能重排到它之前。(类似一道屏障,分割前后两部分)。
// 线程1
a = 1;           // (1)
volatile flag = true;     // (2)

// 线程2
if (flag) {      // (3)
    System.out.println(a); // (4)
}
- 使用 synchronized 同步块:通过加锁,两个线程强制变为串行执行,在单线程情况下,遵循as-if-serial原则即可保证有序性。
4.5 其他保证线程安全的方式
- 共享变量只读:如果允许,则通过final修饰变量
- 局部变量:如果允许,将共享变量修改为局部变量,每个线程的局部变量存储在栈帧中。各线程创建多份,可以避免线程安全问题
- ThreadLocal:线程本地变量,如果创建了一份ThreadLocal变量,那么访问这个变量的每个线程都会有这个变量的一份本地拷贝。多线程操作这个变量实际上是操作自己本地内存中的拷贝变量。从而实现线程隔离的作用。避免了线程安全问题。
4.6 JMM内存模型
4.6.1 JMM简介
1. 什么是JMM?
JMM(Java Memory Model,Java内存模型) 是 Java 语言规范中定义的一套规则,用于描述多线程程序中各个线程如何访问共享变量,以及在什么情况下一个线程对变量的修改对其他线程可见。
2. JMM的核心目标:让 Java 程序在不同硬件和操作系统上,多线程行为保持一致。
3. JMM是如何运作的?
JMM将内存分为两类
- 主内存(Main Memory):所有线程共享,存储所有的共享变量(如实例字段、静态变量)。
- 工作内存(Working Memory):每个线程私有(可理解为 CPU 缓存或寄存器),保存了它用到的主内存变量的副本。
线程不能直接读写主内存,所有操作都必须在自己的工作内存中进行。
变量读写流程(8 大原子操作):当线程要读/写一个共享变量时,JMM 规定了以下步骤(以写为例):
线程A:
  assign → store → write   // 修改本地副本 → 传给主内存 → 主内存更新

线程B:
  read → load → use        // 从主内存读 → 加载到本地副本 → 使用
这 8 个底层操作(read, load, use, assign, store, write, lock, unlock)是原子的,构成了线程与主内存交互的基础。
4. JMM架构图:
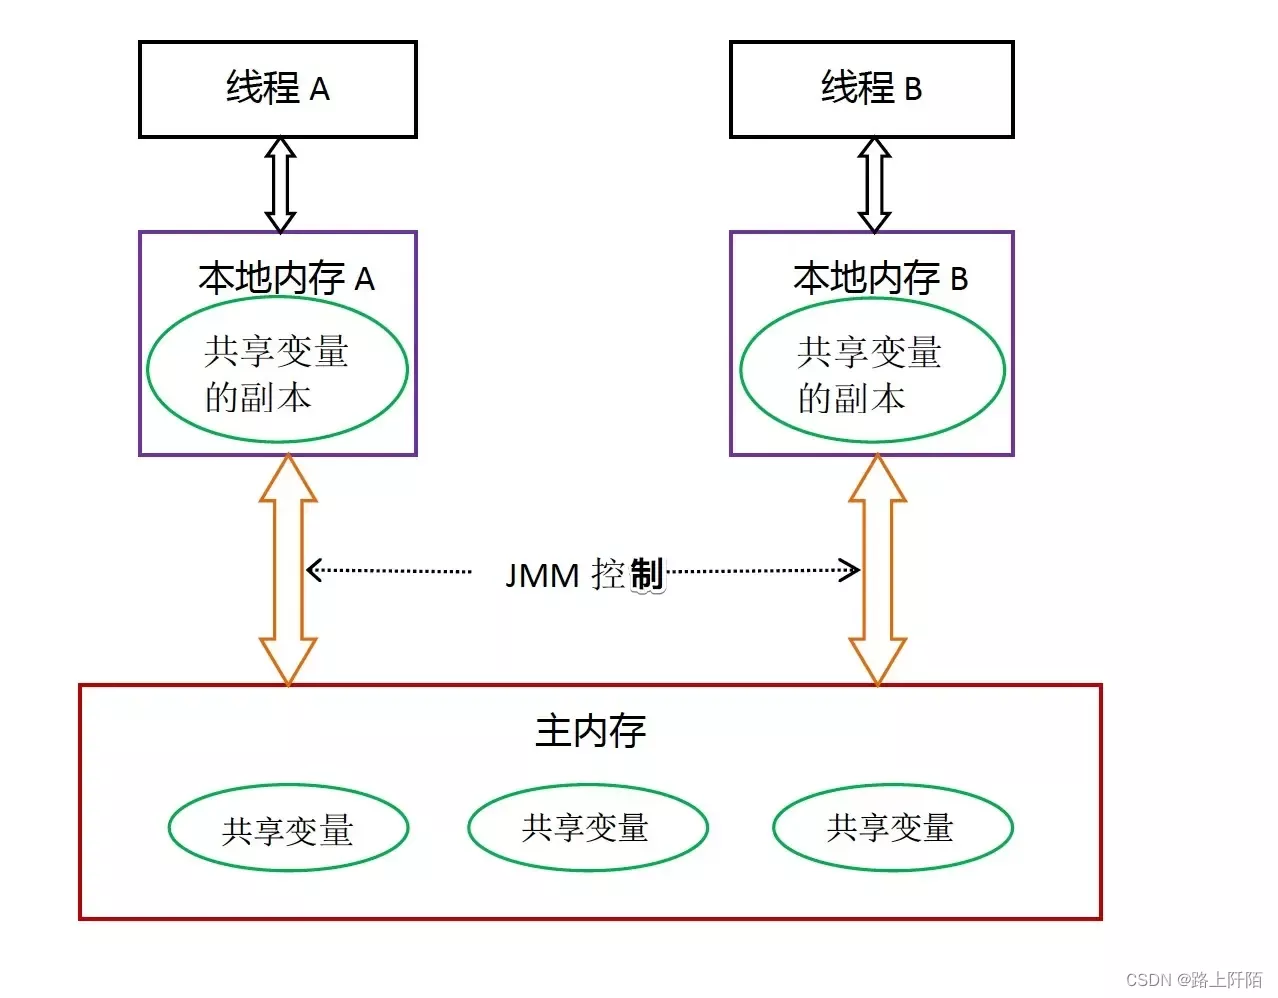
4.6.2 JMM与可见性的关系
JMM 的核心目标之一,就是定义并解决多线程环境下的可见性问题。
1. 为什么会出现可见性问题?
在多线程程序中,一个线程修改了共享变量的值,其他线程可能看不到这个修改,因为:
- 每个线程有自己的工作内存(如 CPU 缓存);
- 修改可能只停留在本地缓存,未及时同步到主内存;
- 其他线程读取时,仍从自己的缓存中拿到旧值。
这就会导致数据不一致
2. JMM如何解决可见性问题?
JMM 通过以下机制明确定义在什么条件下,一个线程对变量的修改必须对其他线程可见:
- 所有共享变量存在主内存;
- 线程操作变量时,先从主内存load到工作内存,修改后再store/write回主内存;
- JMM 规定了这些操作的同步时机
并且只要满足以下规则,就保证可见性
- volatile 变量规则:对 volatile 变量的写 happens-before 后续对该变量的读 → 读线程一定看到最新值。
- 锁规则:释放锁(unlock)happens-before 后续获取同一把锁(lock)→ 锁保护的变量修改对下一个持有者可见。
- 线程启动/终止规则:主线程启动子线程前的操作,对子线程可见。
3. JMM如何保证缓存一致性?
JMM通过缓存一致性协议(MESI)来保证缓存一致性
- 线程会通过 read (从主内存读取数据) 、load(加载到本地副本),将数据加载到线程内存中,并通过use(cpu读取变量使用)使用该变量
- 当有一个线程修改该变量(assign)后,会立刻store(将本地副本加载到主内存中)并且wriite(修改主内存中该变量的值)
- 随后会通过总线机制,推送到所有持有该变量副本的线程中。其他的线程会直接使该变量失效,并从主内存中重新加载数据,从而实现了缓存一致性。
4.7 原子类
4.7.1 原子类简介
1. 什么是原子类?
原子类是 Java 中位于 java.util.concurrent.atomic 包下的一组类(如 AtomicInteger、AtomicLong、AtomicReference 等),它们利用 CAS(Compare-And-Swap) 机制,在多线程环境下能无锁地实现对变量的原子操作(如自增、赋值、比较并设置等),从而避免使用 synchronized,提高并发性能。
2.相比较于synchronized,原子类有什么优势?
- 粒度更细:原子变量可以把竞争范围缩小到变量级别,这是我们可以获得的最细的粒度情况,通常锁的粒度要大于原子变量的粒度。
- 效率更高:通常,使用原子类的效率会比使用锁的效率更高。除了高度竞争的情况。
3. 常用原子类总结
| 类别 | 原子类 | 用途说明 |
|---|---|---|
| 基本类型 | AtomicBoolean | 原子操作的布尔值 |
AtomicInteger | 原子操作的 int 类型(如自增、CAS) | |
AtomicLong | 原子操作的 long 类型 | |
| 引用类型 | AtomicReference<V> | 原子操作的对象引用 |
AtomicMarkableReference<V> | 带一个 boolean 标记位的引用(用于解决 ABA 问题) | |
AtomicStampedReference<V> | 带一个 int “戳”(stamp)的引用(更可靠地解决 ABA 问题) | |
| 数组类型 | AtomicIntegerArray | 数组中每个 int 元素支持原子操作 |
AtomicLongArray | 数组中每个 long 元素支持原子操作 | |
AtomicReferenceArray<E> | 数组中每个对象引用支持原子操作 | |
| 字段更新器 (基于反射) | AtomicIntegerFieldUpdater<T> | 对任意对象的 volatile int 字段进行原子更新 |
AtomicLongFieldUpdater<T> | 对任意对象的 volatile long 字段进行原子更新 | |
AtomicReferenceFieldUpdater<T, V> | 对任意对象的 volatile V 引用字段进行原子更新 | |
| 高性能累加器 (JDK 8+) | LongAdder / DoubleAdder | 高并发下的高效累加(如计数器),比 AtomicLong 吞吐更高 |
LongAccumulator / DoubleAccumulator | 支持自定义累积函数(如 max、min、sum 等) |
4. 简单使用示例
public class AtomicMain {

    /**
     * 实现Runnable接口的内部类,用于模拟抢购场景
     * 使用原子类AtomicInteger来处理并发环境下的库存扣减
     */
    static class MyRunnable implements Runnable {

        // 定义初始库存为100的原子整数变量,确保多线程环境下的原子性操作
        public static AtomicInteger stock = new AtomicInteger(100);

        @Override
        public void run() {
            // 判断当前库存是否大于0,决定是否可以继续抢购
            if (stock.get() > 0) {
                // 执行库存扣减操作,使用decrementAndGet()确保扣减操作的原子性
                int i = stock.decrementAndGet();
                // 输出当前线程名称及抢购结果,以及剩余库存数量
                System.out.println(Thread.currentThread().getName() + " 抢购成功,剩余:" + i);
            } else {
                // 库存不足时输出抢购失败信息
                System.out.println(Thread.currentThread().getName() + " 抢购失败");
            }
        }
    }


    /**
     * 主方法,启动多线程环境进行抢购测试
     * 创建固定大小的线程池,并提交多个抢购任务到线程池中执行
     */
    public static void main(String[] args) {
        // 创建一个拥有40个线程的固定大小线程池
        ExecutorService newFixedThreadPool = Executors.newFixedThreadPool(40);

        // 提交200个抢购任务到线程池中,模拟高并发抢购场景
        for (int i = 0; i < 200; i++) {
            newFixedThreadPool.execute(new MyRunnable());
        }
    }

}
4.7.2 原子类常用方法速查
| 原子类 | 常用方法 | 功能说明 |
|---|---|---|
AtomicInteger(同理适用于 AtomicLong) | get() | 获取当前值 |
set(int newValue) | 直接设置新值(无原子保障以外的同步) | |
getAndSet(int newValue) | 先返回旧值,再设为新值(原子) | |
compareAndSet(int expect, int update)(CAS) | 若当前值 == expect,则设为 update;返回是否成功 | |
incrementAndGet() | 自增 1 并返回新值(++i) | |
getAndIncrement() | 返回当前值,再自增 1(i++) | |
addAndGet(int delta) | 加 delta 并返回新值 | |
getAndAdd(int delta) | 返回当前值,再加 delta | |
AtomicBoolean | get() / set(boolean) | 获取/设置布尔值 |
getAndSet(boolean) | 原子地设新值并返回旧值 | |
compareAndSet(boolean expect, boolean update) | CAS 操作 | |
AtomicReference<V> | get() / set(V) | 获取/设置引用 |
getAndSet(V) | 原子设新引用,返回旧引用 | |
compareAndSet(V expect, V update) | 引用级别的 CAS(比较引用是否相等) | |
AtomicIntegerFieldUpdater<T>(其他 FieldUpdater 类似) | get(T obj) | 获取 obj 的目标字段值 |
set(T obj, int newValue) | 设置 obj 的目标字段值 | |
compareAndSet(T obj, int expect, int update) | 对 obj 的字段执行 CAS | |
> ⚠️ 要求字段是 volatile int,且非 static | ||
LongAdder(高并发计数推荐) | add(long x) | 累加 x |
increment() | 自增 1(等价于 add(1)) | |
sum() | 获取当前总和(注意:非原子快照,但最终一致) | |
reset() | 重置为 0 | |
| > 💡 适用于写多读少的高并发计数场景 | ||
LongAccumulator | accumulate(long x) | 按构造时指定的函数(如 Long::max)累积 x |
get() | 获取当前累积结果 | |
> 示例:new LongAccumulator(Long::max, 0L) | 实现原子取最大值 |
5. 锁
5.1 乐观锁与悲观锁
简介
乐观锁和悲观锁是并发编程中两种对数据并发访问的控制策略,核心区别在于对“冲突是否经常发生”的假设不同。
1. 悲观锁
- 思想:
“总是假设最坏情况——只要不去加锁,就一定会发生冲突。”
所以在访问数据前,先加锁,确保独占资源。 - 实现方式:
- Java 中:
synchronized、ReentrantLock等。 - 数据库中:
SELECT ... FOR UPDATE。
- Java 中:
- 特点:
- ✅ 保证绝对安全,不会出现并发问题。
- ❌ 性能开销大(线程阻塞、上下文切换)。
- 适合写操作多、竞争激烈的场景。
📌 “先上锁,再操作” —— 宁可错杀,不可放过。
2. 乐观锁
- 思想:
“假设一般不会冲突,所以不加锁;只在提交更新时检查是否被别人改过。”
如果发现冲突,则重试或失败。 - 实现方式:
- Java 中:
AtomicInteger等原子类(基于 CAS:Compare-And-Swap)。 - 数据库中:通过版本号(version) 或 时间戳 字段实现。
例如:UPDATE table SET value=..., version=version+1 WHERE id=1 AND version=old_version;
- Java 中:
- 特点:
- ✅ 无锁、高并发性能好(无阻塞)。
- ❌ 冲突频繁时,重试成本高(可能多次失败)。
- 适合读多写少、冲突较少的场景。
📌 “先操作,提交时校验” —— 相信世界是美好的,但留一手验证。
总结来说:悲观锁要求必须先获取到资源,才能进行对资源的操作。而乐观锁则允许共同尝试操作资源,但是会通过校验来保证只有少部分操作通过并使资源达到目标状态。
CAS
1. 什么是CAS?
CAS 通常指的是 Compare-And-Swap(比较并交换),它是一种用于实现多线程同步的原子操作。
2. CAS如何实现?
简单来说,CAS包括三个参数,分别是内存(也可以是数据库等其他地方)中的实际值,线程读取到的期望值,以及需要替换的新值。当线程读取到的值与内存中的实际值相同时,就执行替换操作,反之则返回失败(或者不执行任何操作)。这个过程被封装为原子操作。要么同时成功,要么同时失败。
3. CAS的优缺点?
优点:避免了传统锁带来的线程阻塞和上下文切换开销。
缺点:可能遇到 ABA 问题(值从 A 变成 B 又变回 A,导致 CAS 误判)、循环时间长开销大等。
4. CAS使用示例
public class CasExample {

    /**
     * 库存扣减任务类
     * 实现Runnable接口,用于在多线程环境中执行库存扣减操作
     */
    static class CasRunnable implements Runnable {

        // 使用AtomicInteger保证库存操作的原子性,初始库存为20
        static AtomicInteger stock = new AtomicInteger(20);

        @Override
        public void run() {
            int oldValue; // 保存当前库存值
            int newValue; // 计算扣减后的库存值

            // 使用CAS算法实现无锁化的原子更新
            do {
                oldValue = stock.get(); // 获取当前库存值
                // 如果库存大于0则减1,否则保持为0(不小于0)
                newValue = oldValue > 0 ? oldValue - 1 : 0;

                // 比较并交换:仅当当前值仍等于oldValue时才更新为newValue
                // 同时确保只有在newValue > 0时才继续尝试(即至少还有1个库存)
            } while (!stock.compareAndSet(oldValue, newValue) && newValue > 0);

            // 输出操作结果
            if (newValue == 0) {
                System.out.println(Thread.currentThread().getName() + " 抢购失败");
            } else {
                System.out.println(Thread.currentThread().getName() + " 抢购成功,剩余:" + newValue);
            }
        }

    }

    /**
     * 主方法
     * 创建多个线程并发执行库存扣减操作,模拟高并发场景下的抢购功能
     */
    public static void main(String[] args) {
        // 创建线程池
        ExecutorService defaulExecutors = MyThreadPool.createDefaulExecutors();
        // 提交50个抢购任务到线程池
        for (int i = 0; i < 50; i++) {
            defaulExecutors.execute(new CasRunnable());
        }
        // 注意:这里没有关闭线程池,程序可能不会自动结束
    }
}
5.2 自旋锁与互斥锁
1. 什么是自旋锁?
当一个线程尝试获取已被占用的锁时,不会立即阻塞,而是循环(“自旋”)不断重试获取锁,直到成功。
2. 什么是互斥锁?
当一个线程尝试获取已被其他线程占用的锁时,该线程会被挂起(阻塞),进入等待状态,直到锁被释放。
3. 自旋锁特点
- 线程一直占用 CPU,持续检查锁是否可用;
- 无上下文切换开销;
- 适用于锁持有时间非常短的场景(比如几纳秒到微秒级);
- 如果锁竞争激烈或持有时间长,会浪费大量 CPU 资源。
- 其底层经常采用CAS提供的原子操作来实现
4. 互斥锁特点
- 操作系统会将该线程从运行队列中移出,不占用 CPU 资源;
- 锁释放后,操作系统负责唤醒等待的线程;
- 适用于锁持有时间较长的场景;
- 有上下文切换开销(因为涉及线程阻塞/唤醒)。
5. 补充:现代很多锁实现(如 Java 的 synchronized 在 JDK 6+)采用了自适应自旋策略:
- 先尝试自旋几次;
- 如果失败,再转为阻塞;
- 这样结合了两者优点,提升性能。
6. 总结来说:互斥锁让线程“睡着等”,自旋锁让线程“站着等”——前者省 CPU,后者省切换。
5.2 synchronized锁升级
1. synchronized锁升级是什么?
synchronized 锁升级是 Java 虚拟机(JVM)为了提升 synchronized 关键字的性能,在运行时根据竞争情况动态调整锁状态的一种优化机制。它主要出现在 JDK 6 及之后的版本中,属于 HotSpot 虚拟机对内置锁(也叫监视器锁)的优化策略。
2. 锁升级的四种状态
- 无锁状态:对象刚创建时没有被任何线程锁定。
- 偏向锁(Biased Locking):
- 适用于只有一个线程反复进入同步块的场景。
- JVM 会将对象头中的标记字段(Mark Word)记录该线程 ID,后续该线程再次进入时无需进行 CAS 操作,直接获得锁。
- 目的是减少无竞争情况下的同步开销。
- 轻量级锁(Lightweight Locking):
- 当有第二个线程尝试竞争锁时,偏向锁会撤销,升级为轻量级锁。
- 轻量级锁通过自旋 + CAS 尝试获取锁,避免线程阻塞和操作系统上下文切换。
- 适用于短时间、低竞争的同步场景。
- 重量级锁(Heavyweight Locking):
- 如果自旋次数过多或竞争激烈,轻量级锁会膨胀为重量级锁。
- 此时线程会真正挂起,由操作系统调度,涉及用户态与内核态切换,开销较大。
注意:锁可以升级但不能降级(在常规执行路径下)。不过从 JDK 15 开始,偏向锁已被默认禁用,并计划在未来版本中移除,因为现代应用中多线程竞争更常见,偏向锁反而可能带来额外开销。
5.3 可重入锁
1. 什么是可重入锁?
可重入锁(Reentrant Lock) 是指:同一个线程可以多次获取同一把锁而不会发生死锁的锁机制。
在 Java 中,synchronized 和 java.util.concurrent.locks.ReentrantLock 都是可重入锁。
2. 可重入锁示例
public class Example {
    public synchronized void methodA() {
        System.out.println("进入 methodA");
        methodB(); // 调用另一个同步方法
    }

    public synchronized void methodB() {
        System.out.println("进入 methodB");
    }
}
// 额外说明:被synchronized修饰的方法,本质上是调用了synchronized (this),锁住的是当前对象实例
当一个线程进入methodA()后,其会获取到该对象的锁,而当进入methodB()后,他并不会因为当前对象实例的锁已被持有(持有者就是该线程本身)而被阻塞。
为什么不会死锁?
因为JVM 为每个对象的锁维护了一个持有线程 + 重入计数器:
- 第一次进入
methodA():线程 T 获取this的锁,计数器 = 1。 - 在
methodA()中调用methodB():线程 T 再次请求this的锁。- JVM 发现:当前锁的持有者就是 T → 允许进入,计数器 = 2。
- 退出
methodB():计数器减为 1。 - 退出
methodA():计数器减为 0,锁被真正释放。
这就是可重入性的核心:同一个线程可以重复获取同一个锁,而不会阻塞自己。
5.4 ReentrantLock
5.4.1 ReentrantLock 简介
1. 什么是ReentrantLock?
ReentrantLock 是 Java 并发包(java.util.concurrent.locks)中提供的一种可重入的互斥锁,用于替代传统的 synchronized 关键字,实现线程同步。
2. 核心特点
- 可重入性(Reentrant)
同一个线程可以多次获取同一个锁而不会死锁。每次加锁,内部计数器加一;每次释放锁,计数器减一;只有当计数器归零时,锁才真正被释放。 - 显式加锁/解锁
与synchronized自动加锁和释放不同,ReentrantLock需要程序员手动调用lock()获取锁、unlock()释放锁。通常建议在try-finally块中使用,确保锁一定会被释放: - 支持公平/非公平策略
- 默认是非公平锁(性能更好):线程争抢锁时不严格按请求顺序。
- 可通过构造函数指定为公平锁(
new ReentrantLock(true)),保证等待时间最长的线程优先获取锁。
- 功能更丰富
- 支持可中断的锁获取(
lockInterruptibly()) - 支持带超时的锁获取(
tryLock(timeout, unit)) - 可查询当前是否被锁定、是否有线程在等待等
- 支持可中断的锁获取(
3. 使用示例
/**
 * 演示使用 ReentrantLock 实现线程安全的售票系统。
 * 本例中,多个线程并发尝试购买有限数量的票(初始为100张),
 * 通过显式锁 ReentrantLock 确保对共享资源(STOCK)的安全访问。
 *
 * @author 王玉涛
 * @version 1.0
 * @since 2026/1/22
 */
public class ReentrantLockExample implements Runnable {

    /**
     * 可重入互斥锁,用于保护对共享变量 STOCK 的并发访问。
     * 使用静态 final 保证所有线程共享同一把锁,从而实现同步控制。
     */
    private static final ReentrantLock LOCK = new ReentrantLock();

    /**
     * 共享的票库存数量,初始值为100。
     * 该变量被多个线程并发读写,必须通过锁保护以避免竞态条件。
     */
    private static int STOCK = 100;

    /**
     * 线程执行体:尝试获取锁并购买一张票。
     * 若库存大于0,则成功售出并打印信息;否则提示购票失败。
     *
     * 注意:必须在 finally 块中释放锁,确保即使发生异常也能正确解锁,
     * 避免死锁。同时通过 isHeldByCurrentThread() 判断当前线程是否持有锁,
     * 提高健壮性(尽管在此逻辑下通常总是持有)。
     */
    @Override
    public void run() {
        try {
            // 获取锁(阻塞直到获得)
            LOCK.lock();

            // 检查库存是否还有余票
            if (STOCK > 0) {
                // 售出一张票
                STOCK--;
                // 打印售出信息(注意:(STOCK + 1) 是刚售出的票号)
                System.out.println("当前售卖第" + (STOCK + 1) + "张票,剩余: " + STOCK);
            } else {
                // 库存已空,购票失败
                System.out.println(Thread.currentThread().getName() + "购票失败");
            }
        } finally {
            // 安全释放锁:仅当当前线程持有该锁时才解锁
            // (防止 IllegalMonitorStateException,增强代码鲁棒性)
            if (LOCK.isHeldByCurrentThread()) {
                LOCK.unlock();
            }
        }
    }

    /**
     * 主方法:启动200个线程模拟高并发购票场景。
     * 由于票数只有100张,预期前100个成功获取锁且库存未耗尽的线程能购票成功,
     * 其余线程将因库存为0而购票失败。
     *
     * @param args 命令行参数(本例未使用)
     */
    public static void main(String[] args) {
        // 创建200个线程
        Thread[] threads = new Thread[200];

        for (int i = 0; i < 200; i++) {
            // 每个线程执行同一个 Runnable 实例(无状态,安全)
            threads[i] = new Thread(new ReentrantLockExample());
            threads[i].start();
        }

        // 注意:主线程未等待子线程结束,实际应用中可能需要 join()
        // 但本例仅用于演示并发行为,输出顺序可能因调度而异。
    }
}
4. 与 synchronized 的对比
| 特性 | ReentrantLock | synchronized |
|---|---|---|
| 可重入 | ✅ | ✅ |
| 自动释放 | ❌(需手动 unlock) | ✅ |
| 公平性控制 | ✅(可选) | ❌(始终非公平) |
| 可中断/超时 | ✅ | ❌ |
| 条件变量(Condition) | ✅(支持多个) |
❌(仅 wait/notify) |
5. 适用场景:
- 需要更灵活的锁控制(如超时、中断)
- 高竞争环境下希望使用公平锁
- 需要多个条件变量进行线程通信
总之,
ReentrantLock提供了比synchronized更强大、灵活的同步机制,但使用时需格外小心,避免忘记释放锁导致死锁。
5.4.2 tryLock 方法
1. 简单介绍
ReentrantLock 的 tryLock() 方法是其区别于 synchronized 的一个重要特性,它提供了一种非阻塞或带超时的尝试获取锁的方式。
2. 无参 tryLock()
boolean tryLock()
- 作用:立即尝试获取锁。
- 返回值:
- 如果锁可用(即没有被其他线程持有),则立即获取锁并返回
true; - 如果锁已被占用,则不等待、直接返回
false。
- 如果锁可用(即没有被其他线程持有),则立即获取锁并返回
- 特点:非阻塞,不会让当前线程挂起。
✅ 适用场景:希望快速尝试加锁,失败就做别的事(比如重试、降级处理等)。
使用示例:
ReentrantLock lock = new ReentrantLock();
if (lock.tryLock()) {
    try {
        // 执行临界区代码
    } finally {
        lock.unlock();
    }
} else {
    // 锁被占用,执行其他逻辑(如记录日志、跳过、排队等)
}
⚠️ 注意:即使成功获取了锁,也必须在 finally 块中释放,否则可能导致死锁。
3. 带超时的 tryLock(long timeout, TimeUnit unit)
boolean tryLock(long timeout, TimeUnit unit) throws InterruptedException
- 作用:在指定时间内尝试获取锁。
- 行为:
- 如果锁立即可用,获取并返回
true; - 如果锁不可用,则最多等待
timeout时间; - 若在超时前获得锁,返回
true; - 若超时仍未获得锁,返回
false; - 等待期间如果线程被中断,会抛出
InterruptedException。
- 如果锁立即可用,获取并返回
- 特点:可中断 + 带超时,避免无限期等待。
✅ 适用场景:需要限制等待时间,防止线程长时间阻塞(如响应式系统、高可用服务)。
使用示例:
ReentrantLock lock = new ReentrantLock();
try {
    if (lock.tryLock(2, TimeUnit.SECONDS)) {
        try {
            // 执行临界区代码
        } finally {
            lock.unlock();
        }
    } else {
        // 超时未获取到锁,处理超时逻辑
    }
} catch (InterruptedException e) {
    Thread.currentThread().interrupt(); // 恢复中断状态
    // 处理中断
}
4. 与lock对比
| 方法 | 是否阻塞 | 是否可中断 | 是否超时 | 返回值 |
|---|---|---|---|---|
lock() | 是(永久阻塞直到获取) | ❌ | ❌ | void |
tryLock() | 否(立即返回) | ❌ | ❌ | boolean |
tryLock(timeout, unit) | 是(最多阻塞 timeout) | ✅ | ✅ | boolean |
5. 总结
tryLock()让你主动控制锁竞争的行为,避免死锁或长时间阻塞;- 特别适合实现高响应性、容错性强的并发程序;
- 使用时务必注意资源释放和中断处理。
5.4.3 中断获取锁的过程
1. 简单介绍
ReentrantLock 获取锁的过程在某些方法下是可以被中断的,比如支持中断的加锁方法:lockInterruptibly()
void lockInterruptibly() throws InterruptedException
- 行为:
- 如果锁可用,立即获取并返回;
- 如果锁不可用,当前线程会阻塞等待;
- 但在等待过程中,如果线程被其他线程调用
interrupt()中断,则会抛出InterruptedException并退出等待,不会获得锁。
- 特点:可响应中断,适合需要取消长时间等待的场景。
2. 使用示例:
ReentrantLock lock = new ReentrantLock();

Thread t = new Thread(() -> {
    try {
        lock.lockInterruptibly(); // 可中断地获取锁
        try {
            // 临界区代码
            System.out.println("执行任务...");
        } finally {
            lock.unlock();
        }
    } catch (InterruptedException e) {
        System.out.println("等锁时被中断,放弃获取锁!");
        // 线程可以优雅退出或做清理
    }
});

t.start();

// 主线程稍后中断它
Thread.sleep(100);
t.interrupt(); // 触发中断
⚠️ 注意:必须捕获
InterruptedException,并在中断后不要继续操作临界资源(因为没拿到锁)。
5.5 公平锁与非公平锁
5.5.1 公平锁介绍
- 定义:公平锁会按照线程请求锁的顺序来分配锁,即“先来先得”。
- 实现方式:当一个线程尝试获取锁时,如果锁已被占用,该线程会被放入一个 FIFO(先进先出)的等待队列中;只有队列中最前面的线程才有资格在锁释放后获取它。
- 优点:避免线程“饥饿”,保证所有线程最终都能获得锁。
- 缺点:吞吐量通常较低,因为频繁的上下文切换和严格的排队机制会带来额外开销。
- 创建方式:
ReentrantLock fairLock = new ReentrantLock(true); // true 表示启用公平模式
5.5.2 非公平锁介绍
- 定义:非公平锁允许插队。即使有线程在等待队列中,新来的线程仍可能在锁可用时直接获取它。
- 实现方式:当锁被释放时,任何尝试获取锁的线程(包括刚到达的)都有机会立即抢到锁,而不一定按排队顺序。
- 优点:整体吞吐量更高,响应更快,因为减少了线程挂起/唤醒的开销。
- 缺点:可能导致某些线程长时间得不到锁(即“线程饥饿”)。
- 创建方式:
ReentrantLock nonFairLock = new ReentrantLock();        // 默认是非公平
ReentrantLock nonFairLock2 = new ReentrantLock(false); // 显式指定非公平
5.5.3 补充说明
- Java 内置的
synchronized关键字实现的是非公平锁。 - 选择公平还是非公平,需根据具体应用场景权衡:对响应时间敏感的系统通常用非公平锁;对公平性要求高的场景(如任务调度)可考虑公平锁。
5.5.4 代码示例
/**
 * 公平锁与非公平锁行为演示示例
 *
 * @author 王玉涛
 * @version 1.0
 * @since 2026/1/22
 *
 * 说明:
 * - 本例通过 ReentrantLock 的构造参数控制锁的公平性。
 * - 当前代码使用的是 **非公平锁**(new ReentrantLock(false))。
 * - 若想观察公平锁行为,请将 false 改为 true。
 */
public class FairLockExample implements Runnable {
    private String name;

    // ⚠️ 当前为【非公平锁】。若需测试公平锁,请将参数改为 true
    public static final ReentrantLock LOCK = new ReentrantLock(false);

    /**
     * 构造方法:初始化线程名称
     *
     * @param name 线程标识名,如 "线程1"
     */
    public FairLockExample(String name) {
        this.name = name;
    }

    /**
     * 线程执行逻辑:尝试获取锁并打印信息,共执行5次
     */
    @Override
    public void run() {
        for (int i = 0; i < 5; i++) {
            try {
                // 尝试获取锁(公平锁:排队等待;非公平锁:可能直接抢到)
                LOCK.lock();
                System.out.println(this.name + "获取到锁");

                // 模拟临界区操作(可选)
                // Thread.sleep(1); // 若取消注释,公平性表现会更明显

            } catch (Exception e) {
                e.printStackTrace();
            } finally {
                // 安全释放锁:仅当当前线程持有锁时才解锁
                if (LOCK.isHeldByCurrentThread()) {
                    LOCK.unlock();
                }
            }
        }
    }

    /**
     * 主方法:启动3个线程并发竞争锁
     *
     * @param args 命令行参数(未使用)
     * @throws InterruptedException 主线程等待子线程时可能抛出
     */
    public static void main(String[] args) throws InterruptedException {
        Thread[] threads = new Thread[3];

        // 创建并启动3个线程
        for (int i = 0; i < 3; i++) {
            threads[i] = new Thread(new FairLockExample("线程" + (i + 1)));
            threads[i].start();
        }

        // 等待所有线程执行完毕
        for (int i = 0; i < 3; i++) {
            threads[i].join();
        }

        System.out.println("所有线程执行完毕。");
    }
}
公平锁:
线程1获取到锁
线程2获取到锁
线程3获取到锁
线程1获取到锁
线程2获取到锁
线程3获取到锁
线程1获取到锁
线程2获取到锁
线程3获取到锁
线程1获取到锁
线程2获取到锁
线程3获取到锁
线程1获取到锁
线程2获取到锁
线程3获取到锁

非公平锁:
线程1获取到锁
线程1获取到锁
线程1获取到锁
线程1获取到锁
线程1获取到锁
线程2获取到锁
线程2获取到锁
线程2获取到锁
线程2获取到锁
线程2获取到锁
线程3获取到锁
线程3获取到锁
线程3获取到锁
线程3获取到锁
线程3获取到锁
非公平锁的输出示例,本质上是因为当前正在执行的任务的线程,其释放资源后又可以立即参与到锁的竞争中。而其他的线程可能因为阻塞唤起等原因,落后于当前线程,因此才呈现线程1 -> 线程2 -> 线程3的输出结果。相比较于公平锁,非公平锁使得CPU的线程上下文切换开销变得更小。
5.6 共享锁与排它锁
5.6.1 简介
在 Java 中,共享锁(Shared Lock)和排它锁(Exclusive Lock,也称独占锁)是并发控制中两种基本的锁模式,主要用于协调多个线程对共享资源的访问。它们的概念源自操作系统和数据库,并在 Java 的并发工具类(如 ReentrantReadWriteLock、AQS 框架等)中得到实现。
5.6.2 共享锁
- 定义:允许多个线程同时持有该锁,但不能与排它锁共存。
- 用途:用于只读操作,提高并发读性能。
- 特点:
- 多个读线程可以并发执行(提升吞吐量)。
- 如果有线程持有共享锁,其他线程不能获取排它锁(写必须等待所有读完成)。
- 如果有线程持有排它锁,其他线程既不能读也不能写。
- Java 中典型实现:
ReentrantReadWriteLock.ReadLock- AQS 中的
tryAcquireShared/tryReleaseShared方法
✅ 示例:
多个线程同时读取缓存中的配置信息,使用共享锁可避免不必要的阻塞。
5.6.3 排它锁
- 定义:同一时刻只允许一个线程持有该锁。
- 用途:用于写操作或需要修改共享资源的场景,确保数据一致性。
- 特点:
- 具有互斥性:其他线程(无论是读还是写)都必须等待锁释放。
- Java 中典型的排它锁包括:
synchronized关键字ReentrantLockReentrantReadWriteLock.WriteLock
✅ 示例:
多个线程要修改同一个计数器,必须用排它锁防止并发修改导致数据错误。
5.6.4 对比
| 特性 | 共享锁(读锁) | 排它锁(写锁) |
|---|---|---|
| 是否允许多个线程同时持有 | ✅ 是 | ❌ 否(只能一个) |
| 是否允许与对方共存 | ❌ 不能与排它锁共存 | ❌ 不能与任何锁共存 |
| 适用场景 | 只读操作 | 写操作或读写混合 |
| 典型实现 | ReentrantReadWriteLock.ReadLock | ReentrantLock, WriteLock |
5.6.5 使用示例
ReentrantReadWriteLock rwLock = new ReentrantReadWriteLock();

// 读操作(共享)
rwLock.readLock().lock();
try {
    // 多个线程可同时执行此处
} finally {
    rwLock.readLock().unlock();
}

// 写操作(排它)
rwLock.writeLock().lock();
try {
    // 只有一个线程能执行此处
} finally {
    rwLock.writeLock().unlock();
}
总结:多个线程可以同时申请共享锁。如果有线程正在持有共享锁(读锁),任何尝试申请排它锁(写锁)的线程都必须等待共享锁完全释放。而如果有线程正在持有排它锁(写锁),其他线程无论是尝试申请共享锁还是排它锁,都必须等待它完全释放。
- 读-读:允许并发 ✅
- 读-写:互斥,写需等所有读完成 ⏳
- 写-写:互斥,只能一个写 ❌
- 写-读:互斥,读需等写完成 ⏳
这就是经典的 “读写锁语义” —— 允许多读,禁止读写/写写并发。
5.7 synchronized 和 Lock的区别、
- 语法层面
synchronized是 Java 语言关键字,由 JVM 原生支持;Lock是java.util.concurrent.locks包中的接口,属于 JDK API。
- 加锁与释放方式
synchronized自动加锁和释放锁(进入同步块时加锁,退出时自动释放,包括异常情况);Lock必须手动调用lock()加锁,并在finally块中显式调用unlock()释放锁,否则可能导致死锁。
- 响应中断能力
synchronized不可中断:线程在等待锁时无法响应中断;Lock支持中断:可通过lockInterruptibly()方法使等待线程响应Thread.interrupt()。
- 超时获取锁
synchronized不支持超时,只能一直阻塞等待;Lock支持带超时的尝试获取锁,如tryLock(long timeout, TimeUnit unit)。
- 非阻塞尝试获取锁
synchronized无法“尝试”获取锁,只能阻塞;Lock提供tryLock()方法,可立即返回是否成功获取锁,不阻塞。
- 公平性控制
synchronized仅支持非公平锁;Lock(如ReentrantLock)可通过构造函数指定是否为公平锁(new ReentrantLock(true))。
- 条件变量(Condition)
synchronized只能使用对象内置的一个隐式条件(通过wait()/notify()/notifyAll());Lock可创建多个Condition对象,实现更精细的线程通信(如生产者-消费者多队列场景)。
- 锁状态查询
synchronized无法查询锁的状态(如是否被持有、持有次数等);Lock提供方法如isLocked()、isHeldByCurrentThread()、getHoldCount()等用于监控和调试。
- 底层实现机制
synchronized基于 JVM 的 Monitor(监视器),依赖对象头中的 Mark Word;Lock基于 AQS(AbstractQueuedSynchronizer)框架,使用 CAS 和 CLH 队列实现。
- 性能表现(现代 JVM)
- 在低竞争或简单同步场景下,
synchronized经过 JVM 优化(偏向锁、轻量级锁等)性能优异且更轻量; - 在高竞争、复杂同步逻辑或需要高级功能时,
Lock更灵活可控,但代码复杂度更高。
- 在低竞争或简单同步场景下,
✅ 最佳实践建议:优先使用
synchronized保证简洁与安全;仅当需要中断、超时、公平锁或多条件等高级特性时,才选用Lock。
6. 总结
Java 并发编程是构建高性能、高可靠系统的核心能力之一。JUC(java.util.concurrent)包作为 JDK 提供的高级并发工具集,极大地简化了多线程开发的复杂性。本文系统梳理了从线程创建、线程池管理,到线程安全三大特性(原子性、可见性、有序性)、JMM 内存模型,再到各类锁机制(悲观/乐观、公平/非公平、共享/排它)的核心知识点。
通过对比传统 synchronized 与现代 ReentrantLock、Atomic 类等无锁编程方案,我们看到:并发设计的本质是在正确性、性能与复杂度之间寻找平衡。合理选择线程模型、谨慎配置线程池参数、善用原子类与显式锁,是写出健壮并发代码的关键。
需谨记:没有银弹。Executors 工厂方法虽便捷,但隐藏的风险不容忽视;synchronized 虽简单,但在高竞争场景下可能成为瓶颈。真正的高手,既懂“开箱即用”,更知“底层何为”。
掌握 JUC,不仅是掌握 API,更是理解并发思想。愿你在高并发的世界里,写得出高效代码,也守得住数据一致。

汇聚全球AI编程工具,助力开发者即刻编程。
更多推荐


 26
 0
- 0


 已为社区贡献2条内容

所有评论(0)