
redis前期工作:环境搭建-在ubuntu安装redis
一.在服务器上安装redis过程
在Linux服务器上安装redis
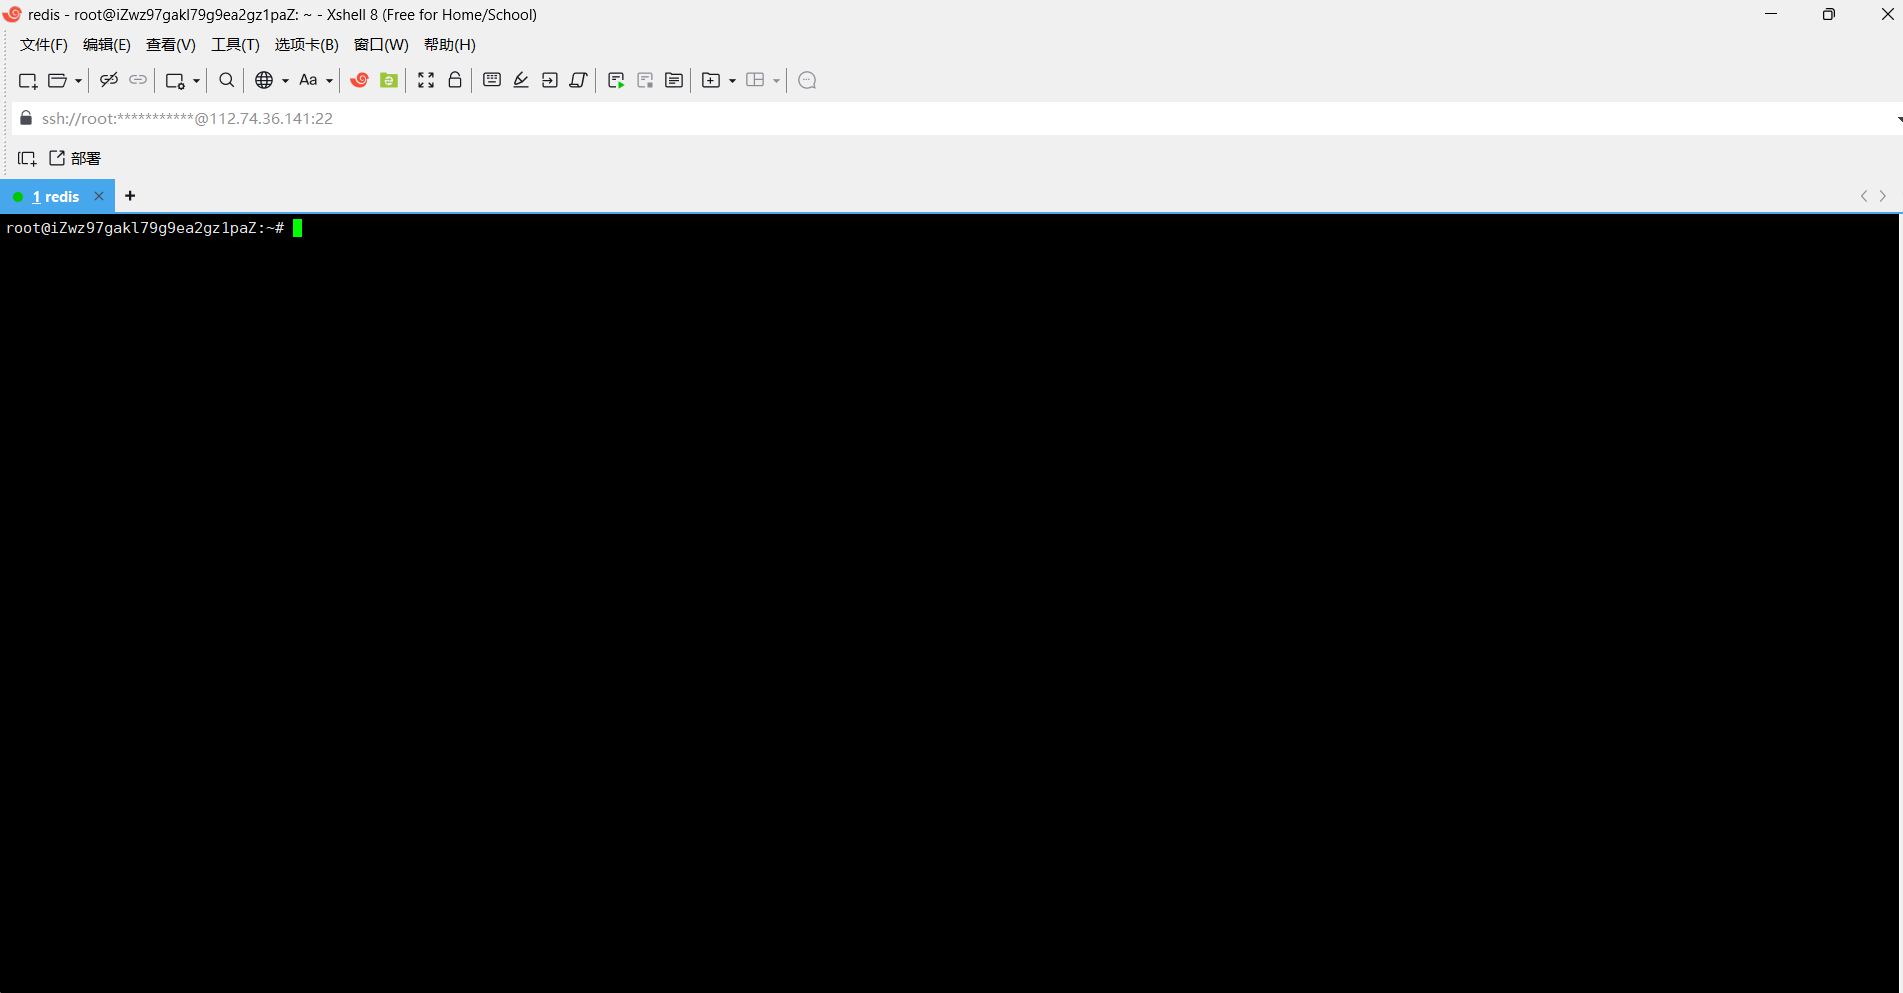
apt update
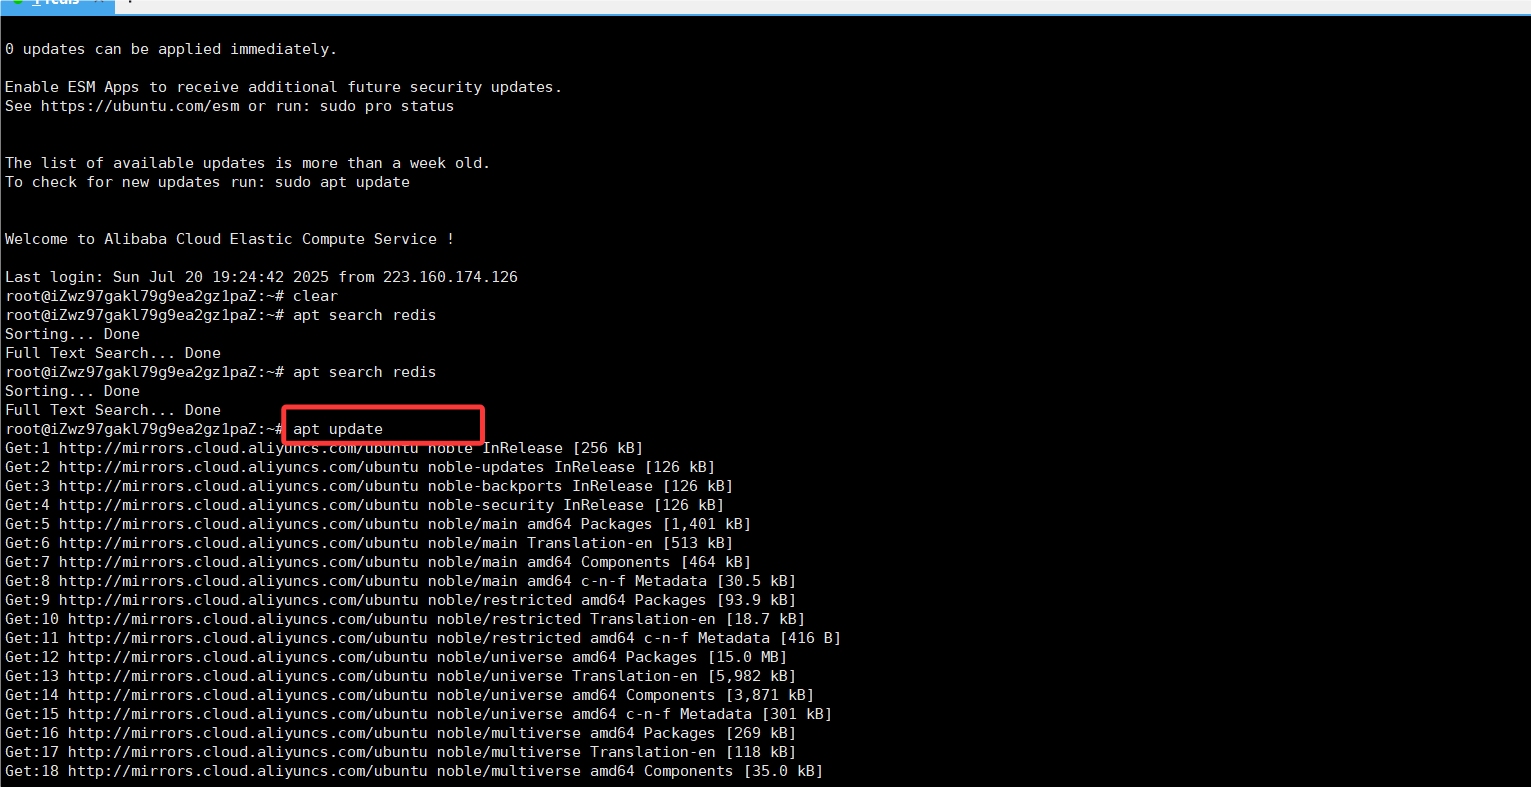
apt search redis
apt install redis (确认y)
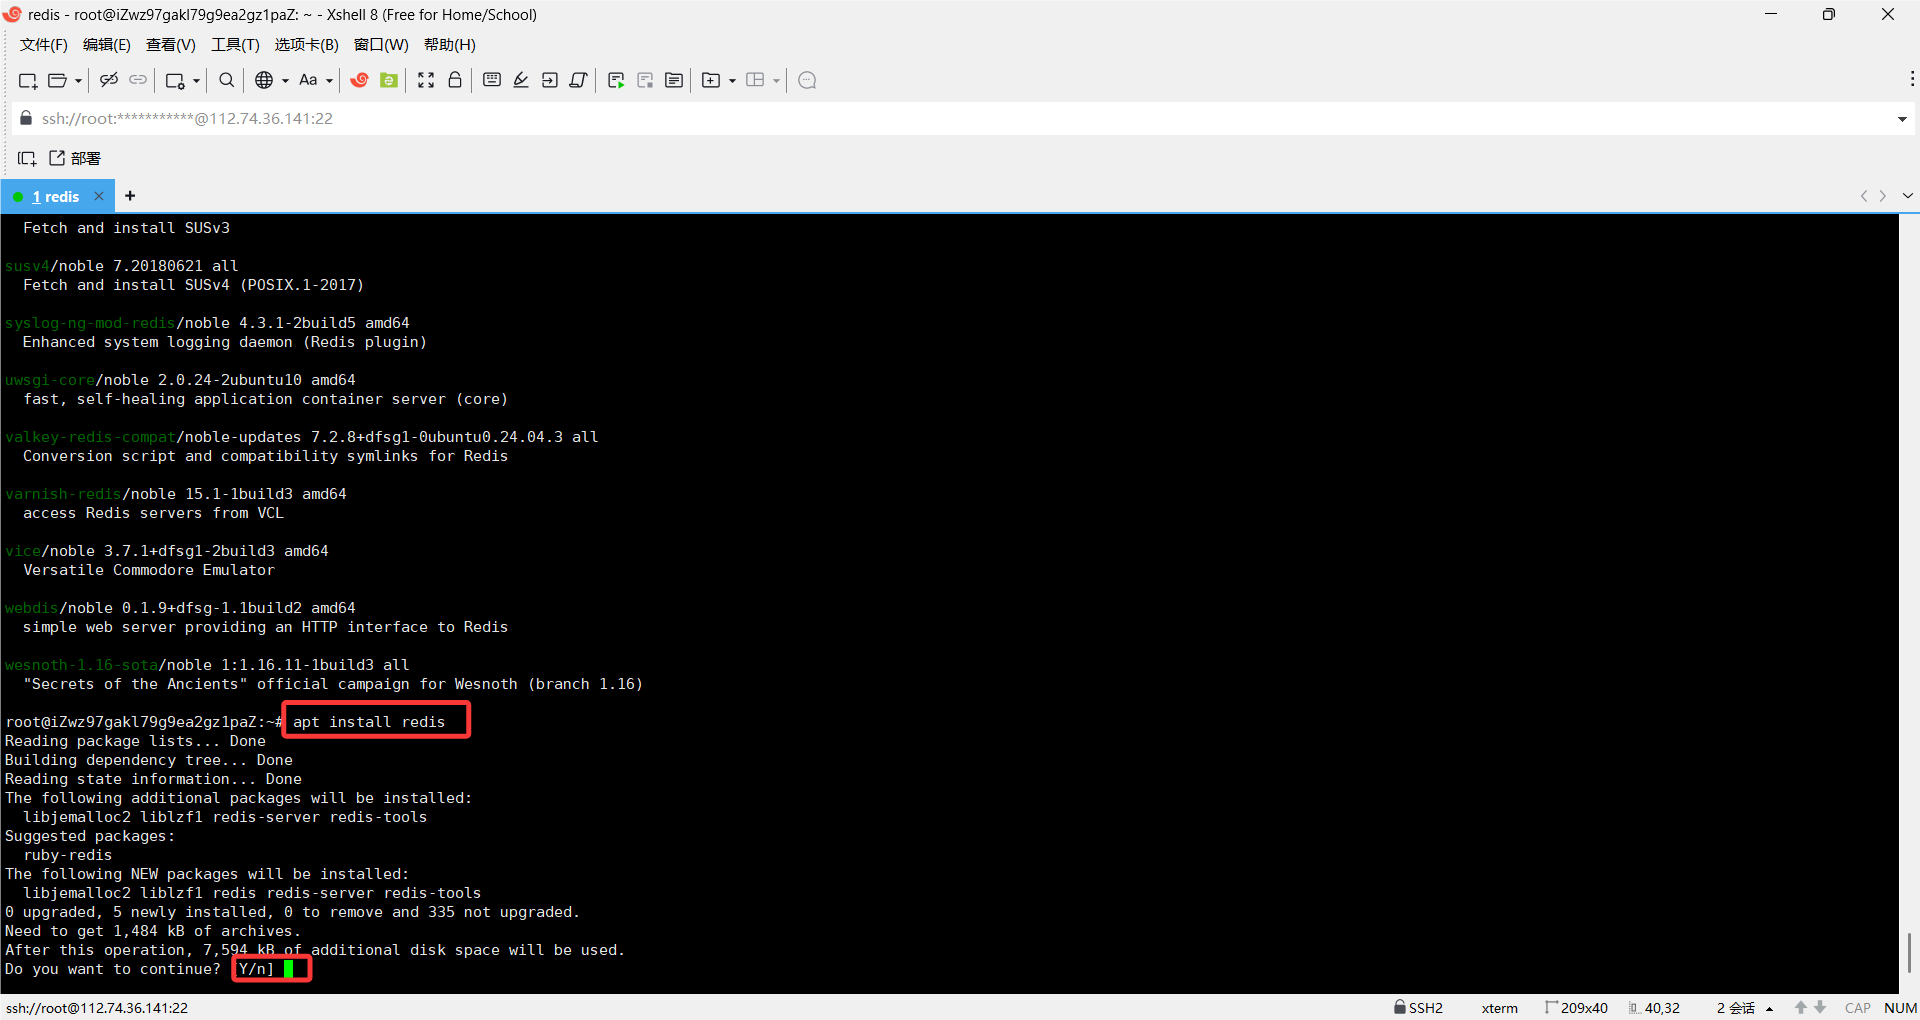
netstat -anp | grep redis
(查看服务是否启动)
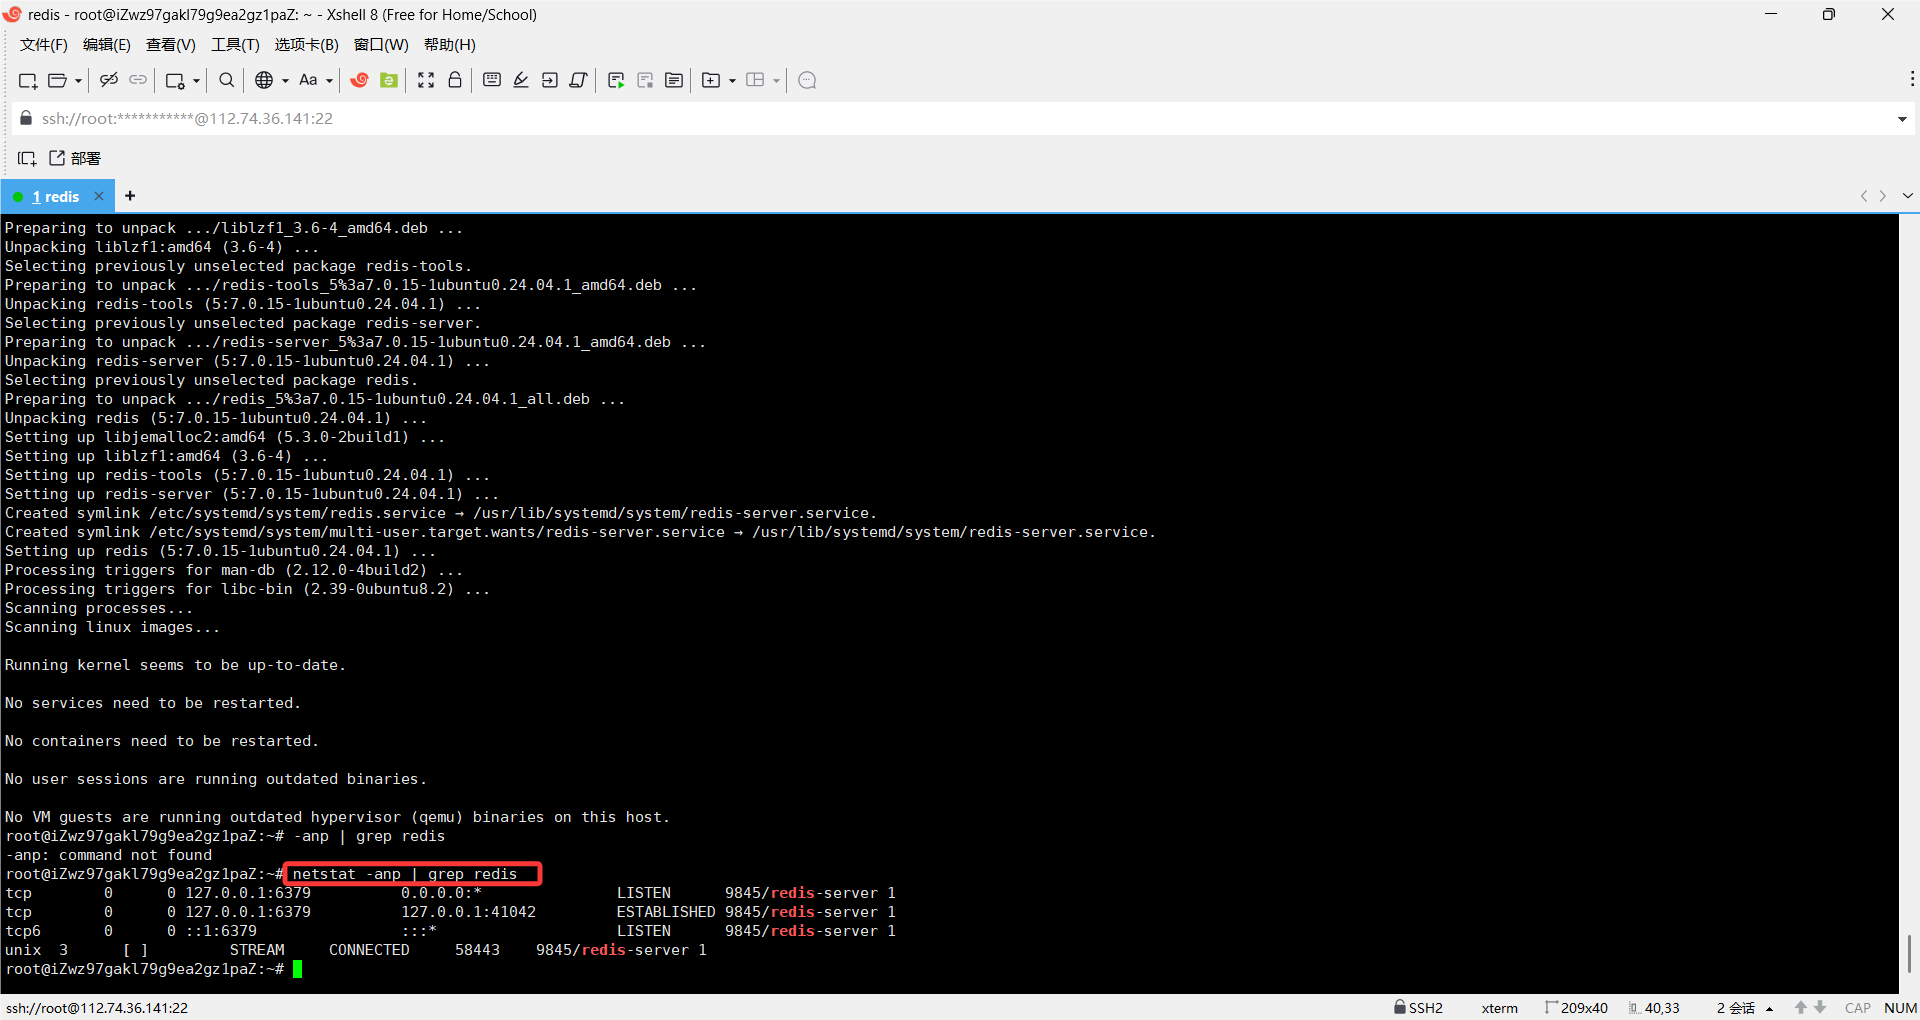 实现远程连接:
修改自己主键的ip修改(默认是在自己主机的ip,其他主机访问不了)
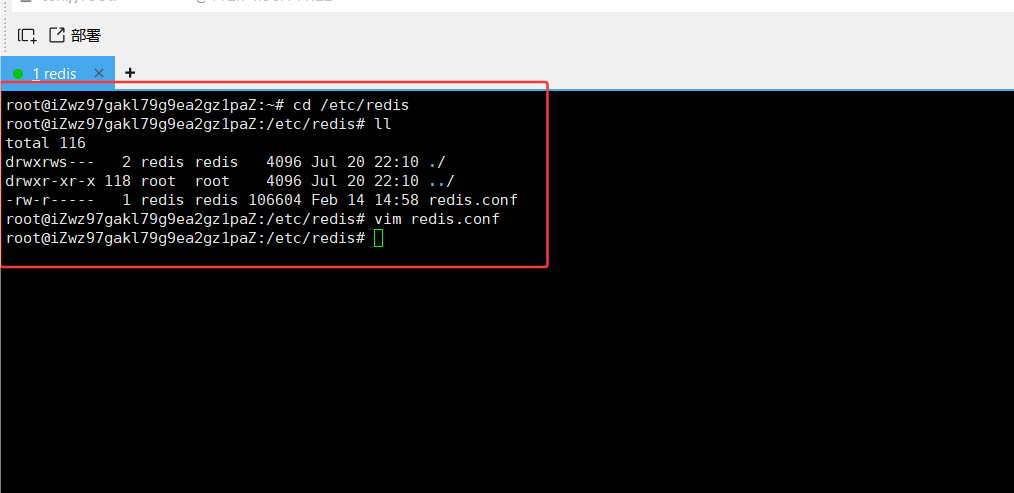
- 修改 /etc/redis/redis.conf
- 修改 bind 127.0.0.1 为 bind 0.0.0.0
- 修改 protected-mode yes 为 protected-mode no
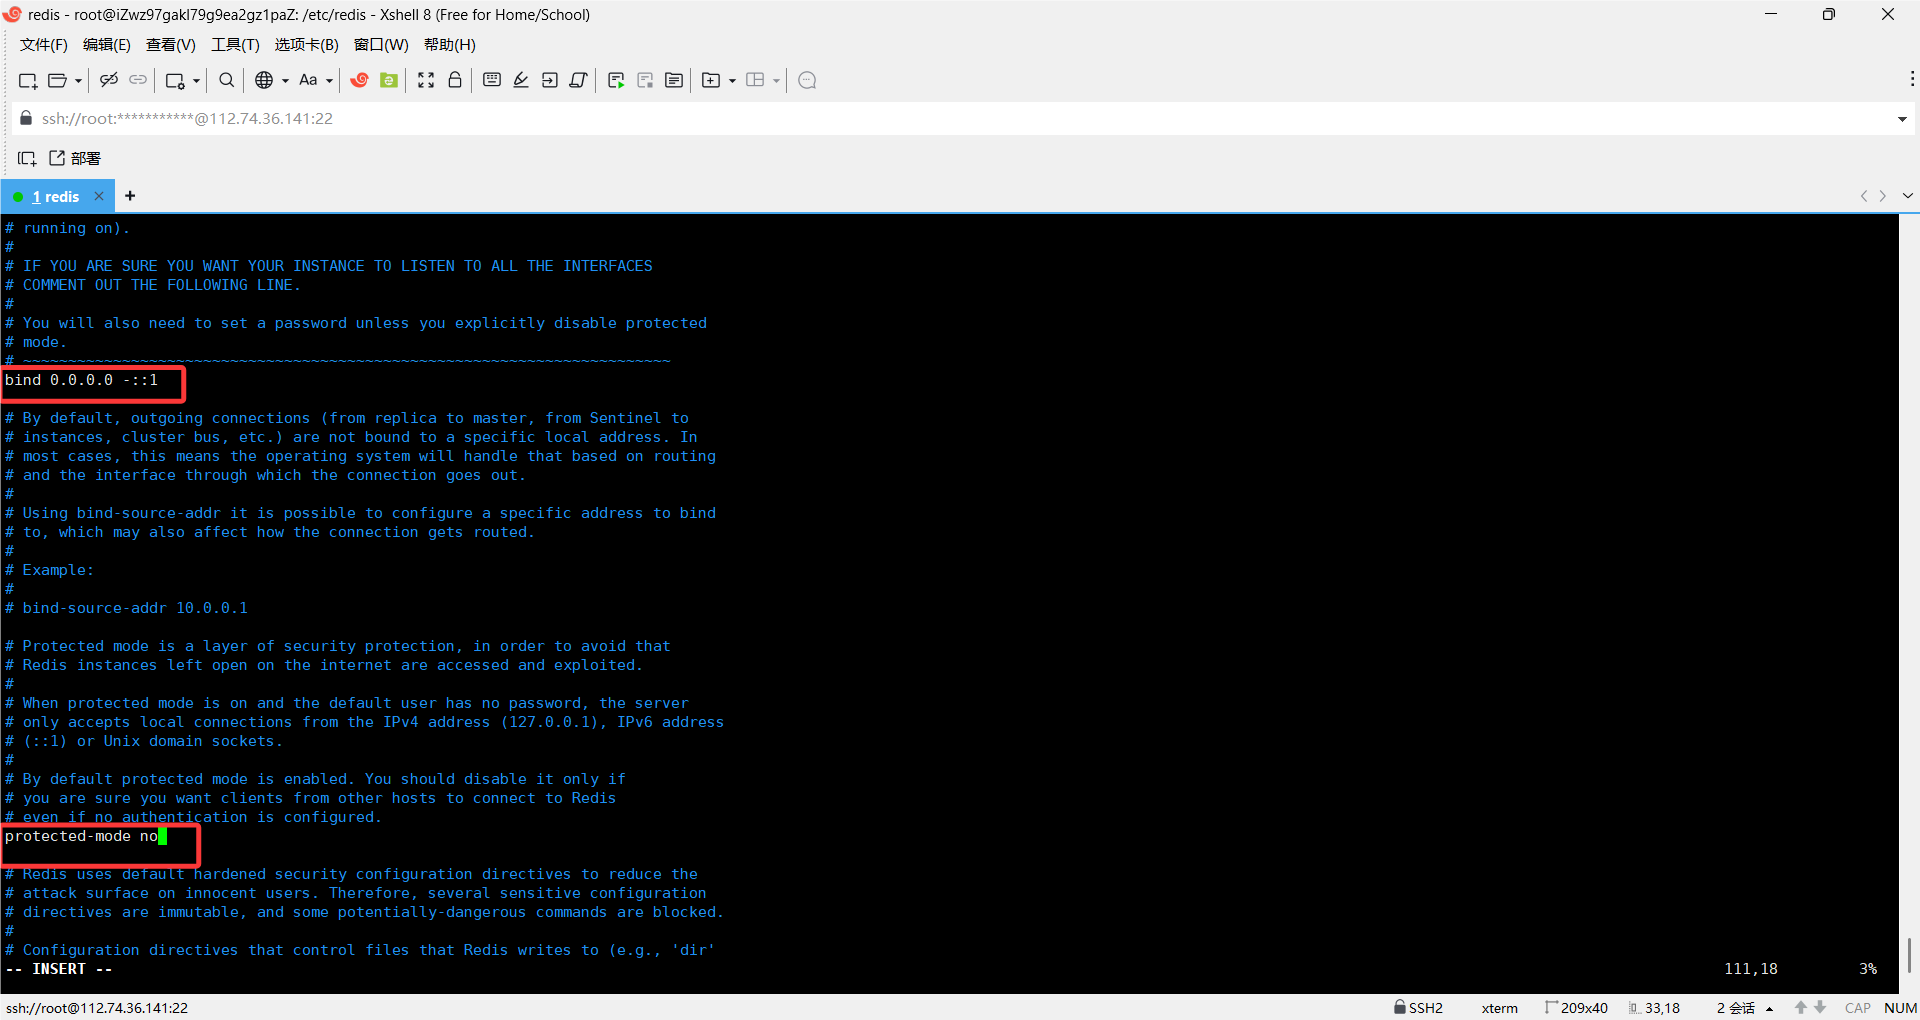
重启一下 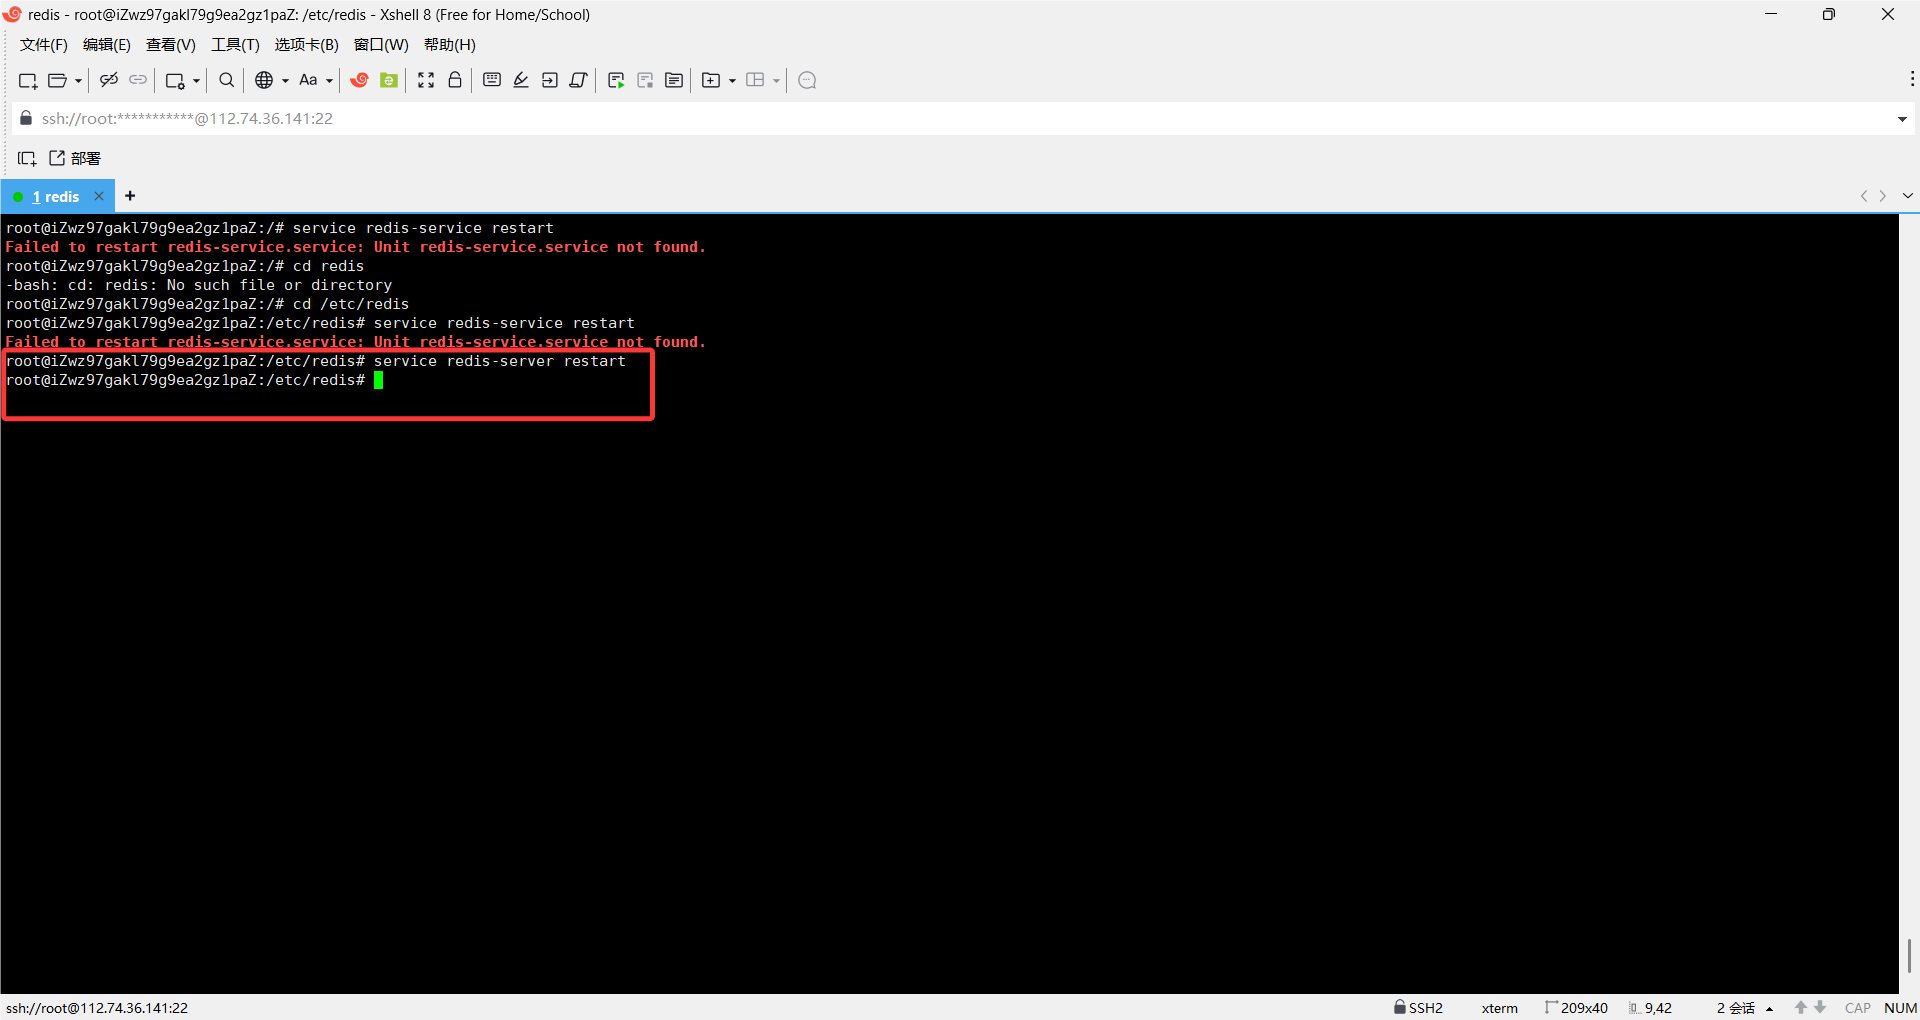
redis服务器连接到服务器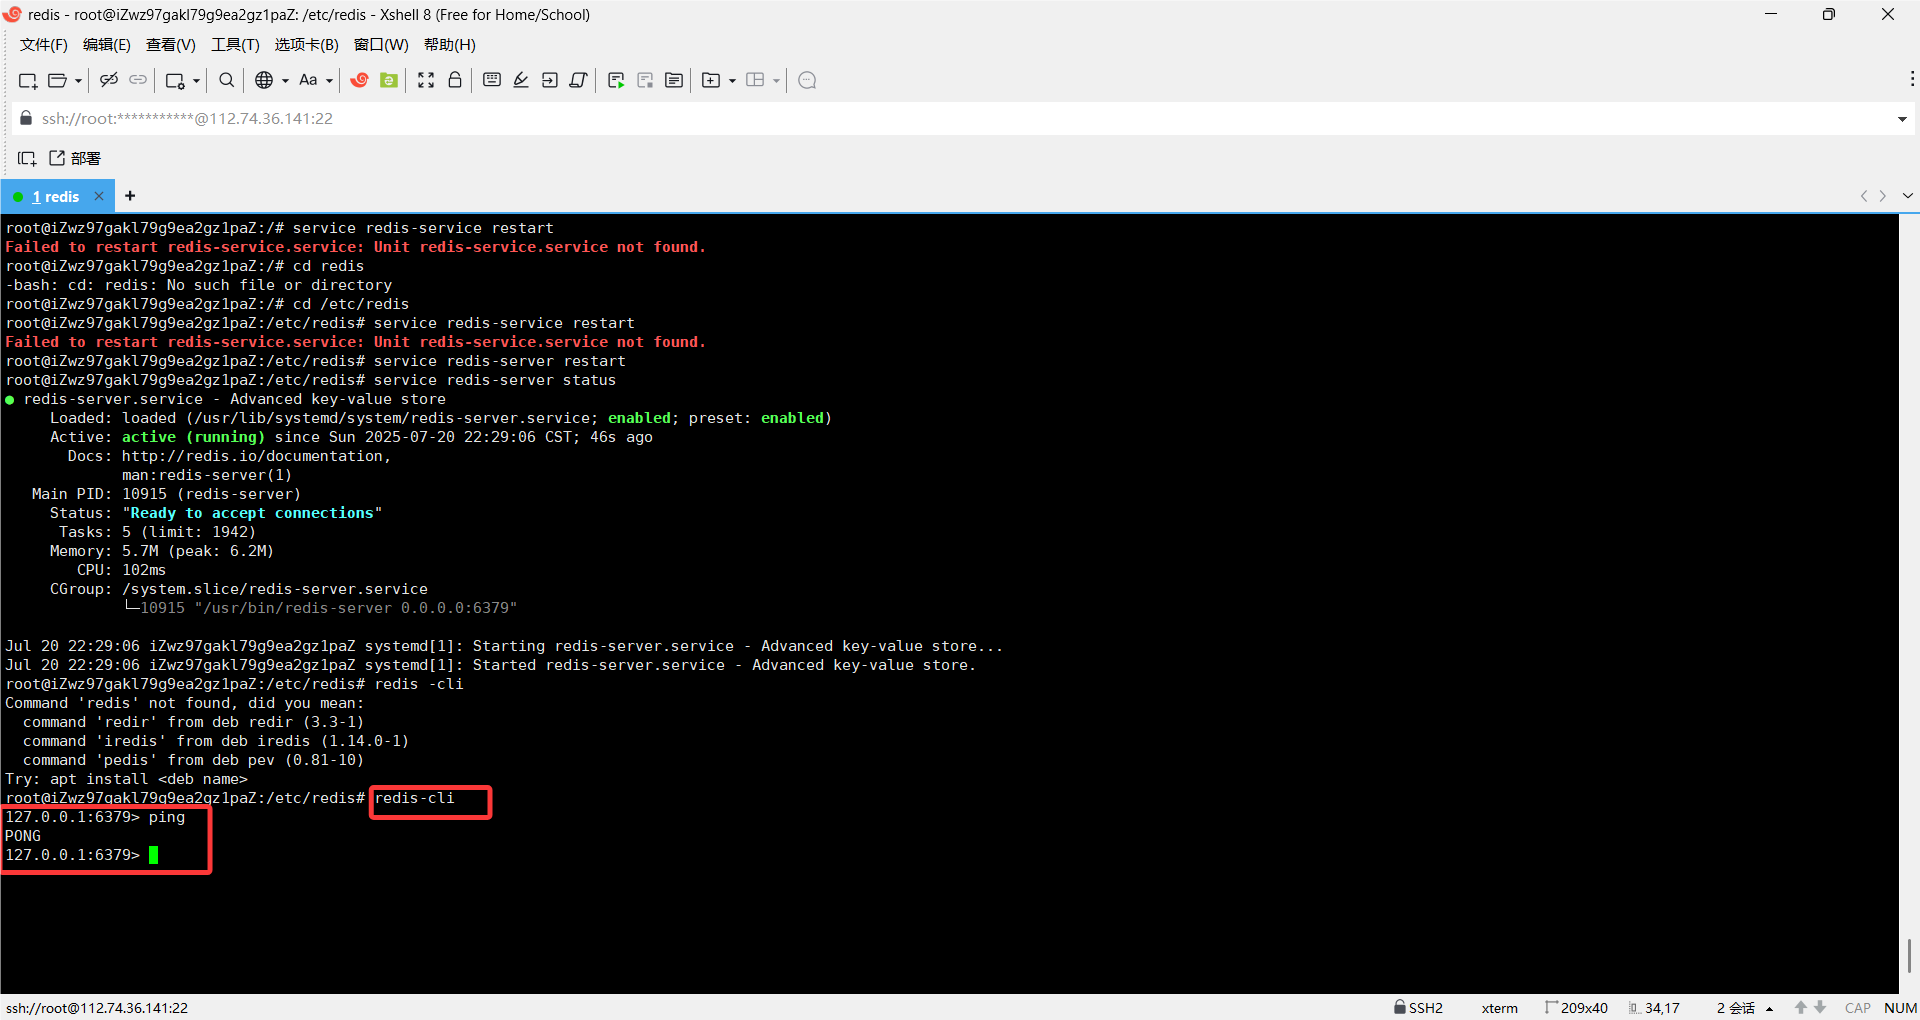
cltr + d 可选择退出(到这一步安装成功!)
二.特定场景下是否选择使用 Redis 分析
redis的结构本质上还是客户端-服务器的程序
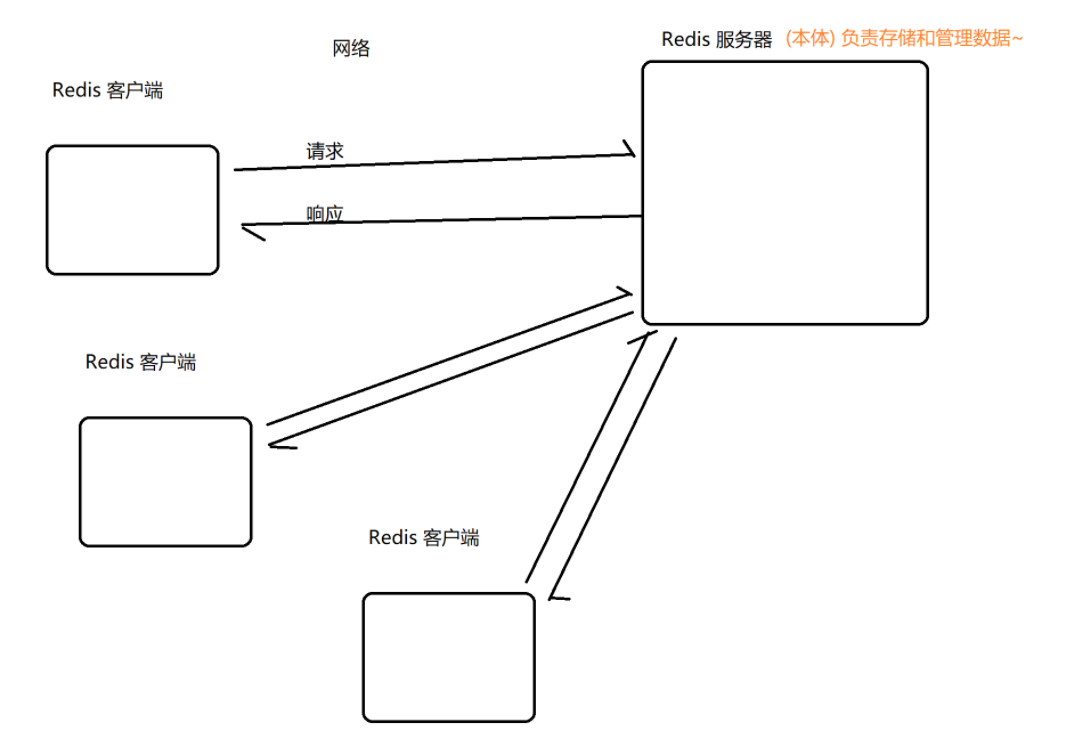
redis的客户端也有很多种形态
1.自带命令行
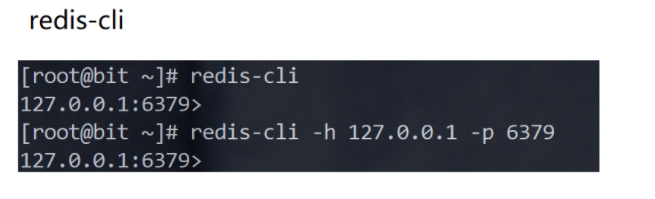
2。使用图形化界面(桌面程序,web程序)
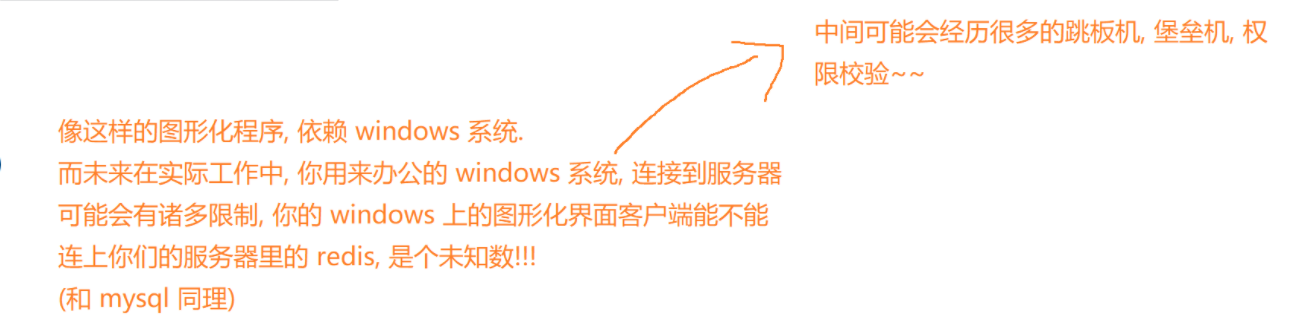
3.基于redis的api自行开发客户端(工作中最主要的形态,非常类似于mysql的C语言API和JDBC
Redis 的 “快” 是相对关系型数据库(如 MySQL)而言的,若与内存中直接操作变量相比,Redis 并无优势甚至更慢。
其实也很好理解,以存储用户点赞数(视频 id 和点赞个数键值对形式)为例
视频id,点赞个数键值对格式来存储
- 使用hash map直接操作内存
- 使用redis是先通过网络,再操作内存
这两者各有优缺点:
如果追求存储快,那肯定是直接操作内存的hash map 快,redis再快也是要通过网络,再来操作内存的。
如果想实现数据单独存储(或者持久化存储),那就使用redis,即便应用服务器重启,数据也不会丢失。而hash map在内存上,服务重启就直接没了。
具体情况具体分析,围绕在特定场景下是否选择使用 Redis
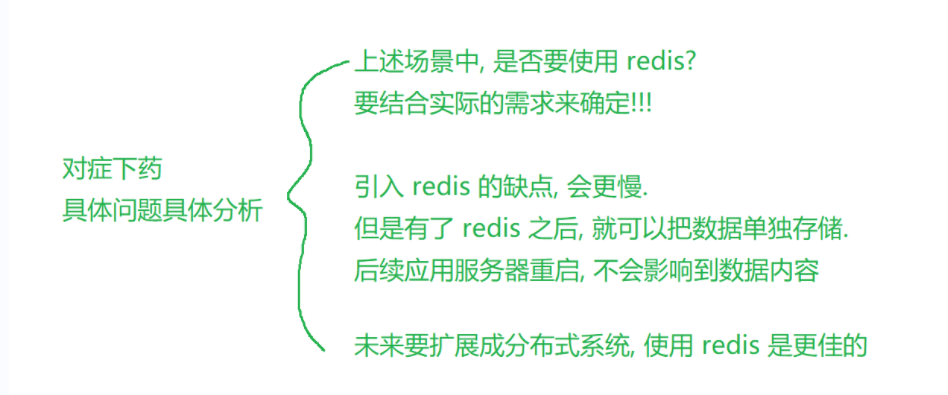
最后强调,引入任何技术都要权衡利弊,清楚其能解决的问题和带来的新问题,不能盲目使用,避免陷入 “锤子思维”(即过度依赖某种技术.)
三.初识 Redis
Redis 是一种基于键值对(key - value)的 NoSQL 数据库,与很多键值对数据库不同的是,Redis 中的值不仅可以是字符串,而且还可以是具体的数据结构,如 string(字符串)、hash(哈希)、list(列表)、set(集合)、zset(有序集合)等。Redis 会将所有数据都存放在内存中,所以读写性能非常惊人,官方给出的数字是读写性能可以达到 10 万 / 秒。不仅如此,Redis 还可以将内存的数据利用快照和日志的形式保存到硬盘上,这样在发生类似断电或者机器故障的时候,内存中的数据不会 “丢失”。除了上述功能以外,Redis 还提供了键过期、发布订阅、事务、流水线、Lua 脚本等附加功能。
2008 年,Redis 的作者 Salvatore Sanfilippo 在开发一个叫 LLOOGG 的网站时,需要实现一个高性能的队列功能,最开始是使用 MySQL 来实现的,但后来发现无论怎么优化 SQL 语句等都不能使网站的性能提高上去,再加上自己囊中羞涩,于是他决定自己做一个专属于 LLOOGG 的数据库,这个就是 Redis 的前身。后来,Salvatore Sanfilippo 将 Redis 1.0 的源码发布到 Github 上,可能连他自己都没想到,Redis 后来如此受欢迎。
从 Redis 的官方公司统计来看,有很多重量级的公司都在使用 Redis,如国外的 Twitter、Instagram、Stack Overflow、Github 等,国内就更多了,如果单单从体量来统计,新浪微博可以说是全球最大的 Redis 使用者,除了新浪微博,还有像阿里巴巴、腾讯、搜狐、优酷土豆、美团、小米、唯品会等公司都是 Redis 的使用者。除此之外,许多开源技术像 ELK 等已经把 Redis 作为它们组件中的重要一环,而且 Redis 还提供了模块系统让第三方人员实现功能扩展,让 Redis 发挥出更大的威力。
举一个栗子~:
以电商系统为例,在电商大促期间,大量用户会同时访问商品详情页。此时,Redis 可以将商品的基本信息(如名称、价格、库存等)以键值对的形式存储在内存中。因为 Redis 读写速度极快,能在瞬间响应大量请求,快速返回商品数据,让用户流畅地浏览商品。当商品库存发生变化时,利用 Redis 的持久化功能,将库存数据及时保存到硬盘,确保数据不会因服务器故障而丢失。同时,电商系统还可以利用 Redis 的发布订阅功能,当商品库存不足时,向相关部门(如采购、运营)发送通知;利用键过期功能,设置商品缓存的过期时间,保证数据的实时性。
2.1.2Redis 的 8 大核心特性
速度快:基于内存存储、C 语言实现、单线程模型(避免线程竞争)、源码优化,是高性能的核心原因。
多数据结构:支持 5 种基础结构及衍生类型,灵活适配不同场景。
功能丰富:键过期、发布订阅、Lua 脚本、事务、流水线(Pipeline)等。
简单稳定:源码量少(早期约 2 万行)、单线程模型简化设计、不依赖系统类库,稳定性强。
多客户端支持:兼容主流编程语言(C、Java、Python 等)。
持久化:通过 RDB 和 AOF 将内存数据保存到硬盘,防止数据丢失。
主从复制:实现数据副本,为分布式架构奠定基础。
高可用与分布式:哨兵(Sentinel)实现故障自动转移,集群(Cluster)支持高可用和扩展。
2.1.3Redis 可以做什么
Redis 的典型应用场景包括:
缓存(Cache):缓存机制几乎在所有大型网站都有使用,合理使用缓存可加速数据访问速度,降低后端数据源压力。Redis 支持键过期时间设置、灵活控制最大内存及内存溢出淘汰策略,是网站稳定的重要保障。
排行榜系统:几乎所有网站都有排行榜(如热度、时间、复杂维度排名),Redis 的列表(list)和有序集合(zset)能方便地构建这类系统。
计数器应用:视频播放数、电商浏览数等需要实时计数的场景,Redis 天然支持高效计数,能应对高并发挑战。
社交网络:赞 / 踩、粉丝、共同好友、推送等功能,Redis 的数据结构能轻松实现,适合高访问量场景。
消息队列系统:作为大型网站的基础组件,消息队列可实现业务解耦、非实时业务削峰。Redis 的发布订阅和阻塞队列功能能满足一般需求(虽不及专业消息队列强大)。
举个例子~:
1. 缓存:电商商品详情页
在电商系统中,商品详情(名称、价格、库存)是用户高频访问的数据。如果每次都从 MySQL 查询,会导致数据库压力过大。
用 Redis 缓存商品详情,键为 product:1001(1001 为商品 ID),值为序列化的商品信息,设置 1 小时过期时间。
用户访问时先查 Redis,命中则直接返回;未命中再查 MySQL,同时写入 Redis。
这样既能让用户快速看到商品信息,又能减少 MySQL 访问量,尤其适合大促期间的流量高峰。
2. 排行榜:音乐平台热歌榜
音乐 App 的 “热歌榜” 需要按播放量实时排序,用 Redis 的有序集合(zset)可轻松实现:
键为 hot_songs,成员为歌曲 ID,分数为播放量。
每播放一次歌曲,执行 ZINCRBY hot_songs 1 song:10086(播放量 +1)。
展示 Top 10 时,用 ZREVRANGE hot_songs 0 9 WITHSCORES 即可获取播放量最高的 10 首歌,无需自己写排序逻辑。
3. 计数器:视频网站播放量
视频网站需要实时显示每部视频的播放次数,高并发下传统数据库容易卡顿:
用 Redis 的 INCR 命令,键为 video:play:2023(2023 为视频 ID),每次播放执行 INCR video:play:2023。
该命令原子性强,即使上万人同时播放,也能保证计数准确,性能远超 MySQL 的 UPDATE ... +1。
4. 社交网络:用户粉丝关系
在社交系统中,存储用户 A 的粉丝列表:
用集合(set),键为 user:100:fans(100 为用户 ID),成员为粉丝的用户 ID。
新增粉丝执行 SADD user:100:fans 200(200 为粉丝 ID),取共同好友用 SINTER user:100:fans user:200:fans,高效又简洁。
5. 消息队列:订单状态通知
电商订单支付后,需要通知物流、积分系统等处理后续流程:
用列表(list)作为队列,键为 order:queue,订单支付后执行 LPUSH order:queue "order:10086"。
物流系统用 BRPOP order:queue 0 阻塞获取订单,处理完再消费下一个,实现业务解耦,避免某一环节故障影响整体流程。
2.1.4Redis不适合做什么
Redis 虽然强大,但并非 “万能钥匙”。就像再锋利的刀也不适合用来拧螺丝,Redis 也有不擅长的场景。本节从数据规模和数据冷热两个角度,聊聊哪些情况不适合用 Redis。
Redis 不是万金油,其局限性主要体现在:
数据规模角度:Redis 数据存于内存,若数据量极大(如每天几亿条用户行为数据),用 Redis 存储会导致内存成本过高,如同 “无底洞”。
数据冷热角度:数据分热数据(频繁操作)和冷数据(极少访问)。冷数据(如用户观看记录)存于 Redis 是内存浪费,热数据(如视频基本信息)才适合用 Redis 加速读写。
举个栗子~:
1. 大规模冷数据:短视频平台的用户观看记录
某短视频平台每天有 10 亿条用户观看记录(如 “用户 A 看了视频 B 10 秒”),这类数据特点是:
规模极大:每天 10 亿条,每月可达 300 亿条,存内存需要海量服务器,成本高到离谱;
属于冷数据:99% 的记录用户不会再查看(谁会天天翻自己半年前看过的短视频?)。
正确做法:用 HBase 或 ClickHouse 等分布式数据库存储,它们适合海量冷数据,且成本远低于 Redis。
2. 数据规模远超内存上限:社交平台的全量消息记录
某社交软件有 10 亿用户,每人平均 1 万条聊天记录,总数据量达 10 万亿条。若用 Redis 存储:
即使每条记录仅占 100 字节,总内存也需要 10 万亿 × 100 字节 = 1 万亿 KB ≈ 10PB,这在硬件上几乎不可能实现。
正确做法:核心聊天记录(近 3 个月)用 Redis 缓存,全量记录存在 MongoDB 等适合海量存储的数据库。
Redis 的核心价值是 “加速热数据的读写”,而非 “存储所有数据”。使用时需牢记:
数据规模小、访问频繁 → 适合用 Redis;
数据规模大、访问极少 → 坚决不用 Redis;
2.2单机架构:小而美的起点
初期业务刚起步,用户访问量少,系统架构简单,一台服务器即可承担所有工作:应用服务(处理用户、商品、交易逻辑)和数据库服务(存储用户、商品、交易数据)都部署在同一台机器上。这种架构无需复杂运维,适合快速上线验证业务。图片中提到,单机架构中,一台服务器同时运行应用程序(如用 Spring 或 cpp-httplib 编写的 HTTP 服务)和 MySQL 数据库,承担所有用户请求。
举个栗子~:
假设我们刚上线一个小型电商平台,每天只有几百个用户访问。此时用一台服务器就足够:
应用服务处理用户注册、商品浏览、下单等逻辑;
MySQL 数据库存储商品信息(如 “商品信息” 的名称、价格)、用户订单等数据;
所有请求都在这台机器上完成,无需网络通信开销。
这种架构就像街角的 “一人小店”,老板既收银又理货,效率高且成本低
2.3模块协作的分布式系统
系统中的多个模块被部署在不同服务器之上,这些模块通过网络通信配合完成任务,即构成分布式系统。例如 Web 服务器与数据库分别部署在不同服务器,或多台 Web 服务器分散在不同服务器,它们通过网络协同工作。
某电商平台业务增长后,将系统拆分为多个模块并部署在不同服务器:
Web 服务器集群部署在多台机器,负责接收用户的商品浏览、下单请求;
数据库服务器单独部署,存储用户信息、商品库存和订单数据;
缓存服务器另设一台,存储热门商品信息以加速访问。
这些模块通过网络传递数据(如 Web 服务器向数据库请求商品库存,向缓存服务器获取热门商品数据),共同完成用户的购物流程。
这种架构就像一个分散在多个城市的工作小组,通过远程协作完成项目,各场地间的沟通依靠网络实现。

汇聚全球AI编程工具,助力开发者即刻编程。
更多推荐

 3
 0
- 0


 已为社区贡献1条内容

所有评论(0)