
关于redis主从复制的全量同步和增量同步实现细节
redis的主从复制
完全同步
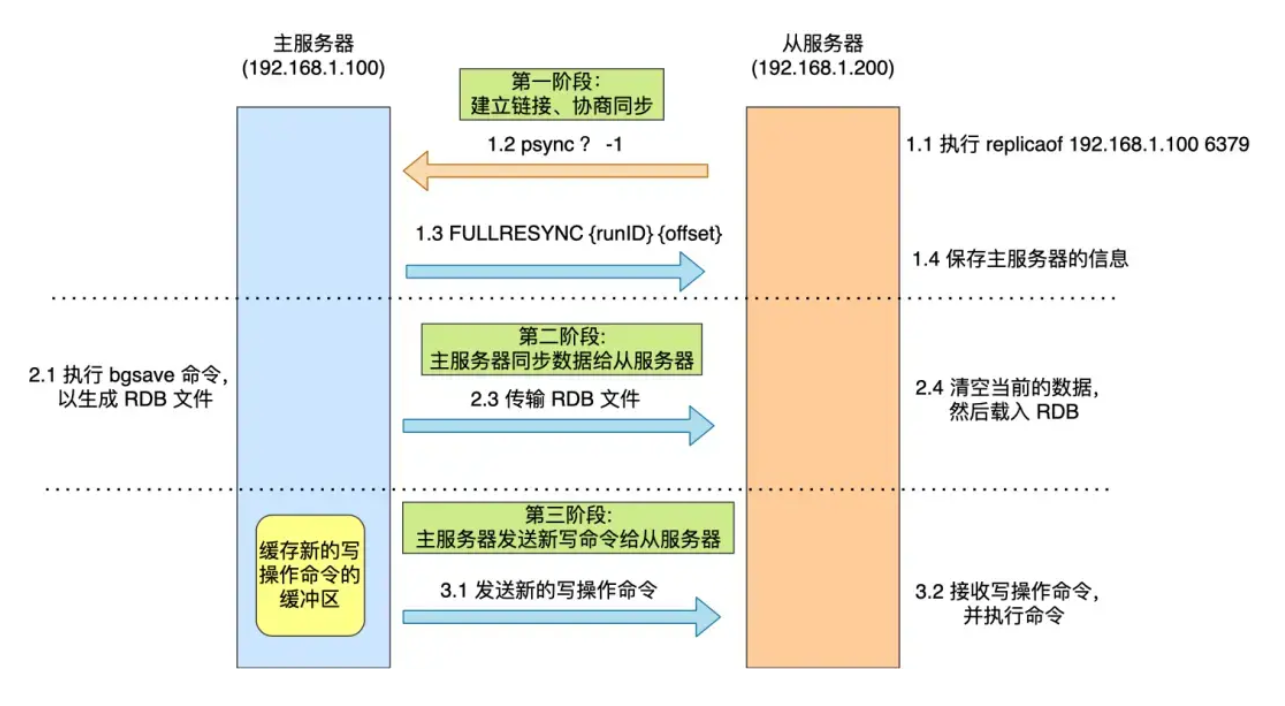
以下是结合流程图,对Redis主从全量同步每一步的详细拆解说明,包含各环节主从节点的具体行为:
实现细节
阶段一:建立连接与协商同步(从节点主动发起,主节点响应协商)
-
从节点发起同步请求
- 从节点执行
replicaof 192.168.1.100 6379(或旧版slaveof),向主节点(IP:192.168.1.100,端口:6379)主动发起同步连接,标记为“1.1 执行 replicaof 命令”。 - 连接建立后,从节点发送
PSYNC ? -1命令(?表示未知主节点运行ID,-1表示需要全量同步),即“1.2 psync ? -1” 。
- 从节点执行
-
主节点响应全量同步指令
- 主节点收到
PSYNC请求,因从节点是首次连接(或偏移量无效),返回FULLRESYNC {runID} {offset},其中runID是主节点唯一标识,offset是当前主节点复制偏移量,对应“1.3 FULLRESYNC {runID}{offset}” 。
- 主节点收到
-
从节点记录主节点信息
- 从节点接收主节点响应后,保存主节点的
runID和offset,用于后续增量同步校验,也就是“1.4 保存主服务器的信息” ,完成连接协商,确定进入全量同步流程。
- 从节点接收主节点响应后,保存主节点的
阶段二:主节点生成并传输全量数据(主节点主动触发,从节点接收加载)
-
主节点生成全量RDB文件
- 主节点执行
bgsave命令(对应“2.1 执行 bgsave 命令,以生成 RDB 文件” ),会 fork 一个子进程专门进行 RDB 持久化:- 父进程(主节点服务)继续处理客户端请求,不阻塞;
- 子进程遍历内存数据、写入磁盘生成 RDB 文件(如
dump.rdb)。
- 主节点执行
-
主节点传输RDB文件给从节点
- 主节点子进程生成 RDB 文件后,主节点将该文件通过网络发送给从节点(“2.3 传输 RDB 文件” ),此过程依赖网络IO,大文件传输会受带宽、延迟影响。
-
从节点接收并清空旧数据
- 从节点开始接收 RDB 文件,同时执行“2.4 清空当前的数据” :
- 先删除自身内存中已有的键值对(保证数据纯净,避免与即将加载的 RDB 冲突 );
- 待 RDB 文件接收完成,执行“然后载入 RDB” ,将 RDB 内容反序列化、加载到自身内存,完成全量数据初始化。
- 从节点开始接收 RDB 文件,同时执行“2.4 清空当前的数据” :
阶段三:同步增量操作(主节点缓存新操作,从节点追平数据)
-
主节点缓存新写操作(关键“中间态”处理)
- 在主节点执行
bgsave、传输 RDB 期间,若有客户端新写操作(如SETINCR等),主节点会将这些命令缓存到 “复制客户端缓冲区”(也叫复制积压缓冲区 ),本质是一段内存空间,用于暂存“主节点在 RDB 生成/传输阶段产生的增量操作”。
- 在主节点执行
-
从节点加载完成,主节点发送增量指令
- 从节点加载完 RDB 后,主动向主节点确认“已准备好接收增量”;
- 主节点将复制缓冲区中缓存的新写操作,发送给从节点(对应“3.1 发送新的写操作命令” ),保证从节点追平主节点在 RDB 生成期间的新数据。
-
从节点执行增量指令
- 从节点接收主节点发送的增量命令,逐句执行(“3.2 接收写操作命令,并执行命令” ),最终实现:
- 从节点内存数据 = 主节点 RDB 全量数据 + 主节点缓存的增量操作,完成主从数据对齐。
- 从节点接收主节点发送的增量命令,逐句执行(“3.2 接收写操作命令,并执行命令” ),最终实现:
补充细节说明
-
bgsave为何不阻塞?
主节点用fork子进程生成 RDB,父进程仍可处理客户端请求,但fork瞬间会有短暂“内存页复制”开销(大内存实例可能卡顿,需关注latency monitor)。 -
复制缓冲区会溢出吗?
会!若从节点加载 RDB 耗时过长(如 RDB 过大、从节点性能差 ),主节点缓存的增量命令会填满缓冲区(默认大小有限),触发client-output-buffer-limit策略,可能导致:- 缓冲区溢出,主节点断开与从节点连接;
- 从节点同步失败,需重新触发全量同步,极端场景下形成“同步循环”。
-
从节点加载 RDB 时,客户端访问会怎样?
从节点加载 RDB 是阻塞操作(单线程执行 ),若此时有客户端访问:- 默认(
slave-server-stale-data yes)返回旧数据(可能已被清空,实际是“空数据”或加载中的中间状态,存在一致性风险 ); - 若配置
slave-server-stale-data no,直接返回LOADING错误,强制客户端等待加载完成。
- 默认(
这一套流程,核心解决 “主从节点初始数据不一致” 问题,通过“全量 RDB 打底 + 增量命令追平”,让从节点最终与主节点数据一致;但过程中“RDB 生成/传输”“缓冲区溢出风险”“从节点加载阻塞”,也是 Redis 主从同步性能优化、稳定性保障的关键痛点。
深度补充
以下从技术细节补充、异常场景说明、优化与替代方案三个维度,对 Redis 主从全量同步流程做更深入补充,帮你更透彻理解底层逻辑:
一、技术细节补充(深入到 Redis 内核、内存/IO 行为)
1. bgsave 深度拆解(主节点 fork 与内存机制)
-
fork本质是“写时复制(Copy-On-Write)”
主节点执行bgsave时,fork子进程不会立刻复制所有内存页:- 初始仅复制页表(记录内存地址映射关系,极小),父子进程共享物理内存;
- 若主进程(父进程)处理新写操作,会复制被修改的内存页(如某 key 被
SET覆盖),子进程仍保留原页数据,保证 RDB 生成不受新操作干扰。 - 极端场景(主节点高频写):
fork后父子进程内存差异大,子进程生成 RDB 耗时会显著增加,甚至触发rdb_bgsave_slow日志告警。
-
bgsave对主节点性能的“隐性影响”
虽然bgsave用子进程生成 RDB,但:- 磁盘 IO 竞争:子进程写 RDB 文件到磁盘,若主节点同时有 AOF 刷盘、大 key 淘汰等操作,会放大磁盘 IO 压力;
- CPU 缓存失效:
fork可能打乱 CPU 缓存(如 L1/L2 缓存被刷新),短暂影响主节点处理客户端请求的 latency(延迟)。
2. RDB 传输与从节点加载的“底层行为”
-
从节点接收 RDB 的“分阶段校验”
从节点并非直接接收 RDB 就加载:- 先校验 RDB 文件魔数(
REDIS标识)、版本号,若不匹配直接断开连接; - 校验文件完整性(CRC64 校验),防止网络传输中文件损坏导致数据错误。
- 先校验 RDB 文件魔数(
-
从节点加载 RDB 的“内存分配策略”
从节点加载 RDB 时,会:- 预先估算内存需求(根据 RDB 中键值对数量、类型),若自身剩余内存不足,可能触发 内存淘汰策略(如
allkeys-lru),但因此时从节点已清空旧数据,实际是“为加载 RDB 预留空间”; - 对大 key(如巨型字符串、超大规模哈希表),反序列化时会一次性分配大块连续内存,可能引发系统
swap(若物理内存不足 ),导致加载耗时陡增。
- 预先估算内存需求(根据 RDB 中键值对数量、类型),若自身剩余内存不足,可能触发 内存淘汰策略(如
3. 复制缓冲区的“双重角色”
-
复制缓冲区 vs 复制积压缓冲区(易混淆概念)
- 你提到的“复制客户端缓冲区”,更准确叫 复制积压缓冲区(
repl_backlog),是主节点全局维护的一段环形缓冲区:- 大小由
repl-backlog-size控制(默认 1MB ),存储主节点近期执行的写命令; - 从节点若因网络闪断等短暂失联,可通过
PSYNC <runID> <offset>,直接从积压缓冲区获取增量命令,避免全量同步(这也是“部分同步”的核心依赖 )。
- 大小由
- 而“客户端输出缓冲区”(
client-output-buffer-limit)是主节点为每个从节点连接单独分配的内存,用于暂存待发送给从节点的命令,若从节点消费慢(如加载 RDB 过久 ),会先占满该缓冲区,触发主节点断开连接。
- 你提到的“复制客户端缓冲区”,更准确叫 复制积压缓冲区(
-
缓冲区溢出的连锁反应
若从节点加载 RDB 耗时过长 → 主节点“客户端输出缓冲区”先被填满 → 触发hard limit(如配置client-output-buffer-limit slave 256mb 512mb 60,超过 512MB 或持续 60 秒占满 )→ 主节点强制关闭与从节点连接 → 从节点重新发起PSYNC,但因主节点复制积压缓冲区可能已覆盖旧offset→ 再次触发全量同步,形成“同步死循环”。
二、异常场景与边界情况(生产环境易踩坑点)
1. 主节点 bgsave 失败(直接阻断全量同步)
- 触发条件:
- 主节点内存不足(
fork时无法分配足够内存页 ); - 磁盘满(无法写入 RDB 文件 );
- 达到
save策略限制(如save 900 1但 15 分钟内无 1 次写操作,bgsave被跳过 )。
- 主节点内存不足(
- 现象:主节点返回
ERR Can't BGSAVE,从节点同步失败,日志报错Master can't BGSAVE,需人工干预(修复磁盘、调整save策略等 )。
2. 从节点加载 RDB 时的“隐性阻塞”
- 场景:从节点配置
slave-read-only no(允许从节点写 ),但加载 RDB 时若有客户端写入:- 从节点单线程会先处理 RDB 加载(高优先级 ),客户端写操作被阻塞,直到 RDB 加载完成;
- 若 RDB 加载耗时 10 秒,客户端会看到 10 秒超时,引发业务报错。
3. 跨版本/跨架构同步风险
- 版本差异:
- Redis 7.0+ 引入模块化、多线程 IO ,若主节点是 7.0 ,从节点是 6.2 ,RDB 中部分新数据类型(如
JSON模块数据 )可能无法被从节点解析,导致加载失败。
- Redis 7.0+ 引入模块化、多线程 IO ,若主节点是 7.0 ,从节点是 6.2 ,RDB 中部分新数据类型(如
- 架构差异:
- 主节点是 64 位系统,从节点是 32 位系统,若 RDB 中存在超过 32 位寻址范围的大 key ,从节点加载时会因内存不足崩溃。
4. 无盘复制的“半吊子”问题(repl-diskless-sync yes )
- 主节点开启无盘复制后,
bgsave生成的 RDB 不落地磁盘,直接通过网络发送给从节点:- 优点:减少主节点磁盘 IO,适合 SSD 性能差的环境;
- 缺点:
- 主节点
fork子进程后,需持续占用内存(不能释放 RDB 内存 ),直到从节点加载完成,增加主节点内存压力; - 不支持“断点续传”,网络中断后需重新全量同步;
- 生产环境遇到过“从节点因网络波动反复重传,拖垮主节点带宽”的案例,稳定性不如传统磁盘复制。
- 主节点
三、优化与替代方案(让同步更稳定、高效)
1. 缩短全量同步耗时的核心手段
-
优化
bgsave效率:- 升级主节点磁盘(用 NVMe SSD 替代 SATA ),降低 RDB 落盘耗时;
- 开启
rdb-compression yes(默认开启 ),用 LZF 算法压缩 RDB,减少传输体积(CPU 消耗 vs 带宽节省的权衡 ); - 避开业务高峰触发
bgsave,通过redis-cli手动在低峰期执行同步。
-
加速从节点 RDB 加载:
- 从节点预分配大页内存(
echo never > /sys/kernel/mm/transparent_hugepage/enabled关闭透明大页,避免加载时内存碎片化 ); - 对巨型 RDB,拆分主节点数据(如按业务模块分库 ),减少单 RDB 文件大小。
- 从节点预分配大页内存(
2. 替代全量同步的思路(适用于超大规模集群)
-
冷热数据分离:
- 主节点只保留热点数据,冷数据迁移到 Redis 集群外(如 SSD 、对象存储 ),降低 RDB 大小;
- 从节点通过定时任务批量拉取冷数据,避免全量同步时传输冗余数据。
-
基于快照的增量同步(非官方黑科技):
- 借助外部工具(如
redis-rdb-tools解析 RDB 差异 ),对比主从 RDB 差异,仅同步变化的键值对,跳过全量传输; - 适合“主从数据差异小,但因网络波动频繁触发全量同步”的场景。
- 借助外部工具(如
3. 监控与告警的“救命指标”
-
必盯指标(通过
INFO replicationINFO persistence查看 ):指标名 含义 & 异常阈值 作用 rdb_last_bgsave_time_sec> 30 秒(大内存实例可放宽到 60 ) 主节点 bgsave耗时,过长说明内存/Fork 有问题slave_repl_offset主从 offset差距 > 10000从节点追平主节点的延迟,过大说明同步卡壳 client_output_buffer_slave_peaked> 主节点内存 20% 从节点连接的输出缓冲区峰值,过大有溢出风险 aof_rewrite_in_progress(从节点)持续时间 > 60 秒 从节点加载 RDB 后触发 AOF 重写,过长会阻塞同步 -
告警逻辑示例:
rdb_last_bgsave_time_sec > 60→ 主节点bgsave异常,可能引发全量同步超时;slave_repl_offset主从差距持续 5 分钟 > 10MB → 从节点同步卡住,需排查网络/缓冲区。
通过补充这些细节,能更清晰看到 Redis 主从同步“美丽的流程”下,暗藏的 内存博弈(fork 、缓冲区 )、IO 瓶颈(RDB 落盘/传输 )、异常边界(版本、架构差异 )。生产环境中,主从同步失败往往不是“流程没走通”,而是这些隐性细节没处理好,导致看似简单的同步流程,成为集群稳定性的“阿喀琉斯之踵”。
增量同步
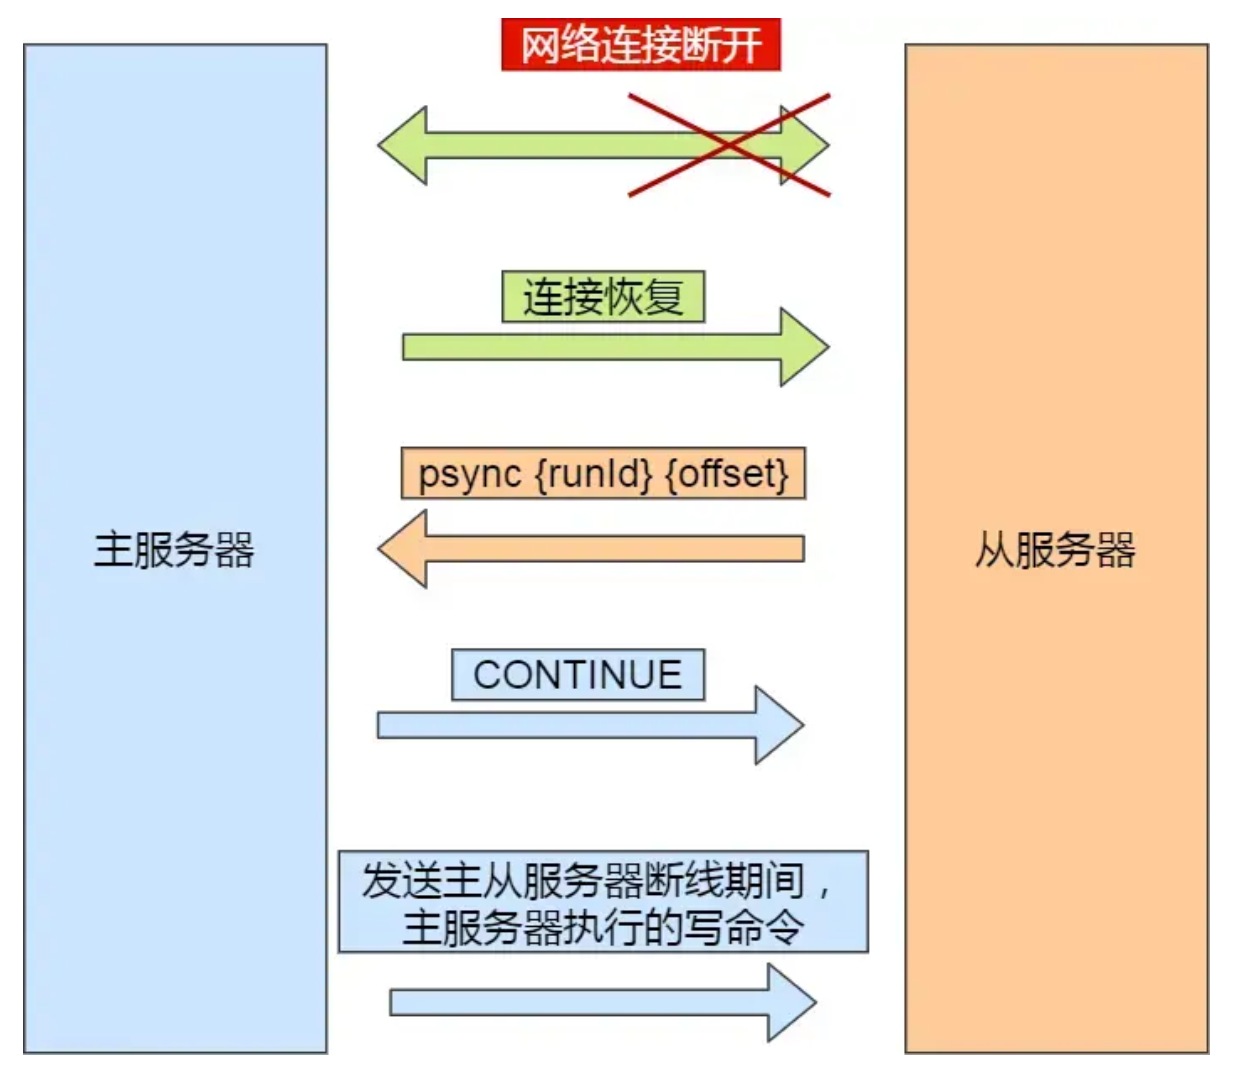
这是 Redis 主从增量同步(部分重同步)流程,描述主从连接断开后恢复时,如何通过 PSYNC 机制快速同步增量数据,核心步骤解析:
以下是对 Redis 主从部分重同步(增量同步)流程更细致的拆解,包含每个步骤主从节点的具体行为、依赖的核心机制和潜在问题:
一、流程触发条件(“网络断开-恢复”的完整闭环)
-
网络正常阶段
- 主从节点维持心跳(通过
REPLCONF ACK {offset}命令,从节点周期性向主节点汇报自身同步偏移量 )。 - 主节点将写命令同时写入 复制积压缓冲区(
repl_backlog,环形内存缓冲区,默认 1MB ,可通过repl-backlog-size调整 )。
- 主从节点维持心跳(通过
-
网络断开(触发条件)
- 因网络抖动、主从节点负载过高等,从节点无法发送
REPLCONF ACK,主节点超过repl-timeout(默认 60 秒 )未收到响应,标记从节点“失联”。 - 主节点继续处理写命令,新操作持续写入
repl_backlog,但因从节点失联,不再向其同步。
- 因网络抖动、主从节点负载过高等,从节点无法发送
二、重连后增量同步的逐步骤拆解
步骤1:网络恢复,从节点发起重连
- 从节点检测到网络恢复,主动尝试与主节点建立 TCP 连接(基于原
replicaof/slaveof配置的主节点地址 )。 - 连接建立后,从节点读取本地记录的 主节点
runID(runID是主节点启动时生成的唯一标识符,类似“身份 ID” )和 最后同步的offset(记为slave_repl_offset)。
步骤2:从节点发送 PSYNC {runID} {offset} 请求
- 从节点向主节点发送
PSYNC <runID> <offset>命令:runID:用于主节点校验“从节点是否曾连接过自己”(防止连错主节点 )。offset:从节点断开前最后确认的同步偏移量,主节点需判断该偏移量是否在repl_backlog范围内。
步骤3:主节点校验请求,决定是否支持增量同步
-
校验
runID:
主节点对比自身runID与从节点发送的runID:- 若不一致(如主节点重启过,
runID改变 ),直接拒绝增量同步,触发全量同步(返回FULLRESYNC)。 - 若一致,进入
offset校验。
- 若不一致(如主节点重启过,
-
校验
offset:
主节点检查repl_backlog中是否包含从节点发送的offset:- 若
offset在repl_backlog的有效范围内(即断开期间的增量命令仍在缓冲区 ),主节点返回CONTINUE,进入增量同步。 - 若
offset超出repl_backlog范围(如断开时间过长,积压缓冲区被新命令覆盖 ),主节点拒绝增量同步,触发全量同步(返回FULLRESYNC)。
- 若
步骤4:主节点准备增量命令,从节点执行同步
-
主节点发送积压命令:
主节点从repl_backlog中,找到从节点offset之后的所有命令(即“断开期间主节点执行的写命令” ),按顺序发送给从节点。 -
从节点执行命令:
从节点接收命令后,逐句执行(如SET key valueINCR counter等 ),更新自身内存数据,逐步追平主节点的offset。
步骤5:恢复心跳,持续增量同步
- 从节点执行完积压命令后,恢复周期性发送
REPLCONF ACK {new_offset}给主节点,汇报当前同步偏移量。 - 主节点收到
REPLCONF ACK后,确认从节点已追平,恢复正常增量同步流程(新写命令实时发送给从节点 )。
三、核心机制与依赖的“底层支撑”
1. 复制积压缓冲区(repl_backlog)的细节
-
环形缓冲区的工作原理:
- 缓冲区有两个指针:
head(读指针,从节点消费命令的位置 )和tail(写指针,主节点写入命令的位置 )。 - 当
tail追上head(缓冲区写满 ),新写入的命令会覆盖最旧的命令(类似“环形队列” )。
- 缓冲区有两个指针:
-
缓冲区大小的影响:
- 若
repl-backlog-size过小(如默认 1MB ),主从断开时间稍长(如 1 分钟 ),repl_backlog就会被新命令覆盖,导致offset失效,触发全量同步。 - 若业务中主从网络不稳定,建议调大
repl-backlog-size(如 100MB ),但会增加主节点内存占用。
- 若
2. repl-timeout 的“临界作用”
repl-timeout是主节点判断从节点“是否失联”的超时时间:- 若从节点超过
repl-timeout未发送REPLCONF ACK,主节点标记从节点为“失联”,停止向其同步新命令。 - 若从节点重连时间超过
repl-timeout,即使repl_backlog有有效数据,主节点也可能误判为“全量同步”(因超时后主节点会清理从节点连接的输出缓冲区 )。
- 若从节点超过
3. runID 的“身份校验”逻辑
runID是主节点启动时随机生成的 40 位字符串(如f9b9d2c3d8e7a6b5c4d3e2f1a0b9c8d7e6f5a4b),重启后改变。- 若主节点重启,从节点保存的旧
runID失效,即使repl_backlog有数据,也会因runID校验失败,触发全量同步。
四、异常场景与解决方案
1. 积压缓冲区溢出,触发全量同步
-
现象:
从节点断开时间过长 →repl_backlog被新命令覆盖 → 主节点返回FULLRESYNC→ 从节点重新全量同步(耗时、耗资源 )。 -
解决方案:
- 调大
repl-backlog-size(如repl-backlog-size 100mb),延长缓冲区覆盖时间。 - 监控
repl_backlog_histlen(INFO replication中查看,代表积压缓冲区当前存储的命令长度 ),若接近repl-backlog-size,及时扩容。
- 调大
2. 主节点重启,runID 改变
-
现象:
主节点重启 →runID改变 → 从节点PSYNC因runID不匹配,触发全量同步。 -
解决方案:
- 若主节点是“无状态”(如使用 Redis Cluster 或哨兵切换 ),从节点需重新执行
replicaof绑定新主节点。 - 业务层需兼容“主节点重启后从节点全量同步”的耗时,或通过 Redis 高可用方案(如哨兵、Cluster )自动切换主节点,减少人工干预。
- 若主节点是“无状态”(如使用 Redis Cluster 或哨兵切换 ),从节点需重新执行
3. 从节点执行命令失败(数据冲突)
-
现象:
主从断开期间,若从节点本地有“未同步的写操作”(如从节点开启slave-read-write),重连后执行主节点积压命令时,可能因键冲突(如SET key冲突 )导致同步失败。 -
解决方案:
- 严格限制从节点为
slave-read-only yes(默认推荐配置 ),禁止从节点写操作。 - 若业务需要从节点可写,通过发布订阅(Pub/Sub )或外部队列同步写操作,避免主从数据冲突。
- 严格限制从节点为
五、与全量同步的对比(为什么增量同步更高效)
| 对比项 | 全量同步(FULLRESYNC) | 增量同步(CONTINUE) |
|---|---|---|
| 核心操作 | 主节点 bgsave 生成 RDB,从节点加载 RDB | 主节点发送积压命令,从节点执行命令 |
| 耗时环节 | RDB 生成、传输、加载(秒级~分钟级) | 积压命令传输、执行(毫秒级~秒级) |
| 资源消耗 | 主节点 CPU(bgsave)、磁盘 IO(RDB 落盘) | 主从网络 IO(命令传输) |
| 触发条件 | 从节点首次连接、主节点 runID 改变、offset 失效 | 从节点重连,runID 一致且 offset 在积压缓冲区 |
通过这套增量同步机制,Redis 主从集群能在“网络短暂抖动”时快速恢复数据一致,避免频繁全量同步带来的性能损耗,是 Redis 高可用架构(哨兵、Cluster )的核心支撑。理解 repl_backlog、runID、offset 的交互,才能真正驾驭 Redis 主从复制的稳定性。
潜在的问题及解决方法
全量同步
Redis全量同步在实现主从数据一致性的过程中,存在一些潜在问题,以下是对这些问题及对应解决方法的分析:
1. bgsave 导致主节点阻塞问题
问题描述:
主节点执行 bgsave 命令生成RDB文件时,会通过 fork 子进程来完成。在 fork 操作期间,主节点会暂停处理客户端请求,虽然这个时间通常很短,但如果主节点内存占用很高(比如达到数GB甚至更高 ),fork 操作耗时会显著增加,可能导致主节点出现短暂的卡顿,影响服务可用性。
解决方法:
- 优化内存使用:定期清理主节点中过期的键值对,避免大key的堆积,减少主节点内存占用。例如,使用
KEYS命令结合DEL来删除过期或不再使用的大key(生产环境中需谨慎使用KEYS,可考虑使用SCAN命令 )。 - 调整硬件配置:为Redis主节点配置性能更好的CPU,尤其是支持大页内存(HugePage)的硬件环境。大页内存可以减少
fork时的内存页复制开销,降低fork操作对主节点性能的影响。 - 调整
save策略:合理设置save配置参数,减少自动bgsave的触发频率。例如,将默认的save 900 1(900秒内至少有1个写操作则触发bgsave),调整为更宽松的策略,如save 3600 1,避免在业务高峰期频繁触发bgsave。
2. RDB文件传输耗时问题
问题描述:
当RDB文件较大时,主节点将RDB文件传输给从节点会消耗较长时间。传输时间受网络带宽、文件大小等因素影响,比如一个5GB的RDB文件,在千兆网络环境下,理论传输时间约为40多秒。此外,主节点会为每个从节点单独传输RDB文件,如果存在多个从节点同时进行全量同步,可能会导致网络带宽被占满,影响其他业务的网络通信。
解决方法:
- 优化网络环境:提升主从节点之间的网络带宽,使用高速网络设备和链路,比如将千兆网络升级为万兆网络,减少文件传输时间。同时,合理规划网络拓扑,避免网络拥塞。
- 压缩RDB文件:确保Redis配置中开启RDB文件压缩(
rdbcompression yes,默认开启 ),通过LZF等压缩算法,减小RDB文件体积,从而缩短传输时间。不过,开启压缩会增加主节点的CPU消耗,需要在网络传输时间和CPU资源之间进行权衡。 - 限制并发同步:通过配置参数控制从节点的同步节奏,避免多个从节点同时触发全量同步。例如,使用
repl-backlog-ttl参数,设置从节点重连的时间间隔,让从节点分批进行同步,减轻网络和主节点的压力。
3. 从节点加载RDB文件阻塞问题
问题描述:
从节点在加载RDB文件时,会阻塞所有客户端请求,因为Redis是单线程模型。如果RDB文件非常大,从节点加载时间可能长达数秒甚至数分钟,这段时间内从节点无法响应客户端的读请求,会导致业务出现短暂的服务不可用,影响用户体验。
解决方法:
- 合理设置参数:通过配置
slave-server-stale-data no,当从节点在加载RDB文件时,客户端向从节点发起读请求,从节点会返回LOADING错误,告知客户端当前正在加载数据,避免返回旧的或不一致的数据。同时,业务端可以根据这个错误提示,将读请求暂时转发到主节点或其他可用的从节点。 - 分阶段同步:在一些对数据一致性要求不是特别高的场景下,可以采用先在离线的从节点上加载RDB文件,加载完成后再将其接入到主从集群中,然后进行增量同步,这样可以减少对在线从节点服务的影响。
- 优化硬件性能:为从节点配置性能更好的CPU和内存,提升从节点加载RDB文件的速度,减少阻塞时间。
4. 复制缓冲区溢出问题
问题描述:
在主节点执行 bgsave 以及传输RDB文件期间,如果客户端有大量的写操作,主节点会将这些写操作暂存到复制客户端缓冲区。如果从节点加载RDB文件耗时过长,复制客户端缓冲区可能会被填满,触发缓冲区溢出。当缓冲区溢出时,主节点会断开与从节点的连接,导致全量同步失败,需要重新进行同步。
解决方法:
- 调大缓冲区大小:通过
client-output-buffer-limit slave配置参数,增大主节点为从节点分配的复制客户端缓冲区大小。例如,将默认配置client-output-buffer-limit slave 256mb 512mb 60(缓冲区软限制256MB,硬限制512MB,持续60秒达到硬限制则断开连接 ),根据业务实际情况调整为更大的值,但会增加主节点的内存占用。 - 监控缓冲区使用情况:使用
INFO replication命令实时监控复制客户端缓冲区的使用情况,关注client_output_buffer_slave相关指标。当缓冲区使用量接近阈值时,及时发出告警,并采取相应措施,如加快从节点加载RDB文件的速度,或者优化主节点的写操作频率。
5. 跨版本/跨架构同步问题
问题描述:
如果主节点和从节点的Redis版本不一致,或者运行在不同的硬件架构上(如主节点是64位系统,从节点是32位系统 ),可能会出现兼容性问题。例如,高版本Redis中的一些新数据类型或特性,在低版本中不被支持,从节点在加载RDB文件时可能会出现解析错误,导致全量同步失败;不同架构对数据的存储和处理方式可能存在差异,也可能影响同步过程。
解决方法:
- 统一版本和架构:尽量确保主从节点使用相同的Redis版本,并且运行在相同的硬件架构上,避免因版本和架构差异导致的兼容性问题。
- 测试验证:在部署新的主从节点或者进行版本升级时,提前在测试环境中进行充分的兼容性测试,模拟各种数据操作场景,验证全量同步和后续的数据读写是否正常。如果发现问题,及时调整版本或采取其他兼容性解决方案,如对数据进行预处理,避免使用低版本不支持的特性。
增量同步
Redis主从部分重同步(增量同步)虽然提升了同步效率,但仍存在一些潜在问题,以下是对这些问题及解决方法的详细介绍:
1. 复制积压缓冲区溢出问题
问题描述:
复制积压缓冲区(repl_backlog)大小有限,默认是1MB, 当主从节点断开连接时间较长,或者主节点写入操作非常频繁时,复制积压缓冲区中旧的写命令会被新命令覆盖。从节点重连后,发送的偏移量(offset)可能超出缓冲区记录范围,导致主节点无法进行增量同步,只能触发全量同步。
解决方法:
- 增大缓冲区大小:根据业务写入量和允许的最大断开时间,适当调大
repl-backlog-size配置参数,比如设置为100mb,为从节点重连后进行增量同步提供更大空间,但会增加主节点内存占用。 - 监控缓冲区使用情况:通过
INFO replication命令查看repl_backlog_histlen指标(代表积压缓冲区当前存储的命令长度),若接近repl-backlog-size,及时发出告警并扩容,避免因缓冲区溢出导致全量同步。
2. 主节点重启导致 runID 改变问题
问题描述:
Redis主节点重启后,会重新生成一个新的 runID 。从节点保存的是主节点重启前的 runID ,重连时发送的 PSYNC 命令中携带的 runID 与主节点当前的 runID 不一致,主节点会拒绝增量同步,触发全量同步。
解决方法:
- 利用高可用方案自动处理:在使用Redis哨兵(Sentinel)或Redis集群(Cluster)等高可用方案时,当主节点发生故障切换,这些方案会自动处理从节点与新主节点的同步关系,减少人工干预。
- 业务层兼容处理:业务代码中增加对主从同步状态的检测,当发现主节点
runID改变导致全量同步时,合理安排业务操作,避免因同步耗时对业务造成影响,比如在全量同步期间,将对从节点的读请求适当分流或延迟处理。
3. 从节点执行积压命令失败问题
问题描述:
在主从节点断开连接期间,如果从节点开启了写操作(slave-read-only no ,不推荐的配置 ),本地可能存在与主节点积压命令冲突的数据,比如相同键的不同值。从节点重连后执行主节点发送的积压命令时,就会出现数据冲突,导致同步失败。
解决方法:
- 设置从节点为只读:确保从节点配置
slave-read-only yes,禁止从节点写操作,这样可以避免从节点本地数据与主节点积压命令产生冲突,保证增量同步的顺利进行。 - 使用外部机制同步写操作:若业务场景确实需要从节点可写,可以通过Redis的发布订阅(Pub/Sub)机制,或者外部消息队列(如Kafka)等,将从节点的写操作同步到主节点,同时保证主从数据一致性。
4. 网络延迟和抖动问题
问题描述:
网络延迟或抖动可能导致从节点发送的 PSYNC 命令丢失,或者主节点发送的积压命令在传输过程中出错、乱序,从节点可能无法及时收到主节点的 CONTINUE 响应,或者无法正确执行积压命令,从而影响增量同步的正常进行。
解决方法:
- 优化网络环境:确保主从节点之间的网络稳定,采用高速、低延迟的网络设备和链路,减少网络延迟和抖动对同步的影响。
- 增加重试机制:在从节点端,增加对
PSYNC命令发送和积压命令接收的重试逻辑。当从节点在一定时间内未收到主节点的CONTINUE响应,或者检测到积压命令执行出错时,自动重新发送PSYNC命令请求同步。
5. repl-timeout 配置不合理问题
问题描述:
repl-timeout 用于主节点判断从节点是否失联,默认值是60秒。如果设置过小,从节点可能因为短暂的网络波动,就被主节点判定为失联,导致不必要的重连和同步判断;如果设置过大,在从节点实际已经断开连接且长时间无法恢复的情况下,主节点会一直等待,浪费资源。
解决方法:
根据实际网络环境和业务容忍度,合理设置 repl-timeout 。如果网络环境较为稳定,可以适当减小该值;如果网络波动较大,且业务对主从同步短暂延迟有一定容忍度,可以适当增大该值。同时,结合监控系统,对主从节点的连接状态进行实时监测,及时发现并处理异常。

汇聚全球AI编程工具,助力开发者即刻编程。
更多推荐



 7
 0
- 0


 已为社区贡献1条内容

所有评论(0)