
YOLO11相比YOLOv8的主要改进:重点解析C2PSA注意力机制
前言
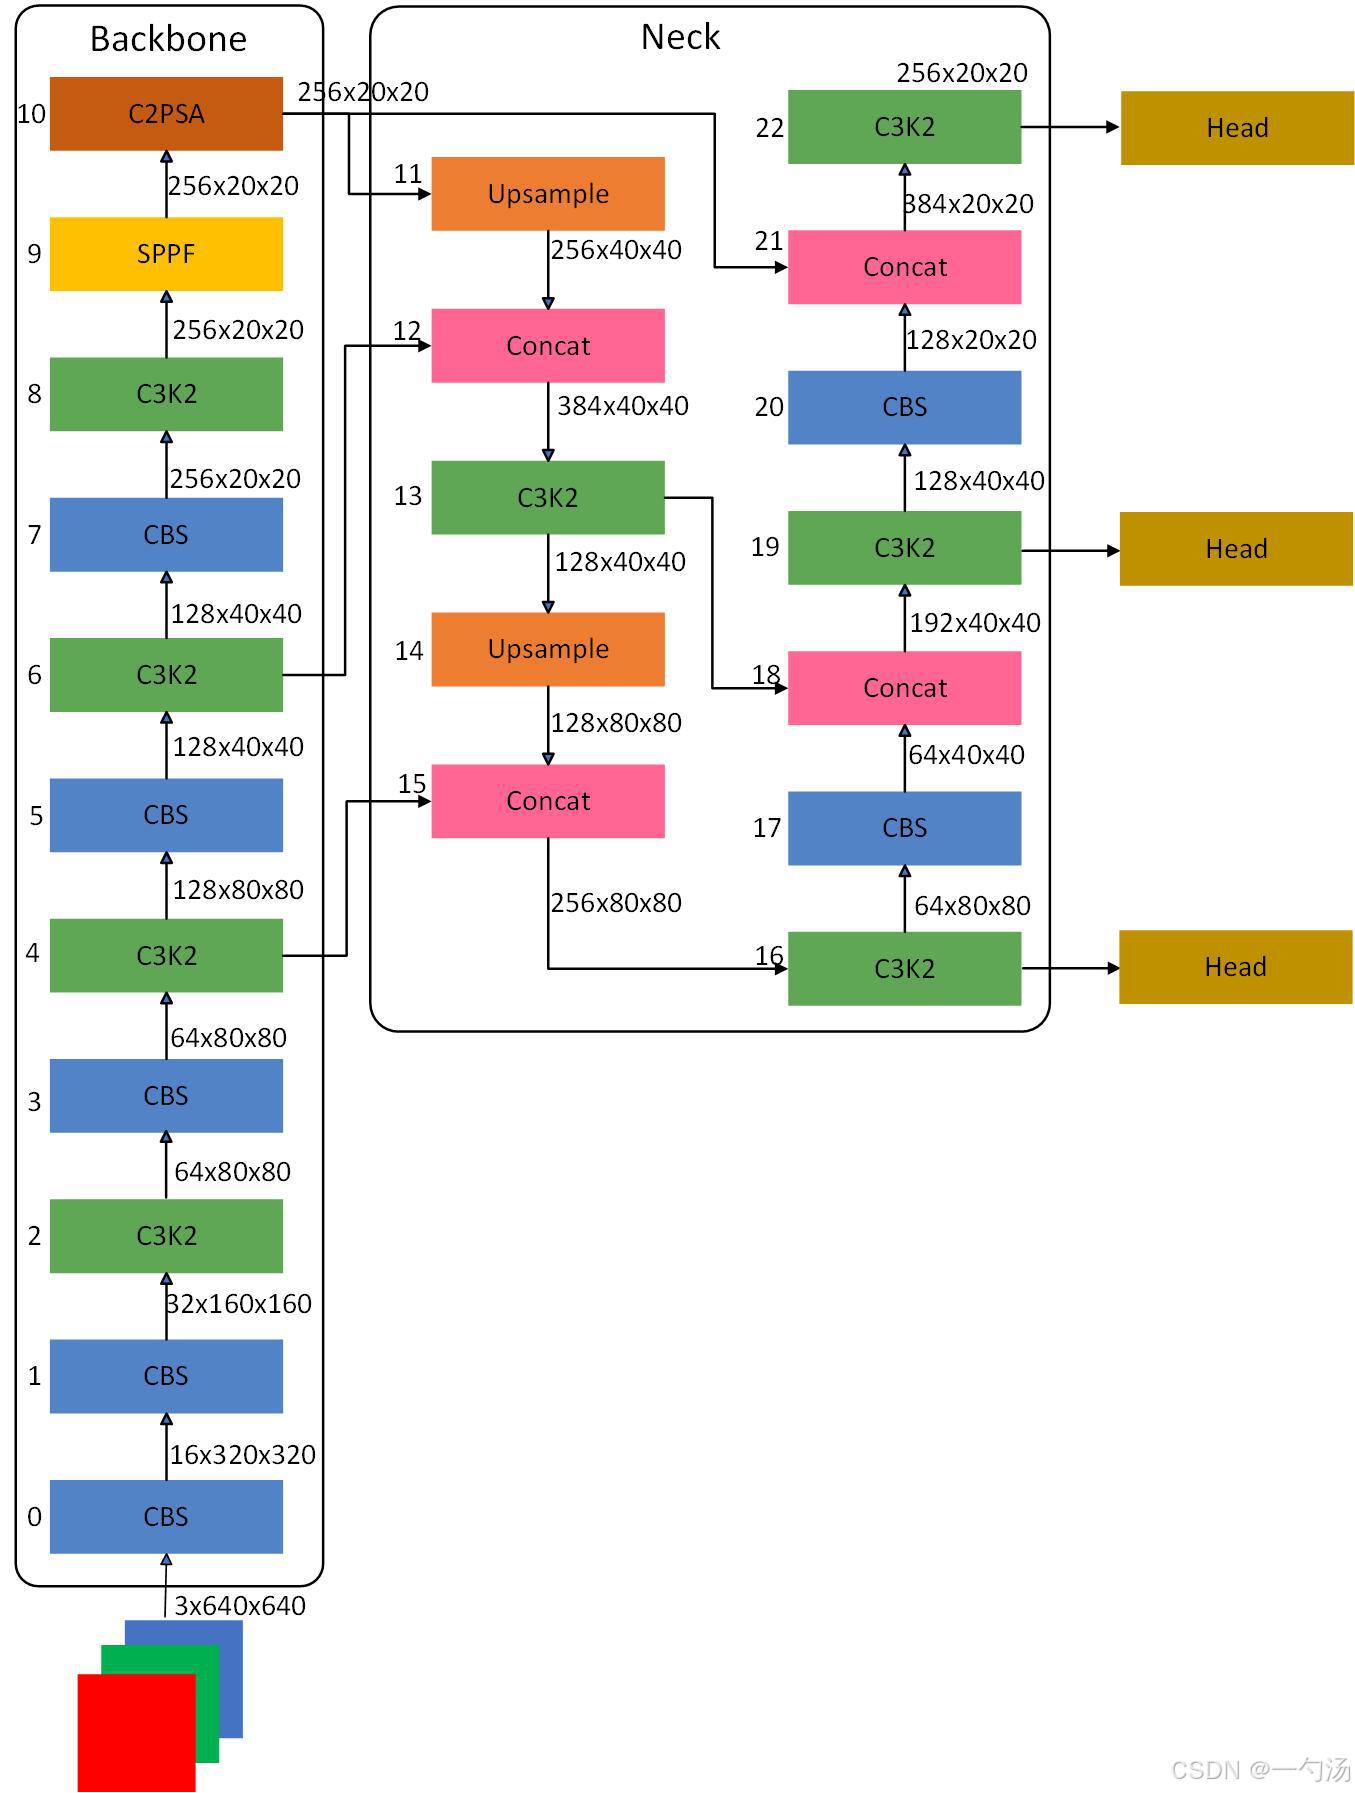
YOLO11 并没有完全改变 YOLOv8 的检测框架。
两者仍然采用多尺度特征输出、Anchor-Free 检测头以及相似的训练策略。YOLO11 的改进主要集中在网络结构上:
- 使用
C3k2替换大量C2f模块; - 在 Backbone 深层加入
C2PSA; - 对检测头进行轻量化调整;
- 损失函数基本沿用 YOLOv8 的设计,包括 BCE、CIoU 和 DFL。
其中,C2PSA 是 YOLO11 比较有代表性的改进。它在保留卷积特征的同时,引入自注意力来建模较远位置之间的关系。
1. YOLO11 相比 YOLOv8 的主要变化
| 对比项 | YOLOv8 | YOLO11 |
|---|---|---|
| 主要卷积模块 | C2f | C3k2 |
| Backbone 深层结构 | SPPF | SPPF + C2PSA |
| 全局关系建模 | 主要依赖卷积 | 加入自注意力 |
| 检测头 | Anchor-Free 解耦头 | 更轻量的 Anchor-Free 检测头 |
| 损失函数 | BCE + CIoU + DFL | 基本沿用 |
YOLO11 的提升主要不是来自损失函数,而是来自特征提取结构的调整。
整体可以概括为:
C3k2:提高卷积特征提取效率

C2PSA:增加全局空间关系建模

轻量检测头:降低参数量和计算量
2. C3k2:替换 C2f 的主要模块
YOLOv8 中大量使用 C2f,YOLO11 则将其中不少位置替换成了 C3k2。
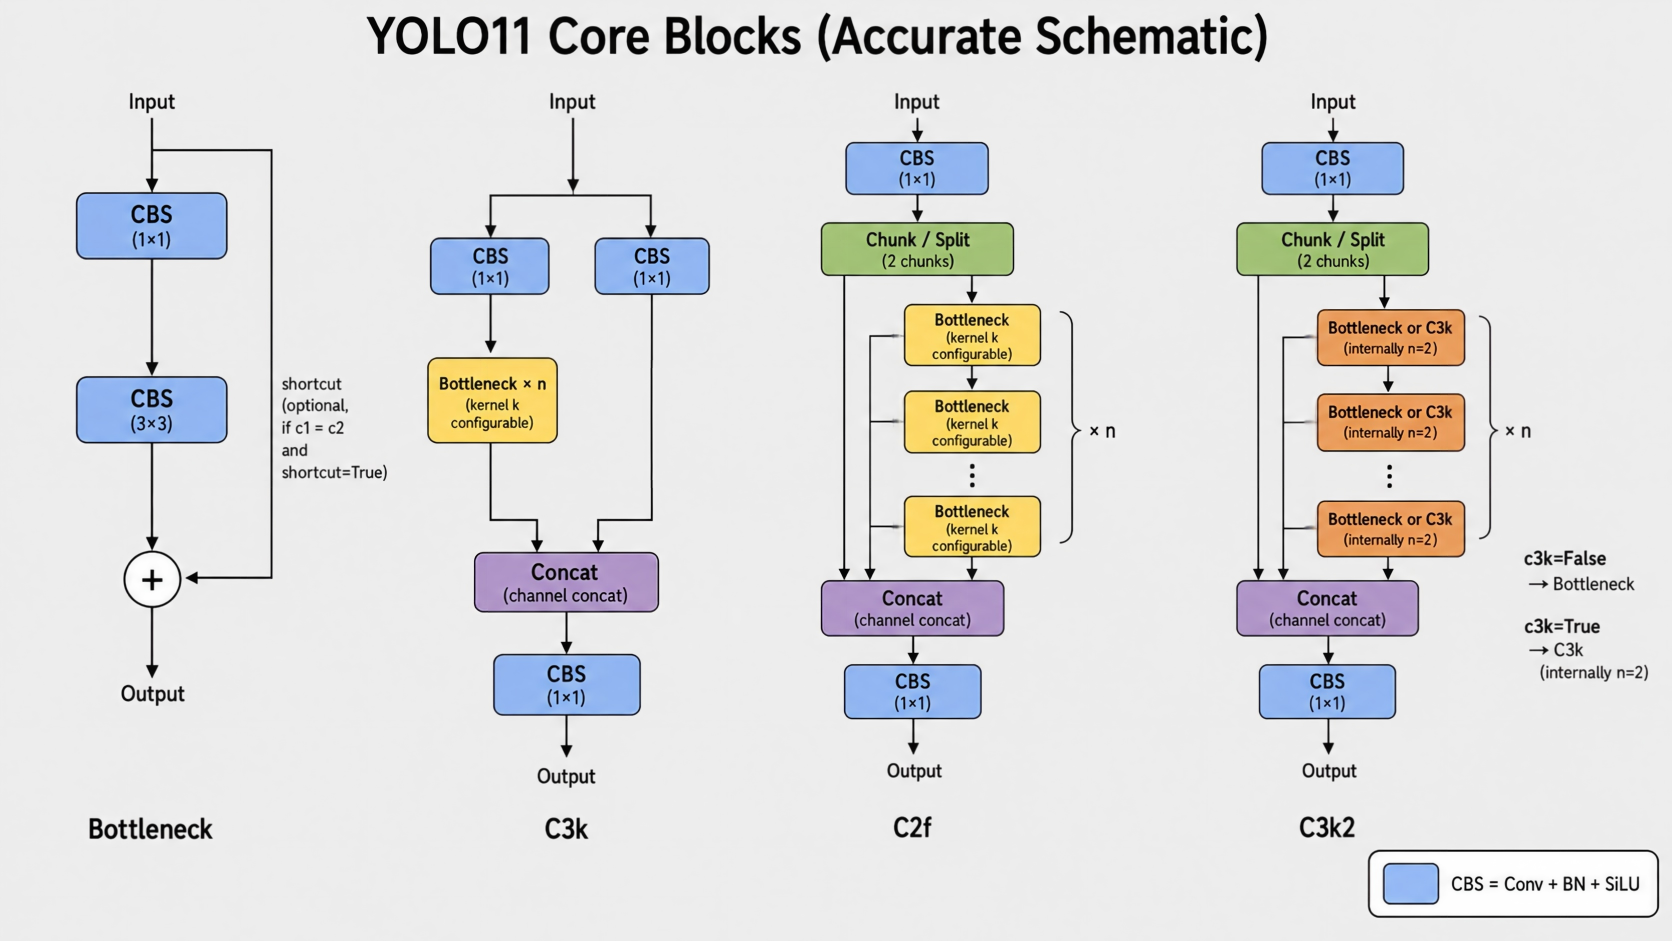
从实现上看,C3k2 仍然保留了 CSP 类模块的基本思想:
输入
  │
  ├──────── 直接分支
  │
  └──────── Bottleneck / C3k 分支
                 │
               拼接
                 │
              卷积融合
它并不是完全不同于 C2f 的新结构,而是在 C2f 的分流和拼接框架上,重新设计内部的特征提取模块。
C3k2 的主要作用是:
- 保持较好的梯度流;
- 减少不必要的计算;
- 根据模型规模灵活调整内部结构;
- 在参数量和特征提取能力之间取得平衡。
不过,相比 C3k2,YOLO11 中更值得展开分析的是 C2PSA。
3. C2PSA 在网络中的位置
YOLO11 的 Backbone 后半部分可以简化为:
高层 C3k2
    │
    ▼
  SPPF
    │
    ▼
 C2PSA
    │
    ▼
进入 Neck
C2PSA 被放在 Backbone 的深层,而不是浅层。
这是因为自注意力的计算量与空间位置数量有关。
假设输入图像大小为 640×640,不同阶段的特征图可能为:
P3:80×80,N = 6400
P4:40×40,N = 1600
P5:20×20,N = 400
注意力需要构造大小为:
N × N
的相关性矩阵。
如果在 80×80 的特征图上计算注意力,需要构造:
6400 × 6400
的矩阵,计算量和显存占用都比较高。
在 20×20 的深层特征图上,只需要构造:
400 × 400
的矩阵。
因此,将 C2PSA 放在低分辨率、高语义的深层特征上,可以用相对较低的成本引入全局信息。
4. C2PSA 的整体结构
C2PSA 的核心代码可以简化为:
class C2PSA(nn.Module):
    def __init__(self, c1, c2, n=1, e=0.5):
        super().__init__()

        assert c1 == c2

        self.c = int(c1 * e)

        self.cv1 = Conv(c1, 2 * self.c, 1, 1)
        self.cv2 = Conv(2 * self.c, c1, 1)

        self.m = nn.Sequential(
            *(
                PSABlock(
                    self.c,
                    attn_ratio=0.5,
                    num_heads=self.c // 64
                )
                for _ in range(n)
            )
        )

    def forward(self, x):
        a, b = self.cv1(x).split(
            (self.c, self.c),
            dim=1
        )

        b = self.m(b)

        return self.cv2(
            torch.cat((a, b), dim=1)
        )
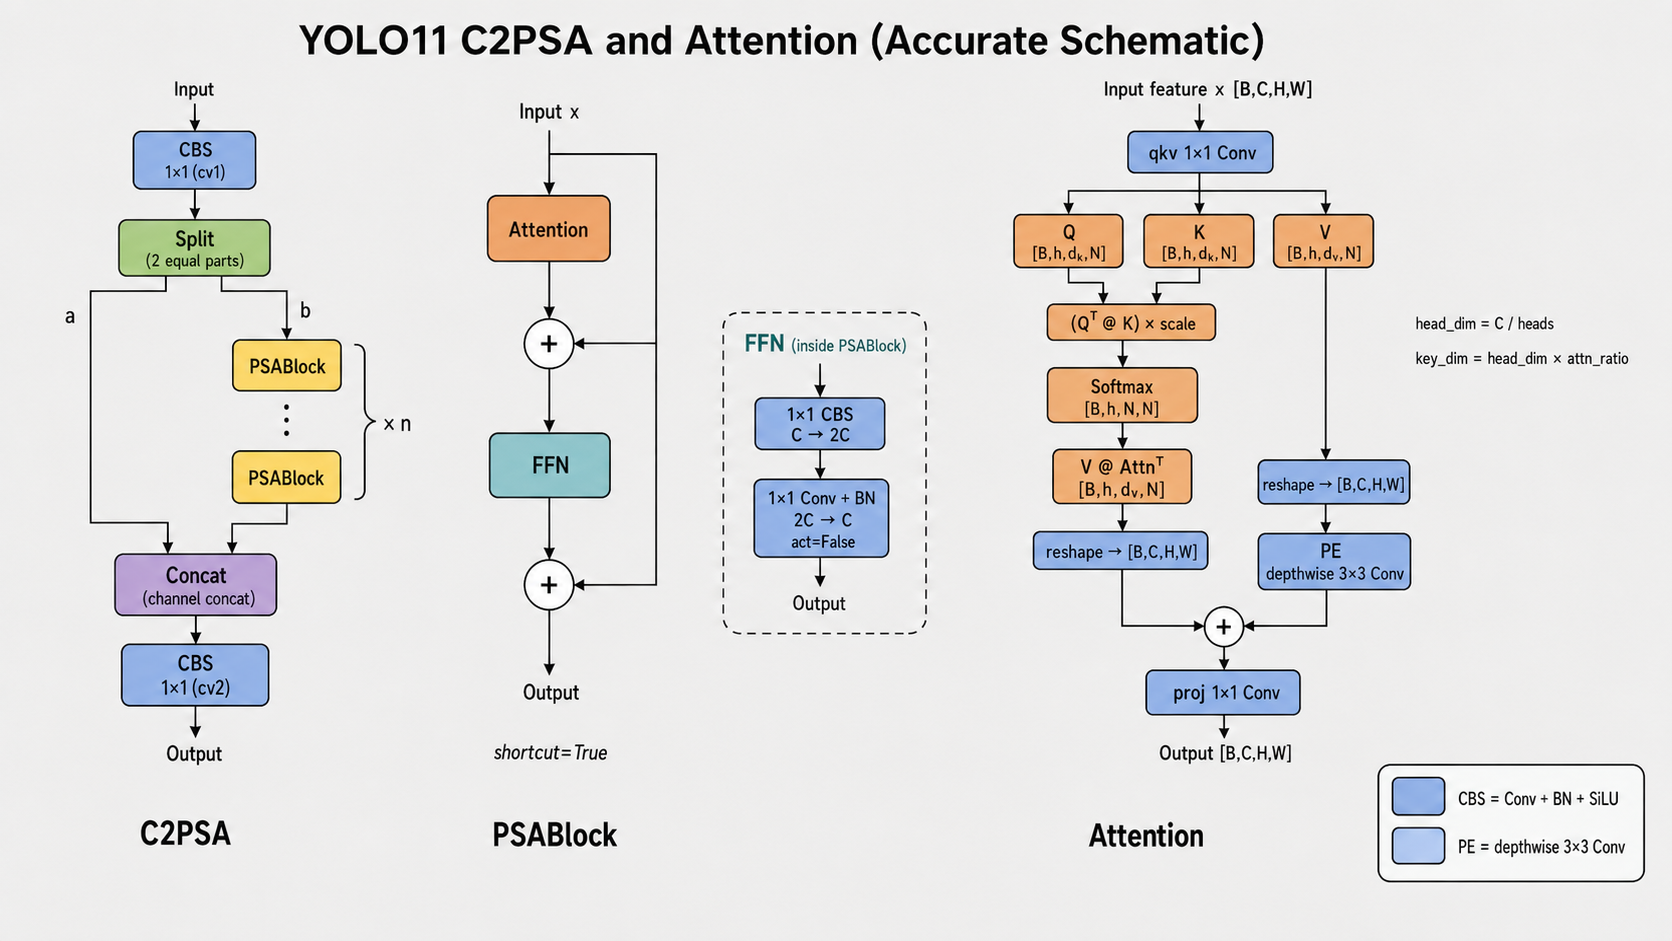
它的结构可以表示为:
                    ┌──────── a:直接保留 ────────┐
                    │                             │
输入 ── 1×1 Conv ──┤                             ├─ concat ─ 1×1 Conv ─ 输出
                    │                             │
                    └──── b:经过 PSABlock ───────┘
C2PSA 没有让所有通道都经过注意力,而是将特征拆成两部分:
a:保留原始卷积特征

b:经过注意力和前馈网络
这样做有几个好处:
- 降低注意力计算量;
- 保留原始局部特征;
- 提供更短的梯度传播路径;
- 避免所有特征都被全局注意力重新编码。
这和 CSP 系列模块的设计思路比较接近:只让部分特征经过复杂变换,最后再进行融合。
4.1 C2PSA 的维度变化
假设输入为:
x.shape = [B, 512, 20, 20]
并且:
e = 0.5
隐藏通道数为:
self.c = 512 × 0.5 = 256
经过第一层卷积:
[B, 512, 20, 20]
        ↓ cv1
[B, 512, 20, 20]
沿通道维切分:
a.shape = [B, 256, 20, 20]

b.shape = [B, 256, 20, 20]
其中 b 经过 PSABlock:
[B, 256, 20, 20]
        ↓ PSABlock
[B, 256, 20, 20]
然后与 a 拼接:
[B, 256, 20, 20]
        +
[B, 256, 20, 20]
        ↓ concat
[B, 512, 20, 20]
最后经过 cv2 融合:
[B, 512, 20, 20]
        ↓ 1×1 Conv
[B, 512, 20, 20]
因此,C2PSA 不会改变输入输出的特征图尺寸。
5. PSABlock 的结构
C2PSA 内部堆叠的是 PSABlock。
其代码可以简化为:
class PSABlock(nn.Module):
    def __init__(
        self,
        c,
        attn_ratio=0.5,
        num_heads=4,
        shortcut=True
    ):
        super().__init__()

        self.attn = Attention(
            c,
            attn_ratio=attn_ratio,
            num_heads=num_heads
        )

        self.ffn = nn.Sequential(
            Conv(c, c * 2, 1),
            Conv(c * 2, c, 1, act=False)
        )

        self.add = shortcut

    def forward(self, x):
        x = x + self.attn(x) if self.add else self.attn(x)
        x = x + self.ffn(x) if self.add else self.ffn(x)
        return x
结构如下:
输入 x
  │
  ├─────────────────┐
  │                 │
  ▼                 │
Attention            │
  │                 │
  └──── 残差相加 ◄──┘
          │
          ├───────────────┐
          │               │
          ▼               │
         FFN              │
          │               │
          └── 残差相加 ◄──┘
                 │
                输出
可以看出,PSABlock 的结构与 Transformer Block 有些相似:
Attention
    +
Residual
    +
FFN
    +
Residual
区别是,这里的输入仍然是 CNN 常用的四维特征图:
[B, C, H, W]
FFN 也不是标准的全连接层,而是使用两层 1×1 Conv:
C → 2C → C
用于完成通道维度上的非线性变换。
6. Attention 初始化部分
Attention 源码如下:
class Attention(nn.Module):
    def __init__(
        self,
        dim,
        num_heads=8,
        attn_ratio=0.5
    ):
        super().__init__()

        self.num_heads = num_heads
        self.head_dim = dim // num_heads
        self.key_dim = int(
            self.head_dim * attn_ratio
        )
        self.scale = self.key_dim ** -0.5

        nh_kd = self.key_dim * num_heads
        h = dim + nh_kd * 2

        self.qkv = Conv(dim, h, 1, act=False)
        self.proj = Conv(dim, dim, 1, act=False)

        self.pe = Conv(
            dim,
            dim,
            3,
            1,
            g=dim,
            act=False
        )
假设:
dim = 256
num_heads = 4
attn_ratio = 0.5
6.1 每个注意力头的维度
self.head_dim = dim // num_heads
得到:
head_dim = 256 // 4 = 64
也就是:
256 个通道
被分成
4 个注意力头

每个头 64 维
6.2 Q 和 K 的维度压缩
self.key_dim = int(
    self.head_dim * attn_ratio
)
得到:
key_dim = 64 × 0.5 = 32
因此每个注意力头中:
Q:32 维
K:32 维
V:64 维
Q 和 K 负责计算位置之间的相关性,因此对它们进行压缩,可以降低注意力计算量。
V 负责保存最终被聚合的特征,所以仍然保留完整的 head_dim。
6.3 缩放因子
self.scale = self.key_dim ** -0.5
对应公式:
scale=1dk\text{scale}=\frac{1}{\sqrt{d_k}}scale=dk1
点积的维度越大,结果的数值范围通常也越大。
如果直接将较大的点积结果送入 softmax,输出可能会变得过于极端,影响训练稳定性。
因此需要除以:
dk \sqrt{d_k} dk
6.4 QKV 输出通道数
代码:
nh_kd = self.key_dim * num_heads
h = dim + nh_kd * 2
当前例子中:
nh_kd = 32 × 4 = 128
所有注意力头的通道数分别为:
Q 总通道:128
K 总通道:128
V 总通道:256
所以:
Q + K + V
= 128 + 128 + 256
= 512
因此:
self.qkv = Conv(256, 512, 1)
维度变化为:
[B, 256, H, W]
        ↓
[B, 512, H, W]
这里的 h 表示 Q、K、V 三部分需要的总通道数。
7. Q、K、V 的生成
Attention 的 forward 前半部分:
def forward(self, x):
    B, C, H, W = x.shape
    N = H * W

    qkv = self.qkv(x)

    q, k, v = qkv.view(
        B,
        self.num_heads,
        self.key_dim * 2 + self.head_dim,
        N
    ).split(
        [
            self.key_dim,
            self.key_dim,
            self.head_dim
        ],
        dim=2
    )
假设输入:
x.shape = [B, 256, 20, 20]
则:
N = H × W = 400
经过 QKV 卷积:
[B, 256, 20, 20]
        ↓ qkv Conv
[B, 512, 20, 20]
整理成多头形式后:
[B, 4, 128, 400]
其中每个头内部包含:
Q:32
K:32
V:64
最终得到:
q.shape = [B, 4, 32, 400]

k.shape = [B, 4, 32, 400]

v.shape = [B, 4, 64, 400]
这里的 400 表示将 20×20 的二维特征图展开成了 400 个空间位置。
每个空间位置都可以看作一个 token。
8. 注意力矩阵的计算
核心代码:
attn = (
    q.transpose(-2, -1) @ k
) * self.scale

attn = attn.softmax(dim=-1)
Q 的维度为:
[B, 4, 32, 400]
交换最后两个维度后:
[B, 4, 400, 32]
与 K 做矩阵乘法:
Qᵀ                  K
[400, 32]    @    [32, 400]
得到:
[400, 400]
加上 Batch 和 head 维度:
attn.shape = [B, 4, 400, 400]
这个矩阵描述了每一个空间位置与其他所有位置之间的相关性。
其中:
attn[..., i, j]
表示第 i 个位置对第 j 个位置的关注程度。
经过 softmax 后,每个位置对所有位置的权重之和为 1。
可以理解为:
当前位置应该从其他每个位置获取多少信息
9. 使用注意力权重聚合 Value
代码:
x = (
    v @ attn.transpose(-2, -1)
).view(B, C, H, W)
Value 的维度为:
v.shape = [B, 4, 64, 400]
注意力矩阵为:
attn.shape = [B, 4, 400, 400]
矩阵乘法:
V                    Attentionᵀ
[64, 400]      @      [400, 400]
得到:
[64, 400]
加入 Batch 和 head 后:
[B, 4, 64, 400]
随后将 4 个注意力头重新合并:
4 × 64 = 256
并恢复二维空间:
[B, 4, 64, 400]
        ↓
[B, 256, 20, 20]
这一步完成了全局信息聚合。
原本每个位置主要表示自己的局部特征,现在它可以根据注意力权重,从整张特征图的其他位置获取信息。
10. 深度卷积位置增强
完整代码中还有一条位置增强分支:
x = (
    v @ attn.transpose(-2, -1)
).view(B, C, H, W) + self.pe(
    v.reshape(B, C, H, W)
)
self.pe 的定义为:
self.pe = Conv(
    dim,
    dim,
    3,
    1,
    g=dim,
    act=False
)
因为:
groups = dim
所以它是一个 3×3 深度卷积。
深度卷积的特点是:
每个通道单独执行卷积
不在不同通道之间进行混合
它主要提取每个通道内部的局部空间信息。
10.1 为什么称为位置增强
自注意力主要根据特征内容计算相关性。
它擅长回答:
哪些位置的内容比较相关
但对局部空间结构的建模不如卷积直接。
3×3 卷积核天然包含相对空间关系:
左上   上   右上
左    中心   右
左下   下   右下
因此,这条分支可以为注意力结果补充:
- 局部邻域关系;
- 边缘和轮廓;
- 相对方向信息;
- 局部空间结构。
这里的 pe 不是经典 Transformer 中固定的正弦余弦位置编码。
更准确地说,它是一种:
可学习的卷积位置增强
卷积核在训练开始时同样是随机初始化的,但网络结构已经限制它只能从 3×3 局部邻域中学习空间信息。
训练过程中,它会根据检测损失逐渐学习对定位和识别有用的局部模式。
11. Attention 的完整数据流
以:
输入:[B, 256, 20, 20]

num_heads = 4
key_dim = 32
head_dim = 64
为例,整个过程如下:
输入特征

[B, 256, 20, 20]

        │
        │ 1×1 QKV Conv
        ▼

[B, 512, 20, 20]

        │
        │ 整理成多头形式
        ▼

[B, 4, 128, 400]

        │
        │ 切分 Q、K、V
        ├──────── Q:[B, 4, 32, 400]
        ├──────── K:[B, 4, 32, 400]
        └──────── V:[B, 4, 64, 400]

        │
        │ Qᵀ @ K
        ▼

注意力分数

[B, 4, 400, 400]

        │
        │ softmax
        ▼

注意力权重

[B, 4, 400, 400]

        │
        │ V @ Attentionᵀ
        ▼

[B, 4, 64, 400]

        │
        │ 合并注意力头
        │ 恢复二维特征图
        ▼

[B, 256, 20, 20]

        │
        ├──── 加上深度卷积位置增强
        │
        └──── 输出投影
        ▼

输出特征

[B, 256, 20, 20]
输入输出尺寸保持不变,但每个空间位置已经融合了其他位置的信息。
12. 总结
YOLO11 并没有彻底改变 YOLOv8 的框架。
它保留了:
- Anchor-Free 检测;
- 多尺度特征输出;
- 解耦检测头;
- Task-Aligned Assigner;
- BCE、CIoU 和 DFL 损失。
主要结构改进可以概括为:
C2f → C3k2

SPPF → SPPF + C2PSA

检测头进一步轻量化
其中,C2PSA 的核心思想是:
一部分通道保留原始卷积特征

一部分通道使用自注意力建模全局关系

最后将两部分重新融合
这种设计没有让整个网络全面 Transformer 化,而是在深层、低分辨率特征图上加入注意力。
卷积负责:
局部纹理
边缘
轮廓
空间先验
Attention 负责:
远距离位置之间的关系
全局上下文
跨区域信息交互
因此,我更倾向于把 C2PSA 理解为:
在保留 YOLO 卷积特性的基础上,用较低成本补充全局建模能力。
它不是单纯增加一个注意力模块,而是在计算量、局部特征和全局关系之间做了一次折中。

汇聚全球AI编程工具,助力开发者即刻编程。
更多推荐



 22
 0
- 0


 已为社区贡献2条内容

所有评论(0)