
通过智普平台和阿里云百炼平台获取相关的大模型
1. 通过智普平台获取相关的大模型
举例1:调用智普平台的glm-5.2模型
智普平台:<智谱AI开放平台>
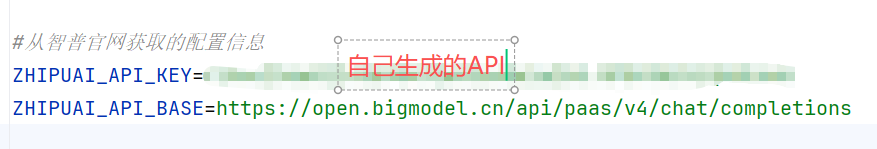
点进去,注册一个API,这个API—KEY就是我们需要的,复制一下,一会粘贴到env文件里面
import os

from dotenv import load_dotenv
from langchain_community.chat_models import ChatZhipuAI

#1. 读取.env配置文件中的信息,相关的环境变量以.env文件中的优先
#读取项目根目录下的.env文件,并把里面定义的键值对加载到系统环境变量os.environ中
#override=True:.env文件里的变量优先级更高,会强制覆盖系统已有的同名环境变量
load_dotenv(override=True)

#从系统的环境变量中,读取名为ZHIPUAI_API_KEY的值
ZHIPUAI_API_KEY=os.getenv("ZHIPUAI_API_KEY")
#从系统的环境变量中,读取名为ZHIPUAI_API_BASE的值
ZHIPUAI_API_BASE=os.getenv("ZHIPUAI_API_BASE")

# 2. 模型的初始化

llm_zhipu=ChatZhipuAI(
    model="glm-5.2",#模型的名字
    api_key=ZHIPUAI_API_KEY,#模型的api密钥
    api_base=ZHIPUAI_API_BASE#模型的地址
)

#3. 模型的调用
#.invoke()是调用大模型的核心方法,作用就是向模型发请求,等待回复
#传入参数:传给模型的提问/对话文本
#输出参数:模型的回答内容
#reponse不是单纯字符串,是Langchain封装的对象,真正的回答文本在response.content
response=llm_zhipu.invoke("你好,你是谁")
print(response)
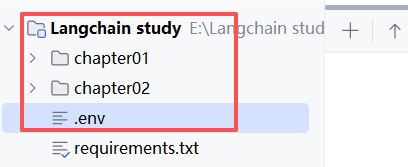
env文件是在根目录下存放的
env文件里的内容
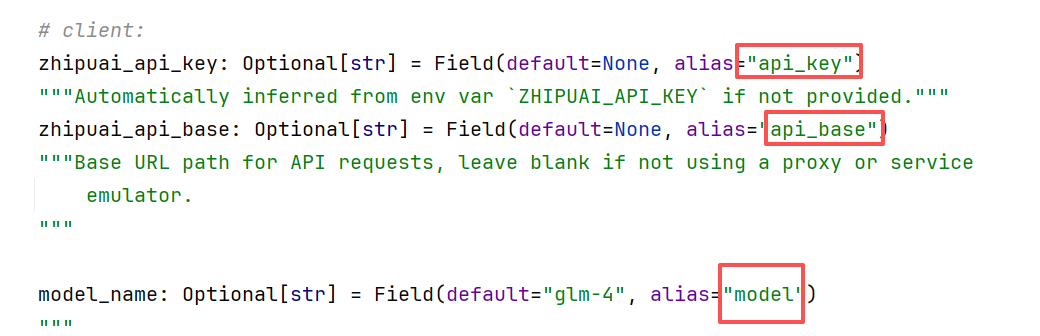
按着ctrl和鼠标的左键点击ChatZhipuAI,进入zhipuai.py,根据这个图片,我们可以知道如何填写ChatZhipuAI里面的参数
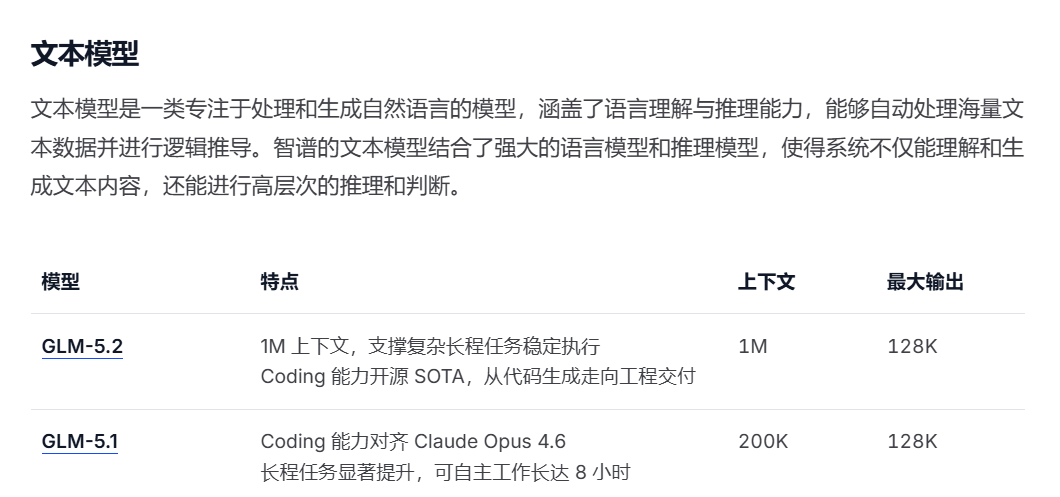
模型的选择,我们可以进入智普平台,点击开发文档,这里我们选择的glm-5.2
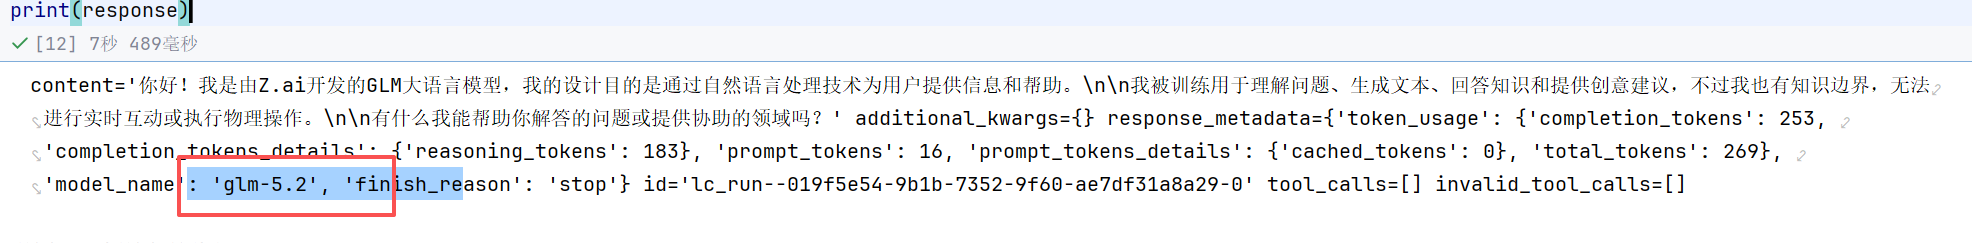
运行的结果,可以看出我们使用的模型是glm-5.2.
举例2:是对举例1的优化
from dotenv import load_dotenv
from langchain_community.chat_models import ChatZhipuAI

#1. 读取.env配置文件中的信息,相关的环境变量以.env文件中的优先
#读取项目根目录下的.env文件,并把里面定义的键值对加载到系统环境变量os.environ中
#override=True:.env文件里的变量优先级更高,会强制覆盖系统已有的同名环境变量
load_dotenv(override=True)

# 2. 模型的初始化

llm_zhipu=ChatZhipuAI()

#3. 模型的调用
#.invoke()是调用大模型的核心方法,作用就是向模型发请求,等待回复
#传入参数:传给模型的提问/对话文本
#输出参数:模型的回答内容
#reponse不是单纯字符串,是Langchain封装的对象,真正的回答文本在response.content
response=llm_zhipu.invoke("你好,你是谁")
print(response)
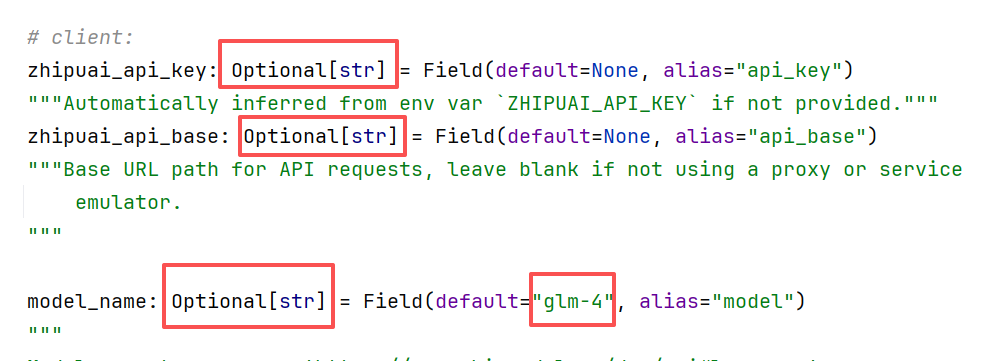
我们从下面的图中可以看出,模型的名字,模型的api_key和模型的链接api_base都是可选的,可以省略不写,模型名字省略不写,默认调用glm-4,模型的api_key默认从环境变量中读取ZHIPUAI_API_KEY,因为我们在env里面设置的ZHIPUAI_API_KEY就是这个变量名,所以可以默认读取,api_base是可选的,它一般是具体厂商的类,基本上不需要我们在传入这个URL了,因为已经很具体了,这个模型的URL已经给写死了,不写模型也可以理解,不需要特意去传。因此可以三个都不写,但是还是建议自己写个模型名,调用自己想调用的模型
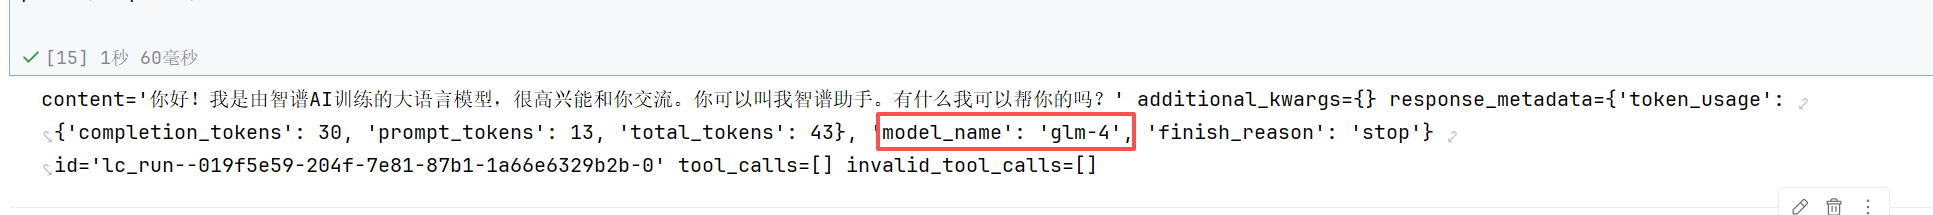
结果可以看出,模型默认调用的就是glm-4
举例3:参数声明在代码中(不推荐)
from langchain_community.chat_models import ChatZhipuAI

# 2. 模型的初始化
llm_zhipu=ChatZhipuAI(
    model="glm-5.2",#模型的名字
    api_key="(自己申请的api_key)",#模型的api密钥
    api_base="https://open.bigmodel.cn/api/paas/v4/chat/completions"#模型的地址
)

#3. 模型的调用
#.invoke()是调用大模型的核心方法,作用就是向模型发请求,等待回复
#传入参数:传给模型的提问/对话文本
#输出参数:模型的回答内容
#reponse不是单纯字符串,是Langchain封装的对象,真正的回答文本在response.content
response=llm_zhipu.invoke("你好,你是谁")
print(response)
这种不推荐,因为别人都能看到你的api_key,别人也能复制你的,消耗你的token
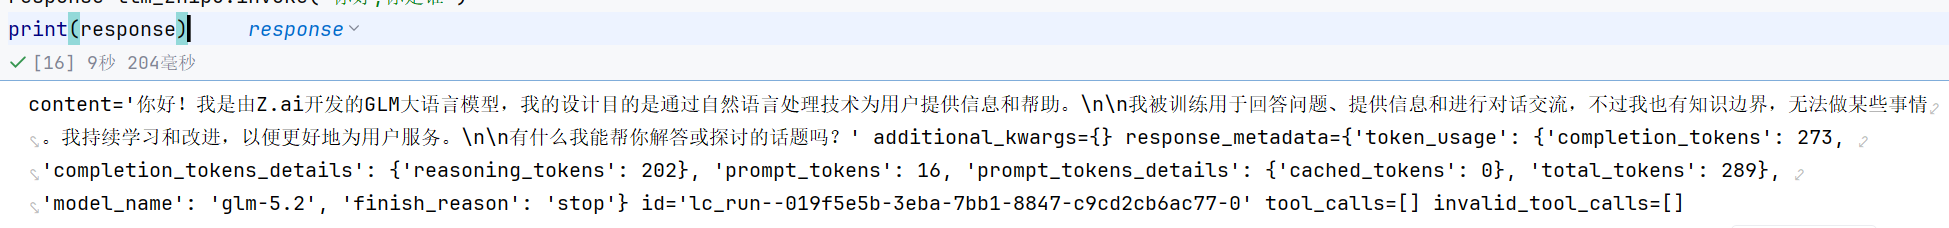
举例3的结果
2. 通过阿里云百炼平台获取相关的大模型
举例1:调用qwen模型
阿里云百炼平台:<大模型服务平台百炼控制台>
点进去,注册一个API,这个API——KEY自己要保存起来,因为如果不保存,后面就看不到了,需要用API就需要再重新生成。
import os

from dotenv import load_dotenv
from langchain_community.chat_models import ChatTongyi

#1. 读取.env配置文件中的信息,相关的环境变量以.env文件中的优先
#读取项目根目录下的.env文件,并把里面定义的键值对加载到系统环境变量os.environ中
#override=True:.env文件里的变量优先级更高,会强制覆盖系统已有的同名环境变量
load_dotenv(override=True)

#从系统的环境变量中,DASHSCOPE_API_KEY
DASHSCOPE_API_KEY=os.getenv("DASHSCOPE_API_KEY")

# 2. 模型的初始化

llm_qwen=ChatTongyi(
    model="qwen3-max",#模型的名字
    api_key=DASHSCOPE_API_KEY,#模型的api密钥
)

#3. 模型的调用
#.invoke()是调用大模型的核心方法,作用就是向模型发请求,等待回复
#传入参数:传给模型的提问/对话文本
#输出参数:模型的回答内容
#reponse不是单纯字符串,是Langchain封装的对象,真正的回答文本在response.content
response=llm_qwen.invoke("你好,你是谁")
print(response)
在env文件里面填写自己的API—KEY

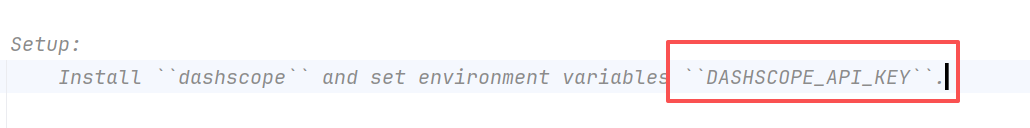
按着ctrl和鼠标的左键点击ChatTongyi,进入tongyi.py,可以看出,我们env里面的参数名应该是DASHSCOPE_API_KEY
我们从前面的DeepSeek和智普可以知道这中厂商模型不需要在传入模型的URL,所以不需要在env文件里面填写这个URL
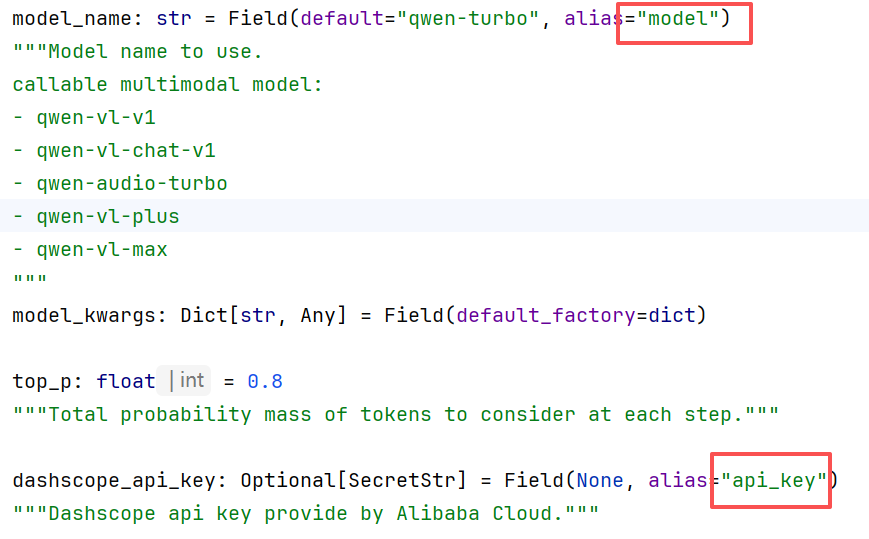
模型名我们可以在模型广场,找到全部模型,看是文本模型的,我们都可以选择,这里我选择了qwen3-max,模型越新,用的token越多。
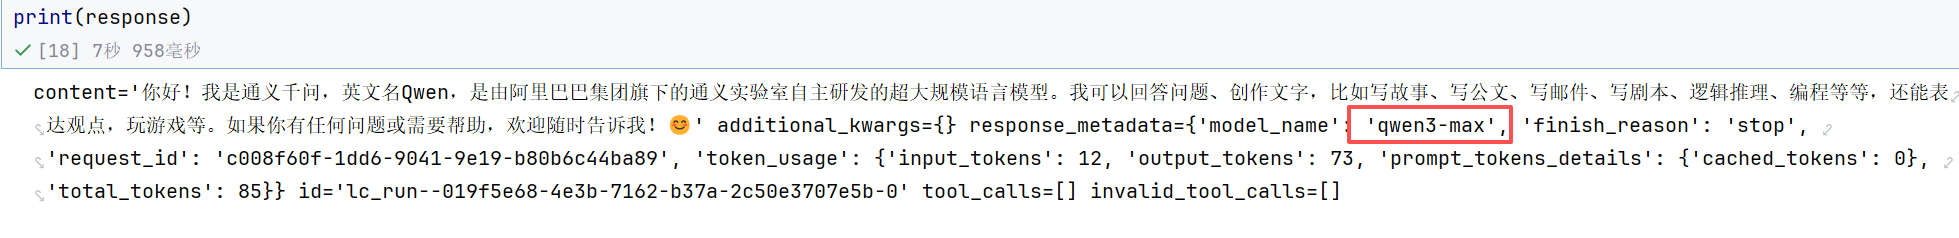
举例1的结果
举例2:对举例1的优化
from langchain_community.chat_models import ChatTongyi
from dotenv import load_dotenv

#1. 读取.env配置文件中的信息,相关的环境变量以.env文件中的优先
#读取项目根目录下的.env文件,并把里面定义的键值对加载到系统环境变量os.environ中
#override=True:.env文件里的变量优先级更高,会强制覆盖系统已有的同名环境变量
load_dotenv(override=True)

# 2. 模型的初始化
llm_qwen=ChatTongyi()

#3. 模型的调用
#.invoke()是调用大模型的核心方法,作用就是向模型发请求,等待回复
#传入参数:传给模型的提问/对话文本
#输出参数:模型的回答内容
#reponse不是单纯字符串,是Langchain封装的对象,真正的回答文本在response.content
response=llm_qwen.invoke("你好,你是谁")
print(response)
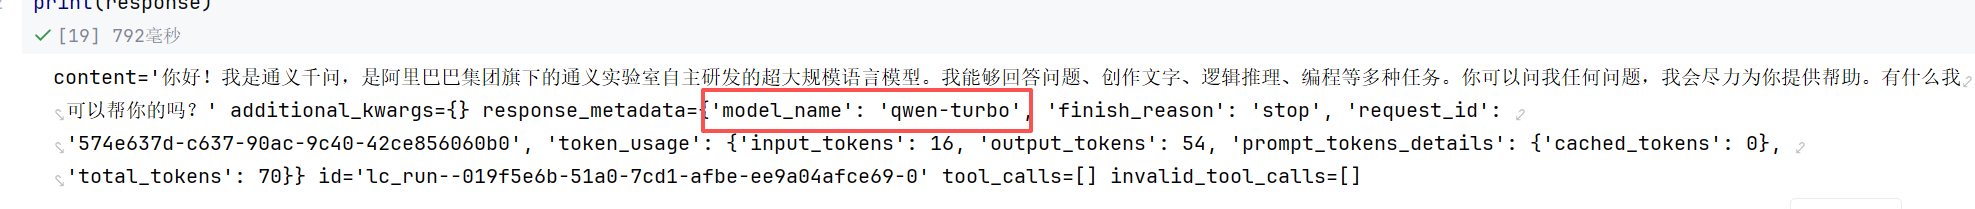
如果不传模型名称这个参数,从图中可以看出默认是使用qwen-turbo,api_key是默认从环境变量中读取。
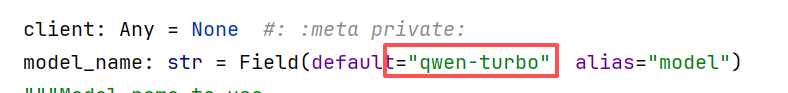
举例2的结果,可以看出在不传模型名字参数的时候,默认使用的是qwen-turbo
举例3:参数声明在代码里(不推荐)
from langchain_community.chat_models import ChatTongyi

# 2. 模型的初始化
llm_qwen=ChatTongyi(
    model="qwen3-max",#模型的名字
    api_key=“(自己生成的API_KEY)",#模型的api密钥
)

#3. 模型的调用
#.invoke()是调用大模型的核心方法,作用就是向模型发请求,等待回复
#传入参数:传给模型的提问/对话文本
#输出参数:模型的回答内容
#reponse不是单纯字符串,是Langchain封装的对象,真正的回答文本在response.content
response=llm_qwen.invoke("你好,你是谁")
print(response)
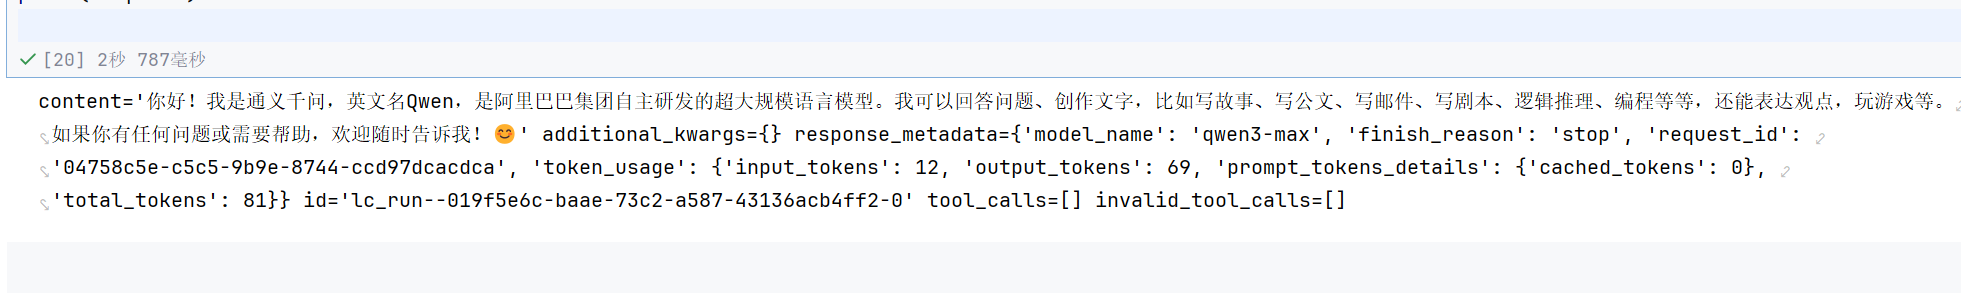
这种不推荐,因为别人都能看到你的api_key,别人也能复制你的,消耗你的token.
举例3的结果

汇聚全球AI编程工具,助力开发者即刻编程。
更多推荐

 11
 0
- 0


 已为社区贡献1条内容

所有评论(0)