
YOLOv8改进 - 注意力机制 | HCF-Net 之 PPA:并行化注意力设计 | 小目标
前言
本文介绍了面向红外小目标检测的 HCF-Net 核心模块 PPA(Parallelized Patch-Aware Attention),用于增强小目标在复杂背景下的特征表达能力。该模块通过局部-全局注意力、多分支卷积特征提取、ECA通道注意力与空间注意力协同建模,捕获不同尺度和层次的上下文信息,缓解小目标在下采样过程中易丢失的问题。我们将 PPA 成功集成进 YOLOv8,强化主干高层语义特征表达,实现更精细的小目标特征提取与检测性能提升。
文章目录: YOLOv8改进大全:卷积层、轻量化、注意力机制、损失函数、Backbone、SPPF、Neck、检测头全方位优化汇总
专栏链接: YOLOv8改进专栏
介绍
摘要——红外小目标检测是计算机视觉中的一项重要任务,涉及识别和定位红外图像中的微小目标,这些目标通常只有几个像素。然而,由于目标体积小且红外图像背景通常复杂,这项任务面临诸多挑战。本文提出了一种深度学习方法HCF-Net,通过多个实用模块显著提升红外小目标检测性能。具体而言,该方法包括并行化的感知补丁注意力(PPA)模块、维度感知选择性融合(DASI)模块和多膨胀通道优化(MDCR)模块。PPA模块使用多分支特征提取策略来捕捉不同尺度和层次的特征信息。DASI模块实现了自适应的通道选择和融合。MDCR模块通过多层深度可分离卷积捕捉不同感受野范围的空间特征。大量实验结果表明,在SIRST红外单帧图像数据集上,所提出的HCF-Net表现优异,超越了其他传统和深度学习模型。代码可在https://github.com/zhengshuchen/HCFNet获取。
文章链接
论文地址:论文地址
代码地址:代码地址
基本原理
HCF-Net(Hierarchical Context Fusion Network)是一种用于红外小目标检测的深度学习模型,旨在提高对红外图像中微小目标的识别和定位能力。
-
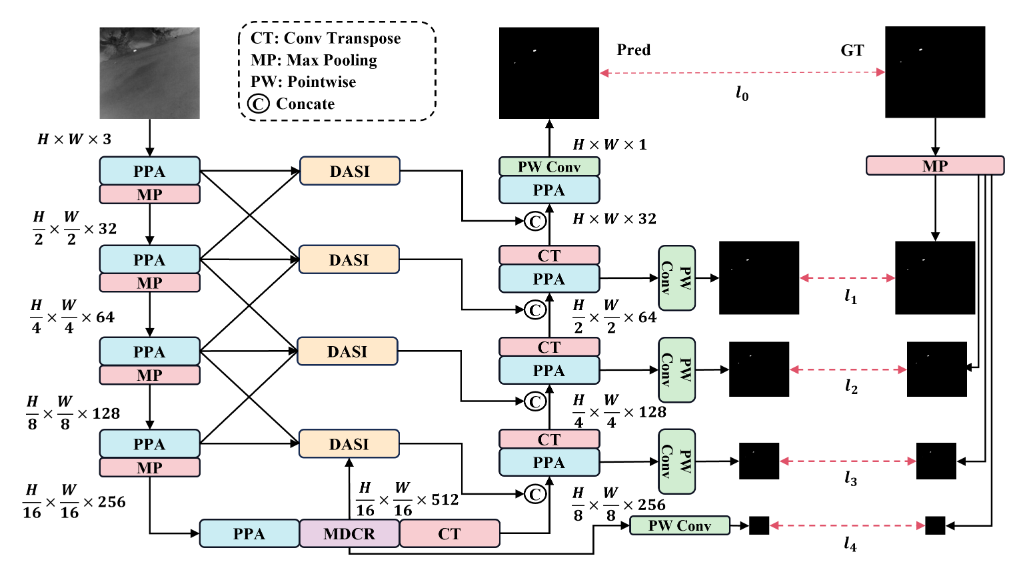
网络架构:HCF-Net采用了一种升级版的U-Net架构,主要由三个关键模块组成:Parallelized Patch-Aware Attention(PPA)模块、Dimension-Aware Selective Integration(DASI)模块和Multi-Dilated Channel Refiner(MDCR)模块。这些模块在不同层级上解决了红外小目标检测中的挑战 。
-
PPA模块:
- Hierarchical Feature Fusion:PPA模块利用分层特征融合和注意力机制,以在多次下采样过程中保持和增强小目标的表示,确保关键信息在整个网络中得以保留[T1]。
- Multi-Branch Feature Extraction:PPA采用多分支特征提取策略,以捕获不同尺度和级别的特征信息,从而提高小目标检测的准确性 。
-
DASI模块:
- Adaptive Feature Fusion:DASI模块增强了U-Net中的跳跃连接,专注于高低维特征的自适应选择和精细融合,以增强小目标的显著性 。
-
MDCR模块:
- Spatial Feature Refinement:MDCR模块通过多个深度可分离卷积层捕获不同感受野范围的空间特征,更细致地建模目标和背景之间的差异,提高了定位小目标的能力 。
PPA
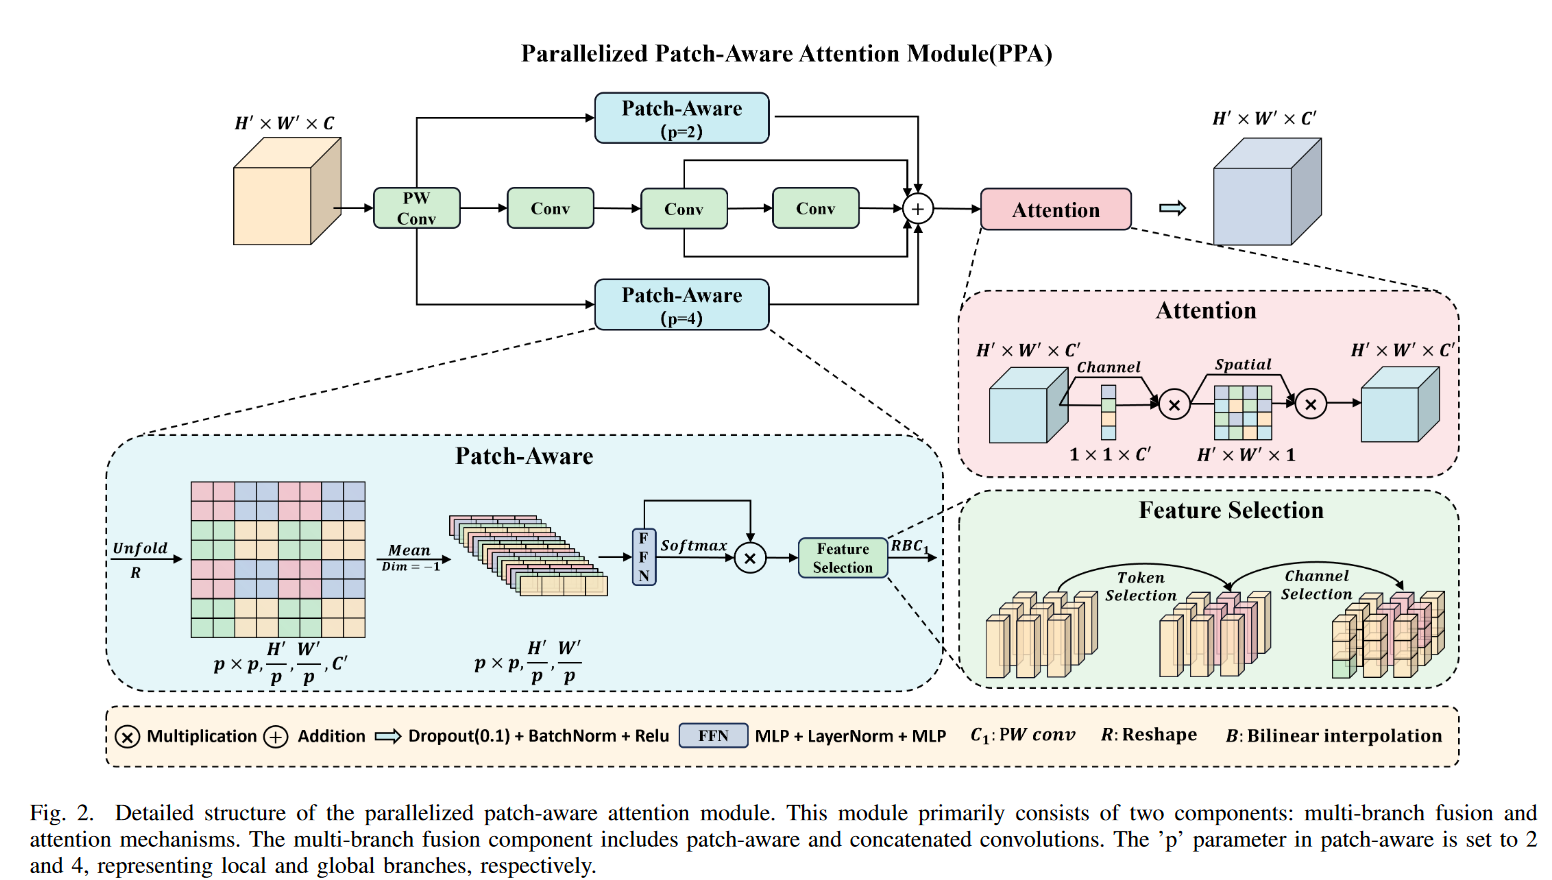
在红外小物体检测任务中,小物体很容易在多次降采样操作中丢失关键信息。 ,PPA 在编码器和解码器的基本组件中取代了传统的卷积运算,从而更好地应对了这一挑战。PPA 主要有两大优势:多分支特征提取和特征融合注意力。
多分支特征提取
PPA 的多分支特征提取策略如下图 所示,采用并行多分支方法,每个分支负责提取不同规模和级别的特征。这种策略有利于捕捉物体的多尺度特征,提高小物体检测的准确性。具体而言,这包括三个并行分支:局部分支、全局分支和串行卷积分支。
  1. **局部分支**:通过调整逐点卷积后的特征张量 $F'$,分割成一组空间上连续的斑块,进行信道平均和线性计算,再应用激活函数得到空间维度上的概率分布。

  2. **全局分支**:使用高效操作,在斑块中选择与任务相关的特征,通过余弦相似度衡量加权,最终产生局部和全局特征。

  3. **串行卷积分支**:采用三个 3x3 卷积层替代传统的大卷积核,得到多个输出结果,最后相加得到串行卷积输出。
这些分支计算得到的特征分别是 F l o c a l F_{local} Flocal、 F g l o b a l F_{global} Fglobal 和 F c o n v F_{conv} Fconv,它们在尺寸和通道数上保持一致。
通过这种策略,PPA 不仅能有效捕获不同尺度下的特征,还能提升特征的表达能力和模型的整体性能。
核心代码
class PPA(nn.Module):
    def __init__(self, in_features, filters) -> None:
        super().__init__()

        # 定义跳跃连接卷积块
        self.skip = conv_block(in_features=in_features,
                               out_features=filters,
                               kernel_size=(1, 1),
                               padding=(0, 0),
                               norm_type='bn',
                               activation=False)

        # 定义连续卷积块
        self.c1 = conv_block(in_features=in_features,
                             out_features=filters,
                             kernel_size=(3, 3),
                             padding=(1, 1),
                             norm_type='bn',
                             activation=True)
        self.c2 = conv_block(in_features=filters,
                             out_features=filters,
                             kernel_size=(3, 3),
                             padding=(1, 1),
                             norm_type='bn',
                             activation=True)
        self.c3 = conv_block(in_features=filters,
                             out_features=filters,
                             kernel_size=(3, 3),
                             padding=(1, 1),
                             norm_type='bn',
                             activation=True)

        # 定义空间注意力模块
        self.sa = SpatialAttentionModule()
        # 定义ECA模块
        self.cn = ECA(filters)
        # 定义局部和全局注意力模块
        self.lga2 = LocalGlobalAttention(filters, 2)
        self.lga4 = LocalGlobalAttention(filters, 4)

        # 定义批归一化层、dropout层和激活函数
        self.bn1 = nn.BatchNorm2d(filters)
        self.drop = nn.Dropout2d(0.1)
        self.relu = nn.ReLU()
        self.gelu = nn.GELU()

    def forward(self, x):
        x_skip = self.skip(x)  # 跳跃连接输出
        x_lga2 = self.lga2(x_skip)  # 局部和全局注意力输出(大小为2的patch)
        x_lga4 = self.lga4(x_skip)  # 局部和全局注意力输出(大小为4的patch)
        x1 = self.c1(x)  # 第一个卷积块输出
        x2 = self.c2(x1)  # 第二个卷积块输出
        x3 = self.c3(x2)  # 第三个卷积块输出
        x = x1 + x2 + x3 + x_skip + x_lga2 + x_lga4  # 合并所有输出
        x = self.cn(x)  # ECA模块
        x = self.sa(x)  # 空间注意力模块
        x = self.drop(x)  # Dropout层
        x = self.bn1(x)  # 批归一化层
        x = self.relu(x)  # 激活函数
        return x
引入代码
在根目录下的ultralytics/nn/目录,新建一个attention 目录,然后新建一个以PPA为文件名的py文件, 把代码拷贝进去。
import math
import torch
import torch.nn as nn
import torch.nn.functional as F


class conv_block(nn.Module):
    def __init__(self,
                 in_features,
                 out_features,
                 kernel_size=(3, 3),
                 stride=(1, 1),
                 padding=(1, 1),
                 dilation=(1, 1),
                 norm_type='bn',
                 activation=True,
                 use_bias=True,
                 groups=1
                 ):
        super().__init__()

        self.conv = nn.Conv2d(in_channels=in_features,
                              out_channels=out_features,
                              kernel_size=kernel_size,
                              stride=stride,
                              padding=padding,
                              dilation=dilation,
                              bias=use_bias,
                              groups=groups)

        self.norm_type = norm_type
        self.act = activation

        if self.norm_type == 'gn':
            self.norm = nn.GroupNorm(32 if out_features >= 32 else out_features, out_features)
        if self.norm_type == 'bn':
            self.norm = nn.BatchNorm2d(out_features)
        if self.act:
            # self.relu = nn.GELU()
            self.relu = nn.ReLU(inplace=False)

    def forward(self, x):
        x = self.conv(x)
        if self.norm_type is not None:
            x = self.norm(x)

        if self.act:
            x = self.relu(x)
        return x


class LocalGlobalAttention(nn.Module):
    def __init__(self, output_dim, patch_size):
        super().__init__()
        self.output_dim = output_dim
        self.patch_size = patch_size
        self.mlp1 = nn.Linear(patch_size*patch_size, output_dim // 2)
        self.norm = nn.LayerNorm(output_dim // 2)
        self.mlp2 = nn.Linear(output_dim // 2, output_dim)
        self.conv = nn.Conv2d(output_dim, output_dim, kernel_size=1)
        self.prompt = torch.nn.parameter.Parameter(torch.randn(output_dim, requires_grad=True))
        self.top_down_transform = torch.nn.parameter.Parameter(torch.eye(output_dim), requires_grad=True)

    def forward(self, x):
        x = x.permute(0, 2, 3, 1)
        B, H, W, C = x.shape
        P = self.patch_size

        # Local branch
        local_patches = x.unfold(1, P, P).unfold(2, P, P)  # (B, H/P, W/P, P, P, C)
        local_patches = local_patches.reshape(B, -1, P*P, C)  # (B, H/P*W/P, P*P, C)
        local_patches = local_patches.mean(dim=-1)  # (B, H/P*W/P, P*P)

        local_patches = self.mlp1(local_patches)  # (B, H/P*W/P, input_dim // 2)
        local_patches = self.norm(local_patches)  # (B, H/P*W/P, input_dim // 2)
        local_patches = self.mlp2(local_patches)  # (B, H/P*W/P, output_dim)

        local_attention = F.softmax(local_patches, dim=-1)  # (B, H/P*W/P, output_dim)
        local_out = local_patches * local_attention # (B, H/P*W/P, output_dim)

        cos_sim = F.normalize(local_out, dim=-1) @ F.normalize(self.prompt[None, ..., None], dim=1)  # B, N, 1
        mask = cos_sim.clamp(0, 1)
        local_out = local_out * mask
        local_out = local_out @ self.top_down_transform

        # Restore shapes
        local_out = local_out.reshape(B, H // P, W // P, self.output_dim)  # (B, H/P, W/P, output_dim)
        local_out = local_out.permute(0, 3, 1, 2)
        local_out = F.interpolate(local_out, size=(H, W), mode='bilinear', align_corners=False)
        output = self.conv(local_out)

        return output


class ECA(nn.Module):
    def __init__(self,in_channel,gamma=2,b=1):
        super(ECA, self).__init__()
        k=int(abs((math.log(in_channel,2)+b)/gamma))
        kernel_size=k if k % 2 else k+1
        padding=kernel_size//2
        self.pool=nn.AdaptiveAvgPool2d(output_size=1)
        self.conv=nn.Sequential(
            nn.Conv1d(in_channels=1,out_channels=1,kernel_size=kernel_size,padding=padding,bias=False),
            nn.Sigmoid()
        )

    def forward(self,x):
        out=self.pool(x)
        out=out.view(x.size(0),1,x.size(1))
        out=self.conv(out)
        out=out.view(x.size(0),x.size(1),1,1)
        return out*x


class SpatialAttentionModule(nn.Module):
    def __init__(self):
        super(SpatialAttentionModule, self).__init__()
        self.conv2d = nn.Conv2d(in_channels=2, out_channels=1, kernel_size=7, stride=1, padding=3)
        self.sigmoid = nn.Sigmoid()

    def forward(self, x):
        avgout = torch.mean(x, dim=1, keepdim=True)
        maxout, _ = torch.max(x, dim=1, keepdim=True)
        out = torch.cat([avgout, maxout], dim=1)
        out = self.sigmoid(self.conv2d(out))
        return out * x


class PPA(nn.Module):
    def __init__(self, in_features, filters) -> None:
         super().__init__()

         self.skip = conv_block(in_features=in_features,
                                out_features=filters,
                                kernel_size=(1, 1),
                                padding=(0, 0),
                                norm_type='bn',
                                activation=False)
         self.c1 = conv_block(in_features=in_features,
                                out_features=filters,
                                kernel_size=(3, 3),
                                padding=(1, 1),
                                norm_type='bn',
                                activation=True)
         self.c2 = conv_block(in_features=filters,
                                out_features=filters,
                                kernel_size=(3, 3),
                                padding=(1, 1),
                                norm_type='bn',
                                activation=True)
         self.c3 = conv_block(in_features=filters,
                                out_features=filters,
                                kernel_size=(3, 3),
                                padding=(1, 1),
                                norm_type='bn',
                                activation=True)
         self.sa = SpatialAttentionModule()
         self.cn = ECA(filters)
         self.lga2 = LocalGlobalAttention(filters, 2)
         self.lga4 = LocalGlobalAttention(filters, 4)

         self.bn1 = nn.BatchNorm2d(filters)
         self.drop = nn.Dropout2d(0.1)
         self.relu = nn.ReLU()

         self.gelu = nn.GELU()

    def forward(self, x):
        x_skip = self.skip(x)
        x_lga2 = self.lga2(x_skip)
        x_lga4 = self.lga4(x_skip)
        x1 = self.c1(x)
        x2 = self.c2(x1)
        x3 = self.c3(x2)
        x = x1 + x2 + x3 + x_skip + x_lga2 + x_lga4
        x = self.cn(x)
        x = self.sa(x)
        x = self.drop(x)
        x = self.bn1(x)
        x = self.relu(x)
        return x
tasks注册
在ultralytics/nn/tasks.py中进行如下操作:
步骤1:
from ultralytics.nn.attention.PPA import PPA
步骤2
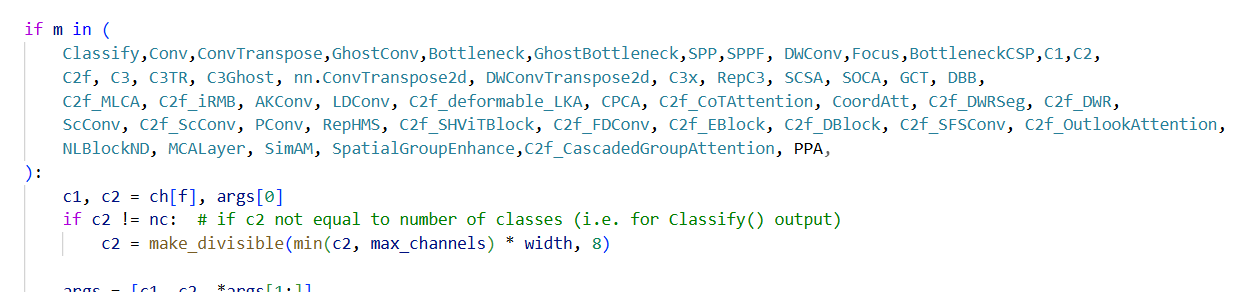
修改def parse_model(d, ch, verbose=True):
PPA
配置yolov8-PPA.yaml
# Ultralytics YOLO 🚀, AGPL-3.0 license
# YOLOv8 object detection model with P3-P5 outputs. For Usage examples see https://docs.ultralytics.com/tasks/detect

# Parameters
nc: 80  # number of classes
scales: # model compound scaling constants, i.e. 'model=yolov8n.yaml' will call yolov8.yaml with scale 'n'
  # [depth, width, max_channels]
  n: [0.33, 0.25, 1024]  # YOLOv8n summary: 225 layers,  3157200 parameters,  3157184 gradients,   8.9 GFLOPs
  s: [0.33, 0.50, 1024]  # YOLOv8s summary: 225 layers, 11166560 parameters, 11166544 gradients,  28.8 GFLOPs
  m: [0.67, 0.75, 768]   # YOLOv8m summary: 295 layers, 25902640 parameters, 25902624 gradients,  79.3 GFLOPs
  l: [1.00, 1.00, 512]   # YOLOv8l summary: 365 layers, 43691520 parameters, 43691504 gradients, 165.7 GFLOPs
  x: [1.00, 1.25, 512]   # YOLOv8x summary: 365 layers, 68229648 parameters, 68229632 gradients, 258.5 GFLOPs

# YOLOv8.0n backbone
backbone:
  # [from, repeats, module, args]
  - [-1, 1, Conv, [64, 3, 2]]  # 0-P1/2
  - [-1, 1, Conv, [128, 3, 2]]  # 1-P2/4
  - [-1, 3, C2f, [128, True]]
  - [-1, 1, Conv, [256, 3, 2]]  # 3-P3/8
  - [-1, 6, C2f, [256, True]]
  - [-1, 1, Conv, [512, 3, 2]]  # 5-P4/16
  - [-1, 6, C2f, [512, True]]
  - [-1, 1, Conv, [1024, 3, 2]]  # 7-P5/32
  - [-1, 3, C2f, [1024, True]]
  - [-1, 1, SPPF, [1024, 5]]  # 9
  - [-1, 1, PPA, [1024]]  # 10

# YOLOv8.0n head
head:
  - [-1, 1, nn.Upsample, [None, 2, 'nearest']]
  - [[-1, 6], 1, Concat, [1]]  # cat backbone P4
  - [-1, 3, C2f, [512]]  # 13

  - [-1, 1, nn.Upsample, [None, 2, 'nearest']]
  - [[-1, 4], 1, Concat, [1]]  # cat backbone P3
  - [-1, 3, C2f, [256]]  # 16 (P3/8-small)

  - [-1, 1, Conv, [256, 3, 2]]
  - [[-1, 13], 1, Concat, [1]]  # cat head P4
  - [-1, 3, C2f, [512]]  # 19 (P4/16-medium)

  - [-1, 1, Conv, [512, 3, 2]]
  - [[-1, 10], 1, Concat, [1]]  # cat head P5
  - [-1, 3, C2f, [1024]]  # 22 (P5/32-large)

  - [[16, 19, 22], 1, Detect, [nc]]  # Detect(P3, P4, P5)
实验
脚本
import os
from ultralytics import YOLO

yaml = 'ultralytics/cfg/models/v8/yolov8-PPA.yaml'


model = YOLO(yaml)

model.info()
if __name__ == "__main__":

    results = model.train(data='./ultralytics/cfg/datasets/coco8.yaml',
                          name='C2f_CascadedGroupAttention',
                          epochs=10,
                          amp=False,
                          workers=8,
                          batch=1,
                         device="cpu")
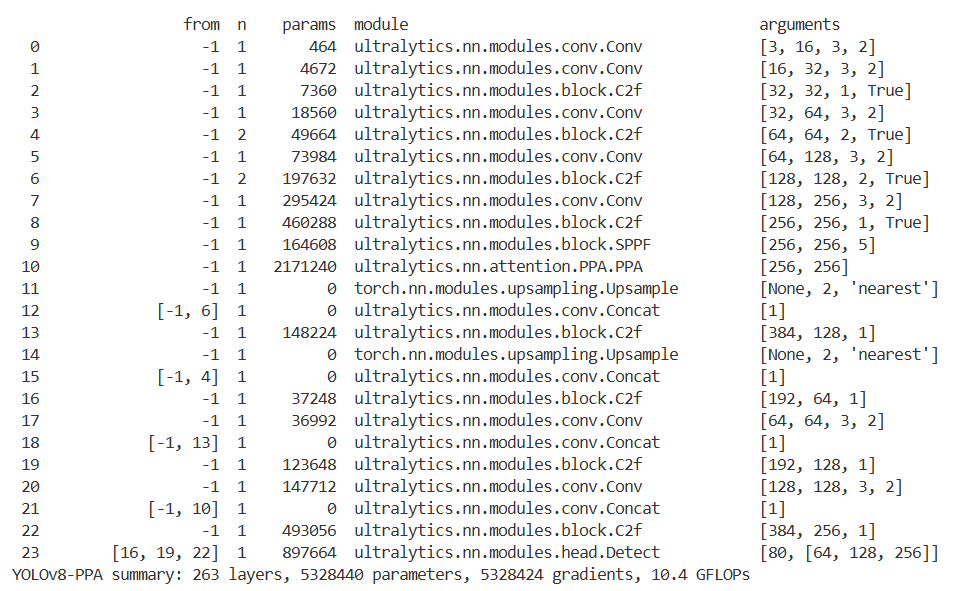
结果

汇聚全球AI编程工具,助力开发者即刻编程。
更多推荐


 8
 0
- 0


 已为社区贡献3条内容

所有评论(0)