
鸿蒙智能体开发实战:15.使用工作流
title: 鸿蒙智能体开发实战:15.使用工作流
date: 2026-04-15 08:00:00
tags: [鸿蒙智能体开发实战, 工作流, AI]
鸿蒙智能体开发实战:使用工作流
前言
在智能体开发中,单靠大模型的对话能力往往无法满足复杂的业务需求。工作流(Workflow) 是鸿蒙智能体平台提供的一种可视化任务编排工具,它允许开发者通过拖拽节点的方式构建多步骤的业务流程,让智能体具备执行复杂任务的能力。本文将深入介绍工作流的概念、创建流程、18种节点详解以及版本管理等进阶功能。
工作流概述
什么是工作流
工作流是将一系列任务按照预定义的逻辑顺序组织起来的可视化编排工具。每个工作流由多个节点(Node) 组成,节点之间通过连线连接,数据在节点间流动传递。
工作流的核心价值:将复杂业务拆分为可编排的步骤,实现"流程即代码"的工程化思维,让智能体的能力从简单对话扩展到复杂任务处理。
工作流 vs 智能体提示
| 特性 | 工作流 | 智能体提示(角色指令) |
|---|---|---|
| 任务复杂度 | 支持多步骤、分支、循环 | 单步骤、线性 |
| 可视化编排 | ✅ 拖拽式图形化界面 | ❌ 纯文本 |
| 条件分支 | ✅ 选择器节点 | ❌ 不支持 |
| 数据转换 | ✅ 代码节点、文本处理 | ❌ 不支持 |
| 复用性 | ✅ 可跨智能体复用 | ❌ 仅当前智能体 |
| 调试方式 | ✅ 单节点调试、试运行 | ❌ 需完整对话测试 |
创建工作流
新建工作流
在小艺开放平台页面,通过【资源库】→【工作流】→【新建工作流】,进入新建工作流配置页面:
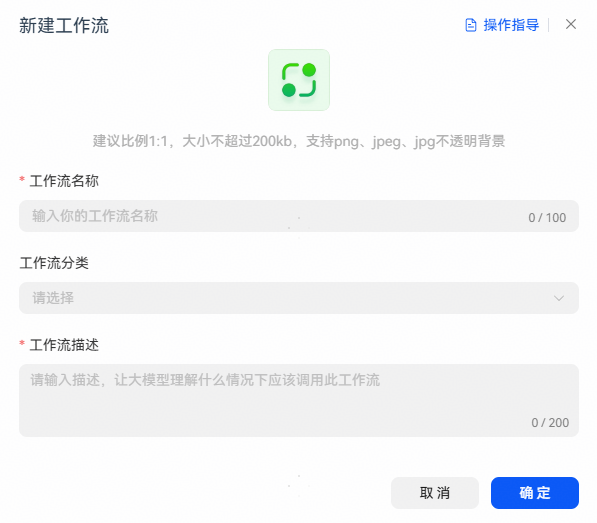
上图展示了在小艺开放平台中新建工作流的配置入口,设置名称、分类和描述后即可进入编排页面。
{
  "workflow": {
    "name": "天气查询工作流",
    "category": "信息查询",
    "description": "根据用户输入的城市名称,查询该城市当前的天气信息",
    "initial_nodes": ["start", "end"]
  }
}
创建后页面会自动跳转至工作流的编辑页面,初始状态下工作流包含开始节点和结束节点。
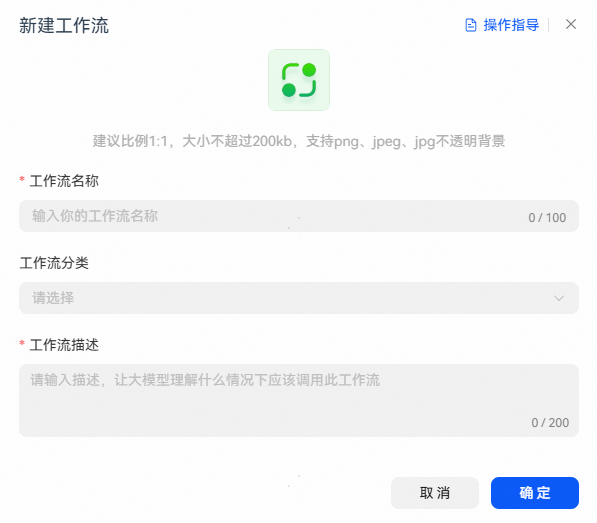
上图展示了在小艺开放平台中新建工作流的配置入口,设置名称、分类和描述后即可进入编排页面。
编排工作流
编排工作流的基本步骤如下:
- 在底部面板中选择要使用的节点
- 将节点按任务流程相连接
- 配置节点的输入和输出参数
# 工作流编排的逻辑示例
# 以下代码展示一个简单工作流的处理流程

def weather_query_workflow(user_input: str):
    """天气查询工作流的Python模拟"""
    # Step 1: 开始节点 - 接收用户输入
    city_name = extract_city(user_input)

    # Step 2: 插件节点 - 调用天气查询API
    weather_data = call_weather_api(city_name)

    # Step 3: 大模型节点 - 格式化回复
    response = generate_response(weather_data)

    # Step 4: 结束节点 - 返回结果
    return response
测试并发布工作流
工作流开发完成后,需要经过测试和发布才能在智能体中使用:
# 测试流程
1. 单击【试运行】按钮
2. 成功后节点的边框将显示为绿色
3. 在页面右侧弹窗中查看节点的输入输出
4. 单击【上架】,调测成功的工作流方可发布上架
工作流节点详解
鸿蒙工作流提供了 18种内置节点,覆盖了从数据输入、处理到输出的全流程:
节点功能对照表
| 序号 | 节点名称 | 功能说明 | 适用场景 |
|---|---|---|---|
| 1 | 开始节点 | 工作流的起始节点,设定启动输入信息 | 所有工作流的起点 |
| 2 | 结束节点 | 工作流的最终节点,返回运行结果 | 所有工作流的终点 |
| 3 | 大模型节点 | 调用大语言模型生成内容 | 文案生成、文本总结、文章扩写 |
| 4 | 插件节点 | 调用插件运行指定工具 | 天气查询、订单查询等API调用 |
| 5 | 工作流节点 | 嵌套调用另一个工作流 | 复杂任务模块化拆分 |
| 6 | 代码节点 | 编写Python代码处理数据 | 数据处理、格式转换、逻辑判断 |
| 7 | 选择器节点 | if-else条件分支 | 根据条件执行不同流程 |
| 8 | 意图分类节点 | 识别用户意图并分流 | 客服智能体、多意图处理 |
| 9 | 输出节点 | 中间过程的回答或思考输出 | 流式输出、思考过程展示 |
| 10 | 循环节点 | 重复执行一系列任务 | 批量数据处理、遍历操作 |
| 11 | 批处理节点 | 一次性运行多次相同任务 | 多城市天气查询 |
| 12 | 知识库节点 | 查询知识库召回匹配信息 | FAQ问答、文档检索 |
| 13 | 变量节点 | 修改和存储用户变量值 | 数据动态更新、状态记录 |
| 14 | 文本处理节点 | 字符串拼接和分隔处理 | Prompt构建、数据格式化 |
| 15 | 提问器节点 | 主动收集用户信息 | 信息采集、选项确认 |
| 16 | 配额管理节点 | 对计数变量进行原子化赋值 | 资源扣减、调用管控 |
| 17 | 长期记忆节点 | 召回智能体的长期记忆数据 | 个性化推荐、用户画像 |
| 18 | 查询计数变量节点 | 读取计数变量的当前值 | 使用量查询、配额检查 |
开始节点
开始节点是工作流的起始节点,用于设定启动工作流需要的输入信息。它包含三个默认参数:
{
  "start_node": {
    "default_params": {
      "USER_INPUT": "用户在本轮对话中输入的原始内容",
      "FILES_INPUT": "用户上传的图片或文件(Array<string>类型)",
      "EVENT_INPUT": "触发智能体的事件消息"
    },
    "custom_params": ["String", "Boolean", "Integer", "Time", "Object"]
  }
}
注意:开始节点中的自定义参数,因无法从用户输入中接收,所以有自定义输入参数的工作流不支持在工作流模式的智能体中使用,仅支持试运行。
大模型节点
大模型节点可以调用大语言模型,根据输入参数和提示词生成内容:
# 大模型节点配置示例
llm_node_config = {
    "model": "Pangu-LLM",
    "parameters": {
        "top_k": 50,
        "top_p": 0.95,
        "temperature": 0.8
    },
    "system_prompt": "你是一个友好且专业的健康咨询助手。",
    "user_prompt": "我最近总是感到疲劳,这可能是什么原因呢?",
    "output_format": "text"  # text / markdown / json
}
提示:大模型节点支持配置技能(插件/工作流),扩展模型能力的边界。配置技能后,大模型节点可以自动进行意图识别并判断调用技能的时机。
选择器节点
选择器节点是一个 if-else 节点,用于设计工作流内的分支流程:
# 选择器节点的逻辑模拟
def selector_node(input_value, conditions):
    """
    选择器节点处理逻辑
    conditions = [
        {"if": "input_value > 100", "then": "branch_high"},
        {"if": "input_value > 50", "then": "branch_medium"},
        {"else": "branch_low"}
    ]
    """
    for condition in conditions:
        if condition.get("if"):
            if eval(condition["if"]):
                return condition["then"]
    return conditions[-1]["else"]  # 兜底分支
意图分类节点
意图分类节点能够识别用户输入的意图,并将不同的意图流转至工作流不同的分支处理:
{
  "intent_classification": {
    "categories": [
      {"name": "产品咨询", "flow": "knowledge_base_node"},
      {"name": "售后服务", "flow": "after_sale_workflow"},
      {"name": "投诉建议", "flow": "complaint_handler"}
    ],
    "fallback": "default_response"
  }
}
输出节点
输出节点支持三种模式:
| 模式 | 说明 | 是否支持绑卡 |
|---|---|---|
| 输出模式 | 输出中间过程回答内容 | ✅ 支持 |
| 思考模式 | 输出思考状态和思考内容 | ❌ 不支持 |
| 暂态模式 | 执行时间长时展示预设提示语 | ❌ 不支持 |
# 输出节点配置示例
output_node = {
    "mode": "thinking",
    "config": {
        "stepInfo": "思考中",
        "streamingTextId": "main_stream",
        "reasoningText": "正在分析用户的问题..."
    }
}

# 配合输出模式使用
output_node_result = {
    "mode": "output",
    "config": {
        "answer": "根据分析结果,建议您...",
        "streamingTextId": "main_stream",
        "stepInfo": "已深度思考"
    }
}
循环节点
循环节点支持三种循环方式:
# 1. 数组循环 - 类似 for 循环
def array_loop(items):
    results = []
    for index, item in enumerate(items):
        result = process_item(item)
        results.append(result)
    return results

# 2. 指定次数循环
def count_loop(times):
    for i in range(times):
        do_something()

# 3. 无限循环 - 类似 while 循环
def infinite_loop():
    while True:
        result = do_something()
        if condition_met(result):
            break  # 通过终止循环节点跳出
循环体中可以添加三种特殊节点:终止循环(break)、继续循环(continue)、设置变量。
批处理节点
批处理节点用于一次性运行多次相同任务。例如,一次性查询多个城市的天气:
# 批处理节点的逻辑模拟
def batch_process(cities: list):
    """
    批处理查询多个城市的天气
    并行运行数量:最多20个并发
    批处理次数上限:最多200次
    """
    max_parallel = min(len(cities), 20)
    results = []

    for city in cities:
        # 每个城市并行执行天气查询
        result = query_weather(city)
        results.append(result)

    return results
知识库节点
知识库节点可以基于用户输入查询指定的知识库,召回最匹配的信息:
# 知识库节点配置
knowledge_base_config = {
    "query": "用户的问题",
    "knowledge_bases": ["产品FAQ知识库", "技术文档库"],
    "retrieval_config": {
        "threshold": 0.5,        # 检索文本相关阈值
        "max_segments": 3,       # 最大召回分段数
        "max_chars": 500,        # 单条片段最大字符数
        "query_rewrite": True    # 查询改写(多轮对话)
    }
}
查询改写:在多轮对话中,用户的 Query 和对话的上下文息息相关。例如用户先问"知识库检索节点可以用来做什么?“,再问"怎么用?”,开启查询改写后第二个问题会被改写为"知识库检索节点怎么用?"。
代码节点
代码节点支持通过编写Python代码来生成返回值:
# 代码节点示例:数据处理
def process_order_data(input_data: dict) -> dict:
    """
    处理订单数据的代码节点
    注意:代码节点仅企业开发者可用,基于Python 3.11.4
    """
    order_id = input_data.get("orderId")
    status = input_data.get("status")

    # 数据处理逻辑
    result = {
        "orderId": order_id,
        "status": status,
        "processed": True,
        "timestamp": "2026-04-15 10:00:00"
    }

    return result
安全限制:代码节点禁用了网络请求和系统资源访问,如
os.system、subprocess、eval等高风险函数。
提问器节点
提问器节点用于主动收集用户的信息,支持三种方式:
{
  "questioner": {
    "mode": "direct_answer",
    "question": "请问您需要查询哪个城市的天气?",
    "field_name": "city"
  }
}
动态生成槽位示例:
{
  "extractedFields": [
    {
      "fieldName": "depart_time",
      "description": "航班的起飞时间",
      "cnFieldName": "起飞时间",
      "fieldType": "String",
      "required": true,
      "defaultValue": "2025年1月8日12:00"
    },
    {
      "fieldName": "arrive_time",
      "description": "航班的到达时间",
      "cnFieldName": "到达时间",
      "fieldType": "String",
      "required": false
    }
  ]
}
工作流版本管理
版本存档方式
工作流版本管理支持三种存档方式:
| 存档类型 | 触发条件 | 说明 |
|---|---|---|
| 上架存档 | 工作流每次上架完成 | 自动记录 |
| 系统存档 | 工作流发生编辑后 | 自动保存为【当前】版本 |
| 手动存档 | 手动点击存档图标 | 填写存档描述后生成记录 |
版本操作
- 预览历史版本:查看版本编排内容或试运行,不可编辑
- 还原到该版本:将历史版本覆盖当前工作流的草稿版本
- 版本筛选:按存档类型筛选历史版本
导入导出工作流
导出工作流
点击工作流操作项中的【导出】按钮,可以将工作流导出为JSON文件:
# 导出工作流文件
# 文件格式:.json,包含各节点详细信息
# 支持选择是否一并导出嵌套的工作流节点
导入工作流
点击工作流列表右上方的【导入工作流】,上传导出的JSON文件:
注意事项:
- 部分组件的有效性与账号有关,导入后可能存在失效(如插件、知识库、工作流)
- 如果工作流中包含子工作流节点,需要先导入子工作流并上架,再导入主工作流
工作流最佳实践
1. 复杂任务模块化
# 使用工作流节点实现模块化
main_workflow = {
    "nodes": [
        {"type": "start"},
        {"type": "intent_classification"},
        {"type": "workflow", "name": "order_query_workflow"},  # 子工作流
        {"type": "workflow", "name": "after_sale_workflow"},   # 子工作流
        {"type": "end"}
    ]
}
2. 流式输出与参考来源
输出节点支持配置参考来源,让回复更可信:
{
  "reference": {
    "items": [{
      "params": {
        "name": "环球网",
        "source": "华为浏览器"
      },
      "card": {
        "type": "leftPictureRightText",
        "params": {
          "title": "网页标题",
          "subTitle": "站点名称-站点来源类型",
          "link": {
            "webLink": {
              "startMode": 0,
              "url": "https://example.com/article"
            }
          }
        }
      }
    }]
  }
}
3. 处理非文本请求
当工作流需要处理用户上传的图片或文件时,可以通过开始节点的 FILES_INPUT 参数接收,再借助文本处理组件提取文件链接:
# FILES_INPUT 是一个 Array<string> 类型参数
# 通过文本处理组件的字符串拼接方式取出目标链接
file_url = input[0]  # 取出第一个文件链接
4. 用户问题建议
输出节点支持配置用户问题建议(suggestions),引导用户后续对话:
{
  "suggestions": {
    "chipsList": [
      {"content": "superlink://vassistant?text=如何缓解压力?&startmode=recognize", "domain": "documentSummary"},
      {"content": "superlink://vassistant?text=常见症状有哪些?&startmode=recognize", "domain": "documentSummary"}
    ]
  }
}
注意:最多只会展示一组用户问题建议,最多3条,每条不超过30个字符。
常见问题(FAQ)
Q1:工作流试运行失败如何排查?
答:首先检查节点的边框颜色——运行成功的节点边框显示为绿色,失败的节点会显示错误信息。可以在运行结果面板中查看调测树信息,定位失败节点。
Q2:工作流模式的智能体使用返回变量的结束节点时没有响应内容?
答:工作流模式的智能体,如果结束节点配置了返回变量,因为没有大模型做融合答复,智能体会没有响应内容。可以为结束节点绑定卡片,或者改为返回文本模式。
Q3:工作流中的插件版本如何更新?
答:工作流中添加的插件如果有版本更新,在工作流试运行时会自动执行新版本插件。如果工作流已被智能体引用,需更新发布工作流后在引用资源中升级到新版本。
Q4:流式云插件的结果为什么在后续节点获取不到?
答:流式云插件注册时含默认输出参数 streamInfo(string类型),后续节点必须通过引用 streamInfo 字段获取流式结果。
总结
本文全面介绍了鸿蒙智能体平台的工作流功能:
- 工作流概念:可视化任务编排工具,将复杂业务拆分为可编排步骤
- 创建流程:新建→编排→测试→上架四个阶段
- 18种节点:覆盖输入、处理、输出全流程的各类节点
- 高级功能:版本管理、导入导出、流式输出、参考来源
- 最佳实践:模块化设计、非文本处理、用户问题建议
掌握工作流开发是构建复杂智能体的关键一步,它让智能体具备了真正的"工程化"能力。
如果这篇文章对你有帮助,欢迎点赞👍、收藏⭐、关注🔔,你的支持是我持续创作的动力!
相关资源

汇聚全球AI编程工具,助力开发者即刻编程。
更多推荐
 8
 0
- 0


 已为社区贡献3条内容

所有评论(0)