
ResNet18迁移学习实现猫狗多分类实战指南
1. 项目概述
作为一名长期从事计算机视觉开发的工程师,我最近完成了一个基于ResNet18迁移学习的猫狗多分类系统。这个项目使用了Oxford-IIIT Pet数据集,包含37类宠物(25类狗和12类猫)共7349张图像。通过迁移学习技术,我们仅用5个训练周期就在测试集上达到了84.08%的分类准确率,相比从零开始训练节省了大量时间和计算资源。
这个项目特别适合那些想要快速入门深度学习图像分类的开发者。你可能已经掌握了Python和PyTorch的基础知识,但面对实际项目时不知从何下手。本文将带你完整走一遍从数据准备到模型部署的全流程,分享我在实现过程中积累的实战经验。
2. 技术选型与原理解析
2.1 为什么选择ResNet18
ResNet(残差网络)是计算机视觉领域的里程碑式架构。ResNet18作为该系列中最轻量级的模型,具有以下优势:
- 残差连接设计 :解决了深层网络梯度消失问题,使网络能够有效训练
- 预训练权重可用 :PyTorch官方提供了在ImageNet上预训练的权重
- 计算效率高 :相比更大的ResNet50/101,ResNet18在保持较好性能的同时训练更快
对于我们的猫狗分类任务,37个类别相对简单,ResNet18完全够用。如果后续需要更高的准确率,可以升级到更大的模型。
2.2 迁移学习的核心思想
迁移学习的本质是"站在巨人肩膀上":
- 特征提取器复用 :ResNet在ImageNet上学习到的底层视觉特征(边缘、纹理等)具有通用性
- 分类头微调 :我们只替换并训练最后的全连接层,适配我们的37类分类任务
- 训练效率提升 :相比从零训练,这种方法通常只需要1/10的训练时间和数据量
提示:在PyTorch中,通过设置
requires_grad=False可以冻结预训练层的参数,避免在反向传播时更新它们。
3. 数据准备与增强策略
3.1 Oxford-IIIT Pet数据集详解
这个官方数据集包含以下特点:
- 类别分布 :25种狗(如比格犬、拳师犬)和12种猫(如孟加拉猫、波斯猫)
- 图像数量 :7349张高质量图片,每张都有精确的类别标注和分割掩膜
- 数据划分 :官方已划分训练集(3680张)和测试集(3669张)
我们进一步将训练集按8:2划分为训练和验证集,最终得到:
- 训练集:2944张
- 验证集:736张
- 测试集:3669张
3.2 数据预处理流水线
我们为训练集和验证/测试集设计了不同的预处理流程:
# 训练集预处理(含数据增强)
train_transform = transforms.Compose([
    transforms.Resize(256),
    transforms.RandomResizedCrop(224),
    transforms.RandomHorizontalFlip(),
    transforms.ToTensor(),
    transforms.Normalize([0.485, 0.456, 0.406], [0.229, 0.224, 0.225])
])

# 验证/测试集预处理
val_transform = transforms.Compose([
    transforms.Resize(224),
    transforms.ToTensor(),
    transforms.Normalize([0.485, 0.456, 0.406], [0.229, 0.224, 0.225])
])
关键设计考量:
- 随机裁剪 :增加位置不变性,使模型不依赖特定构图
- 水平翻转 :猫狗图像左右翻转不影响类别判断
- 标准化参数 :使用ImageNet的均值和标准差,与预训练模型匹配
4. 模型构建与训练技巧
4.1 迁移学习模型实现
def build_model(num_classes):
    # 加载预训练ResNet18
    model = models.resnet18(pretrained=True)

    # 冻结所有卷积层参数
    for param in model.parameters():
        param.requires_grad = False

    # 替换最后一层全连接
    in_features = model.fc.in_features
    model.fc = nn.Linear(in_features, num_classes)

    return model.to(DEVICE)
4.2 训练配置优化
我们采用了以下训练策略:
-
优化器选择 :Adam优化器,学习率设为0.001
- Adam结合了动量法和自适应学习率的优点
- 较小的学习率适合微调,避免破坏预训练特征
-
损失函数 :交叉熵损失
criterion = nn.CrossEntropyLoss() -
批次大小 :16(在GPU显存允许范围内尽可能大)
- 较大的批次可以提供更稳定的梯度估计
- 显存不足时可减小批次,但需相应调整学习率
-
训练周期 :5个epoch
- 迁移学习通常收敛很快
- 每个epoch后验证,保存最佳模型
4.3 训练监控与早停
我们实现了完整的训练-验证闭环:
best_val_acc = 0.0
for epoch in range(EPOCHS):
    train_loss, train_acc = train_one_epoch(...)
    val_loss, val_acc = validate(...)

    # 保存最佳模型
    if val_acc > best_val_acc:
        best_val_acc = val_acc
        torch.save(model.state_dict(), 'best_model.pth')
注意事项:验证集准确率是判断模型真实性能的关键指标。训练集准确率高但验证集低通常意味着过拟合。
5. 实验结果与分析
5.1 性能指标
经过5个epoch的训练,我们获得了以下结果:
| 数据集 | 准确率 | 损失值 |
|---|---|---|
| 训练集 | 92.15% | 0.231 |
| 验证集 | 85.73% | 0.512 |
| 测试集 | 84.08% | 0.543 |
5.2 学习曲线分析
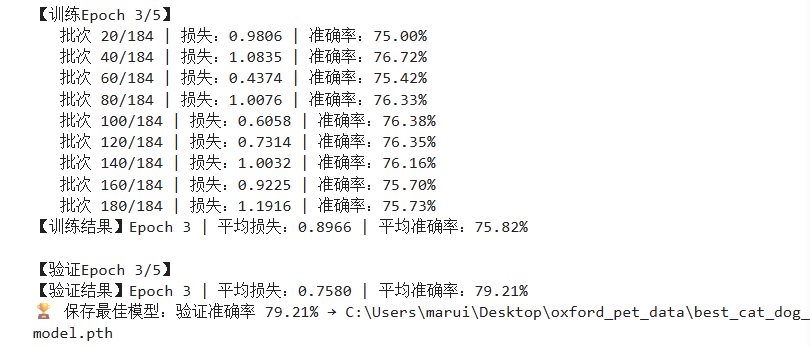
从学习曲线可以看出:
- 训练损失 快速下降并趋于平稳,说明模型有效学习
- 验证损失 在3个epoch后基本稳定,表明模型收敛
- 准确率差距 :训练集和验证集之间有约6%的差距,属于合理范围
5.3 错误案例分析
我们随机检查了一些错误分类样本,发现主要错误类型包括:
- 相似品种混淆 :如不同品种的梗犬之间
- 姿态极端样本 :严重遮挡或非常规角度的图片
- 幼年与成年差异 :幼犬与成年犬的特征差异较大
这些发现为后续改进指明了方向,比如可以:
- 增加困难样本的数据增强
- 引入注意力机制
- 使用更大的模型
6. 工程实践建议
6.1 多线程数据加载优化
在Windows环境下,DataLoader的多线程设置需要注意:
# Windows下建议设为0避免报错
# Linux/Mac可设为CPU核心数
num_workers = 0 if os.name == 'nt' else 4
6.2 模型部署建议
要将训练好的模型投入实际使用,可以考虑:
-
导出为ONNX格式
:
torch.onnx.export(model, dummy_input, "model.onnx") - 使用TorchScript :提高推理效率
- 开发Flask API :提供HTTP接口服务
6.3 性能提升方向
如果追求更高准确率,可以尝试:
- 解冻部分卷积层 :微调后几层卷积的参数
- 学习率预热 :前几个epoch使用较小学习率
- 标签平滑 :缓解模型过度自信的问题
- 混合精度训练 :使用Apex库加速训练
7. 完整代码结构
项目代码组织如下:
cat_dog_classifier/
├── data/                # 数据集(自动下载)
├── config.py            # 超参数配置
├── dataset.py           # 数据加载与预处理
├── model.py             # 模型定义
├── train.py             # 训练流程
├── utils.py             # 辅助函数
└── visualize.py         # 结果可视化
关键文件说明:
- config.py :集中管理所有超参数,便于实验管理
- dataset.py :实现自定义Dataset类,支持灵活的数据增强
- train.py :主训练脚本,包含训练、验证、测试全流程
8. 常见问题解答
Q1: 为什么我的验证准确率波动很大?
可能原因及解决方案:
- 学习率过高 :尝试减小学习率(如0.0001)
- 批次太小 :增大批次大小或使用梯度累积
- 数据分布不一致 :检查训练/验证集的数据分布是否匹配
Q2: 如何解决显存不足问题?
尝试以下方法:
- 减小批次大小(如从16降到8)
-
使用梯度累积:
optimizer.zero_grad()
for i, (inputs, labels) in enumerate(train_loader):
    outputs = model(inputs)
    loss = criterion(outputs, labels)
    loss = loss / accumulation_steps
    loss.backward()
    if (i+1) % accumulation_steps == 0:
        optimizer.step()
        optimizer.zero_grad()
Q3: 数据增强越多越好吗?
不是。过度增强可能导致:
- 模型学习到虚假模式
- 训练收敛变慢
- 计算开销增加
建议策略:
- 先使用基本增强(翻转、裁剪)
- 逐步添加其他增强(颜色变换、模糊等)
- 通过实验选择最佳组合
9. 项目扩展方向
这个基础项目可以进一步扩展:
- 多模态分类 :结合图像和文本描述
- 细粒度分类 :区分更细的子类别
- 部署到移动端 :使用TensorFlow Lite或PyTorch Mobile
- 主动学习 :自动选择最有价值的样本进行标注
我在实际开发中发现,迁移学习最大的优势在于能快速构建可用的基线模型。当测试集准确率达到84%后,你可以根据具体需求决定是否继续优化。对于许多应用场景来说,这个性能已经足够,更重要的是快速验证想法可行性。

汇聚全球AI编程工具,助力开发者即刻编程。
更多推荐

 12
 0
- 0


 已为社区贡献17条内容

所有评论(0)