
零代码机器学习实战|基于 K-Means 聚类实现学生考勤群体分群与标签扩充(助睿 AI+ETL+BI 全流程)
一、实验概述
1.1 实验目的
本次实验依托助睿 Uniplore一站式数据科学平台,基于已有的学生考勤主题标签表,以迟到、早退、请假、未穿校服次数作为核心特征,使用K-Means 无监督聚类算法完成学生考勤行为自动分群。结合数据可视化解读聚类结果,为不同聚类簇赋予业务含义,划分出多类考勤群体;最后通过 ETL 工具将聚类编号、群体标签回写至原始数据表,完成考勤扩展标签构建,为校园学生行为分析、精细化管理与精准干预提供数据支撑。
1.2 实验环境
- 实验平台:助睿在线实验平台 https://lab.guilian.cn/
- 配套官网:助睿数智 https://www.uniplore.com/
- 核心模块:人工智能 AI Studio、数据集成 ETL、助睿 BI 数据可视化
- 数据库:MySQL 团队私有数据库
- 前置数据源:
student_attendance_stats学生考勤主题标签表 - 运行设备:普通计算机,具备平台访问及数据库连接权限
二、实验数据与建模思路
2.1 数据源介绍
实验数据源为student_attendance_stats,整合了学生基础信息、年级、性别、校区、住校状态以及四类考勤违纪统计数据,字段覆盖文本、分类、连续数值、日期等多种类型。本次仅选用考勤次数类数值字段参与聚类建模,学生基础属性仅用作后续画像辅助分析。
2.2 核心字段说明
表格
| 字段名称 | 字段类型 | 说明 | 是否参与建模 |
|---|---|---|---|
| student_id | 整型 | 学生 ID | 是(维度标识) |
| class_id | 整型 | 班级 ID | 是(维度标识) |
| late_count | 整型 | 迟到次数 | 是(核心特征) |
| early_leave_count | 整型 | 早退次数 | 是(核心特征) |
| leave_count | 整型 | 请假次数 | 是(核心特征) |
| uniform_violate_count | 整型 | 未穿校服次数 | 是(核心特征) |
| 其余字段 | 文本 / 日期 | 姓名、年级、性别、校区等 | 否 |
2.3 建模思路
- 特征选择:选取迟到、早退、请假、未穿校服四类次数作为聚类特征,字段业务含义独立、相关性低,无数据冗余,模型解释性强。
- 数据适配:考勤次数均为非负连续整数,完全适配 K-Means 算法,无需额外做归一化、哑变量编码等复杂预处理。
- 建模规则:固定聚类簇数量为3 类,贴合校园考勤业务场景,划分不同纪律等级的学生群体。
- 分工逻辑:数值指标用于聚类分群,学生基础属性仅用于后期群体画像解读,不参与模型训练。
三、完整实验操作步骤(附截图指引)
3.1 AI Studio 完成 K-Means 聚类建模
3.1.1 新建 AI 工作流
- 登录平台,左侧菜单栏进入 ** 人工智能(AI Studio)** 模块。
- 点击「+」→新建工作流,搭建机器学习流程画布。
3.1.2 数据库加载原始数据
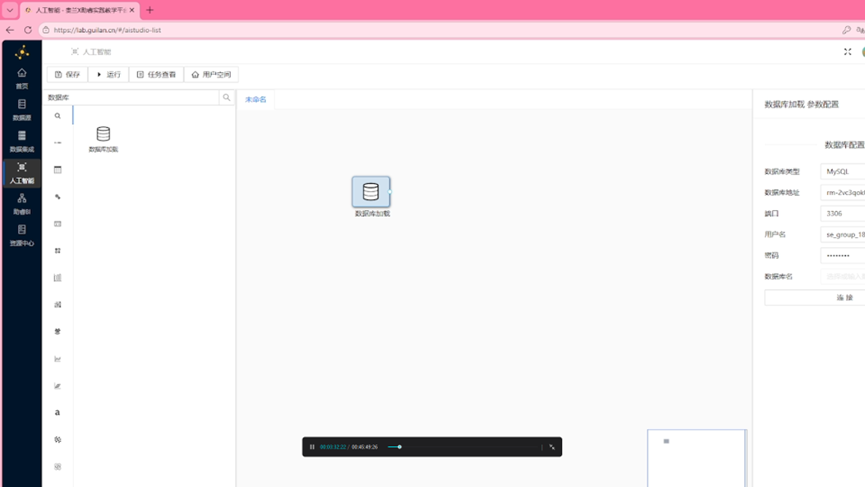
- 在组件库搜索并拖拽数据库加载组件至画布。
- 双击组件,配置团队私有 MySQL 数据库并完成连接,选择数据表
student_attendance_stats。 - 字段筛选:仅保留
student_id、class_id、late_count、early_leave_count、leave_count、uniform_violate_count,其余字段设置为skip,并区分分类型、数值型字段属性。 - 右键运行组件,执行成功后查看输出数据预览。
3.1.3 配置并运行 K-Means 聚类
- 拖拽K-Means组件,连线至数据库加载组件输出端。
- 双击组件设置参数:簇数量 = 3,其余参数保持默认。
- 右键运行组件,模型执行完成后,每条数据会被标记聚类编号
C1/C2/C3。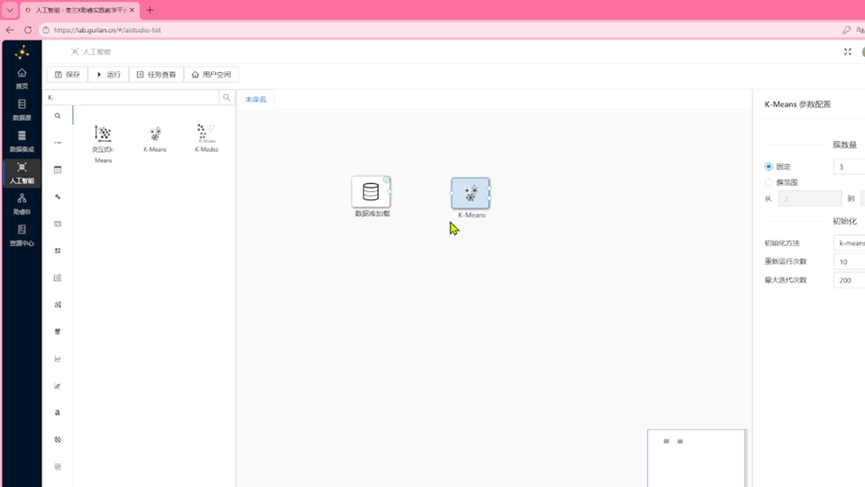
3.1.4 聚类结果入库保存
- 拖拽数据入库组件,连接 K-Means 输出结果。
- 配置数据库连接,选择新建数据表,命名为
student_cluster。 - 运行整条工作流,将聚类编号、轮廓系数、原始特征等数据持久化到数据库。
3.2 助睿 BI 可视化解读聚类群体
单纯的聚类编号不具备业务含义,借助助睿 BI 制作散点图,分析三类簇的行为特征,完成群体定义。
3.2.1 新建数据源与数据集
-
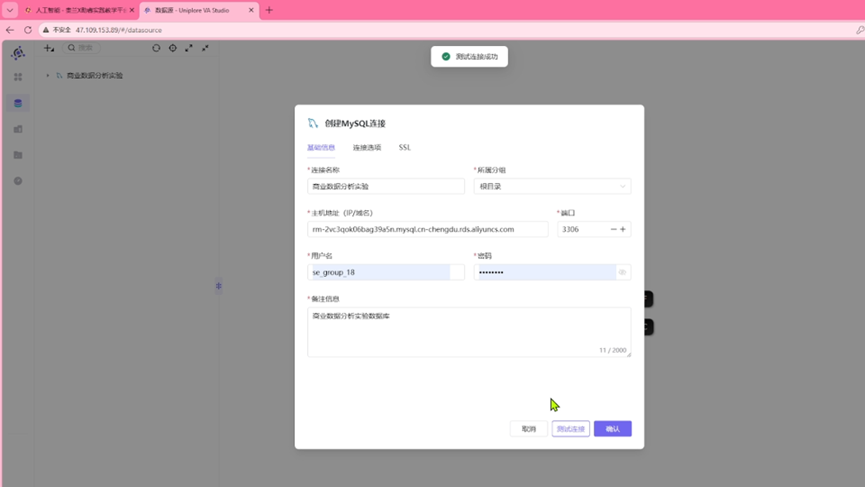
进入助睿 BI模块,点击「数据源」→新建 MySQL 连接,填入团队数据库信息,测试连接并保存。📷 截图 5:BI 平台 MySQL 数据源创建与连接测试
-
进入「数据集」,新建数据集,选择对应数据源与
labs目录,将student_cluster数据表拖拽至画布。 -
批量修改字段中文备注,核对表结构后保存并发布数据集。
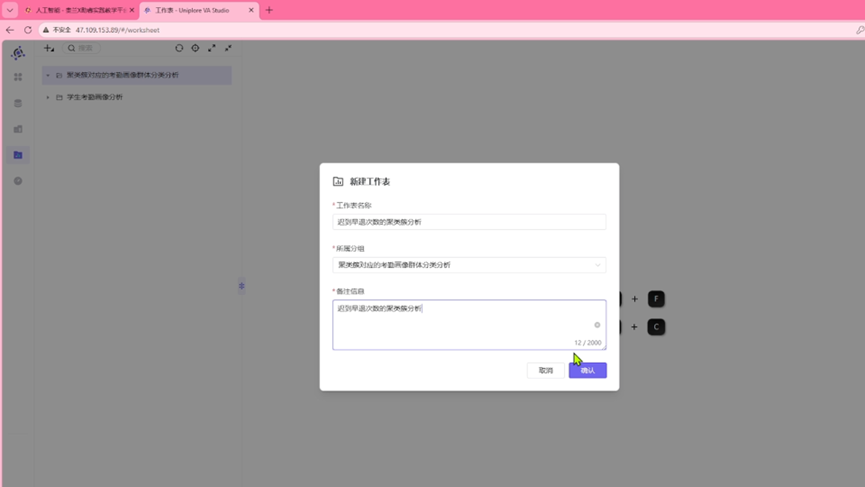
3.2.2 制作探索器散点图
- 进入「工作表」,新建分组统一管理图表,在分组内依次新建工作表。
- 图表类型选择探索器(散点图),两两组合四类考勤指标搭建分析图表:
- 迟到次数 VS 早退次数
- 迟到次数 VS 请假次数
- 迟到次数 VS 未穿校服次数
- 早退次数 VS 请假次数
- 早退次数 VS 未穿校服次数
- 请假次数 VS 未穿校服次数
- 配置规则:X/Y 轴对应考勤字段,颜色绑定
Cluster聚类编号,信息绑定student_id,数据限额设置为 100%,调整主题色区分不同簇,完成后保存发布。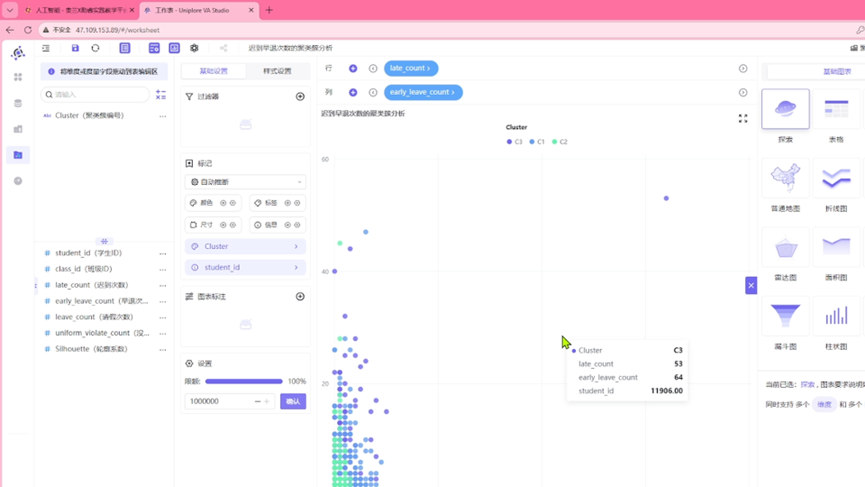
3.2.3 搭建综合分析仪表盘
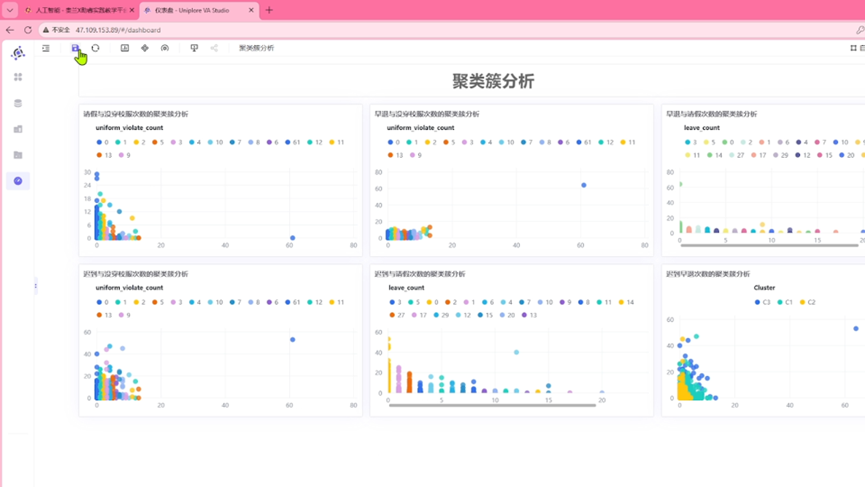
- 进入「仪表盘」模块,新建仪表盘并命名为「聚类簇分析」。
- 拖拽文本组件制作标题,再将 6 张散点图依次添加至画布,自由调整布局、大小。
- 完成后保存并发布仪表盘,支持集中查看、对比所有聚类分布特征。
3.2.4 聚类群体业务解读
结合六组散点图分布规律,对三类聚类簇进行业务释义:
表格
| 聚类簇编号 | 标识颜色 | 群体名称 | 核心行为特征 |
|---|---|---|---|
| C1 | 蓝色 | 自律模范型 | 各类考勤异常次数极低,数据集中在低位,出勤稳定、纪律意识强 |
| C2 | 青色 | 轻微波动型 | 迟到、早退极少,仅偶发请假或未穿校服行为,整体纪律可控 |
| C3 | 黄色 | 纪律高危型 | 高频违纪,多类异常行为叠加,存在大量离群数据,为重点管控群体 |
3.3 ETL 工具实现标签回写与字段扩充
通过 ETL 将聚类编号、中文群体标签追加到原始考勤表,完成标签扩充。
3.3.1 为原始表新增扩展字段
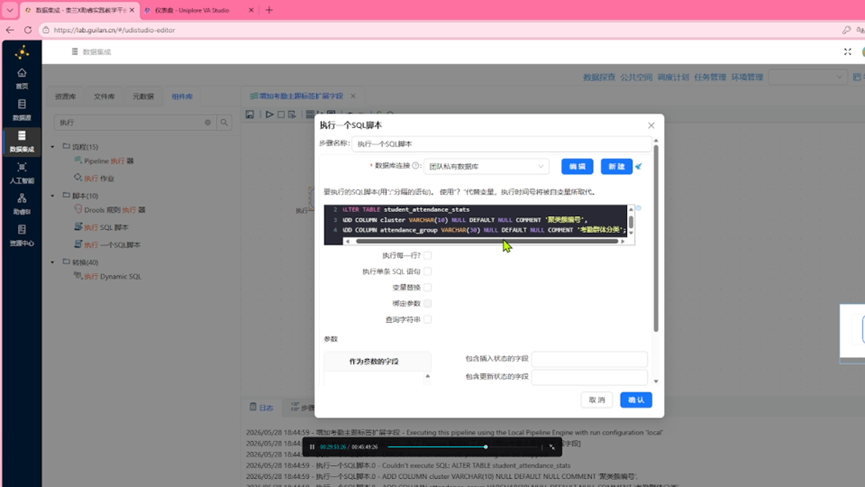
- 进入数据集成 ETL模块,新建转换流,拖拽执行 SQL 脚本组件。
- 连接团队私有数据库,执行以下 SQL 语句,为
student_attendance_stats新增两个字段:
sql
ALTER TABLE student_attendance_stats
ADD COLUMN cluster VARCHAR(10) NULL DEFAULT NULL COMMENT '聚类簇编号',
ADD COLUMN attendance_group VARCHAR(30) NULL DEFAULT NULL COMMENT '考勤群体分类';
- 运行转换流,完成表结构变更。
3.3.2 读取聚类结果并精简字段
- 新建转换流「增加考勤群体分类标签」,拖拽表输入组件,读取
student_cluster表数据。 - 搭配字段选择组件,仅保留
student_id、Cluster两个关键字段,删除冗余内容,并统一字段数据类型。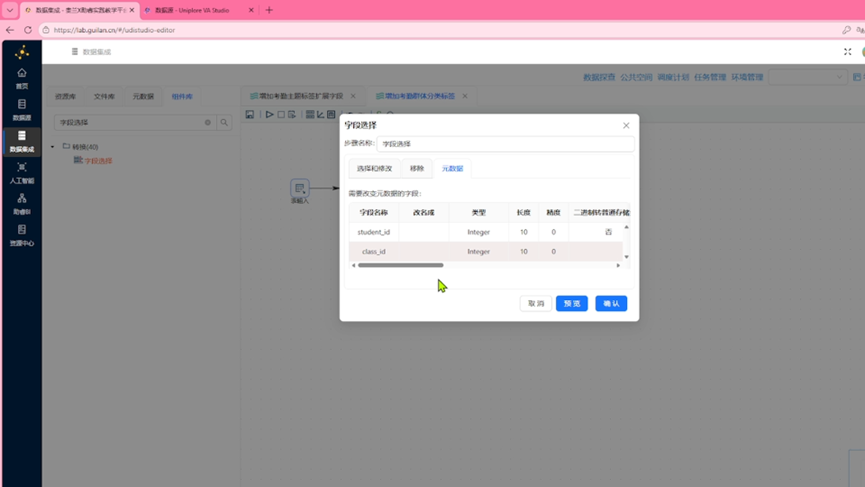
3.3.3 聚类编号映射为中文标签
- 拖拽值映射组件,连线至字段选择组件。
- 配置映射规则:
- C1 → 自律模范型
- C2 → 轻微波动型
- C3 → 纪律高危型
- 生成新字段
attendance_group,实现编号到中文标签的转换。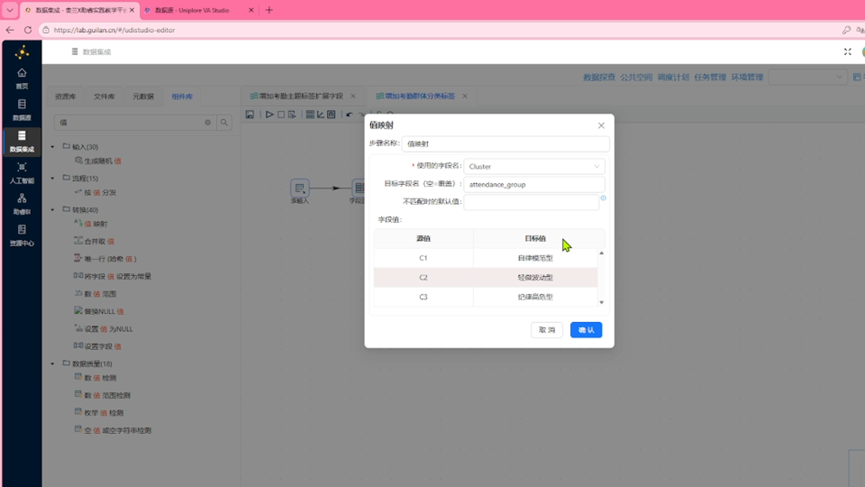
3.3.4 数据更新至原始考勤表
- 拖拽更新组件,连接值映射输出端。
- 选择目标表
student_attendance_stats,设置关联条件:根据 student_id 匹配数据。 - 配置更新规则:将流中的
Cluster、attendance_group写入目标表对应新增字段。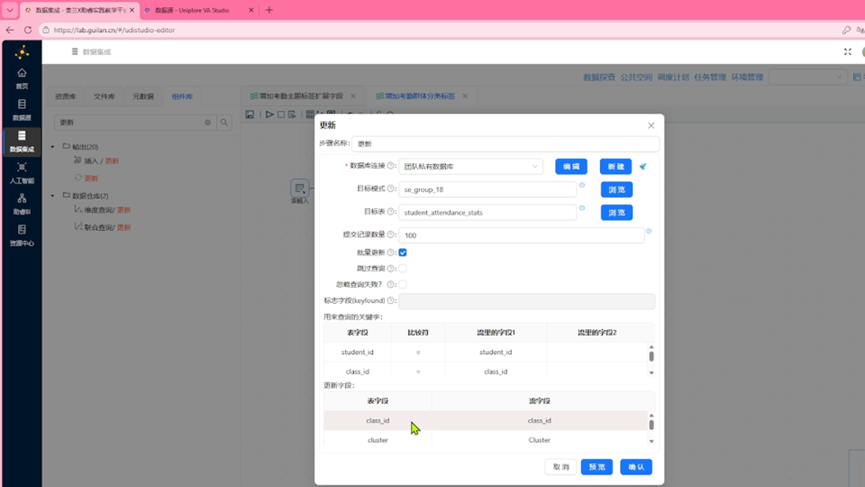
3.3.5 运行流程并验证结果
- 运行整条 ETL 转换流,查看执行日志确保无报错。
- 通过数据探查功能打开
student_attendance_stats,校验cluster与attendance_group字段数据是否更新成功。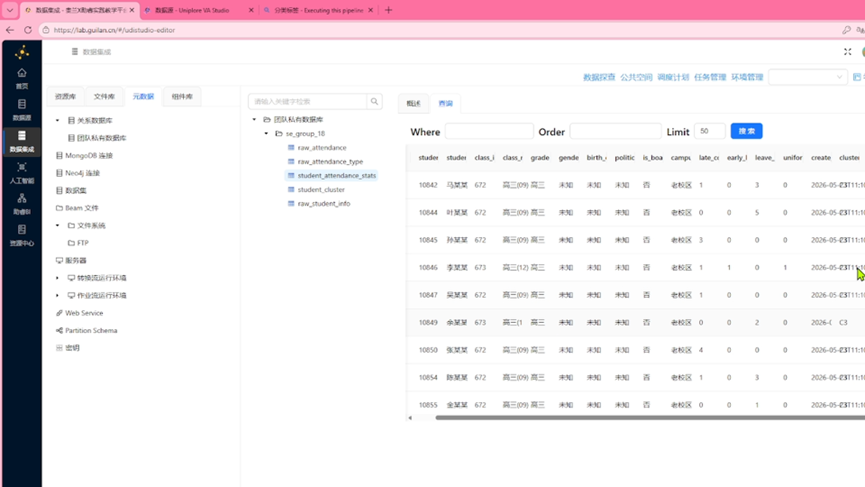
四、实验总结
- 技术流程闭环:本次实验串联AI 聚类建模、BI 可视化分析、ETL 数据更新三大模块,完整复现了「特征选取→模型训练→结果解读→标签落地」的标准数据挖掘全流程,全程零代码拖拽操作,大幅降低机器学习落地门槛。
- 模型效果与业务结合:基于 K-Means 算法成功将全体学生划分为三类考勤群体,通过散点图完成聚类结果的业务化解读,让机器生成的抽象编号转变为可落地、可理解的用户画像。
- 数据价值落地:利用 ETL 工具将聚类标签回写至业务表,扩充学生考勤标签体系,形成标准化数据集。
- 应用场景延伸:该方案不仅适用于校园考勤分析,也可迁移至员工行为分群、用户消费聚类、风险人群识别等场景,具备较强的复用性。
整套流程充分体现了零代码数据平台在教学、企业数据加工中的优势,无需深厚编程功底,即可完成从原始数据到智能标签的全链路处理,为校园精细化管理提供了扎实的数据支撑。
文章标签
#助睿数智 #零代码 AI #KMeans 聚类 #数据挖掘 #学生画像 #考勤数据分析 #ETL 数据集成 #数据标签化

汇聚全球AI编程工具,助力开发者即刻编程。
更多推荐

 8
 0
- 0


 已为社区贡献1条内容

所有评论(0)