
[人工智能]国内国外大型语言模型技术比较指南V02(2026.9月)
国内国外大型语言模型技术比较指南
Claude, GPT, Gemini, Copilot, Llama, Grok, DeepSeek, Qwen3.8-Max, ERNIE, Doubao, Hunyua, Kimi, GLM(智谱AI)
本文从工程视角比较Claude、GPT、Gemini、Copilot、Llama、Grok、DeepSeek、Qwen3.8-Max、ERNIE、Doubao、Hunyua、Kimi和GLM(智谱AI),覆盖模型定位、推理、编程、多模态、长上下文、检索、工具、智能体、企业部署和治理。
本文是定性选型参考,不是当前基准排名。版本、API、价格、上下文、访问条件、安全策略和许可证会变化。生产采用前应核实具体版本,并使用统一真实任务评估。
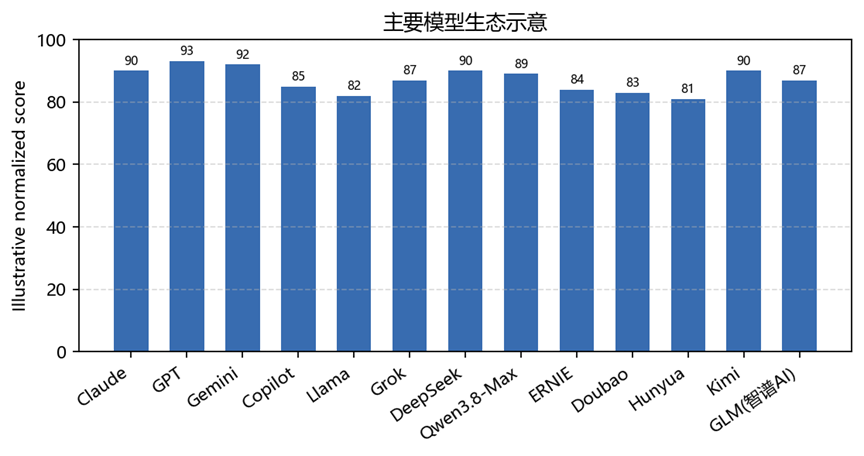
图1:模型能力轮廓示意,数值不代表正式基准结果。
|
模型 |
组织 |
定位 |
优势方向 |
工程重点 |
|
Claude |
Anthropic |
谨慎助手与推理模型家族 |
写作、分析、长上下文、工具 |
证据、策略行为、权限 |
|
GPT |
OpenAI |
通用模型平台 |
推理、编程、多模态、智能体 |
结构化输出、工具、成本 |
|
Gemini |
|
多模态模型家族与平台 |
文本、图像、音频、视频、代码 |
跨模态接地、生态 |
|
Copilot |
Microsoft |
生产力与企业AI |
编程、文档、会议、搜索 |
身份、来源、审核 |
|
Llama |
Meta |
开放权重模型家族 |
私有服务、定制、研究 |
供应链、许可证、安全 |
|
Grok |
xAI |
通用助手与对话模型家族 |
对话、推理、编程、当前信息 |
访问、来源、安全、边界 |
|
DeepSeek |
DeepSeek |
推理与编程模型家族 |
数学、代码、研究、技术任务 |
推理质量、成本、部署 |
|
Qwen3.8-Max |
阿里巴巴 |
大型通用企业模型 |
中英文、编程、工具、长上下文 |
版本、API、上下文行为 |
|
ERNIE |
百度 |
中文理解与企业AI生态 |
知识服务、中文理解、智能体 |
接地、领域语言、治理 |
|
Doubao |
字节跳动 |
助手与内容AI生态 |
对话、创作、多模态体验 |
安全、可用性、流程 |
|
Hunyua |
腾讯 |
基础模型生态标签 |
中文内容、多模态、企业服务 |
准确名称、版本、数据边界 |
|
Kimi |
月之暗面 |
长上下文知识工作家族 |
文档、研究、综合 |
引用、检索保真、稳定性 |
|
GLM(智谱AI) |
智谱AI |
通用与智能体方向模型家族 |
中文推理、编程、工具、企业 |
端点、授权、安全、工具 |
表1:十三类模型家族高层比较。
1. 模型只是系统的一部分
生产级LLM应用结合模型、提示词、策略、检索、身份、工具、记忆、界面、监控和人工审核。相似的聊天表现可能隐藏接地、数据边界、可控性、延迟、成本和运维责任的差异。
应使用统一评测工具,保持提示词、文档、工具和评分一致。测量任务成功率、事实性、推理、结构化输出、多语言、延迟、成本、安全、隐私和可靠性,并分析失败严重程度。
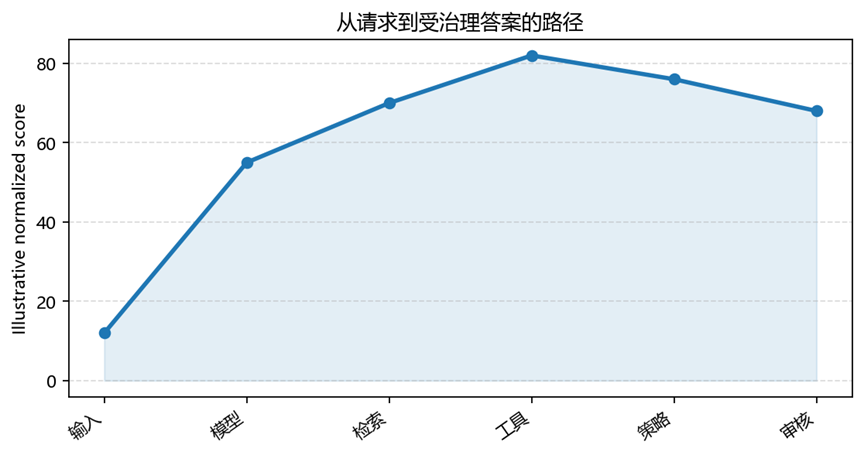
图2:生产应用通常在模型外围增加检索、工具、策略和审核。
2. Claude与GPT
Claude常用于谨慎助手、写作、分析和长上下文知识工作。评估证据与假设、拒答、提示注入防护、长文档一致性和工具权限,并加入证据缺失与冲突来源。
GPT常用于对话、编程、推理、结构化输出、多模态和智能体。为任务定义输入、工具、输出、拒答、不确定性、延迟和语义校验契约。结构化输出不能替代业务规则检查。
3. Gemini与Copilot
Gemini适合文本、图像、音频、视频和代码多模态工作流。分别测试各模态,再测试视觉抽取、视频时间推理、页面接地和视觉文本一致性,并保留时间戳与来源。
Copilot是嵌入编程、文档、会议、搜索和协作的生产力体验。其价值依赖身份、权限感知检索、工作流上下文和生成内容标识。测试最小权限连接器、来源和外部动作审批。
4. Llama与Grok
Llama通常与开放权重部署、定制和研究相关。应评估模型供应链、许可证、依赖、权重、微调数据、量化、多语言、安全、工具、延迟和内存。私有托管不等于自动安全。
Grok作为通用助手与对话模型纳入比较。评估应绑定当前产品或API,覆盖对话、推理、编程、工具和当前或外部信息工作流,并测量来源、时效、安全、访问边界和产品变化。
5. DeepSeek与Qwen3.8-Max
DeepSeek通常与推理和编程联系在一起。测试数学、调试、仓库代码、科学解释、不完整指令和工具工作流。推理长度不能替代正确性,应测量最终质量、复现性、延迟和成功任务成本。
Qwen3.8-Max作为面向企业和多语言工作的通用模型标签。测试中英文、术语、代码、结构化输出、工具、长文档和服务行为,核实具体版本,并通过检索提供变化中的企业知识。
6. ERNIE与Doubao
ERNIE通常与中文理解、知识服务和企业场景相关。测试术语、实体消歧、摘要、分类、文档问答和有依据的中文写作,并加入知识库没有答案的案例。
Doubao通常被视为助手和内容生态。测试写作、改写、摘要、客户互动、媒体理解、风格控制、安全、个人信息、高峰延迟和外部动作审核。
7. Hunyua与Kimi
本文保留用户提供的Hunyua拼写。集成前确认准确名称、端点、版本和文档,评估中文、多模态、企业集成、认证、托管、留存和区域数据边界。
Kimi与长上下文知识工作和研究相关。使用技术规格、合同、会议记录和流程测试位置敏感、冲突来源、表格、引用、重复实体和多轮一致性。大上下文不能替代检索设计。
8. GLM(智谱AI)
GLM(智谱AI)作为通用和智能体方向模型纳入比较。测试中文推理、编程、结构化输出、工具、文档分析、多语言提示和企业助手,核实端点、访问条件、授权和工具语义。
采用边界自主:窄化工具、模型外授权、预算、超时、外部动作确认和可追踪证据。测试提示注入、工具错误、证据缺失、服务中断和运行回放。
|
维度 |
托管通用模型 |
开放权重 |
企业Copilot |
长上下文/研究 |
|
优势 |
快速接入与托管 |
部署与定制 |
流程与权限集成 |
文档综合 |
|
风险 |
提供商耦合 |
运维负担 |
权限与来源缺口 |
证据丢失 |
|
首要测试 |
通用任务集 |
质量成本部署 |
权限感知任务 |
引用与冲突任务 |
|
运营重点 |
成本与版本 |
供应链与安全 |
身份与审核 |
检索与来源追踪 |
表2:模型运行模式决策维度。
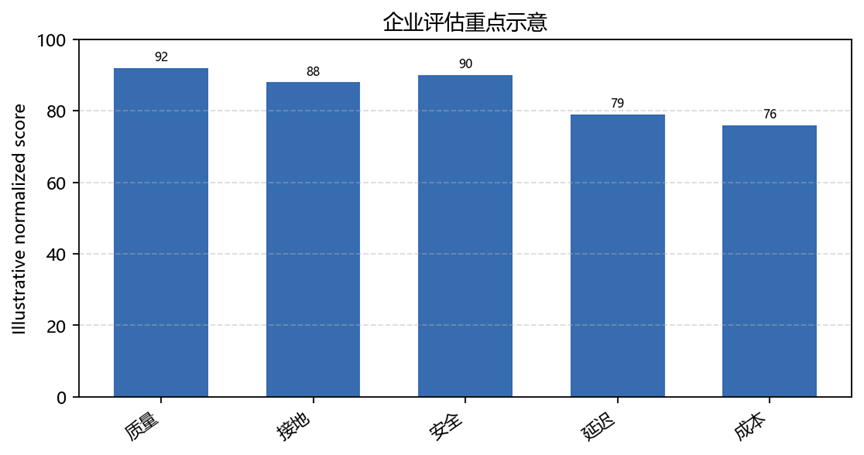
图3:试点应同时测量多个维度。
9. 检索、智能体与工具调用
检索提供最新或私有证据,工具让模型影响外部系统,记忆提供连续性。检索是来源与权限问题,工具是授权与副作用问题,记忆是隐私与留存问题。
- 为重要结论保留来源标识、时间戳和证据。
- 在模型外校验工具参数,并在动作时检查权限。
- 高影响规则使用结构化输出和确定性代码。
- 用预算、超时、重试、审批和停止开关限制智能体循环。
- 记录模型版本、提示词、状态、来源、工具、输出和人工修正。
10. 训练、微调与知识接地
预训练提供语言模式,后训练塑造指令、风格、安全和工具行为。微调适合稳定重复行为,检索适合最新或私有知识。两者都不能替代权限、来源校验和确定性业务逻辑。
有依据的回答需要有效检索和忠实综合。分别测量检索召回率、引用精度和生成质量,并加入证据缺失、冲突来源、恶意文档和混合语言术语。
11. 安全与治理
治理应覆盖隐私、安全、知识产权、内容安全、模型风险、审计和事故响应。记录预期与禁止用途、人工监督、升级、留存、回滚和变更管理。模型、提示词、工具、策略或知识索引变化后应重新评估。
|
层次 |
核心问题 |
证据 |
|
能力 |
是否完成真实任务? |
成功率、事实性和代码测试 |
|
推理 |
多步结论是否有效? |
轨迹审查和不变量 |
|
接地 |
结论是否有支持? |
引用精度和召回率 |
|
安全 |
是否抵抗有害或越权行为? |
红队和策略测试 |
|
运维 |
能否持续运行? |
延迟、成本、可用性、吞吐 |
|
人为因素 |
信任是否校准? |
修正率和审核时间 |
表3:所有模型家族的实用评估框架。
12. 推荐选型流程
- 明确用户、任务、数据分类、风险和可量化阈值。
- 建立统一工具,使用相同提示词、来源、工具和评分。
- 在真实样例和困难拒答案例上进行盲测。
- 以权限受限、人工审核和完整可观测性开展试点。
- 按照质量、风险、成本和可运维性的综合平衡选择,并在变更后重新评估。
结论。这些模型家族应作为完整系统选项比较。最佳方案是以可衡量质量、受控风险和可持续运营满足真实工作负载的方案。

汇聚全球AI编程工具,助力开发者即刻编程。
更多推荐

 10
 0
- 0


 已为社区贡献7条内容

所有评论(0)