
14400 Star 的开源神器:让 Claude Code 帮你维护 Obsidian 知识图谱,打造永不消失的第二大脑!
知识积累了大半年,为什么感觉什么都没留下?
说一个我自己的真实体验。
用 Claude 工作快一年了,每天大量对话——调研、分析、写文档、解决技术问题。然后某天我意识到一件事:我的知识库里几乎什么都没有。那些对话里产生过的好想法、梳理过的技术细节、做过的深度分析,全都消失在聊天历史里了。
下次遇到类似的问题,还是从头来。还是要重新介绍背景,重新推导结论。
这不是我的问题,这是 AI 工具的结构性缺陷:每次对话都是一座孤岛。
所以当我看到 claude-obsidian 这个项目时,眼睛一亮。它想解决的问题,正是这个。
它到底是什么?
claude-obsidian 是一个本地优先的知识系统,把 Claude Code 和 Obsidian 深度打通。
简单说:你把各种素材(文章、PDF、网页、对话内容)丢进去,它通过 AI 处理成带链接、有来源引用的 Obsidian 笔记页面;之后你的查询、研究,都直接从这个知识库里检索——每次使用,知识库都在增值,而不是重置。
核心设计原则是:你的知识库依然是本地的普通 Markdown 文件。不隐藏在插件缓存里,不锁定到云数据库,也不会悄悄上传给任何模型。
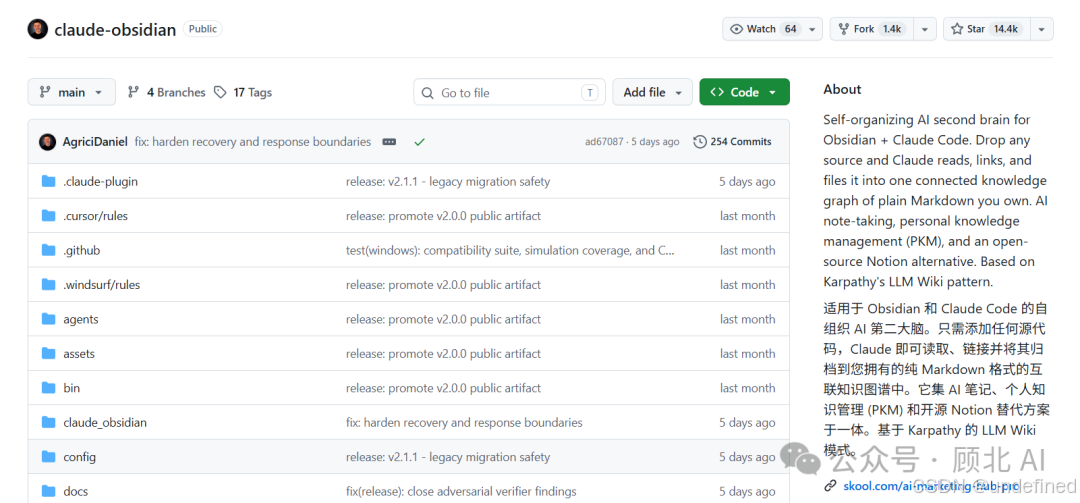
目前 GitHub 上已经有 14,400+ Star、1,200+ Fork,是 Claude Code 生态里最受关注的开源项目之一。
和普通 AI 笔记工具,本质区别在哪里?
知识有复利,不是每次从零开始
大多数 AI 笔记工具的工作流程是这样的:
-
你和 AI 聊了一个话题
-
对话里产生了有价值的内容
-
对话关闭,内容消失
-
下次从头来
claude-obsidian 的设计核心是打破这个循环,构建一个知识复利机制:
知识"捕获→落地→连接→复用"复利循环
捕获(Capture)素材进 inbox → 落地(Ingest)生成有链接的笔记 → 连接(Connect)建立知识关联 → 复用(Use)直接从库里检索答案 → 再捕获新素材……
每一次循环,知识库都在增值。你加入的第 50 份素材,会和前面 49 份建立连接,产生的价值远超第 1 份。这才是知识管理的正确形态。
来源溯源,不是魔法生成
这是我觉得设计最用心的地方。
大多数"AI + 笔记"工具有个隐患:AI 生成了内容,但你不知道这些内容哪些有真实依据,哪些是模型幻觉。时间一长,知识库里会混入大量没有根基的内容,可信度越来越低。
claude-obsidian 的做法是维护一个 source ledger(来源账本)和 claim ledger(声明账本),记录每条知识的来源、权威性、新鲜度、支持证据和矛盾证据。
高风险的声明要求两个独立来源支撑。不支持或相互矛盾的证据不会被自动删掉,而是保持可见——它会用 [!contradiction] 标注出来,让你自己判断。
这个设计的底层逻辑是:一个诚实的"不知道",远比一个自信的"编造"更有价值。
本地优先,数据主权在你手上
很多知识管理工具的商业模式,其实是把你的数据变成它的资产。
claude-obsidian 走的是反方向:
产品与知识库的安全隔离边界
产品代码和你的知识库是严格隔离的。知识库必须通过 CLAUDE_OBSIDIAN_VAULT 环境变量或显式配置文件明确指定,不会自动推断你的目录。网络请求(URL 抓取、外部数据等)需要你显式给出"出口同意",不会后台偷跑。
Claude API 宕机了?你的知识库依然正常打开,在 Obsidian 里全文搜索。明年换了 AI 工具?你的笔记带着走,因为它们从来都只是你机器上的一堆 Markdown 文件。
15 个 Skill,组成完整的知识操作系统
claude-obsidian 把功能拆成了 15 个细粒度的 Skill,用起来像一套工具集,而不是一个黑盒子。
核心工作流:
|
Skill |
做什么 |
|---|---|
wiki |
初始化或接管知识库,诊断就绪状态,路由任务 |
save |
主动保存一个有范围的洞察或答案,从不自动记录聊天流水账 |
wiki-ingest |
把 inbox 里的素材转成有链接的笔记和溯源记录 |
wiki-query |
只读检索,从知识库证据里回答问题 |
wiki-lint |
报告死链、孤岛笔记、元数据缺失、过期索引 |
扩展能力:
|
Skill |
做什么 |
|---|---|
autoresearch |
有界的网络研究(3 轮渐进式),显式出口同意 |
canvas |
Obsidian Canvas 可视化知识地图的创建和维护 |
defuddle |
在摄入前清理网页内容,去掉广告和噪音 |
wiki-retrieve |
上下文前缀 + BM25 关键词检索 + 可选余弦重排序 |
wiki-mode |
LYT / PARA / Zettelkasten 等笔记方法论路由 |
think |
结构化的"观察→倾听→连接→创造→成长"思考循环 |
所有 Skill 共享同一套来源溯源、知识库选择和写入安全规则,协调一致,不会互相打架。
实际效果长什么样?
这是知识库在 Obsidian 里运行之后的真实截图:
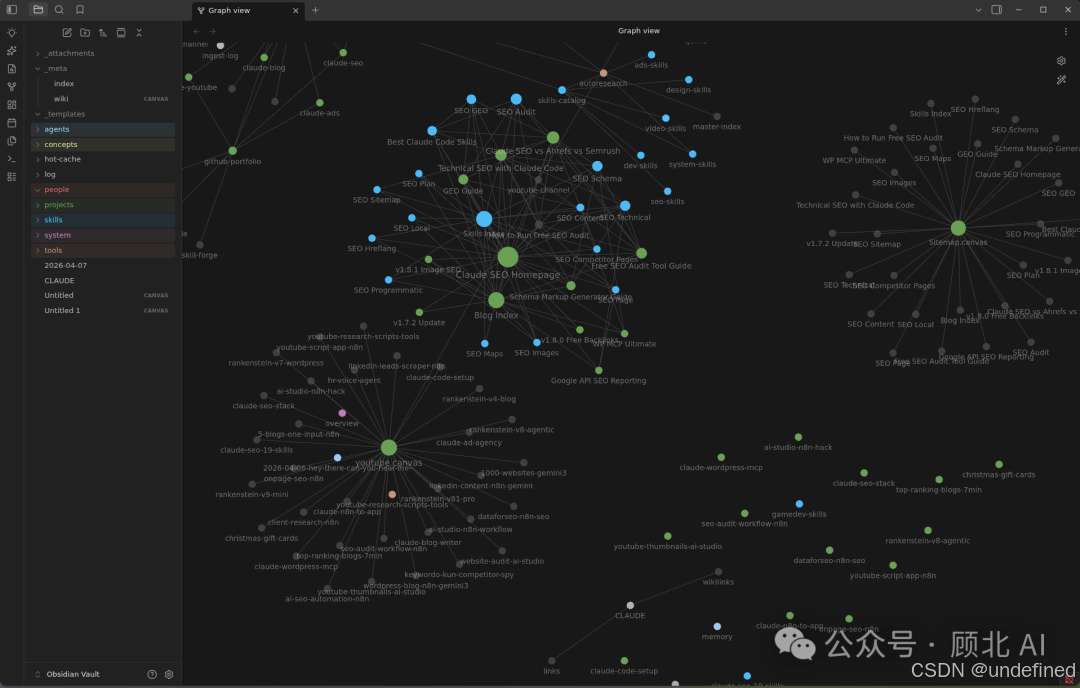
Obsidian 知识图谱视图(Graph View)
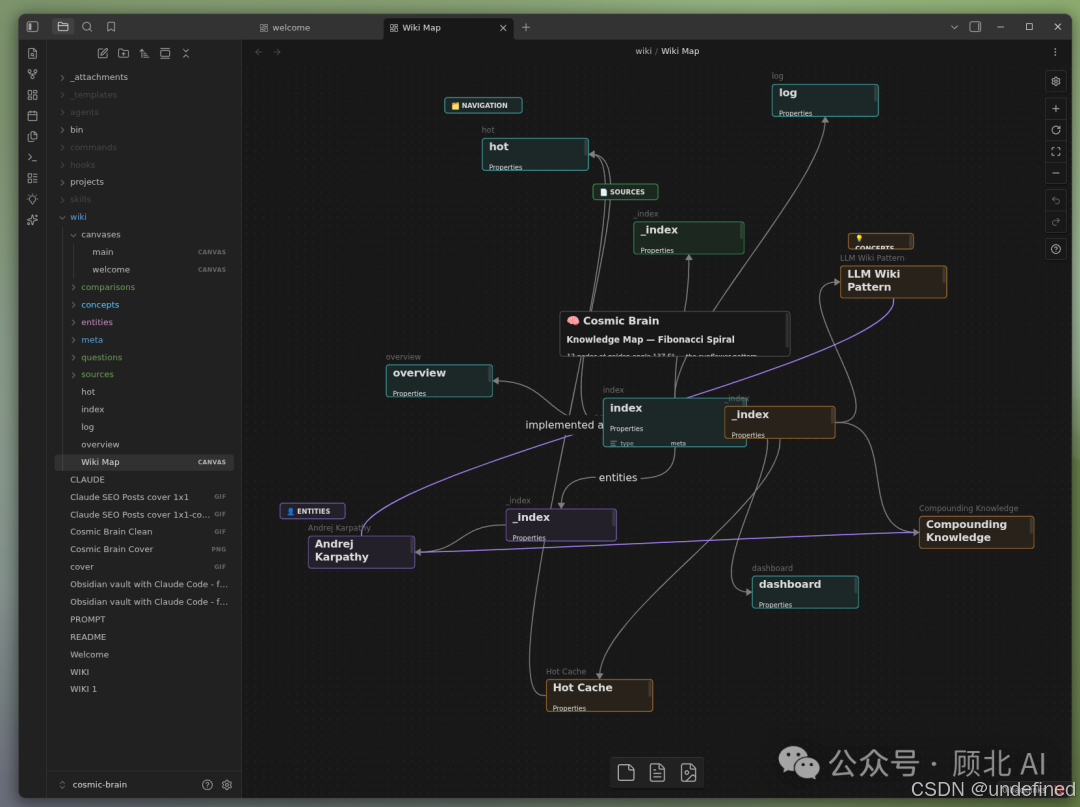
Obsidian Canvas 可视化知识地图
左图是 Graph View,能直观看到笔记之间的链接关系网络。右图是 Canvas,用可视化地图的方式呈现知识结构和主题关联。
这些都是原生 Obsidian 功能,不需要额外插件,因为所有笔记都是标准 Markdown + Obsidian wikilink 语法,打开即用。
写入安全机制:对你的数据真正负责
这是 claude-obsidian 和其他 AI 笔记插件最大的工程差异——它对数据安全的重视程度,更接近数据库系统,而不是普通笔记工具。
每一次涉及写入的操作,流程是这样的:
-
读取每个目标文件,记录其预期的 SHA-256 哈希值
-
让并行的 agent workers 只返回草稿和证据,不直接写入
-
把完整变更合并成一个操作包(operation bundle)
-
人工审查这个操作包,复制其哈希值
-
用这个哈希值作为授权,执行一次可恢复的事务
如果在计划生成到实际执行之间,文件系统发生了变化(比如你手动编辑了笔记),它会拒绝写入,而不是静默覆盖。
这个设计的实际意义是:并行的 AI agent 永远无法相互覆盖你的笔记。Workers 只产出草稿,一个 orchestrator 审查后才执行写入。如果操作中途中断,运行 transaction recover 可以恢复到之前的状态。
上手流程:一步一步来
环境要求
-
Python 3.11+(核心运行时)
-
Obsidian(可选,但强烈推荐)
-
Claude Code
-
Bash(Linux / macOS,或 Windows WSL)
Windows 用户注意:原生 Windows 环境只支持只读检查和预览操作,知识库写入需要 WSL。平台检测失败会报
UNSUPPORTED_PLATFORM,不会静默写入错误文件。
第一步:克隆仓库
git clone https://github.com/AgriciDaniel/claude-obsidian.git
cd claude-obsidian
注意:这个目录是产品代码,不是你的知识库。两者是严格分离的。
第二步:初始化独立知识库(先预览,再执行)
export GENERATED_AT="$(date -u +%Y-%m-%dT%H:%M:%SZ)"
export OPERATION_ID="init-reviewed"

# 第一步:生成操作计划(只预览,不写入)
python3 scripts/claude-obsidian.py init "$HOME/Documents/MyKnowledgeVault" \
  --generated-at "$GENERATED_AT" --operation-id "$OPERATION_ID"
命令会输出一个 JSON 格式的操作计划,里面有详细说明和一个 approved_plan_sha256 字段。这是关键:必须人工审查计划,复制这个哈希值,才能真正执行写入。
# 第二步:确认计划后,带哈希执行
python3 scripts/claude-obsidian.py init "$HOME/Documents/MyKnowledgeVault" \
  --generated-at "$GENERATED_AT" --operation-id "$OPERATION_ID" \
  --approved-plan-sha256 "<从计划里复制的sha256>" --apply
已经有 Obsidian 知识库的用户,用 adopt 命令做非破坏性接入,不会动你现有的笔记。
第三步:用 Claude Code 启动
# 进入你的知识库目录
cd "$HOME/Documents/MyKnowledgeVault"

# 加载插件启动 Claude Code
claude --plugin-dir /absolute/path/to/claude-obsidian
然后就可以开始了:
# 初始化和诊断知识库状态
/claude-obsidian:wiki

# 把 inbox/ 目录里的素材摄入知识库
/claude-obsidian:wiki-ingest

# 从知识库里检索
/claude-obsidian:wiki-query

# 检查知识库健康状态(死链、孤岛、过期索引等)
/claude-obsidian:wiki-lint
选择你的笔记方法论
wiki-mode 支持 4 种模式,可以根据自己的习惯选:
|
模式 |
逻辑 |
|---|---|
|
Generic(默认) |
来源、概念、实体、会话,各归其位 |
|
LYT |
Map of Content + 原子链接笔记 |
|
PARA |
项目、领域、资源、归档 |
|
Zettelkasten |
稳定 ID + 原子笔记 + 密集链接 |
切换模式只影响新笔记的路由方式,不会自动重组你已有的笔记。这个设计很贴心——不会因为你改变了方法论偏好,就悄悄重新整理你花了几年建立的笔记结构。
我的真实感受
说实话,这个工具的学习曲线不低。初始化流程里的哈希审查机制,在第一次用的时候会让人觉得繁琐——明明只是建个目录,为什么要搞出这么复杂的审查流程?
但理解了它的设计意图之后,这个"繁琐"就变成了"用心"。它不愿意因为追求方便而绕过安全检查。对于一个要存放你多年知识积累的系统来说,这种态度是对的。
它更适合这样的人:
-
已经在认真经营 Obsidian 知识库的重度用户
-
深度使用 Claude Code 做研究或开发的人
-
对数据主权有要求、不愿意把所有笔记喂给云服务的人
-
研究者、需要长期管理知识资产的开发者
如果你只是偶尔记几条笔记、想要"一键搞定"的极简体验,原生 Obsidian 加几个轻量插件就够了。
但如果你已经有一个认真维护的知识库,同时又重度使用 Claude Code,那这个工具值得花时间深入研究。知识库每次使用都在增值,而不是重置——这件事说起来简单,但真正做到的工具极少。
开源地址:https://github.com/AgriciDaniel/claude-obsidian,MIT 许可,免费,数据完全自有。
你现在用什么方式管理 AI 对话里产生的知识?是有一套固定流程,还是基本靠记忆力?欢迎评论区聊聊,感兴趣的话我后面可以出一篇实际工作流的实操记录。
谢谢你阅读我的文章!
我是顾北,我们下去再见!

汇聚全球AI编程工具,助力开发者即刻编程。
更多推荐

 8
 0
- 0


 已为社区贡献17条内容

所有评论(0)