
小白程序员也能掌握大模型最佳实践:从Prompt到Harness Engineering的完整演进
本文阐述了AI编程助手表现的关键因素在于其“工作环境”——Harness,而非模型本身。文章从Prompt Engineering到Harness Engineering的三次范式演进,详细介绍了Harness的三大支柱:上下文工程、架构约束和熵管理。同时,文章提供了CLAUDE.md/AGENTS.md的最佳实践、省Token的四大原则以及Subagent、Skill、Workflow的正确使用方法。最后,提出了五层自我修复Harness的构建方法,帮助读者全面掌握大模型的最佳实践。
· · ·
一、三次范式演进:从 Prompt 到 Harness
理解 Harness 之前,先看 AI 编程的三次范式跳跃:
| 阶段 | 时代 | 核心动作 | 类比 |
|---|---|---|---|
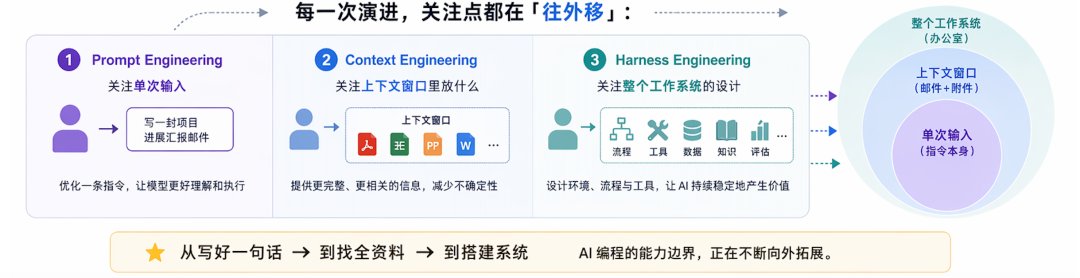
| Prompt Engineering | 2022-2024 | 把一条指令写得更好 | 教你怎么写一封好邮件 |
| Context Engineering | 2025 | 把相关附件都带上 | 给邮件附上参考资料 |
| Harness Engineering | 2026 至今 | 搭建整个办公室 | 设计办公环境、流程、工具 |
每一次演进,关注点都在「往外移」:
- Prompt Engineering 关注单次输入
- Context Engineering 关注上下文窗口里放什么
- Harness Engineering 关注整个工作系统的设计
这不是概念游戏。Ghostty 作者 Ryan Lopopolo 说得好:「Agent 不难,Harness 才难。」
Mitchell Hashimoto 把这个过程定义为 Agent 演化的第五阶段:每当你发现 Agent 犯了一个错误,你就花时间去工程化一个解决方案,让它再也不会犯同样的错。
在 Ghostty 项目里,AGENTS.md 文件里的每一行规则,背后都对应着 Agent 曾经犯过的一个错。 这就是 Harness 的本质——把踩过的坑固化成系统约束。
· · ·
二、什么是 Harness?一个公式
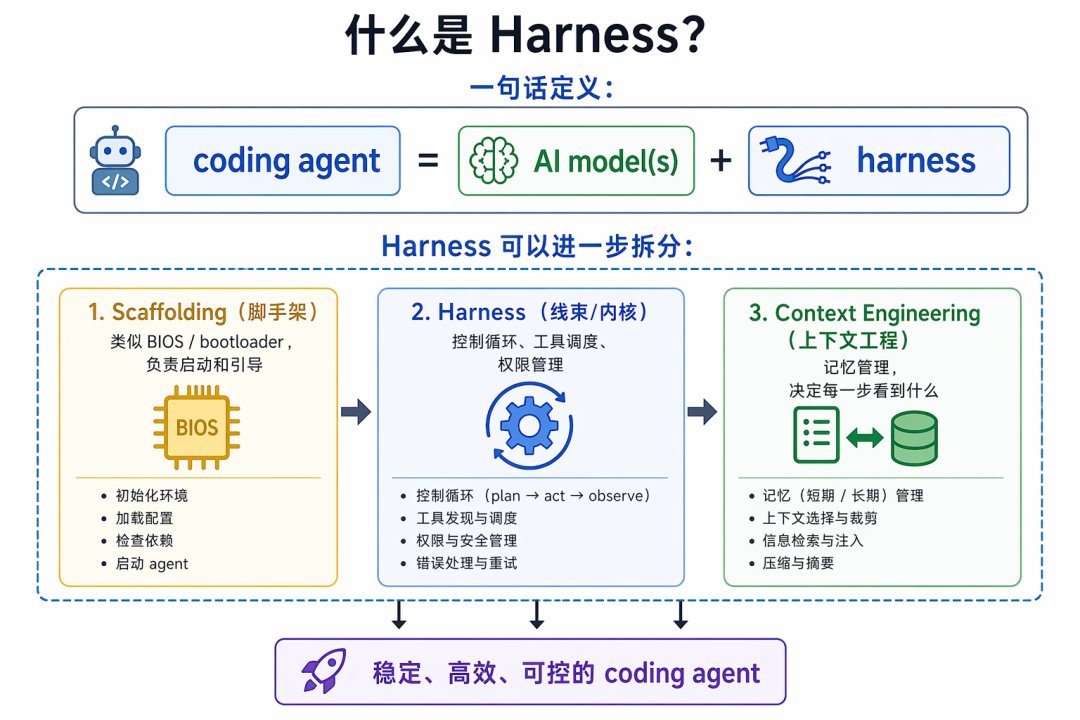
一句话定义:
coding agent = AI model(s) + harness
Harness 可以进一步拆分:
- Scaffolding(脚手架) — 类似 BIOS / bootloader,负责启动和引导
- Harness(线束/内核) — 控制循环、工具调度、权限管理
- Context Engineering(上下文工程) — 记忆管理,决定每一步看到什么
OpenAI Codex 团队交出过一份成绩单:5 个月,大约 100 万行代码,1500 个 PR,全部由 Agent 生成,人类一行代码都没写。 3-7 名工程师,每人每天合并 3.5 个 PR,比手工编写快 10 倍。
Stripe 更激进:每周合并 1300 多个 PR,通过 Blueprint 编排——确定性节点 + Agentic 节点混合。
他们靠的不是更聪明的模型,而是更精密的 Harness。
· · ·
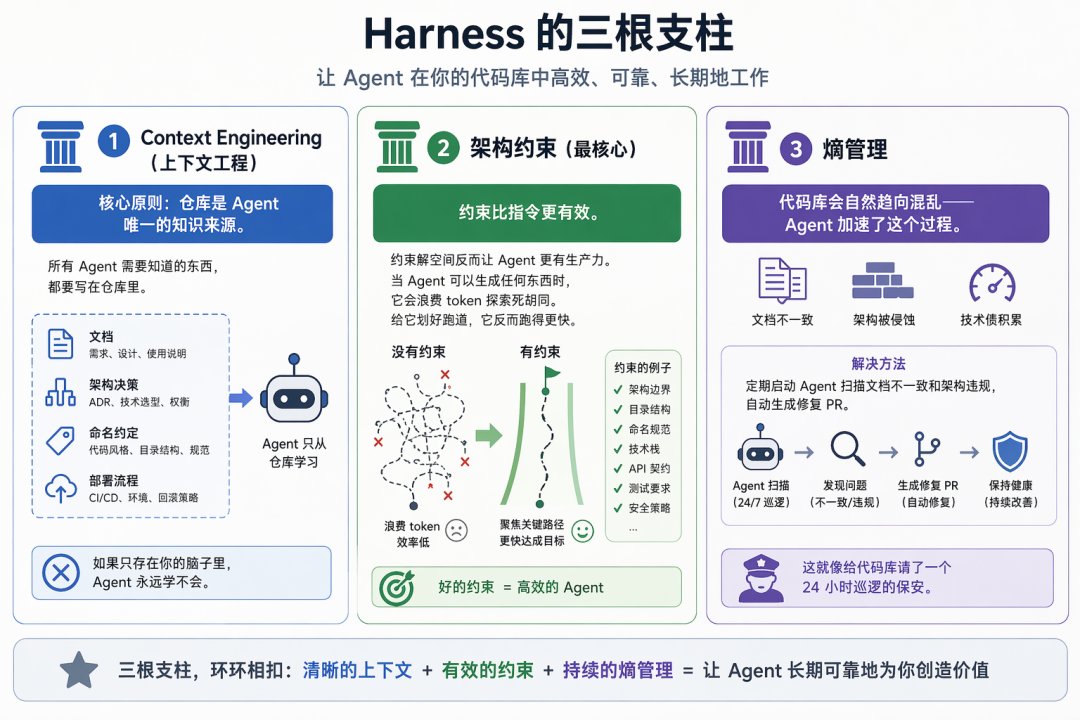
三、Harness 的三根支柱
支柱 1:Context Engineering(上下文工程)
核心原则:仓库是 Agent 唯一的知识来源。
这意味着:所有 Agent 需要知道的东西,都要写在仓库里——文档、架构决策、命名约定、部署流程。如果它只存在你的脑子里,Agent 永远学不会。
具体做法:
- AGENTS.md 是行为唯一可信来源。它不是文档,是 Agent 的「操作手册」
- 代码不仅要对人类可读,更要对 Agent 可读(application legibility)
- ETH Zurich 研究发现,CLAUDE.md / AGENTS.md 应控制在 60 行以内最优
- 给 Agent 提供浏览器和可观测性栈,让它能自己查看结果
支柱 2:架构约束(最核心)
这是 Harness 区别于 Prompt Engineering 的关键:约束比指令更有效。
什么意思?与其在 prompt 里说「请注意分层架构」,不如用 linter、类型系统、CI 把分层规则变成机器可检查的硬性约束。
推荐的分层模式:
Types → Config → Repo → Service → Runtime → UI
每一层只能依赖比它更内层的模块。这个规则由确定性 linter 强制执行,不靠 Agent 自觉。
约束解空间反而让 Agent 更有生产力。当 Agent 可以生成任何东西时,它会浪费 token 探索死胡同。给它划好跑道,它反而跑得更快。
支柱 3:熵管理
代码库会自然趋向混乱——文档不一致、架构被侵蚀、技术债积累。Agent 加速了这个过程。
解决方法:定期启动 Agent 扫描文档不一致和架构违规,自动生成修复 PR。这就像给代码库请了一个 24 小时巡逻的保安。
· · ·
四、CLAUDE.md / AGENTS.md 最佳实践
它们是什么?
| 文件 | 读者 | 定位 |
|---|---|---|
| README.md | 人类 | 项目介绍 |
| AGENTS.md | 通用 Agent | 所有 AI 工具通用的项目简报 |
| CLAUDE.md | Claude 专用 | Claude 特定的行为指令 |
AGENTS.md 是 2025 年由 Sourcegraph、OpenAI、Google、Cursor 联合推出的通用标准,现在由 Linux Foundation 下的 Agentic AI Foundation 维护。它被 Claude Code、Cursor、Copilot、Gemini CLI、Windsurf、Aider、Zed、Warp、RooCode 等工具广泛支持。
实用技巧:多工具共用时,用符号链接统一管理:
ln -sfn AGENTS.md .github/copilot-instructions.md
Karpathy 的 4+4 规则
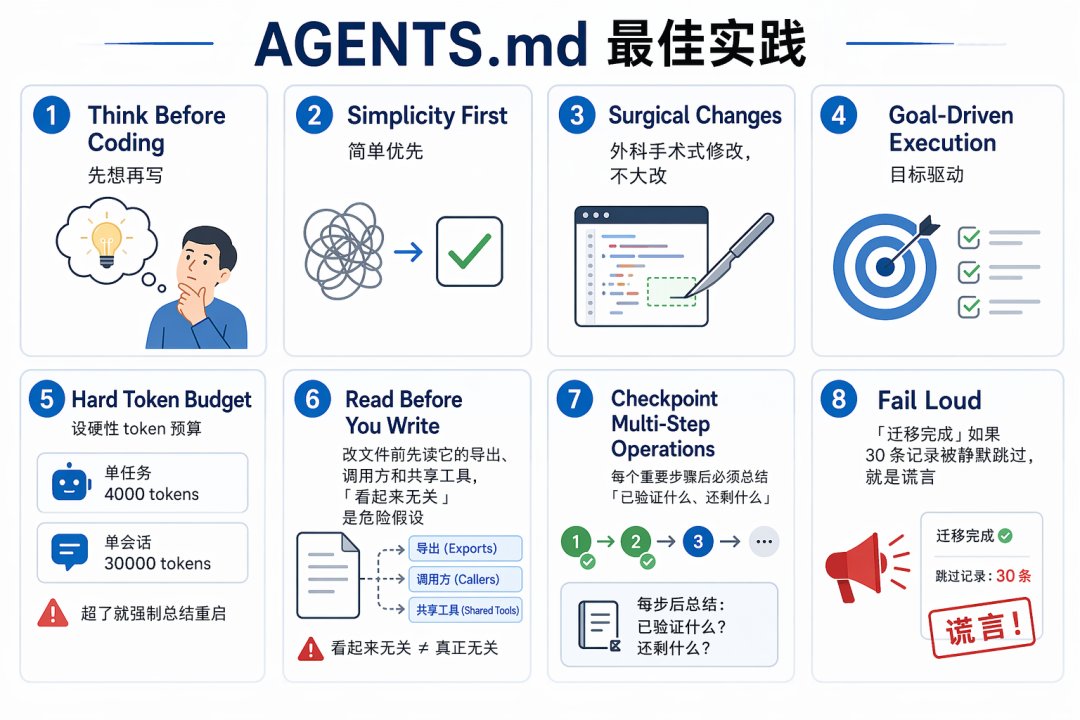
Andrej Karpathy 最初提出 4 条 CLAUDE.md 规则:
-
Think Before Coding — 先想再写
-
Simplicity First — 简单优先
-
Surgical Changes — 外科手术式修改,不大改
-
Goal-Driven Execution — 目标驱动
但这 4 条已经不够用了——它们对 multi-step pipeline 完全沉默。后来社区补充了 4 条执行层规则:
-
Hard Token Budget — 设硬性 token 预算(单任务 4000 tokens,单会话 30000 tokens),超了就强制总结重启
-
Read Before You Write — 改文件前先读它的导出、调用方和共享工具,「看起来无关」是危险假设
-
Checkpoint Multi-Step Operations — 每个重要步骤后必须总结「已验证什么、还剩什么」
-
Fail Loud — 「迁移完成」如果 30 条记录被静默跳过,就是谎言
为什么限制在 8 条?因为超过一定长度,Claude 就不再认真读规则,而是模式匹配出「规则存在」这个事实。8 条规则可以达到 75%+ 的遵守率,错误率接近零。
文件长度黄金法则
- 60 行最优,200 行上限
- Claude Code 官方建议控制在 300 行以内
- CLAUDE.md 支持分层加载:企业 → 个人 → 项目 → 子目录
- 支持 @imports 递归引用(最多 5 层)
- 可用条件加载: 只在写 Go 时激活
关键区别:你写 CLAUDE.md,Claude 写 MEMORY.md
Claude Code 有自动记忆系统,位于 ~/.claude/projects//memory/:
-
MEMORY.md
索引文件始终加载
-
独立记忆文件按需加载
-
只有前 200 行自动加载(MAX_ENTRYPOINT_LINES=200)
你负责写 CLAUDE.md 告诉它规则,它负责写 MEMORY.md 记住经验。 两者各司其职。
· · ·
五、省 Token 的四大原则
一个未经优化的 Agent,每天跑 100 条消息、16.6 万输入 tokens,在 Claude Opus 上每月要花约 $2,490。优化后可以降到 $50-100/月。
差距在哪?四个设计原则:
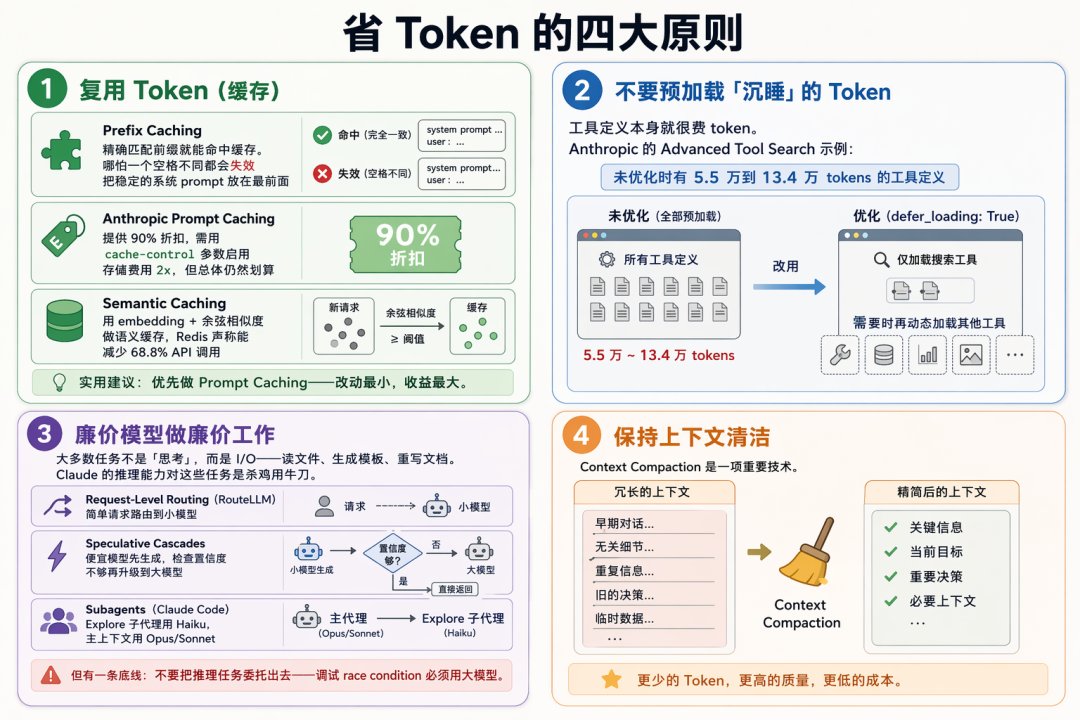
原则 1:复用 Token(缓存)
- Prefix Caching:精确匹配前缀就能命中缓存。注意——哪怕一个空格不同都会失效,所以要把稳定的系统 prompt 放在最前面
- Anthropic Prompt Caching:提供 90% 折扣,需用 cache-control 参数启用(存储费用 2x,但总体仍然划算,更何况国内模型这部分还没有收费)
- Semantic Caching:用 embedding + 余弦相似度做语义缓存,Redis 声称能减少 68.8% API 调用
实用建议:优先做 Prompt Caching——改动最小,收益最大。
原则 2:不要预加载「沉睡」的 Token
工具定义本身就很费 token。Anthropic 的 Advanced Tool Search 示例:未优化时有 5.5 万到 13.4 万 tokens 的工具定义。
解决方法:用 defer_loading: True,初始只加载搜索工具,用到其他工具时再动态加载。
原则 3:廉价模型做廉价工作
大多数任务不是「思考」,而是 I/O——读文件、生成模板、重写文档。Claude 的推理能力对这些任务是杀鸡用牛刀。
三种策略:
- Request-Level Routing(RouteLLM):简单请求路由到小模型
- Speculative Cascades:便宜模型先生成,检查置信度不够再升级到大模型
- Subagents:Claude Code 的 Explore 子代理用 Haiku,主上下文用 Opus/Sonnet
一位无人机导航工程师分享过极端案例:用 ask-kimi(便宜模型做批量读取)+ kimi-write(模板生成),文档更新 token 消耗从 ~5000 降到 ~200(25 倍减少),每周成本 $0.38。
但有一条底线:不要把推理任务委托出去——调试 race condition 必须用大模型。
原则 4:保持上下文清洁
Context Compaction 是一项重要技术。Jia 等人的论文表明:6 倍压缩率可以实现 51.8%-71.3% 的 token 预算减少,同时 SWE-bench 提升 5.0-9.2%。
清理 30-50% 上下文,在 10 万次运行、4 万窗口的场景下,节省约 $6,000。
· · ·
六、Subagent、Skill、Workflow:选对工具
这三者经常被混淆,但它们的上下文行为完全不同:
| 工具 | 适用场景 | 上下文行为 |
|---|---|---|
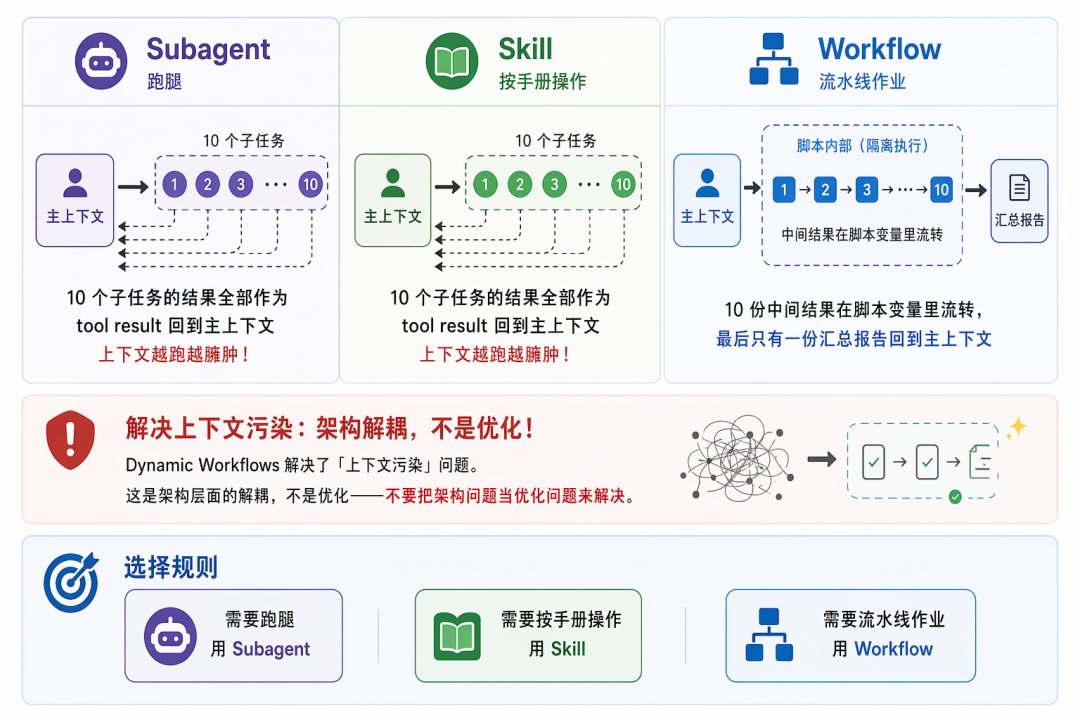
| Subagent | 需要「跑腿」 | 10 个子任务的结果全部作为 tool result 回到主上下文,上下文越跑越臃肿 |
| Skill | 需要「按手册操作」 | 同上 |
| Workflow | 需要「流水线作业」 | 10 份中间结果在脚本变量里流转,最后只有一份汇总报告回到主上下文 |
Dynamic Workflows 解决了「上下文污染」问题。这是架构层面的解耦,不是优化——不要把架构问题当优化问题来解决。
选择规则:需要跑腿用 Subagent,需要按手册操作用 Skill,需要流水线作业用 Workflow。
Claude Code Workflow 的运行边界(v2.1.154+):最多 16 个并发 agent,单次最多 1000 个 agent。Workflow 脚本本身不直接访问文件系统——它编排 agent,由 agent 去操作。
Thariq(Anthropic)总结过六种编排模式:分类-执行、扇出-汇总、对抗验证、生成-过滤、锦标赛、循环至终。核心思想:一个 harness for every task。
· · ·
七、记忆系统:让 Agent 真正记住经验
Claude Code 的记忆系统有两层架构:
静态层(你写的)
CLAUDE.md 的六层级(叠加关系,不是覆盖):
Managed(企业强制) └─ User(~/.claude/CLAUDE.md,全局个人) └─ Project(./CLAUDE.md,项目共享) └─ Local(./CLAUDE.local.md,个人本地) └─ Auto(~/.claude/projects/,自动记忆) └─ Team(团队共享)
这种分层避免了「加载无关上下文浪费 token」的问题——全局规则、项目规则、个人规则各司其职。
动态层(Claude 写的)
自动记忆只有 4 种类型:user、feedback、project、reference。
提取记忆通过 stopHook 触发一个独立的 extractMemories 代理——它完美 fork 主对话,复用 prompt cache(省钱)。
检索记忆用 Sonnet(不是 Haiku,不是向量检索),从前 30 行 frontmatter 里挑 top-5。
为什么不用更便宜的 Haiku?因为记忆相关性判错的代价远大于多花的那点钱。 为什么不用向量检索?向量检索把检索当「数学题」,Claude Code 把检索当「选择题」来做。后者更准。
记忆注入时包裹在 里,并带有老化警告:2 天前的记忆会主动加 stale 提醒——「记忆说 X 存在 ≠ X 现在存在」。
核心纪律:只记代码推不出来的东西。代码是「活的」,记忆是「死的」。
· · ·
八、五层自我修复 Harness
Claude Code 的「自我修复」不是魔法,而是把错误变得可见、可验证、并写回流程。完整的 Harness 有五层:
| 层 | 组件 | 作用 |
|---|---|---|
| 入口约束 | CLAUDE.md / .claude/rules | 从源头定义行为 |
| 过程规程 | Skills / Commands / Runbooks | 标准化操作流程 |
| 执行检查 | Permissions / Hooks / Sandbox | 运行时拦截 |
| 反馈证据 | Tests / Lint / Typecheck / Logs | 可验证的反馈 |
| 长期记录 | Auto Memory / 复盘规则更新 | 经验沉淀 |
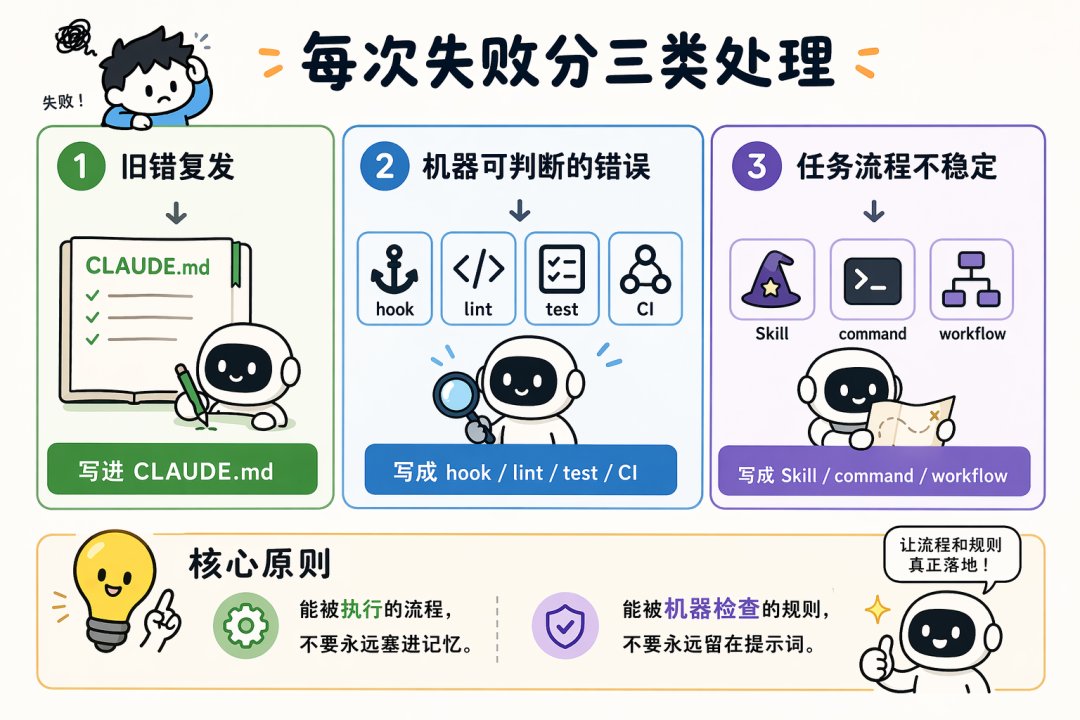
每次失败分三类处理:
- 旧错复发 → 写进 CLAUDE.md
- 机器可判断的错误 → 写成 hook / lint / test / CI
- 任务流程不稳定 → 写成 Skill / command / workflow
核心原则:能被执行的流程,不要永远塞进记忆。能被机器检查的规则,不要永远留在提示词。
Hooks 不消耗 token
Hooks 在 Agent 循环外运行——不消耗 token,不中断任务。三种关键 Hook:
- PreToolUse:拦截危险操作(比如阻止 rm -rf)
- PostToolUse:自动格式化(写完 .ts 文件后跑 prettier)
- Stop:完成验证(Claude 说 done 不代表真的 done)
⚠️ 常见坑:{“matcher”: “Write(*.ts)”} 这种写法是错误的——matcher 匹配的是工具名,不是文件路径。文件类型必须在脚本内部判断。Stop 钩子需要 stop_hook_active 标志位防止无限循环。
· · ·
九、实战清单:照着做
把上面所有原则浓缩成一张可执行的清单:
文件结构
项目根/├── AGENTS.md # Agent 行为唯一真相源(<60 行)├── CLAUDE.md # 仅写「Read AGENTS.md first」+ Claude 特定指令├── ARCHITECTURE.md # 架构分层规则├── Makefile # 所有命令通过 make 执行├── .claude/│ ├── rules/ # 条件规则(带 paths frontmatter)│ ├── commands/ # 自定义 slash commands│ ├── agents/ # 自定义 subagent│ └── skills/ # 可复用技能├── docs/ # 设计文档、安全规范└── exec-plans/ ├── active/ # 进行中的执行计划 └── completed/ # 已完成的(供参考)
日常操作
- 每次修正后更新 CLAUDE.md / AGENTS.md
- CLAUDE.md 超过 280 行时归档到 Archive 文件
- 复杂任务先进入 Plan Mode,计划 solid 再执行
- 同一操作每天做超过两次 → 做成 slash command
- 推理任务用大模型,I/O 任务委托给便宜模型
- 设置 per-task 和 per-session token 预算
- 用 PostToolUse 钩子自动跑 typecheck
- 用 Stop 钩子做完成验证
心态转变
| 旧心态 | 新心态 |
|---|---|
| 把 Claude 当聊天机器人 | 把它当你要调度的容量 |
| 每次犯错都自己修 | 每次犯错都写进系统约束 |
| 写更聪明的 prompt | 搭更好的 Harness |
| 一个会话干所有事 | 多个并行会话各司其职 |
|
十、一句话总结
Agent 不会自主学习进化。如果你不把这些知识写下来,它第一百次犯的错会和第一次一模一样。
Claude Code 是一个天才般的初级开发者,能以超快速度写代码。但它需要你来指导架构决策、安全实践和长期可维护性。
高级工程师还是你。 你的工作不是写更多代码,而是设计那个让 Agent 高效、安全、可验证地工作的 Harness。
这就是 Harness Engineering 的全部意义——从亲手拧阀门,变成设计调速器本身。
· · ·
如何学习大模型 AI ?
由于新岗位的生产效率,要优于被取代岗位的生产效率,所以实际上整个社会的生产效率是提升的。
但是具体到个人,只能说是:
“最先掌握AI的人,将会比较晚掌握AI的人有竞争优势”。
这句话,放在计算机、互联网、移动互联网的开局时期,都是一样的道理。
我在一线科技企业深耕十二载,见证过太多因技术卡位而跃迁的案例。那些率先拥抱 AI 的同事,早已在效率与薪资上形成代际优势,我意识到有很多经验和知识值得分享给大家,也可以通过我们的能力和经验解答大家在大模型的学习中的很多困惑。我们整理出这套 AI 大模型突围资料包:
- ✅ 从零到一的 AI 学习路径图
- ✅ 大模型调优实战手册(附医疗/金融等大厂真实案例)
- ✅ 百度/阿里专家闭门录播课
- ✅ 大模型当下最新行业报告
- ✅ 真实大厂面试真题
- ✅ 2026 最新岗位需求图谱
所有资料 ⚡️ ,朋友们如果有需要 《AI大模型入门+进阶学习资源包》,下方扫码获取~
① 全套AI大模型应用开发视频教程
(包含提示工程、RAG、LangChain、Agent、模型微调与部署、DeepSeek等技术点)
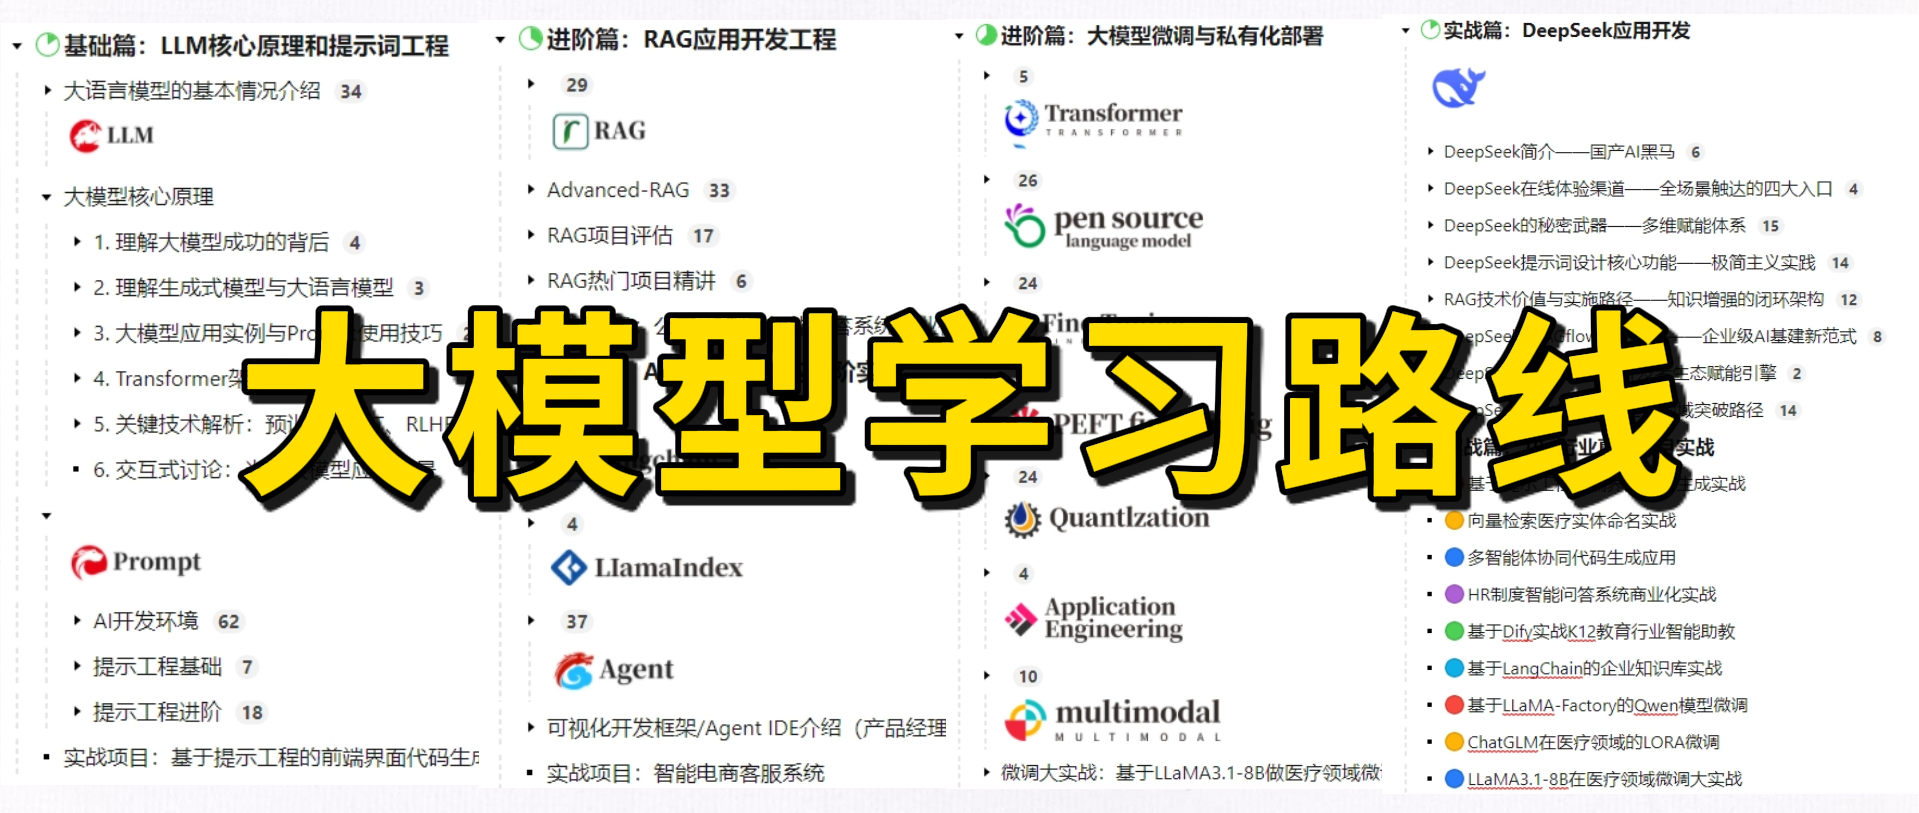
② 大模型系统化学习路线
作为学习AI大模型技术的新手,方向至关重要。 正确的学习路线可以为你节省时间,少走弯路;方向不对,努力白费。这里我给大家准备了一份最科学最系统的学习成长路线图和学习规划,带你从零基础入门到精通!
③ 大模型学习书籍&文档
学习AI大模型离不开书籍文档,我精选了一系列大模型技术的书籍和学习文档(电子版),它们由领域内的顶尖专家撰写,内容全面、深入、详尽,为你学习大模型提供坚实的理论基础。
④ AI大模型最新行业报告
2025最新行业报告,针对不同行业的现状、趋势、问题、机会等进行系统地调研和评估,以了解哪些行业更适合引入大模型的技术和应用,以及在哪些方面可以发挥大模型的优势。
⑤ 大模型项目实战&配套源码
学以致用,在项目实战中检验和巩固你所学到的知识,同时为你找工作就业和职业发展打下坚实的基础。
⑥ 大模型大厂面试真题
面试不仅是技术的较量,更需要充分的准备。在你已经掌握了大模型技术之后,就需要开始准备面试,我精心整理了一份大模型面试题库,涵盖当前面试中可能遇到的各种技术问题,让你在面试中游刃有余。
以上资料如何领取?
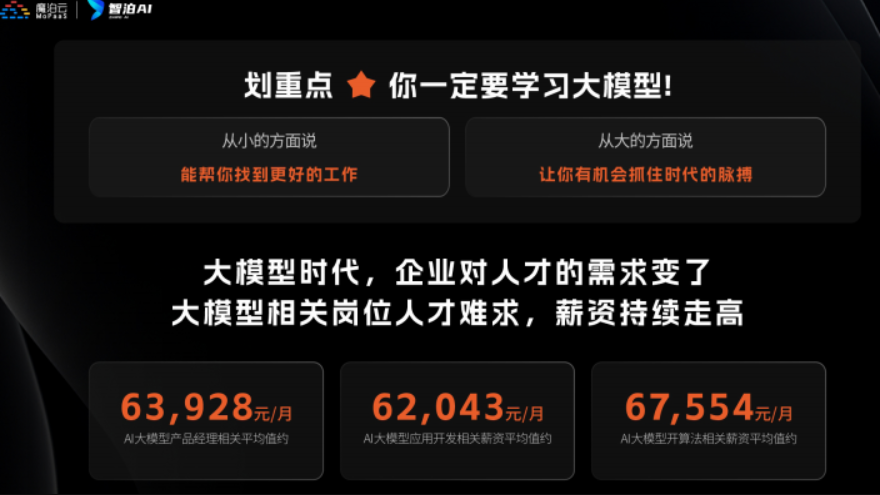
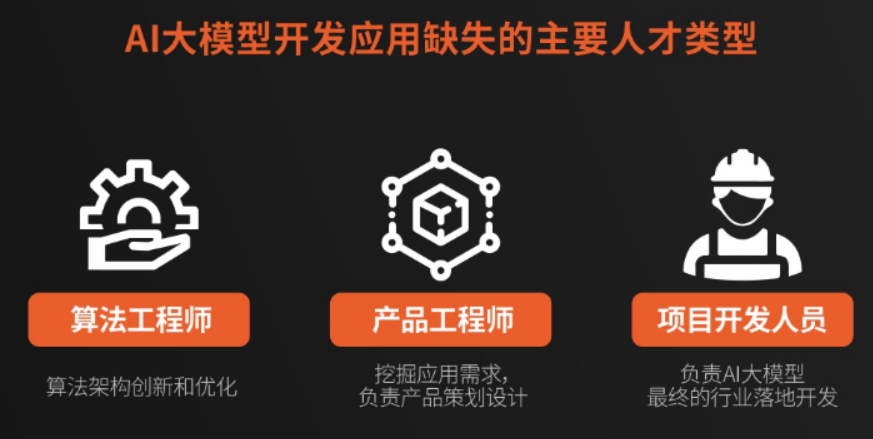
为什么大家都在学大模型?
最近科技巨头英特尔宣布裁员2万人,传统岗位不断缩减,但AI相关技术岗疯狂扩招,有3-5年经验,大厂薪资就能给到50K*20薪!
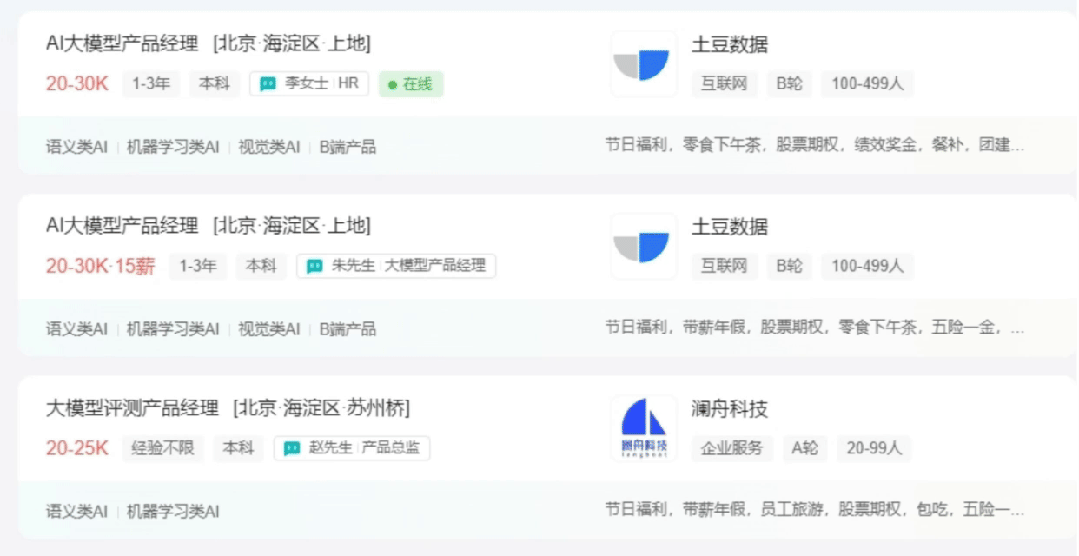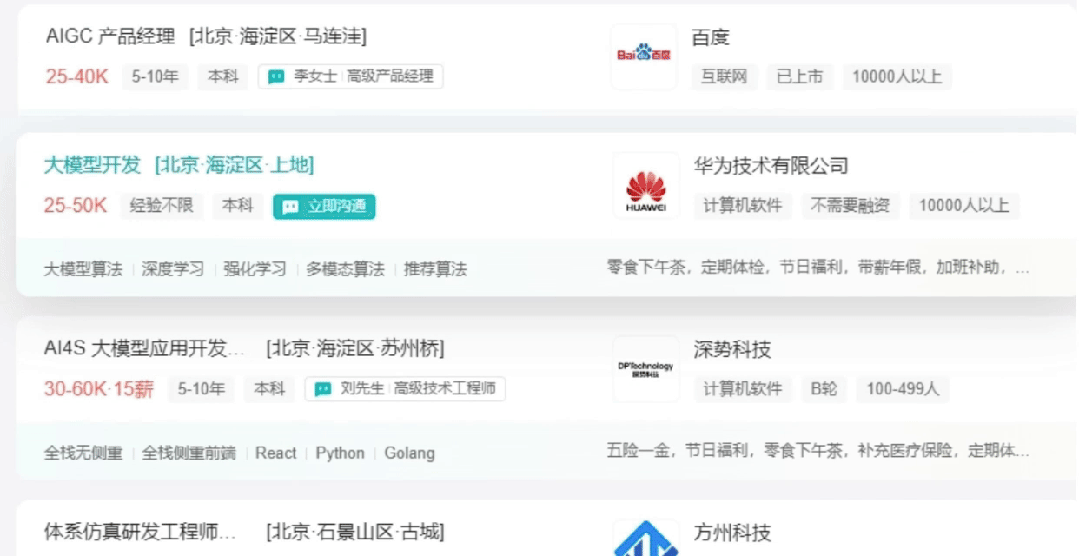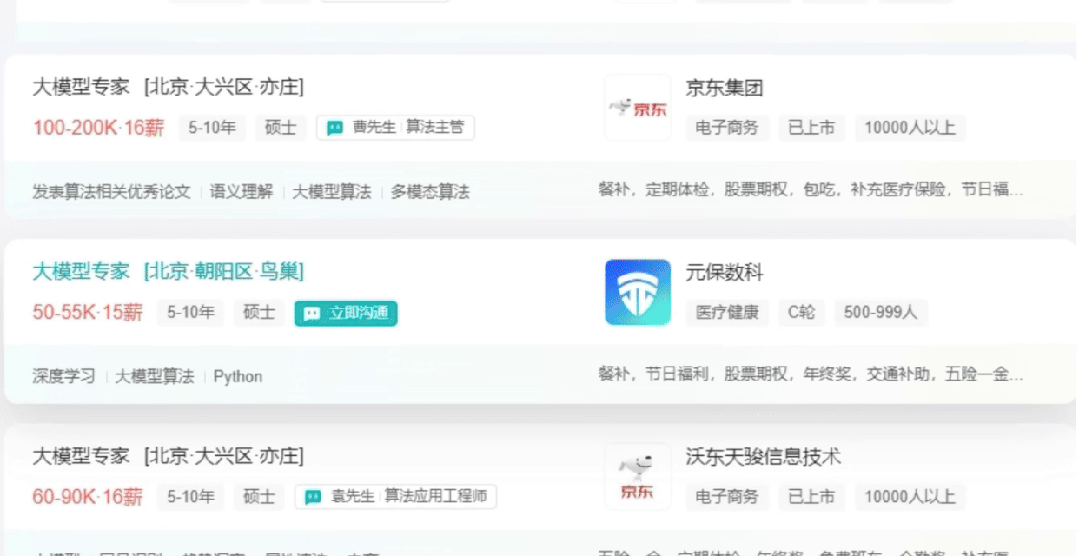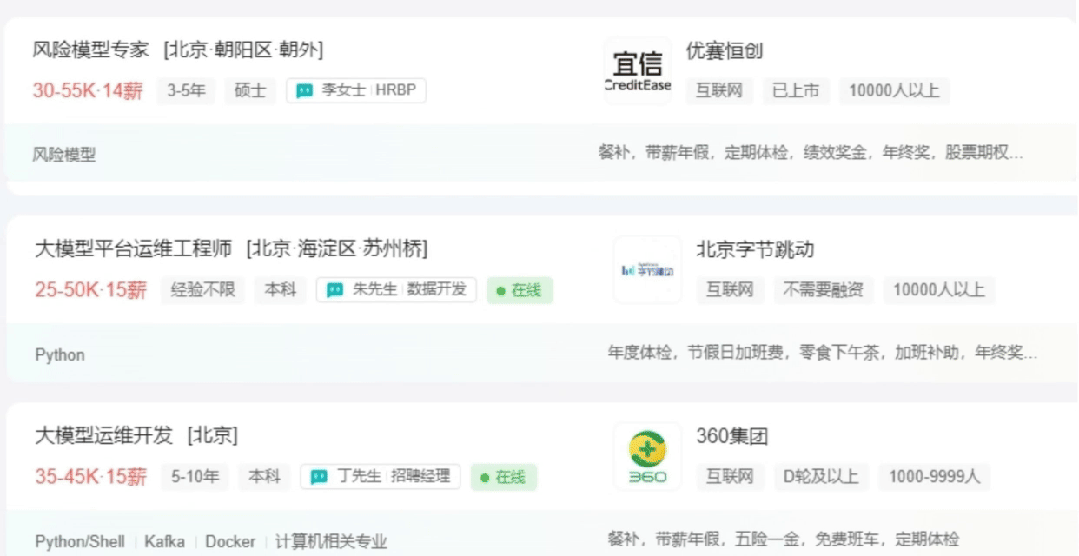
不出1年,“有AI项目经验”将成为投递简历的门槛。
风口之下,与其像“温水煮青蛙”一样坐等被行业淘汰,不如先人一步,掌握AI大模型原理+应用技术+项目实操经验,“顺风”翻盘!
这些资料真的有用吗?
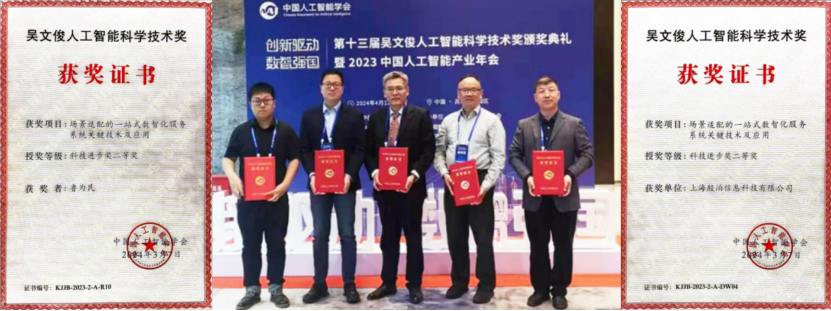
这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。
以上全套大模型资料如何领取?

汇聚全球AI编程工具,助力开发者即刻编程。
更多推荐

 12
 0
- 0


 已为社区贡献124条内容

所有评论(0)