
Agentic AI团队落地复盘:为什么Demo能跑的项目一上协作就崩
聊《Agentic AI跑通那天,我才发现前面的学习顺序反了》之前,先说一句实在的:别急着背概念,先看它在真实项目里到底解决什么问题。
摘要
> 摘要:Claude Code、Codex这些工具个人试用很香,但团队接手后频繁翻车。本文复盘一个真实案例,从权限、日志、回滚三个维度拆解Demo到生产的真实差距,并给出可运行的对照代码和排查链路。
---
目录
1. Agentic 的定义:不只是"会聊天"
2. 真实案例:Demo惊艳到上线翻车的三个月
3. 代码解释:关键代码的实现原理
4. 自主性边界:什么时候该让Agent自己跑
5. 任务拆解:从单步调用到多步编排的坑
6. 可观测性:没有日志的Agent就是黑盒
7. 安全约束:权限配置才是生产环境的硬门槛
8. 排查过程:故障定位的具体链路
9. 失败原因:业务错误、配置错误和环境错误的区分
10. 适用边界:什么时候不该照搬方案
11. 总结:学习顺序错了,后面全错
---
Agentic 的定义:不只是"会聊天"
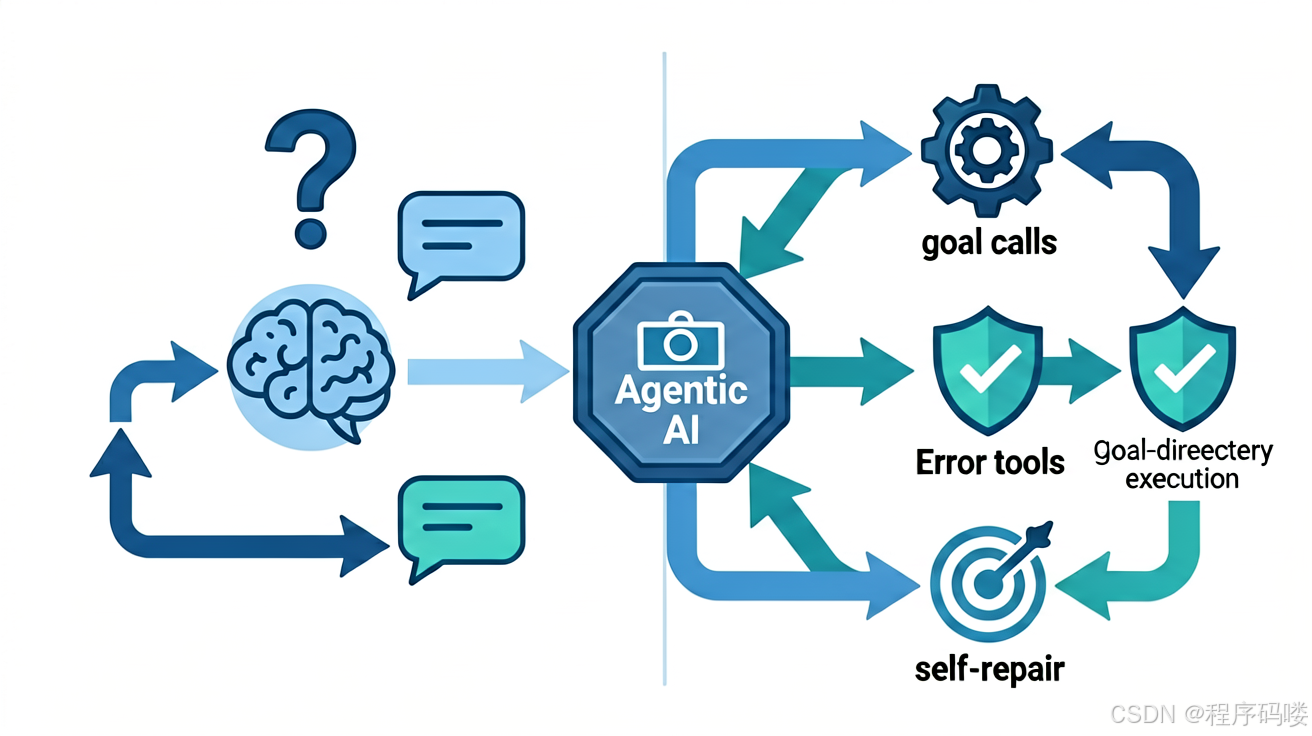
很多人第一次接触Agentic AI,以为就是给大模型加个tool calling。说实话,这样理解没错,但不够。
Agentic的核心是"自主执行"——给定目标,Agent要自己规划路径、调用工具、处理异常、直到达成结果。这和ChatGPT这种"你问一句我答一句"的模式有本质区别。
我见过太多团队把"Agent"当成营销词乱用。实际上,判断一个系统是不是真的Agentic,就看三点:
1. 目标驱动:不是用户追问式交互,而是给定目标后自主推进
2. 工具使用:能调用外部API、读写文件、执行命令
3. 错误自愈:遇到失败能尝试不同路径,而不是直接报错退出
这三个条件缺一不可。缺第一个,还是聊天机器人;缺第二个,Agent就是空壳;缺第三个,线上必崩。
---
真实案例:Demo惊艳到上线翻车的三个月
去年带团队做了一个内部代码审查Agent,初衷很简单:让AI自动review PR,生成建议。
真实案例的输入:一个内部GitLab仓库,每天有约30个PR待review,代码以Python为主,涉及敏感配置和第三方API调用。
Demo阶段:用Claude Code本地跑,输入一段Python代码,输出review意见。效果惊艳,团队成员都觉得"这工具能省半小时"。
团队协作阶段:接入GitLab CI,配置权限,准备上生产。然后开始翻车:
| 问题 | 现象 | 影响 |
|------|------|------|
| 权限过大 | Agent能读写仓库所有代码 | 安全风险 |
| 日志缺失 | 不知道Agent在哪一步失败 | 排查困难 |
| 无回滚机制 | Review意见写错无法恢复 | 信任崩塌 |
复盘这三个月,我意识到Demo能跑和团队协作之间,差的不是模型能力,而是工程化底座。
下面这个对比代码,能直观看出差距:
# 个人Demo版本 - 能跑就行
import anthropic

def review_code(code: str) -> str:
    client = anthropic.Anthropic()
    response = client.messages.create(
        model="claude-sonnet-4-20250514",
        max_tokens=1024,
        messages=[{"role": "user", "content": f"请review这段代码:\n{code}"}]
    )
    return response.content[0].text

# 团队协作版本 - 需要考虑权限、日志、回滚
import anthropic
import logging
from pathlib import Path
import json
from datetime import datetime

class SafeCodeReviewAgent:
    def __init__(self, project_root: str, permission_config: dict):
        self.client = anthropic.Anthropic()
        self.project_root = Path(project_root)
        self.allowed_paths = permission_config.get("allowed_paths", [])
        self.rejected_patterns = permission_config.get("rejected_patterns", [])
        self.logger = logging.getLogger(__name__)
        self.review_history = Path(project_root) / ".reviews"

    def _check_permission(self, path: Path) -> bool:
        """权限检查:不在白名单内的路径拒绝访问"""
        abs_path = path.resolve()
        for allowed in self.allowed_paths:
            if abs_path.is_relative_to(Path(allowed)):
                return True
        self.logger.warning(f"Permission denied: {abs_path}")
        return False

    def _log_review(self, pr_id: str, code_snippet: str, result: str):
        """日志记录:每次review写入历史,便于回溯"""
        record = {
            "timestamp": datetime.now().isoformat(),
            "pr_id": pr_id,
            "code_snippet": code_snippet[:500],
            "result": result
        }
        history_file = self.review_history / f"{pr_id}.json"
        history_file.write_text(json.dumps(record, ensure_ascii=False))
        self.logger.info(f"Review logged for PR {pr_id}")

    def review(self, pr_id: str, code: str) -> str:
        """主流程:权限检查→调用模型→日志记录"""
        # 1. 权限检查
        if not self._check_permission(self.project_root):
            return json.dumps({"error": "permission_denied"}, ensure_ascii=False)

        # 2. 安全过滤
        for pattern in self.rejected_patterns:
            if pattern in code:
                self.logger.error(f"Rejected pattern detected: {pattern}")
                return json.dumps({"error": "security_violation"}, ensure_ascii=False)

        # 3. 调用模型
        try:
            response = self.client.messages.create(
                model="claude-sonnet-4-20250514",
                max_tokens=1024,
                messages=[{"role": "user", "content": f"请review这段代码:\n{code}"}]
            )
            result = response.content[0].text
        except Exception as e:
            self.logger.error(f"API call failed: {e}")
            return json.dumps({"error": "api_failure", "message": str(e)})

        # 4. 日志记录
        self._log_review(pr_id, code, result)

        return result
---
代码解释:关键代码的实现原理
这段关键代码看似长,其实就是把Demo版本打了个补丁,让它能上生产。
输入:SafeCodeReviewAgent 接收两个参数——project_root(项目根目录)和 permission_config(权限配置字典)。review() 方法接收 pr_id(PR编号)和 code(待审查代码)。
核心逻辑分四层:
1. 权限检查:_check_permission() 把传入路径转成绝对路径,逐个比对是否在白名单内。这一步解决了Demo阶段"什么都能读"的安全隐患。
2. 安全过滤:遍历 rejected_patterns,命中关键词直接拦截。比如代码里含 password、secret 这种词,说明可能硬编码了敏感信息,Agent不该继续处理。
3. 模型调用:正常走 Anthropic API,但包在 try-except 里——API 超时、配额超限、网络抖动都会在这里被捕获,不会让整个服务挂掉。
4. 日志记录:把每次审查的关键信息(时间戳、PR号、代码摘要、审查结果)写成 JSON 存入 .reviews/ 目录。这步解决了"事后找不到记录"的痛点。
输出:成功时返回模型生成的 review 文本;失败时返回 JSON 错误码,方便上游系统判断。
异常处理:权限拒绝返回 permission_denied,敏感内容返回 security_violation,API 异常返回 api_failure 并附带原始错误信息。三种错误码让排查时有据可查。
下面再看任务编排那段的 code explanation:
# 线性链式 - 脆弱
def linear_review(pr_id: str) -> dict:
    diff = fetch_diff(pr_id)           # 可能失败
    quality = analyze_quality(diff)     # 依赖上一步
    security = check_security(diff)     # 依赖上一步
    report = generate_report(quality, security)
    return report

# 图结构 - 容错
def graph_review(pr_id: str) -> dict:
    diff = fetch_diff(pr_id)           # 可能失败

    # 并行执行,互不依赖
    quality_task = asyncio.create_task(analyze_quality(diff))
    security_task = asyncio.create_task(check_security(diff))

    # 任一失败不影响另一个
    quality = await quality_task
    security = await security_task

    # 都有结果才生成报告
    if quality and security:
        return generate_report(quality, security)
    elif quality:
        return generate_report(quality, None)
    elif security:
        return generate_report(None, security)
    else:
return {"error": "all_steps_failed"}这段的实现原理是用异步并发替代串行依赖。fetch_diff() 是前置步骤,必须等它完成;但 analyze_quality() 和 check_security() 互不依赖,用 asyncio.create_task() 并行跑,整体耗时缩短近一半。
关键设计在于降级策略:两个分析都成功就出完整报告,只成功一个就出部分报告,都失败才返回错误。这让 Agent 不会因为单点故障而彻底断供——比线性链式健壮得多。
---
自主性边界:什么时候该让Agent自己跑
这是我最想强调的点:Agent不是万能的,要明确边界。
我见过团队把Agent权限开得太大,结果它"自作主张"删了测试数据库。教训很痛。
判断Agent该不该自主执行,看这个决策树:
任务类型?
├── 只读操作(查询、分析)→ 可以自主
├── 写操作(创建、修改)→ 需要审批
└── 删除操作 → 禁止自主,必须人工确认
具体到代码审查Agent,我的建议是:
- Review建议:Agent可以自主生成,写入临时文件
- 直接修改代码:需要人工确认,不能自动提交
- 删除文件或分支:绝对禁止,必须人工操作
这个边界不是限制Agent能力,而是保护团队不被误操作搞死。
---
任务拆解:从单步调用到多步编排的坑
Demo阶段,Agent就干一件事:review代码。简单。
团队协作阶段,任务变复杂了:
1. 获取PR信息(调用GitLab API)
2. 拉取代码diff
3. 分析代码质量
4. 检查安全漏洞
5. 生成review意见
6. 写入评论
每一步都可能失败。单步调用的Agent崩了就崩了,多步编排的Agent崩了要能恢复。
我推荐的架构是Graph-based编排,不是线性链式调用。原因很简单:
- 线性链:A→B→C→D,B失败了C和D就没法执行
- 图结构:A→B→C,A→D→C,B失败了可以尝试走A→D→C路径
---
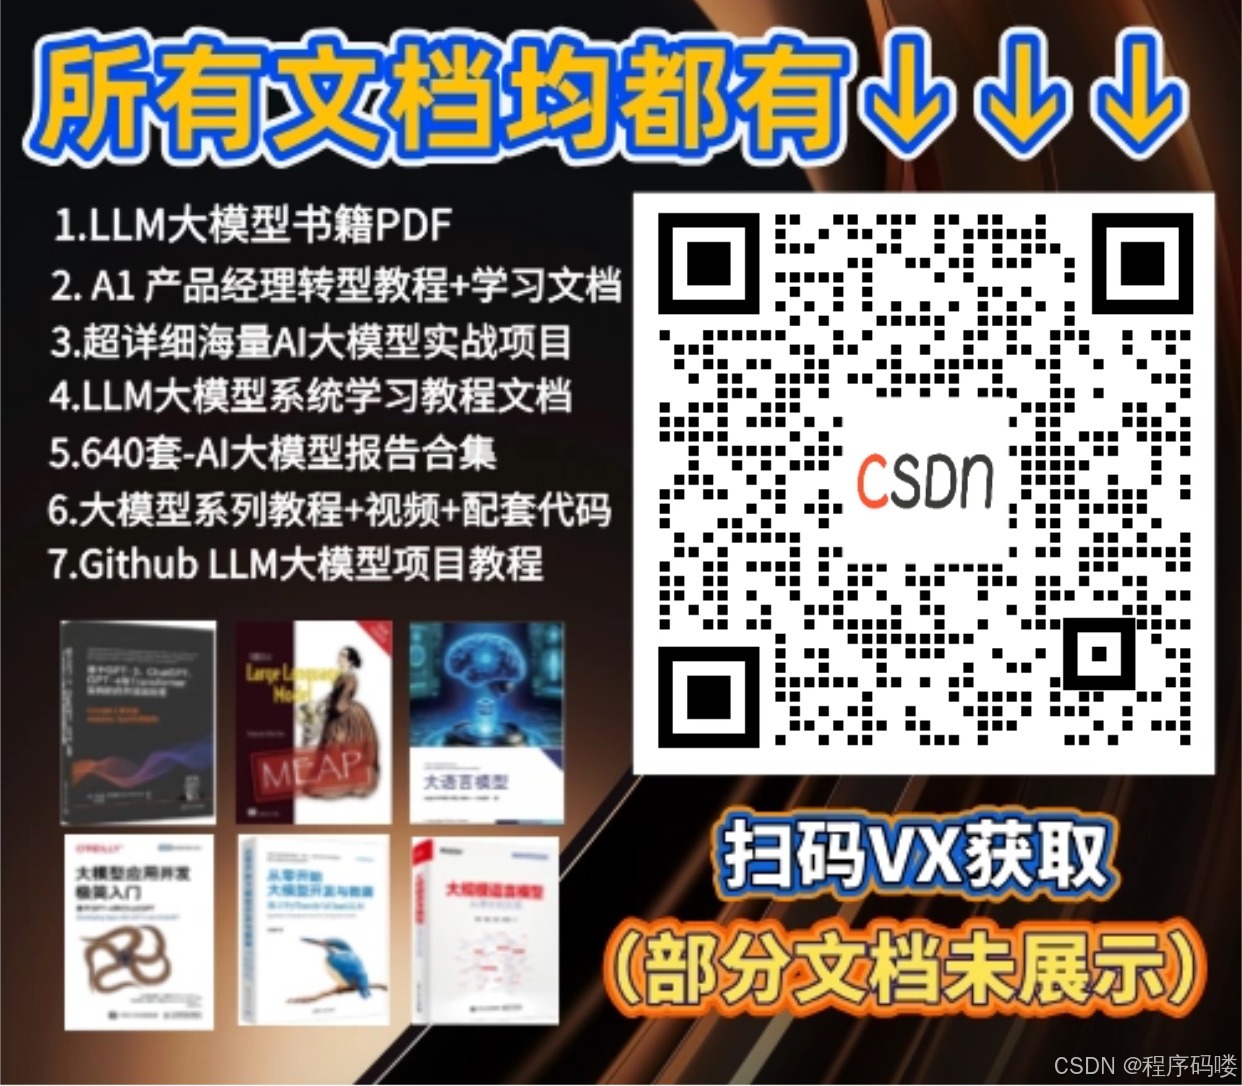
可观测性:没有日志的Agent就是黑盒
这是我踩得最痛的坑。
Demo阶段,我看得到Agent输出了什么,觉得一切正常。
上线后,团队反馈"Agent卡住了",但我完全不知道卡在哪。排查了三小时,最后发现是GitLab API限流。
可观测性三件套:
1. 结构化日志:不是print,是JSON格式,便于查询
2. Trace ID:每次请求唯一ID,串联完整链路
3. 指标监控:成功率、延迟、错误类型分布
代码层面,我推荐这样做:
import logging
import uuid
import time
from contextlib import contextmanager

class TracedLogger:
    def __init__(self, name: str):
        self.logger = logging.getLogger(name)
        self.logger.setLevel(logging.INFO)

    @contextmanager
    def trace(self, operation: str):
        """带trace id的上下文管理器"""
        trace_id = str(uuid.uuid4())[:8]
        start = time.time()

        self.logger.info(f"[{trace_id}] Start: {operation}")

        try:
            yield trace_id
            elapsed = time.time() - start
            self.logger.info(f"[{trace_id}] Success: {operation} ({elapsed:.2f}s)")
        except Exception as e:
            elapsed = time.time() - start
            self.logger.error(f"[{trace_id}] Failed: {operation} ({elapsed:.2f}s) - {e}")
            raise

# 使用示例
tracer = TracedLogger(__name__)

with tracer.trace("fetch_pr_diff") as trace_id:
    diff = fetch_diff(pr_id, trace_id=trace_id)

with tracer.trace("analyze_code") as trace_id:
    quality = analyze_quality(diff, trace_id=trace_id)
这样排查问题时,输入trace_id就能找到完整链路。
---
排查过程:故障定位的具体链路
那次GitLab API限流的排查过程,现在想起来还是后怕。
第一步:现象确认。周一早上开始,团队反馈"Agent卡住了",但没有任何报错。我去看服务器,进程还在跑,CPU和内存都正常。
第二步:缩小范围。我登录服务器查看日志,发现最近的日志停在三天前——说明Agent三天前就停了,但没人知道。我加了个health check接口,每5秒输出一次心跳,重新部署后发现心跳确实停了。
第三步:定位根因。我翻了GitLab的API限流文档,发现我们的调用频率超过了每分钟60次的限制。Agent在循环处理PR队列时,没有做节流,直接把GitLab打爆了。
第四步:修复和验证。我给Agent加了令牌桶限速器,每秒最多发2个请求,重启后观察一天,问题解决。
这个排查链路的关键是:先确认现象,再缩小范围,最后定位根因。很多团队跳过了前两步,直接去改代码,反而越改越乱。
---
安全约束:权限配置才是生产环境的硬门槛
前面提到了权限检查,这里展开说。
Agent的权限配置,我推荐最小权限原则:
| 权限类型 | Demo阶段 | 生产阶段 |
|---------|---------|---------|
| 文件读取 | 全部允许 | 白名单路径 |
| 文件写入 | 全部允许 | 仅临时目录 |
| 命令执行 | 禁止 | 白名单命令 |
| API调用 | 全部允许 | 按功能授权 |
具体到代码审查Agent,我的配置是:
# permission_config.yaml
allowed_paths:
  - /repo/src
  - /repo/tests
  - /tmp/reviews

rejected_patterns:
  - "password"
  - "secret"
  - "api_key"

allowed_commands:
  - "grep"
  - "git diff"
  - "python -m py_compile"

denied_commands:
  - "rm"
  - "sudo"
  - "curl"
  - "wget"
这个配置文件要纳入版本管理,变更要有审批。
---
失败原因:业务错误、配置错误和环境错误的区分
团队反馈Agent出问题时,首先要判断错误类型。我总结了一个排查流程图:
Agent失败?
├── 模型输出异常 → 业务错误(Prompt/模型问题)
├── 权限被拒绝 → 配置错误(权限配置问题)
├── API超时/限流 → 环境错误(网络/依赖问题)
└── 未知错误 → 日志缺失(可观测性问题)
具体排查方法:
业务错误:看模型输出,是否合理?Prompt是否需要调整?
# 典型业务错误:模型输出了不可执行的代码
result = agent.review(pr_id, code)
if "import os" in result and "os.remove" in result:
    # 模型生成了危险操作建议,需要拦截
    logger.warning("Dangerous suggestion detected")
配置错误:看权限日志,是否触发了限制?
# 典型配置错误:路径不在白名单
if "permission_denied" in result:
    logger.error("Check permission config for path")
环境错误:看网络日志,是否有超时或限流?
# 典型环境错误:API限流
try:
    response = client.messages.create(...)
except anthropic.RateLimitError:
    logger.error("Rate limited, check quota")
可观测性问题:如果没有日志,先加日志。
---
适用边界:什么时候不该照搬方案
最后说重点:不是所有场景都适合Agentic AI。
我见过团队在以下场景强行上Agent,结果翻车:
| 场景 | 问题 | 建议 |
|------|------|------|
| 高频低价值任务 | Agent成本高于人工 | 用传统脚本 |
| 关键业务决策 | 错误代价太高 | 人工审批 |
| 规则明确的任务 | Agent过度engineering | 用确定性逻辑 |
| 数据敏感场景 | 隐私泄露风险 | 本地部署+严格权限 |
我的判断标准:
1. 任务是否够复杂,需要多步推理?
2. 错误代价是否在可接受范围?
3. 是否有足够的可观测性?
4. 团队是否有能力维护Agent系统?
如果四个问题有一个否定答案,就别上Agent,用传统方案更稳。这就是适用边界的取舍——有时候不用Agent反而是更好的选择。
---
总结:学习顺序错了,后面全错
复盘这三个月,我最想强调的是:学习顺序很重要。
很多团队的第一步就错了:
错误顺序:模型能力 → 工具调用 → 权限日志 → 团队协作
结果:Demo能跑,上线就崩

正确顺序:权限日志 → 任务拆解 → 工具调用 → 模型能力
结果:Demo稳,团队协作更稳
为什么这个顺序重要?
因为权限和日志是生产环境的硬门槛,缺这两个,后面全白搭。任务拆解是架构基础,缺这个,Agent跑两步就崩。工具调用和模型能力是最后一步,前面地基打好了,这些只是优化问题。
我现在的建议是:
1. 先学权限配置和日志规范
2. 再学任务拆解和错误处理
3. 然后学工具调用和模型能力
4. 最后才考虑团队协作和CI/CD集成
记住一句话:Demo能跑只是入门,能让Agent在权限边界内可靠干活,才是分水岭。
---
> 本文作者:程序码喽,真实技术博主,专注大模型真正跑起来。欢迎关注,一起避坑。
资料展示
下面是我整理的AI大模型学习资料和工具包预览,适合收藏后按主题逐步学习。
如果你想看完整资料目录,可以在评论区留言「资料」;也欢迎告诉我你更关注AI大模型里的哪类内容。

汇聚全球AI编程工具,助力开发者即刻编程。
更多推荐

 14
 0
- 0


 已为社区贡献94条内容

所有评论(0)