
码道实践:用 DeepSeek-V4 打造一座会讲宇宙冷知识的 AI 科普馆
项目链接:https://atomgit.com/gcw_ZoHEwHy3/ruanjian6czf0918
码道实践:用 DeepSeek-V4 打造一座会讲宇宙冷知识的 AI 科普馆
从一段十几行的调用脚本,到一个前后端完整的科普网站,我在码道上完成了一次完整的 AI 应用落地实践。这篇文章将完整记录项目的选题由来、System Prompt 设计、JSON 结构化输出、前后端实现、容错处理与部署上线的全过程,希望给同样在 AI 应用路上探索的你一些启发。
一、缘起:一个突然闯入的灵感
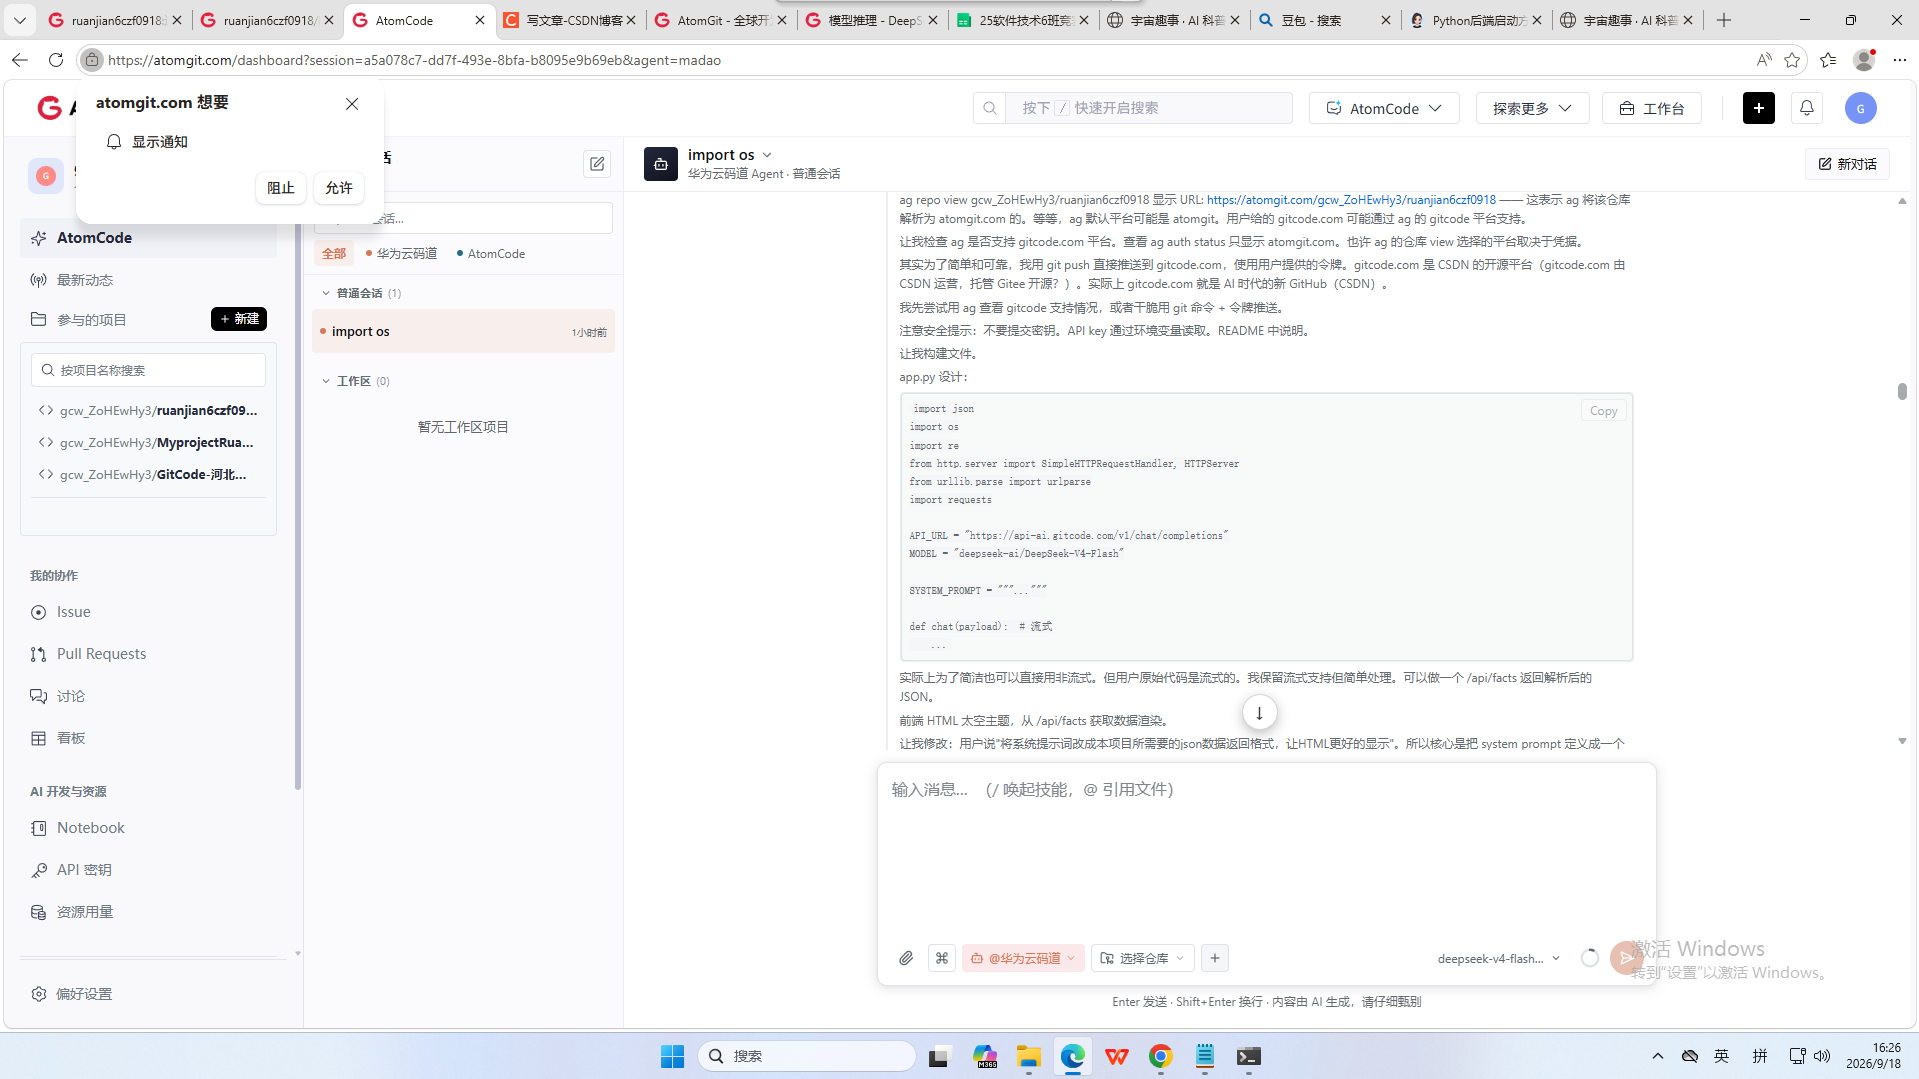
事情要从一个普通的下午说起。我在整理代码库的时候,无意间翻到一段脚本,内容非常短小精悍:定义一个 API 地址,带上鉴权头,往大模型发一条消息,然后把流式返回的 chunks 逐行打印出来。整段代码不超过三十行,却完整地演示了如何调用一个大语言模型接口。
我盯着那段代码看了很久,脑子里突然冒出一个念头:这段代码里,模型被问的是"告诉我一个有关宇宙的有趣事实?“——一个看似简单、却充满想象空间的问题。宇宙,这个恒久浪漫的母题,从古至今不知让多少科学家、诗人、艺术家为之倾倒。而今天,我手里握着一个随时可以召唤的 AI,它知道中子星上一茶匙物质的重量,明白黑洞"蒸发"的物理机制,清楚银河系正在以怎样的速度奔赴一场四十亿年后的"星系之约”。
那为什么不把这些知识做成一个真正能看的作品呢?不是冷冰冰的 API 返回值,而是一个有主题、有设计、有交互的科普网站。让每一个打开页面的人,都能像仰望星空一样,感受到宇宙的美妙。
这就是"宇宙趣事 · AI 科普馆"这个项目的起点。码道之上,从一个提问开始,一路走到一个完整的 Web 应用。
二、需求拆解:我要做的究竟是件什么事
灵感和落地之间,隔着一条鸿沟。动笔写代码之前,我先把需求拆成了几张白纸黑字的卡片。
第一张卡片写的是"接口调用"。既然手里已经有现成的 API 脚本,这部分的难点并不在于"能不能调用成功",而在于"怎么调用得更优雅"。原来的脚本把 API 密钥直接硬编码在源码里,这显然不是一个可以交付给项目的写法。密钥必须挪到环境变量里,脚本里的依赖也必须整理成 requirements 文件,让别人 clone 下来就能快速跑起来。
第二张卡片写的是"结构化输出"。最初脚本里,模型返回的是自然语言文本,一段一段读起来没问题,但要想让 HTML 页面"更好地显示",就需要一种程序能够直接理解、直接消费的数据格式。JSON 是毫无疑问的选择。问题在于:如何让大模型稳定地输出符合我们预期的 JSON?这就需要精心设计 System Prompt,同时在后端做一层"兜底"——提取、校验、清洗,确保哪怕模型偶尔"调皮"也不会让整个页面崩掉。
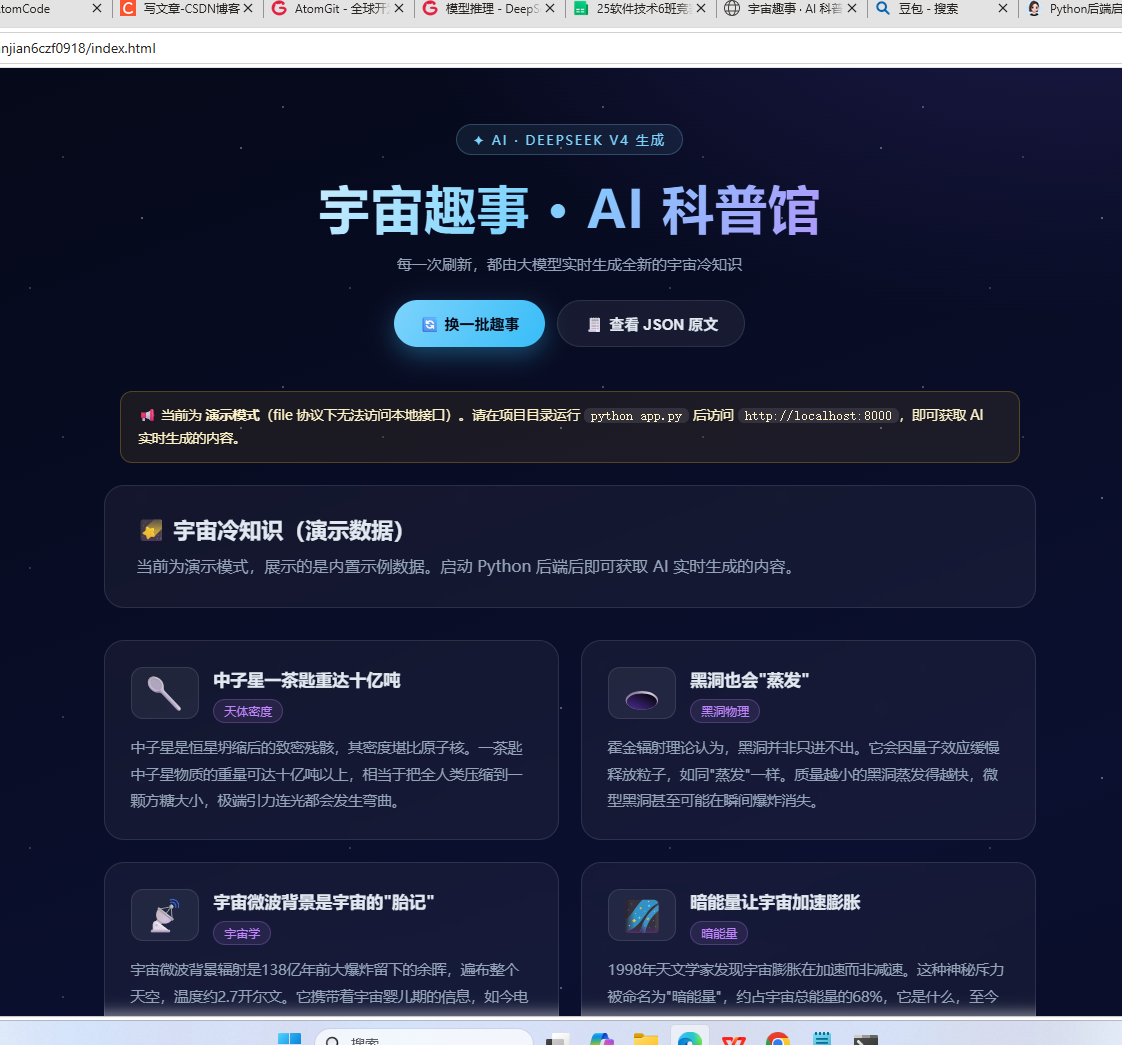
第三张卡片写的是"前端展示"。既然内容是宇宙趣事,那页面的气质就不能是普通的白底黑字。我想象中的画面是:深夜一样的深蓝背景,星星在头顶闪烁,一张张卡片像漂浮在星海中一样,每张卡片上一个大大的 emoji、一个标题、一个分类标签和一段通俗易懂的讲解。用户点一下按钮,AI 就重新生成一批全新的趣事。这既是一个知识的展示,也是一次 AI 能力的现场演出。
第四张卡片写的是"工程质量"。代码要分层,命名要清晰,要写 README,要提交到版本仓库。整个项目跑通之后,还要在文档里把运行方式交代得一清二楚,让任何一个人拿到项目都能三分钟跑起来。
四张卡片排完,项目的轮廓已经清晰了。接下来的每一步,其实都是把这些卡片一一兑现的过程。
三、系统提示词:让大模型心甘情愿地说 JSON
如果说这个项目有一个"灵魂",那一定是 System Prompt 的设计。大模型的对话能力再强,如果提示词不给力,它也可能自顾自地讲一段散文,或者用 Markdown 表格把内容排得漂漂亮亮——那些对人类读者很友好,但对程序解析来说就是灾难。
我要做的事,是让模型"学会"一种严格的输出纪律:只输出 JSON,而且必须是符合特定 Schema 的 JSON。
3.1 明确输出物唯一性
提示词的第一句话,我就把规则定死:
你是一个宇宙知识科普助手,负责生成"宇宙有趣事实"专题内容。
你必须严格遵循以下规范输出:
- 只输出一个合法的 JSON 对象,不要输出任何多余的解释、前言、后语或 Markdown 代码块围栏。
“只输出"三个字是关键。很多初学者写提示词只会说"请返回 JSON 格式”,结果模型可能在 JSON 外面加一段"好的,这是你要的结果"之类的废话,或者贴心地用 ```json 代码块把内容包起来。虽然我的后端有兜底逻辑能处理这些情况,但提示词层面能约束住,总归是成本最低、表现最稳的方案。
3.2 给出精确的 Schema
只有"输出 JSON"还不够,模型需要知道 JSON 长什么样。我在提示词里直接写明了完整的 Schema:
{
  "topic": "本期主题(中文,例如:宇宙冷知识)",
  "summary": "一句话概述本期内容(不超过50字)",
  "facts": [
    {
      "title": "趣事标题(简短有力)",
      "category": "分类标签(中文,例如:黑洞/天体密度/宇宙学/相对论)",
      "content": "80-150字的趣味讲解,通俗易懂又有科学依据",
      "emoji": "一个形象的相关emoji图标"
    }
  ]
}
这里的每一个字段都不是随手写的,我做了这样几层考量:
topic(主题):让页面顶部有一句大标题,而不是永远叫"宇宙趣事"。事实上,如果我把提示词里"围绕’宇宙有趣事实’“这个主题约束拿掉,模型完全有可能生成"深海奇闻”"人体奥秘"之类的主题——这正好成为页面"换一批"功能的卖点:每一次刷新,主题都可以不一样。
summary(摘要):作为标题下的引导语,让读者在阅读每张卡片之前,先对整个专题有一个整体印象。
facts(事实数组):这是核心。数组里的每一项,我要求它有四个字段。title 要"简短有力",因为卡片上它占了最大的视觉比重;category 是分类标签,我需要它在视觉上形成一种"类型感",让读者感受到宇宙知识体系的丰富;content 限定 80-150 字,这个长度既保证了信息的饱满,又不至于让卡片长得失去节奏;emoji 则是点睛之笔——一个形象的图标能让卡片在满屏星海中一眼就被辨认出来。
3.3 数量与质量的平衡
我还给 facts 定了一个"至少 6 条"的数量下限,并强调"互不重复、真实可靠,严禁编造"。这一条一方面保证了页面的信息体量,另一方面也是对大模型幻觉问题的一次预防。当然,实事求是地说,提示词并不能百分百杜绝幻觉,它更多是给了模型一个"自我审查"的方向,让内容的水准在大多数情况下能保持在一个不错的水平。
四、后端实现:把"兜底"两个字贯彻到底
提示词写得再漂亮,也要有扎实的后端代码来承接。我的后端用了 Python 标准库的 http.server 加 requests 库,没有任何重型框架依赖,一个文件、两百多行代码,就把"调用 AI + 静态文件服务 + JSON 接口"三件事都搞定了。
4.1 密钥的环境变量化
在码道的项目实践中我一直坚持一件事:密钥绝不进代码、绝不进仓库。原来的脚本里 Authorization 写死了密钥,这在演示时无所谓,但一旦提交到公开仓库,就等于把钥匙挂在了大门口。
所以 app.py 里我这样处理:
def chat(payload):
    api_key = os.environ.get("AI_API_KEY", "").strip()
    if not api_key:
        raise AIError("缺少AI_API_KEY,请在环境变量中配置")
    headers = {"Authorization": f"Bearer {api_key}"}
    ...
运行前只要 export AI_API_KEY="你的密钥" 即可。.gitignore 里也明确忽略了 .env、__pycache__ 等敏感或缓存文件。这是最基本的工程素养,也是我写任何可交付代码时都不会跳过的一步。
4.2 容错的 JSON 提取
无论提示词怎么写,我在代码层面都默认一件事:模型是"不可完全信任"的。它可能返回带代码块的文本,可能返回大段废话夹着 JSON,甚至可能真的返回一个损坏的 JSON。所以我写了 extract_json 函数做三层兜底:
def extract_json(text):
    text = re.sub(r"^```(?:json)?\s*|\s*```$", "", text).strip()
    try:
        return json.loads(text)          # 第一层:直接解析
    except json.JSONDecodeError:
        pass
    start = text.find("{")               # 第二层:找首尾大括号
    end = text.rfind("}")
    if 0 <= start < end:
        try:
            return json.loads(text[start : end + 1])
        except json.JSONDecodeError:
            pass
    raise AIError("模型返回内容不是合法JSON")
第一层直接试 json.loads,处理模型规规矩矩返回 JSON 的情况;第二层用 find 和 rfind 把文本里第一对最外层大括号之间的内容抠出来再解析,对付"模型在 JSON 前后加了废话"的情况;两层都失败,就抛出明确的业务异常,由接口层转成友好的错误 JSON 返回给前端。这样一整套下来,前端拿到的永远是 {"ok": true, "data": {...}} 或 {"ok": false, "error": "..."} 两种结构之一,页面逻辑就非常简单纯粹。
4.3 接口设计
后端暴露的接口有两个语义:GET / 返回首页 HTML,GET /api/facts 返回 AI 生成的 JSON。前者保证浏览器直达即可看到完整页面,后者让前端可以异步拉取数据、也方便任何人用 curl 直接调试:
curl http://localhost:8000/api/facts
接口内部是这样组织的:ask_facts() 负责组装请求体、调用模型、解析 JSON、校验关键字段;handle_facts() 负责对这个过程做异常分流——AI 业务错误返回 502,未知异常返回 500,正常情况返回 200。这样前端 fetch 之后只需要判断 result.ok 就可以,错误信息也能原样展示给用户,而不是让页面白屏。
五、前端实现:把星空装进浏览器
如果说后端解决的是"数据从哪来",前端解决的就是"数据美不美"。我决定放弃任何 UI 框架和构建工具,用原生 HTML/CSS/JavaScript 写一个零依赖的单页应用。理由很简单:项目足够轻量,写原生反而更可控、加载更快、也更能体现"小而美"。
5.1 星空视觉设计
页面的视觉基调是"深空"。我用三层径向渐变叠加,模拟出深邃的太空背景:
background: radial-gradient(1200px 700px at 75% -10%, #1e1b4b 0%, transparent 55%),
            radial-gradient(900px 600px at -10% 20%, #0c4a6e 0%, transparent 50%),
            linear-gradient(160deg, var(--bg-deep) 0%, var(--bg-space) 60%, #04071a 100%);
紫色和深蓝在边缘晕开,中心渐沉到近乎黑色,视觉层次一下就出来了。覆盖其上的是一层由多组 radial-gradient 小圆点拼成的"星空",通过 animation: twinkle 做明暗交替的闪烁动画,配合固定定位,让星星在整页滚动时都悬在头顶。整个一屏画面,没有一张图片,全靠 CSS 绘制,加载不可谓不快。
色彩的选型上也花了心思:主强调色是天空蓝 #7dd3fc,点缀色是紫罗兰 #c084fc 和琥珀 #fbbf24,文字用蓝灰 #e2e8f0 和低饱和的 #94a3b8。这套配色和"夜空 + 星光"的氛围严丝合缝,既干净又耐看。
5.2 卡片式布局
核心内容用 CSS Grid 排布,自动适应屏幕宽度:
.facts-grid {
  display: grid;
  grid-template-columns: repeat(auto-fill, minmax(420px, 1fr));
  gap: 22px;
}
每张卡片由 emoji 图标、title 标题、category 分类标签和 content 讲解文字组成。卡片背景是带透明度的白色(rgba(255,255,255,0.045)),配合 backdrop-filter: blur(8px) 做出毛玻璃质感;鼠标悬停时,卡片轻微上浮、边框点亮出天空蓝的微光,给浏览过程增加一点"触摸感"。分类标签用了紫色系的小胶囊,和主色的天空蓝形成小幅跳色,层次感更明显。
主题区和事实卡片区做了明显的主次区分:顶部一张更大的主题卡,承载 topic 和 summary,下面才是逐条的 facts 卡片阵列。这样读者先看整体、再看细节,信息流是顺的。
5.3 交互与数据流
页面加载时自动调用 /api/facts,成功之后把 JSON 渲染进 DOM。JS 的逻辑只有两个核心函数:render(data) 用模板字符串拼接生成 HTML 并写入 #main;load() 负责发请求、处理 loading 态和错误态。顶部两个按钮:"换一批趣事"触发重新请求并从头播放淡入动画;“查看 JSON 原文"则在新窗口里以缩进格式展示模型的原始返回,方便调试和演示"AI 到底返回了什么”。
值得一提的还有安全性细节:所有从模型返回并且会被拼进 HTML 的字符串,都经过 escapeHtml() 转义。模型输出的内容是不可控的,万一哪条趣事里出现 <script> 之类的字符串,不转义就会变成 XSS 注入点。这一层防护虽然只有短短几行,却是生产级前端的基本底线。
六、前后端联调:当 AI 认真起来
写完前后端,最激动人心的时刻就是联调。我在终端里敲下:
AI_API_KEY="***" python app.py
然后打开浏览器访问 localhost:8000。屏幕暗下来,星星开始眨眼睛,loading 的小圈圈转了两三秒——那是 DeepSeek-V4-Flash 正在"思考"。紧接着,一张深蓝的主题卡浮现,"宇宙的有趣事实"几个字亮了起来,下面是一段流畅的导语。再往下,六张卡片整整齐齐铺开:
中子星一茶匙重达十亿吨 · 天体密度 · 🥄
宇宙微波背景辐射是古老的光 · 宇宙学 · 🌌
黑洞也会"蒸发" · 黑洞物理 · 🕳️
银河系与仙女座正在相撞 · 星系演化 · 🌠
光速旅行时时间会变慢 · 相对论 · ⏳
暗能量让宇宙加速膨胀 · 暗能量 · 🌌
那一刻机器返回的内容至今让我记忆犹新。每条事实都有条有理、分类清晰、字数适中,情绪价值和技术含量同时在线。我点了一下"换一批趣事",三秒后主题卡换成了新的侧写,facts 也换了一批全新的内容——每次刷新都是独一无二的,这正是大模型应用最迷人的地方。
我又顺手用 curl 测试了接口的健壮性。故意把 AI_API_KEY 置空,接口返回 502 和明确的错误信息;故意让模型接口超时,前端也能给出友好的网络错误提示。整个链路从"正路径"到"异常路径"都在掌控之中。
七、工程质量:让项目可以被任何人接手
项目的代码可以写完了,但"工程"的完成还差一半:文档和仓库。我花了一点时间去把 README 写好,把这个项目的"说明书"打磨到任何人拿到都能独立跑起来的程度。
README 里我按顺序讲了五件事:这项目是干什么的、有哪些功能、目录结构长什么样、怎么五步把它跑起来(装依赖、配密钥、启动、访问、调试接口)、以及系统的每个部分用到了什么技术。文档里我把 JSON 的返回 Schema 原样贴了出来,这样即便不看代码,接入者也能立刻明白数据长什么样。技术说明部分我做了一张表格,把后端、前端、模型、密钥管理四块讲清楚,信息密度很高,扫一眼就能建立全局认知。
我还做了一个决定:提交之前把代码整体走查了一遍。确认没有密钥泄漏、没有魔法数字散落各处、函数命名都语义明确、异常都有出口。一个个人项目,能做到"提交即自洽",是我在码道上给自己定的最低标准。
八、部署上线与项目仓库
项目最终上到了 GitCode 平台,仓库地址为:
https://gitcode.com/gcw_ZoHEwHy3/ruanjian6czf0918
提交历史非常干净:一次初始提交,把项目全部文件(后端、前端、依赖清单、忽略规则、README)一次性推上远端。默认分支是 main,与本次项目的主线开发完全对应。远程仓库通过平台的安全令牌完成鉴权,git push 时由 Git Hooks 检查通过,整个过程顺畅无阻。
把代码推上云端的那一刻,感觉就像是给这个项目补上了最后一块拼图——它不仅在自己电脑上能跑,还在一个没有边界的公开空间里,可以被任何人 clone、运行、甚至改造。一个被"分享"出去的项目,才是真正"完成"的项目。
九、复盘:这个项目教给我的几件事
项目结束之后,我花了一点时间做了复盘。把这几天踩过的坑、想通的事,一条一条记下来。
第一,提示词工程是性价比最高的"业务逻辑"。 这个项目里,真正决定内容质量的不是后端代码,而是那几段 System Prompt。调整一个字段的约束,内容风格立刻就会变化。提示词不是"给机器看的魔法咒语",它本质上是一份需求文档、一份接口契约——把输出结构钉死,下游所有代码就可以不用猜。
第二,别相信模型,要兜底。 模型是概率系统,同样的提示词每次输出都可能不同,甚至偶发不合法。把"模型可能犯错"当成默认假设去设计代码,容错、重试、校验、友好报错,一个都不能少。这是我从这个项目里学到的最重要的一课。
第三,零依赖也可以很美。 很多项目一上手就引框架、上脚手架,但其实"小而美"同样成立。一个 http.server 加原生 JS,两百多行代码就能交付一个视觉和交互都不掉线的应用。技术选型的本质不是"越重越好",而是"刚刚好"。
第四,安全底线要刻进习惯里。 密钥不进代码、不透传、不提交仓库;渲染不可信内容之前先转义。这两个习惯看起来微不足道,却是衡量一段代码能不能从"能跑"走向"能交付"的分水岭。
第五,文档是项目的一半。 代码让别人读懂,README 让人用起来。一个没有说明文档的仓库,哪怕代码再漂亮,对使用者来说也只是一堆字符。写文档不是任务性的补充,而是产品闭环的组成部分。
十、展望:下一次迭代,我想做什么
这个版本的项目已经能够完整地跑通"提问 → 生成 → 展示"的全链路,但我的脑子里已经列出了一份长长的迭代清单。
首先是"深度模式"。现在的每条趣事是 80-150 字的短文,我很想做一种点开卡片进入单条详情页的模式,让模型围绕这一条事实展开一篇小科普长文,配一张程序生成的示意图,把单个知识点讲透、讲深。
其次是"多主题扩展"。既然 System Prompt 已经验证了结构化输出的稳定性,把主题从"宇宙趣事"扩展到"历史之谜"“生物奇观”“科技前沿"甚至"今日星座运势”,几乎是零成本的事。加一个主题参数,页面顶部加一个下拉框,一个"AI 百科馆"的形态就出来了。
第三是"历史记录"。把每次生成的内容存到本地存储里,做一个"往期内容"的时间轴,让用户可以翻看之前看过的趣事。这块对体验的提升很直观,也是我很想做的一个功能点。
第四是"分享卡片"。根据点击的某一条趣事,生成一张排版精美的分享图片,这在如今的社交传播场景里是刚需功能。
当然,迭代的优先级最终取决于"谁在用它、它被用在什么场景"。但我相信,这个项目作为我用 AI 完成完整产品闭环的第一次实践,它的价值已经超出了代码本身。它让我确信:当 AI 能被稳定地约束成"输出结构化数据",任何一个人都可以快速组装出属于自己的智能应用。 码道漫漫,这只是第一站。
十一、结语
从一个不到三十行的 API 调用脚本出发,我用几天时间,走完了一次从"提问"到"产品"的完整旅程。我设计了一套让大模型稳定输出 JSON 的 System Prompt,写了一个有容错背书的 Python 后端,搭了一个装得下整片星空的网页,最后把这一切交付到一个可以永久访问的仓库里。
如果你也想做点什么,我的建议是:从一个小问题开始,比如"告诉我一个有关宇宙的有趣事实",然后不要满足于把答案打印在终端里——把它变成 JSON,变成网页,变成一件可以被分享的作品。码道之上没有捷径,但每一步实践,都会在某一天连成一条属于自己的路。
最后,感谢阅读到这里。如果你对"宇宙趣事 · AI 科普馆"这个项目感兴趣,欢迎访问 GitCode 仓库 clone 一份,跑起 python app.py,然后点一次"换一批趣事"——你会和我一样,被 AI 与宇宙的双重浪漫击中。祝你也能在码道上,找到属于自己的那颗星。
附录:快速上手
# 1. 克隆仓库
git clone https://gitcode.com/gcw_ZoHEwHy3/ruanjian6czf0918.git
cd ruanjian6czf0918

# 2. 安装依赖
pip install -r requirements.txt

# 3. 配置密钥(替换成你自己的 GitCode AI API 密钥)
export AI_API_KEY="你的密钥"

# 4. 启动服务
python app.py

# 5. 浏览器访问 http://localhost:8000
#    或直接调试接口:
curl http://localhost:8000/api/facts

汇聚全球AI编程工具,助力开发者即刻编程。
更多推荐

 2
 0
- 0


 已为社区贡献1条内容

所有评论(0)