
码道:歌曲接龙AI项目开发实战
码道 · 歌曲接龙:当 AI 学会"接歌词",一个纯前端对话项目从零到一的完整实战记录
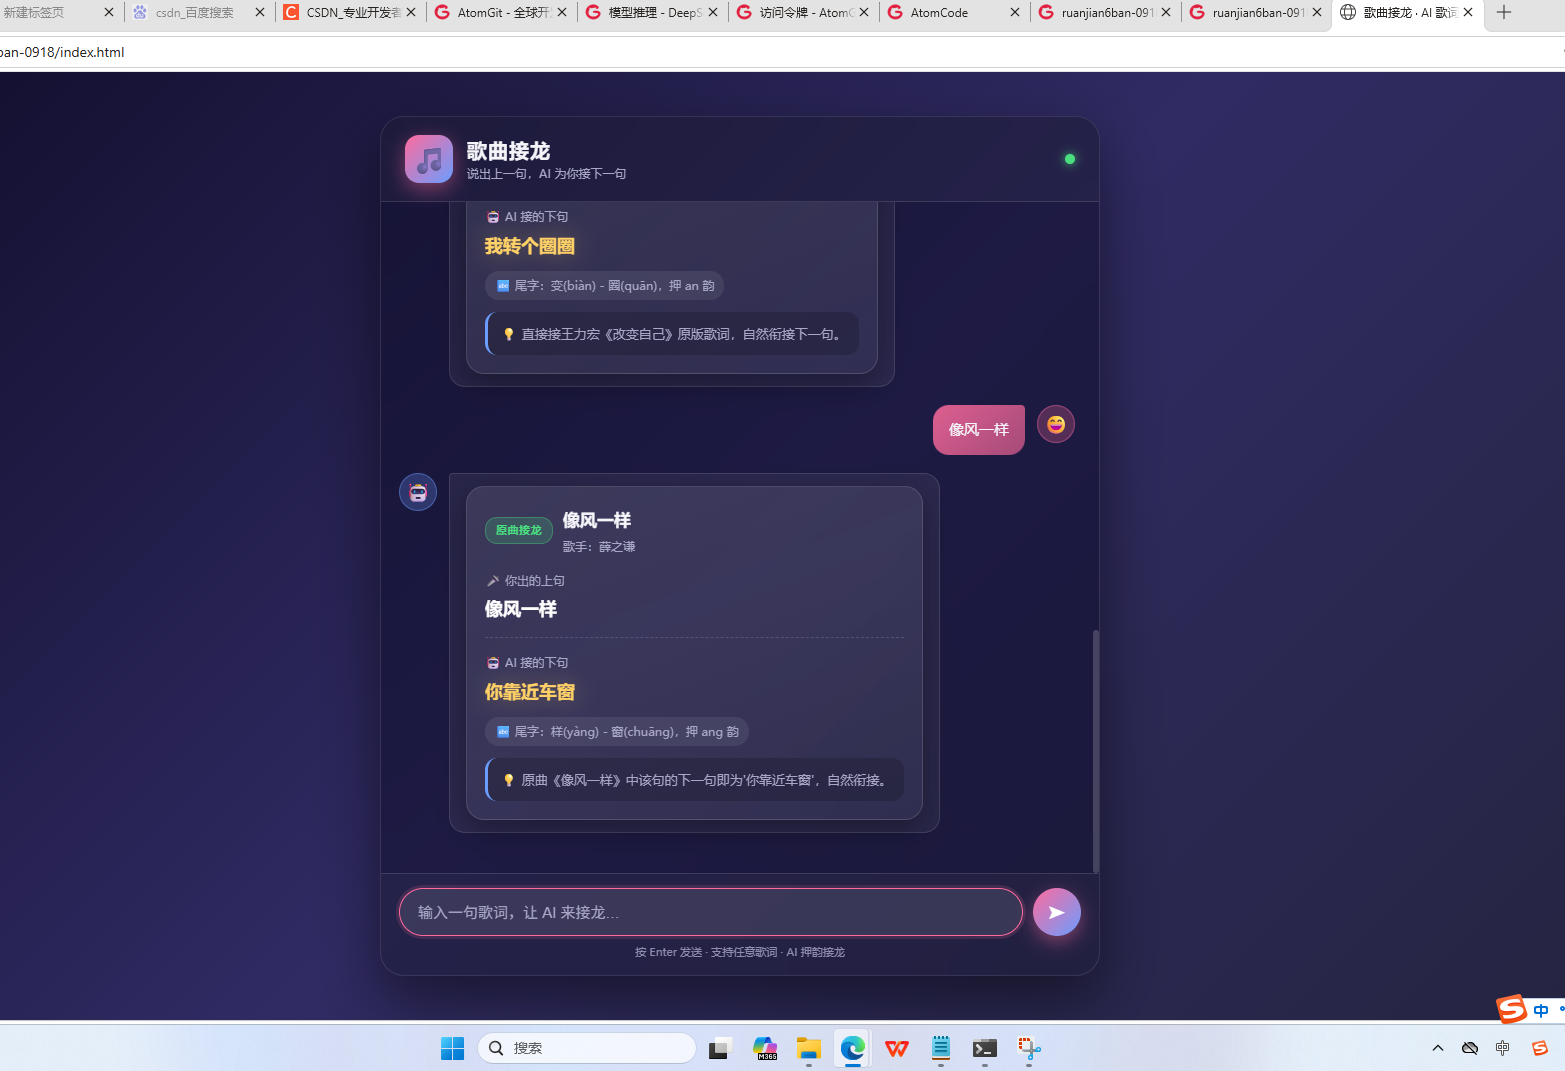
运行实例效果:
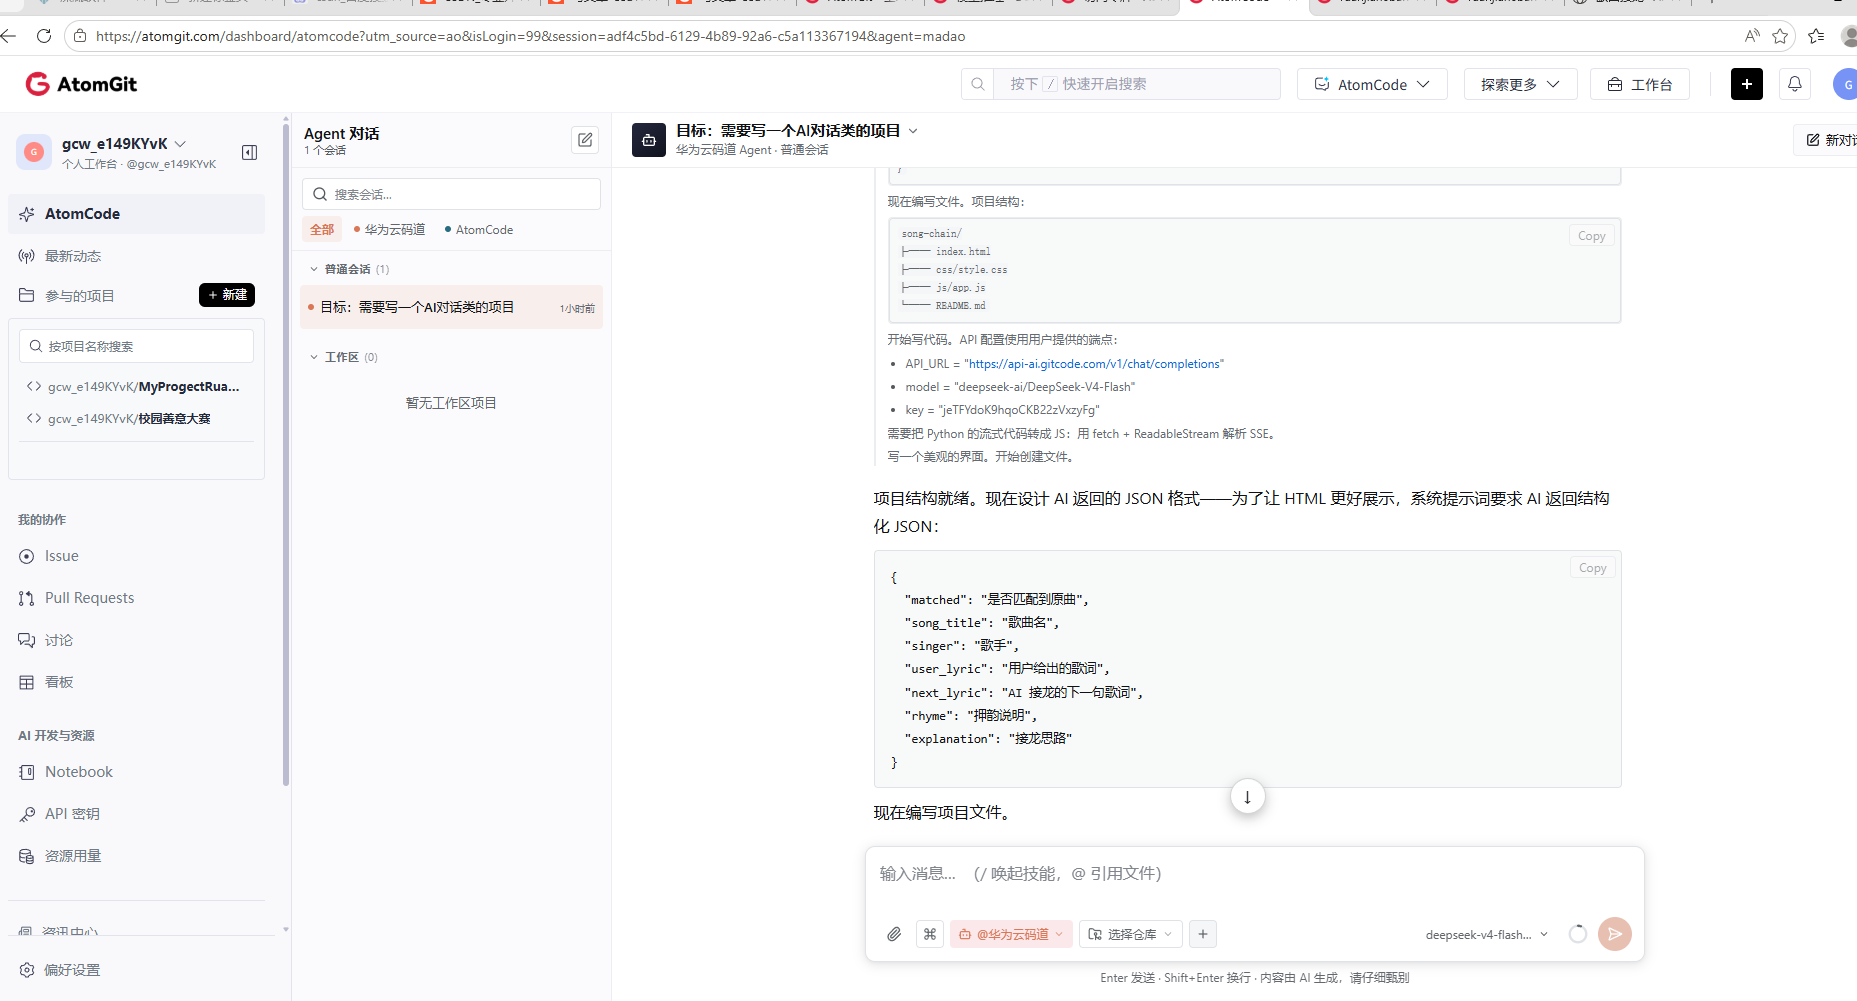
使用工具:
一、写在前面:为什么会有这个项目
在麦步的创作世界里,代码从来不只是工具,更是表达创意的方式。作为一名经常和音乐、产品打交道的人,我一直对"歌词"有一种特殊的情感:一句歌词,往往承载着整首歌的情绪;而两句歌词之间的衔接,则是词作者最见功力的地方。你有没有想过,如果让 AI 来玩"歌词接龙"的游戏,会碰撞出什么样的火花?
这个想法诞生于一堂实践课。课程要求我们用 HTML5、CSS3 和 JavaScript 构建一个 AI 对话类项目,并且允许我们自由发挥创意。多数同学选择做普通的问答机器人,但我想做一点不一样的——不是让 AI 回答知识,而是让 AI 变成一个"歌词接龙的高手":我唱出上一句,它接下一句,还要告诉我是哪首歌、歌手是谁、押什么韵、为什么这么接。
于是,"歌曲接龙"就诞生了。这个项目的定位非常明确:
- 一个纯粹的前端项目:不需要后端服务器,不需要数据库,不需要构建工具;
- 一个有灵魂的 AI 应用:不是简单的 ChatBot 复读机,而是有明确任务目标(接歌词)和结构化输出的智能体验;
- 一个学习价值拉满的工程:从 HTTP 请求、SSE 流式解析、JSON 数据处理,到 DOM 渲染、动画效果、响应式布局,几乎覆盖了前端开发的全部基础知识点。
在接下来的文章里,我会完整地记录这个项目的诞生过程:从 API 的调研与对接、Python 参考代码到 JavaScript 的"翻译"、系统提示词的精妙设计、前端流式渲染的实现,到最后的测试与优化。这篇文章既是对我自己的总结,也希望给正在学习前端开发或 AI 应用开发的同学一些启发。
二、技术的起点:读懂一个 OpenAI 兼容的接口
任何 AI 应用的第一步,都是先搞清楚你要调用的是什么接口。我们这次使用的是 GitCode 提供的 AI 对话服务,它的地址是:
https://api-ai.gitcode.com/v1/chat/completions
这是一个典型的 OpenAI 兼容格式 的接口。说"兼容",意味着接口的请求体、响应体、错误格式,都尽量向 OpenAI 的官方协议看齐。这对开发者来说是一个巨大的利好——因为这意味着你在任何教程里学到的 OpenAI SDK 用法、代码示例,稍微改改就能用到它上面。
2.1 请求体里有什么
调用这个接口,我们需要告诉它四件事:
第一,用哪个模型。我们使用 deepseek-ai/DeepSeek-V4-Flash,这是一个性价比很高的模型。注意模型名的写法是"厂商/模型名"的格式,这是平台对模型的一种组织方式。
第二,对话的上下文。通过 messages 字段传递一个消息数组。数组里每个元素有两个关键字段:role(角色)和 content(内容)。角色有三种:system(系统提示词,定义 AI 的人设和行为准则)、user(用户说的话)、assistant(AI 的回答)。在多轮对话中,这个数组会越来越长,保存着整个对话的历史。
第三,生成的参数。包括:
max_tokens:最大生成长度。我们不希望 AI 写一篇论文出来,2048 就够用了;temperature:温度,控制随机性。0.6 是一个比较平衡的值,既不会太死板,也不会太飘;top_p:核采样参数,0.95 是常见的默认值;frequency_penalty:重复惩罚,设置为 0 表示不额外惩罚;thinking_budget:思考预算。这个参数很有特色,相当于让模型"多想一会儿再回答",对于接歌词这种需要创作的任务很有帮助。
第四,是否流式返回。stream: true 表示开启流式输出(SSE 协议),AI 生成的文字会像打字机一样一个字一个字地吐出来。
2.2 响应的结构
当你关闭流式(stream: false),响应体是一个完整的 JSON,核心部分在 choices[0].message.content,里面就是 AI 的完整回答。
当开启流式时,响应就变成了若干行 SSE 数据。每一行都以 data: 开头,后面跟着一个 JSON 片段。形如:
data: {"choices":[{"delta":{"content":"我"}}]}
data: {"choices":[{"delta":{"content":"们"}}]}
data: [DONE]
我们可以从 choices[0].delta.content 里取出每一条增量内容,然后把它们拼起来,就是完整的回答。当收到 data: [DONE] 时,说明回答结束了。
三、把 Python 参考代码"翻译"成 JavaScript
拿到接口之后,官方给了一段 Python 的参考代码。它是这个项目最初的"种子":
import os
import requests
import json

API_URL = "https://api-ai.gitcode.com/v1/chat/completions"
headers = {
    "Authorization": f"Bearer {os.environ.get('GITCODE_API_KEY')}",
}

def query(payload):
    response = requests.post(API_URL, headers=headers, json=payload, stream=True)
    for line in response.iter_lines():
        if not line.startswith(b"data:"):
            continue
        if line.strip() in (b"data:[DONE]", b"data: [DONE]"):
            return
        yield json.loads(line.decode("utf-8").lstrip("data:").rstrip("/n"))

chunks = query({
    "model": "deepseek-ai/DeepSeek-V4-Flash",
    "messages": [{"role": "user", "content": "你好"}],
    "stream": True,
    "max_tokens": 2048,
    "temperature": 0.6,
    "top_p": 0.95,
    "frequency_penalty": 0,
    "thinking_budget": 2048
})

for chunk in chunks:
    print(chunk["choices"])
这段代码非常优雅地展示了流式对话的完整流程。但问题是:我们的项目是纯前端的,要用 JavaScript 实现同样的功能。这就涉及到几个关键的技术挑战:
3.1 挑战一:发起请求的方式完全不同
Python 用的是 requests 库的 post 方法,一个函数搞定。而 JavaScript 在浏览器里用的是 fetch API:
const response = await fetch(CONFIG.API_URL, {
  method: "POST",
  headers: {
    "Content-Type": "application/json",
    "Authorization": `Bearer ${CONFIG.API_KEY}`,
  },
  body: JSON.stringify(body),
});
两者有本质的区别:requests 是同步/阻塞的(或通过迭代器惰性处理),而 fetch 返回一个 Promise,必须用 await 来处理异步。这种异步模型是 JavaScript 最大的特点,也是很多从 Python 转过来的开发者最需要适应的地方。
3.2 挑战二:流式数据的读取方式完全不同
这是最核心的难点。Python 的 iter_lines() 会帮我们自动把响应按行拆分,我们只需要处理每一行。而 JavaScript 拿到的是一个 ReadableStream,我们必须手动处理字节流和数据缓冲:
const reader = response.body.getReader();
const decoder = new TextDecoder("utf-8");
let buffer = "";

while (true) {
  const { done, value } = await reader.read();
  if (done) break;
  buffer += decoder.decode(value, { stream: true });

  let newlineIndex;
  while ((newlineIndex = buffer.indexOf("\n")) !== -1) {
    const line = buffer.slice(0, newlineIndex).trim();
    buffer = buffer.slice(newlineIndex + 1);
    // ... 处理这一行
  }
}
这里有三个细节值得注意:
细节一:为什么要用 TextDecoder? 因为网络传输过来的是原始的二进制字节,我们必须用 TextDecoder('utf-8') 把它解码成字符串。而且要注意 decoder.decode(value, { stream: true }) 这第二个参数——它告诉解码器"数据还没完,先别急着判断截断的字符"。因为在流式传输中,一个多字节的 UTF-8 字符(比如中文"你"占 3 个字节)可能被拆成两段送到浏览器,如果不用 stream: true,第一段就会解码出错。
细节二:为什么要维护一个 buffer? reader.read() 每次返回的 value 并不一定是完整的一行。可能这一块数据里包含了三行半,也有可能半行都没有。所以我们必须自己维护一个缓冲区,把收到的数据先拼进去,然后按 \n 逐行切分。切分剩下的半行,留在 buffer 里等下一次数据到达后再处理。
细节三:Python 清洗和 JS 清洗的差异。 在 Python 里,line.lstrip("data:").rstrip("/n") 是一句很简洁的清洗逻辑。在 JavaScript 里,我选择先 line.startsWith("data:") 判断前缀,再 line.slice(5).trim() 取出数据。这个方式更显式、更不容易出错。
3.3 挑战三:处理结束标记
Python 代码用 line.strip() == b"data:[DONE]"(注意它同时兼容了有空格和没空格的情况)来判断流式响应结束。在 JavaScript 里,我们同样需要判断 [DONE]:
const data = line.slice(5).trim();
if (data === "[DONE]") return;
这个判定必须在 JSON.parse 之前做,因为 [DONE] 本身不是合法的 JSON。
3.4 挑战四:错误处理
Python 代码里没有写异常处理,但作为工程化的前端项目,我们必须考虑。我们的实现里,首先检查 response.ok,如果请求失败(比如 API Key 无效、触发了限流、网络断开),会抛出带着状态码和错误信息的异常:
if (!response.ok) {
  const errText = await response.text().catch(() => "");
  throw new Error(`HTTP ${response.status}: ${errText || "请求失败"}`);
}
前端捕获到这个异常后,会在聊天界面显示一个红色的错误气泡,让用户明确知道发生了什么。
四、系统提示词的艺术:让 AI 输出结构化的 JSON
这是整个项目设计中最妙的一环。普通的 AI 应用会让 AI 自由发挥输出文字,但我们的需求是:前端要拿到结构化的数据,并且要美观地展示出来。怎么办?答案是:用系统提示词(System Prompt)约束 AI 的输出格式。
4.1 为什么需要 JSON 格式
想想看,如果我们让 AI 自由发挥,它的回答可能是这样的:
“你唱的是《错位时空》里的’我吹过你吹过的晚风’,这首歌是艾辰唱的。下一句歌词是’那我们算不算相拥’,尾字’风’和’拥’押上了韵,因为风的拼音是 fēng,拥是 yōng,eng 和 ong 通押……”
这段文字信息其实很全,但前端要从中解析出"歌名"“歌手”“下一句”"押韵说明"这些字段,只能靠正则匹配,非常脆弱且容易出错。
但如果用系统提示词约束 AI,让它以 JSON 格式返回:
{
  "matched": "matched",
  "song_title": "错位时空",
  "singer": "艾辰",
  "user_lyric": "我吹过你吹过的晚风",
  "next_lyric": "那我们算不算相拥",
  "rhyme": "尾字:风(fēng) - 拥(yōng),eng/ong 通押",
  "explanation": "直接引用原曲的下一句,自然衔接。"
}
前端就能拿到结构完全一致的数据,直接渲染成漂亮的卡片。这就是程序化协作的魅力:AI 负责创作的"不确定性",而格式的"确定性"由我们通过提示词来保障。
4.2 系统提示词的设计要点
我们来看项目里这段系统提示词的完整设计:
你是一位精通中文流行歌曲的"歌曲接龙"大师。用户会给你一句歌词,你需要接出下一句歌词,
并按照严格的 JSON 格式返回接龙结果,禁止输出任何 JSON 以外的内容。

接龙规则:
1. 如果用户给出的歌词能匹配到真实存在的歌曲,必须优先使用该歌曲原版的下一句歌词。
2. 如果匹配不到原曲,或原曲前后句不押韵,可以创作一句押韵的新歌词来接龙,并如实标注为"创作"。
3. 输出的下一句必须与上一句在内容、情感和韵律上自然衔接。
4. 一律使用简体中文回复。

返回格式:
{
  "matched": "matched | created",
  "song_title": "匹配到的歌曲名,若为创作则填写'即兴创作'",
  "singer": "歌手名",
  "user_lyric": "用户给出的上一句歌词",
  "next_lyric": "接龙的下一句歌词",
  "rhyme": "押韵说明",
  "explanation": "一句话说明接龙思路"
}
这个提示词的价值在于几个细节:
第一,“禁止输出任何 JSON 以外的内容”。 这句话至关重要。没有这句约束,AI 很可能在 JSON 前后加上"好的,这是你要的答案:"之类的废话,或者用 markdown 代码块包裹,导致前端解析失败。
第二,“匹配到原曲就优先用原曲下句”。 这保证了大部分时候结果是有"出处"的,有真实感和说服力。用户说出周杰伦的歌词,AI 如果能接出周杰伦真正的下句,体验远超"随便编一句"。
第三,明确的字段说明。 每个字段都有清晰的语义和取值约定(比如 matched 只有 matched 和 created 两种值),AI 就不会自由发挥出第三种类别。
4.3 前端如何兜底:宽容的 JSON 提取器
虽然提示词已经很严格了,但大型语言模型毕竟不是形式化的 API——它偶尔可能还是会把 JSON 包在 ```json 代码块里,或者在前置文本中多说两句。为了工程的健壮性,我在前端写了一个"宽容的 JSON 提取器":
function extractJson(raw) {
  let text = raw.trim();
  const fence = text.match(/```(?:json)?\s*([\s\S]*?)```/);
  if (fence) text = fence[1].trim();
  const start = text.indexOf("{");
  const end = text.lastIndexOf("}");
  if (start === -1 || end === -1 || end <= start) return null;
  try {
    return JSON.parse(text.slice(start, end + 1));
  } catch {
    return null;
  }
}
这个函数做了三件事:
- 如果文本被 markdown 代码块包裹,先剥掉围栏;
- 找到第一个
{和最后一个},把中间内容截取出来(不怕 AI 在前后说废话); - 尝试 JSON.parse,失败返回 null,绝不把异常抛给上层。
这种"我尽力解析,但解析不了就返回 null"的思路,是真实工程里和 AI 协作的标准姿势——永远不要假设 AI 的输出是完美的。
五、实时渲染:把流式输出变成"打字机效果"
接了流式接口之后,一个很自然的想法就是:让 AI 的回答像真人打字一样,一个字一个字地显示出来。这样用户等待的焦虑感会大大降低,体验也会生动很多。这就是 SSE(Server-Sent Events)最迷人的地方。
5.1 流式渲染的实现
我们的 sendLyric 函数接收到流式的增量内容后,会有两步渲染:
第一步,在 AI 消息气泡里放一个 stream-text 的容器,把收到的原始文本实时 append 进去。用户会看到 AI 正在"思考并打字"。
第二步(也是更聪明的一步),在每一次拿到增量后,立即尝试 extractJson 解析当前累积的全部文本。只要 JSON 一旦能解析成功,就立刻把纯文本替换成精美的卡片。这意味着用户可能看到的是一个渐变出现的卡片效果——标题、歌词、押韵说明逐项"长"出来。
await streamChat(SYSTEM_PROMPT, text, (delta) => {
  raw += delta;
  streamHolder.textContent = raw;
  const parsed = extractJson(raw);
  if (parsed && parsed.next_lyric) {
    typingBubble.innerHTML = "";
    typingBubble.appendChild(buildSongCard(parsed));
  }
  scrollToBottom();
});
这个设计还有一个优雅的降级策略:如果流结束后 JSON 依然解析不出来(极少数情况),就把累积的原始文本直接显示出来,保证用户至少能看到 AI 的回答。
5.2 模拟"正在思考"的打字动画
在 AI 开始回复之前、第一行数据还未到达的时候,我们展示一个三个小圆点跳跃的打字动画:
<div class="typing"><span></span><span></span><span></span></div>
配合 CSS 的 keyframes 动画:
@keyframes bounce {
  0%, 60%, 100% { transform: translateY(0); opacity: 0.5; }
  30% { transform: translateY(-6px); opacity: 1; }
}
三个点分别设置不同的 animation-delay(0s、0.2s、0.4s),就形成了依次跳动的节奏感。这个细节虽然小,但让整个交互"活"了起来。
六、把数据变成精美的卡片:前端渲染的艺术
拿到 JSON 数据之后,前端要做的事情就是把结构化数据渲染成好看的 UI。回忆一下我们的数据结构:song_title(歌名)、singer(歌手)、user_lyric(用户歌词)、next_lyric(AI 歌词)、rhyme(押韵)、explanation(解释),还有一个 matched 状态表示是"原曲接龙"还是"即兴创作"。
6.1 卡片的分层设计
我把卡片设计成这几个区块:
- 头部区:左侧一个徽章(Badge)标记类型——绿色"原曲接龙"或黄色"即兴创作";中间是醒目的歌名,下方小字写着歌手;
- 歌词区:上方是用户出的上句(“🎤 你出的上句”),用一条虚线分隔,下方是 AI 接的下句(“🤖 AI 接的下句”),下句用一个更亮眼的暖金色显示,并带有柔和的文字光晕,突出"这是 AI 的创作成果";
- 元信息区:一个胶囊样式的 Chip,展示押韵说明;
- 思路区:最下方一个左边带蓝色竖线的圆角区块,展示 AI 的接龙思路,给整个交互一个"有温度"的收尾。
值得强调的是 matched 状态的双态设计。上面的徽章根据 isMatched 变量切换两类样式:命中原曲时是绿色调"原曲接龙",否则是黄色调"即兴创作"。这让用户一眼就能识别 AI 回答的性质——是"查出来的真实歌词"还是"现场编的押韵句",透明且可信。
6.2 动态构建 DOM 而不是拼接字符串
可能有人会问:为什么卡片不直接用模板字符串 innerHTML += 拼出来?因为前端渲染有个安全红线叫 XSS(跨站脚本攻击)。用户输入的歌词字符可能包含 <script>、<img onerror> 等恶意内容,如果直接拼进 HTML,就会执行恶意脚本。
所以我在构建卡片时采用了两个策略:
- 优先使用
document.createElement和textContent来构建文本节点(textContent 天然不会解析 HTML); - 对必须用
innerHTML的歌词内容,先经过一个escapeHtml函数转义:
function escapeHtml(str) {
return String(str)
.replace(/&/g, "&")
.replace(/</g, "<")
.replace(/>/g, ">")
.replace(/"/g, """);
}
作为开发者,把用户输入当作不可信数据、永远不信任它,是刻在骨子里的安全意识。
七、UI 设计:让"歌曲接龙"有音乐的氛围感
聊完了功能,我们再来聊聊视觉。这是一个音乐相关的产品,所以我希望它的视觉语言带有舞台感、霓虹感、氛围感。
7.1 配色:午夜霓虹渐变色
主背景是一个三段式的渐变:
background: linear-gradient(135deg, #0f0c29, #302b63, #24243e);
从深蓝紫到青紫,这个配色让我联想到演唱会暗场后的舞台灯光。主强调色是玫粉色 #ff6b9d(对应"音乐的热情与浪漫"),辅助强调色是天空蓝 #6b9dff(对应"科技与理性"),一暖一冷,形成悦目的对比。
7.2 玻璃拟态(Glassmorphism)
整个应用外壳是个带透明度的卡片:
background: rgba(15, 12, 41, 0.55);
border: 1px solid rgba(255, 255, 255, 0.12);
backdrop-filter: blur(18px);
border-radius: 24px;
半透明材质 + 背景模糊 + 细腻描边 + 大圆角,这就是近几年流行的"玻璃拟态"设计。它让卡片像一块磨砂玻璃悬浮在渐变背景上,层次感一下子就出来了。
7.3 微交互与动效
细节决定体验。我在几个关键位置点缀了动效:
- 发送按钮 hover 时上浮 2px 并加大光晕;
- 空状态的大麦克风图标 🎤 有缓慢的上下漂浮动画;
- 新消息滑入时有一个
slideIn弹性动画; - 状态小圆点在 AI 忙碌时会呼吸闪烁(黄色),空闲时是常亮的绿色。
7.4 响应式:手机上也一样好看
通过媒体查询,在宽度小于 520px 时切换为全屏模式(去掉圆角和内边距,占满整个视口),并放宽消息气泡的最大宽度。这样就保证了在手机上这个应用也像一个真正的"聊天气泡 App"。
八、状态管理:一个 isBusy 变量怎么撑起整个交互
这个项目没有引入任何状态管理库,只有一个全局的 isBusy 布尔变量。但正是它,把整个交互的边界都管住了。
let isBusy = false;

function setBusy(busy) {
  isBusy = busy;
  sendBtn.disabled = busy;
  lyricInput.disabled = busy;
  statusDot.classList.toggle("busy", busy);
  if (!busy) lyricInput.focus();
}
思路很简单:当 AI 正在回答时(busy=true),禁掉发送按钮和输入框,防止用户连点产生并发请求;同时把状态小圆点切到"忙碌"呼吸态。AI 回答完(busy=false),按钮恢复,输入框自动重新获得焦点,让用户可以直接敲下一条。
一个变量的状态管理看似简陋,但对于这种"同一时刻最多一个请求"的应用,它反而是最简单可靠的方案。选择合适复杂度的方案,是每个开发者都应该学会的功课。
九、完整的功能闭环:从输入到渲染的全流程
让我们把 sendLyric 的完整流程串起来,看看一次"歌曲接龙"从用户输入到页面呈现,到底经历了什么:
- 用户点击发送按钮或按下回车;
- 函数校验输入非空、且当前无进行中的请求;
- 把用户的歌词渲染成右侧的蓝色气泡,清空输入框;
- 调用
setBusy(true),界面进入忙碌态; - 在 AI 侧添加一个"打字中"气泡(三个跳动的小圆点);
- 调用
streamChat建立 SSE 流式请求,实时拿到 AI 的增量文本; - 增量文本实时追加显示;同时持续尝试解析 JSON;
- 一旦 JSON 解析成功(且包含有效的
next_lyric),把打字气泡替换成完整卡片; - 流结束,再做一次最终 JSON 解析作为兜底;
setBusy(false)恢复界面,输入框重新聚焦,滚动条自动滚到底。
这个闭环麻雀虽小,五脏俱全,它包含了前端开发中最重要的几个概念:事件驱动、异步并发控制、流式数据处理、DOM 渲染、错误处理、状态管理。
十、真实测试记录:当 AI 真的接上了《错位时空》
写代码只是开始,真正让我兴奋的是测试环节。我准备了一个测试脚本,用真实 API 跑了一遍流式对话,输入歌词"我吹过你吹过的晚风",看看 AI 会怎么接。
结果令人惊喜,AI 的完整流式输出是一个完全合法的 JSON:
{
  "matched": "matched",
  "song_title": "错位时空",
  "singer": "艾辰",
  "user_lyric": "我吹过你吹过的晚风",
  "next_lyric": "那我们算不算相拥",
  "rhyme": "尾字:风(fēng) - 拥(yōng),eng/ong 通押,韵律和谐",
  "explanation": "直接引用原曲《错位时空》的下一句,自然衔接并延续对时空交错情感的追问。"
}
这个测试结果证明了几个关键点:
第一,指令遵循能力过关。 AI 严格按 JSON 格式输出,没有夹带任何多余文字,字段名、取值都符合我们的约定,matched 正确地用了 matched 而不是自己造一个词。
第二,知识库真实有效。 "我吹过你吹过的晚风"确实是《错位时空》的歌词,而"那我们算不算相拥"正是它的下一句。AI 的歌曲知识库是真实可用的,不是凭空编造。
第三,韵律说明专业。 它能准确指出"风"(fēng) 和"拥"(yōng) 构成 eng/ong 通押——这是汉语音韵学中"通押"的用法,说明模型对韵脚的理解是准确的。
这个测试让我对这个项目的实际效果彻底放了心。
十一、工程细节与踩坑记录
开发过程中自然少不了一些"坑",这些坑每一条都是宝贵的经验。我记录下来,与大家共勉:
11.1 坑一:SSE 行内可能有空格
参考代码里同时判断了 data:[DONE] 和 data: [DONE] 两种格式(有空格与无空格),说明实际服务端返回时,冒号后的空格是不稳定的。我采用 line.slice(5).trim() 先切掉前缀再 trim,一劳永逸地解决了这个问题。
11.2 坑二:一个中文可能被拆在两次 read 中
这是流式解析最容易踩的坑。如果 TextDecoder 不指定 stream: true,当中文字符的字节被切开时,解码器会直接报错。指定了 stream: true 后,解码器会自己记住未完成的字节序列,自然衔接下一次解码。
11.3 坑三:跨域问题(CORS)
api-ai.gitcode.com 和我们部署的前端地址不是同源,浏览器会发起跨域请求。好在这个接口服务端已经配置了 CORS 头,fetch 可以直接调用。如果哪天遇到"Access-Control-Allow-Origin"报错,就说明服务端没有放开跨域,那时候就需要通过后端代理来规避了。
11.4 坑四:不要连续点击发送
用户快速连点发送按钮,理论上会同时发起多个 SSE 连接,既浪费 token 又打乱 UI 状态。通过 isBusy 标志 + 禁用按钮,从根源上杜绝了这个并发问题。
11.5 坑五:API Key 的暴露问题
API Key 直接写在 app.js 里,这是纯前端项目的"天然缺陷"。任何打开浏览器控制台的人都能看到它。虽然教学项目为了方便测试可以这么做,但真实的生产环境必须把 Key 放到后端,前端通过自己的后端接口转发请求。这一点我在 README 中也特别强调了。
十二、项目结构设计与代码组织
最后来看看整个项目的最终结构:
song-chain/
├── index.html          # 页面骨架:头部、聊天区、输入栏
├── css/
│   └── style.css       # 全部样式:配色、卡片、动画、响应式
├── js/
│   └── app.js          # 全部逻辑:config、SSE 流式、JSON 解析、DOM 渲染
└── README.md           # 项目说明文档
我刻意保持了简单的结构:一个 HTML、一个 CSS、一个 JS。对初学者来说,这种"三件套"的结构最容易理解,每个文件各司其职,没有过度设计。在项目不大时过度工程化,是比功能缺失更常见的问题。
代码组织上,app.js 内部也有清晰的层次:
- 顶层
CONFIG配置对象(API 地址、Key、模型、参数)——改配置不用翻代码; streamChat、extractJson等纯函数——不依赖 DOM,可以独立测试;buildSongCard、escapeHtml、addMsg等渲染函数——专注 DOM;- 底部的事件绑定和入口逻辑——保持清晰。
这种"数据层/逻辑层/视图层"的朴素分层,让代码既好读又易维护。
十三、总结与展望
至此,"歌曲接龙"这个项目就完整地走完了从创意到上线的全过程。回顾整个开发,我最想分享的是几个心得:
第一,好的产品创意来自"AI 能力 × 用户场景"。 AI 对话类应用的想象力远不止问答机器人,"歌词接龙"就是 AI 创作能力与音乐场景碰撞出的火花。下次当你面对 AI 应用开发时,不妨多想想:AI 最擅长什么?我的用户最想要什么?两者交汇的地方,就是好产品的诞生地。
第二,结构化输出是 AI 应用的工程基石。 一句精心设计系统提示词 + 一个健壮的 JSON 提取器,就能让"不可控的大模型"输出"可控的结构化数据",这是无数 AI 应用得以落地的关键。
第三,流式体验让 AI 应用"活"起来。 SSE 流式接口加上打字机效果,把"等待"变成了"观看",从根本上改变了用户对 AI 应用的感知。
第四,永远把安全放在心上。 用户输入永远不可信,转义、校验、禁用并发,这些基础功夫做扎实了,才有资格谈更多的功能。
关于未来的拓展,我也有一些想法:
- 多轮接龙:不只接一句,而是和 AI 你一句我一句地接下去,形成完整的接龙链;
- 歌曲库扩展:接入更大的歌曲数据库,给用户看更多例句、歌词出处,甚至提供 30 秒的试听;
- 难度模式:简单模式不限韵脚,困难模式要求必须押指定韵;
- 排行榜:如果做成多人在线,可以增加接龙 PK 和排行榜,让"歌曲接龙"真正变成一款小游戏。
不管怎样,这个项目的核心已经打好:一个纯前端、零依赖、流式对话、结构化展示的 AI 应用模板。它证明了——用最基础的前端三件套,你也能做出有格调、有智能、有灵魂的 AI 产品。
感谢麦步提供了 AI 能力与平台,也感谢每一位看完这篇文章的读者。如果你也对"歌词接龙"感兴趣,欢迎给它输入一句你喜欢的歌词,看看 AI 会怎么接——说不定,它能接出一段让你起鸡皮疙瘩的旋律。
本文由 码道 创作,记录了歌曲接龙项目从 0 到 1 的完整开发历程。仓库地址:https://atomgit.com/gcw_e149KYvK/ruanjian6ban-0918

汇聚全球AI编程工具,助力开发者即刻编程。
更多推荐

 1
 0
- 0


 已为社区贡献1条内容

所有评论(0)