码道:当AI接管轮回,我用纯前端写了一个修仙模拟器
一念入道,一念成魔。诸般因果,皆由心证。
项目地址:https://atomgit.com/peioooooo/r6_9.18
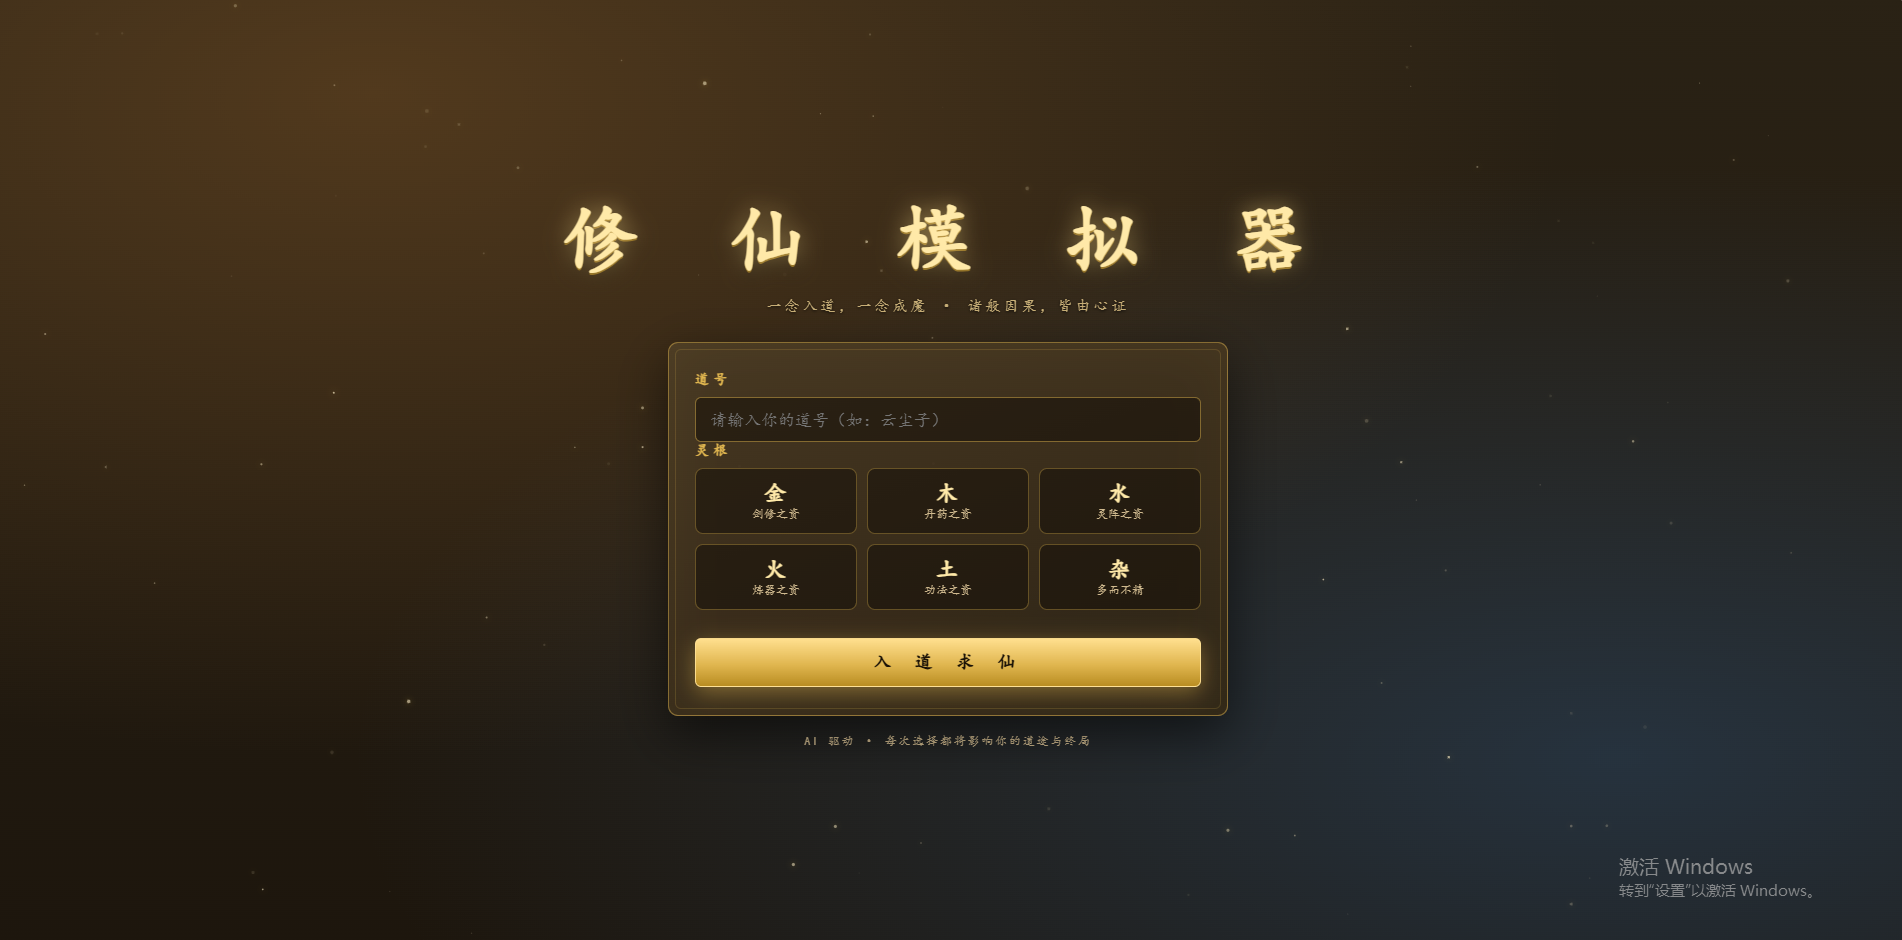
项目实例:
使用软件:
一、缘起:代码之外的另一条"道"
三个月前的一个深夜,我盯着屏幕上密密麻麻的报错日志,忽然想起小时候看过的那些修仙小说——主角被困在某个阵法里,面前摆着几条岔路,选错了就是万劫不复,选对了便是扶摇直上。那一刻我突然意识到:如今的我们,何尝不是被困在自己的"代码道"里?每一次技术选型、每一次架构决策,不都是在做一个影响深远的"选择"吗?
于是"修仙模拟器"这个念头在脑海里扎了根:为什么不把小说的叙事张力,和程序员的日常体验结合起来,做一款 AI 驱动的人生模拟游戏?让大语言模型来扮演"天道",让玩家在一次次选择中走向截然不同的结局,最后还能根据这一生的所作所为,结算经验、修为与机缘物品。
这篇文章,就想完整地记录下这个项目从灵感到落地的全过程。包括:我如何在纯前端(HTML5 + CSS3 + JavaScript)的约束下完成架构设计,如何把一段 Python 的流式 API 调用"翻译"成 JavaScript,又如何通过"系统提示词工程"让 AI 输出结构化的 JSON,从而让 HTML 页面能稳定地渲染出剧情与选项。
如果你也想过"要不要试着用 AI 接口做点有意思的事",希望这篇博客能给你一些启发。
二、需求拆解:先搞清楚"修仙"到底要模拟什么
动手写代码之前,我把脑子里模糊的想法整理成了一份需求清单。任何项目在动工之前,需求拆解都是最重要的一步,这个项目也不例外。
2.1 核心玩法
- 角色创建:玩家给自己起一个道号,并挑选一种灵根。不同灵根代表不同的修行资质与路线——金灵根适合剑修,木灵根适合丹道,水灵根适合阵法,火灵根适合炼器,土灵根适合体修,杂灵根虽然平庸,但多了"后天补足"的戏剧空间。
- 剧情推进:游戏不再使用写死的剧本树,而是由 AI 实时生成剧情。AI 根据玩家当前的境界、选择的历史行为,生成一段旁白(narrator),并给出三到四个方向不同的选项。玩家每做出一次抉择,剧情就沿着新的方向继续演化。
- 多结局系统:由于剧情是 AI 动态生成的,结局天然是开放的。飞升成仙、一代枭雄、走火入魔、老死凡尘……只要 AI 认为剧情走到了合适的终点,模拟就会结束,并给整段人生写下判词。
2.2 行为结算奖励
这是整个项目最有特色的需求:模拟结束时的奖励不是固定的,而是根据本次模拟中玩家的真实行为动态计算出来的。
换句话说:你这一世如果一直在行侠仗义、斩妖除魔,那结算时的"经验"和"修为"就高;如果碌碌无为、浑噩度日,那结算的奖励就低得可怜。AI 需要在游戏结束时回顾整段对话历史,评估出三样东西:
- exp(模拟经验):衡量玩家参与剧情、做出抉择的丰富程度,范围 0~500。
- cultivation(修为):衡量玩家在境界提升、机缘获取、苦修方面的造化,范围 0~1000。
- items(物品):把玩家在模拟中获得过的宝物、丹药、功法,在结算时以物品清单的形式返还给玩家。
这个设计让"结局面板"有了仪式感——它不是冷冰冰的 game over,而是给这一世人生盖棺定论。
2.3 技术约束
用户对这个项目提出了明确的技术要求:
- 纯前端实现:使用原生 HTML5 + CSS3 + JavaScript,不引入任何前端框架,也不要有后端服务。这意味着游戏状态、对话历史都要放在浏览器内存里,AI 接口也由浏览器直接调用(当然,这里有一个安全性的妥协,后文会专门讨论)。
- 流式输出:AI 的回答要像 ChatGPT 一样逐字流式输出,这样剧情文案一行行浮现,体验更好。
- 参考代码语言转换:用户提供了一段 Python 的流式调用代码,我需要把它等价地"翻译"成浏览器里的 JavaScript。
- JSON 数据契约:系统提示词要把"输出格式"约束为项目需要的样子,让 AI 直接返回结构化 JSON,方便 HTML 页面渲染。
需求清楚了,接下来就是技术选型。
三、技术选型:为什么死磕纯前端
也许有人会问:做个修仙模拟器,用 Vue 或 React 不香吗?为什么非要"刀耕火种"地写原生 JS?
3.1 零依赖即零负担
前端框架这些年越来越重。一个 node_modules 动辄几百兆,几天不更新就一堆依赖告警。而原生 HTML + CSS + JS 有一个不可替代的优势:打开即用,无需构建。把文件往任意静态服务器上一扔,甚至直接双击 index.html,游戏就能跑起来。这对一个分享给朋友玩的"小作品"来说,非常重要——朋友不需要 npm install,不需要起 dev server,只要一个浏览器。
3.2 项目规模适中
这个项目的核心逻辑其实就四层:调用 AI、解析 JSON、维护状态、渲染界面。单页应用的三屏结构(开场注册、游戏主界面、结局面板)用 DOM 操作完全够用,引入框架反而增加了心智负担。我始终认为,技术选型要服务于项目规模,杀鸡用牛刀并不是好习惯。
3.3 浏览器原生 API 足够强大
很多人以为流式请求必须借助第三方 SDK,其实浏览器原生的 fetch + ReadableStream 就足够胜任。这个项目就证明了:一个趣味的 AI 对话应用,在没有任何外部依赖的情况下,完全可以用几十行代码实现。
确定了大方向,接下来是整篇文章最硬核的部分——把 Python 的流式调用翻译成 JavaScript。
四、核心攻坚:Python 流式调用 → JavaScript 等价实现
用户提供的参考代码是一段典型的 Python SSE(Server-Sent Events)消费代码。我先把它完整解读一遍,再来谈翻译。
4.1 解读 Python 参考实现
import requests
import json

API_URL = "https://api-ai.gitcode.com/v1/chat/completions"
headers = {
    "Authorization": f"Bearer bLx9gTqCma8jy2q44sqzK58x",
}

def query(payload):
    response = requests.post(API_URL, headers=headers, json=payload, stream=True)
    for line in response.iter_lines():
        if not line.startswith(b"data:"):
            continue
        if line.strip() == b"data:[DONE]" or line.strip() == b"data: [DONE]":
            return
        yield json.loads(line.decode("utf-8").lstrip("data:").rstrip("/n"))
这段代码做的事情非常典型:
- 用
requests.post(..., stream=True)发起流式请求; - 用
response.iter_lines()按行迭代响应体; - 跳过不以
data:开头的行(SSE 协议里这些是注释、心跳等噪音); - 遇到
data:[DONE]或data: [DONE]就停止——这是 OpenAI 兼容协议里约定的"流结束"标记; - 其余行去掉
data:前缀,用json.loads解析成字典,通过生成器yield抛给调用方。
调用方再循环取出 chunk["choices"],也就是每个分块里的增量内容。
4.2 翻译的核心难点
把这段代码移植到浏览器,难的不是语法,而是执行模型:
- Python 的
iter_lines()是一个阻塞式的同步迭代器,天然适合逐行消费; - 浏览器的
fetch是异步的,我们需要用ReadableStream+reader.read()不断地"拉"数据块; - SSE 的分行不是在"块"级别保证的——一个网络分包可能只包含半行,所以必须自己维护一个"行缓冲",把读到的字节按
\n切分,把不完整的最后一行留到下一轮拼装。
这就是读取流式数据的"本地化改造",我在 js/api.js 里这样实现的:
const AiApi = {
  async chat(messages, onDelta) {
    const payload = {
      model: AppConfig.model,
      messages: messages,
      stream: AppConfig.stream,
      max_tokens: AppConfig.maxTokens,
      temperature: AppConfig.temperature,
      top_p: AppConfig.topP,
      frequency_penalty: AppConfig.frequencyPenalty,
      thinking_budget: AppConfig.thinkingBudget
    };

    const response = await fetch(AppConfig.apiUrl, {
      method: "POST",
      headers: {
        "Content-Type": "application/json",
        "Authorization": `Bearer ${AppConfig.apiKey}`
      },
      body: JSON.stringify(payload)
    });

    if (!response.ok) {
      const errText = await response.text().catch(() => "");
      throw new Error(`接口返回 ${response.status}: ${errText || response.statusText}`);
    }

    const reader = response.body.getReader();
    const decoder = new TextDecoder("utf-8");
    let buffer = "";
    let fullText = "";

    while (true) {
      const { done, value } = await reader.read();
      if (done) break;

      buffer += decoder.decode(value, { stream: true });
      const lines = buffer.split("\n");
      buffer = lines.pop();

      for (const line of lines) {
        const trimmed = line.trim();
        if (!trimmed.startsWith("data:")) continue;
        const data = trimmed.replace(/^data:\s*/, "");
        if (data === "[DONE]") return fullText;
        try {
          const chunk = JSON.parse(data);
          const delta = chunk.choices?.[0]?.delta?.content || "";
          if (delta) {
            fullText += delta;
            if (typeof onDelta === "function") onDelta(delta);
          }
        } catch (e) {
          // 忽略无法解析的行(如 keep-alive)
        }
      }
    }
    return fullText;
  }
};
逐行对照一下,就能看出两种语言的"等价关系":
| 原 Python 实现 | JavaScript 等价实现 |
|---|---|
requests.post(..., stream=True) | fetch(url, { method, headers, body }) |
response.iter_lines() | reader.read() 分块读取 + split("\n") 行缓冲 |
line.startswith(b"data:") 过滤 | trimmed.startsWith("data:") |
data:[DONE] 终止并 return | 同逻辑判断后 return fullText |
json.loads(...) 解析每行 | JSON.parse(data) 解析每行 |
chunk["choices"] 取增量 | chunk.choices?.[0]?.delta?.content(可选链更安全) |
值得一提的细节:
- TextDecoder 的
{ stream: true }:应对多字节 UTF-8 字符被网络分包"劈开"的情况,保证中文不乱码。 buffer = lines.pop():每次只处理完整行,把残留的半行留到下一轮,这是 SSE 解析的经典套路。chunk.choices?.[0]?.delta?.content:用可选链(Optional Chaining)逐层取增量内容。因为有些分块(比如空转的 keep-alive)并没有content字段,直接访问会抛错。
至此,Python 到 JavaScript 的"翻译"完成。API 层打通之后,真正的难点来了——如何让 AI 输出的内容变得"可用"。
五、系统提示词工程:让 AI 乖乖吐 JSON
如果说 API 调用是"血管",那系统提示词就是"灵魂"。直接让 AI 输出一段散文,页面只能把它整个展示出来,完全没法渲染成选项按钮,也没法做状态结算。
所以我认认真真地设计了一份"数据契约"——在系统提示词里,明确规定 AI 每次只能输出一个合法的 JSON 对象,并且区分两种形态。
5.1 为什么选 JSON 而不是让 AI 自己发挥
有几种方案可以实现"AI 驱动选项":
- 方案 A:正则瞎猜。让 AI 输出 Markdown 列表,前端再解析。缺点是格式不稳定,AI 心情一好多写两句前言就全毁了。
- 方案 B:两步调用。先让 AI 生成剧情,再让它单独生成选项。缺点是多一次网络往返,慢,还贵。
- 方案 C:JSON 数据契约。在系统提示词里把"只能输出 JSON"写死,并给出明确的字段语义。前端拿到 JSON 后直接驱动渲染。这是最稳定、最高效的方案。
我选择了方案 C,这也是用户需求里点名的方向:“将系统提示词改成本项目所需要的 json 数据返回格式”。
5.2 进行中形态的契约设计
游戏还没结束时,AI 应该输出这样的结构:
{
  "done": false,
  "narrator": "烟雨朦胧,青云宗山门前……",
  "gains": { "cultivation": 8, "items": ["培元丹"] },
  "options": [
    { "id": "A", "text": "上前叩门拜师", "hint": "得正统传承" },
    { "id": "B", "text": "转身离去做散修", "hint": "自由却飘零" },
    { "id": "C", "text": "山门前打坐三日", "hint": "心性考验" }
  ]
}
字段语义:
done: false:告诉前端"模拟还没结束,去渲染选项";narrator:场景旁白,前端用打字机效果逐字显示;gains:本次事件立刻获得的修为增量与物品,前端会把它累加到状态栏;options:3~4 个选项,每个选项带text(按钮文案)和hint(悬停时显示的风险暗示)。
为了让 AI 的表现稳定,我在提示词里写了几条"行为守则":
- 选项方向要彼此不同(求稳、冒险、行善、作恶、闭关……);
- 每 1~3 回合必须推进一次明显的时间或地点变化,保持叙事节奏;
- 收益与代价要合理,不能凭空开挂。
5.3 结束时形态的契约设计
当 AI 判定剧情走到终点,就切换成"结算模式":
{
  "done": true,
  "narrator": "百年一晃,你终究未能叩开仙门……",
  "ending": {
    "title": "凡尘一梦",
    "type": "老死凡尘",
    "desc": "你于剑峰之下结庐而居,收徒传艺,终老山中。"
  },
  "rewards": {
    "exp": 88,
    "cultivation": 12,
    "items": ["青锋剑"]
  },
  "summary": "心性尚可,机缘未至。"
}
这里最关键的是 rewards 字段——它直接呼应了"行为结算"的产品需求。为了让奖励"诚实",我在提示词里特别强调了三条规则:
exp是"模拟经验",范围 0~500,根据玩家参与剧情、做出抉择的丰富程度评定;cultivation是"修为",范围 0~1000,根据境界成就、机缘、苦修给予;- 三项奖励必须诚实依据本局真实行为生成,碌碌无为者奖励应极低。
这三条规则把"AI 自由发挥"限制成了"有纪律的评判",保证了游戏的公平感和仪式感。
5.4 容错:AI 不听话怎么办
再严的提示词也会遇到 AI"叛逆"的时刻。模型偶尔会输出 ```````json ````代码块包裹,偶尔会先说一句"好的,天道为你推演:"再吐 JSON,偶尔干脆输出纯文本。对于这些情况,我写了一个非常务实的容错解析函数:
function extractJSON(text) {
  try {
    const cleaned = text
      .replace(/^```(?:json)?\s*/i, "")
      .replace(/```\s*$/, "")
      .trim();
    const start = cleaned.indexOf("{");
    const end = cleaned.lastIndexOf("}");
    if (start === -1 || end === -1) throw new Error("no json braces");
    return JSON.parse(cleaned.slice(start, end + 1));
  } catch (e) {
    return null;
  }
}
它只做三件事:
- 剥掉常见的 ``````json ```代码块标记;
- 找到第一个
{和最后一个},截取出 JSON 主体——这能容忍 AI 前后夹杂的任何废话; JSON.parse一旦失败就返回null,交给上层做降级处理。
而"上层降级"在 game.js 里也很干脆:解析失败就把原文整段展示给玩家,同时渲染一个"继续推演(重试)"按钮,保证流程永远不会卡死。
六、前端架构:三屏结构 + 打字机 + 星空
6.1 单页三屏设计
整个页面被我切成了三个 <section>,通过 CSS 的 opacity 与 pointer-events 实现切换,避免传统"跳页"的白屏闪烁:
#screen-setup:开场屏。居中展示游戏大标题、道号输入框、灵根选择网格、入道按钮;#screen-game:游戏主界面。顶部是六格状态栏,中间是剧情滚动区,底部是选项按钮区,右上角是"天道推演中"的加载指示;#screen-ending:结局屏。展示结局名、结局类型徽章、结局描述,以及一个"本次模拟所得"的奖励清单,最后是"再入轮回"按钮。
三个屏在同一棵 DOM 树里,切换只是改一个 active class,逻辑极简。
6.2 状态栏:让"道行"看得见
游戏主界面的顶部,我放了一条六格状态栏。它绑定着 Game.player 对象里的六个字段:
境界 | 修为 | 年龄 | 寿元 | 灵石 | 法宝·丹药
- 境界:由"修为"数值映射出来的九阶体系(炼气 → 筑基 → 金丹 → 元婴 → 化神 → 渡劫 → 大乘 → 飞升);
- 修为:一个不断累加的数值,AI 每次回传的
gains.cultivation都会加到这里; - 年龄 / 寿元:体现"人生"的流逝感;
- 灵石:游戏内的通用货币;
- 法宝·丹药:玩家获得的物品清单,动态拼接显示。
境界映射用了一个很朴素的"对照表":
evolveRealm() {
  const c = this.player.cultivation;
  const table = [
    [0, "炼气一层"], [10, "炼气三层"], [30, "炼气六层"], [60, "炼气巅峰"],
    [100, "筑基初期"], [160, "筑基中期"], [240, "筑基后期"],
    [340, "金丹初期"], [470, "金丹中期"], [630, "元婴初期"],
    [820, "化神初期"], [1050, "渡劫期"], [1400, "大乘期"], [1800, "飞升成仙"]
  ];
  let realm = table[0][1];
  for (const [need, name] of table) {
    if (c >= need) realm = name;
  }
  this.player.realm = realm;
}
这套映射是"演示级"的,保证玩家每走几步就能看到境界肉眼可见地提升,获得即时的正向反馈。
6.3 打字机效果:让文字自己"长"出来
流式输出是技术能力,但打字机是体验设计。我把两者结合:AI 的流式增量先进入一个"流式预览"消息,等整段收完后,再提炼出 narrator,切换成"打字机模式"逐字渲染。
打字机实现不复杂,但有一个容易被忽略的细节:末尾光标。在逐字渲染时,先插入一个 cursor 的闪烁光标 span,每渲染一个字符,就把字符插到光标之前;全部完成后移除光标。这样玩家能清楚地感受到"这段文字正在被写出来"。
typewriter(el, text, done) {
  let i = 0;
  el.textContent = "";
  const cursor = document.createElement("span");
  cursor.className = "cursor";
  el.appendChild(cursor);
  const tick = () => {
    if (i < text.length) {
      el.insertBefore(document.createTextNode(text[i]), cursor);
      i++;
      this.scrollBottom();
      setTimeout(tick, 14);
    } else {
      cursor.remove();
      if (done) done();
    }
  };
  tick();
}
6.4 星空粒子背景:氛围感全靠 canvas
为了营造"渺渺仙途,星河为伴"的氛围,我用原生 canvas 画了一层飘动的星光粒子。每一帧,粒子在正弦函数的驱动下明暗闪烁,配合黑金配色的星际渐变,页面瞬间就有了"修仙"的味道。
代码不复杂:90 颗随机分布的星点,每颗拥有自己的半径、基础透明度、闪烁频率和相位,requestAnimationFrame 循环重绘。这对性能压力几乎可以忽略,但视觉收益非常可观。
七、游戏主循环:回合是如何流转的
前端架构搭好后,最重要的一环是"游戏主循环"——即每一次玩家选择如何变成一次 AI 调用,再变成界面更新。我把这个流程叫做"一次回合",用一张时序图可以讲清楚:
玩家点击选项
   │
   ▼
┌─────────────────────────────────────────────┐
│ 1. UI:隐藏旧选项,显示玩家抉择气泡          │
│ 2. Game:把选项文本 push 进对话历史          │
│    (messages: [...历史, {role:user, ...}])│
│ 3. Game:调用 buildMessages 组装完整消息     │
│    (system 提示词 + 全部历史)              │
│ 4. AI:流式返回剧情 JSON                     │
│ 5. UI:打字机渲染 narrator / 状态栏更新      │
│ 6. Game:extractJSON 解析                    │
│    ├─ done=false → 渲染新选项,等待下一回合  │
│    └─ done=true  → 进入结算流程,展示结局    │
└─────────────────────────────────────────────┘
整个循环由 Game.playTurn(userText) 驱动,核心代码只有几十行,但把"状态、界面、AI、状态"四个环节串得干干净净。
另有一个关键细节:对话历史是全量携带的。因为 AI 需要依据"这一生的所有行为"来结算奖励,所以历史里的每个 user / assistant 消息都被完整保留,直到游戏结束。这也是"行为结算"能够成立的技术前提。
八、结算系统:给这一世盖棺定论
当 AI 返回 done: true 时,游戏进入结算阶段。前端做三件事:
- 剧情收尾:把
narrator以打字机效果展示完,给玩家读完最后一段判词的"仪式时间"; - 渲染结局:切换到最后屏,展示结局标题、结局类型徽章(仙途飞升 / 身死道消 / 老死凡尘 / 魔道枭雄 / 逍遥人间),以及结局描述;
- 展示奖励:把 AI 结算的
exp、cultivation、items渲染成一张"本次模拟所得"清单,再配一条一句话复盘summary。
结算面板的渲染我专门做了防御处理:rewards 里的数值用 Math.max(0, Math.floor(...)) 保证非负整数;items 用 Array.isArray 校验,避免 AI 偶尔返回 null 导致渲染崩溃。
值得一提的是,这套"行为 → 奖励"的闭环,在传统的剧本树游戏里几乎无法实现——因为传统游戏的奖励是作者预先写死的,而这里,奖励的"裁判"是 AI,它亲自看着玩家走完了这一生。这是 AI 游戏最有魅力的地方之一。
九、测试与调试:小项目也要认真验证
虽然是个"小作品",我依然做了比较完整的验证,毕竟 AI 相关的东西不确定性最大。
9.1 静态语法检查
所有 JS 文件先过 node --check,确保没有任何语法错误。这是最低门槛。
9.2 接口连通性测试
用 Node 直接对这个 GitCode AI 接口发一个最小请求,确认 endpoint、鉴权方式、请求体格式都是可用的。这一步非常重要——很多人卡在"代码写好了但接口调不通",大概率是请求体字段名对不上。
9.3 JSON 契约单测
我把"完美 JSON"“夹杂废话的 JSON”"代码块包裹的 JSON"三种输入喂给 extractJSON,确认都能正确解析出对象。这种"输入-契约"级别的测试,比跑通一整局游戏更省时间也更可靠。
9.4 端到端冒烟测试
我用无头浏览器(Playwright)自动跑了完整游戏流程:输入道号 → 选择灵根 → 开始游戏 → 等待 AI 返回 → 点击选项 → 连续推进数个回合 → 检查修为数值正确累加、物品正确累计 → 进入结局 → 点击"再入轮回"回到开场。整个过程中监听页面是否有 JS 异常上报。
结果很干净:ALL E2E PASSED, js errors: 0。虽然 mock 的接口返回是预设好的,但前端的状态流转、渲染逻辑、异常兜底都得到了验证。
十、安全与合规:前端放 Key 的"妥协"
必须坦诚地讲:本项目把 API Key 直接写在了 js/config.js 里,在浏览器里是明文可见的。这是"纯前端 + 无后端"诉求下无可避免的妥协。
- 对个人学习演示:完全够用,方便快捷。
- 对公开部署:强烈不推荐。任何访问者都能从控制台里把你的 Key 抠走。
如果你的项目可能被公开访问,正确做法是:加一层轻量代理(比如 Cloudflare Worker、Vercel Serverless),由代理保管 Key、转发请求,浏览器只和代理通信。我在 README 里已经把这个风险写得很清楚,提醒后来者注意。
十一、总结与展望
11.1 我学到了什么
- AI 项目的核心是"契约",不是"魔法"。模型输出的随机性并不可怕,可怕的是没有一个清晰的、可解析的格式约束。一份好的系统提示词 + 一份容错解析函数,比疯狂堆 try/catch 有用得多。
- 流式是体验的分水岭。同样的文字,一次性吐出和逐字浮现,给玩家的感受天差地别。把 SSE 的"行缓冲"处理好,流式就是很朴素的能力。
- 纯前端依然有它的生态位。在一个体量适中的项目里,原生 HTML/CSS/JS 的开箱即用、零构建、零依赖,反而是巨大的开发效率。
11.2 可以继续做的方向
这个项目目前是一个完整可玩的闭环,但还有不少可以延伸的地方:
- 结局图鉴系统:把每次模拟的结局标题记录下来,做成一个"轮回档案",激励玩家冲刺不同的结局;
- 状态持久化:用 localStorage 保存玩家成就与历史,让"再入轮回"有积累感;
- 参数可配置:把提示词里的世界观、境界表、结算规则做成可视化配置面板;
- 更强的前端工程化:当项目继续膨胀时,再考虑引入 TypeScript 或轻量框架,但那是"届时"的事,而不是"现在"的事。
11.3 写在最后
从灵感到落地,这个修仙模拟器只用了很短的开发周期,但它几乎涵盖了"AI 应用开发"的所有关键环节:API 调用、流式传输、提示词工程、数据契约、容错设计、状态管理、视觉呈现、测试验证。
如果把写代码的这条路也看作一条"修仙之路",那么:
- 学会调用 API,是炼气;
- 掌握流式处理,是筑基;
- 精通提示词工程,是金丹;
- 懂得设计数据契约与容错,是元婴;
- 能把产品体验打磨到让人眼前一亮,才算化神。
而我,也才刚刚踏上这条"码道"。愿每一位读到这篇文章的你,都能在自己的"码道"上,做出让你自己满意的作品。愿你的代码,终有一日如飞剑一般,直破九霄。
项目信息
- 项目地址:https://atomgit.com/peioooooo/r6_9.18
- 技术栈:HTML5 · CSS3 · JavaScript(原生,零依赖)
- AI 接口:GitCode AI(
api-ai.gitcode.com/v1/chat/completions,SSE 流式) - 运行方式:任意静态服务器托管,或直接打开
index.html
汇聚全球AI编程工具,助力开发者即刻编程。
更多推荐
 1
 0
- 0


 已为社区贡献1条内容

所有评论(0)