
六、Hadoop 3.3.6 分布式集群安装部署
前言
Apache Hadoop 是大数据生态的基石框架,提供了分布式存储(HDFS)和分布式计算(YARN + MapReduce)两大核心能力。尽管当前 Spark、Flink 等新一代计算引擎已成为主流,但 Hadoop 仍然是绝大多数大数据平台的底层基础设施——HDFS 提供可靠的海量数据存储,YARN 提供统一的资源调度管理。
本文以 Hadoop 3.3.6 版本为例,手把手讲解在 3 台 CentOS 7 虚拟机上搭建集群的全过程,涵盖环境准备、JDK 安装、Hadoop 配置、集群启动与验证。适合大数据初学者和需要快速搭建测试环境的工程师参考。
1. 基础设施
- 3 台 CentOS 7 最小化安装的主机或虚拟机
- 能够正常上网,并且 3 台机器都处于同一个局域网
- 每台机器建议配置:4C4G 以上
2. 环境准备
2.1 创建 hadoop 用户并配置 sudo 权限(每台机器执行)
使用 root 账户操作:
useradd hadoop          # 创建用户
passwd hadoop           # 设置密码
修改 /etc/sudoers 文件:
vim /etc/sudoers
在 %wheel 那行下面添加一行:
%wheel  ALL=(ALL)       ALL
hadoop  ALL=(ALL)       NOPASSWD:ALL
💡 使用
NOPASSWD:ALL可以免密码执行 sudo 命令,方便集群管理。生产环境建议根据安全策略调整。
2.2 关闭防火墙、创建目录(每台机器执行)
退出 root,使用 hadoop 用户登录:
# 关闭防火墙
sudo systemctl stop firewalld
sudo systemctl disable firewalld

# 创建目录
sudo mkdir /opt/module
sudo mkdir /opt/software

# 修改目录所属主和所属组
sudo chown hadoop:hadoop /opt/module
sudo chown hadoop:hadoop /opt/software
2.3 设置静态 IP(每台机器执行)
修改网络配置文件:
sudo vim /etc/sysconfig/network-scripts/ifcfg-ens33
文件内容修改如下(注意每台机器 IPADDR 不同):
ONBOOT="yes"
BOOTPROTO=static
IPADDR=192.168.1.101      # hadoop2 改为 192.168.1.102,hadoop3 改为 192.168.1.103
NETMASK=255.255.255.0
GATEWAY=192.168.1.1
DNS1=114.114.114.114
DNS2=8.8.8.8
重启网络服务并验证:
sudo systemctl restart network
ip addr                   # 查看 IP
ping www.baidu.com        # 验证网络连通性
2.4 修改主机名和 hosts 文件(每台机器执行)
设置主机名:
sudo vim /etc/hostname
分别设置为 hadoop1、hadoop2、hadoop3。
配置 hosts 映射:
sudo vim /etc/hosts
在末行添加:
192.168.1.101 hadoop1
192.168.1.102 hadoop2
192.168.1.103 hadoop3
2.5 重启所有机器
sudo reboot
2.6 实用脚本
2.6.1 集群分发脚本 xsync
在 hadoop1 上操作(hadoop 用户登录,工作目录 /home/hadoop):
mkdir ~/bin
vim ~/bin/xsync
输入以下内容:
#!/bin/bash

#1. 判断参数个数
if [ $# -lt 1 ]
then
  echo Not Enough Arguement!
  exit;
fi

#2. 遍历集群所有机器,in 后面的是集群配置的3台机器的映射主机名
#   可根据实际情况增改
for host in hadoop1 hadoop2 hadoop3
do
  echo ====================  $host  ====================
  #3. 遍历所有目录,挨个发送
  for file in $@
  do
    #4 判断文件是否存在
    if [ -e $file ]
    then
      #5. 获取父目录
      pdir=$(cd -P $(dirname $file); pwd)
      #6. 获取当前文件的名称
      fname=$(basename $file)
      ssh $host "mkdir -p $pdir"
      rsync -av $pdir/$fname $host:$pdir
    else
      echo $file does not exists!
    fi
  done
done
添加执行权限并测试:
chmod +x ~/bin/xsync

# 将脚本自身分发到其他节点
xsync ~/bin/xsync
2.6.2 集群命令执行脚本 xcall
vim ~/bin/xcall
输入以下内容:
#!/bin/bash

for i in hadoop1 hadoop2 hadoop3
do
    echo --------- $i ----------
    ssh $i "$*"
done
添加执行权限:
chmod +x ~/bin/xcall
2.7 配置 SSH 免密登录(每台机器执行)
生成公钥和密钥:
ssh-keygen -t rsa # 连按三次回车,使用默认配置
将公钥分发到所有节点:
ssh-copy-id hadoop1
ssh-copy-id hadoop2
ssh-copy-id hadoop3
验证免密登录:
ssh hadoop2 hostname # 应直接返回主机名,无需输入密码
2.8 JDK 安装
下载地址:Java SE 8 Archive Downloads(需登录 Oracle 账户)
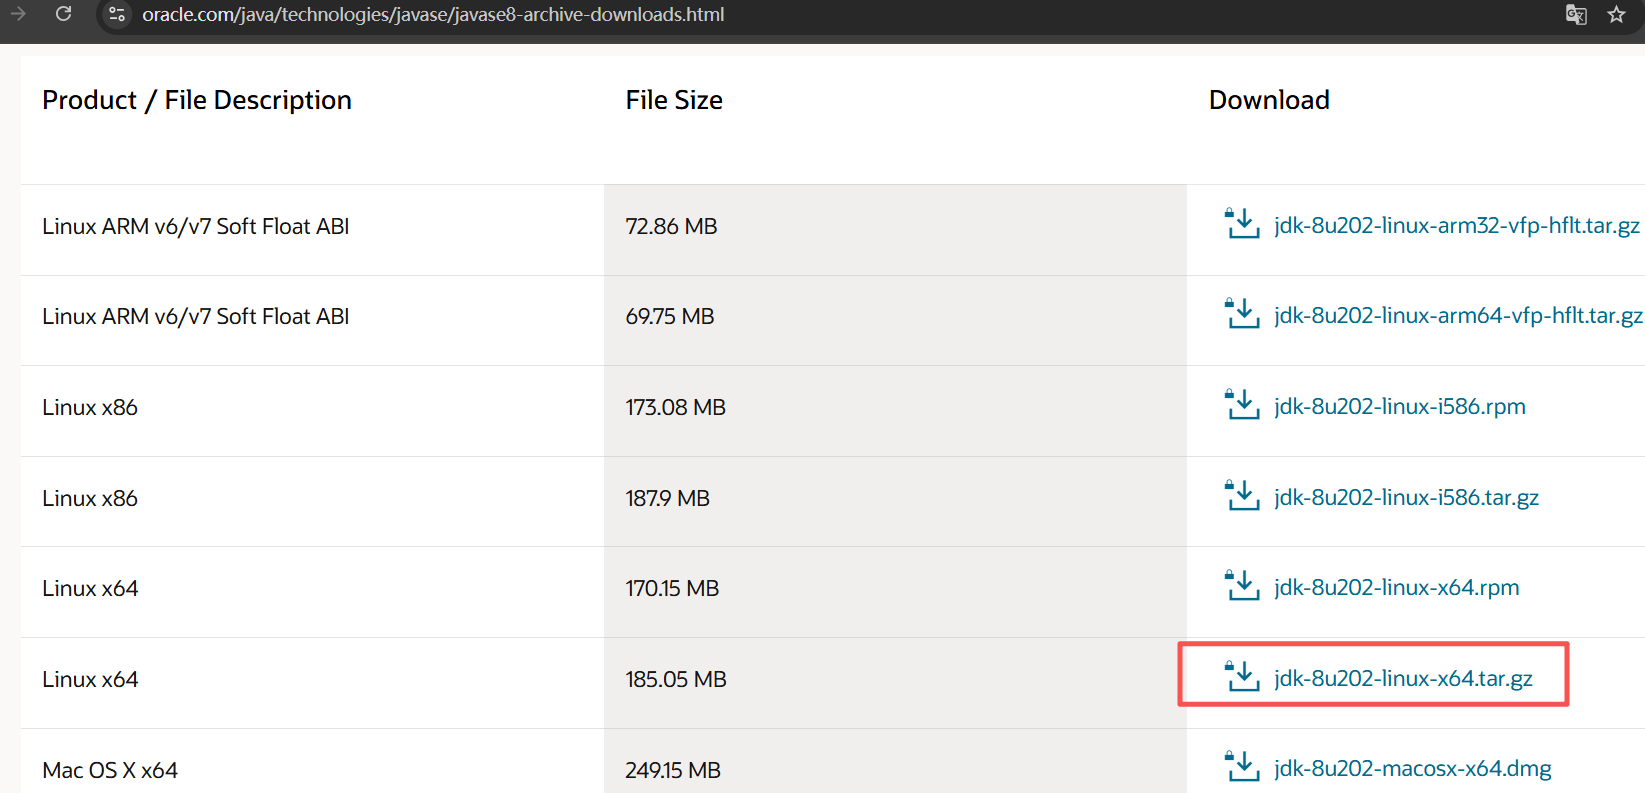
下载完成后上传到 hadoop1 的 /opt/software 目录,执行解压:
tar -zxvf /opt/software/jdk-8u202-linux-x64.tar.gz -C /opt/module/
配置环境变量:
sudo vim /etc/profile.d/my_env.sh
输入如下内容:
#JAVA_HOME
export JAVA_HOME=/opt/module/jdk1.8.0_202
export PATH=$PATH:$JAVA_HOME/bin
使环境变量生效并验证:
source /etc/profile.d/my_env.sh
java -version
输出类似如下即表示安装成功:
openjdk version "1.8.0_181"
OpenJDK Runtime Environment (build 1.8.0_181-b13)
OpenJDK 64-Bit Server VM (build 25.181-b13, mixed mode)
分发 JDK 到集群所有节点:
xsync /opt/module/jdk1.8.0_202
sudo /home/hadoop/bin/xsync /etc/profile.d/my_env.sh
在其它机器上执行 source /etc/profile.d/my_env.sh,然后验证:
xcall java -version
3. Hadoop 安装部署
3.1 集群规划
| 组件 | hadoop1 | hadoop2 | hadoop3 |
|---|---|---|---|
| IP | 192.168.1.101 | 192.168.1.102 | 192.168.1.103 |
| HDFS | NameNode, DataNode | DataNode | SecondaryNameNode, DataNode |
| YARN | NodeManager | ResourceManager, NodeManager | NodeManager |
| 其他 | HistoryServer | — | — |
💡 角色分配说明:
- NameNode 放在 hadoop1:NameNode 是 HDFS 的核心,需要较高内存
- ResourceManager 放在 hadoop2:RM 是 YARN 的核心,与 NN 分离可以避免单点资源争抢
- SecondaryNameNode 放在 hadoop3:2NN 辅助 NN 合并 FsImage 和 EditLog,不与其他主节点同机
3.2 下载安装
下载地址:Hadoop 3.3.6 发行版
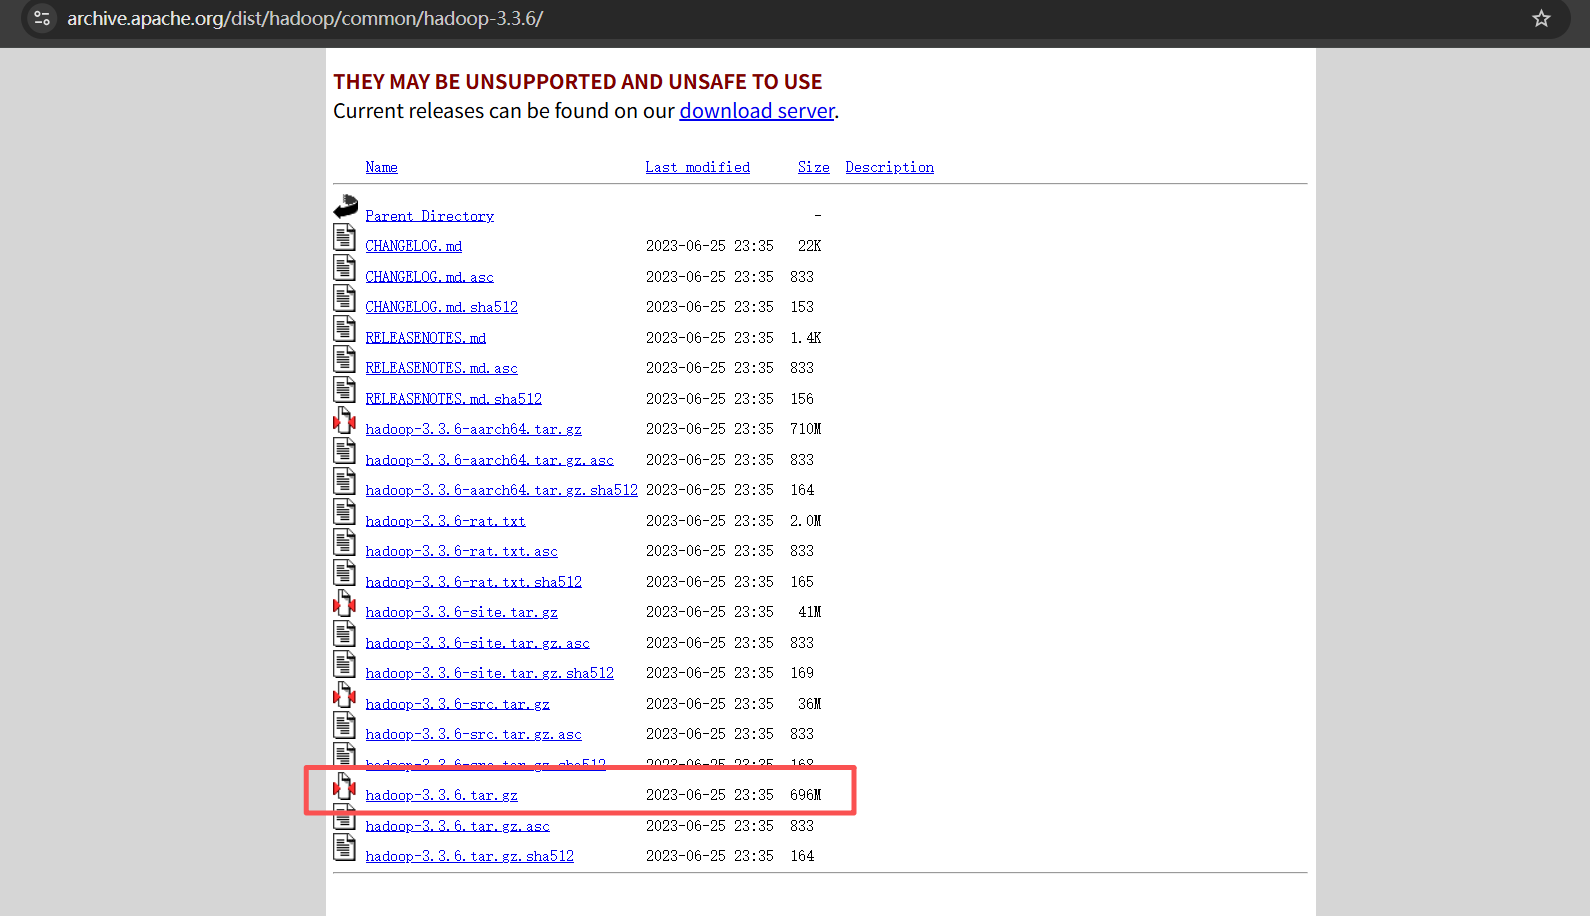
下载完成后上传到hadoop1的 /opt/software 目录,上传完成后使用hadoop账户登录hadoop1执行下面的命令解压到 /opt/module 目录:
tar -zxvf /opt/software/hadoop-3.3.6.tar.gz -C /opt/module
创建软链接并配置环境变量:
cd /opt/module
ln -s hadoop-3.3.6 hadoop

sudo vim /etc/profile.d/my_env.sh
在文件末尾添加:
#HADOOP_HOME
export HADOOP_HOME=/opt/module/hadoop
export PATH=$PATH:$HADOOP_HOME/bin
export PATH=$PATH:$HADOOP_HOME/sbin
分发环境变量文件
sudo /home/hadoop/bin/xsync /etc/profile.d/my_env.sh
在每台机器上执行 source
source /etc/profile.d/my_env.sh
验证 Hadoop 安装:
hadoop version
3.3 配置集群
以下配置均在 hadoop1 上执行,配置目录为
$HADOOP_HOME/etc/hadoop。
3.3.1 核心配置文件:core-site.xml
cd $HADOOP_HOME/etc/hadoop
vim core-site.xml
<?xml version="1.0" encoding="UTF-8"?>
<?xml-stylesheet type="text/xsl" href="configuration.xsl"?>

<configuration>
    <!-- 指定NameNode的地址 -->
    <property>
        <name>fs.defaultFS</name>
        <value>hdfs://hadoop1:8020</value>
</property>
<!-- 指定hadoop数据的存储目录 -->
    <property>
        <name>hadoop.tmp.dir</name>
        <value>/opt/module/hadoop/data</value>
</property>

<!-- 配置HDFS网页登录使用的静态用户为hadoop -->
    <property>
        <name>hadoop.http.staticuser.user</name>
        <value>hadoop</value>
</property>

<!-- 配置该hadoop用户允许通过代理访问的主机节点 -->
    <property>
        <name>hadoop.proxyuser.hadoop.hosts</name>
        <value>*</value>
</property>
<!-- 配置该hadoop用户允许通过代理用户所属组 -->
    <property>
        <name>hadoop.proxyuser.hadoop.groups</name>
        <value>*</value>
</property>
<!-- 配置该hadoop用户允许通过代理的用户-->
    <property>
        <name>hadoop.proxyuser.hadoop.users</name>
        <value>*</value>
</property>
</configuration>
关键配置说明:
| 配置项 | 说明 |
|---|---|
fs.defaultFS | HDFS 的 NameNode 地址,客户端通过此地址访问 HDFS |
hadoop.tmp.dir | Hadoop 运行时数据的本地存储目录,格式化 NameNode 时会初始化此目录 |
hadoop.http.staticuser.user | 访问 HDFS Web UI 时使用的默认用户 |
hadoop.proxyuser.* | 代理用户配置,允许 hadoop 用户代理其他用户访问 HDFS |
3.3.2 HDFS 配置文件:hdfs-site.xml
vim hdfs-site.xml
<?xml version="1.0" encoding="UTF-8"?>
<?xml-stylesheet type="text/xsl" href="configuration.xsl"?>

<configuration>
    <!-- nn web端访问地址-->
    <property>
        <name>dfs.namenode.http-address</name>
        <value>hadoop1:9870</value>
    </property>

    <!-- 2nn web端访问地址-->
    <property>
        <name>dfs.namenode.secondary.http-address</name>
        <value>hadoop3:9868</value>
    </property>

    <!-- 测试环境指定HDFS副本的数量1 -->
    <property>
        <name>dfs.replication</name>
        <value>1</value>
    </property>
</configuration>
关键配置说明:
| 配置项 | 说明 |
|---|---|
dfs.namenode.http-address | NameNode Web UI 端口(Hadoop 3.x 为 9870,2.x 为 50070) |
dfs.namenode.secondary.http-address | SecondaryNameNode Web UI 端口 |
dfs.replication | HDFS 数据块副本数,测试环境设为 1 节省空间,生产环境建议 3 |
3.3.3 YARN 配置文件:yarn-site.xml
vim yarn-site.xml
<?xml version="1.0" encoding="UTF-8"?>
<?xml-stylesheet type="text/xsl" href="configuration.xsl"?>

<configuration>
    <!-- 指定MR走shuffle -->
    <property>
        <name>yarn.nodemanager.aux-services</name>
        <value>mapreduce_shuffle</value>
    </property>

    <!-- 指定ResourceManager的地址-->
    <property>
        <name>yarn.resourcemanager.hostname</name>
        <value>hadoop2</value>
    </property>

    <!-- 环境变量的继承 -->
    <property>
        <name>yarn.nodemanager.env-whitelist</name>
        <value>JAVA_HOME,HADOOP_COMMON_HOME,HADOOP_HDFS_HOME,HADOOP_CONF_DIR,CLASSPATH_PREPEND_DISTCACHE,HADOOP_YARN_HOME,HADOOP_MAPRED_HOME</value>
    </property>

    <!--yarn单个容器允许分配的最大最小内存 -->
    <property>
        <name>yarn.scheduler.minimum-allocation-mb</name>
        <value>512</value>
    </property>
    <property>
        <name>yarn.scheduler.maximum-allocation-mb</name>
        <value>4096</value>
    </property>

    <!-- yarn容器允许管理的物理内存大小 -->
    <property>
        <name>yarn.nodemanager.resource.memory-mb</name>
        <value>4096</value>
    </property>

    <!-- 关闭yarn对物理内存和虚拟内存的限制检查 -->
    <property>
        <name>yarn.nodemanager.pmem-check-enabled</name>
        <value>true</value>
    </property>
    <property>
        <name>yarn.nodemanager.vmem-check-enabled</name>
        <value>false</value>
    </property>

    <!-- 开启日志聚集功能 -->
    <property>
        <name>yarn.log-aggregation-enable</name>
        <value>true</value>
    </property>

    <!-- 设置日志聚集服务器地址 -->
    <property>
            <name>yarn.log.server.url</name>
        <value>http://hadoop1:19888/jobhistory/logs</value>
    </property>

    <!-- 设置日志保留时间为7天 -->
    <property>
        <name>yarn.log-aggregation.retain-seconds</name>
        <value>604800</value>
    </property>
</configuration>
关键配置说明:
| 配置项 | 说明 |
|---|---|
yarn.resourcemanager.hostname | ResourceManager 所在节点,本例为 hadoop2 |
yarn.nodemanager.resource.memory-mb | NodeManager 可管理的总内存,需根据实际机器配置调整 |
yarn.nodemanager.vmem-check-enabled | 设为 false 可避免容器因虚拟内存超限被 kill |
yarn.log-aggregation-enable | 开启后任务日志自动收集到 HDFS,便于排查问题 |
3.3.4 MapReduce 配置文件:mapred-site.xml
vim mapred-site.xml
<?xml version="1.0" encoding="UTF-8"?>
<?xml-stylesheet type="text/xsl" href="configuration.xsl"?>

<configuration>
    <!-- 指定MapReduce程序运行在Yarn上 -->
    <property>
        <name>mapreduce.framework.name</name>
        <value>yarn</value>
    </property>
    <!-- 历史服务器端地址 -->
    <property>
        <name>mapreduce.jobhistory.address</name>
        <value>hadoop1:10020</value>
    </property>

    <!-- 历史服务器web端地址 -->
    <property>
        <name>mapreduce.jobhistory.webapp.address</name>
        <value>hadoop1:19888</value>
    </property>
</configuration>
3.3.5 Worker 配置文件
vim workers
⚠️ Hadoop 3.x 中该文件名为
workers(Hadoop 2.x 为slaves)。
删除默认的 localhost,添加如下内容:
hadoop1
hadoop2
hadoop3
3.4 分发 Hadoop 到所有节点
xsync /opt/module/hadoop /opt/module/hadoop-3.3.6
3.5 启动集群
3.5.1 格式化 NameNode(首次启动必须执行)
cd $HADOOP_HOME
bin/hdfs namenode -format
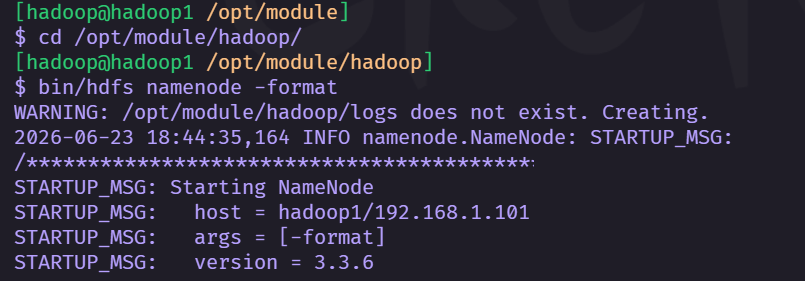
出现 successfully formatted 表示格式化成功。
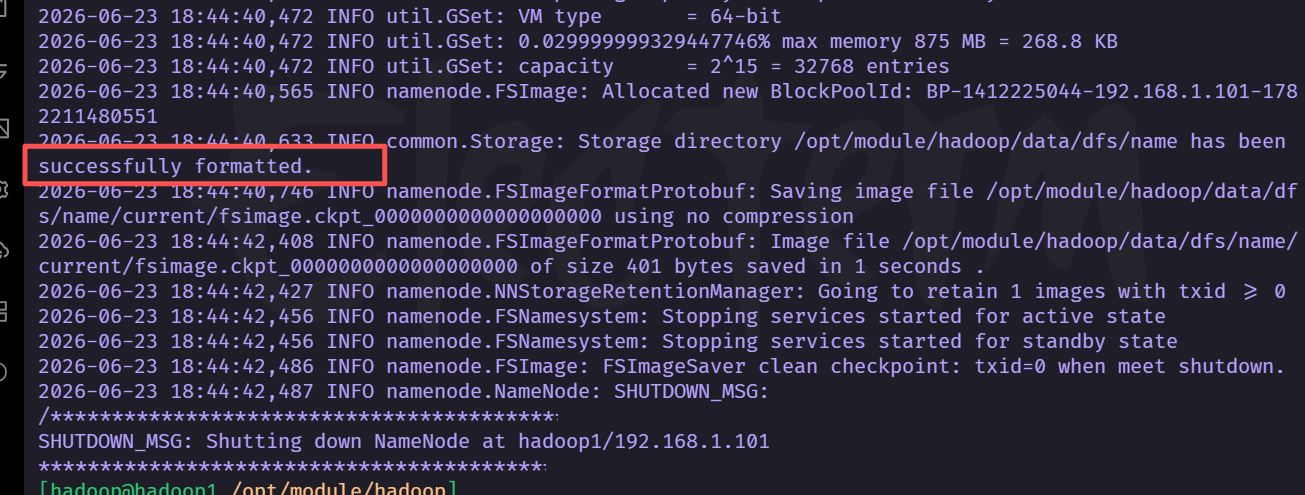
⚠️ 重要提醒:格式化 NameNode 是首次部署时的操作。如果集群已经运行过,需要重新格式化时,必须先停止所有服务,再删除所有节点的 data 目录,最后再格式化。反复格式化会导致 NameNode 和 DataNode 的 clusterID 不一致,DataNode 无法启动。
3.5.2 启动 HDFS 和 YARN
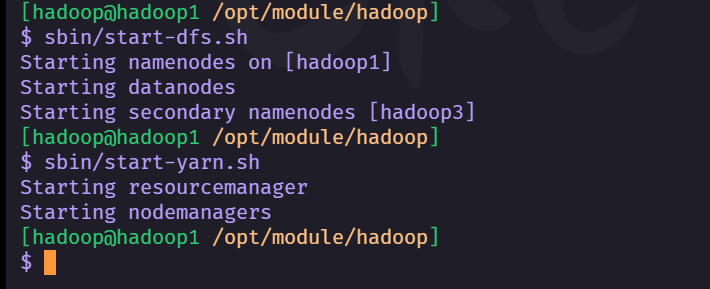
在 hadoop1 上启动 HDFS、YARN:
sbin/start-dfs.sh
sbin/start-yarn.sh
3.5.3 验证进程
使用 xcall 检查各节点进程:
xcall jps
预期输出:
| 节点 | 进程 |
|---|---|
| hadoop1 | NameNode, DataNode, Jps |
| hadoop2 | DataNode, ResourceManager, NodeManager, Jps |
| hadoop3 | DataNode, SecondaryNameNode, NodeManager, Jps |
3.5.4 Web UI 访问
| 服务 | 地址 | 说明 |
|---|---|---|
| HDFS NameNode | http://hadoop1:9870 | HDFS 管理界面 |
| YARN ResourceManager | http://hadoop2:8088 | YARN 资源管理界面 |
| MapReduce HistoryServer | http://hadoop1:19888 | 历史任务查看 |
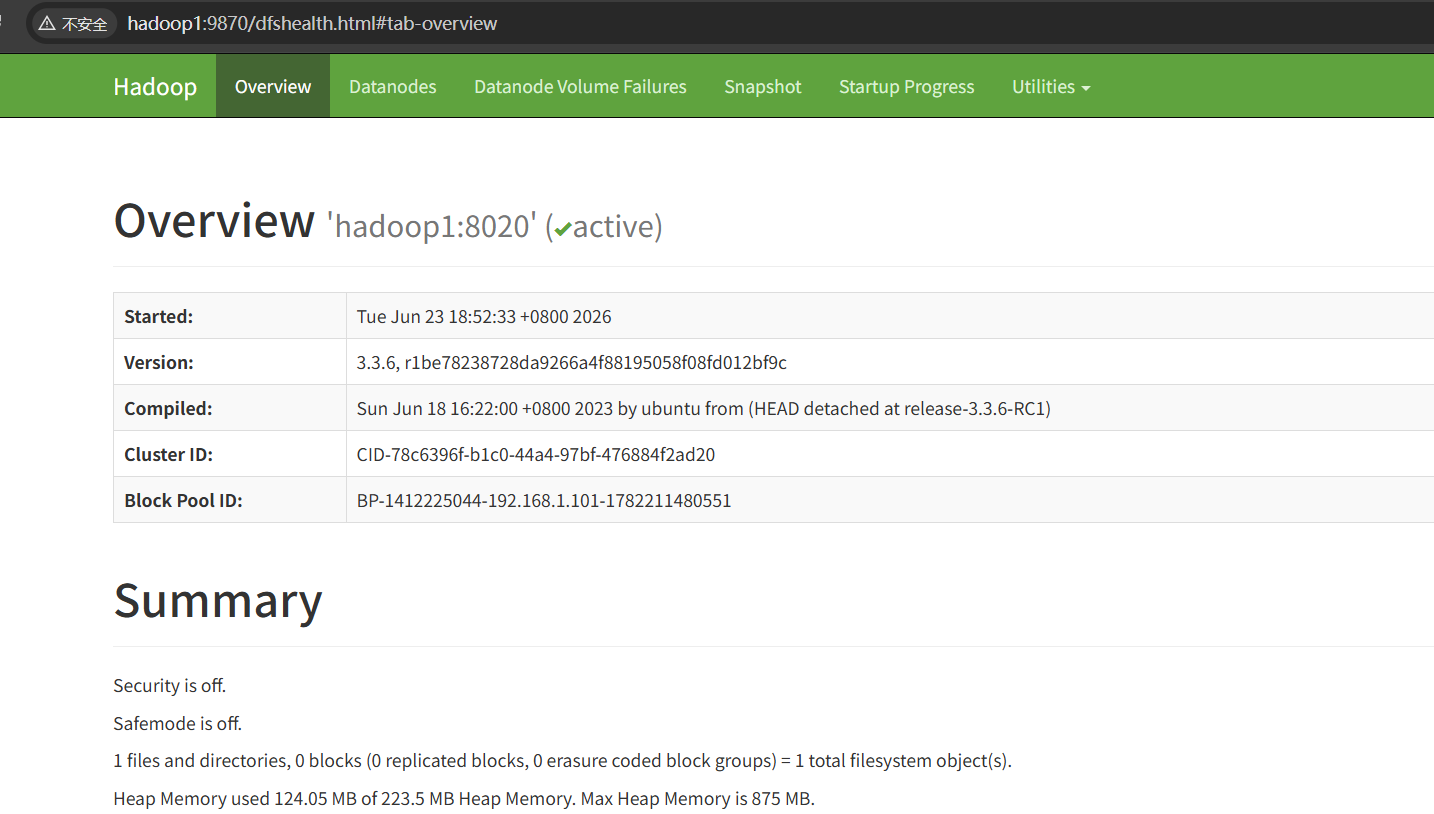
💡 如果从 Windows 浏览器访问,确保 hosts 文件中已配置 hadoop1/2/3 的 IP 映射,或直接用 IP 地址访问。
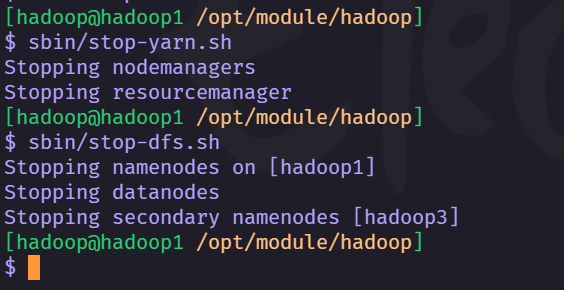
3.5.5 关闭集群
stop-yarn.sh
stop-dfs.sh
3.6 一键启停脚本
在 /home/hadoop/bin 下创建 hdp.sh:
vim ~/bin/hdp.sh
添加下文:
#!/bin/bash
if [ $# -lt 1 ]
then
    echo "没有输入参数!"
    echo "示例:hdp.sh start|stop"
    exit ;
fi
case $1 in
"start")
        echo " =================== 启动 hadoop集群 ==================="

        echo " --------------- 启动 hdfs ---------------"
        ssh hadoop1 "/opt/module/hadoop/sbin/start-dfs.sh"
        echo " --------------- 启动 yarn ---------------"
        ssh hadoop2 "/opt/module/hadoop/sbin/start-yarn.sh"
        echo " --------------- 启动 historyserver ---------------"
        ssh hadoop1 "/opt/module/hadoop/bin/mapred --daemon start historyserver"
;;
"stop")
        echo " =================== 关闭 hadoop集群 ==================="

        echo " --------------- 关闭 historyserver ---------------"
        ssh hadoop1 "/opt/module/hadoop/bin/mapred --daemon stop historyserver"
                echo " --------------- 关闭 yarn ---------------"
        ssh hadoop2 "/opt/module/hadoop/sbin/stop-yarn.sh"
        echo " --------------- 关闭 hdfs ---------------"
        ssh hadoop1 "/opt/module/hadoop/sbin/stop-dfs.sh"
;;
*)
    echo "输入参数有误!"
    echo "示例:hdp.sh start|stop"
;;
esac
添加执行权限:
chmod +x ~/bin/hdp.sh
使用方式:
hdp.sh start    # 启动集群
hdp.sh stop     # 关闭集群
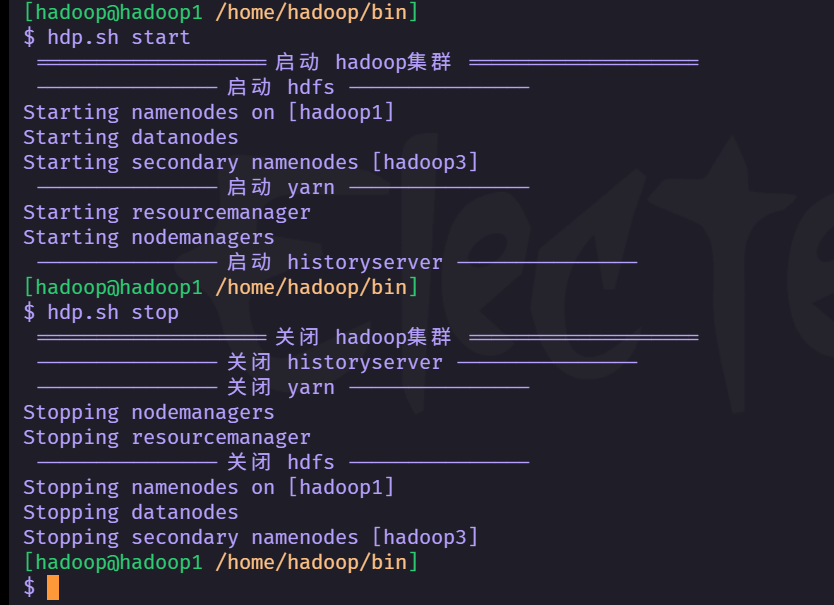
3.7 运行测试任务
集群启动后,运行一个示例任务验证:
# 创建 HDFS 测试目录
hdfs dfs -mkdir /input

# 上传测试文件
hdfs dfs -put $HADOOP_HOME/etc/hadoop/core-site.xml /input/

# 运行 WordCount 示例
hadoop jar $HADOOP_HOME/share/hadoop/mapreduce/hadoop-mapreduce-examples-3.3.6.jar wordcount /input /output

# 查看结果
hdfs dfs -cat /output/part-r-00000
4. 常见问题排查
| 问题 | 可能原因 | 解决方案 |
|---|---|---|
| DataNode 启动失败 | 多次格式化导致 clusterID 不一致 | 停止集群,删除所有节点的 data 和 name 目录,重新格式化 NameNode |
| NameNode 安全模式无法写入 | 未退出安全模式 | hdfs dfsadmin -safemode leave |
| YARN 容器被 kill | 内存不足或 vmem 检查 | 调大 NM 内存配置,关闭 vmem 检查 |
| Web UI 无法访问 | 防火墙未关闭或 IP 映射错误 | 检查防火墙状态,确认 hosts 配置正确 |
| SSH 免密登录失败 | 权限问题 | 确保 ~/.ssh 目录权限为 700,authorized_keys 权限为 600 |
5. 总结
本文完成了 Hadoop 3.3.6 分布式集群的安装部署,主要涵盖以下内容:
5.1 部署流程回顾
环境准备 → JDK 安装 → Hadoop 下载解压 → 配置文件修改 → 集群分发 → 格式化 → 启动验证
5.2 关键节点总结
| 阶段 | 关键操作 | 注意事项 |
|---|---|---|
| 环境准备 | 用户创建、静态IP、SSH免密、主机名 | 3 台机器都要执行,注意 IP 和主机名对应关系 |
| JDK 安装 | 解压到 /opt/module,配置环境变量 | 需要分发到所有节点 |
| Hadoop 配置 | core-site / hdfs-site / yarn-site / mapred-site / workers | 在 hadoop1 上统一配置后分发 |
| 集群启动 | 格式化 NN → start-dfs → start-yarn → 启动 HistoryServer | 首次启动前必须格式化,且只需格式化一次 |
| 验证 | jps 查看进程 + Web UI 访问 | 确认各节点进程与规划表一致 |
5.3 集群端口速查表
| 服务 | 端口 | 节点 |
|---|---|---|
| HDFS NameNode RPC | 8020 | hadoop1 |
| HDFS NameNode Web UI | 9870 | hadoop1 |
| HDFS DataNode | 9866 | 所有节点 |
| SecondaryNameNode Web UI | 9868 | hadoop3 |
| YARN ResourceManager Web UI | 8088 | hadoop2 |
| YARN NodeManager | 8042 | 所有节点 |
| MapReduce HistoryServer | 19888 | hadoop1 |
5.4 Hadoop 2.x 与 3.x 主要差异
| 差异点 | Hadoop 2.x | Hadoop 3.x |
|---|---|---|
| NameNode Web UI 端口 | 50070 | 9870 |
| SecondaryNN Web UI 端口 | 50090 | 9868 |
| 从节点配置文件 | slaves | workers |
| 支持的 Java 版本 | JDK 7/8 | JDK 8+ |
| Erasure Coding | 不支持 | 支持(节省存储空间) |
| 多 NameNode | 仅 HA 双 NN | 支持多 NN 联邦 |
参考资源
官方文档
| 资源 | 链接 | 说明 |
|---|---|---|
| Hadoop 官方文档 | hadoop.apache.org/docs/r3.3.6 | Hadoop 3.3.6 完整文档 |
| HDFS 架构设计 | hadoop.apache.org/docs/r3.3.6/hadoop-project-dist/hadoop-hdfs/HdfsDesign.html | HDFS 设计文档 |
| YARN 架构设计 | hadoop.apache.org/docs/r3.3.6/hadoop-yarn/hadoop-yarn-site/YARN.html | YARN 架构说明 |
推荐书籍
| 书名 | 作者 | 说明 |
|---|---|---|
| 《Hadoop 权威指南》(第4版) | Tom White | Hadoop 经典入门与进阶 |
| 《Hadoop 大数据技术从入门到精通》 | 黄宜华 等 | 中文 Hadoop 实战指南 |
常见问题参考
| 问题 | 参考链接 |
|---|---|
| DataNode 启动失败排查 | 检查 clusterID:cat /opt/module/hadoop/data/current/VERSION |
| Hadoop 3.x 端口变化说明 | Hadoop 3.x 默认端口列表 |
| JDK 环境变量配置 | JAVA_HOME 必须指向 JDK 安装根目录,不是 bin 目录 |

汇聚全球AI编程工具,助力开发者即刻编程。
更多推荐

 11
 0
- 0


 已为社区贡献5条内容

所有评论(0)