
JavaSE[自用笔记]
分支:
[Java线程池]
[Java动态代理]
● JDK JRE JVM
三者关系:JDK > JRE > JVM
○ JVM
(Java Virtual Machine):Java 虚拟机
JVM 就是一个 专门的翻译官 + 运行引擎。
我们写的java代码,不能直接丢给操作系统(Windows/Mac/Linux),它看不懂,而是编译成一种叫「字节码」的通用代码;JVM 的作用就是:把这份通用的 Java 字节码,翻译成你电脑系统能看懂的「母语指令(也就是汇编语言二进制)」,然后指挥电脑执行代码。
特点:
「一次编写,到处运行」,全靠 JVM!
比如你在 Windows 上写的 Java 程序,拿到 Mac/Linux 上不用改一行代码就能运行,原因是:不同的操作系统,都有对应版本的 JVM 翻译官,Java 字节码是通用的,只是换个翻译官而已,核心代码不变。
JVM运作大体流程:
JVM 运行 Java 代码时,会把内存划分为 两大核心类型 的区域,所有代码执行的内存操作都围绕这两块展开,划分原则是「线程归属」,也是整个运作流程的基础:
✅线程共享区(全局唯一,所有线程共用) :堆(Heap) + 方法区(Method Area,JDK8 叫元空间)
✅ 线程私有区(线程独有,随线程创建而生、线程销毁而灭,互不干扰) :虚拟机栈 + 程序计数器 + 本地方法栈
△ 虚拟机栈
(Java Virtual Machine Stack)[线程私有]
核心作用
是 Java 方法执行的「核心载体」,Java 中每一个方法的调用与执行,都对应虚拟机栈中一个「栈帧」的「入栈 → 执行 → 出栈」,没有虚拟机栈,就没有方法的执行。
栈帧:(虚拟机栈的最小单位)包含内容
每个栈帧对应一个方法,里面存着:局部变量表(方法内的局部变量、方法入参)、操作数栈(临时存放运算数据,做加减乘除等计算)、动态链接(指向方法区的当前方法字节码)、方法返回地址。
特点:
遵循 先进后出(FILO) 栈结构:调用 A→A 调用 B→B 调用 C,栈帧压入顺序 A→B→C,执行完 C 先弹栈,再弹 B,最后弹 A;
内存释放:方法执行完毕(return / 异常结束),对应栈帧立刻出栈,内存自动释放,无需 GC;
异常:方法递归调用过深(无终止递归)→ 栈溢出 StackOverflowError;虚拟机栈内存配置过小 + 创建栈帧过多 → OOM 内存溢出;
方法内的局部变量,都存在虚拟机栈的栈帧里。
△ 程序计数器
(Program Counter Register)[轻量]
核心作用
精准记录 当前线程正在执行的「Java 字节码指令的行号 / 地址」,简单说:给 CPU「指路」,告诉 CPU 下一行要执行哪条字节码指令。
特点:
线程切换的核心保障:CPU 切换线程时,程序计数器会保存当前线程的执行位置;线程再次获得执行权时,直接从记录的位置继续执行,不会错乱、不会丢执行进度;
绝对唯一特殊点:JVM 所有内存区域中,唯一一个不会抛出任何内存异常(无 OOM、无 StackOverflowError)的区域;
内存占用:极小,轻量级到几乎可以忽略不计;
补充:如果线程正在执行native本地方法,程序计数器的值会暂时变为空 (undefined)。
△ 本地方法栈
(Native Method Stack)
核心作用
作用和虚拟机栈完全一致,唯一区别:虚拟机栈为「Java 编写的普通方法」服务,本地方法栈为「被native关键字修饰的本地方法」服务(底层是 C/C++ 实现,非 Java 代码)。
特点:
常见 native 方法:Object.hashCode ()、Thread.start0 ()、System.arraycopy (),都是 JDK 底层自带的,我们几乎不用自定义;
异常:和虚拟机栈一样,调用 native 方法过深会触发 StackOverflowError,内存不足会触发 OOM;
一句话总结:虚拟机栈管 Java 方法,本地方法栈管 C/C++ 方法,功能同源、各司其职。
△ 堆
(Heap)[内存占比最大、GC 核心区域]
核心作用
JVM 中唯一存放「对象实例本体」[Class实例(通过Class类加载的对象模板)]和「数组本体」的区域,Java 代码中只要执行 new 关键字(比如new User()、new String()、new int[10]),创建出来的东西,本体一定在堆里,没有任何例外!
补充:new出来的对象如果包含方法,那只存方法的引用地址,方法实际存在方法区
特点:
1:内存占比:JVM 进程中 内存占用最大的区域(默认占 JVM 总内存的 70%+);
2:引用规则(灵魂考点):堆里存对象本体,虚拟机栈里永远只存「对象的引用地址」,比如 User user = new User();
new User() → 堆中创建 User 对象本体,初始化属性,分配内存;
User user → 局部变量,存在虚拟机栈的栈帧局部变量表中;
= → 把堆中 User 对象的内存地址,赋值给局部变量 user;
3:存储内容:对象的所有成员变量(非 static 的属性) 都跟着对象本体存在堆里;
4:垃圾回收核心:堆是 JVM 垃圾回收(GC)的「唯一主战场」,没有之一!当一个对象没有任何引用地址指向它时,会被标记为「垃圾对象」,GC 会自动回收这块内存,释放空间;
5:异常:创建的对象过多、对象生命周期过长,GC 来不及回收 → 堆内存溢出 OOM (OutOfMemoryError),这是开发中最常见的内存异常;
6:线程特性:全局共享,所有线程都能访问堆中的对象,这也是堆中会出现「并发安全问题」的根源。
△ 方法区
(Method Area)[JDK8 改名元空间 Metaspace 线程共享]
核心作用
存储 Java 类的 元数据信息(类的模板),是 JVM 加载.class 字节码文件后,存放「类的核心信息」的区域,简单说:类的定义是什么样的,就存在方法区里。
存储的核心内容
类的完整结构:类的包名、类名、父类、接口、字段(属性)定义、方法定义;
静态相关:所有 static 修饰的静态变量、静态方法的字节码指令;
常量相关:字符串常量池(JDK7 后移到堆里)、final 修饰的常量;
其他:方法的字节码指令、符号引用、访问权限修饰符(public/private)等。
特点:
版本变更:JDK7 及之前叫「方法区」,物理内存在 JVM 堆内存中;JDK8 彻底移除方法区,替换为「元空间(Metaspace)」,物理内存从 JVM 堆内,转移到了 操作系统的本地内存 中;本质作用没变,只是存储位置变了,名字变了。
存储规则:static 静态变量 一定存在方法区(元空间)里,和堆 / 栈无关;、
内存释放:类的元数据只有在「类被卸载」时才会释放,类卸载的条件非常苛刻(几乎很少触发),所以方法区的内存回收效率极低;
异常:加载的类过多(比如动态代理生成大量类、框架加载过多类)→ 方法区 / 元空间内存溢出 OOM;
线程特性:全局共享,所有线程共用同一块方法区内存。
△ 内存模型图
图来自[https://www.bilibili.com/video/BV1fh411y7R8/?spm_id_from=333.337.search-card.all.click&vd_source=cc7c91e214cab08f67a0c0a813c18647]

图来自百度:

Java程序的开发过程与运行过程(图自来:https://www.bjpowernode.com/tutorial_java_se/57.html):

类加载子系统:
在磁盘中的class文件将其加载到jvm虚拟机内走一遍jvm内存模型流程
将类的元信息(类结构、方法、字段等)存储到 元空间(方法区) 里,供后续执行使用。
字节码执行引擎:
是 JVM 中负责执行字节码的 “动力核心”:把类加载子系统加载好的.class字节码指令,翻译成当前操作系统能识别的机器指令,最终让 CPU 执行。
两种模式:
1:解释执行:逐行翻译字节码指令,执行一行翻译一行(启动快,但执行效率低);
2:即时编译(JIT):把频繁执行的 “热点代码”(比如循环、常用方法)一次性编译成机器码缓存起来,后续直接执行缓存的机器码(执行效率高,但首次编译需要时间)。
jvm会将class文件译成二进制汇编语言与操作系统交互
○ JRE
✅ 核心定义
JRE 是 Java Runtime Environment 的缩写,中文叫「Java 运行时环境」,它是运行 Java 程序的必备基础环境,专门负责解析、执行已经编译好的 Java 字节码文件(.class 文件),仅提供「运行能力」,没有编译 Java 源代码的功能。
✅ JRE 的核心组成(2 个核心部分,缺一不可)
JRE 是一个完整的运行环境,核心由两部分构成:
Java 虚拟机(JVM):这是 JRE 的核心核心,是真正执行 Java 字节码的底层引擎,负责字节码的解释 / 编译执行、内存分配与回收(GC 垃圾回收)、线程调度等核心工作;
Java 核心类库(Java SE API):Java 提供的基础标准类库(比如 java.lang、java.util、java.io 等包),Java 程序运行时必须依赖这些类库实现基础功能,这部分类库是运行 Java 程序的基础支撑。
补充:JRE 内部还包含一些运行时的支撑文件、系统配置等,是一个开箱即用的完整运行包。
○ JDK
JDK 基础定义
JDK 全称 Java Development Kit(Java 开发工具包),是 Oracle 官方提供的、面向 Java 程序员的核心开发套件,是进行 Java 程序开发的必备基础环境,所有 Java 开发都基于 JDK 完成。
JDK 的核心组成
1:内置JRE环境,自带java运行环境,无需安装jre即可运行java编译后的class文件
2:内置核心开发编译工具:如常用的javac.exe(将.java文件编译为.class的jvm可运行文件)还有java.exe启用jvm虚拟机执行class文件,javadoc.exe文档生成工具等
总结
✅ JDK ⊃ JRE ⊃ JVM
JVM (Java Virtual Machine):Java 虚拟机,Java 的「跨平台核心」,负责解析运行.class字节码文件;JVM 不能独立运行,必须依赖 JRE 的类库支持。
JRE (Java Runtime Environment):Java 运行环境,包含 JVM + 运行 Java 程序所需的核心类库;JRE 只有运行能力,没有开发 / 编译能力,适合只需要运行 Java 程序的普通用户。
JDK:Java 开发工具包,包含完整 JRE + 全套 Java 开发 / 编译 / 调试工具;JDK 是开发专属,有了 JDK,既能写代码、编译代码,也能运行代码。
JDK 是 Java 开发的必备工具包,包含开发工具 + 运行环境,是 JRE 的超集,而 JRE 又是 JVM 的超集,三者层层包含,共同支撑 Java 的开发与运行。
● Java注释
javadoc.exe 是 JDK 自带的工具,用来根据 Java 代码里的规范注释,生成和官方 Java API 风格一致的 HTML 文档(方便其他人查看类、方法的说明)。
○ Javadoc的使用
使用javadoc.exe:
1:javadoc Demo.java
2:javadoc -d doc -author -version -encoding UTF-8 -charset UTF-8 Demo.java
-d 目录名:指定文档输出目录(必用,避免当前目录混乱)
-author:显示代码中的@author信息
-version:显示代码中的@version信息
-encoding UTF-8:指定代码文件的编码(解决中文注释乱码)
-charset UTF-8:指定生成文档的编码
*.java:批量处理当前目录下所有 Java 文件
○ 注释标签
Javadoc 有很多实用标签,不同标签对应不同的说明场景(比如类、方法、字段),下面按「适用场景」分类详细说明,附用法示例:
通用标签:
@author

用途:标注作者信息
适用:类、接口
示例:@author 张三(可写多个,用逗号分隔)
@version

用途:标注版本号
适用:类、接口
示例:@version 1.0.0
@since

用途:标注「该类 / 方法 / 字段从哪个版本开始提供」
适用:类、接口、方法、字段
示例:@since JDK 1.8(说明从 JDK8 开始支持)
@see

用途:添加「相关参考链接」(可以是其他类、方法、外部文档)
适用:所有元素
@see java.lang.String  // 参考String类
@see #add(int, int)    // 参考当前类的add方法(#代表当前类)
@see "https://docs.oracle.com"  // 参考外部文档
@link

用途:在注释文本中嵌入可点击的链接(比 @see 更灵活,可写在句子里)
适用:所有注释文本
格式:{@link 目标}
/**
 * 调用{@link #add(int, int)}方法可以实现求和
 */
类 / 接口专用标签:
@deprecated

用途:标记「该类 / 接口已过时」,同时说明替代方案
适用:类、接口、方法、字段
/**
 * @deprecated 该类已过时,请使用{@link NewDemo}替代
 */
方法 / 构造器专用标签:
@param

用途:说明方法的参数含义
适用:方法、构造器
格式:@param 参数名 参数说明
示例:@param a 要相加的第一个整数
@return

用途:说明方法的返回值含义
适用:有返回值的方法(void 方法不能用)
示例:@return 两个整数相加的结果
@throws / @exception

用途:说明方法可能抛出的异常(两者功能一致,@exception 是旧写法)
适用:方法、构造器
格式:@throws 异常类型 异常触发场景
/**
 * @throws IllegalArgumentException 当参数a为负数时抛出
 */
@inheritDoc

用途:继承父类 / 接口的 Javadoc 注释(减少重复编写)
适用:子类方法(覆盖父类方法时用)
/**
 * {@inheritDoc}
 */
public int add(int a, int b) { ... }
字段专用标签:
@value
用途:显示静态常量的具体值(仅用于static final字段)
适用:静态常量
/**
 * 圆周率常量:{@value}
 */
public static final double PI = 3.1415926;
○ Idea工具快捷注释模板
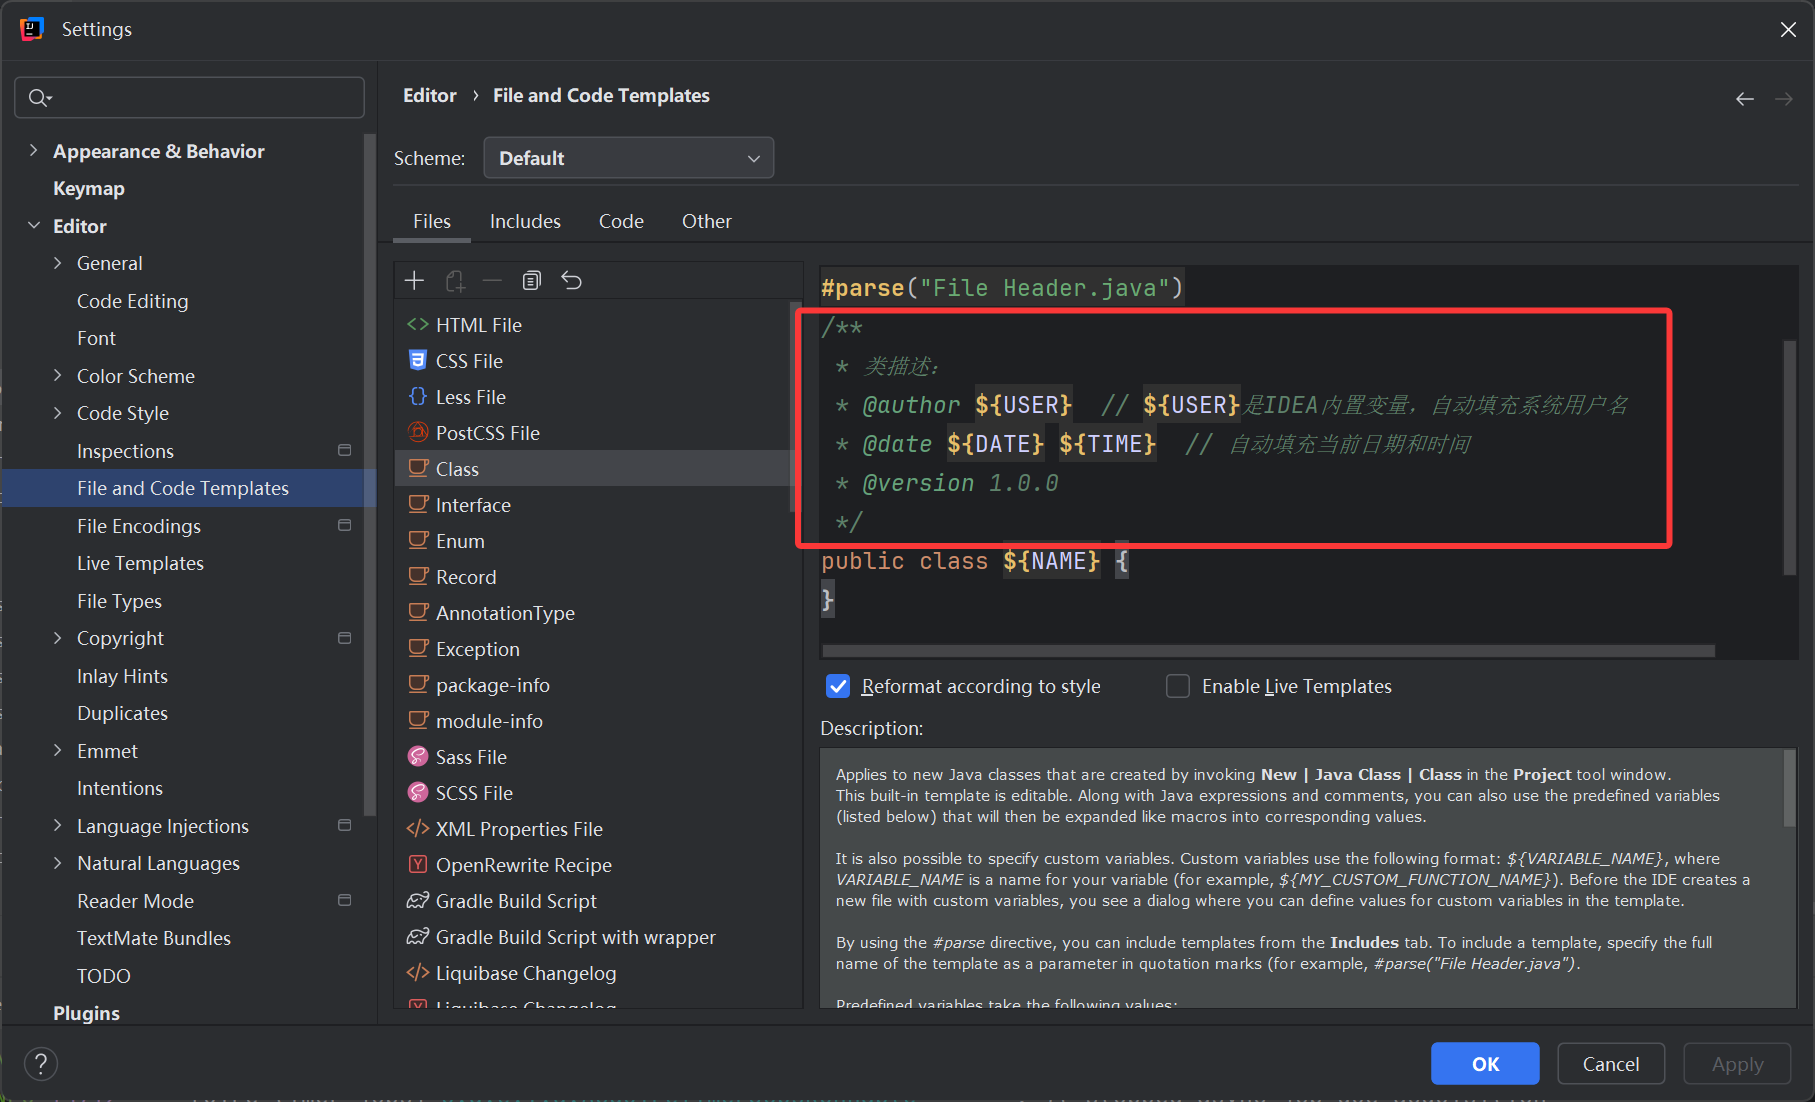
1:创建接口或类时自动生成注释:
打开idea设置:File-Settings
进入 Editor → File and Code Templates(文件和代码模板);
选中class(Enum等也可以配置):
2:注释快捷键生成标签:
打开 IDEA 设置,进入 Editor → Live Templates
点击右侧「+」→ 选Template Group… → 输入分组名(比如MyJavadoc)→ 确定;
选中刚创建的分组,点击「+」→ 选Live Template(新建实时模板);
配置模板:
Abbreviation(缩写):输入触发快捷键(比如doc,也可以用/**)(默认输入完缩写后按tab快捷生成);
Description(描述):填 “生成方法 Javadoc 注释”;
Template text(模板内容):
/**
 * 方法描述:
 * @author name
 */
设置模板适用范围:
点击模板下方的「Define」→ 勾选「Java」→ 选「Declaration」(声明处,比如方法上方);
● 匿名内部类
匿名内部类的核心定义
匿名内部类 是 Java 中一种「没有名字的局部内部类」,是内部类的简化写法;
本质:
创建一个类的子类 / 一个接口的实现类,但是不给这个子类 / 实现类起名字,并且在定义这个类的同时,直接创建该类的对象,一步完成「类定义 + 对象创建」。
○ 匿名内部类语法
✔ 写法 1:实现接口的匿名内部类(最常用)
// 格式
接口 变量名 = new 接口名() {
    // 必须重写接口中的【所有抽象方法】
    @Override
    抽象方法1(){ 业务逻辑 }
    @Override
    抽象方法2(){ 业务逻辑 }
};
✔ 写法 2:继承普通类的匿名内部类
// 格式
父类 变量名 = new 父类名(构造参数) {
    // 可选:重写父类的方法,也可以自定义方法
    @Override
    父类方法(){ 业务逻辑 }
};
Java 匿名内部类是「无类名、一次性使用、定义即创建对象」的局部内部类,可继承任意类 / 实现任意接口,简化单次使用的子类 / 实现类代码;Lambda 是它在「函数式接口」场景的极致简化版,二者是 Java 中简化代码的两大核心方式。
● Lambda表达式
核心作用:
简化「函数式接口」的匿名内部类写法,极大精简代码、提高可读性
○ 函数式接口
定义:
一个接口中,有且仅有 1 个抽象方法(可以有默认方法、静态方法,不影响),这样的接口就是「函数式接口」。
例如:
java.lang.Runnable :抽象方法 void run()
java.util.Comparator :抽象方法 int compare(T o1, T o2)
Java 中专门提供了注解 @FunctionalInterface 标记函数式接口,作用是编译期校验:如果加了这个注解的接口,不符合「只有 1 个抽象方法」的规则,编译器会直接报错。
@FunctionalInterface
public interface Message {
    //不算唯一抽象方法
    default void send() {
        System.out.println("固定发送信息");
    }
    //可以有默认方法和静态方法
    static void send(String msg) {
        System.out.println("动态发送信息" + msg);
    }

    //唯一抽象方法
    String run(String msg);
}
○ Lambda语法
Lambda 本质是「函数式接口中抽象方法」的代码实现简写,语法完全固定,标准格式如下:
(参数列表) -> { 方法体代码 };
(参数列表):和「函数式接口的抽象方法」的参数列表 完全一致(参数个数、类型、顺序都一样)
->:Lambda 的「语法分隔符」,固定写法,无实际含义,作用是:把「参数列表」和「方法体」分隔开
{方法体代码}:就是原来抽象方法需要编写的业务逻辑代码,等价于匿名内部类中重写抽象方法的方法体
以 Java 内置的Runnable接口(函数式接口)为例,对比「匿名内部类」和「Lambda 标准写法」,效果完全等价:
public class LambdaDemo {
    public static void main(String[] args) {
        // 1. 传统写法:Runnable匿名内部类
        Runnable runnable1 = new Runnable() {
            @Override
            public void run() { // Runnable唯一的抽象方法
                System.out.println("匿名内部类:执行线程任务");
            }
        };

        // 2. Lambda标准写法:等价于上面的匿名内部类
        Runnable runnable2 = () -> {
            System.out.println("Lambda标准写法:执行线程任务");
        };
    }
}
本质上是:
new了一个接口的实现类 重写父类的run方法 然后返回赋值给父引用
可以看到:Lambda 省略了「new 接口 ()」「@Override」「方法名」这些冗余代码,只保留了核心的「参数 + 业务逻辑」。
○ Lambda核心语法
标准语法只是基础,实际开发中几乎不用标准写法,都是用「简化写法」,Lambda 提供了 4 条核心简化规则,规则可以叠加使用,简化后代码极致精简,这也是 Lambda 的精髓,所有规则都基于「函数式接口的抽象方法」定义,规则优先级从高到低,全部通用:
规则 1:参数的「数据类型」可以直接省略
// 示例:Comparator接口(抽象方法 int compare(Integer o1, Integer o2))
// 标准写法
Comparator<Integer> com1 = (Integer o1, Integer o2) -> {
    return o1 - o2;
};
// 简化后:省略参数类型
Comparator<Integer> com2 = (o1, o2) -> {
    return o1 - o2;
};
规则 2:如果参数列表只有 1 个参数,参数的「小括号 ()」可以直接省略
// 示例:自定义函数式接口(抽象方法 void doSomething(String str))
@FunctionalInterface
interface MyInterface {
    void doSomething(String str);
}
// 标准写法
MyInterface mi1 = (String str) -> {
    System.out.println(str);
};
// 叠加规则1+2:省略类型+省略小括号
MyInterface mi2 = str -> {
    System.out.println(str);
};
规则 3:如果方法体中只有 1 行代码,方法体的「大括号 {}」可以直接省略
// 示例:Runnable接口(无参数、无返回值,方法体1行代码)
// 标准写法
Runnable r1 = () -> {
    System.out.println("Hello Lambda");
};
// 简化后:省略大括号
Runnable r2 = () -> System.out.println("Hello Lambda");
规则 4:如果方法体中只有 1 行 return 语句,省略大括号的同时,必须一起省略 return 关键字和分号;
// 示例:Comparator接口(返回int类型,方法体只有1行return)
// 标准写法
Comparator<Integer> com1 = (o1, o2) -> {
    return o1 - o2;
};
// 叠加所有规则:省略类型+省略大括号+省略return+省略分号
Comparator<Integer> com2 = (o1, o2) -> o1 - o2;
规则 5:方法引用式
public class JavaMainTest {
    public static void main(String[] args) {
        List<User> userList = new ArrayList<>();
        userList.add(new User(1, "张三", 20, "正常"));
        userList.add(new User(2, "李四", 22, "禁用"));
        userList.add(new User(3, "王五", 25, "正常"));
        userList.add(new User(4, "张三", 18, "正常"));

        userList.forEach(System.out::println);
        //等价于
        userList.forEach(user -> {
            System.out.println(user);
        });
    }
}
使用场景:For循环遍历
public class JavaMainTest {
    public static void main(String[] args) {
        List<User> userList = new ArrayList<>();
        userList.add(new User(1, "张三", 20, "正常"));
        userList.add(new User(2, "李四", 22, "禁用"));
        userList.add(new User(3, "王五", 25, "正常"));
        userList.add(new User(4, "张三", 18, "正常"));

        //使用Lambda表达式进行遍历
        userList.forEach(u -> {
            System.out.println(u);
        });

        //使用Lambda进行集合排序
        Collections.sort(userList, (u1, u2) -> u1.getAge() - u2.getAge());

        userList.forEach(System.out::println);
    }
}
○ 类字面常量[额外语法]
new Class[]{Service.class} 是 Java 中 「创建【Class 类型的数组】的标准语法」,是一个数组字面量初始化写法,属于 Java 基础语法
new Class[]{ ... } 是什么
新建一个 Class 类型的数组,并且立即初始化数组中的元素
这是 Java 中 「数组的动态初始化语法」,是创建数组的标准写法之一
例如:
// 字符串数组:创建String类型数组,元素是"a","b"
new String[]{"a","b"};

// 整数数组:创建int类型数组,元素是1,2,3
new int[]{1,2,3};

// 对象数组:创建User类型数组,元素是new User()
new User[]{new User(), new User()};

// 你的写法:创建Class类型数组,元素是Service.class
new Class[]{Service.class};
等价于:
Class<?>[] aclass = new Class[]{Service.class, ServiceDemo.class}

Class<?>[] aclass = {Service.class, ServiceDemo.class}
使用场景:
// 需求:获取Service类中「参数是 String 和 int 类型」的构造器
Class<Service> clazz = Service.class;
// 传入:参数类型的Class数组 → new Class[]{String.class, int.class}
Constructor<Service> constructor = clazz.getConstructor(new Class[]{String.class, int.class});
// 简化写法(推荐)
Constructor<Service> constructor = clazz.getConstructor(String.class, int.class);
● Java Stream流
Java Stream流是什么:
Java 8 新增的 Stream 流是「集合 / 数组的终极处理工具」,可以完全替代所有 for/foreach 循环,核心作用是:对 集合(List/Set/Map)、数组 做【批量数据处理】,所有遍历、筛选、加工、统计、转换、聚合的逻辑,都能通过 Stream 一行代码搞定,代码极简、无嵌套、可读性拉满。
Java Stream流能做什么:
stream() 不是一个普通方法,是开启流式处理的「入口」,通过 集合.stream() / Arrays.stream(数组) 生成流对象后,就能调用各种流式方法,完成所有你能想到的数据批量处理。
✅ 核心能力 1:替代循环(遍历 / 赋值)
遍历集合 / 数组的每一个元素,替代 for / foreach 循环
遍历的同时给对象赋值 / 修改属性(就是你之前问的循环赋值)
支持「带条件的遍历赋值」,精准修改符合要求的元素
✅ 核心能力 2:数据筛选 & 过滤
按条件筛选集合中的元素(比如:筛选年龄 > 20 的用户、ID 不为空的数据、名称包含指定字符的元素)
多条件组合筛选(且 / 或),无需写嵌套if判断
✅ 核心能力 3:数据映射 & 转换
提取集合中对象的单个属性(比如:从List中提取所有用户名,得到List)
对象类型转换(比如:把List转List、把实体类转 DTO/VO)
对元素做计算处理(比如:所有数字 + 10、字符串拼接前缀 / 后缀)
✅ 核心能力 4:数据排序 & 去重 & 截取
对集合元素自然排序(数字升序、字符串字典序)
对对象按指定属性排序(比如:按年龄升序、按 ID 降序、多字段排序)
对集合去重(基本类型直接去重、对象按属性去重)
截取前 N 个元素、跳过前 N 个元素
✅ 核心能力 5:数据统计 & 聚合
统计数量(替代list.size(),支持筛选后统计)
数值类聚合:求最大值、最小值、平均值、总和
对象类聚合:找属性最大 / 最小的对象
✅ 核心能力 6:数据匹配 & 查找
判断集合中是否存在符合条件的元素
判断集合中全部元素都符合条件
判断集合中没有符合条件的元素
查找任意一个符合条件的元素、查找第一个符合条件的元素
✅ 核心能力 7:数据收集 & 归约
将处理后的流,重新封装为List/Set/Map集合(流式处理的收尾操作)
将所有元素聚合为一个值(比如:所有数字求和、所有字符串拼接成一个长字符串)
○ Stream流的操作
✔️ Stream 的操作[三步走:开流 -> 干活 -> 收尾]
开流:
集合.stream() 就这一句话,意思是「打开数据流,准备处理这个集合里的所有数据」;
干活:
调用各种方法[中间操作](比如挑数据、改数据、排序),可以连着调用多个(比如:先挑数据,再改数据,再排序);
收尾:
必须调用一个「收尾方法」,意思是「处理完了,给我结果 / 结束操作」;
✅ 关键坑:只开流、只干活,不收尾 → 等于啥都没做!代码白写!
数据:
@Data
public class User {
    private Integer id;       // 用户ID
    private String name;      // 用户名
    private Integer age;      // 年龄
    private String status;    // 状态
}
List<User> userList = new ArrayList<>();
        userList.add(new User(1, "张三", 20, "正常"));
        userList.add(new User(2, "李四", 22, "禁用"));
        userList.add(new User(3, "王五", 25, "正常"));
        userList.add(new User(4, "张三", 18, "正常"));
△ 中间操作
1:过滤筛选:filter(条件)
作用:筛选出符合条件的元素,条件是 Lambda 表达式,返回布尔值
// 示例1:筛选年龄>20的用户
        userList.stream().filter(user -> user.getAge() > 20).forEach(System.out::println);
        // 示例2:多条件筛选(年龄>=18 且 状态为正常 且 ID不为空)
        userList.stream().filter(user -> user.getAge()>=18
                && "正常".equals(user.getStatus())
                && user.getId() != null).forEach(System.out::println);
2:映射转换:map(处理逻辑)
作用:对每个元素做「转换 / 加工」,返回新的元素;核心能力:提取属性、类型转换、数据计算
// 示例1:提取属性 → 从User集合中提取所有用户名,得到List<String>
        List<String> nameList = userList.stream().map(User::getName).collect(Collectors.toList());
        nameList.forEach(System.out::println);

        // 示例2:数据计算 → 所有用户年龄+5
        userList.stream().map(user -> user.getAge() +5).forEach(System.out::println);

        // 示例3:类型转换 → Integer转String
        List<Integer> numList = Arrays.asList(1,2,3);
        List<String> strList = numList.stream().map(String::valueOf).collect(Collectors.toList());
        strList.forEach(System.out::println);
3:遍历处理:peek(处理逻辑)
作用:遍历每个元素,执行处理逻辑(比如赋值、修改属性),返回值还是流,可以继续链式调用
✔️ 和 forEach 的区别:peek 是「中间方法」(可继续链式调用),forEach 是「终止方法」(调用后流关闭),循环赋值优先用 peek!
// 示例:遍历赋值,给所有状态为正常的用户,修改备注(实际开发赋值首选)
        userList.stream().filter(user -> "正常".equals(user.getStatus()))
                .peek(user -> user.setName(user.getName() + "-VIP")) // 赋值
                .peek(user -> user.setAge(user.getAge()+1)).collect(Collectors.toList()) // 继续赋值
                .forEach(System.out::println);
4:去重:distinct()
作用:去除集合中的重复元素,基本类型直接去重,对象默认按「地址」去重,对象去重配合 filter/map 使用
// 示例1:基本类型去重
List<Integer> numList = Arrays.asList(1,2,2,3,3,3);
numList.stream().distinct(); // 结果:[1,2,3]

// 示例2:对象去重(比如:去重同名的用户)
userList.stream().map(User::getName).distinct();
5:排序:sorted() / sorted(Comparator)
作用:对元素排序;无参是「自然排序」,有参是「自定义属性排序」,对象排序必用有参!
// 示例1:自然排序(数字升序、字符串字典序)
        List<Integer> numList = Arrays.asList(3,1,2);
        numList.stream().sorted().forEach(System.out::println); // 结果:[1,2,3]
        // 示例2:对象按单个属性排序 → 按年龄升序
        userList.stream().sorted(Comparator.comparing(User::getAge)).forEach(System.out::println);
        // 示例3:对象按单个属性降序 → 按ID降序
        userList.stream().sorted(Comparator.comparing(User::getId).reversed()).forEach(System.out::println);
        // 示例4:对象多字段排序 → 先按状态升序,再按年龄降序
        userList.stream().sorted(Comparator.comparing(User::getStatus)
                .thenComparing(User::getAge).reversed()).forEach(System.out::println);
6:截取 / 跳过:limit(n) / skip(n)
limit(n):只保留前 n 个元素
skip(n):跳过前 n 个元素,保留后面的元素
// 示例1:只取前2个用户
userList.stream().limit(2);
// 示例2:跳过前1个,取后面的所有元素
userList.stream().skip(1);
△ 终止方法
1:遍历执行:forEach(处理逻辑)
作用:遍历流中所有元素,执行处理逻辑(无返回值 void),最常用的「循环赋值」方式
// 示例1:纯赋值 → 给所有用户设置状态为正常
userList.stream().forEach(user -> user.setStatus("正常"));
// 示例2:带条件赋值 → 给年龄>20的用户设置备注
userList.stream().filter(user -> user.getAge()>20)
        .forEach(user -> user.setRemark("成年用户"));
// 示例3:打印数据
userList.stream().forEach(System.out::println);
2:收集结果:collect(Collectors.xxx)
作用:将处理后的流,转换为集合 / 其他数据结构,返回值是集合,是 Stream 中最核心的终止方法
// 示例1:收集为List集合(最常用)
List<User> filterList = userList.stream().filter(user -> user.getAge()>20).collect(Collectors.toList());
// 示例2:收集为Set集合(自动去重)
Set<String> nameSet = userList.stream().map(User::getName).collect(Collectors.toSet());
// 示例3:收集为Map集合(比如:ID为key,User对象为value)
Map<Integer, User> userMap = userList.stream().collect(Collectors.toMap(User::getId, user -> user));

// 拓展:高级收集(开发常用)
// 分组 → 按状态分组,key=状态,value=对应状态的用户集合
Map<String, List<User>> statusGroup = userList.stream().collect(Collectors.groupingBy(User::getStatus));
// 统计数量 → 按状态分组后,统计每组的用户数
Map<String, Long> statusCount = userList.stream().collect(Collectors.groupingBy(User::getStatus, Collectors.counting()));
3:统计数量:count()
作用:统计流中元素的个数,返回值 long 类型,替代传统的list.size(),支持筛选后统计
// 示例1:统计总用户数
long total = userList.stream().count();
// 示例2:统计年龄>20的用户数(开发高频)
long adultCount = userList.stream().filter(user -> user.getAge()>20).count();
4. 匹配判断:anyMatch / allMatch / noneMatch
作用:判断流中元素是否符合指定条件,返回值 boolean 类型,业务中做「条件判断」的核心方法
anyMatch(条件):是否存在至少一个符合条件的元素 → 有一个就返回 true
allMatch(条件):是否全部元素都符合条件 → 全符合才返回 true
noneMatch(条件):是否没有任何一个符合条件的元素 → 全不符合才返回 true
// 示例1:判断是否存在年龄>25的用户
boolean hasAdult = userList.stream().anyMatch(user -> user.getAge()>25);
// 示例2:判断所有用户的状态都是正常
boolean allNormal = userList.stream().allMatch(user -> "正常".equals(user.getStatus()));
// 示例3:判断没有ID为0的用户
boolean noZeroId = userList.stream().noneMatch(user -> user.getId() == 0);
5:查找元素:findAny() / findFirst()
作用:查找流中的元素,返回值 Optional 类型(避免空指针),配合 filter 使用,查找符合条件的元素
findAny():返回流中任意一个元素(并行流中效率高)
findFirst():返回流中第一个元素
// 示例1:查找第一个年龄>20的用户
Optional<User> firstUser = userList.stream().filter(user -> user.getAge()>20).findFirst();
// 安全取值(Optional避免空指针)
firstUser.ifPresent(user -> System.out.println(user.getName()));

// 示例2:查找任意一个状态为禁用的用户
Optional<User> disableUser = userList.stream().filter(user -> "禁用".equals(user.getStatus())).findAny();
6:聚合最值:max() / min()
作用:查找流中的最大值 / 最小值,返回值 Optional 类型,支持数值 / 对象属性的最值
// 示例1:查找年龄最大的用户
Optional<User> maxAgeUser = userList.stream().max(Comparator.comparing(User::getAge));
// 示例2:查找ID最小的用户
Optional<User> minIdUser = userList.stream().min(Comparator.comparing(User::getId));
// 示例3:数值集合的最大值
List<Integer> numList = Arrays.asList(1,2,3);
Optional<Integer> maxNum = numList.stream().max(Integer::compare);
7:归约聚合:reduce()
作用:将流中所有元素聚合为一个值(比如:求和、求积、拼接字符串),返回 Optional 类型,开发中数值聚合常用
// 示例1:所有用户的年龄求和
Optional<Integer> sumAge = userList.stream().map(User::getAge).reduce(Integer::sum);
// 示例2:数值集合求和,指定初始值0
int sum = Arrays.asList(1,2,3).stream().reduce(0, Integer::sum);
// 示例3:拼接所有用户名,用逗号分隔
String nameStr = userList.stream().map(User::getName).reduce("", (a,b) -> a + "," + b);
● 面向对象
面向过程:
关注「步骤」,我要做一件事,得拆解成「第一步做什么、第二步做什么、第三步做什么」,所有步骤自己写,从头到尾指挥到底。
面向对象
关注「谁来做」,我要做一件事,先找「能做这件事的东西 / 人」,然后直接喊它来做,我不用管它具体怎么完成的。
○ 封装
封装 = 把东西「装起来」,对外只留「能用的门」,内部的东西不让外人乱碰、乱改。
比如:你的手机 → 手机内部有电池、主板、芯片这些核心零件(内部东西),都被手机外壳「封装」起来了,你看不到也摸不到;手机只给你留了屏幕、按键、充电口这些「能用的门」,你只能通过这些门来用手机,不能直接去抠主板。
好处:
① 安全:不会被乱改内部零件导致坏了;
② 方便:你不用懂内部原理,只用会用按键就行。
public class User {
    // 1. 把【属性】私有化:private修饰 → 相当于手机的内部零件,藏起来,外部不能直接改
    private Integer id;       // 用户ID
    private String name;      // 用户名
    private Integer age;      // 年龄
    private String status;    // 状态

    // 2. 对外只留【能用的门】:提供get/set方法 → 相当于手机的按键,外部只能通过这些方法操作属性
    public Integer getId() {
        return id;
    }

    public void setId(Integer id) {
        this.id = id;
    }

    public String getName() {
        return name;
    }

    public void setName(String name) {
        this.name = name;
    }

    public Integer getAge() {
        return age;
    }

    public void setAge(Integer age) {
        // 还能加规则:比如年龄不能是负数,非法数据直接拦截,这就是封装的安全!
        if(age < 0) {
            this.age = 0;
        } else {
            this.age = age;
        }
    }

    public String getStatus() {
        return status;
    }

    public void setStatus(String status) {
        this.status = status;
    }
}
○ 继承
继承 = 儿子继承父亲的「特征和本事」,儿子不用重新学,直接能用;儿子还能有自己的「新特征、新本事」,甚至能把父亲的本事改得更好。
比如:你(儿子)继承了你父亲的「黑头发、大眼睛」这些特征,也继承了「吃饭、走路」这些本事;你不用重新学走路,直接就会;同时你还有自己的新本事(比如编程),还能把父亲的「做饭」本事改得更好吃。
子类能直接用父类的所有属性和方法,不用重新写;
子类能新增自己的属性和方法;
图来自[https://www.bilibili.com/video/BV1fh411y7R8/?spm_id_from=333.337.search-card.all.click&vd_source=cc7c91e214cab08f67a0c0a813c18647]
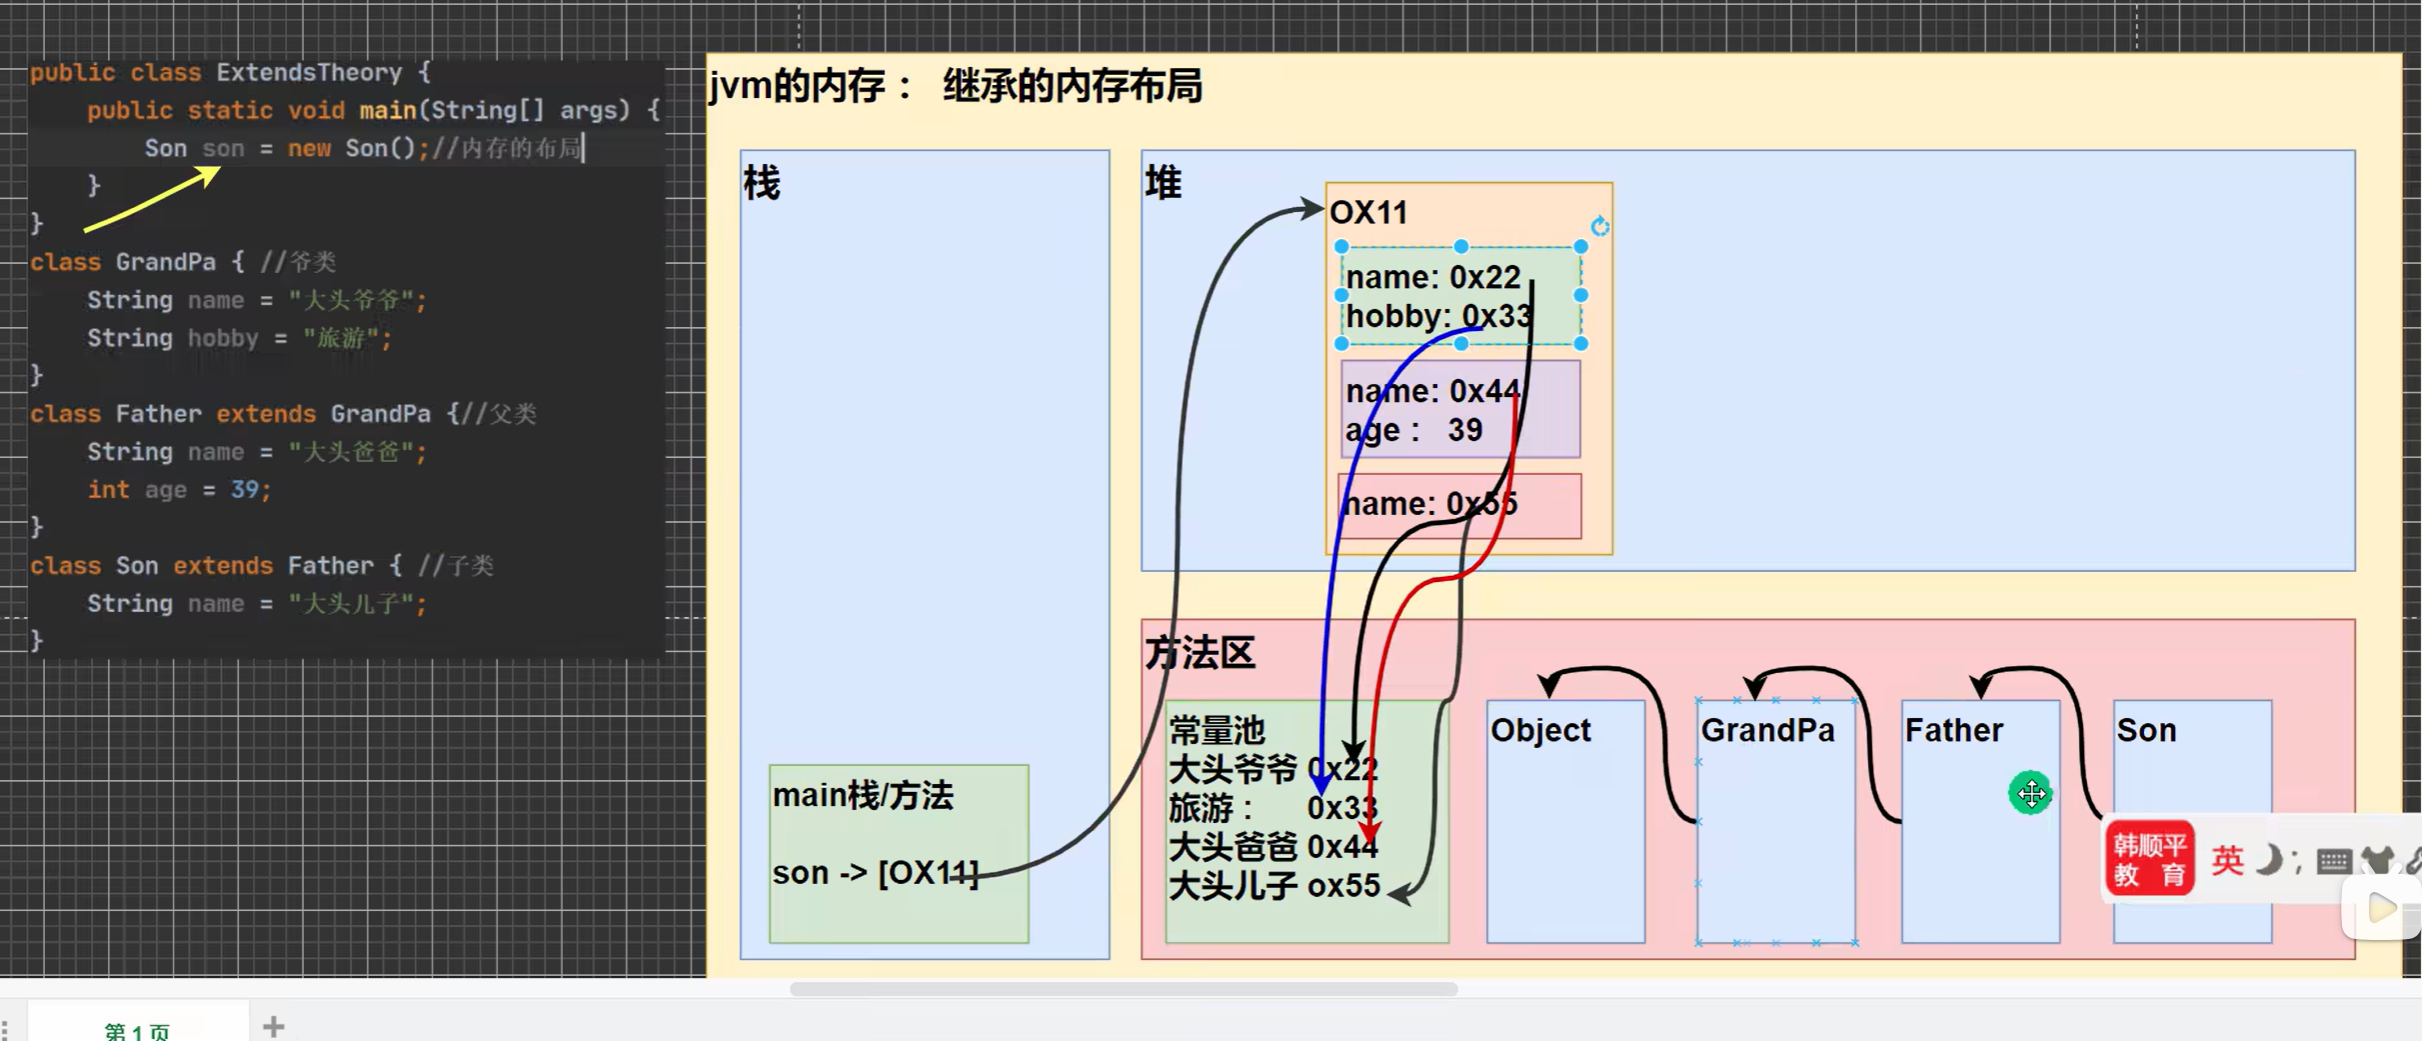
方法区依次加载main方法以及son到object的class字节码并加载其类内信息——main方法压栈创建局部变量son——堆内开辟son对象内存空间——这个空间存储了son的属性及其父类的属性——属性的赋值是常量的都存在方法区基本数据类型则在堆内——堆内存对象赋值给son变量——son内存存储了其父类的变量及属性值不管是不是private和protected——访问son的变量时如果son也有和父类一样的属性则优先访问son的属性——没有的话就访问在son内存内的其父类的属性值(依次从父亲——爷爷访问)(如果是public或protected可以访问的话)
ps:继承后的子对象内存内存父类及父类的父类属性和方法因此可以直接用访问
// 父类:人类,定义了所有人都有的特征和行为
public class Person {
    private String name;
    private Integer age;
    public void eat() {
        System.out.println(name + "在吃饭");
    }
}
// 子类:学生类,继承人类 → 不用写name、age、eat(),直接能用
public class Student extends Person {
    // 1. 新增自己的属性 → 学生特有的:学号
    private String studentId;

    // 2. 新增自己的方法 → 学生特有的:上课
    public void goToClass() {
        System.out.println(getName() + "去上课");
    }

    // 3. 重写父类的方法 → 把父亲的"吃饭"改一下,学生吃饭更快
    @Override
    public void eat() {
        System.out.println(getName() + "狼吞虎咽的吃饭");
    }
}
继承的好处:减少代码重复
比如学生、老师、员工,都是人,都有姓名、年龄、吃饭走路的行为,不用在每个类里都写一遍,只需要写一个父类,子类继承就行,大大减少代码量,后期改起来也方便。
○ 多态
多态 = 「同一个动作 / 指令」,不同的对象做出来,效果完全不一样。
[总结一句话:父类型引用指向子类型的对象]
例如:
指令都是:「叫一声」
狗 听到后 → 汪汪汪的叫;
猫 听到后 → 喵喵喵的叫;
鸡 听到后 → 咯咯咯的叫;
人 听到后 → 喊一声「哎」。
// 父类:动物类,定义一个"叫"的方法
public class Animal {
    public void shout() {
        System.out.println("动物叫了一声");
    }
}

// 子类:狗,重写"叫"的方法
public class Dog extends Animal {
    @Override
    public void shout() {
        System.out.println("汪汪汪");
    }
}

// 子类:猫,重写"叫"的方法
public class Cat extends Animal {
    @Override
    public void shout() {
        System.out.println("喵喵喵");
    }
}

// 测试:同一个指令,不同对象,执行不同结果
public static void main(String[] args) {
    Animal animal1 = new Dog(); // 父类引用 指向 子类对象
    Animal animal2 = new Cat(); // 父类引用 指向 子类对象

    animal1.shout(); // 执行狗的叫 → 汪汪汪
    animal2.shout(); // 执行猫的叫 → 喵喵喵
}
○ this/super关键字
this
图来自[https://www.bilibili.com/video/BV1fh411y7R8/?spm_id_from=333.337.search-card.all.click&vd_source=cc7c91e214cab08f67a0c0a813c18647]
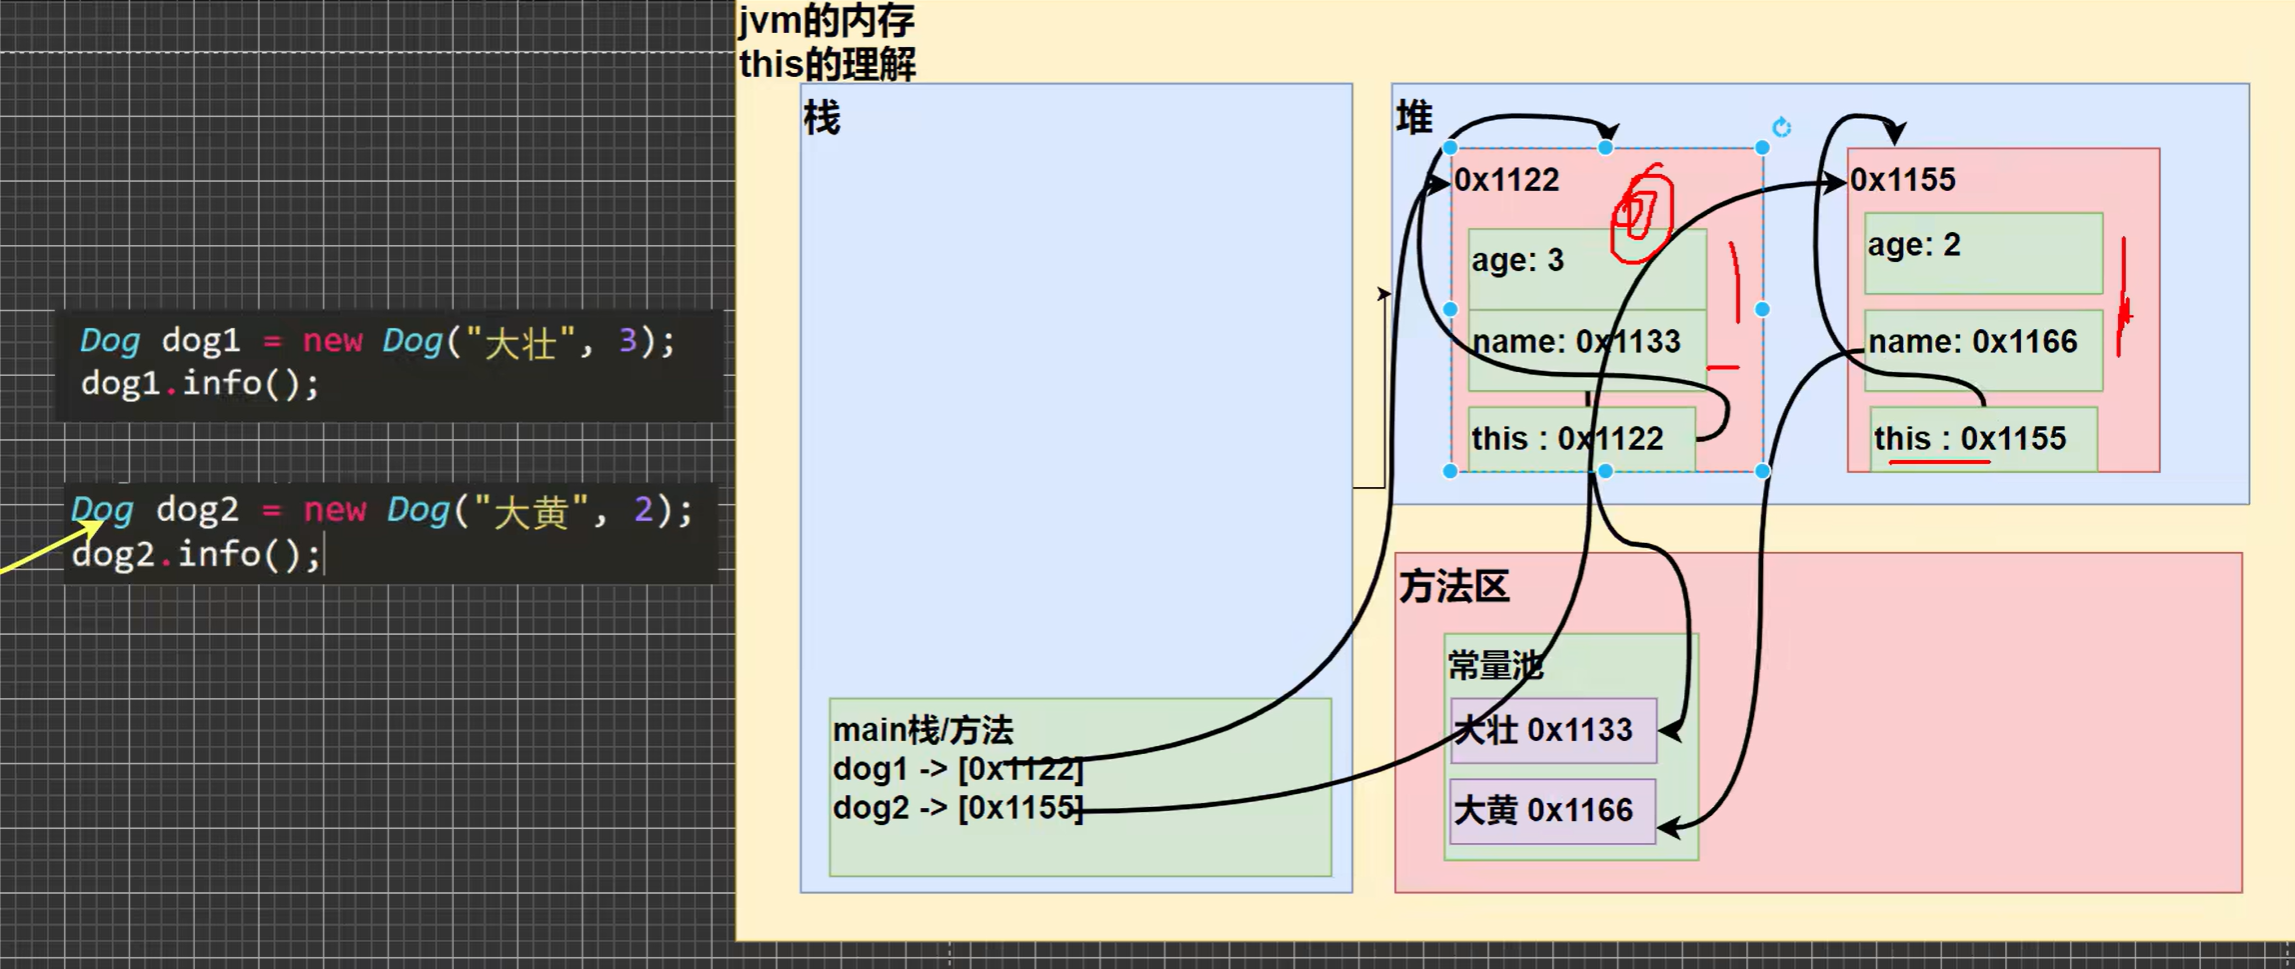
this关键在在堆内对象空间内的一块地址空间,这个地址指向的是对象本身的地址
super
super则是在对象内存内直接跳过子类的成员属性和方法等直接访问超类的
○ 动态绑定机制
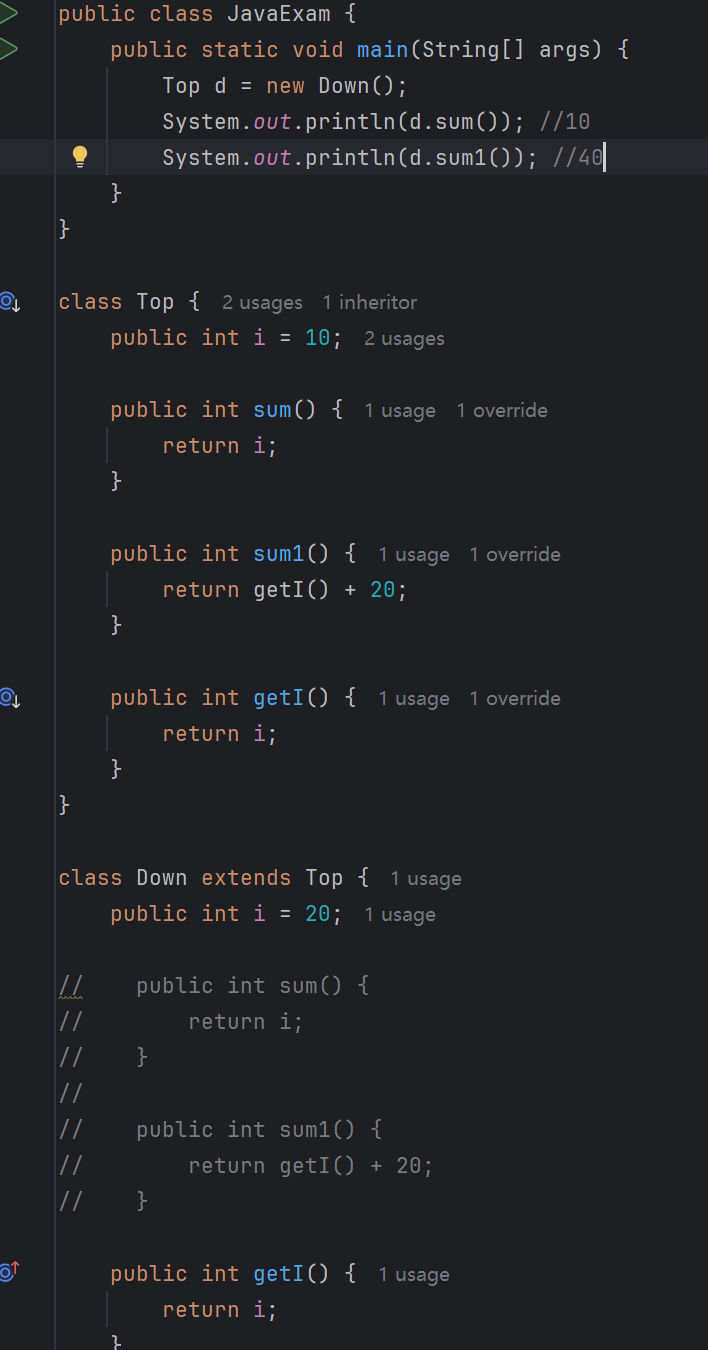
动态绑定:执行子类不存在父类存在的方法时,当这个方法中存在父子都存在的方法就会触发动态绑定机制,外方法sum1执行父类而里面getI执行的是子类的
○ 作用域
全局变量与局部变量:
局部变量未赋值不能直接使用而全局变量可以
全局变量默认初始化时会创建默认值
访问变量使用就近原则,全局与局部一样的变量名如果是局部访问则使用局部变量的
静态域:
static = 静态的,被 static 修饰的所有东西(变量、方法、代码块),统称为「静态域」。
【静态成员变量】→ 存在「方法区」的类模板里
比如:static String className = “一班”,这个值存在「方法区的 User 类模板 也就是加载的class内」里;
核心原因:静态变量属于「类」,不属于对象,类一加载,方法区就会创建这个类的模板,静态变量就跟着加载好了,早于所有对象的创建;
静态变量与方法被所有的对象实例(运行类型)共享
代码块:
你之前写的方法里的代码、循环里的代码,其实都是代码块,Java 里给代码块分了类,不同的代码块有「不同的执行时机」—— 不用手动调用,到了特定的时间,代码块会「自动执行」 ,这就是代码块的核心!
静态代码块 > 构造代码块 > 普通代码块
✔️ ① 普通代码块 —— 最普通:方法里的代码块
定义:写在 方法里、循环里、if 里 的 {} 代码块,就是普通代码块;
执行时机:调用方法的时候,执行到这个代码块,才会运行;
作用:把方法里的代码「分组」,让逻辑更清晰,没别的特殊作用;
public class Student {
    public void test() {
        System.out.println("方法开始");
        // 普通代码块
        {
            int a = 10;
            System.out.println("普通代码块执行:" + a);
        }
        System.out.println("方法结束");
    }
    public static void main(String[] args) {
        new Student().test(); // 调用方法,才会执行代码块
    }
}
✔️ ② 构造代码块 —— 核心:对象出生时「自动执行」,在构造方法前执行
定义:写在 类里、所有方法外面 的 {} 代码块,没有任何修饰符,就是构造代码块;
执行时机:每次 new 一个对象的时候,都会自动执行,而且执行在「构造方法」之前;
核心作用:给所有对象统一初始化属性,不用在每个构造方法里重复写初始化代码,减少重复代码;
public class Student {
    String name;
    // 构造代码块 ✔️
    {
        name = "李四";
        System.out.println("构造代码块执行了");
    }
    // 构造方法
    public Student() {
        System.out.println("构造方法执行了");
    }
    public static void main(String[] args) {
        new Student(); // new对象,自动执行:构造代码块 → 构造方法
    }
}
// 运行结果:
// 构造代码块执行了
// 构造方法执行了
✔️ ③ 静态代码块 —— 重中之重:类加载时「自动执行,只执行一次」
定义:写在 类里、所有方法外面 的 static {} 代码块,加了 static 修饰,就是静态代码块;
执行时机:类一加载,立刻执行,而且整个程序运行期间,只执行一次;
优先级:所有代码块里最高的,早于构造代码块、构造方法、普通代码块;
核心作用:初始化静态变量、加载全局的静态资源(比如加载配置文件、初始化工具类),因为只执行一次,效率极高;
public class Student {
    static String className;
    // 静态代码块 ✔️ 优先级最高
    static {
        className = "一班";
        System.out.println("静态代码块执行了");
    }
    // 构造代码块
    {
        System.out.println("构造代码块执行了");
    }
    // 构造方法
    public Student() {
        System.out.println("构造方法执行了");
    }
    public static void main(String[] args) {
        System.out.println("main方法开始");
        new Student(); // 第一次new对象
        new Student(); // 第二次new对象
    }
}
● Java IO
Java IO 流的四大顶级抽象父类 → 所有 IO 流都是它们的子类,这 4 个类是「根」
1:字节输入流:InputStream
2:字节输出流:OutputStream
3:字符输入流:Reader
4:字符输出流:Writer
InputStream/OutputStream/Reader/Writer → 都是抽象父类,是 IO 流的「设计图纸」,不能直接 new 对象使用,只定义了【读 / 写】的统一规则,所有子类都继承它们、实现具体功能;
子类:
InputStream:
- FileInputStream [字节输入流]
- BufferedInputStream[字节输入缓冲流]
- ObjectInputStream[对象字节输入流]
- ByteArrayInputStream[内存字节输入流]
OutputStream:
- FileOutputStream [文件字节输出流]
- BufferedOutputStream [字节缓冲输出流]
- ByteArrayOutputStream [内存字节输出流]
- ObjectOutputStream [对象输出流]
Reader:
- FileReader [文件字符输入流]
- BufferedReader [字符缓冲输入流]
- InputStreamReader [字符转换输入流]
Writer:
- FileWriter [文件字符输出流]
- BufferedWriter [字符缓冲输出流]
- OutputStreamWriter [字符转换输出流]
○ File类
java.io.File不是IO流;它是「文件 / 文件夹的路径工具类」,专门操作文件 / 文件夹本身(比如创建文件、判断是否存在、删除文件夹),不负责读写文件内容,但所有操作文件的 IO 流,都必须依赖 File 类指定「要操作的文件路径」。
判断类(最常用)
file.exists() → 判断文件 / 文件夹是否存在
file.isFile() → 判断当前路径是不是【文件】(不是文件夹)
file.isDirectory() → 判断当前路径是不是【文件夹】
创建 / 删除类
file.createNewFile() → 创建【空文件】,文件夹不存在会报错
file.mkdir() → 创建【单级文件夹】(比如 D:/test)
file.mkdirs() → 创建【多级文件夹】(比如 D:/test/a/b/c,推荐用这个)
file.delete() → 删除【文件】或【空文件夹】
获取信息类
file.getAbsolutePath() → 获取文件「绝对路径」(比如 D:/test.txt)
file.getName() → 获取文件名(比如 test.txt)
file.length() → 获取文件大小(单位:字节)
file.listFiles() → 获取当前文件夹下的子文件及文件夹
○ 类加载器
它是什么
Java 类加载器(java.lang.ClassLoader)是 JVM 的核心子系统,本质是一个 Java 类,核心使命是:负责将 .class 字节码文件加载到 JVM 内存中,并生成对应的 java.lang.Class 对象,同时提供一系列读取项目资源的 API。
一句话总结:
Java 程序能运行、项目里的资源能读取,全靠类加载器,它是连接「字节码文件 / 项目资源」和「JVM 运行时」的桥梁。
核心加载规则
✅ 按需加载、懒加载:JVM 不会一次性加载所有类,而是程序运行到用到某个类时,才会触发类加载器加载,比如你调用new User(),才会加载User.class,极大节省内存;
✅ 加载一次,永久缓存:同一个类加载器,对同一个全类名(如com.test.User)的类,只会加载一次,加载后会缓存到 JVM 中,后续再使用直接从缓存取,不会重复加载;
✅ 双亲委派机制:Java 类加载器的核心安全机制,子类加载器加载类时,会先委托父类加载器加载,父类加载不到才会自己加载,目的是保证核心类(如java.lang.String)不会被篡改,保证程序安全。
△ 双亲委派机制
Java 内置的「三大类加载器」+ 严格的父子层级关系
Java 给我们提供了 3 个核心的内置类加载器,它们不是平级的,而是存在 「自上而下的严格父子继承关系」,双亲委派的全部逻辑都基于这个层级执行,这是最核心的前提!
【顶层】启动类加载器 (Bootstrap ClassLoader)
        ↓ 父类
    扩展类加载器 (Extension ClassLoader)
        ↓ 父类
【底层】应用程序类加载器 (Application ClassLoader)
各加载器的核心职责:
启动类加载器(Bootstrap):
C++ 编写,JVM 原生组件,负责加载 JDK 核心类库(JAVA_HOME/jre/lib 下的 jar 包,如 rt.jar),比如java.lang.String、java.lang.Object、java.util.ArrayList这些所有 Java 程序的基础核心类,都由它加载。Java 代码中获取该类加载器会返回 null。
扩展类加载器(Extension):
Java 编写,负责加载 JDK 扩展类库(JAVA_HOME/jre/lib/ext 下的 jar 包),是对核心类库的补充,父加载器是启动类加载器。
应用程序类加载器(App):
Java 编写,开发中我们接触到的所有类加载器都是它!负责加载:我们自己写的业务类、Maven 引入的第三方依赖(JUnit、Spring、Mybatis)、src/main/resources下的所有资源文件。父加载器是扩展类加载器。
什么是「双亲」?
很多人会误解「双亲」是「父母两个加载器」,这是错误的!
双亲委派中的「双亲」 = parent 父加载器,本质是「单亲委派」,指的是:每一个类加载器都有且仅有一个父加载器,子类加载器在干活前,一定会先找自己的父加载器帮忙。
假设你在自己的项目中,写了一个类:
package java.lang; // 和核心类的包名+类名完全一致
public class String {
    // 写一段恶意代码
    public String() {
        System.out.println("我是恶意的String类,我被加载了!");
    }
}
你觉得这个类会被加载吗?答案是:永远不会!
执行流程:
当你尝试使用这个类时,App 加载器收到请求,委派给扩展加载器,再委派给启动加载器;
启动加载器在rt.jar中已经找到了 JDK 原生的java.lang.String类,并完成加载,直接返回该类的 Class 对象;
整个流程结束,你的自定义java.lang.String类永远不会被加载,你的恶意代码永远不会执行!
安全结论:
双亲委派机制通过「顶层加载核心类」的规则,彻底杜绝了开发者自定义、篡改 Java 核心类的可能性,核心类的加载权完全由 JVM 掌控,任何人都无法替换,这是 Java 最坚固的安全防线!
△ 类加载器使用
使用类加载器获取maven项目resource下的路径
Maven 的标准资源目录是:项目根目录/src/main/resources
✅ 核心特性:
该目录下的所有文件 / 文件夹,Maven 编译、打包时会自动复制到项目的 classpath 根目录(编译后路径是 target/classes/)
不管是 IDE 中运行项目,还是打包成 jar/war 运行,resources 下的资源最终都是classpath 内的资源,这是读取该目录的核心依据
获取classpath(target/classes)路径:
Maven 打包后,src/main/resources 下的所有内容,都会被放到项目的 classpath 根目录(target/classes/)
Java 中读取 classpath 内的资源,标准做法是通过 ClassLoader 类加载器 获取资源路径,而非直接 new File ()
ClassLoader 的 getResource() 方法,会从 classpath 根目录开始查找资源,返回资源的 URL 路径,完美匹配 Maven 的资源目录规则
普通方法:
URL resource = this.getClass().getClassLoader().getResource("");

静态方法:
URL resource = 类名.class.getClassLoader().getResource("");

打印出来的是target/classes/
如果是target/classes/com/XXX
则需要在getResource("../../")即可
○ 字节输入输出流
[万能流但效率慢 按字节(8bit)传输 推荐二进制文件]
流的操作必须处理IOException:所有 IO 流的创建和读写方法都会抛出此异常,必须用try-catch捕获,或用throws声明。
文件路径的写法:
绝对路径:D:/test.txt(Windows)、/home/test.txt(Linux),注意用/而非\(\是转义字符)。
相对路径:test.txt(项目根目录)、src/main/resources/test.txt(资源目录)。
△ FileInputStream
(字节输入流:读文件)
核心作用
从硬盘文件中读取字节数据到内存。
| new FileInputStream(String path) | new FileInputStream(File file) |
|---|---|
| 通过文件路径创建流,文件不存在则抛FileNotFoundException | 通过File对象创建流,推荐(可先判断文件是否存在) |
int read()	读取 1 个字节,返回字节的 ASCII 值,读完返回-1
int read(byte[] buffer)	读取字节到缓冲区,返回实际读取的字节数,读完返回-1
void close()	关闭流,释放资源(try-with-resources 自动调用)
public void test() {
        //创建File读取文件
        URL resource = TestServiceImpl.class.getClassLoader().getResource("");
        File file = new File(resource.getFile(), "test.txt");

        if (file.exists()) {

            //try-with-resources 自动关闭资源 自动调用fis.close()
            try (FileInputStream fis = new FileInputStream(file)) {

                byte[] bytes = new byte[1024]; // 缓冲区:一次读1024字节(1KB),越大效率越高

                int read = 0; // 记录实际读取的字节数

                while ((read = fis.read(bytes)) != -1) {
                    // 4. 转换为字符串输出(注意:字节流读中文可能乱码,文本文件推荐用字符流)
                    System.out.print(new String(bytes, 0, read));
                }

            } catch (IOException e) {
                System.out.println(e.getMessage());
            }

        }
    }
△ FileOutputStream
(字节输出流:写文件)
核心作用
将内存中的字节数据写入硬盘文件。
| new FileOutputStream(String path) | new FileOutputStream(String path, boolean append) | new FileOutputStream(File file, boolean append) |
|---|---|---|
| 覆盖写入:文件不存在则创建,存在则清空原有内容 | 追加写入:append=true时,在文件末尾追加内容,不覆盖 | 通过File对象创建,推荐 |
void write(int b)	写入 1 个字节
void write(byte[] buffer)	写入整个字节数组
void write(byte[] buffer, int off, int len)	写入字节数组的一部分(off:起始索引,len:写入长度)
void flush()	刷新缓冲区(字节流可省略,缓冲流必须调用)
public void fileOutputStreamTest() {
        if (resource == null) return;
        File file = new File(resource.getFile(), "test.txt");
        if (file.exists()) {
            //创建追加文本的输出流
            try (FileOutputStream fos = new FileOutputStream(file, true)) {
                //定义要写入的文本
                String content = "Hello World\n";
                //写入文件
                //fos.write(content.getBytes());
                //第二种写法 如果是拷贝文件 必须使用此方法 不然会读到空数据导致文件损坏
                fos.write(content.getBytes(), 0, content.getBytes().length);

                //刷新流
                fos.flush();
            } catch (IOException e) {
                System.out.println(e.getMessage());
            }
        }
    }
△ 装饰者模式[Buffered流]
✅ 作用:给「字节输入流」套一个内存缓冲区,增强读取效率;
✅ 核心原理:普通字节流是「一滴一滴读」(读 1 字节就和硬盘交互 1 次),缓冲流是「攒够了再读」(先把字节读到内存缓冲区,攒够 8KB 再返回),减少硬盘交互次数,效率提升 10 倍以上;
✅ 特点:不能独立使用,必须「套娃」包裹一个底层字节流(比如 FileInputStream),这叫「装饰者模式」;
✅ 用法:new BufferedInputStream(new FileInputStream(“test.txt”));
✅ 核心优势:方法和 FileInputStream 完全一样,不用改任何代码,只需要套一层,效率直接拉满。
Java 装饰者模式(Decorator Pattern)是一种结构型设计模式,核心目的是在不修改原有对象代码、不破坏原有结构的前提下,动态地给对象添加额外功能,相比继承更灵活。
以(咖啡订单)为例:
1:抽象组件(Coffee)
定义咖啡的核心功能:描述和价格
// 抽象组件:定义咖啡的核心行为
public interface Coffee {
    // 获取咖啡描述
    String getDescription();
    // 获取咖啡价格
    double getCost();
}
对应IO的InputStream
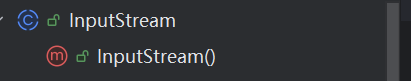
2:抽象装饰者(CoffeeDecorator)
持有咖啡对象的引用,作为装饰者的父类
// 抽象装饰者:持有咖啡对象,统一装饰者的结构
public abstract class CoffeeDecorator implements Coffee {
    // 持有被装饰的咖啡对象(核心:组合而非继承)
    protected Coffee coffee;

    public CoffeeDecorator(Coffee coffee) {
        this.coffee = coffee;
    }
}
对应IO的FilterInputStream
源码:
public class FilterInputStream extends InputStream {
    /**
     * The input stream to be filtered.
     */
    protected volatile InputStream in;
3:具体组件(AmericanCoffee)
基础咖啡,提供核心功能的实现
// 具体组件:基础美式咖啡(被装饰的原始对象)
public class AmericanCoffee implements Coffee {
    @Override
    public String getDescription() {
        return "美式咖啡";
    }

    @Override
    public double getCost() {
        return 10.0; // 基础价格
    }
}
对应IO的FileInputStream
4:具体装饰者(牛奶 / 糖)
给咖啡添加具体功能(额外描述 + 价格)
// 具体装饰者1:加牛奶
public class MilkDecorator extends CoffeeDecorator {
    public MilkDecorator(Coffee coffee) {
        super(coffee);
    }

    @Override
    public String getDescription() {
        // 保留原有描述,添加新功能
        return coffee.getDescription() + " + 牛奶";
    }

    @Override
    public double getCost() {
        // 原有价格 + 牛奶的费用
        return coffee.getCost() + 2.0;
    }
}

// 具体装饰者2:加糖
public class SugarDecorator extends CoffeeDecorator {
    public SugarDecorator(Coffee coffee) {
        super(coffee);
    }

    @Override
    public String getDescription() {
        return coffee.getDescription() + " + 糖";
    }

    @Override
    public double getCost() {
        return coffee.getCost() + 1.0;
    }
}
对应IO的BufferedInputStream
public class BufferedInputStream extends FilterInputStream {
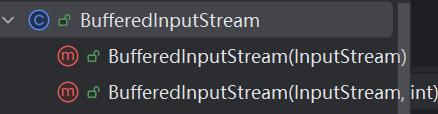
测试:
public class DecoratorTest {
    public static void main(String[] args) {
        // 1. 基础美式咖啡
        Coffee coffee = new AmericanCoffee();
        System.out.println(coffee.getDescription() + " | 价格:" + coffee.getCost());

        // 2. 动态添加牛奶(装饰一次)
        coffee = new MilkDecorator(coffee);
        System.out.println(coffee.getDescription() + " | 价格:" + coffee.getCost());

        // 3. 再动态添加糖(多层装饰)
        coffee = new SugarDecorator(coffee);
        System.out.println(coffee.getDescription() + " | 价格:" + coffee.getCost());
    }
}
结果:
美式咖啡 | 价格:10.0
美式咖啡 + 牛奶 | 价格:12.0
美式咖啡 + 牛奶 + 糖 | 价格:13.0
对应IO:
public void bufferedInputStreamTest() {
        if (resource == null) return;
        File file = new File(resource.getFile(), "test.txt");
        if (file.exists()) {
            //使用基础组件FileInputStream被BufferedInputStream进行装饰 装饰后让FileInputStream具有缓冲流功能
            //还可以在装饰一个转换流 在转换流有写
            try (BufferedInputStream bis = new BufferedInputStream(new FileInputStream(file))) {
                byte[] bytes = new byte[1024]; // 缓冲区:一次读1024字节(1KB),越大效率越高

                int read = 0; // 记录实际读取的字节数

                while ((read = bis.read(bytes)) != -1) {
                    System.out.println(new String(bytes, 0, read));
                }

            } catch (IOException e) {
                System.out.println(e.getMessage());
            }
        }
    }
○ 字符输入输出流
文件字符流专门用于读写纯文本文件,核心解决字节流读中文的乱码问题,核心类是 FileReader(读)和 FileWriter(写)。
△ FileReader
(字符输入流:读文本)
核心作用
从文本文件中读取字符数据,自动处理中文编码,无乱码。
int read()	读取 1 个字符,返回字符的 Unicode 值,读完返回-1
int read(char[] cbuf)	读取字符到字符数组,返回实际读取的字符数,读完返回-1
public void fileReaderTest() {
        if (resource == null) return;
        File file = new File(resource.getFile(), "test.txt");
        if (file.exists()) {
            try (FileReader fr = new FileReader(file)) {
                char[] cache = new char[1024]; // 字符缓冲区
                int len;

                while ((len = fr.read(cache)) != -1) {
                    // 转换为字符串输出,无中文乱码
                    System.out.print(new String(cache, 0, len));
                }
            } catch (IOException e) {
                System.out.println(e.getMessage());
            }
        }
    }
△ FileWriter
(字符输出流:写文本)
核心作用
将字符数据写入文本文件,自动处理中文编码,无乱码。
void write(int c)	写入 1 个字符
void write(char[] cbuf)	写入字符数组
void write(char[] cbuf, int off, int len)	写入字符数组的一部分
void write(String str)	直接写入字符串
void write(String str, int off, int len)	写入字符串的一部分
public void fileWriterTest() {
        if (resource == null) return;
        File file = new File(resource.getFile(), "test.txt");
        if (file.exists()) {
            try (FileWriter fw = new FileWriter(file, true)) {
                //定义要写入的文本
                String content = "你好世界\n";
                fw.write(content, 0, content.length());
                fw.flush();
            } catch (IOException e) {
                System.out.println(e.getMessage());
            }
        }
    }
○ 对象序列化
- 序列化:输出数据到某地时同时保留数据类型和数据值
- 反序列化:读取数据时还原数据的数据类型和数据值
- 序列化和反序列化时读写顺序要一致
对对象进行序列化必须让类实现Serializable接口
对象输入流[装饰者模式]
ObjectInputStream → 对象输入流(序列化专用)
✅ 作用:读取「序列化后的字节数据」,并还原成 Java 对象(反序列化);
✅ 配套使用:必须和ObjectOutputStream一起用,专门处理 Java 对象的读写;
✅ 适用场景:把对象保存到文件、在网络中传输对象;
✅ 特点:只有实现了Serializable接口的类,才能被它读取。
public void objectInputStreamTest() {
        if (resource == null) return;
        File file = new File(resource.getFile(), "test.txt");
        if (file.exists()) {
            try (ObjectInputStream ois = new ObjectInputStream(new FileInputStream(file))) {
                int i = ois.readInt();
                User user = (User) ois.readObject();
                System.out.println((user.getUsername() + user.getBalance()));
            } catch (IOException | ClassNotFoundException e) {
                System.out.println(e.getMessage());
            }
        }
    }
对象输出流[装饰者模式]
4. ObjectOutputStream → 对象输出流(序列化专用)
✅ 作用:把 Java 对象转换成「序列化的字节数据」,写入到文件 / 网络(序列化);
✅ 配套使用:和 ObjectInputStream 成对出现,实现对象的持久化存储。
public void objectOutputStreamTest() {
        if (resource == null) return;
        File file = new File(resource.getFile(), "test.txt");
        if (file.exists()) {
            try (ObjectOutputStream oos = new ObjectOutputStream(new FileOutputStream(file, false))) {
                oos.writeInt(100); //保存数据时指定数据类型 writeXXX
                oos.writeObject(User.builder().username("张三").balance(1234).build());

                oos.flush();
            } catch (IOException e) {
                System.out.println(e.getMessage());
            }
        }
    }
○ 字符转换流
✅ 作用:字节流 → 字符流 的桥梁,可以手动指定「字符编码」(比如 UTF-8、GBK);
✅ 解决的痛点:FileReader 有个致命缺陷 —— 默认使用系统编码(Windows 是 GBK,Linux 是 UTF-8),如果文件编码和系统编码不一致,还是会乱码!InputStreamReader 可以手动指定编码,彻底解决所有中文乱码问题;
✅ 用法:new InputStreamReader(new FileInputStream(“test.txt”), “UTF-8”);
✅ 开发地位:所有字符流的底层都是它,FileReader 其实就是 InputStreamReader 的简化版(默认系统编码)。
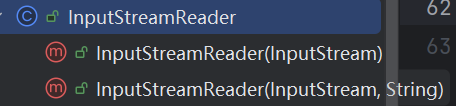
InputStreamReader的构造方法参数为[字节流]
InputStreamReader 的构造方法接收的是 InputStream 而非 Reader,核心原因是:InputStreamReader 是 “字节流” 到 “字符流” 的转换桥梁,它的核心职责就是处理字节流并将其解码为字符流,因此必须以字节流(InputStream)作为输入源,而非已经是字符流的 Reader。
| readLine()方法 |
|---|
| 可以读取文件一行,如果读取结束则返回null可用循环判断 |
public void inputStreamReaderTest() {
        if (resource == null) return;
        File file = new File(resource.getFile(), "test.txt");
        if (file.exists()) {
            try (InputStreamReader isr = new InputStreamReader(new FileInputStream(file), StandardCharsets.UTF_8)) {
                //再次将转换流装饰一下增加缓冲流的功能 [装饰者模式]
                BufferedReader br = new BufferedReader(isr);
                String line;
                while ((line = br.readLine()) != null) {
                    System.out.println(line);
                }
            } catch (IOException e) {
                System.out.println(e.getMessage());
            }
        }
    }
输出流
public void outputStreamWriterTest() {
        if (resource == null) return;
        File file = new File(resource.getFile(), "test.txt");
        if (file.exists()) {
            try (OutputStreamWriter osw = new OutputStreamWriter(new FileOutputStream(file, true),
                    StandardCharsets.UTF_8)) {

                BufferedWriter bw = new BufferedWriter(osw);
                bw.write("你好世界");
                bw.flush();
            } catch (IOException e) {
                System.out.println(e.getMessage());
            }
        }
    }
○ Properties类
它专门解决「硬编码参数」的问题(比如把数据库账号密码写死在代码里),让配置和代码分离,维护起来超方便。
java.util.Properties 是 专门处理 .properties 配置文件的键值对集合类,本质是继承自Hashtable的 Map 集合,但只存String类型的键和值(区别于普通 Map 的 Object 类型)。
setProperty(String key, String value)	往 Properties 对象里设置键值对	相当于 Map 的 put (),但只接受 String

getProperty(String key)	根据键取值,不存在则返回null	最常用的取值方法

getProperty(String key, String defaultValue)	根据键取值,不存在则返回默认值	推荐用这个,避免空指针

load(Reader reader)	从字符流读取配置文件内容	推荐用(支持指定编码,解决中文乱码)

load(InputStream in)	从字节流读取配置文件内容	注意:默认编码是 ISO-8859-1,读中文会乱码

store(Writer writer, String comments)	将键值对写入配置文件(字符流)	comments 是配置文件的注释,可为空

store(OutputStream out, String comments)	将键值对写入配置文件(字节流)	同样有编码问题,推荐用 Writer 版
使用properties读:
public void propertiesTest() {
        if (resource == null) return;
        File file = new File(resource.getFile(), "mysql.properties");
        if (file.exists()) {
            Properties properties = new Properties();
            try (BufferedReader bufferedInputStream = new BufferedReader(new InputStreamReader(new FileInputStream(file)))) {
                //加载配置文件
                properties.load(bufferedInputStream);
                //根据key值获取配置信息value
                String driverClassName = properties.getProperty("driverClassName");
                System.out.println(driverClassName);
            } catch (IOException e) {
                System.out.println(e.getMessage());
            }

        }
    }
使用properties存:
public void propertiesTest() {
        if (resource == null) return;
        File file = new File(resource.getFile(), "mysql.properties");
        if (file.exists()) {
            Properties properties = new Properties();
            try (BufferedWriter bufferedInputStream = new BufferedWriter(new OutputStreamWriter(new FileOutputStream(file, true)))) {
                //设置properties的值
                properties.setProperty("username", "root");
                properties.setProperty("password", "123456");
                //键值对保存到文件
                properties.store(bufferedInputStream, null);
            } catch (IOException e) {
                System.out.println(e.getMessage());
            }

        }
    }
● 多线程
单线程:
就你一个人干,必须先洗完菜才能切菜,切完菜才能炒菜,炒完菜才能煮米饭,一步接一步,全程只有一个 “干活的人”,效率很低。
多线程:
你喊上爸妈一起干 —— 你洗菜(线程 1)、爸妈切菜(线程 2)、同时电饭煲煮米饭(线程 3),这三个 “干活的任务”同时进行,整体做饭速度直接翻倍。
放到 Java 里:
- 进程:可以理解为 “整个做饭的厨房”(一个运行的 Java 程序就是一个进程);
- 线程:就是厨房里面 “干活的人”(线程是程序里最小的执行单元);
- 主线程:Java 程序运行时,默认会有一个main线程(就像默认只有你一个人进厨房干活);
- 多线程:就是你在程序里手动创建多个 “干活的人”,让它们同时执行不同的任务。
- 并发:多人 “交替” 干不同活(你切菜时我洗菜,轮流用菜刀) 多个线程在同一 CPU上交替执行(CPU 切换快,看起来像同时)
- 并行(Parallelism) 多人 “同时” 干不同活(你切菜、我洗菜,各用一把刀) 多个线程在多个 CPU 核心上同时执行(真正的同时)
- 并发和并行可能同时发生
- 共享资源:多线程争抢的 “公共物品”(菜刀、电饭煲) 多个线程共同访问的变量、对象、文件等数据(线程安全问题的根源)
当你的线程数量 > CPU 核心数 时,就会出现「混合模式」。 比如:你的电脑是8 核 CPU,你用线程池开了10 个线程 → 同一时间,8 个线程在 8 个 CPU 核心上「并行执行」(真同时); 剩下的2 个线程,在 CPU 的核心上「并发执行」(交替切换);
整体就是「并发 + 并行」混合,这是最常见的情况。
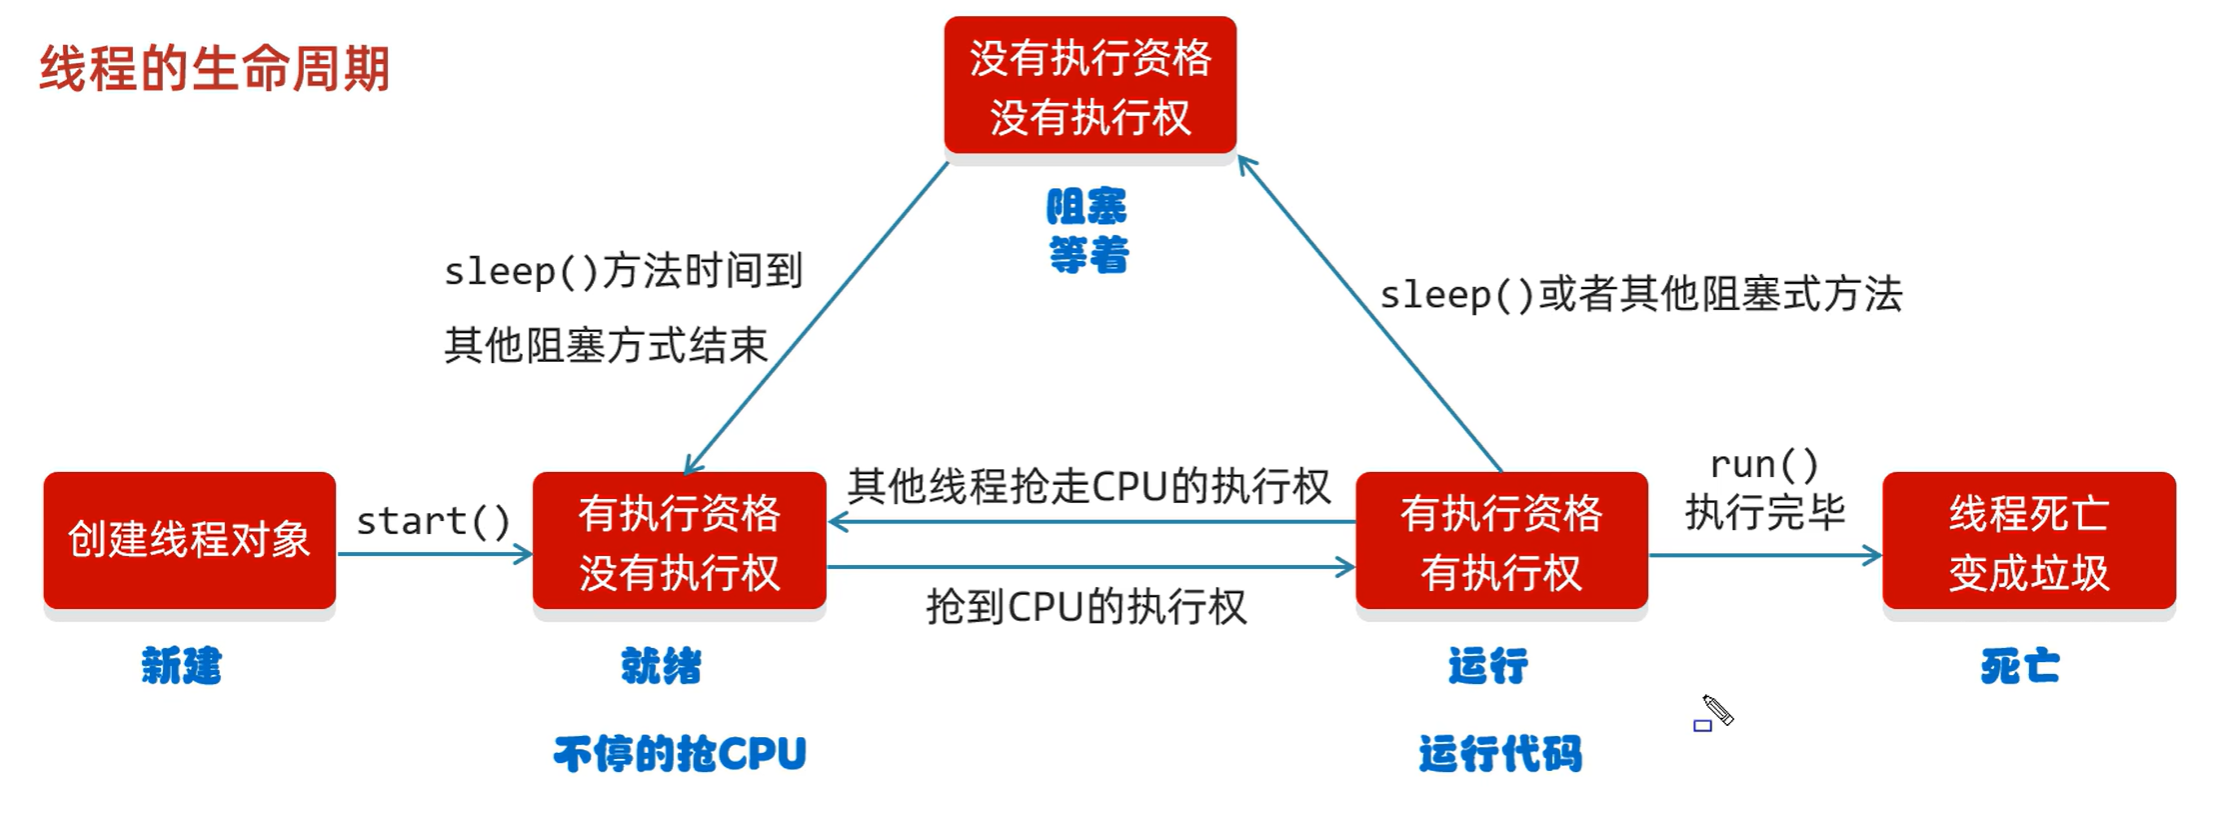
○ 线程生命周期
- 新建(New):创建了 Thread 对象,但还没调用start()(比如 “找好了人,但还没喊他干活”);
- 就绪(Runnable):调用start()后,线程等待 CPU 调度(“人站好队,等分配任务”);
- 运行(Running):CPU 选中线程,执行run()方法(“人正在干活”);
- 阻塞(Blocked/Waiting/Timed_Waiting):线程暂时停止执行,让出 CPU(“人临时停活,比如等菜刀、休息 5 分钟”);
-
-
- Timed_Waiting:有时间限制的阻塞(sleep(1000)、wait(1000));
-
-
-
- Waiting:无时间限制的阻塞(wait()、join());
-
-
-
- Blocked:等待获取锁的阻塞(比如抢synchronized锁);
-
- 终止(Terminated):run()执行完或异常终止(“人干完活下班了”)。
图来自[www.itheima.com]
○ 线程实现
1:基于继承Thread类实现(比较简单,但只能单继承):
// 1. 继承Thread类,重写run()(定义要干的活)
class MyThread extends Thread {
    @Override
    public void run() {
        for (int i = 0; i < 5; i++) {
            // Thread.currentThread().getName() 获取当前线程名
            System.out.println(Thread.currentThread().getName() + " 执行:" + i);
            try {
                Thread.sleep(300); // 模拟耗时
            } catch (InterruptedException e) {
                e.printStackTrace();
            }
        }
    }
}

public class ThreadCreate1 {
    public static void main(String[] args) {
        // 2. 创建线程对象(新建状态)
        MyThread t1 = new MyThread();
        MyThread t2 = new MyThread();
        // 给线程起名,方便调试
        t1.setName("线程1");
        t2.setName("线程2");

        // 3. 启动线程(就绪状态)
        t1.start();
        t2.start();
    }
}
2:基于实现Runnable接口实现(无继承限制):
public void start() {
        Runnable r1 = () -> {
            //设置线程名字
            Thread.currentThread().setName("Run One");
            for (int i = 0; i < 100; i++) {
                //获取线程名字
                System.out.println(Thread.currentThread().getName() + i);
            }
        };

        Runnable r2 = () -> {
            for (int i = 0; i < 100; i++) {
                System.out.println(Thread.currentThread().getName() + i);
            }
        };
        new Thread(r1).start();
        new Thread(r2).start();
    }
3:基于实现Callable接口实现(带返回值 + 可抛异常):
前两种方式的run()没有返回值、不能抛检查异常,Callable 解决了这个问题,需要配合FutureTask使用:
public void start() throws ExecutionException, InterruptedException {
        //lambda创建Callable
        Callable<Integer> callable = () -> {
            int sum = 0;
            for (int i = 0; i < 100; i++) {
                sum += i;
            }
            return sum;
        };
        //配合FutureTask使用
        FutureTask<Integer> futureTask = new FutureTask<>(callable);
        //执行线程
        Thread thread = new Thread(futureTask);
        thread.start();
        //通过FutureTask获取线程返回值
        Integer i = futureTask.get();
        System.out.println(i);
    }
线程常用方法:
- String getName():返回此线程的名称
- void setName(String name):设置线程的名字(构造方法也可以设置名字)
- static Thread currentThread():获取当前线程的对象
- static void sleep(long time):让线程休眠指定的时间,单位为毫秒
- setPriority(int newPriority):设置线程的优先级1~10越大抢cpu概率越高,默认为5
- final int getPriority():获取线程的优先级
- final void setDaemon(boolean on):设置为守护线程
- public static void yield():出让线程/礼让线程
- public static void join():插入线程/插队线程
△ 守护线程
把 Java 程序的运行想象成一家餐厅:
- 用户线程:就是来餐厅吃饭的「顾客」,是餐厅存在的核心意义;
- 守护线程:就是餐厅的「服务员 / 保洁员」,专门为顾客服务,没有顾客了,服务员也就没必要留在餐厅了。
核心逻辑:只要餐厅里还有哪怕 1 个顾客(用户线程),服务员(守护线程)就必须继续工作;
但当最后 1 个顾客离开(所有用户线程结束),餐厅就会关门(JVM 退出),不管服务员的活有没有干完,都会被 “强制下班”(守护线程被终止)。
用户线程:
也叫非守护线程,是程序的核心业务线程(比如 main 线程、处理订单的业务线程),只要有一个用户线程还在运行,JVM 就不会退出;
守护线程:
为用户线程提供「辅助服务」的线程,它的生命周期完全依赖用户线程 —— 当所有用户线程执行完毕,JVM 会直接终止所有守护线程,然后退出。
public void start() throws ExecutionException, InterruptedException {
        //lambda创建Callable
        Callable<Integer> callable = () -> {
            Thread.currentThread().setName("用户线程");
            int sum = 0;
            for (int i = 0; i < 10; i++) {
                System.out.println(Thread.currentThread().getName() + "@" + i);
                sum += i;
            }
            return sum;
        };

        Callable<Integer> callable2 = () -> {
            Thread.currentThread().setName("守护线程");
            int sum = 0;
            for (int i = 0; i < 1000; i++) {
                System.out.println(Thread.currentThread().getName() + "@" + i);
                sum += i;
            }
            return sum;
        };


        //配合FutureTask使用
        FutureTask<Integer> futureTask = new FutureTask<>(callable);
        FutureTask<Integer> futureTask2 = new FutureTask<>(callable2);

        //执行线程
        Thread thread = new Thread(futureTask);
        Thread thread2 = new Thread(futureTask2);

        thread2.setDaemon(true);

        thread.start();//执行完之后
        thread2.start();//当用户线程执行完后守护线程并不会执行到结束而是执行几次后很快结束线程
    }
ps:如果在线程实现方法里设置守护线程则会直接无效,因为守护线程是要在.start()方法执行之前设置才会生效,当在实现方法内设置,调用start()方法时再设置守护线程就已经晚了,会抛出IllegalThreadStateException异常如果不捕获则默认吞线程
△ 礼让线程
把线程争抢 CPU 执行权的过程,比作一群人抢唯一的麦克风唱歌:
CPU 就像这只麦克风,谁拿到谁就能 “表演”(线程执行);
正常情况:大家疯抢,麦克风在谁手里,谁就一直唱,直到唱完或者被 CPU 强制打断;
yield()的作用:某个抢到麦克风的人,主动说 “我先让一让,你们再抢一次”,然后把麦克风放下,回到抢麦的人群里;
关键:
这只是 “礼让”,不是 “让贤”—— 他只是重新加入竞争,最终麦克风落谁手里,还是看现场的调度(比如谁手快、或者主持人(操作系统)偏向谁),有可能他刚让完,又抢到了麦克风继续唱。
public void start() throws ExecutionException, InterruptedException {
        //lambda创建Callable
        Callable<Integer> callable = () -> {
            Thread.currentThread().setName("主线程");
            int sum = 0;
            for (int i = 0; i < 10; i++) {
                System.out.println(Thread.currentThread().getName() + "@" + i);
                sum += i;
            }
            return sum;
        };

        Callable<Integer> callable2 = () -> {
            Thread.currentThread().setName("礼让线程");
            //设置礼让线程
            //表示让出当前cpu执行权
            Thread.yield();
            int sum = 0;
            for (int i = 0; i < 10; i++) {
                System.out.println(Thread.currentThread().getName() + "@" + i);
                sum += i;
            }
            return sum;
        };


        //配合FutureTask使用
        FutureTask<Integer> futureTask = new FutureTask<>(callable);
        FutureTask<Integer> futureTask2 = new FutureTask<>(callable2);

        //执行线程
        Thread thread = new Thread(futureTask);
        Thread thread2 = new Thread(futureTask2);

        thread.start();
        thread2.start();
    }
△ 插入线程
把线程的执行过程比作银行窗口排队办事:
你(main线程)是排在窗口前的第一个人,马上就要办理业务;
突然你的朋友(threadA线程)跑过来,说有急事要先办 —— 这就是调用threadA.join();
核心效果:你(main线程)会主动退到队伍后面,等朋友(threadA)办完所有业务,你才重新回到窗口继续办自己的事;
额外场景:如果朋友说 “我最多占用窗口 5 分钟,5 分钟后不管办完没办完,都该你办”—— 这就是threadA.join(5000)(带超时的 join)。
简单说:join()就是让当前线程“暂停执行”,优先让调用join()的线程 “插队” 执行,等插队的线程执行完(或超时),当前线程才继续。
public static void main(String[] args) throws InterruptedException {
        // 1. 创建一个“急事线程”(模拟要插队的朋友)
        Thread urgentThread = new Thread(() -> {
            Thread.currentThread().setName("急事线程");
            for (int i = 1; i <= 5; i++) {
                try {
                    Thread.sleep(500); // 模拟办事需要时间
                } catch (InterruptedException e) {
                    e.printStackTrace();
                }
                System.out.println(Thread.currentThread().getName() + ":正在办第" + i + "件急事");
            }
            System.out.println(Thread.currentThread().getName() + ":所有急事办完了!");
        });

        System.out.println("=== 场景1:不用join(不插队)===");
        urgentThread.start();
        // main线程不等,自己直接执行
        for (int i = 1; i <= 3; i++) {
            Thread.sleep(500);
            System.out.println("main线程:我在办自己的事,第" + i + "件");
        }

        // 等待所有线程执行完,再演示场景2
        Thread.sleep(3000);
        System.out.println("\n=== 场景2:用join(插队)===");

        // 重新创建一个急事线程(避免复用已结束的线程)
        Thread urgentThread2 = new Thread(() -> {
            Thread.currentThread().setName("急事线程2");
            for (int i = 1; i <= 5; i++) {
                try {
                    Thread.sleep(500);
                } catch (InterruptedException e) {
                    e.printStackTrace();
                }
                System.out.println(Thread.currentThread().getName() + ":正在办第" + i + "件急事");
            }
            System.out.println(Thread.currentThread().getName() + ":所有急事办完了!");
        });

        urgentThread2.start();
        // 核心:main线程调用join(),让急事线程2插队
        urgentThread2.join(); // 无参join:等急事线程2完全执行完
        // (如果想测试超时:urgentThread2.join(2000); // 只等2秒,不管对方完没办完)

        // 只有等急事线程2办完,main线程才会执行下面的代码
        for (int i = 1; i <= 3; i++) {
            Thread.sleep(500);
            System.out.println("main线程:我终于能办自己的事了,第" + i + "件");
        }
    }
○ 线程安全
什么是线程安全?
多个线程同时操作共享资源(比如一个全局变量)时,执行结果不符合预期(比如卖票超卖、计数错误)。
先看问题:
public class MyThread implements Runnable {

    private static int ticket = 100;

    @Override
    public void run() {
        while (true) {
            if (ticket <= 0) {
                break;
            } else {
                try {
                    Thread.sleep(100);
                } catch (InterruptedException e) {
                    throw new RuntimeException(e);
                }
                System.out.println(Thread.currentThread().getName() + "卖" + ticket--);
            }
        }
    }
}
测试:
public void synchronizedTest() {
        Thread t1 = new Thread(new MyThread());
        t1.setName("窗口one");
        Thread t2 = new Thread(new MyThread());
        t2.setName("窗口two");
        Thread t3 = new Thread(new MyThread());
        t3.setName("窗口three");
        t1.start();
        t2.start();
        t3.start();
    }
结果:
....
窗口two卖5
窗口three卖5
窗口one卖5
窗口three卖4
窗口two卖3
窗口one卖2
窗口two卖1
窗口three卖1
窗口one卖0
这样线程会出现数据错乱
根本原因
- 原子性:一个操作(比如count++)不能被拆分,要么全执行,要么全不执行;count++实际是读取→加1→写入三步,多线程下会被拆分;
- 可见性:一个线程修改了共享变量,其他线程能立刻看到修改后的值;
- 有序性:程序执行顺序按代码顺序来(JVM 会指令重排,单线程没问题,多线程可能乱序)。
△ 线程锁
线程锁的核心作用
在多线程场景下,多个线程同时操作共享资源(比如一个变量、一个对象)时,会因为操作的 “非原子性” 导致结果错误(比如卖票超卖、计数不准)。
线程锁的本质:给共享资源加 “访问限制”,让同一时间只有确定的的线程能操作它,从而保证线程安全的原子性。
- 实现层面 内置锁(synchronized)、显式锁(Lock 接口:ReentrantLock、ReentrantReadWriteLock 等)
- 锁的特性 可重入锁、公平锁 / 非公平锁、独占锁 / 共享锁、乐观锁 / 悲观锁、自旋锁、偏向锁 / 轻量级锁 / 重量级锁
- 锁的范围 对象锁、类锁
△ synchronized锁
基础锁:synchronized(内置锁 / 监视器锁)
synchronized 的核心原理:
- 线程获取锁:关联到对象的 Monitor,标记为 “占用”;
- 线程释放锁:解除与 Monitor 的关联,标记为 “空闲”;
- 其他线程抢锁:如果锁被占用,进入等待队列,直到锁释放。
Monitor(锁监视器)就相当于一个锁的门卫,当某个对象被定义为锁之后,就会自动配一个Monitor监视器,如果某个线程抢到了这把锁,门卫会关门不让其他人进来,直到锁被释放
synchronized使用:
- 使用的锁必须是唯一的比如this XXX.class 或者被static final 修饰的Object对象
- 多个线程调用同一个对象的该方法时,会互斥;调用不同对象的该方法时,不互斥。
- 当synchronized修饰非静态方法时默认使用this 反之则是XXX.class
synchronized 的核心特性:
- ✅ 可重入:同一个线程可以多次获取同一把锁(比如递归调用 synchronized 方法,不会死锁);
- ✅ 非公平:锁释放后,等待队列中的线程不按 “先来后到” 抢锁(默认,效率更高);
- ✅ 独占锁:同一时间只有一个线程能获取锁;
- ✅ 自动释放:线程执行完代码块 / 方法,或抛出异常时,会自动释放锁(无需手动操作)。
ps:
public void run() {
        while (true) {
            // synchronized锁不能写在循环之外 否则当某一线程抢到该锁 则会执行完本循环之后再释放锁 程序会单一进程
            synchronized (this) {
                if (ticket <= 0) {
                    break;
                } else {
                    try {
                        Thread.sleep(500);
                    } catch (InterruptedException e) {
                        throw new RuntimeException(e);
                    }
                    System.out.println(Thread.currentThread().getName() + "卖" + ticket--);
                }
            }
        }
    }
private static final Object lock = new Object();

    @Override
    public void run() {
        while (true) {
            //自定义锁 只要是static final修饰的唯一对象即可
            synchronized (lock) {
                if (ticket <= 0) {
                    break;
                } else {
                    try {
                        Thread.sleep(500);
                    } catch (InterruptedException e) {
                        throw new RuntimeException(e);
                    }
                    System.out.println(Thread.currentThread().getName() + "卖" + ticket--);
                }
            }
        }
    }
△ Lock锁
进阶锁Lock 接口(显式锁)
synchronized虽然简单,但功能有限(无法中断、无法超时、无法公平锁),JDK 1.5 引入java.util.concurrent.locks.Lock接口,提供更灵活的显式锁。
Lock 接口的核心方法:
- lock() 获取锁(阻塞,直到获取到锁)
- lockInterruptibly() 获取锁,可被中断(线程调用 interrupt () 时,抛 InterruptedException 并退出)
- tryLock() 尝试获取锁(非阻塞,立即返回 true/false)
- tryLock(long time, TimeUnit unit) 超时获取锁(在指定时间内获取到返回 true,否则 false)
- unlock() 释放锁(必须手动调用,推荐放 finally 块)
- newCondition() 创建条件变量(实现线程间精准通信)
核心实现类 1:ReentrantLock(可重入锁)
基本用法(必须记:lock () 放开头,unlock () 放 finally)
ReentrantLock是 Lock 接口最常用的实现,功能完全覆盖synchronized,且支持更多特性。
public void run() {
        while (true) {
            lock.lock();
            try {
                if (ticket <= 0) {
                    break;
                } else {
                    try {
                        Thread.sleep(500);
                    } catch (InterruptedException e) {
                        throw new RuntimeException(e);
                    }
                    System.out.println(Thread.currentThread().getName() + "卖" + ticket--);
                }
            } catch (Exception e) {
                throw new RuntimeException(e);
            } finally {
                lock.unlock();
            }
        }
    }
为什么lock.unlock()方法必须写在finally语句块内,假设unlock不在finally语句块内,那么当if条件走到break时直接跳出循环导致unlock不执行,那么拿到锁的线程带着锁出去没有释放锁,其他线程还在等待锁释放,这会导致程序一直执行不会结束。
核心实现类 2:ReentrantReadWriteLock(读写锁)
针对 “读多写少” 的场景优化:
- 读锁(共享锁):多个线程可同时获取读锁(读操作不互斥);
- 写锁(独占锁):只有一个线程能获取写锁,且写锁持有期间,读锁也无法获取(写操作与读 / 写操作都互斥)。
public class MyThread {

    private static final ReentrantReadWriteLock rwLock = new ReentrantReadWriteLock();

    private static final ReentrantReadWriteLock.ReadLock readLock = rwLock.readLock();

    private static final ReentrantReadWriteLock.WriteLock writeLock = rwLock.writeLock();

    public void readLock() {
        readLock.lock();
        try {
            System.out.println(Thread.currentThread().getName() + "进行读取操作");
            Thread.sleep(1000);
        } catch (Exception e) {
            throw new RuntimeException(e);
        } finally {
            readLock.unlock();
        }
    }

    public void writeLock() {
        writeLock.lock();
        try {
            System.out.println(Thread.currentThread().getName() + "进行写入操作");
            Thread.sleep(1000);
        } catch (Exception e) {
            throw new RuntimeException(e);
        } finally {
            writeLock.unlock();
        }
    }
}
public void synchronizedTest() {

        for (int i = 0; i < 100; i++) {
            Thread t1 = new Thread(() -> {
                new MyThread().readLock();
            });
            t1.setName("窗口one");
            t1.start();
        }

        for (int i = 0; i < 5; i++) {
            Thread t2 = new Thread(() -> {
                new MyThread().writeLock();
            });
            t2.setName("窗口two");
            t2.start();
        }

    }
当写线程没有拿到锁时,很多个读线程会同时拿到读锁一起执行读取操作,但当一个写线程拿到写锁时所有读线程停止拿锁等写线程完毕后再抢锁
△ 死锁
两个或多个线程互相持有对方需要的锁,且都不释放,导致所有线程永久阻塞。
当两个线程进行时,线程1拿到A锁,线程2同时拿到B锁,当线程1准备拿B锁时,线程2准备拿A锁还没有释放B锁,所以线程1拿不到B锁,线程B拿不到A锁,导致程序一直卡在这,形成死锁。
public class DeadLockDemo {
    // 两把锁
    private static final Object lockA = new Object();
    private static final Object lockB = new Object();

    public static void main(String[] args) {
        // 线程1:先拿lockA,再拿lockB
        new Thread(() -> {
            synchronized (lockA) {
                System.out.println("线程1获取了lockA,等待lockB");
                try {
                    Thread.sleep(1000);
                } catch (InterruptedException e) {
                    e.printStackTrace();
                }
                synchronized (lockB) {
                    System.out.println("线程1获取了lockB,执行任务");
                }
            }
        }, "线程1").start();

        // 线程2:先拿lockB,再拿lockA(与线程1锁顺序相反)
        new Thread(() -> {
            synchronized (lockB) {
                System.out.println("线程2获取了lockB,等待lockA");
                try {
                    Thread.sleep(1000);
                } catch (InterruptedException e) {
                    e.printStackTrace();
                }
                synchronized (lockA) {
                    System.out.println("线程2获取了lockA,执行任务");
                }
            }
        }, "线程2").start();
    }
}
如何避免死锁:
- 固定锁的获取顺序(比如都先拿 lockA,再拿 lockB);
- 使用 tryLock () 超时获取锁(避免永久等待);
- 减少锁的持有时间(尽快释放锁);
- 使用工具检测死锁(比如 JConsole、jstack 命令)。
△ 乐观锁与悲观锁
悲观锁:
悲观锁就像:你是一个极度谨慎的人,做什么事都「默认一定会有人跟你抢」。
比如你在卫生间🚻,进去第一件事就是反锁门,不管外面有没有人、有没有人要进来,先把门锁上,你在里面办事的期间,任何人都进不来;等你办完事儿,再开门解锁,下一个人才能进来。
👉 核心心态:凡事往最坏的想,默认必有争抢,先上锁,再办事,绝对安全。
synchronized锁就是典型的悲观锁
public class MyThread implements Runnable {
    private static int ticket = 100; //共享票数(抢的资源)
    private static final Object LOCK = new Object(); //一把锁

    @Override
    public void run() {
        while (true) {
            // 悲观锁核心:操作资源前,先上锁!
            synchronized (LOCK) {
                if (ticket <= 0) break;
                System.out.println(Thread.currentThread().getName() + "卖" + ticket--);
            }
            // 解锁:代码块执行完,自动释放锁,下一个线程才能进来
        }
    }
}
✅ 效果:3 个窗口线程,谁先拿到锁谁卖票,其他窗口排队,绝对不会出现负数、不会重复卖票,百分百安全!
乐观锁:
乐观锁就像:你是一个大大咧咧的人,做什么事都「默认没人跟你抢」。
比如你去复印店复印文件📄,店里有个公用的打印机,你直接过去就开始复印,全程不上锁,心里想着「应该没人跟我抢这台打印机」;
万一真的有人也来用打印机(小概率事件),你俩撞车了,你也不生气,就说「那我重新来一次」,退回去、等对方用完,你再重新复印就行。
👉 核心心态:凡事往最好的想,默认不会有争抢,先办事,不上锁;万一真的被人抢了、资源被改了,那就「重试一次」。
Java 中乐观锁的核心思想:
- 对共享资源(比如你的ticket票数)持「乐观态度」,认为多线程并发访问时,大概率不会发生争抢,大概率不会出问题。
- 所以操作共享资源时,全程不上锁,直接去修改资源;
- 但是!修改之前会做一个「核对校验」:看看这个资源「我拿到的时候的值」和「现在要修改的值」是不是一样?
✔️ 如果一样:说明没人动过这个资源,修改成功!
❌ 如果不一样:说明被别的线程改过了,我这次修改作废,重新拿最新的值,再试一次(重试)。
CAS机制:
CAS = Compare And Swap(比较并交换)
我想把票数 ticket 从 100 改成 99 → 先「比较」现在的ticket是不是还是 100?如果是,就「交换」成 99;如果不是,说明被别人改了,重来!
这个「比较 + 交换」是 CPU 层面的原子操作(一次性完成,不会被线程打断),这也是乐观锁能保证线程安全的核心!
- AtomicInteger:乐观锁版的 Integer,对应你的int ticket
- AtomicLong:乐观锁版的 Long
- AtomicBoolean:乐观锁版的 Boolean
public class MyThread implements Runnable {

    private static final AtomicInteger lock = new AtomicInteger(100);

    @Override
    public void run() {
        while (true) {
            int ticket = lock.get();
            if (ticket <= 0) {
                break;
            }

            // 假设现在的票要从100改成99 他会记录当前线程的票数100 则会判断当前的ticket是不是100
            // 如果是 则会更改 如果不是 说明被其他线程改了
            boolean flag = lock.compareAndSet(ticket, ticket - 1);

            try {
                Thread.sleep(500);
            } catch (InterruptedException e) {
                throw new RuntimeException(e);
            }

            if (flag) {
                System.out.println(Thread.currentThread().getName() + "@" + ticket);
            }
        }
    }
}
乐观锁与悲观锁总结:
悲观锁:先锁后做,防患于未然,默认必有争抢,上锁保证绝对安全,适合竞争激烈的场景,代表是synchronized;
乐观锁:先做后核,赌大概率无事,默认没有争抢,不上锁提高效率,万一出事就重试,适合竞争少的场景,代表是Atomic原子类;
锁的本质,就是解决「多线程抢共享资源」的问题,悲观锁和乐观锁只是两种不同的解决思路。
△ 线程唤醒与等待机制
核心定位:等待唤醒机制 = 为「生产者消费者模型」量身打造的多线程协作方案
什么是【生产者 - 消费者模型】?
✅ 核心角色(3 个,缺一不可)
- 生产者:负责「生产数据 / 资源」的线程 → 比如:包子铺做包子的师傅
- 消费者:负责「消费数据 / 资源」的线程 → 比如:来买包子的顾客
- 共享缓冲区 / 仓库:存放生产好的资源的地方,是生产者和消费者的唯一交互媒介 → 比如:包子铺的蒸笼(容量有限,比如最多放 5 个包子)
✅ 核心需求(必须遵守的 2 个规矩)
这也是为什么单纯加锁解决不了问题的原因,两个硬性规矩:
- ✔ 规矩 1:蒸笼满了,师傅就不能再做包子了(仓库满 → 生产者停止生产,等待);
- ✔ 规矩 2:蒸笼空了,顾客就不能买包子了(仓库空 → 消费者停止消费,等待);
- ✔ 额外规矩:师傅做好 1 个包子,要喊一声「有包子了」;顾客买走 1 个包子,要喊一声「有空位了」。
✅ 没有「等待唤醒」会怎么样?
- 如果只给蒸笼(共享资源)加锁,没有等待唤醒机制,线程会出现两种极端情况,全是问题:
- 生产者瞎忙活:蒸笼满了还在不停尝试生产,线程一直抢锁、判断、释放锁,白白占用 CPU 资源,这叫「忙等」;
- 消费者瞎忙活:蒸笼空了还在不停尝试消费,也是一样的「忙等」,纯纯浪费性能;
3 个核心方法:
wait()、notify()、notifyAll() 必须在 synchronized 同步代码块 / 同步方法中调用
✅ 原因:这三个方法,必须依附于「锁对象」 才能使用。
- 你用synchronized(锁对象){}锁住了共享资源,那你就必须用这个「锁对象」 去调用这三个方法;
- 如果不在同步代码块里调用,直接抛异常 IllegalMonitorStateException(非法监视器状态异常),大白话:你没拿到锁,没资格喊等待 / 唤醒!
wait()、notify()、notifyAll() 必须是「同一个锁对象」调用
✅ 原因:生产者和消费者,抢的是同一个共享资源的锁,只有用同一个锁对象喊话,对方才能听见。
- 比如:包子铺的蒸笼是锁对象,师傅(生产者)用蒸笼喊「我等了」,顾客(消费者)必须用同一个蒸笼喊「你醒醒」,如果各喊各的,永远唤醒不了对方。
wait方法技术底层逻辑
- 调用wait()的线程,会立刻释放持有的「当前锁对象」(这点和Thread.sleep()天壤之别!);
- 这个线程会从「运行状态」变成「等待状态」,进入这个锁对象的「等待队列」里排队;
- 线程会一直卡在wait()这行代码不动,直到有其他线程用同一个锁对象喊它(notify()/notifyAll()),它才会被唤醒。
关键对比:wait () 和 sleep () 最核心区别
- wait():释放锁 + 线程等待,必须在同步代码块里调用;
- sleep():不释放锁 + 线程休眠,哪里都能调用;
- 例子:师傅如果是 sleep (1000),就是抱着蒸笼睡 1 秒,期间顾客根本碰不到蒸笼;如果是 wait (),就是把蒸笼让出来,顾客可以直接用。
- 单个唤醒:锁对象.notify() → 我干完活了,喊一个等着的人过来干活
public class WaitAndNotifyThread {

    public static void makeFood() {
        //一直做食物
        while (true) {
            synchronized (Food.lock) {
                //判断食物到达最大值 如果食物满了 则等待wait 之所以用循环因为假设食物做好之后
                //这把锁的厨师线程被唤醒 发现食物还是满的 则继续等待
                //使用循环判断锁 放置假唤醒 放置错误数据 如果是if则会出现食物数据异常 自己去试
                while (Food.food.equals(Food.maxFood)) {
                    try {
                        System.out.println("食物满了 厨师等待...");
                        Food.lock.wait(); //释放锁
                    } catch (InterruptedException e) {
                        throw new RuntimeException(e);
                    }
                }
                //如果食物没满 开始做食物 并提醒吃货们来吃
                Food.food++;
                System.out.println(Thread.currentThread().getName() + "做好了1个食物 目前食物有" + Food.food);
                //唤醒持有这把锁的所有线程 唤醒与等待必须在线程绑定的锁上实现 不然就是唤醒其他所有的线程 非常可怕
                Food.lock.notify();

                try {
                    Thread.sleep(500);
                } catch (InterruptedException e) {
                    throw new RuntimeException(e);
                }
            }
        }
    }

    public static void eatFood() {
        while (true) {
            synchronized (Food.lock) {
                //检查是否有食物 没有食物则等待wait
                while (Food.food.equals(Food.minFood)) {
                    try {
                        System.out.println("目前还没有食物 吃货等待...");
                        Food.lock.wait();
                    } catch (InterruptedException e) {
                        throw new RuntimeException(e);
                    }
                }
                //有食物 开吃
                Food.food--;
                System.out.println(Thread.currentThread().getName() + "吃货吃了食物 还剩" + Food.food);
                //唤醒所有线程 开始做饭
                Food.lock.notify();

                try {
                    Thread.sleep(100);
                } catch (InterruptedException e) {
                    throw new RuntimeException(e);
                }
            }
        }
    }
}
使用Lock锁实现阻塞队列:
开始业务时一般有两个及以上的线程
一半用来put放任务的线程
一半用来take取任务的线程
可以模拟两条生产线
put生产线有任务时会呼唤take生产线
反之则亦然
当put生产线任务满了 会自动睡眠 释放锁 此时take生产线就可以为所欲为了
当take生产线没有任务时 会自动睡眠 释放锁 此时put就可以拿到锁放置任务
/**
     * 阻塞队列的锁 防止任务入队列被挤爆发生数据错乱
     * isEmpty --- take队列任务未满时 阻塞的条件
     * isFull --- put队列满时 阻塞的条件
     */
    private static final ReentrantLock lock = new ReentrantLock();

    private static final Condition isEmpty = lock.newCondition();

    private static final Condition isFull = lock.newCondition();


/**
     * @param runnable 新增任务 需要放入队列
     */
    public void put(Runnable runnable) throws InterruptedException {
        lock.lock(); //获取当前的锁
        try {
            while (size == capacity){ //循环判断队列是否满任务 防止假唤醒
                System.out.println("Queue is full waiting...");
                isFull.await();
            }
            tailQueue[tail] = runnable; //开始向队列中加入任务
            tail = (tail + 1) % capacity; //尾指针后移 如果到尾部则循环回头部
            size++; //队列任务数增加
            isEmpty.signal(); //唤醒持队列接取任务锁的所有线程 让他们抢着接活
        } finally {
            lock.unlock(); //程序执行完释放锁
        }
    }


/**
     * 接取任务
     * @return 有空闲线程[正式员工]可以接这个活
     */
    public Runnable take() throws InterruptedException {
        lock.lock();
        try {
            while (size == 0) { //循环判断当前是否没有任务 没有则等待任务
                System.out.println("Queue is empty waiting...");
                isEmpty.await();
            }
            Runnable runnable = tailQueue[head]; //如果有任务则从队列头中拿取任务
            head = (head + 1) % capacity; //进行头指针迭代
            size--; //总任务数减少
            isFull.signal(); //唤醒所有持有新增任务锁的线程开始增任务
            return runnable; //返回这个活给线程[员工]哥干活
        } finally {
            lock.unlock();
        }
    }
△ 阻塞队列实现等待唤醒机制
传统wait()和notify()缺点:
- 必须手动加 synchronized 锁,锁对象还得保证是同一个,写错就报错;
- 必须手动写 while 循环判断仓库满 / 空,用 if 就会出现「假唤醒」,数据必错;
- 必须手动调用 wait() 等待、notifyAll() 唤醒,忘写就会线程卡死;
- 代码臃肿:核心的「生产 / 消费」逻辑就 1 行,结果被锁、判断、等待唤醒的代码包围了一大圈。
阻塞队列的【核心优势】:
阻塞队列的本质:一个自带「等待唤醒机制」的线程安全的队列。
你可以把它理解成:一个有智商、懂规矩的智能蒸笼。
这个「智能蒸笼」自己就懂 2 个铁规矩,不用任何人提醒、不用手动写任何代码:
- ✔ 规矩 1:蒸笼(队列)满了 → 师傅(生产者)想放包子,自动停下等待,直到有顾客买走包子、队列有空位,自动唤醒师傅继续生产;
- ✔ 规矩 2:蒸笼(队列)空了 → 顾客(消费者)想买包子,自动停下等待,直到有师傅做好包子、队列有货,自动唤醒顾客继续消费。
核心结论:
- 阻塞队列的底层源码里,依然是用了 Lock锁 + Condition条件 + await()/signal()(等价于原生的synchronized+wait/notify)实现的等待唤醒,只是 JDK 帮我们把这些细节全部封装在队列内部了。
- 我们作为开发者,只需要调用队列的「放元素、取元素」方法,剩下的等待、唤醒、线程安全,全交给队列自己处理!
阻塞队列的 2 个「核心阻塞方法」
✔ 生产者用:put(E e) 方法 → 往队列里放元素(做包子、放进蒸笼)
- 功能:把一个元素放进阻塞队列;
- 阻塞规则:如果队列已满,调用这个方法的线程会一直阻塞,直到队列有空闲位置,线程被自动唤醒,元素成功放入;
- 线程安全:自带锁,多个生产者同时放,不会出现数据错乱。
✔ 消费者用:take() 方法 → 从队列里取元素(买包子、拿出蒸笼)
- 功能:从队列的头部取出并删除一个元素;
- 阻塞规则:如果队列已空,调用这个方法的线程会一直阻塞,直到队列里有新元素,线程被自动唤醒,成功取出元素;
- 线程安全:自带锁,多个消费者同时取,不会出现数据错乱。
✨ 补充:这两个方法就是「终极懒人版」的等待唤醒,你调用这两个方法,就等于 JDK 帮你执行了「判断 + 加锁 + wait + 唤醒 + 解锁」的全套逻辑!
put方法源码
public void put(E e) throws InterruptedException {
        Objects.requireNonNull(e);
        final ReentrantLock lock = this.lock;
        lock.lockInterruptibly();
        try {
            while (count == items.length)
                notFull.await();
            enqueue(e);
        } finally {
            lock.unlock();
        }
    }
take方法源码
public E take() throws InterruptedException {
        final ReentrantLock lock = this.lock;
        lock.lockInterruptibly();
        try {
            while (count == 0)
                notEmpty.await();
            return dequeue();
        } finally {
            lock.unlock();
        }
    }
测试案例
/**
 * 通俗版 阻塞队列实现生产者消费者(替代wait/notify,实战首选)
 * 核心:BlockingQueue的put()和take()方法 自动实现等待唤醒,无需手动加锁/写wait/notify
 * 包子师傅=生产者,顾客=消费者,智能蒸笼=ArrayBlockingQueue(容量3)
 */
public class BlockingQueueProducerConsumer {
    // 1. 定义阻塞队列作为【智能蒸笼】,固定容量3个包子,线程安全+自带等待唤醒
    private static final BlockingQueue<String> SMART_STEAMER = new ArrayBlockingQueue<>(3);

    public static void main(String[] args) {
        // 2. 创建2个生产者线程:包子师傅
        new Thread(() -> produceBaoZi(), "包子师傅1号").start();
        new Thread(() -> produceBaoZi(), "包子师傅2号").start();

        // 3. 创建3个消费者线程:顾客
        new Thread(() -> consumeBaoZi(), "顾客1号").start();
        new Thread(() -> consumeBaoZi(), "顾客2号").start();
        new Thread(() -> consumeBaoZi(), "顾客3号").start();
    }

    // 生产者方法:做包子 → 往阻塞队列放包子,用put()方法
    private static void produceBaoZi() {
        while (true) { // 循环做包子
            try {
                String baoZi = "猪肉大葱包";
                // 核心:调用put()方法放包子,队列满了会自动阻塞,有空位自动唤醒
                SMART_STEAMER.put(baoZi);
                System.out.println(Thread.currentThread().getName() + ":做好1个包子,智能蒸笼剩余【" + SMART_STEAMER.size() + "】个包子");
                Thread.sleep(500); // 模拟做包子耗时,效果更明显
            } catch (InterruptedException e) {
                e.printStackTrace();
            }
        }
    }

    // 消费者方法:买包子 → 从阻塞队列取包子,用take()方法
    private static void consumeBaoZi() {
        while (true) { // 循环买包子
            try {
                // 核心:调用take()方法取包子,队列空了会自动阻塞,有包子自动唤醒
                String baoZi = SMART_STEAMER.take();
                System.out.println(Thread.currentThread().getName() + ":买到1个【"+baoZi+"】,智能蒸笼剩余【" + SMART_STEAMER.size() + "】个包子");
                Thread.sleep(800); // 模拟吃包子耗时,效果更明显
            } catch (InterruptedException e) {
                e.printStackTrace();
            }
        }
    }
}
△ 线程池
先说说为什么要有线程池?
假设你是老板,要完成 1000 个干活任务
方式 1:
手动创建线程 = 招「临时工」干活
每来 1 个任务,就临时雇 1 个临时工,干完活立刻解雇这个临时工;下一个任务再来,再雇新的临时工。
这种方式的 3 个致命问题:
- 开销极大,效率极低:雇人(创建线程)、解雇人(销毁线程)都是要花「成本」的(CPU / 内存开销),1000 个任务就要创建销毁 1000 个线程,大部分时间都花在「雇人解雇」上,真正干活的时间很少;
- 资源耗尽,程序崩溃:如果任务特别多(比如 1 万个),就会瞬间创建 1 万个线程,CPU 要疯狂切换线程、内存被占满,直接导致程序卡死 / 崩溃(内存溢出 OOM);
- 无人管理,乱糟糟:所有线程都是零散的,没法统一控制、没法知道任务进度、没法限制干活人数,出了问题都不知道找谁。
方式 2:
用线程池 = 建「正规工厂」干活
工厂提前招好一批固定的工人,工人一直待在厂里待命;来了任务,直接分配给空闲的工人干就行;任务多了干不完,就把任务放进任务仓库(阻塞队列) 排队;工人干完一个活,立刻去仓库领新活干;就算活太多,也只会临时招少量临时工,绝不会乱招人;活少了,临时工干一段时间没活就辞退,保证工厂效率最高。
线程池的核心价值
线程池的本质:一个「存放线程的池子」,提前创建好一批线程,复用这些线程执行任务,全程统一管理线程的创建、复用、销毁。
- 线程复用:核心线程创建后不会销毁,一个线程能执行无数个任务,彻底避免「创建 / 销毁线程」的巨大开销;
- 控制数量:能严格限制线程的最大数量,不会出现线程过多导致的 CPU / 内存耗尽问题,保证程序稳定;
- 任务排队:任务过多时,自动把任务放进「阻塞队列」排队,不会丢失任务,完美衔接你学过的阻塞队列知识点;
- 统一管理:能轻松监控线程状态、任务进度,还能设置任务超时、拒绝策略,线程不再是零散的「野线程」;
- 提升效率:任务来了不用等创建线程,直接用池子里的空闲线程执行,响应速度极快。
线程池的【核心工作原理】
线程池的工作流程是 固定的执行顺序,也是线程池的灵魂
前置设定(所有线程池都遵守这个设定):
- 工厂的「正式工」= 线程池的【核心线程】:招进来就不会轻易辞退,就算没活干,也在厂里待命;
- 工厂的「临时工」= 线程池的【非核心线程】:只有活特别多的时候才招,没活干一段时间就会被辞退;
- 工厂的「任务仓库」= 线程池的【阻塞队列】:活干不完的时候,任务就排队放这里(BlockingQueue);
- 工厂的「最大人数」= 线程池的【最大线程数】:正式工 + 临时工的总人数,绝对不能超;
线程池执行任务的「4 步黄金流程」
-
第一步:优先找「正式工」干活
任务来了,先看池子里的「核心线程(正式工)」有没有空闲的,有就直接分配任务,马上干活;
如果正式工都在忙,进入第二步。 -
第二步:任务进「仓库排队」
把任务放进线程池内置的「阻塞队列(任务仓库)」里排队,让正式工干完手上的活后,主动去仓库领新任务继续干;
如果仓库也堆满了、排不下任务了,进入第三步。 -
第三步:招「临时工」帮忙干活
此时任务太多,正式工忙不过来、仓库也满了,线程池会临时创建新的线程(临时工) 来执行任务;
临时工的数量有上限:正式工 + 临时工 ≤ 最大线程数,绝对不会无限招人;如果临时工也招满了,进入第四步。 -
第四步:执行「拒单规则」
此时:正式工全忙 + 仓库满 + 临时工全忙,已经没有任何能力处理新任务了 → 线程池会执行拒绝策略(拒单),对新任务做处理(比如抛异常、丢弃任务、让提交任务的线程自己干)。
✅ 核心总结:核心线程 → 阻塞队列 → 非核心线程 → 拒绝策略
线程池的【7 个核心参数】(ThreadPoolExecutor)
public ThreadPoolExecutor(
    int corePoolSize,        // 参数1:核心线程数 → 工厂的「正式工人数」
    int maximumPoolSize,     // 参数2:最大线程数 → 工厂「正式工+临时工」的总人数上限
    long keepAliveTime,      // 参数3:空闲超时时间 → 临时工没事干,多久后被辞退
    TimeUnit unit,           // 参数4:时间单位 → 配合参数3,比如:秒、毫秒
    BlockingQueue<Runnable> workQueue, // 参数5:阻塞队列 → 工厂的「任务仓库」
    ThreadFactory threadFactory,       // 参数6:线程工厂 → 招人规则(给线程起名字、设置优先级)
    RejectedExecutionHandler handler    // 参数7:拒绝策略 → 任务爆满时的「拒单规则」
)
-
✔ 1. corePoolSize 核心线程数(正式工人数)
线程池常驻的线程数量,线程池创建后,会初始化这些线程,就算没任务,这些线程也不会销毁,一直待命;
比如设置corePoolSize=5,就是工厂固定有 5 个正式工,随时干活。 -
✔ 2. maximumPoolSize 最大线程数(总人数上限)
线程池能创建的最大线程总数,包含「核心线程 + 非核心线程」;
规则:最大线程数 ≥ 核心线程数;比如corePoolSize=5,maximumPoolSize=10,说明最多能招 5 个临时工。 -
✔ 3. keepAliveTime + TimeUnit unit 空闲超时时间 + 单位
专门针对「非核心线程(临时工)」的规则:临时工干完活后,空闲多久就被辞退;
比如keepAliveTime=3,unit=TimeUnit.SECONDS → 临时工空闲 3 秒,就被解雇,释放资源;
补充:可以通过方法设置「核心线程也能超时销毁」,默认核心线程永不销毁。 -
✔ 4. workQueue 阻塞队列(任务仓库)
线程池的任务排队容器,就是你之前学的BlockingQueue接口的实现类;
常用实现:ArrayBlockingQueue(有界队列,推荐)、LinkedBlockingQueue(链表队列);
✅ 核心原则:开发中必须用「有界队列」(指定容量),绝对不能用无界队列!否则任务无限排队,内存直接炸了。 -
✔ 5. handler 拒绝策略(拒单规则)
任务爆满时的处理规则(核心线程忙 + 队列满 + 非核心线程忙),JDK 内置了 4 种默认策略,都是ThreadPoolExecutor的静态内部类,通俗好懂:
AbortPolicy(默认):直接抛异常「拒绝任务」,告诉调用者:任务满了,处理不了;开发中最常用,能及时发现问题;
CallerRunsPolicy:让「提交任务的线程」自己执行这个任务(比如主线程提交任务,就主线程自己干),不会丢任务,也不抛异常;
DiscardPolicy:默默丢弃最新的任务,不抛异常、不提示,不推荐,丢了任务都不知道;
DiscardOldestPolicy:丢弃队列里最老的任务,把位置让给新任务,也不抛异常。 -
✔ 6. threadFactory 线程工厂 & 7. 其他
线程工厂:就是「创建线程的规则」,比如给线程起个有意义的名字(方便调试)、设置线程优先级等;
这两个参数属于「锦上添花」。
线程池的创建:
public void threadPoolTest() {
        ThreadPoolExecutor tpe = new ThreadPoolExecutor(
                5,                  // 核心线程数(正式工):5个
                10,                 // 最大线程数(总人数):5正式+5临时
                60,                  // 临时工空闲3秒就辞退
                TimeUnit.SECONDS,   // 时间单位:秒
                new ArrayBlockingQueue<>(10), // 阻塞队列:任务仓库,最多放10个任务(有界,核心!)
                Executors.defaultThreadFactory(), // 默认线程工厂
                new ThreadPoolExecutor.AbortPolicy() // 拒绝策略:任务爆满抛异常(默认)静态内部类
        );

        //提交20个任务执行(5正式+5临时+10队列=20,刚好容纳,再多就抛异常)
        for (int i = 0; i < 20; i++) {
            int finalI = i;
            tpe.execute(() -> {
                System.out.println(Thread.currentThread().getName() + "----" + finalI);
                try {
                    Thread.sleep(500);
                } catch (InterruptedException e) {
                    throw new RuntimeException(e);
                }
            });
        }
    }
△ 线程池设置多大合适
Java中使用Runtime.getRuntime().availableProcessors()获取当前计算机能够使用的cpu数
// 获取CPU核心数,返回int类型(比如8核返回8)
int coreNum = Runtime.getRuntime().availableProcessors();
线程池的核心线程数设置,唯一的核心依据:
你的业务任务是「CPU 密集型」还是「IO 密集型」,这两种任务的线程运行状态天差地别,配置原则完全相反!
线程数设置的终极目标:让 CPU 的利用率达到最高,不浪费、不超载
CPU 密集型任务:线程「霸占 CPU 不松手」
任务的执行逻辑,99% 的时间都在占用 CPU 做计算,没有任何停顿 / 等待,典型场景:
- 数据计算、排序(冒泡 / 快排)、遍历海量集合;
- 加密 / 解密、压缩 / 解压缩、数学运算;
- 纯内存数据处理,无任何磁盘 / 网络交互。
核心线程数 = CPU核心数 + 1
最大线程数 = 核心线程数 (和核心线程数保持一致即可)

为什么要 +1 ?
CPU 密集型任务的线程,会霸占 CPU 不松手,理论上「CPU 核心数 = 线程数」刚好占满所有核心,效率最高。
+1 的目的:做「备用线程」,防止某个线程因为偶尔的、极短暂的阻塞(比如一次内存分配失败、一次 GC 停顿)导致 CPU 核心空闲,这个备用线程可以立刻补上,让 CPU 利用率始终保持 100%,不浪费一丝性能。
IO 密集型任务:线程「大部分时间摸鱼,偶尔干活」
任务的执行逻辑,90% 的时间都在「等待」,只有 10% 的时间在占用 CPU 干活,典型场景:
- 数据库操作:Mybatis/JDBC 查询、插入、更新数据;
- 缓存操作:Redis 读写、Memcached 交互;
- 文件 / 网络 IO:读写本地文件、调用第三方接口、微服务之间的远程调用、HTTP 请求;
- 消息队列:生产 / 消费 MQ 消息;
核心线程数 = CPU核心数 × 2
最大线程数 = 核心线程数 (无需非核心线程)
△ Volatile关键字
volatile 是 Java 中轻量级的并发关键字
作用:
- ✅ ① 保证变量的 可见性
- ✅ ② 禁止指令的 重排序
- 但是不能保证原子性!
核心功能:
-
主内存 :相当于你们班级的「黑板」,所有同学(线程)都能看到,黑板上写的内容是「唯一的、最新的、真实的」。
-
线程的工作内存(缓存) :相当于每个同学自己的「笔记本」,同学看黑板上的内容后,会抄到自己的笔记本上,之后做题就只看自己的笔记本,不会每次都抬头看黑板。
-
线程操作变量的本质 :Java 中所有变量都存在「主内存」,每个线程执行时,不会直接操作主内存的变量,而是先把变量「复制一份」到自己的「工作内存(缓存)」里,之后对变量的读、改操作,全是在自己的缓存里执行。
没有 volatile 时,会出现 2 个致命问题
- ❌ 问题 1:【缓存不一致 → 可见性缺失】
比如黑板上写了数字 0,同学 A、B 都抄到笔记本上。
同学 A 把自己笔记本的数字改成 1,但是没有把修改后的数字写回黑板,或者写回去了但同学 B「没抬头看黑板」,同学 B 的笔记本上永远是 0。
→ 这就是线程 A 的修改,对线程 B「不可见」。 - ❌ 问题 2:【CPU 乱序执行 → 有序性缺失】
CPU 为了提升执行效率,会对代码的「执行指令」做 「重排序」:比如你写的代码是步骤1→步骤2→步骤3,CPU 可能实际执行步骤2→步骤1→步骤3,只要最终结果不变就行。
○ [Git]手写Java线程池
● 反射
反射(Reflection) 是Java语言的一项强大特性,它允许程序在运行状态中,对于任意一个类,都能够知道这个类的所有属性和方法;对于任意一个对象,都能够调用它的任意属性和方法。简单来说,反射就像给Java类"照镜子",能够看清类的内部结构。
想象一下,你有一个密封的盒子(User类),正常情况下你只能通过盒子上的几个按钮(公共方法)来操作它。但有时候,你需要:
- 知道盒子内部有什么零件(字段)
- 看看盒子有哪些隐藏功能(私有方法)
- 在不知道盒子具体型号的情况下操作它(动态加载)
- 反射就是给你一个X光机,让你能透视这个盒子,看到并操作内部的一切!
实例User类:
package com.example.model;

import lombok.Data;
import lombok.Builder;
import lombok.NoArgsConstructor;
import lombok.AllArgsConstructor;

import java.time.LocalDateTime;
import java.util.List;

@Data
@Builder
@NoArgsConstructor
@AllArgsConstructor
public class User {
    // 基本属性
    private Long id;
    private String username;
    private String password;
    private String email;
    private String phone;
    private String nickname;
    private String realName;

    // 数值属性
    private int age;
    private double score;

    // 布尔属性
    private boolean active;
    private Boolean verified;

    // 日期属性
    private LocalDateTime createTime;

    // 复杂类型
    private List<String> roles;

    // 静态常量
    public static final String DEFAULT_ROLE = "USER";
    public static final int MAX_AGE = 150;

    // 枚举
    public enum Gender {
        MALE, FEMALE, UNKNOWN
    }
    private Gender gender;

    // 构造方法
    public User(String username, String email) {
        this.username = username;
        this.email = email;
        this.createTime = LocalDateTime.now();
        this.active = true;
    }

    // 自定义方法
    public String getDisplayName() {
        return nickname != null ? nickname : username;
    }

    public boolean isAdult() {
        return age >= 18;
    }

    private void privateMethod() {
        System.out.println("This is a private method");
    }

    public static User createDefault() {
        return User.builder()
                .username("default")
                .email("default@example.com")
                .age(18)
                .active(true)
                .build();
    }

    // 重写toString
    @Override
    public String toString() {
        return String.format("User{id=%d, username='%s', email='%s', age=%d, active=%s}",
                id, username, email, age, active);
    }
}
User类的正常使用 vs 反射使用
// 编译时就知道要创建User对象
User user = new User("张三", "zhangsan@example.com");
user.setAge(25);
System.out.println(user.getDisplayName());
// 运行时才知道要操作User类
Class<?> clazz = Class.forName("com.example.model.User");
Object user = clazz.getConstructor(String.class, String.class)
                  .newInstance("张三", "zhangsan@example.com");
Method setAgeMethod = clazz.getMethod("setAge", int.class);
setAgeMethod.invoke(user, 25);
○ 反射的四大核心操作
△ 获取Class对象
每个类在JVM中都有一个唯一的Class对象,就像人的身份证:
获取Class对象的方法
| 方法名 | 所属类 | 描述 | 返回类型 | 示例 |
|---|---|---|---|---|
.class | 类字面量 | 通过类名直接获取Class对象 | Class<T> | User.class |
getClass() | Object | 通过对象实例获取Class对象 | Class<?> | user.getClass() |
Class.forName() | Class | 通过完整类名获取Class对象 | Class<?> | Class.forName("com.example.model.User") |
ClassLoader.loadClass() | ClassLoader | 通过类加载器获取Class对象 | Class<?> | ClassLoader.getSystemClassLoader().loadClass("com.example.model.User") |
获取类信息的方法
| 方法 | 说明 | 示例 | 返回值 |
|---|---|---|---|
getName() | 获取全限定名 | User.class.getName() | "com.example.User" |
getSimpleName() | 获取简单类名 | User.class.getSimpleName() | "User" |
getCanonicalName() | 获取规范类名 | User.class.getCanonicalName() | "com.example.User" |
getPackage() | 获取包信息 | User.class.getPackage() | Package对象 |
getModifiers() | 获取修饰符 | User.class.getModifiers() | int值 |
getSuperclass() | 获取父类 | User.class.getSuperclass() | Class对象 |
getInterfaces() | 获取接口 | User.class.getInterfaces() | Class[]数组 |
类型检查方法
| 方法 | 说明 | 示例 | 返回值 |
|---|---|---|---|
isInterface() | 是否是接口 | User.class.isInterface() | boolean |
isArray() | 是否是数组 | User.class.isArray() | boolean |
isEnum() | 是否是枚举 | User.class.isEnum() | boolean |
isAnnotation() | 是否是注解 | User.class.isAnnotation() | boolean |
isPrimitive() | 是否是基本类型 | User.class.isPrimitive() | boolean |
isAssignableFrom(Class) | 是否可赋值 | Object.class.isAssignableFrom(User.class) | boolean |
获取成员方法
| 方法 | 说明 | 示例 | 返回值 |
|---|---|---|---|
getFields() | 获取公共字段 | User.class.getFields() | Field[] |
getDeclaredFields() | 获取所有字段 | User.class.getDeclaredFields() | Field[] |
getMethods() | 获取公共方法 | User.class.getMethods() | Method[] |
getDeclaredMethods() | 获取所有方法 | User.class.getDeclaredMethods() | Method[] |
getConstructors() | 获取公共构造器 | User.class.getConstructors() | Constructor[] |
getDeclaredConstructors() | 获取所有构造器 | User.class.getDeclaredConstructors() | Constructor[] |
// 完整方法签名
public static Class<?> forName(String className) throws ClassNotFoundException
public static Class<?> forName(String name, boolean initialize, ClassLoader loader) throws ClassNotFoundException

// 参数说明:
// 1. className: 类的全限定名(包名+类名)
// 2. initialize: 是否初始化类(执行static块)
// 3. loader: 指定类加载器

// 使用示例:
// 基本用法
Class<?> userClass1 = Class.forName("com.example.model.User");

// 指定不初始化静态块
Class<?> userClass2 = Class.forName("com.example.model.User", false,
                                     Thread.currentThread().getContextClassLoader());

// 指定系统类加载器
Class<?> userClass3 = Class.forName("com.example.model.User", true,
                                     ClassLoader.getSystemClassLoader());


// 通过类加载器
Class<?> userClass4 = ClassLoader.getSystemClassLoader()
                                 .loadClass("com.example.model.User");
ClassLoader相关方法
// 通过类加载器获取Class对象
ClassLoader classLoader = Thread.currentThread().getContextClassLoader();
Class<?> userClass = classLoader.loadClass("com.example.model.User");

// 区别:
// 1. Class.forName() 会初始化类(执行static代码块)
// 2. ClassLoader.loadClass() 默认不会初始化类
// 3. 初始化:为静态变量分配内存并赋初值,执行static块
△ 构造函数操作
Constructor类用于创建类的实例。
获取构造函数
| 方法名 | 描述 | 返回类型 | 示例 |
|---|---|---|---|
getConstructors() | 获取所有公共构造函数 | Constructor<?>[] | User.class.getConstructors() |
getConstructor(Class<?>...) | 获取指定参数类型的公共构造函数 | Constructor<T> | User.class.getConstructor(String.class, String.class) |
getDeclaredConstructors() | 获取所有构造函数(包括私有) | Constructor<?>[] | User.class.getDeclaredConstructors() |
getDeclaredConstructor(Class<?>...) | 获取指定参数类型的构造函数(包括私有) | Constructor<T> | User.class.getDeclaredConstructor() |
操作构造函数
| 方法名 | 描述 | 返回类型 | 示例 |
|---|---|---|---|
newInstance(Object...) | 使用构造函数创建实例 | T | constructor.newInstance("张三", "zhangsan@example.com") |
getParameterTypes() | 获取构造函数的参数类型数组 | Class<?>[] | constructor.getParameterTypes() |
getModifiers() | 获取构造函数的修饰符 | int | constructor.getModifiers() |
setAccessible(boolean) | 设置构造函数的可访问性 | void | constructor.setAccessible(true) |
import java.lang.reflect.Constructor;

public class ConstructorDemo {
    public static void main(String[] args) throws Exception {
        Class<User> userClass = User.class;

        // 1. 获取所有公共构造方法
        Constructor<?>[] publicConstructors = userClass.getConstructors();
        System.out.println("公共构造方法数量: " + publicConstructors.length);

        // 2. 获取指定参数的公共构造方法
        Constructor<User> stringConstructor = userClass.getConstructor(String.class, String.class);
        System.out.println("获取到(username, email)构造方法: " + stringConstructor);

        // 3. 调用构造方法创建实例
        User user1 = stringConstructor.newInstance("李四", "lisi@example.com");
        System.out.println("反射创建的用户: " + user1);

        // 4. 获取无参构造方法(Lombok生成)
        Constructor<User> noArgConstructor = userClass.getConstructor();
        User user2 = noArgConstructor.newInstance();
        user2.setUsername("王五");
        System.out.println("无参构造创建的用户: " + user2);

        // 5. 获取所有构造方法(包括私有)
        Constructor<?>[] allConstructors = userClass.getDeclaredConstructors();
        System.out.println("\n所有构造方法列表:");
        for (Constructor<?> constructor : allConstructors) {
            System.out.println("  " + constructor);
        }

        //使用私有构造需要设置setAccessible(true)允许使用private
			Constructor<User> constructor = userClass.getDeclaredConstructor(
                String.class,
                String.class,
                String.class
        );
        constructor.setAccessible(true);
        User user = constructor.newInstance("张三", "123", "123");
        System.out.println(user);
    }
}
△ 操作字段(Field)
通过Field类可以访问和修改类的字段,包括私有字段。
访问控制方法
| 方法 | 说明 | 示例 | 返回值 |
|---|---|---|---|
setAccessible(boolean) | 设置可访问性 | field.setAccessible(true) | void |
isAccessible() | 检查是否可访问 | field.isAccessible() | boolean |
获取字段信息
| 方法 | 说明 | 示例 | 返回值 |
|---|---|---|---|
getName() | 获取字段名 | field.getName() | String |
getType() | 获取字段类型 | field.getType() | Class |
getGenericType() | 获取泛型类型 | field.getGenericType() | Type |
getModifiers() | 获取修饰符 | field.getModifiers() | int |
getDeclaringClass() | 获取声明类 | field.getDeclaringClass() | Class |
isEnumConstant() | 是否是枚举常量 | field.isEnumConstant() | boolean |
isSynthetic() | 是否是合成字段 | field.isSynthetic() | boolean |
注解相关方法
| 方法 | 说明 | 示例 | 返回值 |
|---|---|---|---|
getAnnotations() | 获取所有注解 | field.getAnnotations() | Annotation[] |
getAnnotation(Class) | 获取指定注解 | field.getAnnotation(NotNull.class) | Annotation |
isAnnotationPresent(Class) | 是否有指定注解 | field.isAnnotationPresent(NotNull.class) | boolean |
getDeclaredAnnotations() | 获取声明注解 | field.getDeclaredAnnotations() | Annotation[] |
获取字段的方法
import java.lang.reflect.Field;
import java.time.LocalDateTime;
import java.util.Arrays;

public class FieldDemo {
    public static void main(String[] args) throws Exception {
        User user = User.builder()
                .username("testuser")
                .email("test@example.com")
                .age(25)
                .score(95.5)
                .active(true)
                .verified(true)
                .createTime(LocalDateTime.now())
                .roles(Arrays.asList("ADMIN", "USER"))
                .gender(User.Gender.MALE)
                .build();

        Class<?> userClass = user.getClass();

        // 1. 获取所有公共字段
        Field[] publicFields = userClass.getFields();
        System.out.println("公共字段数量: " + publicFields.length);

        // 2. 获取所有字段(包括私有)
        Field[] allFields = userClass.getDeclaredFields();
        System.out.println("\n所有字段列表:");
        for (Field field : allFields) {
            System.out.printf("  字段名: %-15s 类型: %-20s 修饰符: %s\n",
                    field.getName(), field.getType().getSimpleName(),
                    field.getModifiers());
        }

        // 3. 获取并操作公共字段
        Field usernameField = userClass.getDeclaredField("username");
        System.out.println("\n原username: " + usernameField.get(user));
        usernameField.set(user, "newusername");
        System.out.println("修改后username: " + user.getUsername());

        // 4. 操作私有字段(需要设置accessible为true)
        Field idField = userClass.getDeclaredField("id");
        idField.setAccessible(true);  // 突破私有访问限制
        idField.set(user, 1001L);
        System.out.println("设置的私有字段id: " + user.getId());

        // 5. 操作基本类型字段
        Field ageField = userClass.getDeclaredField("age");
        ageField.setAccessible(true);
        System.out.println("原age: " + ageField.getInt(user));
        ageField.setInt(user, 30);
        System.out.println("修改后age: " + user.getAge());

        // 6. 操作静态字段
        Field defaultRoleField = userClass.getDeclaredField("DEFAULT_ROLE");
        System.out.println("静态常量DEFAULT_ROLE: " + defaultRoleField.get(null));

        // 7. 操作枚举字段
        Field genderField = userClass.getDeclaredField("gender");
        genderField.setAccessible(true);
        System.out.println("枚举gender: " + genderField.get(user));
    }
}
△ 方法(Method)操作
获取方法信息
| 方法 | 说明 | 示例 | 返回值 |
|---|---|---|---|
getName() | 获取方法名 | method.getName() | String |
getReturnType() | 获取返回类型 | method.getReturnType() | Class |
getGenericReturnType() | 获取泛型返回类型 | method.getGenericReturnType() | Type |
getModifiers() | 获取修饰符 | method.getModifiers() | int |
getDeclaringClass() | 获取声明类 | method.getDeclaringClass() | Class |
isBridge() | 是否是桥接方法 | method.isBridge() | boolean |
isSynthetic() | 是否是合成方法 | method.isSynthetic() | boolean |
isDefault() | 是否是默认方法 | method.isDefault() | boolean |
isVarArgs() | 是否是可变参数 | method.isVarArgs() | boolean |
参数信息方法
| 方法 | 说明 | 示例 | 返回值 |
|---|---|---|---|
getParameterTypes() | 获取参数类型 | method.getParameterTypes() | Class[] |
getParameterCount() | 获取参数数量 | method.getParameterCount() | int |
getParameters() | 获取Parameter对象 | method.getParameters() | Parameter[] |
getGenericParameterTypes() | 获取泛型参数类型 | method.getGenericParameterTypes() | Type[] |
异常信息方法
| 方法 | 说明 | 示例 | 返回值 |
|---|---|---|---|
getExceptionTypes() | 获取异常类型 | method.getExceptionTypes() | Class[] |
getGenericExceptionTypes() | 获取泛型异常类型 | method.getGenericExceptionTypes() | Type[] |
方法调用
| 方法 | 说明 | 示例 | 返回值 |
|---|---|---|---|
getAnnotations() | 获取所有注解 | method.getAnnotations() | Annotation[] |
getAnnotation(Class) | 获取指定注解 | method.getAnnotation(Override.class) | Annotation |
isAnnotationPresent(Class) | 是否有指定注解 | method.isAnnotationPresent(Override.class) | boolean |
getDeclaredAnnotations() | 获取声明注解 | method.getDeclaredAnnotations() | Annotation[] |
getParameterAnnotations() | 获取参数注解 | method.getParameterAnnotations() | Annotation[][] |
import java.lang.reflect.Method;
import java.lang.reflect.Modifier;

public class MethodDemo {
    public static void main(String[] args) throws Exception {
        User user = User.builder()
                .username("methoduser")
                .email("method@example.com")
                .age(20)
                .nickname("昵称")
                .build();

        Class<?> userClass = user.getClass();

        // 1. 获取所有公共方法(包括继承的)
        Method[] publicMethods = userClass.getMethods();
        System.out.println("公共方法总数: " + publicMethods.length);
        System.out.println("前5个公共方法:");
        for (int i = 0; i < Math.min(5, publicMethods.length); i++) {
            System.out.println("  " + publicMethods[i]);
        }

        // 2. 获取所有声明的方法(不包括继承的)
        Method[] declaredMethods = userClass.getDeclaredMethods();
        System.out.println("\nUser类声明的方法列表:");
        for (Method method : declaredMethods) {
            String modifier = Modifier.toString(method.getModifiers());
            System.out.printf("  %-20s %s\n", modifier, method.getName());
        }

        // 3. 调用公共方法
        Method getDisplayNameMethod = userClass.getDeclaredMethod("getDisplayName");
        Object result = getDisplayNameMethod.invoke(user);
        System.out.println("\n调用getDisplayName(): " + result);

        Method isAdultMethod = userClass.getDeclaredMethod("isAdult");
        boolean isAdult = (boolean) isAdultMethod.invoke(user);
        System.out.println("调用isAdult(): " + isAdult);

        // 4. 调用私有方法
        Method privateMethod = userClass.getDeclaredMethod("privateMethod");
        privateMethod.setAccessible(true);
        System.out.print("调用私有方法privateMethod(): ");
        privateMethod.invoke(user);

        // 5. 调用静态方法
        Method createDefaultMethod = userClass.getDeclaredMethod("createDefault");
        User defaultUser = (User) createDefaultMethod.invoke(null);
        System.out.println("\n调用静态方法createDefault(): " + defaultUser);

        // 6. 调用带参数的方法(示例:setter方法)
        Method setAgeMethod = userClass.getMethod("setAge", int.class);
        setAgeMethod.invoke(user, 35);
        System.out.println("通过反射设置age后: " + user.getAge());
    }
}
△ 操作泛型与枚举
泛型操作
public class ReflectionGenericDemo {
    public static void main(String[] args) throws Exception {
        Class<User> userClass = User.class;
        User user = new User();

        // 获取List<String> roles字段
        Field rolesField = userClass.getDeclaredField("roles");
        rolesField.setAccessible(true);

        // 获取泛型类型信息
        Type genericType = rolesField.getGenericType();
        if (genericType instanceof ParameterizedType) {
            ParameterizedType paramType = (ParameterizedType) genericType;
            Type[] typeArgs = paramType.getActualTypeArguments();
            System.out.println("roles字段的泛型类型: " + typeArgs[0]);  // class java.lang.String
        }

        // 创建ArrayList并设置值
        List<String> roles = new ArrayList<>();
        roles.add("ADMIN");
        roles.add("USER");
        rolesField.set(user, roles);

        // 获取并遍历
        List<String> userRoles = (List<String>) rolesField.get(user);
        System.out.println("用户角色: " + userRoles);
    }
}
操作枚举
public class ReflectionEnumDemo {
    public static void main(String[] args) throws Exception {
        Class<User> userClass = User.class;

        // 1. 获取枚举类
        Class<?> genderEnumClass = Class.forName("com.example.model.User$Gender");

        // 2. 获取所有枚举值
        Object[] enumValues = genderEnumClass.getEnumConstants();
        System.out.println("Gender枚举值:");
        for (Object value : enumValues) {
            System.out.println(value);
        }
        // 输出:MALE, FEMALE, UNKNOWN

        // 3. 创建带枚举的User对象
        User user = new User();

        // 获取枚举字段
        Field genderField = userClass.getDeclaredField("gender");
        genderField.setAccessible(true);

        // 获取特定的枚举值
        Method valueOfMethod = genderEnumClass.getMethod("valueOf", String.class);
        Object maleEnum = valueOfMethod.invoke(null, "MALE");

        // 设置枚举值
        genderField.set(user, maleEnum);
        System.out.println("\n用户性别: " + user.getGender());
    }
}
○ 反射底层原理机制
△ 类加载机制
类的生命周期:从字节码到可用的类
想象你网购了一件家具(.class文件),从下单到使用,经历这样的过程:

| 阶段 | 做了什么 | 生活类比 |
|---|---|---|
| 加载 | 读取.class字节流,创建Class对象 | 快递员把包裹送到家门口 |
| 验证 | 检查字节码格式、语义是否合法 | 开箱检查家具有没有损坏、零件齐不齐 |
| 准备 | 为静态变量分配内存,赋默认值(0/null) | 在房间里腾出放家具的位置 |
| 解析 | 将符号引用转为直接引用 | 把说明书上的零件编号对应到实际零件 |
| 初始化 | 执行静态代码块,赋真正初始值 | 正式组装家具并投入使用 |
类加载的五个核心阶段
阶段1:加载(Loading)
这是反射的生命起点。在这个阶段,JVM完成三件事:
找到字节码:根据类名(如com.example.Student)找到对应的.class文件
读取内容:把文件内容读成二进制数据流
创建Class对象:在堆内存中生成该类的Class对象
一个类只会被加载一次,所以Class对象在JVM中全局唯一
阶段2:验证(Verification)
JVM非常谨慎,它要确保字节码是安全的、合法的:
检查文件格式是否正确(是不是正经的.class文件)
检查是否有非法指令
检查是否符合Java语法规范
这个阶段如果出错,会抛出VerifyError3。
阶段3:准备(Preparation)
为类的静态变量分配内存,并设置默认值(不是代码里写的值!)
// 代码中这样写
public static int count = 100;

// 准备阶段:给count分配内存,赋值为0(int的默认值)
// 真正的赋值100发生在初始化阶段
特殊例外:如果变量是static final常量,准备阶段直接赋真实值:
public static final int MAX_SIZE = 1024; // 准备阶段直接赋值为1024
阶段4:解析(Resolution)
把代码中的"符号引用"(如Student.name)转换成JVM内存中的"直接引用"(内存地址)
阶段5:初始化(Initialization)
真正执行类中的静态代码:
public class Student {
    static {
        System.out.println("Student类初始化了!");  // 这里执行
    }
    public static int count = 100;  // 这里赋值为100
}
在初始化完成后会在方法区生成class二进制数据
会在堆内生成Class实例对象对应类的class模板对象
双亲委派模型的工作流程
// 伪代码:ClassLoader.loadClass() 的核心逻辑
protected Class<?> loadClass(String name) {
    // 1. 先检查是否已经加载过(缓存)
    Class<?> c = findLoadedClass(name);
    if (c == null) {
        // 2. 委派给父加载器(层层上报)
        if (parent != null) {
            c = parent.loadClass(name);  // 递归向上
        } else {
            c = findBootstrapClass(name); // 到顶了,问Bootstrap
        }
        // 3. 父加载器加载失败,自己才尝试加载
        if (c == null) {
            c = findClass(name);  // 自己干活
        }
    }
    return c;
}
源码:
protected Class<?> loadClass(String name, boolean resolve)
        throws ClassNotFoundException
    {
        synchronized (getClassLoadingLock(name)) {
            // First, check if the class has already been loaded
            Class<?> c = findLoadedClass(name);
            if (c == null) {
                long t0 = System.nanoTime();
                try {
                    if (parent != null) {
                        c = parent.loadClass(name, false);
                    } else {
                        c = findBootstrapClassOrNull(name);
                    }
                } catch (ClassNotFoundException e) {
                    // ClassNotFoundException thrown if class not found
                    // from the non-null parent class loader
                }

                if (c == null) {
                    // If still not found, then invoke findClass in order
                    // to find the class.
                    long t1 = System.nanoTime();
                    c = findClass(name);

                    // this is the defining class loader; record the stats
                    PerfCounter.getParentDelegationTime().addTime(t1 - t0);
                    PerfCounter.getFindClassTime().addElapsedTimeFrom(t1);
                    PerfCounter.getFindClasses().increment();
                }
            }
            if (resolve) {
                resolveClass(c);
            }
            return c;
        }
    }
Class如何变为JVM的内部数据

- InstanceKlass(C++层面):存储类的完整元数据,在方法区/元空间
- Class对象(Java层面):InstanceKlass的Java镜像,供反射API使用
△ Class对象
Class对象的本质:类的"身份证"

在Java世界里,每个类(包括String、ArrayList)都是java.lang.Class类的一个实例对象。
更准确地说:每个类在堆内存中都有一个对应的Class对象,这个对象就是该类的"身份证"。
// 这三个Class对象是同一个对象!
Class<?> c1 = Student.class;
Class<?> c2 = new Student().getClass();
Class<?> c3 = Class.forName("com.example.Student");

System.out.println(c1 == c2);  // true
System.out.println(c1 == c3);  // true
Class对象创建(JVM独家垄断)
Class类的构造方法:
private Class(ClassLoader loader, Class<?> arrayComponentType) {
        // Initialize final field for classLoader.  The initialization value of non-null
        // prevents future JIT optimizations from assuming this final field is null.
        classLoader = loader;
        componentType = arrayComponentType;
    }
JVM通过这种方式保证:一个类只有一个Class对象。如果允许随意创建,就会出现多个Class对象对应同一个类,数据就乱套了。
Class对象能做什么?
Class对象就像类的"控制面板",提供了所有操作接口:
public class Class<T> {
    // 1. 获取类的基本信息
    String getName();      // 全限定名:com.example.Student
    String getSimpleName(); // 简单名:Student

    // 2. 获取类的成员(反射的核心)
    Field getDeclaredField(String name);      // 获取属性(包括私有)
    Method getDeclaredMethod(String name, Class<?>... params); // 获取方法
    Constructor<T> getDeclaredConstructor(Class<?>... params); // 获取构造器

    // 3. 创建对象
    T newInstance();  // 过时方法,推荐用构造器

    // 4. 类型判断
    boolean isInstance(Object obj);  // obj是不是这个类的实例
}
△ 反射底层原理
了解完类加载机制与Class对象后开始详解反射底层的机制原理
根据Class部分源码来理解Class.forName()底层机制:
public final class Class<T> implements Serializable, GenericDeclaration,
                                        Type, AnnotatedElement {
    // ========== 核心元数据缓存 ==========
    private transient String name;           // 类名
    private transient Module module;         // 所属模块(Java9+)

    // 反射数据的软引用缓存(按需加载,避免内存浪费)
    private transient volatile SoftReference<ReflectionData<T>> reflectionData;

    // ReflectionData内部结构(简化版):
    // static class ReflectionData<T> {
    //     volatile Field[] declaredFields;      // 声明的字段
    //     volatile Field[] publicFields;        // 公开字段
    //     volatile Method[] declaredMethods;    // 声明的方法
    //     volatile Method[] publicMethods;      // 公开方法
    //     volatile Constructor<T>[] declaredConstructors; // 构造器
    //     ...
    // }

    private transient volatile T[] enumConstants;    // 枚举常量
    private transient volatile Map<String, T> enumConstantDirectory;
    private transient volatile AnnotationData annotationData; // 注解

    // ========== native方法:通往JVM的桥梁 ==========
    private native Field[] getDeclaredFields0(boolean publicOnly);
    private native Method[] getDeclaredMethods0(boolean publicOnly);
    private native Constructor<T>[] getDeclaredConstructors0(boolean publicOnly);
}
这行代码到底做了什么?
Class<?> clazz = Class.forName("com.example.User");

getMethod() / getField() 如何查询元数据
Method method = clazz.getMethod("setName", String.class);

源码简化版:
private Method[] privateGetDeclaredMethods(boolean publicOnly) {
    Method[] res;
    ReflectionData<T> rd = reflectionData();
    if (rd != null) {
        res = publicOnly ? rd.publicMethods : rd.declaredMethods;
        if (res != null) return res;
    }
    // 缓存未命中,调用native
    res = getDeclaredMethods0(publicOnly);  // 真正去JVM取数据
    // 存入缓存...
    return res;
}
△ Invoke的底层
Method method = User.class.getMethod("setName", String.class);
method.invoke(userInstance, "张三");  // 底层发生了什么?
Method.invoke() 的内部机制:


动态生成的字节码
// JVM动态生成的类,等价于:
public class GeneratedMethodAccessor1 extends MethodAccessorImpl {
    public Object invoke(Object obj, Object[] args) {
        // 直接调用!没有任何反射开销
        ((User) obj).setName((String) args[0]);
        return null;
    }
}
NativeMethodAccessorImpl:反射的"慢速通道"
当invoke调用方法在1-15次内使用:
// NativeMethodAccessorImpl的简化源码(OpenJDK)
public class NativeMethodAccessorImpl extends MethodAccessorImpl {
    private final Method method;
    private int numInvocations;  // 调用计数器

    public Object invoke(Object obj, Object[] args) throws ... {
        // 阈值检查:默认15次
        if (++numInvocations > ReflectionFactory.inflationThreshold()) {
            // 达到阈值,创建优化的字节码版本
            MethodAccessorImpl acc = (MethodAccessorImpl)
                new MethodAccessorGenerator()
                    .generateMethod(method.getDeclaringClass(),
                                  method.getName(),
                                  method.getParameterTypes(),
                                  method.getReturnType(),
                                  method.getExceptionTypes(),
                                  method.getModifiers());
            // 替换当前的访问器
            parent.setDelegate(acc);
            // 使用新生成的访问器执行本次调用
            return acc.invoke(obj, args);
        }

        // 未达阈值,使用native调用
        return invoke0(method, obj, args);  // ← JNI调用!
    }

    private static native Object invoke0(Method m, Object obj, Object[] args);
}
这个native调用(invoke0)做了什么
- JNI边界跨越:从Java层进入JVM的C++层
- 参数处理:将Object数组中的参数按需拆箱、类型转换
- 安全检查:检查访问权限(除非setAccessible(true))
- 方法分派:通过vtable(虚方法表)找到实际方法地址
- 栈帧设置:创建新的栈帧,设置参数
- 方法执行:跳转到方法代码开始执行
- 为什么这么慢?
每次调用都要经历完整的JNI开销,相当于每次都要"出国旅游一圈"。
动态字节码生成GeneratedMethodAccessor:反射的"高速公路"
当调用次数达到阈值(默认15次)时,JVM会触发"膨胀"(Inflation)过程,生成优化的字节码。
生成动态字节码相当于生成一个全新的类 下次反射调用指定方法时直接通过这个类调用即可 比在底层寻找虚方法表快多了
// 伪代码:MethodAccessorGenerator如何生成字节码
public MethodAccessor generateMethod(Class<?> declaringClass,
                                   String methodName,
                                   Class<?>[] parameterTypes,
                                   Class<?> returnType,
                                   Class<?>[] exceptionTypes,
                                   int modifiers) {

    // 1. 创建字节码生成器
    BytecodeGenerator gen = new BytecodeGenerator();

    // 2. 生成类名:sun/reflect/GeneratedMethodAccessorN
    String className = "sun/reflect/GeneratedMethodAccessor" + counter.incrementAndGet();

    // 3. 生成类结构
    gen.startClass(className, "sun/reflect/MethodAccessorImpl");

    // 4. 生成invoke方法
    gen.startMethod("invoke", "(Ljava/lang/Object;[Ljava/lang/Object;)Ljava/lang/Object;");

    // 5. 生成方法体字节码(核心!)
    // 目标:直接调用method,避免反射开销
    generateDirectInvocation(gen, declaringClass, methodName,
                            parameterTypes, returnType);

    // 6. 完成生成
    byte[] bytecode = gen.endMethod().endClass();

    // 7. 定义类并加载
    Class<?> accessorClass = defineClass(bytecode);
    return accessorClass.newInstance();
}
总结Invoke
- 入口:method.invoke()调用
- 委托:DelegatingMethodAccessorImpl决定使用哪个实现
- 初始阶段:NativeMethodAccessorImpl通过JNI调用
- 阈值检测:计数达到15次触发优化
- 字节码生成:MethodAccessorGenerator生成直接调用的字节码
- 类加载:动态定义并加载GeneratedMethodAccessor类
- 切换执行:后续调用走优化路径
- 性能提升:从100ns降到10ns
○ 动态代理
想象一下,你是位明星(真实对象),每天要处理各种事务:表演、采访、商务洽谈。如果所有事都亲力亲为,不仅效率低,还可能忙中出错。于是你聘请了一位经纪人(代理对象),他帮你筛选邀请、安排行程、处理杂务,让你能专注于核心业务——表演。
这就是代理模式的精髓:通过一个中间层(代理)来控制对原始对象的访问。在Java中,这个“经纪人”就是动态代理,而它的超能力来自于反射机制。
△ 静态代理
静态代理就像是手写的经纪人合同。你(程序员)需要为每个明星(类)单独编写一个经纪人(代理类),并且在编译前就确定好所有细节。
代理的核心:
- 目标对象(被代理对象):真正干活的人 / 类,比如:租房的房东、唱歌的明星、执行业务逻辑的UserServiceImpl;
- 代理对象(中间人):替目标对象干活的人 / 类,比如:租房中介、明星经纪人、代理类$Proxy0;
- 增强逻辑:代理对象在执行目标方法时,额外加的逻辑,比如:中介收中介费、经纪人安排行程、日志打印、事务开启 / 提交。
特点:
- 代理类需要实现与目标类相同的接口
- 每个代理类只能为一个特定的目标类服务
- 代码冗余,维护困难(明星越多,经纪人合同越多)
// 明星接口
public interface Star {
    void perform();
}

// 真实明星
public class RealStar implements Star {
    public void perform() {
        System.out.println("明星在舞台上表演...");
    }
}

// 静态代理:手动编写的经纪人
public class StaticProxyStar implements Star {
    private Star realStar;

    public StaticProxyStar(Star realStar) {
        this.realStar = realStar;
    }

    @Override
    public void perform() {
        System.out.println("经纪人:安排场地、售票...");
        realStar.perform();  // 明星真正表演
        System.out.println("经纪人:处理后续事宜...");
    }
}
问题:如果有100个明星,就需要写100个不同的经纪人!于是动态代理应运而生。
△ JDK动态代理
动态代理像是一个智能的经纪人机器人,它能在运行时自动生成经纪人,无论什么明星都能适配。
核心优势:
- 运行时生成代理类,无需预编译
- 一个代理处理器可以服务多个不同的目标类
- 代码复用性极高
两大核心:
InvocationHandler 调用处理器:
JDK 提供了一个工具类 java.lang.reflect.Proxy,它只有一个核心静态方法,用来生成代理对象,这是动态代理的入口,方法如下:
public static Object newProxyInstance(ClassLoader loader,
                                      Class<?>[] interfaces,
                                      InvocationHandler h)
- 入参 1:loader → 类加载器(要素 2);
- 入参 2:interfaces → 目标类实现的所有接口(要素 1);
- 入参 3:h → 调用处理器(要素 3,代理的大脑);
返回值:JVM 生成的代理对象,直接强转成接口类型即可使用。
使用:
创建目标接口和实现类(内只有一个login方法 参数需要User类):

创建核心之一(InvocationHanlder实现类):
public class MyInvocationHandler implements InvocationHandler {

    private final Object target;

    public MyInvocationHandler(Object target) {
        this.target = target;
    }

    @Override
    public Object invoke(Object proxy, Method method, Object[] args) throws Throwable {
        System.out.println("前置增强");
        Object invoke = method.invoke(target, args);
        System.out.println("后置增强");
        return invoke;
    }
}
使用Proxy工具的newProxyInstance()方法:
public class JavaApplication {

    private static final UserService userService = new UserServiceImpl();

    private static final AdminService adminService = new AdminServiceImpl();

    public static void main(String[] args) throws Exception {

        UserService userProxy = (UserService) getProxy(
                userService.getClass().getClassLoader(),
                new Class[]{UserService.class},
                new MyInvocationHandler(userService)
        );

        userProxy.login(User.builder().username("张三").password("123456").build());

        AdminService adminProxy = (AdminService) getProxy(
                adminService.getClass().getClassLoader(),
                new Class[]{AdminService.class},
                new MyInvocationHandler(adminService)
        );

        adminProxy.login(User.builder().username("admin").password("123456").build());
    }

    /**
     * 获取代理对象
     * @param classLoader 目标类加载器
     * @param aclass 目标要实现的接口
     * @param invocationHandler 自定义处理器
     * @return 返回代理对象
     */
    public static Object getProxy(ClassLoader classLoader, Class<?>[] aclass, InvocationHandler invocationHandler) {
        return Proxy.newProxyInstance(
                classLoader,
                aclass,
                invocationHandler
        );
    }

}
动态代理的「核心工具类」:Proxy
△ JDK动态代理底层原理
JVM 到底在背后做了什么?为什么调用proxy.login(),就会走到invoke()方法里?
JVM 的底层执行流程(运行时,4 步完成动态代理)
- “剧本”规划:JVM检查你传入的接口数组,确认它们都是接口且可被类加载器加载。
- “生成剧本”:这是最核心的一步! JVM会动态生成一个新的类的字节码。这个新类:
默认继承自 java.lang.reflect.Proxy。
实现了你指定的所有接口(如 UserService)。
类名通常是类似 Proxy0、Proxy1 这样的格式。 - “找演员”:JVM会尝试从缓存中查找是否已经生成过相同接口组合的代理类。如果没有,就用字节码生成库(早期版本是 sun.misc.ProxyGenerator,现在更底层)把上一步规划的类“编译”成字节码(byte[])。
- “登台表演”:使用你传入的 ClassLoader,将这个新生成的字节数组动态定义并加载为一个新的 Class 对象。
- “注入灵魂”:通过反射,用你传入的 InvocationHandler 实例作为参数,调用这个新生代理类的构造函数,实例化出最终的代理对象并返回给你。
为什么调用代理方法,会走到 invoke () 里
自动生成的$Proxy0类内,实现代码逻辑大体如此:
public class $Proxy0 implements UserService{
    private InvocationHandler h;
    public $Proxy0(InvocationHandler h) {
        this.h = h;
    }
    @Override
    public void login() {
        // 调用InvocationHandler的invoke方法,把当前方法、参数传进去
        h.invoke(this, UserService.class.getMethod("张三"), null);
    }
}
1:InvocationHandler
可以把InvocationHandler看作是一个"万能方法处理器",而Method对象就是它手里拿着的"遥控器"——通过不同的"遥控器"(Method)来控制调用不同的方法。
作用类比
想象你是一个老板(目标对象),每天要处理很多工作(方法调用):
- 开会(
meeting()) - 签文件(
signDocument()) - 审批报销(
approveExpense())
现在你聘请了一个秘书(InvocationHandler)。这个秘书的工作流程是这样的:
- 所有找你的电话、请求都必须先经过秘书
- 秘书会决定:
- 要不要记录这个请求(日志切面)
- 你有没有权限处理(权限校验)
- 什么时候转给你处理(时机控制)
- 要不要对你的处理结果再加工(结果包装)
为什么需要这个类?
其实他就是一个很简单的对方法扩展的功能代码
真正的动态还得看proxy生成的$proxy0和method底层native(C++)实现
它只涉及java层面 所以很容易理解
// 没有InvocationHandler会怎样?
// 假设我们要给UserService加事务和日志

// ❌ 传统方式:硬编码(每个方法都要写重复代码)
class UserService {
    public void addUser(User user) {
        log("开始执行addUser");
        beginTransaction();
        // ... 业务逻辑
        commitTransaction();
        log("结束执行addUser");
    }

    public void deleteUser(int id) {
        log("开始执行deleteUser");
        beginTransaction();
        // ... 业务逻辑
        commitTransaction();
        log("结束执行deleteUser");
    }
    // 每个方法都要重复写日志和事务代码!
}

// ✅ 动态代理方式:统一处理
class TransactionHandler implements InvocationHandler {
    private Object target;

    public Object invoke(Object proxy, Method method, Object[] args) {
        log("开始执行" + method.getName());  // 统一记录日志
        beginTransaction();                   // 统一开启事务
        Object result = method.invoke(target, args); // 执行业务
        commitTransaction();                  // 统一提交事务
        log("结束执行" + method.getName());  // 统一结束日志
        return result;
    }
}
核心价值:解耦!业务代码和横切关注点(日志、事务、安全等)分离。
自定义InvocationHandler接口:
package com.example.handler;

import com.example.handler.impl.CoreMethod;

/**
 * 核心方法处理器接口
 */
public interface CoreInvocationHandler {

    Object invoke(Object proxy, CoreMethod method, Object[] args) throws Throwable;

}
实现:
package com.example.handler.impl;

import com.example.handler.CoreInvocationHandler;
import lombok.extern.slf4j.Slf4j;

/**
 * 万能方法处理器
 * 作用:
 * 根据传入的真实对象(接口)执行代理对象的对应方法
 */
@Slf4j
public class CoreInvocationHandlerImpl implements CoreInvocationHandler {

    /**
     * 真实的目标对象(接口)用来让Method生成该接口的所有方法的实现
     */
    private final Object target;

    public CoreInvocationHandlerImpl(Object target) {
        this.target = target;
    }

    /**
     * 实现前后置增强的主要方法以及调用目标方法
     *
     * @param proxy  生成的代理对象 $proxy0之类
     * @param method 该对象能被调用的方法
     * @param args   方法参数
     * @return 新的代理对象
     */
    @Override
    public Object invoke(Object proxy, CoreMethod method, Object[] args) throws Throwable {
        System.out.println("方法前置增强");
        Object result = method.invoke(target, args);
        System.out.println("方法后置增强");
        return result;
    }
}
2:Proxy

生成的$proxy0代理类内部大体样貌:
缓存的Method对象 当这个class类在初始化时会执行static静态代码块的东西
此时m3存的Method对象会初始化这个方法所对应的所有信息(通过反射获取)
执行到super.h.invoke把这个Method带着这些传入就会去执行InvocationHandler的invoke方法
// Proxy.newProxyInstance() 生成的 $Proxy0 类
public final class $Proxy0 extends java.lang.reflect.Proxy implements UserService {

    // 关键:静态缓存Method对象
    private static java.lang.reflect.Method m0;  // hashCode
    private static java.lang.reflect.Method m1;  // equals
    private static java.lang.reflect.Method m2;  // toString
    private static java.lang.reflect.Method m3;  // UserService.getUser

    static {
        try {
            // 在类加载时一次性反射获取所有Method对象
            m3 = Class.forName("com.example.UserService")
                     .getMethod("getUser", String.class);
            // ... 其他方法
        } catch (Exception e) { throw new RuntimeException(e); }
    }

    // 构造器:接收InvocationHandler
    public $Proxy0(java.lang.reflect.InvocationHandler handler) {
        super(handler);  // 传递给Proxy父类保存
    }

    // 关键:代理方法的实现
    public User getUser(java.lang.String userId) {
        try {
            // 调用父类Proxy中保存的handler的invoke方法
            // 参数1: this(代理对象自己)
            // 参数2: m3(缓存的Method对象,代表getUser方法)
            // 参数3: new Object[]{userId}(参数数组)
            return (User) super.h.invoke(this, m3, new Object[]{userId});
        } catch (Throwable e) {
            throw new RuntimeException(e);
        }
    }

    // ... 其他接口方法的实现
}
3:Method
- 封装方法的元信息:把一个类中某个方法的「方法名、参数类型、返回值类型、所属类、访问修饰符」等信息封装成一个对象;
- 动态调用方法:通过
invoke方法,无需在编译期确定调用哪个方法,而是在运行时动态调用目标对象的该方法(这是动态代理中调用真实业务方法的核心); - 解耦方法调用:比如在动态代理中,无论代理对象调用哪个方法,都能通过
Method对象统一处理,无需为每个方法写重复代码。
主要过程:
-
当proxy动态生成的$proxy0(这里面会包含传入newProxyInstance的所有接口的方法拼凑到一个类里面)的方法需要被调用时
-
这时调用动态代理对象$proxy0(newProxyInstance返回值)的方法例如(login,register)会把方法名参数等信息传入invocationHandler的invoke里
-
此时handler会调用method的invoke
简单来说:Method类就是方法的 “说明书” + “执行器”—— 既描述方法长什么样,又能执行这个方法。
method的invoke底层实现:
java层面:
// Java层:Method类的invoke方法
public Object invoke(Object obj, Object... args) throws IllegalAccessException,
                                                       IllegalArgumentException,
                                                       InvocationTargetException {
    // 1. 权限检查
    if (!override) {
        if (!Reflection.quickCheckMemberAccess(clazz, modifiers)) {
            Class<?> caller = Reflection.getCallerClass();
            checkAccess(caller, clazz, obj, modifiers);
        }
    }

    // 2. 调用native方法
    return invoke0(obj, args);
}

// 关键:native方法声明
private native Object invoke0(Object obj, Object[] args);
从这里开始,控制权从Java层转到JVM层!
4:native方法的实现
C文件JDK 9 + 引入模块化后重构了目录结构(原src/native被拆分到各模块目录),且 JDK 运行时调用的是预编译的本地库文件(.dll/.so/.dylib)
可以通过github下载c源码:https://github.com/orgs/openjdk/
java层面的native方法是如何执行的(本质是通过JNI(Java Native Interface) 实现的)
-
编写包含
native方法的 Java 类,声明要调用的本地方法 -
生成对应 JNI 规范的 C 语言头文件
-
编写 C 语言代码实现头文件中的函数
-
将 C 代码编译为系统可识别的动态链接库(DLL/So/DYLIB)
-
运行 Java 程序,加载动态库并调用
native方法
1:编写带有native方法的类:
动态库链接就是生成的c语言的dll文件
从加载动态链接库报错来看加载动态库链接可能从以下几个目录查找
Exception in thread "main" java.lang.UnsatisfiedLinkError: no NativeLib in java.library.path: D:\Minecraft\Java\jdk-21_windows-x64_bin\jdk-21.0.9\bin;C:\Windows\Sun\Java\bin;C:\Windows\system32;C:\Windows;D:\SoftWare\VMWare\bin\;C:\Windows\system32;C:\Windows;C:\Windows\System32\Wbem;C:\Windows\System32\WindowsPowerShell\v1.0\;C:\Windows\System32\OpenSSH\;D:\SoftWare\BandiZip\;D:\SoftWare\NodeJs\;D:\SoftWare\Git\Git\cmd;C:\Users\apec9\AppData\Local\Microsoft\WindowsApps;;D:\SoftWare\IDEA\IntelliJ IDEA 2024.1.1\bin;;C:\Users\apec9\AppData\Roaming\npm;D:\SoftWare\VSCode\Microsoft VS Code\bin;.
public class NativeTest {

    /**
     * 加载动态链接库
     */
    static {
        System.loadLibrary("NativeLib");
    }

    //定义本地c方法
    private native void nativeMethod(String systemName);

    public static void main(String[] args) {
        NativeTest nativeTest = new NativeTest();
        nativeTest.nativeMethod("systemName");
    }

}
2:生成对应的JNI的C语言头文件
在java类所在执行java指令
# 编译Java类 + 生成JNI头文件(Java 8及以上)
javac -h . NativeTest.java
会生成两个文件:

.h头文件(它相当于java的接口了 需要创建一个cpp去实现他的接口):
/* DO NOT EDIT THIS FILE - it is machine generated */
#include <jni.h>
/* Header for class com_example_model_NativeTest */

#ifndef _Included_com_example_model_NativeTest
#define _Included_com_example_model_NativeTest
#ifdef __cplusplus
extern "C" {
#endif
/*
 * Class:     com_example_model_NativeTest
 * Method:    nativeMethod
 * Signature: (Ljava/lang/String;)V
 */
JNIEXPORT void JNICALL Java_com_example_model_NativeTest_nativeMethod
  (JNIEnv *, jobject, jstring);

#ifdef __cplusplus
}
#endif
#endif
3:编写c的实现代码
#include "com_example_model_NativeTest.h"
#include <stdio.h>

JNIEXPORT void JNICALL Java_com_example_model_NativeTest_nativeMethod
  (JNIEnv *, jobject, jstring) {
    printf("java调用C方法参数");
    //代码实现
  }
4:编译为DLL文件
# 编译为DLL动态库(注意替换JDK路径,比如C:\Program Files\Java\jdk1.8.0_301)默认已安装MinGW64 生成之后放到windows/System32文件夹下
gcc -shared -o NativeTest.dll -I"%JAVA_HOME%\include" -I"%JAVA_HOME%\include\win32" NativeTest.cpp
5:运行java
java---c
Process finished with exit code 0
△ CGLIB动态代理
CGLIB 动态代理 = 基于「子类」的动态代理,无接口要求,JVM 自动生成目标类的子类作为代理类
你不用写任何代理类代码,也不用给目标类加接口,只需要告诉 CGLIB「要代理哪个类」「要加什么增强逻辑」,JVM 在运行时会自动在内存中生成一个 目标类的子类 作为代理类,这个子类就是代理对象,能完美替目标类干活,还能加增强逻辑,目标类的代码一行不用改。
CGLIB vs JDK 核心本质区别
- 💡 JDK 动态代理:基于【接口】实现,代理类 ≈ 目标类的「平级兄弟」
- 💡 CGLIB 动态代理:基于【子类】实现,代理类 ≈ 目标类的「亲儿子」
因为CGLIB不是JDK类库中自带的需要导入jar包或依赖:
<dependency>
    <groupId>cglib</groupId>
    <artifactId>cglib</artifactId>
    <version>3.3.0</version>
    <scope>compile</scope>
</dependency>

如果是jdk21及以上直接导入spring依赖即可
cglib不适配jdk21
而spring内置的cglib做了重构适配jdk21

<dependency>
    <groupId>org.springframework</groupId>
    <artifactId>spring-core</artifactId>
    <version>6.2.2</version>
</dependency>
CGLIB两大核心(对应JDK两大核心):
- MethodInterceptor方法拦截器(对应JDK的InvocationHandler逻辑完全一致)
- Enhancer(对应JDK的Proxy逻辑完全一致)
CGLIB基本实现
实现MethodInterceptor类的实现类:
public class MyInterceptor implements MethodInterceptor {
    /**
     *
     * @param o 动态生成的代理类对象
     * @param method 代理对象生成的目标对象的方法
     * @param objects 参数列表
     * @param methodProxy CGLIB方法代理对象
     * @return 返回生成的代理对象
     */
    @Override
    public Object intercept(Object o, Method method, Object[] objects, MethodProxy methodProxy) throws Throwable {
        System.out.println("前置增强");
        //用invokeSuper效率更高
        Object result = methodProxy.invokeSuper(o, objects);
//        method.invoke(o,objects);
        System.out.println("后置增强");
        return result;
    }
}
测试:
public class JavaApplication {

    public static void main(String[] args) {
        // 1. 创建CGLIB的核心工具类:增强器
        Enhancer enhancer = new Enhancer();

        // 2. 核心配置1:告诉CGLIB,要给哪个类生成子类代理(设置父类=目标类)
        enhancer.setSuperclass(UserService.class);

        // 3. 核心配置2:设置方法拦截器(代理的大脑,增强逻辑在这里)
        enhancer.setCallback(new MyInterceptor());

        // 4. 生成代理对象:JVM在内存中动态生成子类,强转为目标类即可
        UserService proxy = (UserService) enhancer.create();

        // 5. 调用代理对象的带参数方法!【重点:直接传参,和调用普通方法完全一样】
        proxy.login(User.builder().username("张三").build());
    }
}
△ CGLIB动态代理底层原理
JDK 动态代理底层:
运行时 → JVM 反射读取接口信息 → 生成实现该接口的代理类$Proxy0 → 创建代理对象 → 调用方法走到invoke()。
CGLIB 动态代理底层:
运行时 → CGLIB 通过 ASM 字节码框架 → 动态生成目标类的子类,类名默认是
目标类名$$EnhancerByCGLIB$$地址值
○ [Git]手写JDK动态代理
○ [Git]手写Spring依赖注入以及AOP

汇聚全球AI编程工具,助力开发者即刻编程。
更多推荐

 19
 0
- 0


 已为社区贡献10条内容

所有评论(0)