
CVPR 2026 | DyFCLT:面向多模态微小目标检测的动态频率解耦跨模态学习 Transformer
CVPR 2026 | DyFCLT:面向多模态微小目标检测的动态频率解耦跨模态学习 Transformer
整理日期: 2026 年 7 月 20 日
整理方式: 中文翻译、方法拆解与实验分析
核心主题: RGBT 微小目标检测、频域建模、跨模态交互、背景噪声抑制
01|论文信息
论文题目: DyFCLT: Dynamic Frequency-Decoupled Cross-Modal Learning Transformer for Multimodal Tiny Object Detection
中文题目: DyFCLT:面向多模态微小目标检测的动态频率解耦跨模态学习 Transformer
论文作者: Chaolang Li, Pengwen Dai(通讯作者), Jingyu Li, Siyuan Yao, Yuchen Jiang, Zhuoran Zheng
发表单位: 中山大学深圳校区网络空间安全学院、深圳市对抗人工智能重点实验室、齐鲁工业大学
发表会议: IEEE/CVF Conference on Computer Vision and Pattern Recognition(CVPR 2026)
研究任务: 可见光—红外(RGBT)微小目标检测
代码链接: 论文正文未提供公开代码链接
原文页码: 11313–11323
1.1 论文研究背景
微小目标通常只有少量像素,容易受到低照度、遮挡、复杂背景和模态噪声影响。可见光图像能够提供纹理与颜色信息,但在夜间或极端光照条件下可靠性下降;红外图像能够突出热目标,却往往缺少细节。如何充分利用两种模态的互补信息,是 RGBT 微小目标检测的关键问题。
现有频域方法通常认为红外图像以低频信息为主、RGB 图像以高频信息为主,并据此设计较粗粒度的跨模态融合。本文通过 RGBT-Tiny 数据集的频率统计发现:随着目标尺寸减小,RGB 与红外两种模态中的中频和高频能量占比都会增加;即使在红外模态中,微小目标也包含跨多个频带的有效信息。
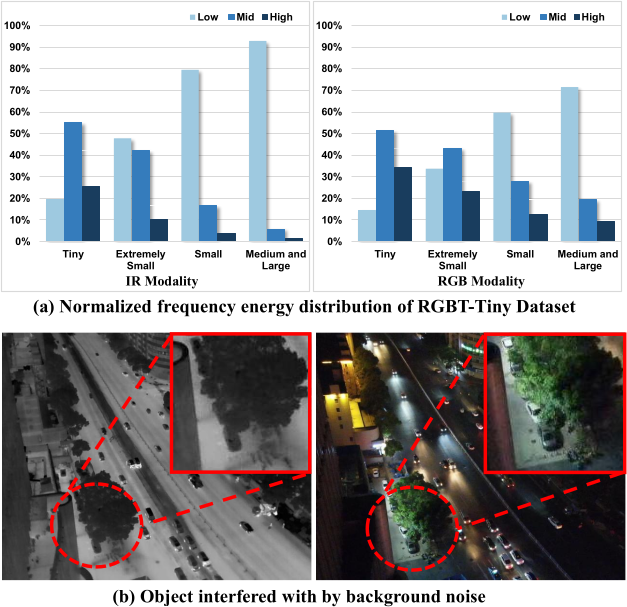
图 1。 (a) 不同尺度目标的归一化频率能量分布;(b) 遮挡与背景噪声共同干扰目标的示例。
1.2 论文要解决的核心问题
论文聚焦两个相互关联的问题:
- 如何对 RGB 与红外特征进行细粒度频带划分,并在对应频带内学习稳定的跨模态互补关系;
- 如何避免频率增强同时放大复杂背景噪声,并在多尺度融合中恢复微小目标的前景细节。
02|论文主要贡献
-
提出新的频率观察。 论文系统分析了 RGBT 场景中不同尺度目标的频率能量分布,指出微小目标在 RGB 和红外模态中都包含丰富的中高频信息,突破了“红外低频、RGB 高频”的简单二分假设。
-
提出 DyFCLT 框架。 该框架通过动态频带解耦跨模态注意力(DFCA)和选择性平滑增强(SSE),完成跨模态特征的“频率丰富—噪声精炼—多尺度融合”。
-
取得较强实验结果。 DyFCLT 在 RGBT-Tiny、RGBTDronePerson 和 FLIR 三个数据集上均达到最先进或最具竞争力的性能,说明该方法不仅适用于微小目标,也能泛化到包含常规尺度目标的场景。
03|论文创新点
(1)动态径向频带划分
论文不再使用固定的低频/高频二分方式,而是以可学习的径向边界将二维 Fourier 频谱划分为低频、中频和高频子带。频带边界在初始化时保持合理顺序,并可在训练中根据数据分布自适应调整。
(2)逐频带跨模态注意力
DFCA 同时对 Query、Key 和 Value 进行频带分解,在相同频带内部计算跨模态相关性,再聚合不同频带的交互结果。这样能够减少频率泄漏,并学习更干净、更稳定的带内跨模态对应关系。
(3)选择性背景平滑与前景引导上采样
SSE 使用二值前景掩码分离前景与背景,只对背景执行通道压缩和平滑,避免直接削弱目标信息;随后利用噪声抑制后的特征预测空间自适应动态核,引导高层特征上采样,从而恢复微小目标细节。
3.1 两个模块之间的逻辑关系
| 模块 | 主要作用 | 解决的问题 |
|---|---|---|
| DFCA | 挖掘不同频带内的跨模态互补信息 | 微小目标表征弱、粗粒度频域融合不足 |
| IBS | 平滑无关背景并保留前景 | 频率增强可能同步放大背景噪声 |
| FREF | 使用前景相关动态核引导上采样 | 高层语义特征中微小目标细节丢失 |
整体逻辑为:DFCA 负责“增加有效信息”,SSE 负责“去除无关噪声并恢复细节”。
04|方法
4.1 DyFCLT 整体架构
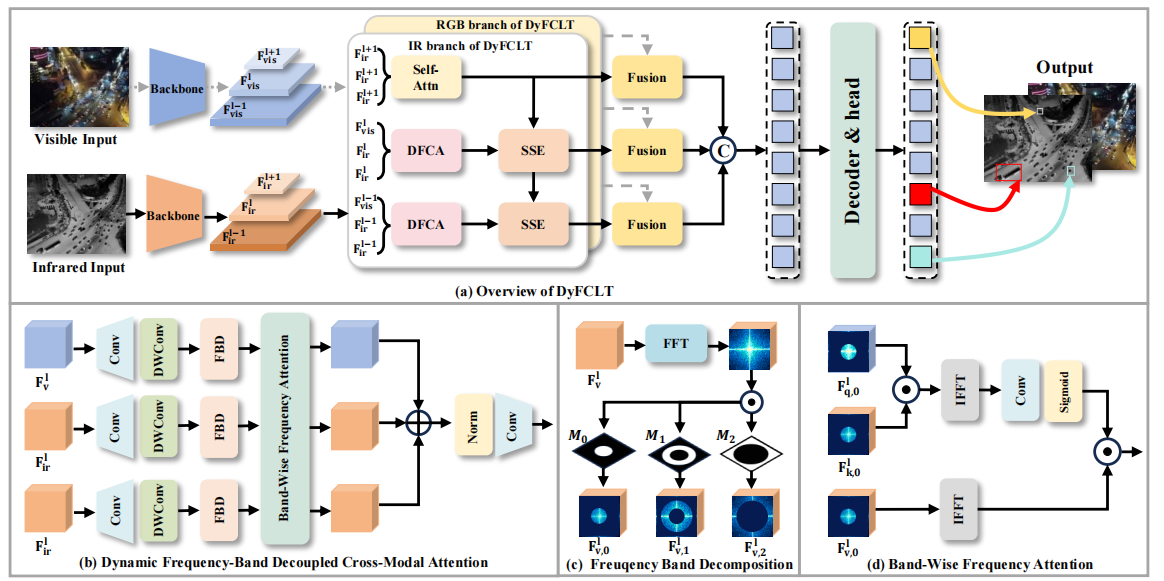
图 2。 DyFCLT 总体结构、动态频带解耦跨模态注意力、频带分解与逐频带注意力。
DyFCLT 由以下三部分组成:
- 双模态主干网络: 分别从可见光图像 IvisI_{vis}Ivis 和红外图像 IirI_{ir}Iir 中提取三层多尺度特征;
- 双分支 DyFCLT: 在 RGB 分支和红外分支中交替执行 DFCA、SSE 与多尺度 Fusion;
- Transformer 解码器与检测头: 将两个分支的多尺度输出拼接、展平,再利用带可变形注意力的解码器输出检测结果。
可见光与红外主干分别产生:
{Fvisl}l=1L=ϕvis(Ivis),{Firl}l=1L=ϕir(Iir), \{F_{vis}^{l}\}_{l=1}^{L}=\phi_{vis}(I_{vis}),\qquad \{F_{ir}^{l}\}_{l=1}^{L}=\phi_{ir}(I_{ir}), {Fvisl}l=1L=ϕvis(Ivis),{Firl}l=1L=ϕir(Iir),
其中 L=3L=3L=3。两个模态分支的结构对称,论文以红外分支为例说明具体操作。
4.1.1 整体数据流
RGB / IR 输入
    ↓
双流 ResNet-50 提取多尺度特征
    ↓
DFCA:动态频带划分与逐频带跨模态交互
    ↓
SSE:前景/背景分离、背景平滑、前景引导上采样
    ↓
双分支特征融合
    ↓
可变形 Transformer 解码器与检测头
    ↓
目标类别与边界框
4.2 动态频带解耦跨模态注意力(DFCA)
DFCA 的目标是在不同频率子带内部进行细粒度跨模态交互。其处理过程分为特征投影、动态频带分解、逐频带注意力和频带聚合四个阶段。
4.2.1 Query、Key、Value 特征生成
给定第 lll 层可见光特征 FvislF_{vis}^{l}Fvisl 和红外特征 Firl∈RC×H×WF_{ir}^{l}\in\mathbb{R}^{C\times H\times W}Firl∈RC×H×W:
- Query 特征 FqlF_q^lFql 由可见光特征 FvislF_{vis}^{l}Fvisl 生成;
- Key 特征 FklF_k^lFkl 和 Value 特征 FvlF_v^lFvl 由红外特征 FirlF_{ir}^{l}Firl 生成;
- 每个特征均依次经过 1×11\times11×1 逐点卷积和 3×33\times33×3 深度卷积。
该设计使红外分支能够使用可见光特征查询红外信息;RGB 分支则执行对称操作。
4.2.2 动态频带分解(FBD)
首先对 QQQ、KKK、VVV 特征执行二维 FFT,再使用径向二值掩码分离各频率子带:
Fm,bl=Mb⊙F(Fml),m∈{q,k,v}. F_{m,b}^{l}=M_b\odot\mathcal{F}(F_m^l), \qquad m\in\{q,k,v\}. Fm,bl=Mb⊙F(Fml),m∈{q,k,v}.
第 bbb 个频带的掩码定义为:
Mb(u,v)={1,kb≤u2+v2<kb+1,0,其他情况. M_b(u,v)= \begin{cases} 1, & k_b\leq\sqrt{u^2+v^2}<k_{b+1},\\ 0, & \text{其他情况}. \end{cases} Mb(u,v)={1,0,kb≤u2+v2<kb+1,其他情况.
其中,u2+v2\sqrt{u^2+v^2}u2+v2 表示二维频率分量到频谱中心的径向距离,[kb,kb+1)[k_b,k_{b+1})[kb,kb+1) 为第 bbb 个频带范围。依据 Nyquist 定理,归一化频率范围为 [0,12][0,\frac{1}{2}][0,21]。
论文设置三个频带:
| 频带 | 主要包含的信息 | 对微小目标的作用 |
|---|---|---|
| 低频 | 整体结构、区域语义、平滑背景 | 提供目标与场景的全局信息 |
| 中频 | 局部形状、边缘过渡、结构变化 | 描述微小目标的主体轮廓 |
| 高频 | 边缘、纹理、细粒度变化 | 强化微小目标的可辨识细节 |
内部频带边界采用累积正增量参数化,以保证 k0<k1<⋯<kBk_0<k_1<\cdots<k_Bk0<k1<⋯<kB。当 B=3B=3B=3 时,边界初始化为 {0,18,14,12}\{0,\frac{1}{8},\frac{1}{4},\frac{1}{2}\}{0,81,41,21},随后在训练中自适应更新。
4.2.3 逐频带频率注意力
在第 bbb 个频带内,先通过 Query 与 Key 的频域相关性计算跨模态权重:
Abl=F−1 (Fq,bl⊙Fk,bl‾). A_b^l=\mathcal{F}^{-1}\!\left( F_{q,b}^l\odot\overline{F_{k,b}^l} \right). Abl=F−1(Fq,bl⊙Fk,bl).
其中,(⋅)‾\overline{(\cdot)}(⋅) 表示复共轭,F−1\mathcal{F}^{-1}F−1 表示逆 FFT。随后使用局部卷积与 Sigmoid 调制空间响应,并作用于对应频带的 Value 特征:
Rbl=σ (Conv3×3(Abl))⊙F−1(Fv,bl). R_b^l= \sigma\!\left(\operatorname{Conv}_{3\times3}(A_b^l)\right) \odot\mathcal{F}^{-1}(F_{v,b}^l). Rbl=σ(Conv3×3(Abl))⊙F−1(Fv,bl).
这一过程相当于:先判断两个模态在当前频带、当前位置上的相关程度,再据此选择性增强红外 Value 特征。
4.2.4 频带聚合
最后,将不同频带的输出相加,并执行层归一化与线性投影:
F~irl=Proj [LN (∑bRbl)]. \widetilde{F}_{ir}^{l}= \operatorname{Proj}\!\left[ \operatorname{LN}\!\left(\sum_b R_b^l\right) \right]. Firl=Proj[LN(b∑Rbl)].
得到的 F~irl\widetilde{F}_{ir}^{l}Firl 同时包含低频语义、中频结构和高频细节,并融合了可见光与红外之间的互补关系。
4.3 选择性平滑增强(SSE)
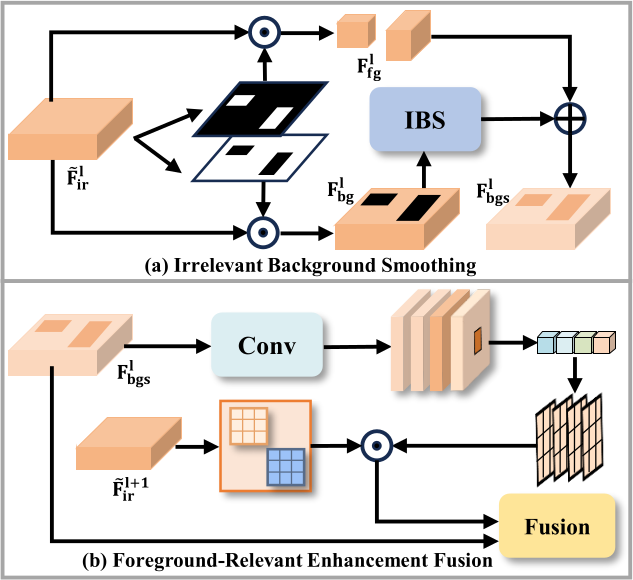
图 3。 SSE 由无关背景平滑(IBS)和前景相关增强融合(FREF)组成。
4.3.1 无关背景平滑(IBS)
DFCA 能够提取丰富的频率信息,但也可能放大树木、道路纹理、建筑边缘等背景高频噪声。IBS 首先预测二值前景掩码 MMM,再将特征分为前景和背景:
Ffgl=M⊙F~irl,Fbgl=(1−M)⊙F~irl. F_{fg}^{l}=M\odot\widetilde{F}_{ir}^{l},\qquad F_{bg}^{l}=(1-M)\odot\widetilde{F}_{ir}^{l}. Ffgl=M⊙Firl,Fbgl=(1−M)⊙Firl.
背景特征依次经过通道压缩与通道恢复:
F^bgl=Conv3×3C (Conv3×3C/r(Fbgl)). \widehat{F}_{bg}^{l}= \operatorname{Conv}_{3\times3}^{C}\!\left( \operatorname{Conv}_{3\times3}^{C/r}(F_{bg}^{l}) \right). Fbgl=Conv3×3C(Conv3×3C/r(Fbgl)).
通道压缩能够削弱背景中的高频干扰,同时保留前景区域不被直接平滑。最后,将原始前景与平滑背景重新组合:
Fbgsl=Ffgl+F^bgl. F_{bgs}^{l}=F_{fg}^{l}+\widehat{F}_{bg}^{l}. Fbgsl=Ffgl+Fbgl.
二值掩码使用 focal Tversky loss 监督,以应对前景像素远少于背景像素的问题。
4.3.2 前景相关增强融合(FREF)
FREF 使用噪声抑制后的低层特征 FbgslF_{bgs}^{l}Fbgsl,引导更高层特征 F~irl+1\widetilde{F}_{ir}^{l+1}Firl+1 上采样。其主要步骤如下:
- 由 FbgslF_{bgs}^{l}Fbgsl 预测每个空间位置对应的 K×KK\times KK×K 动态滤波核;
- 对动态核执行 pixel-unshuffle,使其分辨率与高层特征对齐;
- 将动态核分为四组,对高层特征的局部邻域进行空间自适应调制;
- 使用 pixel-shuffle 恢复空间分辨率;
- 将引导上采样结果与双线性上采样结果相加;
- 与 FbgslF_{bgs}^{l}Fbgsl 拼接后,通过 CSPBlock 完成最终融合。
最终输出为:
Y^l+1=Yguidedl+1+Upsample(F~irl+1), \widehat{Y}^{l+1} =Y_{guided}^{l+1} +\operatorname{Upsample}(\widetilde{F}_{ir}^{l+1}), Yl+1=Yguidedl+1+Upsample(Firl+1),
Foutl=Fusion(Y^l+1,Fbgsl). F_{out}^{l}=\operatorname{Fusion} \left(\widehat{Y}^{l+1},F_{bgs}^{l}\right). Foutl=Fusion(Yl+1,Fbgsl).
与普通双线性插值相比,FREF 的上采样核随空间位置变化,可以优先恢复与微小目标有关的细节,而不是均匀放大所有区域。
4.4 方法逻辑总结
| 阶段 | 输入 | 关键操作 | 输出 |
|---|---|---|---|
| 模态特征提取 | RGB、IR 图像 | 双流 ResNet-50 | 三层多尺度特征 |
| 频率解耦 | Q/K/VQ/K/VQ/K/V 特征 | FFT、动态径向掩码 | 低/中/高频子带 |
| 跨模态交互 | 对应频带特征 | 带内相关性与空间调制 | 互补频率表征 |
| 背景平滑 | DFCA 输出 | 前景掩码、通道压缩 | 噪声抑制特征 |
| 引导上采样 | 低层精细特征、高层语义特征 | 动态核、pixel shuffle | 前景增强的多尺度特征 |
| 检测输出 | 双分支融合特征 | 可变形 Transformer | 类别与边界框 |
05|实验分析
5.1 数据集与训练设置
| 项目 | RGBT-Tiny | RGBTDronePerson | FLIR |
|---|---|---|---|
| 数据规模 | 9.3 万帧、120 万个目标 | 6,125 对图像、70,880 个实例 | 4,129 对训练图像、1,013 对测试图像 |
| 目标特点 | 超过 81% 小于 16×1616\times1616×16 像素 | 98% 的目标小于 20 像素 | 同时包含微小目标与常规尺度目标 |
| 训练轮数 | 20 | 20 | 50 |
| 学习率 | 0.00025 | 0.00025 | 0.00025 |
| 主干网络 | ResNet-50 | ResNet-50 | ResNet-50 |
其他设置如下:
- DFCA 频带数 B=3B=3B=3;
- 数据增强仅使用随机缩放、裁剪和翻转;
- 检测器基线由双模态 RT-DETR 构成;
- 解码器层数与 Query 数量等设置沿用 RT-DETR;
- 实验在 NVIDIA A100 GPU 上完成。
5.2 与 SOTA 方法对比
5.2.1 RGBT-Tiny
| 对比项 | AP | AP50 | APts | AR |
|---|---|---|---|---|
| DQ-DETR(最佳单模态小目标检测器) | 43.6 | 60.2 | 33.0 | 60.8 |
| M²D-LIF(最强多模态基线) | 38.7 | 54.9 | 29.0 | 51.7 |
| DyFCLT | 48.2 | 69.1 | 41.3 | 63.2 |
主要结论:
- 相比 DQ-DETR,DyFCLT 的 AP 提升 4.6 个百分点,AR 提升 2.4 个百分点;
- 相比 M²D-LIF,AP、AP50 和 AR 分别提升 9.5、14.2 和 11.5 个百分点;
- APts=41.3%AP_{ts}=41.3\%APts=41.3%,说明该方法对最困难的微型目标具有明显优势;
- 大目标 APls=100.0%AP_{ls}=100.0\%APls=100.0%,说明频率建模没有牺牲大尺度目标性能。
5.2.2 RGBTDronePerson
| 方法 | AP50 | AP50-tiny | AP50-small |
|---|---|---|---|
| COXNet | 45.5 | 47.1 | 29.7 |
| DyFCLT | 61.0 | 62.4 | 35.1 |
DyFCLT 相比 COXNet 的三个指标分别提升 15.5、15.3 和 5.4 个百分点。微型行人上的提升最大,进一步支持了论文关于“微小目标包含丰富跨频带信息”的核心判断。
5.2.3 FLIR
| 方法 | AP50 | AP |
|---|---|---|
| DINO(IR) | 80.6 | 44.8 |
| FD²Net | 82.9 | — |
| DyFCLT | 84.1 | 45.0 |
FLIR 并非专门面向微小目标,但 DyFCLT 仍取得最佳性能,表明该框架对常规尺度目标和一般道路场景同样具有泛化能力。
5.3 消融实验
5.3.1 DFCA 与 SSE 的作用
| DFCA | IBS | FREF | AP | AP50 | APts |
|---|---|---|---|---|---|
| ✗ | ✗ | ✗ | 45.4 | 65.9 | 36.6 |
| ✓ | ✗ | ✗ | 46.8 | 67.5 | 37.8 |
| ✗ | ✓ | ✓ | 46.9 | 67.4 | 39.7 |
| ✓ | ✓ | ✗ | 47.4 | 68.2 | 40.1 |
| ✓ | ✓ | ✓ | 48.2 | 69.1 | 41.3 |
分析如下:
- 单独加入 DFCA,AP 提升 1.4,说明逐频带跨模态交互本身有效;
- 单独加入完整 SSE,AP 提升 1.5,APtsAP_{ts}APts 提升 3.1,说明背景平滑和引导上采样尤其有利于微小目标;
- 同时使用 DFCA 与 SSE 时性能最佳,说明“丰富频率信息”和“抑制频率噪声”必须协同设计;
- 在完整模型中移除 FREF,APtsAP_{ts}APts 从 41.3 降至 40.1,证明动态引导上采样能够恢复目标细节。
5.3.2 Q/K/VQ/K/VQ/K/V 解耦范围
| 解耦组件 | AP | AP50 | APts |
|---|---|---|---|
| 无 | 46.1 | 66.5 | 37.5 |
| 仅 Query | 45.2 | 66.0 | 37.3 |
| Query 与 Key | 47.1 | 67.8 | 39.3 |
| Key 与 Value | 46.8 | 67.8 | 38.1 |
| Query、Key 与 Value | 48.2 | 69.1 | 41.3 |
仅分解 Query 会导致性能下降,因为 QQQ 与未分解的 K/VK/VK/V 不再位于一致的频带空间,容易产生频率泄漏。对 Q/K/VQ/K/VQ/K/V 全部分解后,模型能够在干净且一致的频带内建立相关性,因此性能最佳。
5.3.3 频带数量与边界类型
| 频带数量 | 边界类型 | AP | AP50 | APts |
|---|---|---|---|---|
| 1 | 不划分 | 46.1 | 66.5 | 37.5 |
| 2 | 可学习 | 46.4 | 66.7 | 37.8 |
| 3 | 可学习 | 48.2 | 69.1 | 41.3 |
| 3 | 静态 | 46.5 | 67.3 | 37.4 |
| 4 | 可学习 | 47.0 | 67.4 | 39.0 |
实验说明:
- 三个可学习频带优于不划分、两频带和四频带;
- 频带过少无法充分区分不同频率信息,频带过多则可能导致每个子带信息不足、学习难度上升;
- 相同的三频带设置下,可学习边界比固定边界高 1.7 AP,验证了动态划分的必要性。
5.4 定性结果与特征可视化
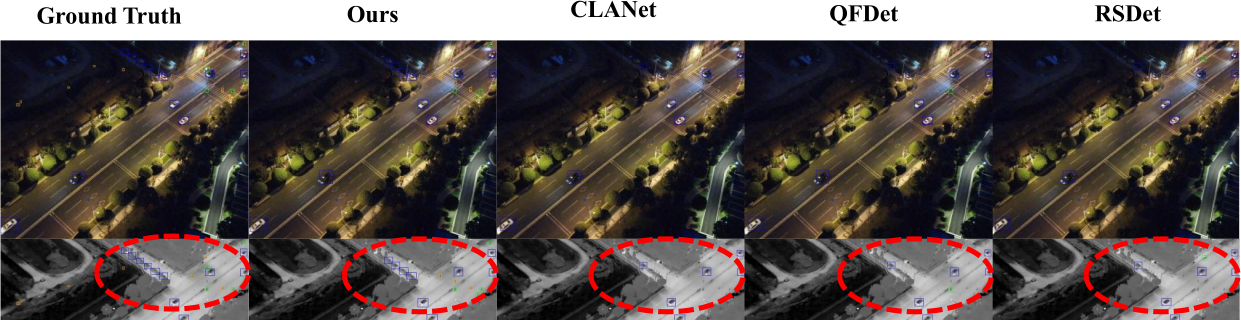
图 4。 在低照度、树木遮挡和目标极小的场景中,DyFCLT 的漏检数量少于 CLANet、QFDet 和 RSDet,并能区分视觉相似的行人与骑行者。
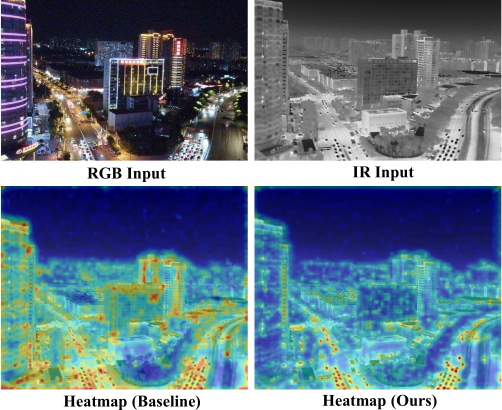
图 5。 与基线相比,DyFCLT 的背景响应更弱,密集微小目标区域的激活更集中、更清晰。
5.5 实验结论与需要关注的问题
实验能够支持的结论:
- 跨模态频率学习对 RGBT 微小目标检测有效;
- 频带划分应当保持 Q/K/VQ/K/VQ/K/V 一致,并允许边界自适应学习;
- 仅增强频率信息不够,还必须显式抑制背景噪声;
- DFCA 与 SSE 对微型目标的增益大于对一般尺度目标的增益,符合模型设计目标。
阅读时需要注意:
- DyFCLT 参数量为 85.5M,高于 RT-DETR(42.0M)和 M²D-LIF(36.6M),性能提升伴随一定模型规模增加;
- 论文未报告 FLOPs、FPS、推理延迟和显存占用,因此尚不能仅根据现有结果判断其部署效率;
- 动态频带边界的具体训练轨迹与最终数值未可视化,频带是否在不同数据集上学习到一致模式仍值得进一步研究;
- 前景掩码需要额外监督,实际复现时应重点确认掩码标签生成方式、损失权重和通道压缩比 rrr。
06|个人声明
本文为对论文 DyFCLT: Dynamic Frequency-Decoupled Cross-Modal Learning Transformer for Multimodal Tiny Object Detection 的中文学习笔记与结构化整理,不是原作者发布的官方中文版本。
本文内容依据论文原文进行翻译、归纳与分析,其中方法结构、实验数据和原始图表版权归论文作者及相关出版机构所有。整理过程中可能存在理解或表述偏差,如需进行学术研究、论文引用或模型复现,请以英文原文及作者公开资料为准。
如本文内容涉及侵权或存在事实性错误,请联系后及时更正或删除。
附录|术语速查
| 缩写 | 英文全称 | 中文含义 |
|---|---|---|
| RGBT | RGB-Thermal | 可见光—热红外双模态 |
| TOD | Tiny Object Detection | 微小目标检测 |
| DyFCLT | Dynamic Frequency-Decoupled Cross-Modal Learning Transformer | 动态频率解耦跨模态学习 Transformer |
| DFCA | Dynamic Frequency-Band Decoupled Cross-Modal Attention | 动态频带解耦跨模态注意力 |
| FBD | Frequency Band Decomposition | 频带分解 |
| SSE | Selective Smoothing Enhancement | 选择性平滑增强 |
| IBS | Irrelevant Background Smoothing | 无关背景平滑 |
| FREF | Foreground-Relevant Enhancement Fusion | 前景相关增强融合 |

汇聚全球AI编程工具,助力开发者即刻编程。
更多推荐

 11
 0
- 0


 已为社区贡献2条内容

所有评论(0)