登录社区云,与社区用户共同成长
邀请您加入社区
摘要:AI系统算法偏见问题日益突出,测试工程师需构建"功能-性能-伦理"三位一体的测试新范式。文章提出道德扫描器框架,包含统计平等、因果推理等核心模块,并展示金融、医疗领域的应用案例。研究表明,部署道德扫描器可显著降低算法偏见(如将金融系统偏见指标从0.38降至0.09)。未来五年,具备算法道德测试能力的工程师薪酬溢价预计达40%,这标志着测试工程师职业价值的战略升级。(149
摘要:随着AI系统广泛应用,算法偏见成为新的质量风险点。本文提出算法偏见的自动化检测框架,涵盖数据源性偏见和模型架构偏见的测试方案。重点介绍道德扫描器的核心原理,包括静态代码分析和动态测试框架,并给出持续集成实践方案。通过行业工具链横向对比,建议分阶段建设测试能力,最后指出多模态偏见检测等未来方向。测试工程师需将道德风险评估纳入常规测试流程,建立敏感数据验证机制,定期进行跨群体模型效能比对。(14
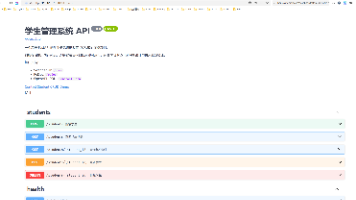
在日常开发中,"接口(API)"是前后端协作的桥梁。无论是招聘系统中的候选人简历、教务系统中的学生档案,还是电商平台里的商品信息,归根到底都离不开最朴素也最重要的四类操作——增、删、改、查,业界常把它称为 CRUD(Create / Read / Update / Delete)。可以说,CRUD 是几乎所有业务系统的地基,也是最值得每个后端开发者熟练掌握的基本功。在本文中,我将从零开始,使用 P
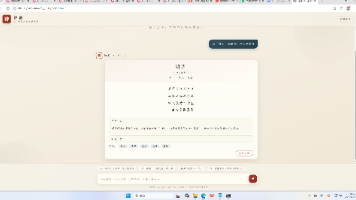
码道之上,写代码的人越来越多,写诗的人却越来越少。我常常在想,一个程序员如果只剩下 if/else,那他和一台打印机又有什么区别。诗词是汉族文化里最精巧的表达方式之一,五个字可以装下一座山,七个字可以淌出一条江。我决定把这两件看似毫不相干的事情放在一起——让大模型学会作诗,让网页学会品诗。于是有了「诗韵AI诗词对答对话系统」。它不是一个花架子 demo,而是一个真正跑在浏览器里的、能够与用户一来一
从这个只有三百多行的项目中,我们可以看到现代 Python 后端开发的魅力:类型注解定义数据契约、框架自动生成文档与校验、REST 规范约束接口语义,三者结合让"写好文档化接口"变成了一件低成本、高质量的事情。如果你也想动手试试,建议不要停留在阅读——把代码下载下来,先跑通再逐个接口调用一遍,然后尝试加上一个"按专业筛选"的查询参数,或者把统计接口改成按班级分组。当你亲手把一个纯手写的接口项目逐步
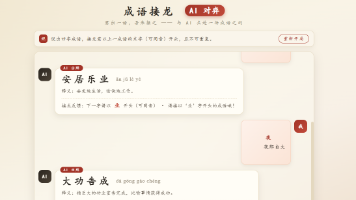
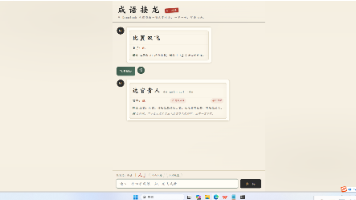
做这个项目之前,我一直在想:怎样的 AI 应用,既有文化底蕴,又能把技术栈完整地跑一遍?成语,是汉语中历经千年沉淀下来的语言结晶。四字一句,言简意赅,字里行间藏着典故与智慧。而成语接龙,则是几乎每个中国人都玩过的文字游戏——一个人说出"守株待兔",下一个人必须以"兔"字(可同音)开头,接出"兔死狐悲",如此往复,妙趣横生。传统成语接龙的最大痛点是什么?需要有一个判官。谁来判断你接的成语是否真实存在
摘要:本文完整记录了「心屿」——一个面向长程心理陪伴的 AI 心灵医生对话系统的开发全流程。项目完全基于 HTML5、CSS3 与原生 JavaScript 构建,零框架、零后端、零构建工具,真正做到了「一个 html 文件就能跑起来的 AI 应用」。文章从需求背景、系统提示词工程、Python 参考代码到 JavaScript 的流式改造、前端模块设计、情绪可视化、持久化存储,一直到真实的踩坑排
云计算技术已经渗透到软件开发的每一个角落,ECS(Elastic Compute Service,云服务器)作为最基础的云服务形态,是许多开发者学习云原生实践的起点。这部课设项目的目标很朴素——在一台云服务器上,动手实现一个完整可用的 Web 服务,把学校里学过的数据结构、HTTP 协议、前后端交互等知识真正串起来。这个仓库中的项目就是一个以"学生信息管理系统"为载体的 ECS 云服务作业。一台云
难度分档:支持"简单词 / 普通词 / 偏门词"三档出题难度,让不同水平的玩家都能玩得尽兴;计时机制:给每轮加一个倒计时,猜得越快加分越多,增加紧张感;服务端代理:把 AI 请求迁到云函数做转发,解决 API Key 暴露问题,顺便增加日志和限流;排行榜:把 localStorage 战绩升级为简单的前后端排行(需要一个轻量后端);多语言:模型本身支持多语言,把提示词抽成 i18n 配置即可支持英
在 Python 生态里,做 Web 接口的主流选择有 Flask、Django、FastAPI 等。我选择 FastAPI,主要是看重以下几点。第一,性能好。FastAPI 基于 Starlette 构建,底层是异步的 ASGI 架构,官方基准测试中吞吐量在主流 Python 框架中名列前茅。即使本项目目前只用同步逻辑,留出的异步能力升级空间也是实实在在的。第二,类型提示带来极佳的开发体验。
项目地址:https://atomgit.com/2501_93821753/Shuyuai_Caishuzi.git
如何把大模型的能力,包装成有质感、有规则、可体验的产品。第一,流式。让人看到过程,体验就从"等待"变成了"期待"。第二,契约。让模型返回结构化 JSON,前端就能"精确地美",而不是"粗暴地展示"。第三,规则与氛围。成语接龙的一字之差要有人裁决,诗韵的四种模式要有各自的呼吸节奏;产品不是 API 的传声筒,而是规则、趣味与美学的容器。“码道"二字,既是写代码的"道”,也是把代码写成作品的"道"。
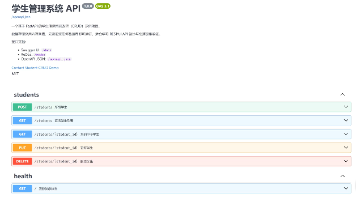
在日常开发中,我们经常会遇到一个尴尬的场景:前端同学已经写好页面了,后端接口却还在评审中;产品想要快速验证一个想法,数据库表结构却还没定下来。这时候,一个"轻量到看一眼就能跑起来"的接口服务就显得尤为重要。本文要分享的,就是这样一个基于FastAPI的学生信息管理接口项目。它实现了对学生表的完整增删改查(CRUD)操作,数据存储只用了一个内存列表,不需要安装任何数据库;更贴心的是,FastAPI
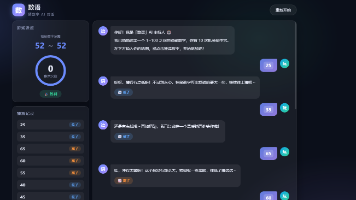
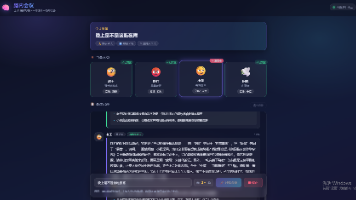
《脑内会议》是一款让AI替你“吵架”的纯前端工具,通过四角色辩论预演现实争执。用户输入议题,AI化身理性派、暴躁哥、毒舌女、和事佬,轮流发言,流式输出如真实会议。基于原生HTML/CSS/JS,零依赖、无构建,支持手机端响应式。核心技术是用浏览器fetch+ReadableStream模拟Python的SSE流式请求,实现“边想边说”的沉浸感。既解压又练逻辑,让“事后诸葛亮”变成“现场赢麻了”。
没有任何框架,没有任何构建工具,也没有任何后端服务。打开index.html就能玩。有人可能会问:对接大模型接口,密钥放前端不是会泄露吗?这确实是生产环境必须面对的问题。零成本部署。GitHub Pages / Gitee Pages / 本地双击即可运行,不需要服务器、不需要域名、不需要运维。学习价值最大化。没有框架黑盒,每一个 DOM 操作、每一次事件绑定都是手写的,最能巩固基本功。演示方便。
在框架遍地开花的今天,我选择了最朴素的 HTML5 + CSS3 + JavaScript 组合,理由有三:第一,零门槛交付。项目不依赖 Node.js 环境、不依赖 npm 安装、不需要打包器,任何一个能打开浏览器的设备——甚至一台老旧的办公电脑——都能立即运行。交付率极高。第二,教学价值最大化。去掉框架这层"面纱",SSE 流式解析、DOM 操作、fetch 请求这些底层原理全部直接暴露在眼前
在人工智能与大模型快速发展的今天,把大语言模型的能力接入到我们日常的 Web 应用中,已经不再是一件遥不可及的事情。无论是智能客服、知识问答,还是内容创作辅助,大模型都能扮演非常出色的角色。作为软件技术专业的学生,我一直希望亲手完成一个"真正跑在浏览器里、由 AI 驱动的完整应用",而不只是停留在调用接口打印文本的层面。这个想法最终落地成为了“AI 家乡文旅对话导游”项目。
如果你是一个经常出行的旅行爱好者,大概都经历过这样的时刻:打开搜索引擎,在"XX 城市旅游攻略"的页面之间来回跳转,把不同博主推荐的景点、美食、住宿信息手抄到一个备忘录里,然后自己一点一点拼凑出所谓的"行程单"。这个过程既繁琐又低效,等到真正出发的时候,往往发现行程里的时间安排根本不合理,景点之间隔了半个城市,一天要赶三四个地方,累得连拍照的力气都没有。
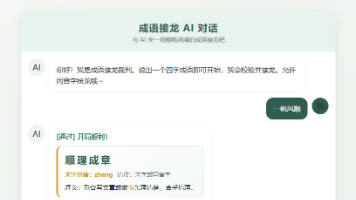
一个基于实现的成语接龙 AI 对话小游戏。通过与智谱/DeepSeek 兼容的 GitCode AI 对话接口(OpenAI 流式协议)实时对话,AI 会以成语「尾字开头」的规则与玩家接龙,并返回成语的在游戏中潜移默化地积累成语知识。
我们都有过这样的经历:课堂上老师讲到一个概念,当时听懂了,课后做题却发现完全不会;翻教材抓不住重点,网上一搜,得到的是一大堆良莠不齐的内容,筛选信息比学习本身还耗时间。常见的问题有三个。第一,回答是"大段文字墙",没有重点、没有结构,读起来像阅读理解;第二,回答缺少"学习场景"的要素——没有关键要点提炼、没有生活化例子、没有下一步可以追问的方向;第三,对话是"一次性"的,昨天问的问题和今天问的问题
词乐对对碰」是一个由 AI 驱动歌词与诗词对答的互动游戏:点击开始,AI 抛出一句经典"上句",玩家在输入框写下"下句",AI 即时判定对错、打分并给出俏皮点评,全程无需后端服务。Vue / React 单页应用:组件化、响应式固然先进,但需要引入构建工具链(Vite、Webpack)、Node 环境与依赖管理。对一个课程演示级的项目来说,npm install 的时间可能比写代码还长,而且任何一
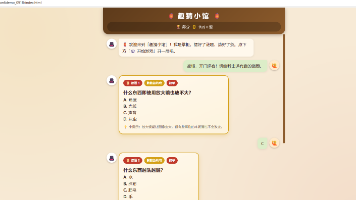
谜弈AI乐园」从一条 Python 示例出发,最终长成为一个五脏俱全的小型产品,这段旅程本身就像一场解谜:流式迁移是解开编码之迷,协议设计是解开沟通之迷,状态机是解开规则之迷,UI 是解开体验之迷。而我很确信,这正是「码道」所倡导的创作方式——让 AI 不止于回答问题,而是成为作品的一部分。给 AI 立规矩,比给 AI 写更多指令更有效。一份强约束的输出协议 + 一套容错解析链路,是「模型输出不可
在日常开发和教学中,我们经常需要一套简单、可控、能快速上手的后端接口来演示"前后端分离"、练习 Restful API 设计,或者作为前端联调的 Mock 服务。传统做法往往是搭一套完整的 Web 工程:配置数据库、编写 DAO、引入 ORM、做请求分发……一套流程下来,光环境搭建就要花去不少时间,对于想快速验证想法、或者刚入门 API 开发的同学来说,显得过于沉重。
数据模型是整个系统的"地基"。(创建时的请求体)、(更新时的请求体)、Student(返回给客户端的完整学生信息)。以name: str = Field(..., min_length=1, max_length=50, description="学生姓名")age: int = Field(..., ge=1, le=150, description="学生年龄")gender: str = F
①,配置成功后直接在cc切换供应商即可,只需把用到的软件(Vscode,桌面版)重启一下会自动切换到相应配置;如果你已经下载好桌面版codex并用官方账号登录,打开后会自动配置好官方的。点击右上角+号新增服务商,自定义配置并下拉到配置界面,按照下方说明填写即可。官网 + 第三方 需要来回切换配置,太麻烦 → 用cc来做配置调度。②,第三方服务商一般都是使用api key登录,不用账号登录;③,网页
文章探讨如何将工作方法组织为按需加载的能力,而非常驻 Prompt。Skill 采用三级加载:描述负责路由召回,脚本提供确定性计算,说明指导模型判断。脚本是知识转化为能力的关键,但需独立测试防止代码与说明漂移。.claude/ 通过 command、agent、skill 配置任务入口并收缩权限。适合封装已稳定的重复性任务,入口描述需精确,否则详细内容也无法被召回。
本文通过一个 Agent 平台设计案例,探讨了 Tool 和 Skill 的区别。作者提出了三个关键问题,揭示了 Skill 在 AI 架构中的重要性。Skill 是由多个 Tool 组合而成,具备编排、领域知识、生命周期等功能,而 Tool 则是单个函数。Skill 的存在使得 AI 系统能够更好地处理复杂任务,同时也需要更高级的管理和设计能力。作者还讨论了 MCP 协议和 Claude Cod
近期大厂如水滴、百度、阿里、字节、腾讯、美团等纷纷扩招AI岗位,尤其是AI和智能体方向。文章分析了这些公司的招聘需求和面试难度,并给出建议:做RAG或Agent项目、掌握相关技术栈、夯实编程基础、学习AI编程工具和开源智能体。最后推荐了一门针对AI大模型应用开发的Python课程,帮助读者抓住AI发展红利期。网友爆料:今年水滴明确扩招,AI浓度极高!重点招聘AI、智能体这类核心方向的人才。
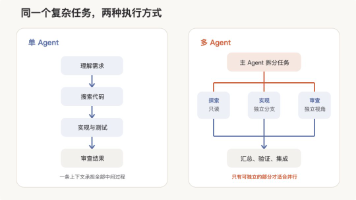
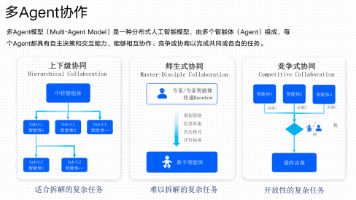
本文深入探讨了多Agent系统在编程领域的应用价值。文章指出,多Agent的优势并非简单的数量叠加,而是通过任务拆分、隔离、协调和验收机制,有效提升复杂工作的处理效率。内容涵盖了Subagent、并行会话和Agent Teams三种协作模式,分析了多Agent在时间、上下文和视角方面的优势,并对比了Codex、Claude Code和GitHub Copilot在多Agent协调机制上的不同侧重。
文章主要介绍前端浮层组件图鉴,列举9种悬浮层级。摘要需简洁概括核心观点:浮层用得克制是体验,泛滥是灾难;介绍9种浮层的用法、边界、AI话术。注意字数限制。我们写一段摘要。</think>前端浮层组件有9种:遮罩层、模态框、确认框、抽屉、下拉菜单、轮播、跑马灯等。浮层临时接管注意力,用得好是体验,用滥则成打扰。每种浮层都有适用场景与边界,如确认框留给不可逆操作,抽屉适合保留上下文的详情展示。面向AI
它曾在 OpenRouter 上以"Ox Alpha"的匿名身份悄悄运行 12 天,处理超 20 万亿 Token,登顶调用量榜首,连 Patrick Collison 都赞叹"very impressive"。8 月 26 日身份揭晓——智谱 AI 的 GLM-5.3-Flash。320B 总参、18B 激活、原生多模态、1M 上下文,价格只有 Claude Opus 4.8 的四十分之一
本章系统讲解图像生成、图像识别(CV)、视频生成与处理、语音处理、编程辅助五类 AI 工具。图像侧覆盖 Midjourney v7、FLUX/Stable Diffusion、即梦/通义万相/豆包图像;CV 侧介绍百度智能云、Google Vision、阿里云视觉的 API 能力;视频侧涵盖 Sora、Veo 3、可灵、即梦与剪映;语音侧包括科大讯飞、Whisper、ElevenLabs;编程侧讲
比如我已经写了一个数据处理脚本,但跑出来有几个样本明显不对,我可以直接把整个项目交给它,让它看看是数据的问题还是代码的问题;我一般不会上来就跟它说“帮我分析数据”,而是把需求说得很具体:这个文件夹里面有 30 个 CSV,把相同字段合并,缺失值先不要删,把异常数据单独标出来,再生成一个新的 Excel。然后让它自己写脚本、运行,出问题再改。所以我的习惯是,涉及科研结果的部分,让 Codex 写完以
Day55|从0学习 Claude Code(五):我给 Agent 发了张工单,它干活终于不跑偏了
本文通过Agent SDK教程分析指出,把Claude Code嵌入应用后,模型只负责决策,真正决定其行为边界的是运行框架:项目配置、权限、hook、subagent、session和进程生命周期。Hook能在工具执行前做确定性检查,构成真正的安全边界;Subagent提供上下文和权限隔离;Session支持执行历史分叉;部署则暴露了分布式系统问题。SDK复用现成框架,但将工程责任清晰地移交给了应
题目目标和最终交付物输入、输出以及约束条件已有代码结构和可复用部分运行方式、测试方式和验收标准不明确或存在风险的地方核心任务:不完成就无法通过主流程的基础能力重要任务:影响主要功能完整性的拓展能力优化任务:边界增强、代码质量、性能和体验优化先保证核心任务,在根据时间处理任务二和任务三,避免一开始陷入细节角色:资深系统架构师。任务:阅读项目根目录的 README.md 和现有代码结构,不要写任何代码
当技术选型不再是“选一个框架”,而是“选一种架构哲学”2026年,AI Agent框架赛道已从百花齐放走向群雄并立。LangGraph、CrewAI、Microsoft Agent Framework、Google ADK、DeepSeek Harness、OpenAI Agents SDK、Claude Agent SDK、Mastra……每个名字背后都代表着一套完整的技术哲学和生态承诺。对于架
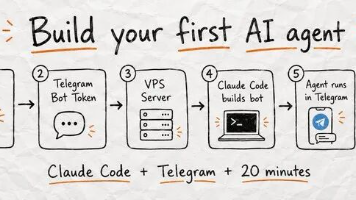
对话越来越长了。把一切重要内容压缩成一份总结:1. 原始目标2. 已经做了什么、发现了什么3. 做过的关键决策4. 还需要什么写完总结后,从那里继续。把这份总结当作新的起点。你现在已经知道Agent是什么、能做什么、以及怎么自己搭一个了。Agent的价值不在于它有多“智能”,而在于它把你从重复劳动里解放出来。
本文提供了一份详尽的12步路线图,旨在帮助开发者理解和掌握构建高效AI Agent的关键要素。文章围绕七大支柱——上下文、工具、记忆、循环、图、harness和evals,深入剖析了每个支柱的核心概念与实现方法,并辅以Claude工作流作为实证案例。通过学习这些内容,开发者能够有效应对Agent在实际应用中遇到的挑战,如上下文膨胀、循环收敛、状态持久化等问题,从而显著提升Agent的性能和可靠性。