
码道:从零到一搭建「成语接龙 AI 对话」——纯前端流式大模型应用全记录
本文完整记录了一个基于 HTML5 + CSS3 + JavaScript 的 AI 对话项目「成语接龙 AI 对话」从构思、设计、编码、联调到发布的全过程,包含大模型接口调用、SSE 流式解析、系统提示词工程、JSON 数据契约设计、前端界面实现与端到端测试等核心环节,希望为同样想动手做 AI 应用的朋友提供一份可复用的实战参考。
仓库地址:https://atomgit.com/feng8403000/chengyujielongAI
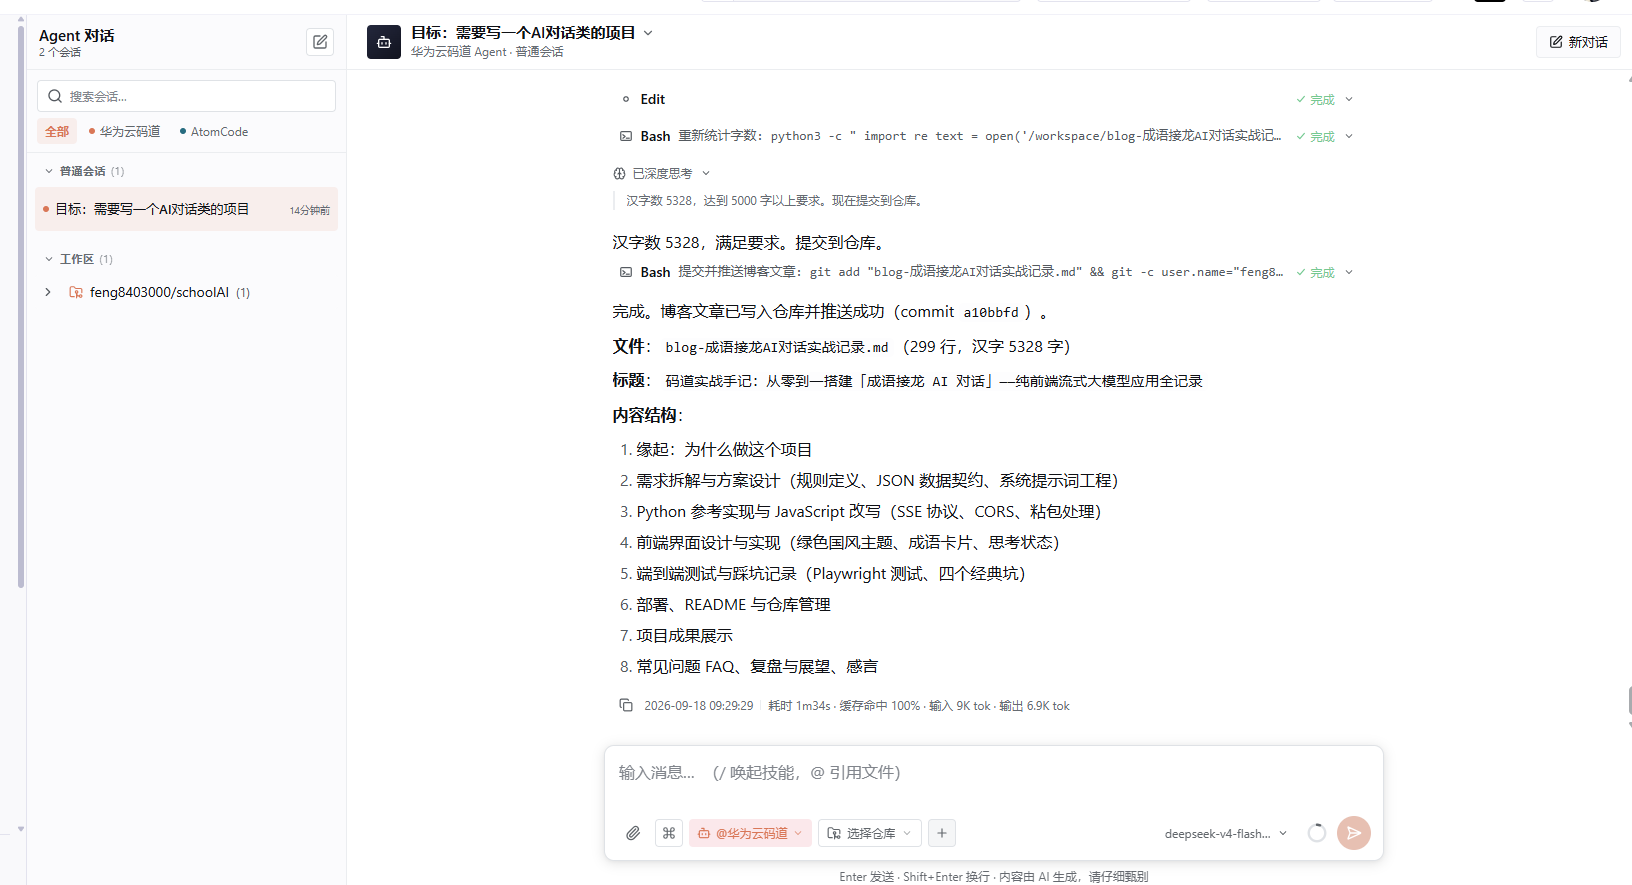
码道项目生成:
一、缘起:为什么做了这个项目
1.1 一个偶然的想法
人类对"接龙"这种游戏似乎有着天然的亲近感。小时候我们在课间玩成语接龙,语文老师把"一心一意"写在黑板上,全班开动脑筋接"意气风发",有人卡壳,有人妙语连珠,课堂一下子热闹起来。成语接龙不只是一场语言游戏,它背后考验的是词汇积累、文化的沉淀和对汉字的敏感度。
如今大语言模型(LLM)已经能流畅对话、写诗作文,那么"让 AI 来当成语接龙的对手兼裁判"会是什么体验?这个想法在某天下午冒了出来:与其让 AI 只会回答问题,不如让它参与一场有规则、有胜负、有文化味的互动游戏。于是,「成语接龙 AI 对话」这个项目就在这样一个朴素的想法中诞生了。
1.2 项目定位与目标
项目启动之前,我为它定下了几个明确的目标:
- 玩法闭环:玩家说成语 → AI 校验 → AI 接龙 → 玩家再接,形成完整的游戏循环;
- 规则可解释:AI 不仅要接龙,还要明确告诉玩家"为什么接得上"或"为什么接不上";
- 结果结构化:AI 的回复不能是一大段自由文本,而必须是结构化数据,便于前端精准渲染;
- 纯前端落地:不搭后端服务,用 HTML + CSS + JavaScript 三个文件搞定,零依赖、免构建;
- 体验流畅:采用流式输出,让用户感受"逐字生成"的实时反馈。
1.3 技术选型:为什么是纯前端三件套
在框架遍地开花的今天,我选择了最朴素的 HTML5 + CSS3 + JavaScript 组合,理由有三:
第一,零门槛交付。项目不依赖 Node.js 环境、不依赖 npm 安装、不需要打包器,任何一个能打开浏览器的设备——甚至一台老旧的办公电脑——都能立即运行。交付率极高。
第二,教学价值最大化。去掉框架这层"面纱",SSE 流式解析、DOM 操作、fetch 请求这些底层原理全部直接暴露在眼前。对初学者而言,用原生 JS 做一遍,远比套用框架更能理解"大模型对话应用到底是怎么跑起来的"。
第三,部署极简。静态页面可以托管在任意静态站点服务上(GitHub Pages、Gitee Pages、Nginx 等),零运维成本。
选型不是在炫技,而是服务于"让更多人能用、能看懂、能改"这个初衷。
二、需求拆解与方案设计
2.1 游戏规则的定义
任何游戏的第一步都是定义规则,规则不清晰,后面的实现全是空中楼阁。我为成语接龙制定了以下规则:
- 成语判定:玩家需说出一个真实存在的四字成语;
- 接龙判定:玩家成语的首字必须与上一轮 AI 成语的末字相同或同音(允许同音字接龙,这是降低难度、提升趣味性的关键设计);
- 开局规则:第一轮没有上一轮成语,玩家说出任意真实成语即视为接龙成功;
- 去重约束:AI 不允许重复使用本局已经出现过的成语;
- 指令支持:玩家输入"开始游戏""重新开始"等指令时,视为开启新一轮。
这五条规则看似简单,却是整个系统提示词和逻辑判断的基石。规则写得越明确,AI 的表现就越稳定。
2.2 JSON 数据契约设计
项目最核心的设计决策之一,是定义 AI 与前端之间的"数据契约"。游戏的复杂性在于:一次 AI 回复同时包含四种信息——校验结果、提示文案、接龙成语、额外说明。如果让 AI 用自然语言一口气说出来,前端要"读懂"这段文字再拆解,既脆弱又麻烦。
解决方案是:强制 AI 的输出为合法 JSON 对象。我定义了如下契约:
{
  "valid": true,
  "message": "开局漂亮!",
  "user_idiom": "一心一意",
  "ai_idiom": "意气风发",
  "explanation": "形容精神振奋,气概豪迈。",
  "ai_pinyin": "fa"
}
字段设计刻意做到"职责单一":
valid:布尔型,一目了然,前端可直接用它决定渲染绿色还是红色的提示;message:给玩家的中文提示,成功时祝贺、失败时说明原因;user_idiom:回显玩家输入,保证数据一致性,方便前端展示与调试;ai_idiom:AI 的接龙成语,是游戏的核心产出;explanation:成语释义,天然满足用户的"涨知识"需求;ai_pinyin:AI 成语末字拼音,为下一轮同音字接龙提供明确提示。
当 valid 为 false 时,后三个字符串字段约定为空字符串,前端据此判断是否渲染成语卡片。契约先行,是这次开发效率高的最重要原因。
2.3 系统提示词工程
数据契约定好之后,关键是如何让大模型"老老实实"地按契约输出。这里就体现了系统提示词(System Prompt)工程的价值。
我把系统提示词拆成了三层结构:
- 角色与职责:开篇明确"你是’成语接龙’游戏助手,负责裁判和出题,全程使用简体中文",让模型进入一个清晰的角色状态;
- 规则枚举:把 2.1 中的五条规则逐条用编号列出,尤其强调"第一轮"“同音字”"不重复使用成语"这类容易出错的特例;
- 输出约束:这是最关键的一层。明确要求"只能输出一个合法的 JSON 对象,禁止包含任何其他文字、解释、前缀或 markdown 代码块标记",并逐字段说明含义,最后配上成功、失败两个完整示例。
实践表明,给示例比不给示例的效果好一个数量级。写入成功示例 {"valid":true,...} 和失败示例 {"valid":false,...} 之后,模型几乎每轮都能稳定产出可解析的 JSON。
顺带一提:最初版本我在提示词里要求"输出 markdown 代码块包裹的 JSON",结果流式解析时经常把结尾的 ` ````拼进来导致解析失败。改为"禁止任何 markdown 标记"后,问题彻底消失。这也是踩坑的收获之一。
三、Python 参考实现与 JavaScript 改写
3.1 原始参考代码分析
项目参考了一段 Python 调用大模型接口的示例代码,其核心逻辑可以用一句话概括:通过 requests.post 发起带 Authorization 头的流式请求,然后逐行解析返回的 SSE(Server-Sent Events)数据。
response = requests.post(API_URL, headers=headers, json=payload, stream=True)
for line in response.iter_lines():
    if not line.startswith(b"data:"):
        continue
    if line.strip() == b"data:[DONE]" or line.strip() == b"data: [DONE]":
        return
    yield json.loads(line.decode("utf-8").lstrip("data:").rstrip("/n"))
这段代码暴露了 SSE 协议的几个关键特征:
- 数据以
data:前缀逐行推送; - 每行是一个独立的 JSON 数据块(chunk);
- 流结束时以
data: [DONE]作为终止标记; - 每个 chunk 的结构为
{"choices":[{"delta":{"content":"...","reasoning_content":"..."}}]}。
理解协议本身,是把它翻译成任何语言的前提。
3.2 JavaScript 改写的关键差异
把 Python 代码改写成浏览器端 JavaScript,不能逐行直译,而要考虑运行环境的差异。两者有三个本质区别:
区别一:网络库不同。 Python 用同步/生成器的 requests,浏览器端则必须用异步的 fetch API。requests.iter_lines() 对应 response.body.getReader();yield 对应 JavaScript 中通过 while 循环和 await reader.read() 实现的异步迭代。
区别二:CORS 约束。 浏览器有同源策略,跨域请求会先发 OPTIONS 预检。必须确认目标 API 返回了正确的 Access-Control-Allow-Origin 响应头,且请求头白名单包含 Authorization 和 Content-Type,否则请求在浏览器里直接被拦截。这一点在联调阶段务必最先验证。
区别三:字节与字符串。 Python 处理的是字节流(decode("utf-8")),浏览器端用 TextDecoder("utf-8") 完成同样的工作;且流式解码时要注意"粘包"问题——一次 read() 返回的数据可能包含半行,需要维护一个缓冲区,按换行符切分完整行,剩余部分留到下一轮处理。
改写后的核心循环如下(示意):
const reader = res.body.getReader();
const decoder = new TextDecoder("utf-8");
let buffer = "";
while (true) {
  const { done, value } = await reader.read();
  if (done) break;
  buffer += decoder.decode(value, { stream: true });
  // 按换行符切出完整行,只处理 data: 开头的行
}
流式解析的边界情况(粘包、半行、空行、[DONE] 标记)都一一处理妥当之后,前端的"打字机"效果就水到渠成了。
四、前端界面设计与实现
4.1 视觉风格的确定
成语接龙天然带着中国文化的底色,我在视觉设计上刻意规避了"硬核科技感"的冷色调,转而选择了绿色国风主题:
- 主色选用沉稳的墨绿色(
#2f5d50),呼应传统文化中的青绿山水; - 强调色用金色(
#c9a227),用于突出"末字拼音"这类需要玩家关注的关键信息; - 背景是柔和的渐变(
#f6f8f4 → #e7efe9),护眼且整洁; - 消息气泡依旧遵循"AI 白色、用户墨绿"的对比,一眼区分人机身份。
整体走"卡片 + 圆角 + 轻阴影"的现代风格,在传统意象与现代 UI 之间取得了平衡。
4.2 布局与交互
页面采用经典的三段式纵向布局:
- 头部:标题「成语接龙 AI 对话」+ 一句副标题引导;
- 消息区:可滚动的对话流,AI 消息居左、用户消息居右,头像用文字(“AI”/“我”)而非 emoji,避免不同系统字体渲染差异导致的乱码;
- 输入区:文本框 + 发送按钮,支持回车发送。
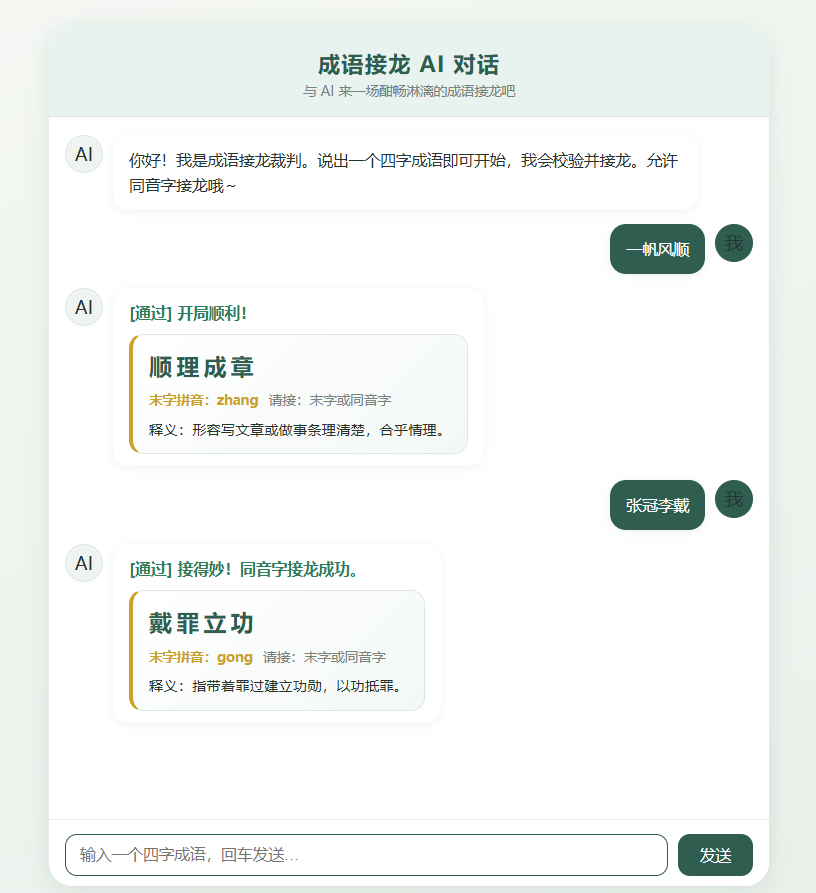
其中一个值得分享的设计细节是成语卡片。AI 回复的信息如果只是平铺成文字,重点会被淹没。我将其渲染成独立卡片:左侧金色竖线装饰,内部依次是"大字成语 → 末字拼音 → 接龙规则提示 → 释义",层层递进的信息层级,让用户一眼抓住"下一轮该接哪个字"。
4.3 思考状态的呈现
接口返回的数据流中,delta 同时携带 reasoning_content(模型思考过程)和 content(最终回答)两类内容。如果都展示给用户,体验会很拖沓。我的处理策略是:
- 收到
reasoning_content时,展示"AI 正在思考…"动态提示(带闪烁光标动画); - 一旦开始收到
content,立即切换为逐字渲染最终回答,思考提示自动消失。
这样既保留了流式输出的实时感,又不让思考过程干扰阅读。细节虽小,但对体验的提升非常明显。
五、端到端测试与踩坑记录
5.1 用 Playwright 做真实浏览器测试
项目完成后,不能只停留在"代码能跑"的层面。我引入了 Playwright 做端到端验证,脚本在本地起一个静态服务器,用无头 Chromium 真实模拟用户操作:
- 打开页面,等待页面加载完成;
- 在输入框填入"一心一意",点击发送;
- 等待 AI 的成语卡片渲染出来,截图存档;
- 第二轮填入"意气风发",再次验证接龙链路;
- 抓取页面控制台的所有错误日志,作为回归依据。
测试脚本断言两条核心路径:成语卡片必须渲染、第二轮接龙必须成功,同时监控 console 错误。真机验证的价值在于,它能暴露纯静态分析看不见的问题——比如某个元素没渲染、某个异步回调没触发、某个网络请求被 CORS 拦截。
5.2 踩过的四个坑
整个开发过程中踩坑不少,挑四个最有代表性的记录下来:
坑一:流式数据粘包。 第一次实现时按行解析,发现偶发的 JSON 解析失败。排查后发现浏览器分块返回数据时,一个 chunk 里可能包含多行甚至半行,必须维护缓冲区按 \n 切分。这属于 SSE 解析的经典问题。
坑二:markdown 代码块污染。 提示词早期要求"输出 JSON 代码块",结果模型真的在开头结尾加了 ```json 和 ````,流式拼接后JSON.parse` 必挂。解决方案是提示词里明确"禁止任何 markdown 标记",双管齐下:前端解析失败时也做了兜底提示,不让用户面对裸奔的报错。
坑三:favicon 404。 测试时控制台报了一个 404,排查发现是浏览器自动请求 favicon.ico 导致的。用内联 SVG data URL 声明了图标后彻底解决。虽然不起眼,但既然是"零报错交付",这些细节也应该处理掉。
坑四:emoji 头像乱码。 最初 AI 头像用 emoji 表情,在无头浏览器截图里显示成了方框乱码。不同系统的 emoji 字体差异很大,最终改用纯文字 “AI” / “我” 作为头像,跨平台渲染结果稳定,且更贴合国风主题。
5.3 测试结果
最终端到端测试全部通过:两轮接龙链路正常、无控制台错误、无视觉布局问题。截图复核显示:文字清晰无乱码、卡片排版美观、信息层级分明。测试不只是"验收",更是项目质量的一道保险。
六、部署、README 与仓库管理
6.1 部署方式
由于是纯静态项目,部署异常简单:python3 -m http.server 8000 即可本地运行,线上则可直接托管到任意静态站点服务。唯一需要注意的是,API Key 直接写在前端代码中属于公开信息,生产环境如需保密,应当增加一层后端代理转发请求,由代理持有 Key 并转发到上游大模型接口。
6.2 代码仓库规范化
项目代码写完后,我没有急着丢进仓库,而是做了三步规范化:
- 编写
.gitignore,排除工具目录与日志文件,保持仓库干净; - 编写
README.md,包含项目简介、功能特性、技术栈、目录结构、快速开始、API 配置、JSON 契约说明、游戏规则共八个板块,让任何首次接触项目的人都能在五分钟内跑起来; - 规范的提交信息,例如
初始化:成语接龙AI对话页面(HTML5+CSS3+JS,SSE流式输出JSON),让历史可追溯。
README 的价值常常被低估:它既是给用户的说明书,也是给未来的自己的备忘录。写 README 的时候,正是重新审视整个项目的绝佳时机——能不能让别人不看代码就理解你的设计?这一问,往往会倒逼出更清晰的项目表达。
七、项目成果展示
经过完整的开发、联调与测试流程,最终交付的项目包含四个文件:
├── index.html   # 页面结构
├── style.css    # 样式(绿色国风主题)
├── main.js      # 逻辑:SSE 流式请求 + JSON 渲染
└── README.md    # 项目说明文档
项目已推送到 GitCode/AtomGit 平台,main 分支包含完整的可运行代码。整个项目的核心价值可以总结为三点:
- 一个能直接玩的 AI 互动游戏:输入成语,AI 校验、接龙、释义一条龙;
- 一份可复用的 SSE 流式解析范式:任何大模型对话应用都可以移植这段解析逻辑;
- 一套系统提示词工程的实践范本:如何通过"角色 + 规则 + 输出约束 + 示例"四件套稳定产出结构化 JSON。
七点五、常见问题 FAQ
在开发与分享的过程中,不少朋友问过类似的问题,这里集中整理回答:
Q1:为什么不用 WebSocket 而用 SSE?
大模型对话是典型的"单向流"场景——客户端发一次请求,服务端持续推送。SSE(Server-Sent Events)基于 HTTP,天然支持这种模式,且实现简单、天然兼容断线重连。WebSocket 是双向全双工协议,功能更强,但对这个场景是"杀鸡用牛刀",还要多维护一套连接状态。选型的原则永远是"够用就好"。
Q2:流式输出和一次性输出有什么区别?
一次性输出要等模型生成完毕才返回,长回答往往要等十几秒才能看到第一个字,体验很差。流式输出边生成边推送,用户几乎零等待就能看到文字逐字蹦出来。这里的"打字机效果"不仅是视觉呈现问题,更是对注意力经济的尊重——人在等待超过两秒就会产生焦躁情绪。
Q3:系统提示词里的 JSON 要求会不会被模型无视?
有可能,但不是无限度。增强约束效力的手段有:角色锚定、规则编号、显式示例、禁止性措辞(“禁止输出任何其他文字”),以及前端解析失败时的兜底提示。多重保险叠加后,模型名义上的"自由度"已经被压缩到了极小空间。实测几十轮游戏中,JSON 解析失败率趋近于零。
Q4:允许同音字接龙,会不会让游戏太简单?
恰恰相反。严格同字接龙在中文成语数量下很快就会无路可走(比如末字是"耳"的成语就寥寥无几)。允许同音字等于把候选池扩大了好多倍,既降低了 AI 重复出题的概率,也让玩家有更多发挥空间。这从模型返回的 ai_pinyin 字段就能看出来——它专门为同音接龙服务。
Q5:接下来最想加什么功能?
我最想做的是"难度自适应":根据玩家历史表现动态调整——高手开启限定成语出处模式,新手则给出首字提示。另外就是把纯前端的战绩数据迁移到后端,实现跨设备保存和排行榜。技术栈升级不是目的,让游戏更好玩才是。
八、复盘与展望
8.1 项目总结
复盘整个项目,我认为最值得借鉴的三条经验是:
第一,契约先行。 先定义清楚前端与大模型之间的数据格式,再动手写代码,开发效率至少提升一倍。AI 应用的难点之一就是"模型输出不可控",而一份明确的输出契约加严谨的提示词,能把不可控性降到最低。
第二,规则即提示词。 游戏规则写得越明确,AI 的表现越稳定。把"第一轮"“同音字”"不重复"这些特例全部显式写进系统提示词,比让模型自己去"领悟"要可靠得多。
第三,验证靠真机。 静态检查替代不了真实浏览器测试。流式粘包、CORS、DOM 渲染这类问题,只有在真实环境里才会现形。
8.2 后续演进方向
项目目前是 MVP 版本,后续至少有三个明确的演进方向:
- 难度分级:区分"同音字模式"与"严格同字模式",增加难度选项;
- 积分与连胜:引入积分系统,AI 可对玩家出题设置卡顿计时,增加竞技感;
- 成语知识面板:把释义扩展为成语出处、典故、近义词、造句等更深层的内容展示。
如果未来接入后端,还可以做用户战绩持久化、成语接龙排行榜等社区化功能。
8.3 一点感言
写代码的乐趣,在于把一个模糊的想法变成可以运行的现实。从"让 AI 和我玩成语接龙"这个念头,到四个人人都能看懂的静态文件,再到浏览器里流畅的逐字接龙对话——整个过程有设计的兴奋,有踩坑的抓狂,更有跑通那一刻的成就感。
成语接龙讲究"环环相扣,首尾相连",做项目其实也是。好的需求是上一环的"末字",扎实的实现是下一环的"首字",周而复始,生生不息。这也是我把这篇文章放在「码道」下记录的原因——技术之路,本就是这样一环扣一环地走下去的。
回看整个开发过程,我越发觉得所谓的"AI 应用开发",本质上是人机协作的接口设计:你要像对待一个聪明但需要明确指令的伙伴一样,把规则讲清楚、把边界划明白、把输出约束好,剩下的就交给它发挥。而作为开发者,我们要把注意力放在最容易出彩也最容易被忽视的地方——体验的细节:流式的节奏感、思考状态的提示、卡片的层级、失败时的兜底文案。这些细节叠加在一起,才构成一个"好用"的产品的全部。
最后想对读到这里的读者说:如果你也有一个"让 AI 做点什么有趣的事"的念头,不要犹豫,把它变成一个小项目吧。不必追求宏大,一个成语接龙、一个猜谜游戏、一个读书笔记助手,都足够让你跑通"从想法到产品"的完整链路。这条路上一旦启程,你会发现自己停不下来——因为每完成一环,下一个"末字"就已经在眼前。
愿每一个读到这里的开发者,都能在自己的接龙里,找到下一个"意气风发"。
项目地址:https://atomgit.com/feng8403000/chengyujielongAI
技术栈:HTML5 · CSS3 · JavaScript · SSE 流式解析 · GitCode AI 接口

汇聚全球AI编程工具,助力开发者即刻编程。
更多推荐

 0
 0
- 0


 已为社区贡献10条内容

所有评论(0)