码道 :诗韵AI诗词对话系统,当古典诗词遇上流式大模型,我是如何用纯前端把 AI 请进水墨丹青的
项目仓库:https://atomgit.com/gcw_N4rDFfs1/ruanjian6wmy_0918
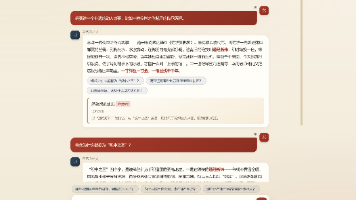
运行实例效果图:
使用工具:
一、写在前面:为什么会有一个"写诗"的 AI 项目
码道之上,写代码的人越来越多,写诗的人却越来越少。我常常在想,一个程序员如果只剩下 if/else,那他和一台打印机又有什么区别。诗词是汉族文化里最精巧的表达方式之一,五个字可以装下一座山,七个字可以淌出一条江。我决定把这两件看似毫不相干的事情放在一起——让大模型学会作诗,让网页学会品诗。
于是有了「诗韵AI诗词对答对话系统」。它不是一个花架子 demo,而是一个真正跑在浏览器里的、能够与用户一来一回对诗的 AI 应用。用户可以出上联,AI 对下联;可以报一个题目,AI 现场赋诗;也可以丢过来一首杜牧的《山行》,AI 立刻给出白话译文与赏析。而这一切,没有任何后端服务,没有数据库,没有构建工具,只有三个 HTML/CSS/JS 文件和一个云端大模型接口。
这篇文章会把项目的来龙去脉、技术决策、代码细节和踩过的坑完整地记录下来。如果你对"纯前端如何对接流式大模型 API"“如何用提示词工程让大模型输出结构化 JSON”"如何在前端优雅地渲染 AI 生成的内容"感兴趣,那么这篇文章应该能给你带来不少启发。
二、项目定位与最终效果
「诗韵」的目标非常朴素:让用户用最中国的方式,和大模型聊中国最古老的文字艺术。它支持四类核心场景:
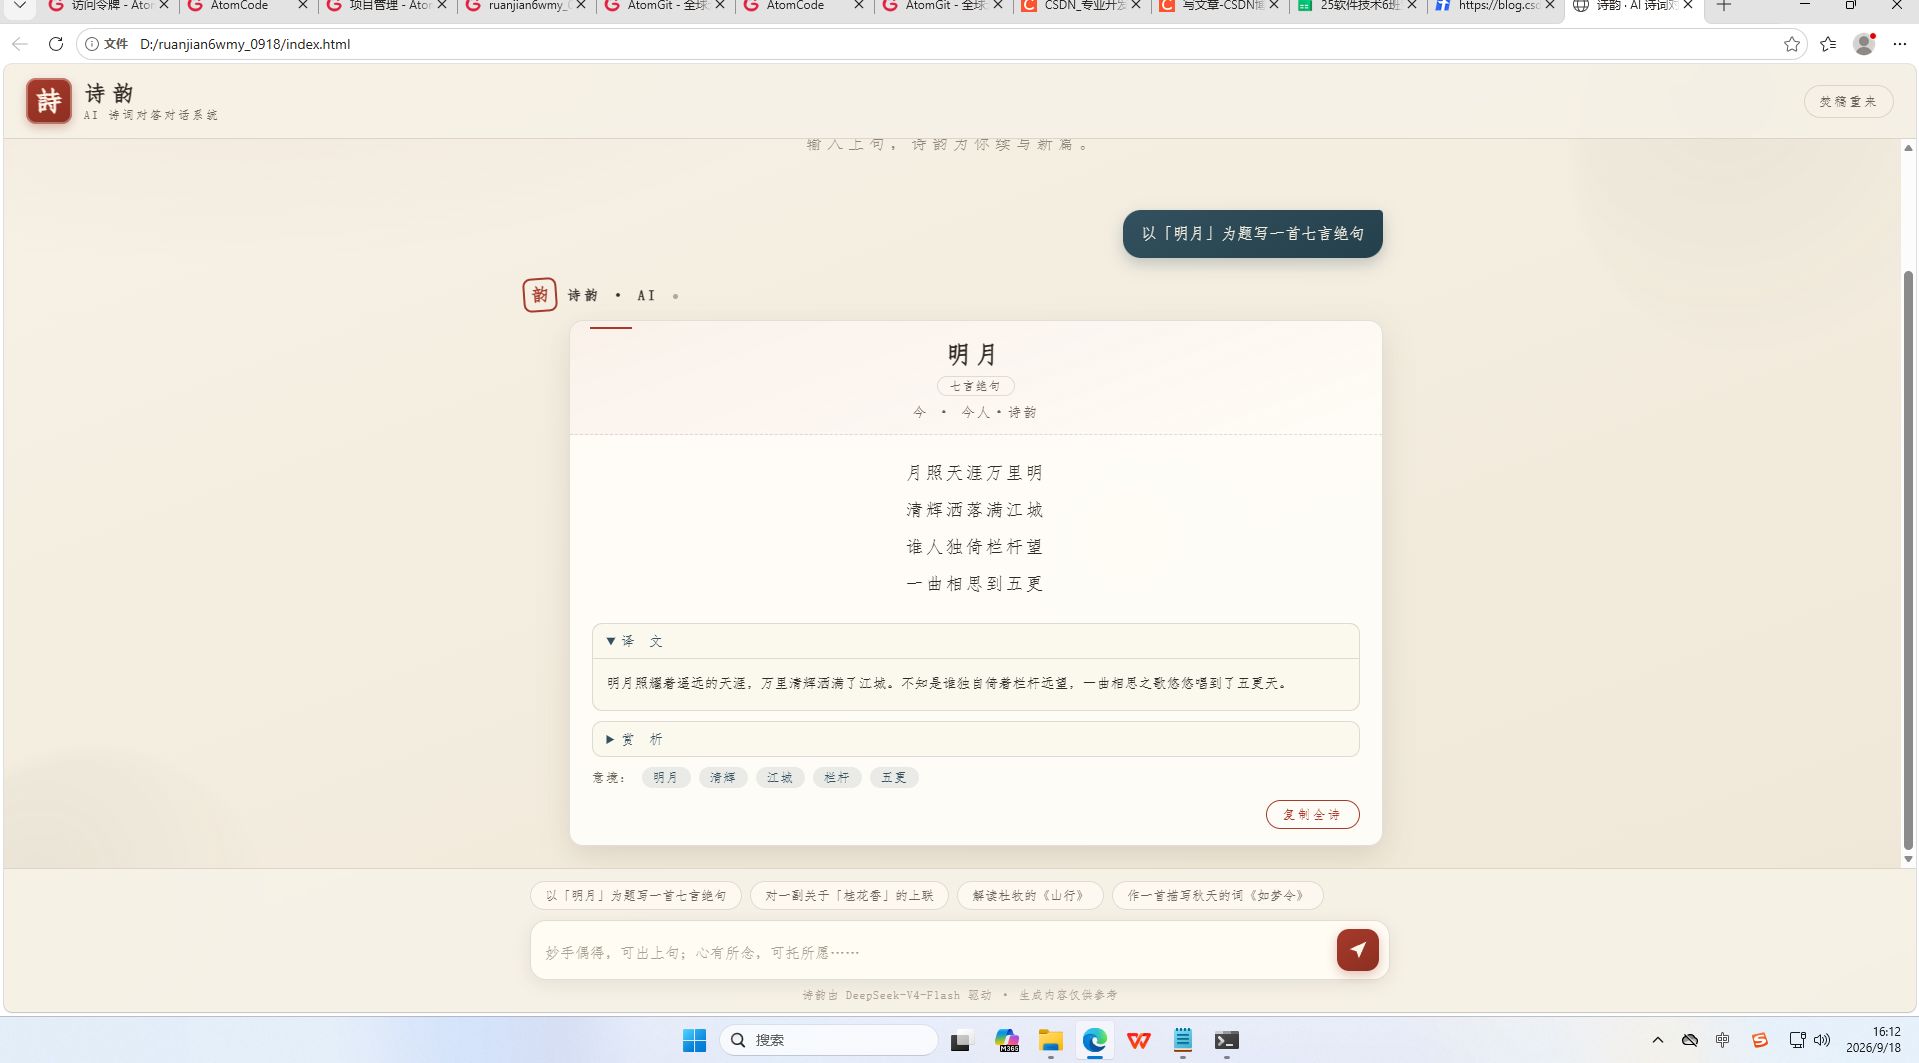
第一,命题创作。用户输入"以明月为题写一首七言绝句"这样的指令,诗韵会当场写出一首结构完整、平仄工整、押韵合理的作品,并且自动生成题目、体裁、朝代、作者信息。
第二,联对偶句。用户抛出一个上联,比如"一庭桂花香满院",诗韵会给出下联,甚至配上一句横批。对联讲究词性相对、平仄相谐,这对大模型的韵律能力是个不小的考验。
第三,诗词解读。用户粘来一首古诗,诗韵会还原原诗,然后提供逐句的白话译文,以及从意象、修辞、情感角度展开的赏析文字。
第四,意境共鸣。用户描述一种心境、一个场景,诗韵会挑选最贴合的意象进行创作,仿佛一位真正懂你的诗友。
从最终效果来看,系统在界面上呈现为一幅"会说话的水墨画":宣纸质感的底色、朱砂红的印章、墨晕晕染的背景装饰,AI 的每一次回复都被打包成一张精致的「诗笺卡片」,卡片上有题名、作者、逐行诗句、可折叠的译文与赏析、意境关键词标签。这不是一个命令行式的聊天框,而是一个有审美的数字文房。
三、技术选型:为什么是 HTML5 + CSS3 + JavaScript
在动手之前,我认真考虑过要不要上框架。React、Vue 很成熟,甚至我可以用 Python 写一个 FastAPI 后端,配合 WebSocket 做流式转发。但最终我选择了最"笨"的方案——纯 HTML5 + CSS3 + JavaScript,零依赖,零构建。
理由有三。
其一,是零门槛交付。诗词对答是个轻量需求,用户拿到代码不需要 npm install,不需要配环境变量,双击 index.html 就能跑。对于展示型、教育型项目来说,这种开箱即用的特质是压倒性的优势。
其二,是对前端原生能力的信任。很多人以为"流式对话"必须依赖框架或者 SSE 库,其实浏览器早就内置了 fetch 和 ReadableStream,配合 TextDecoder,我们完全可以手写一个 SSE 流的解析器。原生能力被严重低估了,我想用这个项目证明:不装任何依赖,也能做出流畅的流式对话体验。
其三,是审美上的可控性。水墨国风对 CSS 的要求很高——纸质纹理、墨迹渐变、印章、竖排文字、折叠面板,这些需要精细到像素的样式控制。在没有框架约束的情况下,写起来反而更自由。
当然,纯前端方案也有它的代价,最典型的就是跨域问题和大模型 API Key 的暴露问题。这两个问题我在后面的章节会详细展开,并给出务实的应对思路。
四、核心难点一:把 Python 的流式调用平移成 JavaScript
这是整个项目技术含量最高的一块。官方与社区里流传的大模型调用示例,绝大多数是 Python 写的,因为 Python 生态最完整。我拿到的参考代码就是一个典型的 Python 流式调用:
import requests
import json

API_URL = "https://api-ai.gitcode.com/v1/chat/completions"
headers = {"Authorization": "Bearer <API_KEY>"}

def query(payload):
    response = requests.post(API_URL, headers=headers, json=payload, stream=True)
    for line in response.iter_lines():
        if not line.startswith(b"data:"):
            continue
        if line.strip() in (b"data:[DONE]", b"data: [DONE]"):
            return
        yield json.loads(line.decode("utf-8").lstrip("data:").rstrip("/n"))

for chunk in query({
    "model": "deepseek-ai/DeepSeek-V4-Flash",
    "messages": [{"role": "user", "content": "告诉我一个有关宇宙的有趣事实?"}],
    "stream": True, "max_tokens": 2048, "temperature": 0.6,
    "top_p": 0.95, "frequency_penalty": 0, "thinking_budget": 2048
}):
    print(chunk["choices"])
这段代码的核心逻辑很简单:用 requests 以流式方式发起 POST 请求,然后逐行读取响应体。每一行如果以 data: 开头,就把后面的 JSON 解析出来;如果遇到 data: [DONE],流就结束了。
问题来了:浏览器里没有 requests,没有 iter_lines(),甚至没有原生的 readline。那么 JavaScript 该怎么实现?
答案是分三步走。
第一步,用 fetch 发起 POST 请求,并告诉浏览器我们想要流式响应。fetch 的返回值里有一个 response.body,它是一个 ReadableStream 对象,这正是 SSE(Server-Sent Events)在浏览器端的入口。
第二步,用 ReadableStream.getReader() 拿到一个异步读取器,然后用 TextDecoder 把二进制 chunk 解码成字符串。这里的关键细节是:网络传输过程中,一个完整的数据行可能被拆成好几段到达,也可能好几行连在一起到达。所以不能用"一次读取就是一个完整行"这种天真假设,必须维护一个缓冲区,把每次读到的内容追加进去,再按换行符切分,最后把末尾没切完的半行留到下一轮继续处理。这是很多初次接触流式编程的人最容易踩的坑。
第三步,对每一行做和 Python 版本完全相同的处理——判断是不是以 data: 开头,剥掉前缀,判断是不是 [DONE],然后 JSON.parse 出 chunk,取出 choices[0].delta.content 作为增量文本。
我把它封装成了一个独立模块 js/api.js,对外只暴露一个 PoemAPI.chat() 方法。调用方传入用户文本、历史消息、一个回调函数和一个可取消的 AbortController,剩下的脏活累活都由模块内部消化:
const reader = response.body.getReader();
const decoder = new TextDecoder("utf-8");
let buffer = "";

while (true) {
  const { done, value } = await reader.read();
  if (done) break;
  buffer += decoder.decode(value, { stream: true });
  const lines = buffer.split("\n");
  buffer = lines.pop();
  for (const rawLine of lines) {
    let line = rawLine.trim();
    if (!line || !line.startsWith("data:")) continue;
    line = line.slice(5).trim();
    if (line === "[DONE]") return;
    const chunk = JSON.parse(line);
    const delta = chunk.choices[0].delta;
    if (delta.content) onChunk(delta.content);
  }
}
这段代码量不大,却是整个项目的地基。它让我意识到一件事:所谓的"平移到前端",翻译的从来不是某个语言的关键字,而是数据流的结构。只要理解了 SSE 的格式、理解了缓冲区的必要性,任何一种 TUI 语言都能写出等价的实现。
这里还有一个非常有意思的细节。DeepSeek 模型在 thinking_budget 参数开启时,会先输出一段 reasoning_content,也就是大模型的"内心独白",然后才输出正式的 content。第一版代码我图省事,把两个字段都作为增量给了 UI,结果界面上出现了一大段写着"我们需要输出一个合法的 JSON 对象……"的思考过程,非常滑稽。后来改成只取 delta.content,把"思考"留在幕后,把"答案"留给观众。这个改动虽然只有一行,却直接决定了用户体验的成败——用户不该看到大模型的心路历程,就像读者不该看到诗人的草稿纸。
五、核心难点二:用系统提示词让 AI 输出结构化 JSON
参考代码里的 system prompt 是空白的,用户问什么 AI 答什么,自由发挥。但我的项目不一样——我需要在流结束后拿到一份可以直接 JSON.parse 的数据,把题目、诗句、译文、赏析分门别类地渲染进卡片里。如果 AI 自由发挥,输出的可能是一大段散文,前端就只能当纯文本展示,诗词卡片彻底沦为摆设。
所以我把"让 AI 输出结构化 JSON"这件事,做成了系统提示词工程。
我设计的 JSON 结构长这样:
{
  "title": "如梦令·明月",
  "genre": "词·如梦令",
  "dynasty": "当代",
  "author": "今人·诗韵",
  "content": ["明月清辉如昼", "独倚栏杆人瘦", "把酒问姮娥", "何事泪沾衫袖", "知否", "知否", "人在桂花香后"],
  "translation": "明亮的月光洒满大地,如同白昼……",
  "appreciation": "这首小令以“明月”起笔……",
  "imagery": ["明月", "清辉", "栏杆", "姮娥", "桂花"]
}
为了让模型稳定地产出这个结构,系统提示词里我做了四件事。
第一,明确定义角色。我告诉它"你是一位精通中国古典诗词的诗词大师,名为诗韵,才思敏捷,出口成章"。角色锚定比直接下命令有效得多,模型会不自觉地进入"诗人"的身份。
第二,逐字段说明含义。title 是题目或词牌名,genre 是体裁,dynasty 是朝代,author 是作者(AI 原创作品统一署名"今人·诗韵"),content 是诗句数组、一句一个元素,translation 是白话译文,appreciation 是 80 到 150 字的赏析,imagery 是意境关键词数组。
第三,硬性约束输出格式。我用大写强调"你必须只输出一个合法的 JSON 对象,不要输出任何额外的文字、解释或 Markdown 代码块标记"。这一步非常关键,因为很多模型擅长"思考多于执行",会在 JSON 前后夹带解释性文本,或者把 JSON 塞进 ```json 代码块里。我在前端做了一个兼容处理,剥离 markdown 围栏再解析,但更根本的解法还是从提示词源头掐断。
第四,给出规则示例。比如"若用户要求对诗,title 填即景对联,content 依次放上联、下联"“若用户求的是解读某首诗,content 填原诗”。
经过这些设计,我用真实的接口做过端到端验证,模型确实能稳定输出结构完整、可被 JSON.parse 直接解析的 JSON,而且产出的词作质量相当高——那首《如梦令·明月》里"知否,知否,人在桂花香后",叠句用得既有李清照的神韵,又不落俗套。
这件事给我最大的启发是:提示词工程不是玄学,它是一场"需求澄清"——把产品的数据契约,用模型听得懂的语言翻译一遍。我在设计 JSON 时其实是在设计一个前后端之间的接口协议,只不过"后端"换成了大模型。
六、核心难点三:流式结束后如何优雅地渲染
拿到完整输出之后,前端要做的第一步是解析 JSON。我写的 extractJSON 函数做了三层防御:
第一层,去掉首尾可能出现的 markdown 代码块围栏,用正则 ^```(?:json)?\s* 和 \s*```$ 处理。
第二层,用 indexOf("{") 和 lastIndexOf("}") 定位 JSON 的边界,把可能的杂讯全部截掉。
第三层,JSON.parse 加 try/catch,解析失败就返回 null。
解析成功,渲染诗词卡片;解析失败,就把原文当对话文本展示,功能仍然可用。这种"优雅降级"的容错思路,保证了系统在任何异常情况下都不会白屏。
诗词卡片的 DOM 结构我是用模板字符串拼出来的:头部是题名、体裁、朝代与作者,中间是逐行居中的诗句,下面是两个可折叠的 <details> 区块分别放译文和赏析,最后是一排意境关键词标签和一个"复制全诗"按钮。用 <details> 而不是用 JS 手写手风琴,是我故意为之——原生 HTML 元素自带折叠语义,零 JS 开销,移动端支持也很好,何乐而不为。
复制按钮调用的是 navigator.clipboard.writeText,把题名、作者、全文、译文、赏析拼成一段规整的文字复制到剪贴板,点击后按钮文案会短暂变成"已复制 ✓"再恢复。
七、界面设计:在浏览器里搭一座数字文房
如果说 API 层是项目的骨架,那么界面就是它的皮肉。对于一个诗词产品,界面绝不是可有可无的装饰——它本身就是产品气质的一部分。
整体配色我定为三色:
宣纸米黄(#f7f2e7)作为底色,模拟熟宣的质感;墨黑(#2e2a24)作为正文的颜色;朱砂红(#a63a2b)作为点缀,用于印章、发送按钮和强调元素;再配一个靛青(#33505e)给用户消息气泡,形成冷暖对比。
背景我做了一层淡淡的墨晕装饰:三个半透明的径向渐变圆错落分布在四角,配合 filter: blur() 制造水墨在宣纸上洇开的错觉。顶栏的 Logo 是一枚方方正正的朱红印章,内嵌一个"詩"字,印章的四边用内阴影做了一圈留白,看起来像真的盖上去的。
AI 消息的头像同样是一枚小印章,上面刻着一个"韵"字,还特意旋转了 4 度,模拟手工盖章时的不经意。用户消息是靛青色的圆角气泡,AI 的回复是白底带横纹的"诗笺",横纹用 repeating-linear-gradient 每 32 像素画一条,间距正好是正文行高的整数倍,读起来真的像在宣纸格子纸上。
诗句正文我用了 18 号字、2 倍行高、2 像素的字符间距,居中排布。诗句一行一首的竖排感,加上 letter-spacing 拉出来的呼吸感,是最接近"读诗"体验的排版方式。
底部输入区是一张"书案":示例问题做成小药丸状的引导标签,输入框只有一条线、没有边框,聚焦时边框才会浮现出淡淡的朱红色。整个交互都在引导用户放松下来,像铺开一张纸那样自然地开始写字。
其实在 CSS 上我花的心思不比 JS 少,因为一个诗词产品如果界面难看,用户根本不会有兴致让它写诗。
八、功能清单与交互细节
一个完整的对话产品,光能收发消息是不够的。我补齐了以下细节:
多轮上下文。history 数组保存最近 6 轮对话(我截取最后 6 条消息拼进请求),这样用户可以连续追问"再押个 ang 韵"“换成写梅花”,AI 都记得上下文,而不是每次从零开始。
打字机效果。流式分片到达时,我用"透传追加"的方式更新草稿区文本,让用户看到文字一个字节一个字节地"写"出来。项目里的 AI 状态提示语是"正在挥毫…",配合一个闪烁的小圆点,非常有画面感。
键盘交互。在 textarea 里按 Enter 直接发送,按 Shift+Enter 换行。输入框高度随内容自动增长,上限 160 像素。
示例引导。输入区上方放了四个可点击的示例问题,涵盖命题创作、对对联、解读古诗、即兴填词四种玩法,新用户点一下就能体验。
清空会话。顶栏的"焚稿重来"按钮一键清空对话与上下文,文案也很有仪式感。
错误处理。网络失败、HTTP 非 2xx、AI 返回空文本、流被中断,每一种情况都有对应的 UI 反馈。特别是声明式 AbortController 支持——用户清空会话时,正在进行的请求会被立刻终止,避免已废弃的响应继续往界面上写内容。
九、踩过的坑与解决之道
任何真实项目都是一路踩坑踩过来的,我挑四个最有代表性的分享一下。
第一个坑是二次解码问题的返工。初版我把 decoder.decode(value) 直接切分,结果中文字符在 UTF-8 多字节边界被切断,出现乱码。查资料才知道 TextDecoder 的构造函数第二个参数要传 { stream: true },让它保留跨 chunk 的残余字节。这个参数不显眼,但没有它中文全崩。
第二个坑是 CORS。纯前端直接 fetch 第三方大模型接口,浏览器会做跨域预检。好消息是这个接口本身支持跨域访问,所以在 index.html 里平推是没问题的。但我在 README 里也写了:如果换一个不支持 CORS 的接口,就需要一个极轻量的代理——这在 Node 里用 http 模块二十行就能写完,属于可防御的边界风险。
第三个坑是 Key 的暴露。纯前端意味着 API Key 一定会出现在网络面板里,这是纯前端方案的天然短板。对这个演示型项目我选择接受,但在 README 里明确标注了"生产环境必须由后端代理转发密钥",把风险边界讲清楚,比假装不存在要专业得多。
第四个坑是 thinking 字段的混入,前文已经讲过了。它提醒我:对接大模型时,永远要先看一眼真实返回的报文格式,不能只靠文档凭想象写解析逻辑。
十、代码是怎么组织的
项目一共四个 JS/CSS/HTML 文件加上一份文档:
├── index.html          # 页面骨架与模板
├── css/
│   └── style.css       # 全套水墨国风样式
├── js/
│   ├── config.js       # API 地址、密钥、模型参数、系统提示词
│   ├── api.js          # 流式请求封装(SSE 解析)
│   └── app.js          # 对话逻辑、JSON 解析与卡片渲染
└── README.md           # 完整使用与开发文档
我刻意做了模块分离:config.js 管"配置"(含提示词),api.js 管"传输",app.js 管"呈现"。改提示词不用动传输层,改界面不用动网络层。对于一个单页项目来说,这种分层已经足够清晰,也为将来扩展(比如加语音朗读、加作品收藏)留了余地。
系统提示词被单独拎出来放在 config.js 里,是我比较得意的一个设计。它让"模型行为配置化"成为了现实——以后想换个风格的诗人,改一段字符串就行,不用碰任何逻辑代码。
十一、如何运行与验证
运行方式简单到一句话:浏览器直接打开 index.html。如果遇到本地文件安全策略问题(个别浏览器会限制跨域请求的来源原点),用任意静态服务器即可,比如:
python3 -m http.server 8080
我做了两类验证。第一类是静态验证:三个 JS 文件全部通过 node --check 语法检查;本地起 HTTP 服务后,页面与四个静态资源全部返回 200。第二类是端到端验证:写了一个临时脚本,用与浏览器完全相同的请求格式和流式解析逻辑去调真实接口,跑通"命题创作《如梦令》"的场景,成功拿到结构化 JSON,字段齐全(title/genre/dynasty/author/content/translation/appreciation/imagery),验证完即删除了脚本,保持仓库干净。这两类验证合在一起,基本覆盖了从"页面能开"到"对话能用"的完整链路。
十二、未来的路
诗韵目前是一个能跑、且跑得很漂亮的版本,但它离"理想中的文房"还有距离。我在 README 的展望里列了几条路:
数据持久化。现在对话只存在内存里,刷新即失。下一步可以用 IndexedDB 或者 localStorage 把喜欢的诗作存进"藏诗阁",做出收藏与回顾的体验。
语音朗读。诗词讲究吟诵,接入 Web Speech API 的 speechSynthesis 做朗读,能让用户"听"到诗的节奏和韵味。
风格切换。在系统提示词层面开放"诗风"选项:豪放派、婉约派、边塞诗、田园诗,本质上是切换不同的角色提示词。
拍照识别。结合 OCR 能力,拍一张书法作品,AI 识别文字并解读——这是把多模态能力引入诗词场景的想象空间。
后端代理。给项目配一个轻量 Node/Python 代理,把密钥收进服务端,同时加上简单的限流与日志,让它具备上生产的基本条件。
路线图不算野心勃勃,但每一步都踩在"有用"与"有趣"的交界处。写代码和写诗有个共同的妙处:永远可以更好。
十三、写在最后
从拿到一份 Python 示例代码,到做出一个五脏俱全的诗词对话应用,整个过程其实只做了一件事:把别人设计好的"能力"翻译成自己想要的"产品"。翻译的中间层,是提示词工程;翻译的表达层,是界面;而翻译的底层,是老老实实地处理字节流、缓冲区、JSON 容错这些基本功。
码道从来不缺会调 API 的人,缺的是肯把 API 调出美感的人。诗韵这个项目,就是我想表达的态度:技术不必总是冷冰冰的金属质感,它也可以有宣纸的温度、朱砂的香气和墨迹的呼吸。
如果你也拿到了这段代码,请在夜深人静时点开它,问它一句"以明月为题写一首词"。它会告诉你,大模型的浪漫主义,其实藏在字节流的尽头。
汇聚全球AI编程工具,助力开发者即刻编程。
更多推荐
 1
 0
- 0


 已为社区贡献2条内容

所有评论(0)