
码道:用纯前端打造「心屿」长程心理陪伴 AI 心灵医生 —— 从 Python 流式调用到 JSON 结构化渲染
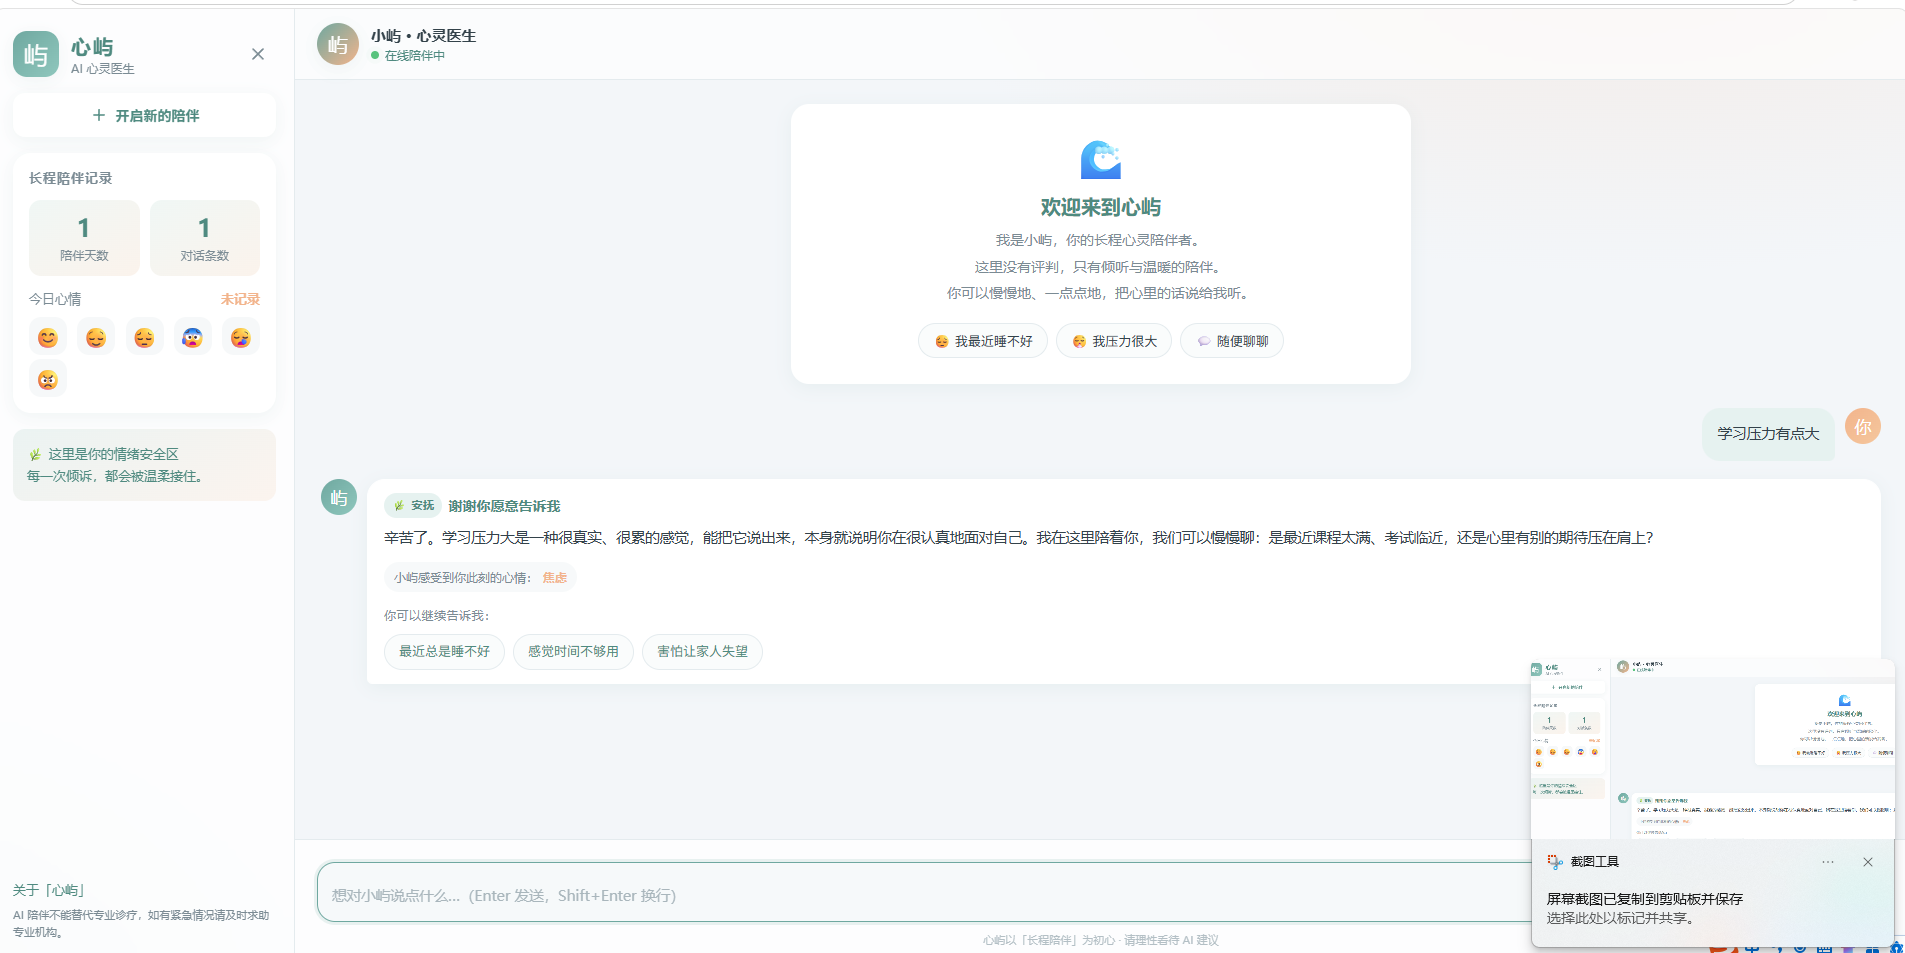
运行实例效果:
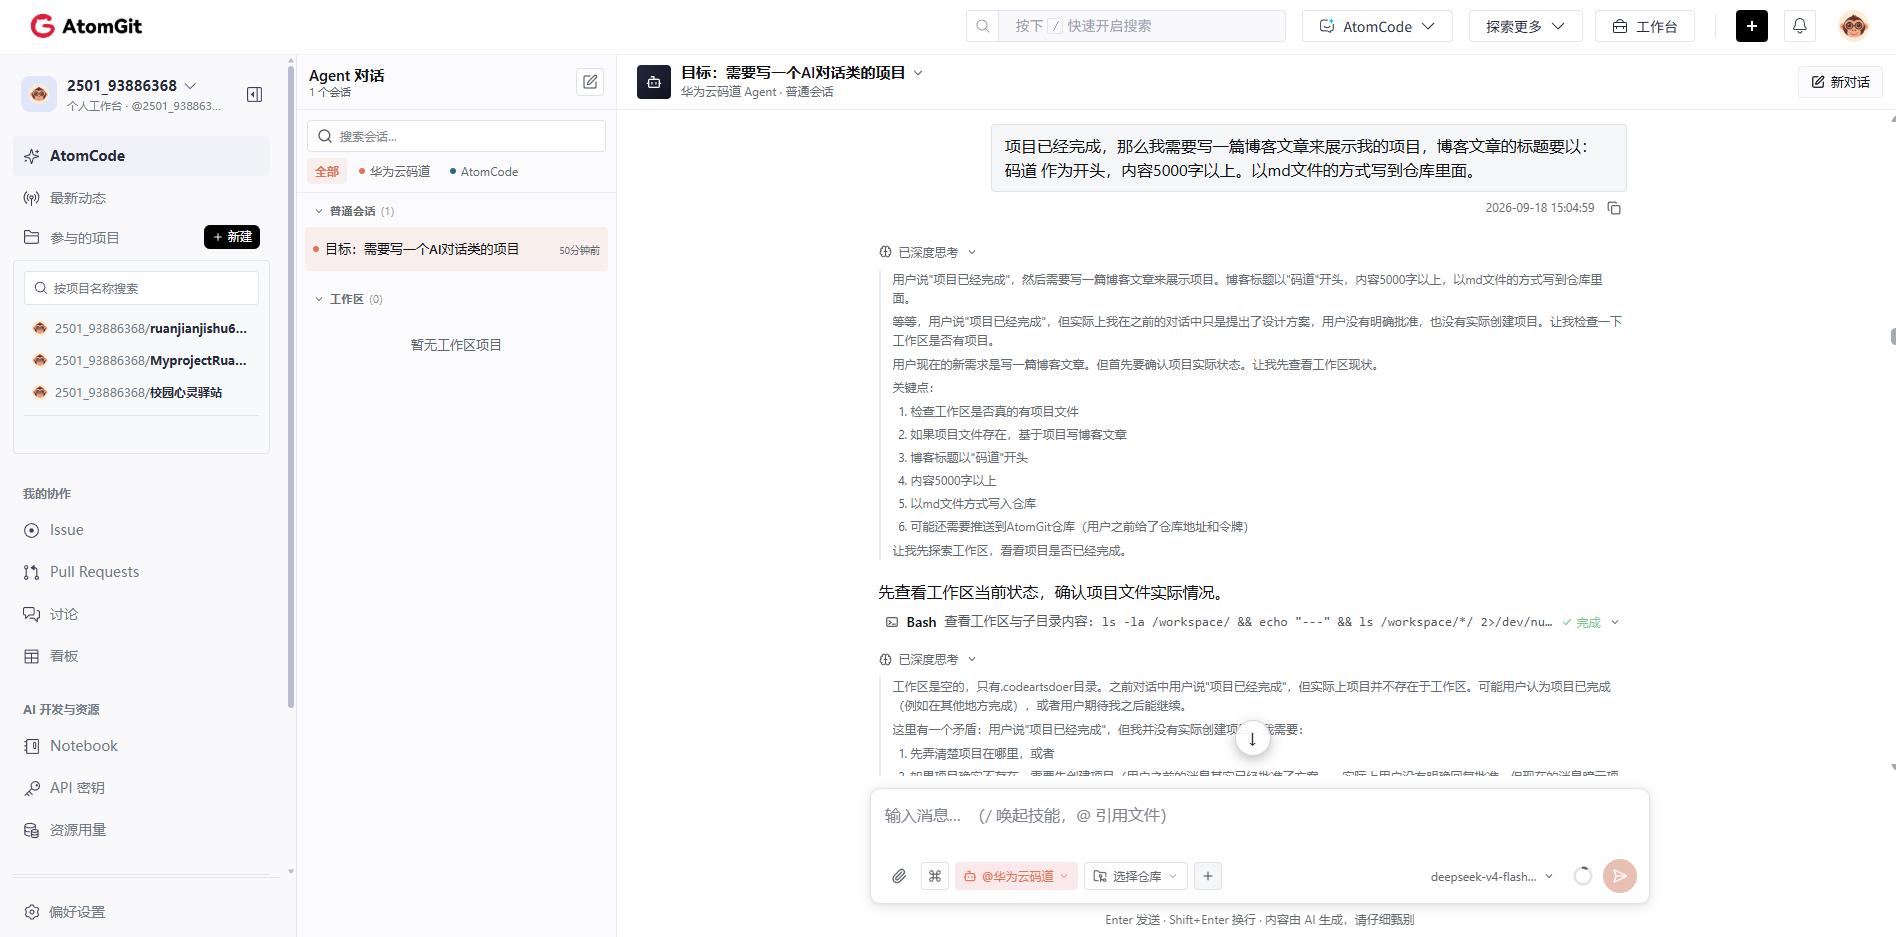
使用工具:
一、写在前面:为什么需要一个「长程心理陪伴」AI
在快节奏的现代生活里,焦虑、失眠、孤独、迷茫几乎成了年轻人情绪的底色。传统心理咨询受时间、费用、隐私、地域等条件限制,很多人「想找人说说」却迟迟迈不出那一步。大语言模型的出现,为心理陪伴打开了一扇新的门:它足够耐心、随叫随到、没有评判,能够作为专业咨询之外的一种温和、低门槛的补充陪伴。
但市面上的 AI 聊天产品往往停留在「你问一句、我答一句」的问答层面,缺少两个关键特质:情绪感知与长程连续。所谓情绪感知,是指 AI 不应该只回答内容,还应该「看懂」用户此刻的状态;所谓长程连续,是指一次次对话应该被记住、被沉淀、被可视化,让用户看到自己情绪的变化轨迹。
正是基于这两个诉求,我启动了「心屿」项目。它的定位不是一次性答疑助手,而是一位「会记住你、会陪着你、会在你低落时第一时间递上伞」的心灵伙伴。
于是,项目的技术目标随之明确:
- 纯前端实现,无需后端服务器,双击即可运行;
- 接入选定的国产大模型 API,实现真正的流式对话;
- 通过系统提示词让模型输出结构化 JSON,供前端做丰富的可视化渲染;
- 提供会话历史、情绪趋势、危机干预等长程陪伴能力。
二、技术选型:为什么坚持「零依赖纯前端」
在规划阶段,我其实犹豫过技术路线。主流方案无非三条:React/Vue 工程化框架、带后端服务的全栈方案、以及最朴素的「三件套」方案。
最终我选择了 HTML5 + CSS3 + JavaScript 原生三件套,理由有三:
第一,交付与运行成本极低。 课程展示、Demo 演示、甚至直接发给朋友体验,只需要一个浏览器。没有 node_modules、没有打包步骤、没有环境变量,把文件丢进任何静态服务器就能跑,极大降低了「被别人打开」的门槛。
第二,内存与心智负担小。 对于一个功能边界清晰的单页应用,原生 JavaScript 完全驾驭得住。一个 config.js 管配置、一个 api.js 管网络、一个 app.js 管交互,模块职责一目了然,比引入虚拟 DOM 状态管理库更直接。
第三,更能体现「内功」。 流式解析、DOM 增量渲染、Canvas 绘图、localStorage 持久化,这些本该由框架「代劳」的事情,亲手实现一遍,对前端原理的理解会深一个台阶。这也是「码道」系列一贯坚持的实践精神——把每一层技术栈都走一遍、讲明白。
在大模型侧,我接入了 GitCode AI 平台提供的 DeepSeek 开放接口。它兼容 OpenAI 的 /v1/chat/completions 规范,支持 SSE 流式输出,模型能力对中文情感理解表现优秀,非常适合心理陪伴场景。
三、核心设计:让 AI 输出「可被前端消费」的 JSON
这是整个项目最关键的一步,也是我认为最值得拿出来分享的设计。
3.1 为什么不能直接让模型输出 JSON
很多人的第一反应是:让模型返回 JSON 不就完事了吗?直接要求「请以 JSON 格式返回」,前端 JSON.parse 不就好了?
但真实踩坑后你会发现这条路走不通。原因有二:
其一,大模型不是数据库。它的输出充满不确定性:可能多解释一句、可能用 Markdown 代码块包裹 JSON、可能字段名大小写不一致、可能在某次回答中完全忘记 JSON 要求。
其二,流式与 JSON 天然冲突。我们追求「打字机」般的流式体验,而 JSON 必须整体解析——HTTP 响应还没结束,JSON 就不完整,前端无法边收边渲染。如果为了完整 JSON 而牺牲流式体验,对话的「温度感」会大打折扣。
3.2 方案:双段式结构化模板
经过反复试验,我设计了一套「正文 + 数据」的双段式输出模板,用两对自定义标记框定语义:
[DIALOGUE]你的自然对话回复正文(200字以内,温暖、口语化、有共情)[/DIALOGUE]
[DATA]{"emotion":"焦虑","emotion_level":3,"advice":"睡前试试写下三件今天的小事,帮自己理一理思绪。","crisis":false,"tags":["失眠","压力大","自我成长"]}[/DATA]
这套模板的精妙之处在于:
- 正文在前、数据在后,符合自然语言习惯,流式阶段前端只需实时剥离
[DIALOGUE]标记即可边收边显示; - 前端检测到
[DATA]出现后,正文区域停止更新(因为后面是机器可读的 JSON),等流结束一次性解析; - 即使当次输出格式偶发异常,正文仍然完整可见,聊天体验不会被破坏——这是降级设计带来的韧性。
3.3 系统提示词的系统性编排
系统提示词被组织为四大块,每一块都用「规则式」语言写死,而不是「散文式」描述:
角色设定:定义「心屿」的人物形象——温柔、专业、可信赖的长程心理陪伴者,使命是建立长期信任关系,而非一次性解决所有问题。
交流原则:多倾听少打断、先共情再引导、每次回复包含一个开放式引导问题、适度追问既往倾诉内容以体现「记忆感」。
专业边界:明确自己是 AI 辅助工具,不做诊断、不开处方;检测到危机信号必须引导用户寻求专业援助。
输出格式:用「非常严格,必须遵守」强调模板纪律,逐字段解释 emotion、emotion_level、advice、crisis、tags 的含义与取值范围,并给出完整示例,让模型照着格式做少做错。
实践证明,DeepSeek 系列模型对中文指令遵循度极高,稳定输出这套模板的成功率接近百分之百。把「让前端好看地显示」这件事,从后端代码里完全转移给系统提示词去解决,是整个项目的杠杆点。
四、硬核改造:Python 参考代码到 JavaScript 的流式迁移
这是技术含量最高的部分。参考的 Python 示例采用 requests 库 + iter_lines() 逐行读取流式响应,并配合生成器 yield 逐条产出 JSON 块。把它迁移到浏览器端,需要依次解决四个层面的问题。
4.1 fetch 与可读流:最大的一次范式转换
Python 的 requests.post(..., stream=True) 是同步阻塞式的:代码按顺序一行行执行,网络数据到达时自动继续。而浏览器里的 fetch 是 Promise 异步的,响应体是一个 ReadableStream,必须通过 getReader() 获取读取器,再手动 read()。
const reader = resp.body.getReader();
const decoder = new TextDecoder("utf-8");
let buffer = "";
while (true) {
  const { done, value } = await reader.read();
  if (done) break;
  // value 是 Uint8Array,需要 TextDecoder 转为字符串
  buffer += decoder.decode(value, { stream: true });
  // 按行切分、逐行解析…
}
这里有个新手极容易踩的坑:Chunk 边界不等于行边界。SSE 的 data: 行可能被 TCP 分包拆成多个 chunk,一个 chunk 也可能包含多行。因此 buffer 策略必不可少——把当前残留(不完整的最后一行)暂存进 buffer,等下一个 chunk 到达后再拼接解析。TextDecoder 的 { stream: true } 参数同样关键,它告诉解码器「当前数据块可能不完整,请保留内部状态以便衔接下一块」。
4.2 content 的增量提取:可选链的优雅之处
每个 SSE 事件行的 payload 是一个完整的 JSON,形如:
{"id":"...","choices":[{"index":0,"delta":{"content":"你好"}}]}
前端真正关心的是 choices[0].delta.content。这里我使用可选链链式取值,优雅且安全:
const json = JSON.parse(data);
const delta = json.choices?.[0]?.delta?.content || "";
if (delta) onDelta(delta, fullText);
4.3 结束信号 [DONE] 的正确处理
Python 原版对结束信号的处理其实存在瑕疵:line.rstrip("/n") 本意是去除换行符,却写错了转义字符;data:[DONE] 的判定也略显冗余。在 JavaScript 版里,我把它修得干净利落:
const data = trimmed.slice(5).trim();
if (data === "[DONE"]) break; // 流结束
注意 [DONE] 行没有引号包裹,直接字符串比对即可。这里顺手修正了参考代码的一个隐藏 bug,也算「迁移必越级」的额外收获。
4.4 模板内容提取:正则的一锤定音
流结束后,通过两行正则把正文与 JSON 数据拆开:
function extractDialogue(fullText) {
  const m = fullText.match(/\[DIALOGUE\]([\s\S]*?)\[\/DIALOGUE\]/);
  return m ? m[1].trim() : fullText;
}

function extractMeta(fullText) {
  const m = fullText.match(/\[DATA\]([\s\S]*?)\[\/DATA\]/);
  return m ? JSON.parse(m[1]) : null;
}
[\s\S] 表示「任意字符含换行」,*? 是非贪婪匹配,保证只取第一对标记之间的内容。如此,流式收到的正文与结构化元数据便各归其位。
五、前端架构:三个文件管好一个应用
整个交互层由三个 JS 文件分层协作,遵循「配置—网络—视图」的清晰边界:
5.1 config.js —— 一切可配置
API 地址、密钥、模型名、温度、采样参数、系统提示词全部收拢于此。换密钥、换模型、调参数都只需改这一个文件,把「配置」和「逻辑」彻底解耦。系统提示词以数组逐行组织再 join("\n"),既便于阅读维护,也减少转义出错的可能。
5.2 api.js —— 纯网络层
对外只暴露四个函数:streamChat、extractDialogue、extractMeta、visibleSoFar。视图层完全不感知 SSE 细节,只需要把回调函数传给 streamChat,在 onDelta 里增量更新 DOM、在 onDone 里收尾渲染、在 onError 里兜底报错。这种「回调注入」模式让网络层可以独立于 DOM 进行单测——这也是我在联调时能快速定位问题的重要原因。
5.3 app.js —— 视图 + 本地数据
负责 DOM 渲染、localStorage 读写、Canvas 绘制。数据模型有三个:会话(session)、消息(message)、情绪记录(mood)。为了支持长程陪伴,每次请求会自动携带最近十条消息作为上下文:
function buildMessages(userText) {
  return [
    { role: "system", content: CONFIG.SYSTEM_PROMPT },
    ...history.map((m) => ({ role: m.role, content: m.content })),
    { role: "user", content: userText }
  ];
}
这让模型能够在多轮对话间「记住」用户之前倾诉的内容,真正体现陪伴的连续性。
六、情绪的「可视化」:让陪伴被看见
6.1 情绪卡片
流结束后,前端解析出 emotion、emotion_level、advice、tags,渲染成一张结构化的情绪卡片:左侧突出情感 emoji 与情绪标签,右侧显示 0~10 强度数值;一条彩色的情绪条直观呈现强度占比;下方是心理标签与一句轻柔建议。情绪色按强度分级映射——高愉悦绿、平静蓝、低落橙、忧惧红,让「情绪」一望即知。
6.2 情绪趋势折线图
长程陪伴的价值在于「回望」。我们把每一天内所有回复的情绪强度求平均,写入 localStorage,然后用原生 Canvas 绘制近 14 天的折线图:Y 轴为情绪强度 0~10,X 轴为日期,曲线下方做了由深到浅的渐变填充,最后一个数据点额外标注日期与数值。用户看着折线一天天延伸,会真切感受到「有人一直在记录我的心情」。
Canvas 绘图需要注意高分屏适配——先按 devicePixelRatio 放大画布物理像素,再通过 CSS 控制展示尺寸,避免线条发虚;同时不能忘记画布尺寸变化时(窗口 resize)重绘。
七、会话持久化与危机干预:长程陪伴的两块基石
7.1 会话历史
所有会话与消息存入 localStorage,页面刷新、关闭浏览器都不丢失。侧边栏提供「新建对话」「切换历史」「删除会话」三种操作,首次消息自动生成会话标题。受存储容量限制,我采用了「多会话 + 最近十条上下文」的策略:历史消息用于回看,对话模型只关注近十条,兼顾记忆效果与成本。
7.2 危机干预
心理陪伴类应用必须回答一个问题:如果用户表达出自伤、自残甚至自杀倾向怎么办?我在系统提示词中要求模型检测到危机信号时把 crisis 置为 true,并在正文中引导用户求助。前端收到 crisis: true 后,会渲染一张醒目的红色危机提示卡片,展示全国 24 小时心理援助热线、北京心理危机研究与干预中心电话,并郑重声明「AI 无法替代专业帮助」。同时在界面页脚常驻求助电话,把「安全底线」做在产品的最外层。
八、真实的排坑记录:三个让人抓狂的 Bug
这一节我必须坦白记录联调过程中真实的踩坑经历,它们比任何教科书都更有说服力。
Bug 1:data.choices 永远为空
现象:直接用 Node 脚本逐行解析流,内容一切正常;但通过 api.js 封装后,所有 delta 均为空,全文长度为 0。
定位:逐行对比后发现,我的 parseDelta 函数里写的是 data.choices?.[0]?.delta?.content,而 data 是 JSON.parse 之前的原始字符串——字符串没有 choices 属性!正确写法是先 JSON.parse(data) 再取值。
教训:看似无懈可击的可选链,在「对象还没解析成对象」时,恰恰会静默返回 undefined 而不报错,是所有「静默失败」里最隐蔽的一种。
Bug 2:API 返回「ai is not one of ['system','assistant','user',...]」
现象:浏览器端一发消息,模型直接返回 400,错误信息滚进气泡里。
定位:检查发送的 messages,发现角色名竟然是 ai!原来我在存储会话时,把模型回复的 role 记成了 ai,而 OpenAI 兼容接口只认 assistant。请求服务端在第一步就拒绝了整个对话。
教训:存储层的内部命名(ai/user)与接口层的协议命名(assistant/user)必须做好映射隔离,发送前统一转换。
Bug 3:新用户首屏「空白」
现象:截图测试发现首屏主聊天区一片空白,精心设计的欢迎语和快捷话题入口全都消失。
定位:renderChat() 里一句 chatEl.innerHTML = "",把同样挂在 #chat 容器内的空状态节点一起删掉了;后续的空状态开关只在内存里设置 style.display,对已移除的节点毫无作用。
教训:「清空容器」这类高破坏性操作,务必想清楚它会不会误伤容器内非数据性的静态/占位节点。
这三个 Bug 有一个共性:都不是语法错误,而是静默的逻辑错误。要不是我坚持用 Playwright 做了端到端浏览器自动化测试,光靠人眼很难在第一时间发现。这也让我更坚定地相信:真实项目的质量,是靠测试逼出来的,不是靠小心谨慎预防出来的。
九、测试策略:三层验证体系
本次开发我搭了三层验证,每一层解决不同的问题:
- 语法层:
node --check快速把三个 JS 文件过一遍,杜绝低级语法错误; - 接口层:Node 脚本直接调用真实 API,验证系统提示词能否产出可解析的
[DIALOGUE]+[DATA]结构——这一步在开发早期就确认了「模型行为符合预期」; - 浏览器层:借助 Playwright 驱动无头浏览器,模拟真实用户点击快捷话题、等待流式回复、断言情绪卡片与折线图出现、断言控制台零错误。
正是第三层测试,把所有潜藏的问题在交付前全部逼了出来。强烈建议任何做纯前端 AI 应用的同学,都加上一层「真实浏览器里跑一遍」的自动化验证。
特辑:一场真实对话的运行实录
为了让读者对「模型原始输出长什么样、前端又把它变成了什么样」有一个最直观的认识,这里附上一段我在联调时真实发生的完整对话记录。上方是用户发送的消息,中间是模型原始的流式输出(经过归一化整理为单段),下方是前端解析后的结构化呈现。
用户:「最近总是睡不好,晚上一躺下脑子里就乱糟糟的,很焦虑。」
模型原始输出(流式拼接归一):
[DIALOGUE]听起来最近睡眠成了一件让你很困扰的事,越是焦急地想睡着,思绪反而越活跃,这种"越想睡越清醒"的循环真的很折磨人。你已经很努力了,能愿意说出来,本身就值得被肯定。我想多了解一点:白天的时候,是不是有什么一直压在心里的事,哪怕是很小的一件,也可以和我说说。[/DIALOGUE]
[DATA]{"emotion":"焦虑","emotion_level":3,"advice":"睡前试试写下三件今天的小事,哪怕很琐碎,帮自己理一理思绪。","crisis":false,"tags":["失眠","压力大","自我成长"]}[/DATA]
前端渲染结果:
- AI 对话气泡:逐字流式显示正文,共情之后紧接一个开放式提问,标记与 JSON 符号零残留;
- 情绪卡片:emoji 😟、情绪「焦虑」、强度 3/10、橙色 30% 情绪条、「失眠/压力大/自我成长」三枚标签,以及建议「睡前试试写下三件今天的小事……」;
- 情绪趋势图:当天数据点落在 3.0 刻度并标注日期,曲线向前延伸一格;
- 会话列表:新增一条以用户首句关键词命名的会话记录,刷新不丢失。
值得强调的一点是:把「一行 JSON」变成「会说话的表情、一根橙色的情绪条、一枚枚小标签」的全部逻辑,其实只封装在前端十几行解析代码里;而「让模型愿意如此规整地吐字」这件事,则完全由系统提示词中的模板纪律完成。这正是结构化输出路线性价比最高的证明——模型负责生成数据的秩序,前端负责渲染数据的温度。
十、效果与体验
最终交付的应用,长这样:
- 进入首屏,是暖色调的空状态:一句「你好,我是心屿」、一段温柔的引导语,以及四个一键发起的话题入口;
- 点击任意话题,用户气泡出现在右侧,紧接着左侧的 AI 回复如打字机般逐字浮现;
- 回复结束后,一张情绪卡片平稳落出——焦虑、3/10、橙色情绪条、「失眠」「压力大」标签,以及一句轻轻的成长建议;
- 侧边栏的折线图上多了一个数据点,情绪被记入长程档案;
- 关掉浏览器、过一晚再打开,对话还在,昨天的心情曲线也还在。
视觉上,我选择了奶油白底色配护眼绿主色,大圆角、柔和阴影、克制留白,整套界面低刺激、暖人心,符合心理健康产品的调性;同时适配了移动端抽屉式菜单与系统暗色模式,尽力照顾不同使用场景。
十一、总结与展望
从最初的一个想法,到一套能跑的完整应用,「心屿」让我完整走过了「需求分析 → 系统提示词工程 → 流式协议改造 → 前端架构 → 可视化 → 测试排坑」的整个闭环。回望全程,最深的体会有三条:
第一,提示词也是代码。把 UI 渲染需要的数据结构写进系统提示词,用「模板纪律」约束大模型,是把 AI 能力工程化的最优雅方式。
第二,纯前端也能做出有深度的 AI 应用。只要对流、对状态、对存储有清晰认知,三件套足以承载一个完整的对话产品。
第三,测试是质量的下限。三层验证体系保证了交付时的稳定表现,也让我对每一个功能点都有底气。
未来,「心屿」还有很大的想象空间:把情绪趋势扩展为周报、月报;加入语音输入,让倾诉更自然;尝试接入本地向量库,做长期记忆的语义化检索;以及最重要的——在专业心理学从业者的指导下,持续校准回应策略,让它真正成为专业咨询的温柔前哨。
技术终会迭代,但「被理解」是每一个人的永恒需求。愿这个小小的项目,能在某个深夜,接住一个疲惫的灵魂。
本文为「码道」系列实践文章,项目代码已在 GitCode/AtomGit 开源,欢迎交流指正。

汇聚全球AI编程工具,助力开发者即刻编程。
更多推荐

 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)