
码道 · 你画我猜文字版 AI 对话:让 DeepSeek 用文字作画的纯前端小游戏开发全记录
码道 · 你画我猜文字版 AI 对话:让 DeepSeek 用文字作画的纯前端小游戏开发全记录
一、写在前面:一个"画不出来"的灵感
你有没有遇到过这样的场景:朋友聚会想玩"你画我猜",可总是凑不齐人手,或者画了半天的火柴人别人根本看不懂?我一直觉得,“画"这件事并不一定需要画笔和画布——好的文字描述,本身就能在脑海里"画出"一幅生动的画面。比如我说"它夏天在屋顶嗡嗡地转,给闷热的房间送来凉风”,你一定能猜到我说的是"电风扇"。
这个念头一直在我脑子里打转。直到我接触到了 gitcode 的 Chat Completions API,特别是 DeepSeek-V4-Flash 这个模型——它的中文理解能力、少样本的即兴创作能力和响应速度都很出色,让我意识到:也许我可以做一个完全用"文字"代替"画笔"的你画我猜游戏,让 AI 和玩家轮流扮演"画师"和"猜家"。
于是,就有了这个项目:「你画我猜 · 文字版 AI 对话」。这是一个纯前端(HTML5 + CSS3 + 原生 JavaScript)实现的小游戏,没有任何后端服务,没有数据库,没有构建工具,甚至连一个第三方库都没用。整个项目从设计、编码、测试到文档,全链路完成,本文就带你完整回顾这个项目的诞生过程,包括创意构思、架构设计、实现难点、踩坑记录和验收测试。
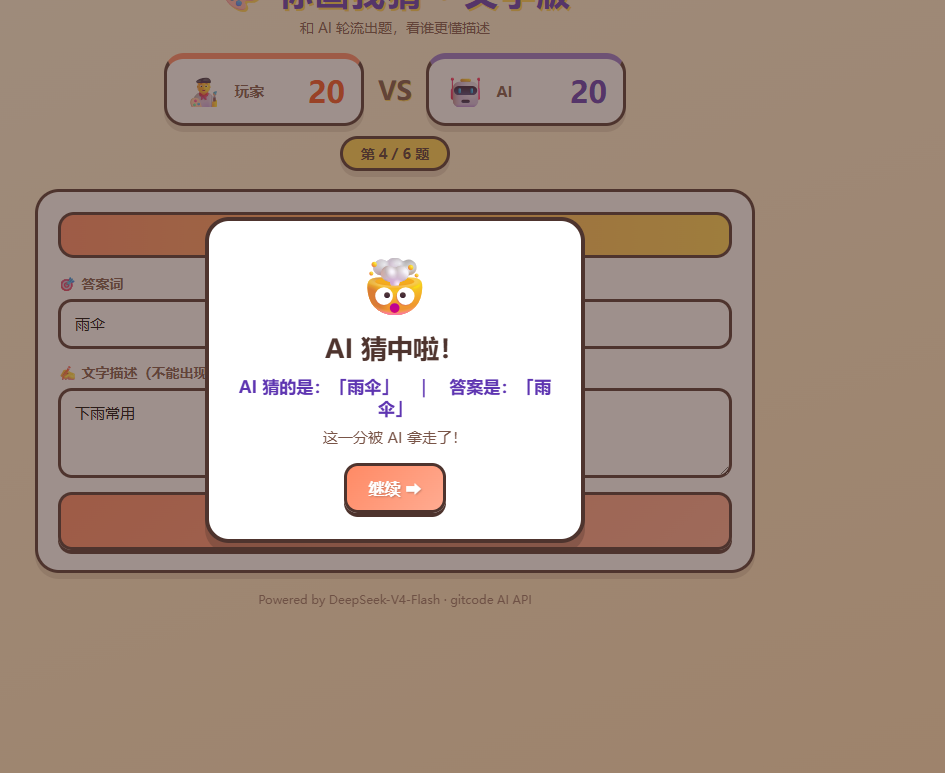
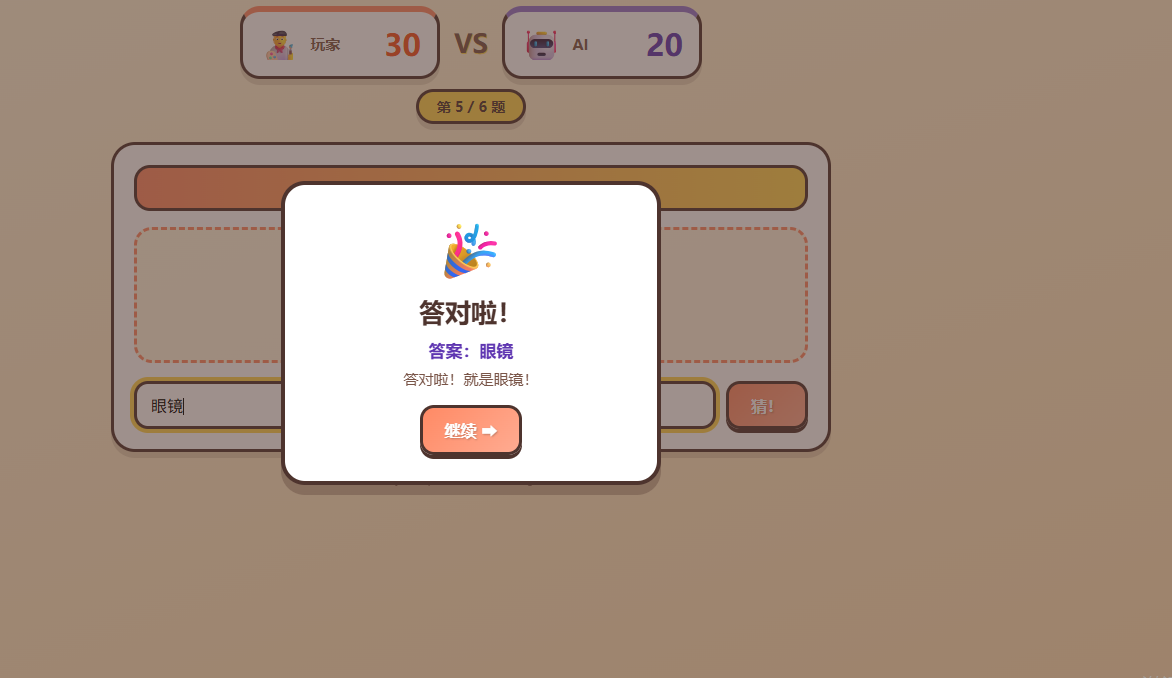
二、项目构想:我们到底要做一个什么样的游戏
在动手写代码之前,我首先把"这个游戏要玩什么"这件事想清楚。传统的你画我猜是:一个人在白板上画图,其他人根据画面猜答案。它的核心乐趣在于信息的不对称表达——画师拥有的信息(答案词)比猜家多,但他只能用一种"间接、易错"的方式(画面)去传递信息,猜家则需要从模糊的信号里还原出精确的答案。
当我把"画面"替换成"文字描述"时,这个游戏会变成:
- AI 出题、玩家猜:AI 随机选一个大众熟悉的中文名词(日常物品、动物、食物、地点、人物等),然后用 1-3 句生动的话进行"文字作画"。注意,描述里绝对不能出现答案词本身、它的同音字或直接同义词。玩家根据这段描述输入自己的猜测。
- 玩家出题、AI 猜:反过来,玩家填写"答案词"和"文字描述"两个输入框,AI 根据描述推断玩家最可能在描述哪个词,输出它唯一的最佳猜测。
一局游戏共 6 题,双方各出 3 题,交替进行。每题只有一次猜测机会,猜对得 10 分,猜错不得分。6 题结束后结算总分,分高者胜;平局则视为"势均力敌"。
这个设计有几个关键决策:
- 为什么是 6 题、各 3 题? 因为要保证公平公正。如果只让 AI 出题,AI 每次出的题难度可能不稳定;双方轮流出题,那么"谁更会出题、谁更会猜"都能得到检验,游戏的策略深度也就出来了——你可以故意出一些模棱两可的词来难倒 AI,反之亦然。
- 为什么只有一次猜测机会? 一次机会让每次出手都有分量,猜错了就要承担后果,这样游戏张力更强。如果允许无限次试错,游戏就失去了悬念。
- 为什么描述必须避开答案词? 这是整个游戏的灵魂约束。如果 AI 直接说"答案就是电风扇",那就不叫游戏了。系统提示词里对这种行为做了严格约定,后文会详细介绍。
想清楚这三点,游戏的规则闭环就成型了。接下来要考虑的是技术实现。
三、技术选型:为什么坚持"纯前端、零依赖"
这个项目我给自己定了几条非常"硬"的约束:
- 不引入任何第三方 JavaScript 库,包括 jQuery、React、Vue 等,全部使用原生 ES2020+ 语法。
- 不需要构建工具,没有 webpack、vite、babel,写完直接用浏览器打开就能跑。
- 不需要后端服务,AI 请求直接从浏览器发出。
有人可能会问:为什么不加一个后端来保护 API Key?为什么不用 Vite 来方便开发?我的考量是:
- 这是一个学习与展示型项目,我希望把"AI 能力如何被一个小游戏调用"这件事讲得尽可能透明。如果把请求都藏到后端,学习者反而看不到全貌。纯前端 + 静态托管,意味着任何会一点 HTML 的人都能 fork 一份、改一改配置、立刻玩起来,上手门槛最低。
- 零依赖意味着零供应链风险,也意味着项目"永不过期"——拉下来就能跑,不需要 npm install 半天。
- 现代浏览器原生能力已经非常强:
fetch发请求、ReadableStream解析 SSE 流、localStorage存储战绩、CSS Grid/Flex 做布局,这些完全够用。
当然,单独把 API Key 放在前端 js/config.js 里是一种"明知不可为而为之"的做法,存在真实的安全隐患(浏览器侧明文暴露)。这一点我在 README 和设计文档里都做了明确的风险提示,并给出两个规避建议:部署到不可信公共环境前必须更换自己的 Key;或者把 AI 请求迁移到服务端代理(比如用云函数做转发)。这是一个面向学习场景的取舍,而不是生产环境的稳妥方案,读者需要区分清楚。
四、架构设计:小而美的模块拆分
虽然项目很小,但我仍然按照"关注点分离"的原则拆成了四个 JS 模块,谁也不越界:
ruabjiansanbanzxh/
├── index.html          # 页面骨架(计分板 / 出题 / 答题 / 弹窗)
├── css/style.css       # 卡通游戏风样式
├── js/
│   ├── config.js       # API 端点、模型、密钥等全局配置
│   ├── api.js          # AI 请求封装:SSE 流式解析 + JSON 协议 + 失败重试
│   ├── game.js         # 游戏状态机:轮次 / 计分 / 胜负判定(纯逻辑)
│   └── ui.js           # 界面渲染与事件绑定
├── tests/
│   ├── game.test.mjs   # 状态机单元测试(node:test)
│   └── smoke.mjs       # AI 接口冒烟测试(真实调用 API)
└── docs/               # 设计文档与实现计划
这四个模块各自的职责边界非常清晰:
- config.js 管"配置":只负责暴露一个全局配置对象
window.GAME_CONFIG,里面是 API 地址、模型名、API Key、max_tokens、temperature、top_p、frequency_penalty、thinking_budget 等。想换模型、换 Key、调温度?只改这一个文件,一分钟搞定。 - game.js 管"规则":这是我最用心设计的一个模块。它包含游戏状态机——当前分数、当前轮次、当前阶段(AI 出题中/玩家出题中/已结束)、答案词、对局记录,以及一系列纯函数:
createState创建初始状态、currentTurn判断这轮轮到谁出题、addScore加分、nextRound推进轮次、result判定胜负。为什么坚持"纯函数 + 不碰 DOM"?因为这样逻辑才能脱离浏览器单独测试——我的单元测试就是通过 Node.js 直接加载game.js来跑的。 - api.js 管"通信":封装了所有 AI 交互,才是技术含量最高的模块——SSE 流式解析、结构化 JSON 提取、解析失败自动重试,下面会有专门章节展开讲。
- ui.js 管"展示":把 game.js 的状态渲染到 DOM,绑定各种事件,处理输入、等待态(按钮禁用 + loading 动画)、弹窗和错误 toast。它不关心 AI 是怎么工作的,只关心"拿到数据之后怎么画界面"。
数据流是这样的:
用户操作 -> ui.js 事件 -> game.js 变更状态 -> api.js 调用 AI -> stream 增量渲染
                                                    |
                                               返回完整 JSON -> game.js 更新分数 -> ui.js 重绘
单行道、无环、每个模块只做一件事。这个架构对后续的测试和排错帮助极大。比如后来我发现计分偶发错误,只要看 game.js 和它的单元测试,几秒钟就能定位问题,完全不用碰 UI 代码。
五、核心难点(一):如何让 AI"只输出 JSON"?
这是整个项目里最关键的工程问题。AI 模型的输出天然是不可控的,它可能:
- 在 JSON 前后加一些解释性文字,比如"好的,我来出题:{…}"
- 用 markdown 代码块包裹 JSON,比如
json {...} - 输出非法的 JSON(比如单引号、多了一个逗号、截断)
- 干脆输出一段散文
而我的前端需要 JSON.parse 之后才能渲染。如果不能稳定拿到合法 JSON,整个游戏就玩不下去。我的解法是双管齐下:
5.1 系统提示词的"暴力约束"
在三类系统提示词(draw / judge / guess)的最后,我都拼接了一段统一的"JSON 硬规则":
强制要求(必须严格遵守):
1. 只输出一个合法的 JSON 对象,禁止在 JSON 之前或之后输出任何文字、解释、标点或空格。
2. 禁止使用 markdown 代码块标记(如 ```json 或 ```)。
3. JSON 必须能被 JSON.parse 直接解析。
这段规则写在 system 角色里,权重最高,是约束 AI 行为的第一道防线。
5.2 解析策略的"宽容兜底"
即便有强提示词,AI 仍然可能不听话。所以解析侧我也做了容错处理:extractJSON 函数并不是直接对整个文本 JSON.parse,而是先找到文本中第一个 { 和最后一个 },把中间的片段取出来再解析。这样做的好处是:
- 即使 AI 在 JSON 前面写了一整段废话,或者用 markdown 代码块包裹,只要内容里存在一个完整的 JSON 对象,我就能提取出来。
- 大幅提高了解析成功率。
5.3 失败后的"纠正重试"
如果第一次解析仍然失败怎么办?我不会直接报错扔掉这轮,而是把一段纠正消息追加到对话历史里,再让 AI 重试一次:
“你刚才的输出无法解析为 JSON。请只输出一个符合系统要求的合法 JSON 对象,不要加任何解释文字、注释或代码块标记,确保 JSON.parse 可以直接解析。”
这其实是利用了对话模型"能听懂人话"的特点——告诉它错在哪、要什么,它大概率马上就能修正输出。两次都失败才抛错。实测下来,绝大多数情况下第一次就能拿到合法 JSON,兜底逻辑几乎不触发,但它保证了极端情况下的稳定性。
三种响应类型各自的 JSON 结构非常简洁:
| 场景 | 返回 JSON | 说明 |
|---|---|---|
| AI 出题 | {"type":"draw","word":"答案词","description":"文字描述"} | description 不含答案词 |
| 判定答案 | {"type":"judge","correct":true,"reply":"反馈语"} | correct 为布尔值 |
| AI 猜词 | {"type":"guess","guess":"AI 猜的词"} | 前端本地比对命中 |
六、核心难点(二):SSE 流式响应的浏览器端解析
DeepSeek-V4-Flash 的 Chat Completions 接口在 stream: true 时返回的是 SSE(Server-Sent Events) 格式:服务器把响应切成很多个小块,每块形如:
data: {"choices":[{"delta":{"content":"一段"} }]}

data: [DONE]
注意,SSE 的每一块之间是用换行分隔的,但流式传输时一个完整的 JSON 可能会被 TCP 层切成两半,出现在两次 reader.read() 的返回值里。如果处理不当,就会出现"JSON 被截断、解析失败"的问题,或者"一次 read 里可能有多个 data 块"导致漏掉内容。
学过 Python 的同学可能对 iter_lines 很熟悉,但浏览器环境的 fetch 用的是 ReadableStream,没有现成的 iter_lines。我的处理思路是手动维护一个 buffer(缓冲区):
- 每次
reader.read()拿到一段Uint8Array,用TextDecoder解码后追加到 buffer。 - 用
buffer.split('\n')按行切分:最后一段可能是不完整的行(SSE 的一行还没传完),先 pop 出来留在 buffer 里;其余的行直接处理。 - 对每一行,检查是否以
data:开头,是则剥掉前缀拿到 payload。 - 如果是
[DONE]标记,说明流结束了,返回已经累积的全部文本。 - 否则尝试
JSON.parse(payload),解析成功就取choices[0].delta.content累积起来。
这个"缓冲区留尾巴"的技巧是流式解析的关键,它保证无论网络怎么切分数据,拼出来的完整文本都不会缺字或者多出半个 JSON。
七、核心难点(三):游戏状态机与纯逻辑可测化
游戏规则看起来简单(6 题、轮流出题、每题得分),但如果不做设计,很容易在 ui.js 里写出一堆互相纠缠的 if…else。我把所有规则收敛进 game.js 的状态机:
- 状态:玩家分、AI 分、当前轮次(1-6)、阶段(‘ai_draw’ | ‘player_draw’ | ‘finished’)、当前答案词、对局记录。
- 轮次与阶段的换算关系:
currentTurn用round % 2 === 1 ? 'ai' : 'player'判断,即单数轮 AI 出题、双数轮玩家出题;nextRound在轮次到达 6 之后把阶段置为 ‘finished’。
为什么我把这些写成"纯函数"而不是直接在 UI 事件里增删分数?因为纯逻辑才是最容易出错、也最适合自动化测试的部分。我给 game.js 配了 5 个单元测试用例:
- 初始状态:分数为 0、首轮为 AI 出题;
- 单数轮 AI 出题、双数轮玩家出题(连做 3 次 nextRound 验证轮换);
- addScore 正确累计(玩家加 20、AI 加 10);
- 6 轮后进入终局;
- 胜负判定 win / lose / draw 三分支。
这些测试用的是 Node.js 内置的 node:test 运行器,不需要装任何测试框架:
node --test tests/game.test.mjs
有这套测试兜底,我对游戏逻辑的正确性非常有信心——它比在浏览器里手动点一百次可靠多了,改代码的时候也能立刻知道有没有改坏。
八、UI 设计:暖色撞色的卡通游戏风
游戏要好玩,视觉是加分项。我在设计文档里给视觉风格定下的关键词是:卡通、撞色、圆润、活泼。
- 配色:暖黄
#FFD54F、橙#FF8A65、紫#9575CD,米白背景、深棕文字。这种高饱和但柔和的暖色组合,视觉亲和力强,天然带"游戏感"。 - 布局:计分板双阵营卡片(玩家 VS AI)实时更新,顶部回合横幅显示"第 X / 6 题",中间是主交互面板。
- 状态表达:AI 思考时显示三个跳动的小圆点动画 + “AI 正在思考…”,按钮进入禁用态防止重复提交;答案揭晓有弹窗;错误有 toast 提示。
- 响应式:CSS 用了相对单位和灵活的布局,手机竖屏、桌面宽屏都能流畅游玩。
关于"玩家出题轮"和"AI 出题轮"的界面差异,我做了很细致的区分:AI 出题轮只展示 AI 的文字描述和一个输入框,让玩家专心猜;玩家出题轮则显示"答案词"+“文字描述"两个输入框,并友情提示"描述不能出现答案词哦”。这种"每轮只给必要信息"的设计,能让玩家的注意力始终放在当前任务上。
另外我还在 HTML 头部做了一个 SVG favicon(一个 🎨 emoji),让浏览器标签页也能一眼认出这是游戏页面,细节之处见心思。
九、测试策略:单元测试 + 冒烟测试双保险
一个没有测试的项目是不完整的。针对纯前端项目,我设计了两个层次的自动化测试:
第一层:状态机单元测试(不依赖网络)
如上所述,node --test tests/game.test.mjs 针对计分、轮换、终局、胜负判定跑 5 个用例。测试通过 eval(readFileSync('./js/game.js')) 的方式加载浏览器写法(IIFE + window 赋值)的 game.js,非常轻巧。
第二层:AI 接口冒烟测试(真实调用 API)
node tests/smoke.mjs 会把三类请求真实地打到 API 上验证协议正确性:
- draw:AI 出题,断言返回的 word 非空、description 非空,且 description 里不能包含答案词(这是游戏的核心约束,必须自动验证);
- judge:先用"答案词当猜测"验证答对场景
correct === true,再用"月亮 vs 冰箱"验证答错场景correct === false,同时还断言答错时 reply 里不能泄露答案词; - guess:给 AI 一段"会发光的圆形灯、夜空中、阴历十五最圆"的描述,看它能不能猜出"月亮"。
为什么要做冒烟测试?因为提示词写得再好,也得用真实模型跑一遍才知道行不行。比如"description 不得包含答案词"这条约束,如果提示词写得不够强硬,AI 偶尔会犯规,冒烟测试立刻就能抓出来。整个冒烟测试跑一遍只要十几秒,消耗的 API 额度也很少,非常适合作为交付前的验收测试。
十、踩坑记录与工程决策复盘
这个项目虽然小,但开发过程中踩了不少坑,也有几个值得记录的工程决策,拿出来分享给后来者:
坑 1:SSE 数据被 TCP 拆包导致 JSON 截断
最初版本我没用 buffer 留尾巴的策略,直接对每次 chunk 做解析,结果发现经常拿到半个 JSON。后来改成"split(‘\n’) + buffer 留尾"方案,问题彻底解决。这个坑是流式解析的"必然课程",值得被记录下来。
坑 2:AI 偶尔输出 markdown 代码块
即使系统提示词明令禁止,偶尔还是有输出包了 ```json 的情况。双保险的 extractJSON(截取首 { 到末 })完美解决。
坑 3:AI 描述里泄露答案词
深究起来,“描述中不能出现答案词"其实是个挺考验模型的约束,尤其是当词本身很常见时(比如"雨伞”),模型很容易顺嘴说出来。我的处理策略是:不在前端强行拦截,而是容忍它——因为即使描述里不小心出现了答案词,最终判定环节还会由 AI 自己裁决对错,而且这属于"出题方失误",责任在出题方,反而成了游戏的一部分。当然,冒烟测试会对这一点做监控报警。
决策 1:API Key 前端明文暴露
这是纯前端 + 直连模型的必然代价。我在 README 和设计文档里都做了明确提示,并给出服务端代理的迁移建议。对于学习型项目这是可接受的,但任何打算部署到公共环境的人都应该意识到这个风险。
决策 2:localStorage 存战绩
没有后端,历史战绩怎么办?用浏览器自带的 localStorage 就够了。每次对局结束自动保存一条记录(比分、胜负),下次打开还能看到,零成本实现"历史战绩"功能。这是"没有后端也能做产品"的典型思路。
决策 3:判定环节交给 AI
谁来判定"玩家猜对了没有"?最初想过让前端做字符串比对,后来发现中文游戏的判定看似简单实则微妙——"雨伞"和"一把雨伞"算不算猜中?“风扇"和"电风扇"呢?单纯字符串包含关系太死板,很容易误判。最后我决定让 AI 来判定(完全一致、包含关系或明显同义均可视为命中),judge 的 reply 还可以顺带生成活泼的反馈语,一举两得。而"AI 猜玩家出的词"时则反过来用前端本地比对,因为这里需要的是"严格命中才算 AI 得分”,规则要尽可能客观。两个方向用两种判定策略,是经过测试验证后定下来的。
十一、交付与验收
项目完成后,我按设计文档里的验收标准逐条核对:
- ✅ 双击打开 index.html(或通过
python3 -m http.server 8080本地起服)可以完整玩一整局; - ✅ 6 题一局、双方各 3 题、交替出题、每题 10 分,计分正确;
- ✅ AI 三种返回类型(draw/judge/guess)均被正确解析渲染;
- ✅ 答案揭晓弹窗、胜负结算弹窗、再来一局功能正常;
- ✅ 战绩自动存入 localStorage,刷新页面不丢失;
- ✅ 单测 5 个用例全绿;冒烟测试 draw/judge/guess 全部通过;
- ✅ README 说明玩法、配置、测试与部署方式。
整个项目被推送到 AtomGit 的 main 分支,成为一个"拉下来就能玩、改改配置就能跑"的完整交付物。
十二、写在最后:下一步还能做什么
这个项目的完成只是一个起点,我心里已经列了一张改进清单:
- 难度分档:支持"简单词 / 普通词 / 偏门词"三档出题难度,让不同水平的玩家都能玩得尽兴;
- 计时机制:给每轮加一个倒计时,猜得越快加分越多,增加紧张感;
- 服务端代理:把 AI 请求迁到云函数做转发,解决 API Key 暴露问题,顺便增加日志和限流;
- 排行榜:把 localStorage 战绩升级为简单的前后端排行(需要一个轻量后端);
- 多语言:模型本身支持多语言,把提示词抽成 i18n 配置即可支持英文对局;
- 真实画板:在保留文字版的同时,增加"AI 看图猜词"模式,端到端玩转多模态。
如果这个项目给了你一点启发,欢迎 fork 下来自己玩玩;也可以把它当作一个"如何使用大模型 API 写一个可玩应用"的最小范例,看看我是如何用系统提示词约束模型输出、用容错解析对抗不确定性、用纯函数设计可测试的核心逻辑的。
项目地址:https://atomgit.com/gcw_QIuQeGVj/ruabjiansanbanzxh
最后想说:AI 时代,人人都可以做自己的小产品。一个灵感 + 一个好用的模型 API + 一点工程上的较真,就能把一个"画不出来"的创意,变成一个能真正玩起来的游戏。码道漫漫,愿你我都能在写代码这条路上,保持好奇,持续创作。

汇聚全球AI编程工具,助力开发者即刻编程。
更多推荐

 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)