
Day55|从0学习 Claude Code(五):我给 Agent 发了张工单,它干活终于不跑偏了
苦猿的大模型日记 · Day55 · 从0学习Claude Code(五)TodoWrite-帮普通人把AI学进简历系列
前言:第五篇,给 Agent 发一张"工单"
上一篇,咱们给循环装上了挂钩:日志、权限、自动收尾、会话统计,全挂在外面,循环本体一行没动。加功能从"开胸手术"变成了"往墙上挂东西"。到这,这个 Agent 看起来已经挺像样了:会干活(五个工具)、有分寸(门禁)、可扩展(挂钩)。
但有个问题,从第一篇憋到现在,我一直没敢碰:这货干活,没有计划。
给它一个多步任务,它一上来就闷头写。写两步,跑个测试,蹦出个报错,它去修报错,修着修着——它忘了自己最开始是要干嘛的了。你盯着终端能明显感觉到那个瞬间:刚才还目标明确的一个人,忽然开始即兴发挥。
工具没问题,权限没问题,挂钩也没问题。问题出在一个更隐蔽的地方:执行到一半的时候,目标不在它的视野里了。
这一篇就干一件事:给 Agent 发一张工单——一个叫 todo_write 的工具。动手之前先列清单,做一项勾一项,清单本身回流进上下文,让"我在哪、我该干嘛"变成它随时看得见的东西。
读完你会拿到三样东西:
- TodoManager 的完整实现:一块带状态机的白板,外加三条专治"清单走样"的校验规则
- 一个反直觉的设计洞察:这个工具不给 Agent 增加任何执行能力——它连一个字节都不读写,它增加的是规划状态
- 本篇的高潮:reminder 机制——模型列完清单就扔在一边不更新?harness 会主动戳它一下;以及一个"连戳带勾"的十步任务实录
门槛不变:会 Python 基础语法、有上一篇跑通的那份带挂钩的代码。直接开始。
PART 01:案发现场——做到第四步,它忘了自己是来干嘛的
先复原现场。我给上一版的 Agent 出过一道题,这道题出自源仓库的教程,堪称"注意力测试"的经典款:
把所有 Python 文件改成 snake_case 命名,然后跑测试,修好失败的。
任务本身不难,拆开就三步:重命名、跑测试、修失败。任何一个实习生拿到这张工单,都会先在纸上写下这三行。
但模型的实际表现是这样的。开局其实很正常,甚至可以说漂亮:
> glob("**/*.py")
> bash("git mv HelloWorld.py hello_world.py")
> bash("git mv UserData.py user_data.py")
> bash("python -m pytest")
有条有理:找文件、改命名、跑测试。然后测试蹦出 2 个失败,画风开始变了:
> bash("python -m pytest tests/test_user_data.py")
> read_file("tests/test_user_data.py")
> edit_file("src/user_data.py", ...)
> edit_file("src/user_data.py", ...)   # 修第 1 个失败,顺手重构了一段
> bash("python -m pytest")             # 重构引入了新问题
> edit_file("src/helpers.py", ...)     # 去处理新问题
看到问题了吗?从第 5 行开始,它在响应报错,而不是在执行任务。每一条新命令的动机都是上一条命令的输出,像多米诺骨牌一样一张推一张——而"把所有文件改成 snake_case"这个最初的目标,不在任何一张牌上。
最后它跟我说"任务完成"的时候,项目里还躺着 4 个没改名的文件。它不装傻,也不偷懒,它就是纯粹地、诚恳地——忘了。因为它此刻的注意力里,确实没有什么没完成的事。
后面的文件没有重命名。它不装傻,也不偷懒,它就是纯粹地、诚恳地——忘了。最后它跟我说"任务完成"的时候,语气特别坦然,因为它此刻的注意力里,确实没有什么没完成的事。
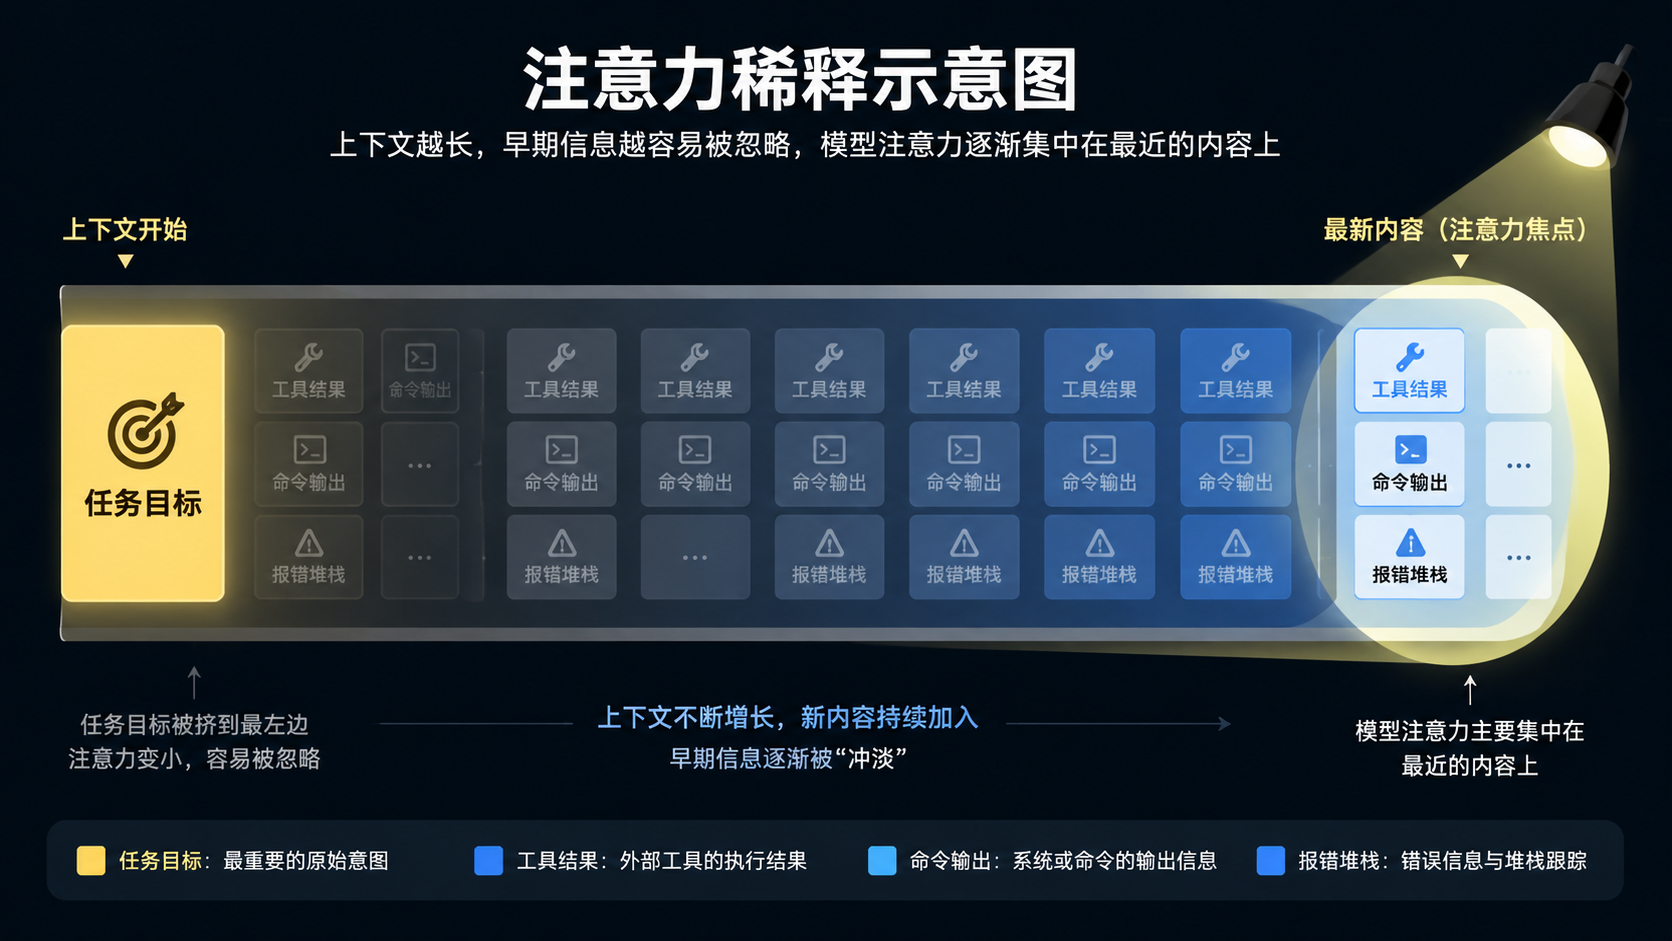
注意,这个跑偏过程里没有任何一步是错的。跑测试是对的,修失败也是对的——单看每一轮,它的决策都合理。灾难是连续性造成的:一步合理的响应接着一步合理的响应,走着走着就走到了任务外面。
为什么会这样?得从这个"脑子"的物理结构说起。
模型的注意力,天然偏向最近的内容。对话每多一轮,工具结果就往上下文里灌一大块新东西——文件内容、命令输出、报错堆栈,每一样都又长又吵。而任务目标呢,是开头那一小段话,离最新的 token 越来越远,影响力被一步步稀释。
一个十步的任务,做完 1-3 步之后,4-10 步就已经被挤出注意力中心了。它不是态度差,是记忆的物理结构就这样:每次只盯着最近的东西看。
这事人也一样。让你边接电话边找文件边回消息,十分钟后你也会忘了最初要干嘛——所以人才发明了便利贴、待办清单、工单系统。你的记忆没变,只是目标被写到了一个你随时看得见的地方。
给 Agent 也发一张,就是这一篇全部的活。
PART 02:TodoManager——一块会自己画勾的白板
先看数据结构。整个方案的核心就一个类,持有内存里的一张清单:
class TodoManager:
    def __init__(self):
        self.items: list[dict] = []

    def update(self, todos: list | str) -> str:
        validated = []
        # ...校验,下面细讲...
        self.items = validated
        return self.render()

    def render(self) -> str:
        if not self.items:
            return "No todos."
        lines = []
        for todo in self.items:
            marker = {
                "pending":     "[ ]",
                "in_progress": "[>]",
                "completed":   "[x]",
            }[todo["status"]]
            lines.append(f"{marker} {todo['content']}")
        done = sum(t["status"] == "completed" for t in self.items)
        lines.append(f"\n({done}/{len(self.items)} completed)")
        return "\n".join(lines)

TODO = TodoManager()
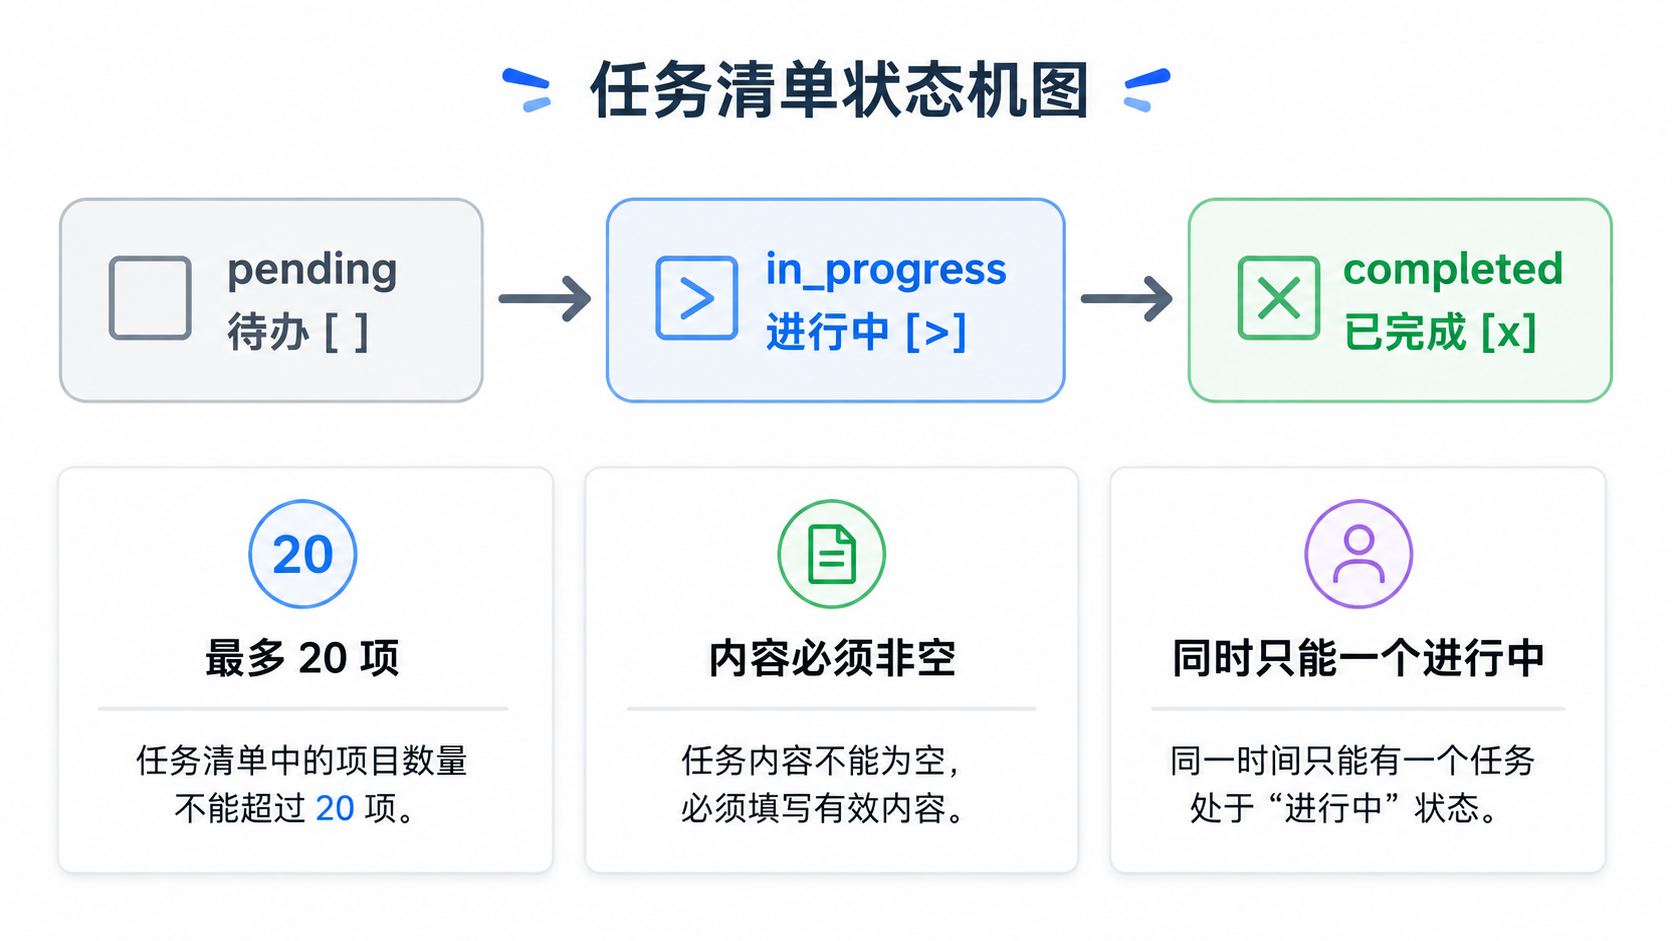
每项就两个键:content(干什么)和 status(什么状态)。状态是个三档状态机:
[ ]pending——还没动工[>]in_progress——正在干[x]completed——干完了
渲染出来长这样,一张人话写的进度表:
[ ] Rename hello.py to snake_case
[>] Run tests
[x] Read existing files
(1/3 completed)
末尾那个 (1/3 completed) 是点睛之笔——进度条。模型每次更新清单,都会看见自己走到哪了。
但真正值钱的是 update() 里的三条校验。每一条都在治一种真实的"清单病":
第一条:最多 20 项。
if len(todos) > 20:
    raise ValueError("Max 20 todos allowed")
清单太长等于没有清单。20 项排开,注意力又被稀释回 PART 01 的老问题。撞到上限,说明这个任务本身太大了,该拆任务,而不是硬塞——这个边界我们在下一篇会真正用上,先埋个伏笔。
第二条:content 必须非空。
content = str(todo.get("content", "")).strip()
if not content:
    raise ValueError(f"todos[{index}] requires content")
空项是自欺欺人的清单。"待办:干点啥"这种条目,列了等于没列,还占用了注意力。要么写清楚,要么别写。
第三条,也是我觉得最妙的一条:同一时间,只允许一个 in_progress。
if in_progress > 1:
    raise ValueError("Only one todo can be in_progress at a time")
这条在治什么?治"全都开着头,全都没收尾"。模型特别容易犯这个病:干着 A 想起 B,把 B 也标成进行中,干着 B 又觉得 C 急,C 也开着——最后一张清单上五六个 [>],跟没标一样。强制单线程推进,每一时刻"正在干什么"有且只有一个答案。
还有一个细节值得单独说:update() 的入参类型是 list | str。模型调工具时传参数,可能规规矩矩传 JSON 数组,也可能手滑传个 JSON 字符串,甚至传个 Python 列表的字符串表示。代码的处理是先 json.loads,失败再 ast.literal_eval:
if isinstance(todos, str):
    try:
        todos = json.loads(todos)
    except json.JSONDecodeError:
        try:
            todos = ast.literal_eval(todos)
        except (SyntaxError, ValueError) as e:
            raise ValueError("todos must be a list or JSON array string") from e
注意用的是 ast.literal_eval,坚决不用 eval——后者会执行任意代码,模型传进来一句 "__import__('os').system('rm -rf /')",你的机器就没了。上一篇装好的门禁管的是工具调用,管不到你在 handler 里手贱写的 eval。安全这根弦,每一行都得绷着。
最后,最关键的一步藏在返回值里:update() 返回的是 render() 之后的清单文本。这个文本会作为 tool_result 回流进上下文——
模型每勾一项,就重新看见一遍整张清单。这就是"看得见"的全部秘密,没有魔法。
PART 03:todo_write 上岗——一个"什么都不干"的工具
工具有了,挂上工具箱。第六个工具,定义照旧走 schema:
{"name": "todo_write",
 "description": "Create and manage a task list for your current coding session.",
 "input_schema": {"type": "object", "properties": {"todos": {
     "type": "array", "maxItems": 20, "items": {
         "type": "object", "properties": {
             "content": {"type": "string", "minLength": 1},
             "status": {"type": "string",
                        "enum": ["pending", "in_progress", "completed"]}},
         "required": ["content", "status"]}}},
     "required": ["todos"]}}

TOOL_HANDLERS["todo_write"] = run_todo_write
handler 本体短得有点寒酸:
def run_todo_write(todos: list | str) -> str:
    try:
        output = TODO.update(todos)
    except ValueError as e:
        return f"Error: {e}"
    print(f"\n\033[33m## Current Tasks\033[0m\n{output}")
    return output
四行:更新清单,往终端打一份黄色的"Current Tasks"面板(给人看的),返回清单文本(给模型看的)。
现在停下来看一件事,这是本篇最反直觉的地方。
盘点一下这六个工具的"产出":bash 执行命令,read_file 读文件,write_file 写文件,edit_file 改文件,glob 找文件——每一个都在改变外部世界。而 todo_write 呢?
它不读写任何文件,不执行任何命令,不产出任何外部结果。调用它一千次,你的硬盘上一个字节都不会变。
那它干了什么?它唯一的作用,是改变模型自己能看到的世界。清单每次更新,render() 的结果回流进上下文,下一轮思考时,模型眼前的世界里就有一张最新的进度表。
bash 是手,read_file 是眼,todo_write 是——一块贴在显示器边上的便利贴。
分发路径上零新意,这正是好事:还是 TOOL_HANDLERS[block.name] 查表那老一套,上一篇的挂钩照常在它身上跑——权限 hook 检查它,日志 hook 记录它,一个不少。新器官长在旧骨架上,心脏又是一行没动,这已经是第三次验证那条架构原则了。
还差最后一块:引导。工具挂上了,得告诉模型"有这玩意,记得用"。SYSTEM 提示加了一句:
SYSTEM = (
    f"You are a coding agent at {WORKDIR}. "
    "Before starting any multi-step task, use todo_write to plan your steps. "
    "Update status as you go."
)
"多步任务,先列清单;随做随更新。"工具给能力,提示给习惯,两手都要有。
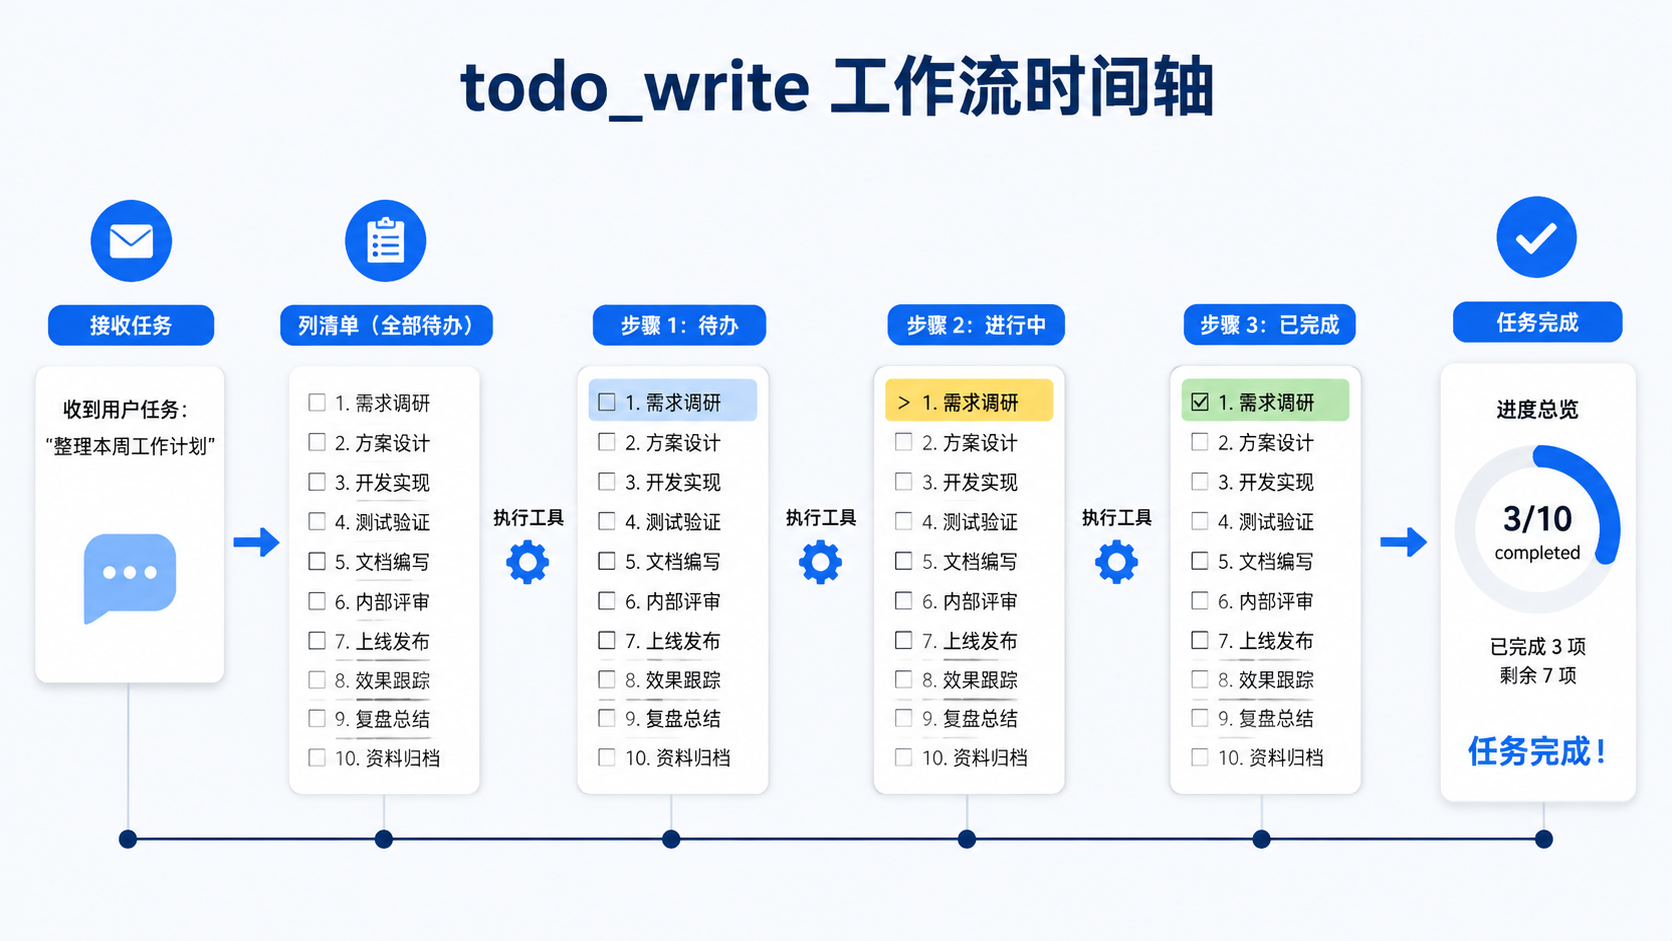
至此全套齐活。模型接到任务后的标准动作变成:先 todo_write 列出所有步骤(全 pending)→ 动手前把某项标成 in_progress → 做完标 completed → 看下一个 pending → 继续。每勾一项,整张清单重刷一遍。
听起来很美。跑起来,就知道哪里会掉链子了。
PART 04:跑起来——清单会变成摆设,所以要有监工
拿源仓库自带的练习题开跑:重构 hello.py,加类型注解、docstring、main guard。
模型的第一个动作,terminal 里先是那个黄色面板亮起来:
## Current Tasks
[ ] Add type hints to hello.py
[ ] Add docstrings
[ ] Add main guard
(0/3 completed)
它先列了清单,再动的手。然后读文件、标 in_progress、改代码、标 completed——三项全勾完,收工。小任务上,整个流程丝滑得像个真正的工程师。
但我很快就撞见了预想中的问题。换个十步的大点的任务,模型列完清单、干完前两步之后——它就把清单忘了。后面的八步一路闷头冲,清单停在 (2/10 completed) 纹丝不动,直到最后跟我说"做完了"。
注意,这比"没有清单"更具有欺骗性:它看起来有计划,实际上那份计划早就死在第三步了。计划和执行脱节,等于给自己发了张免检通行证——"我有清单"这个事实本身,反而成了它不再看清单的理由。
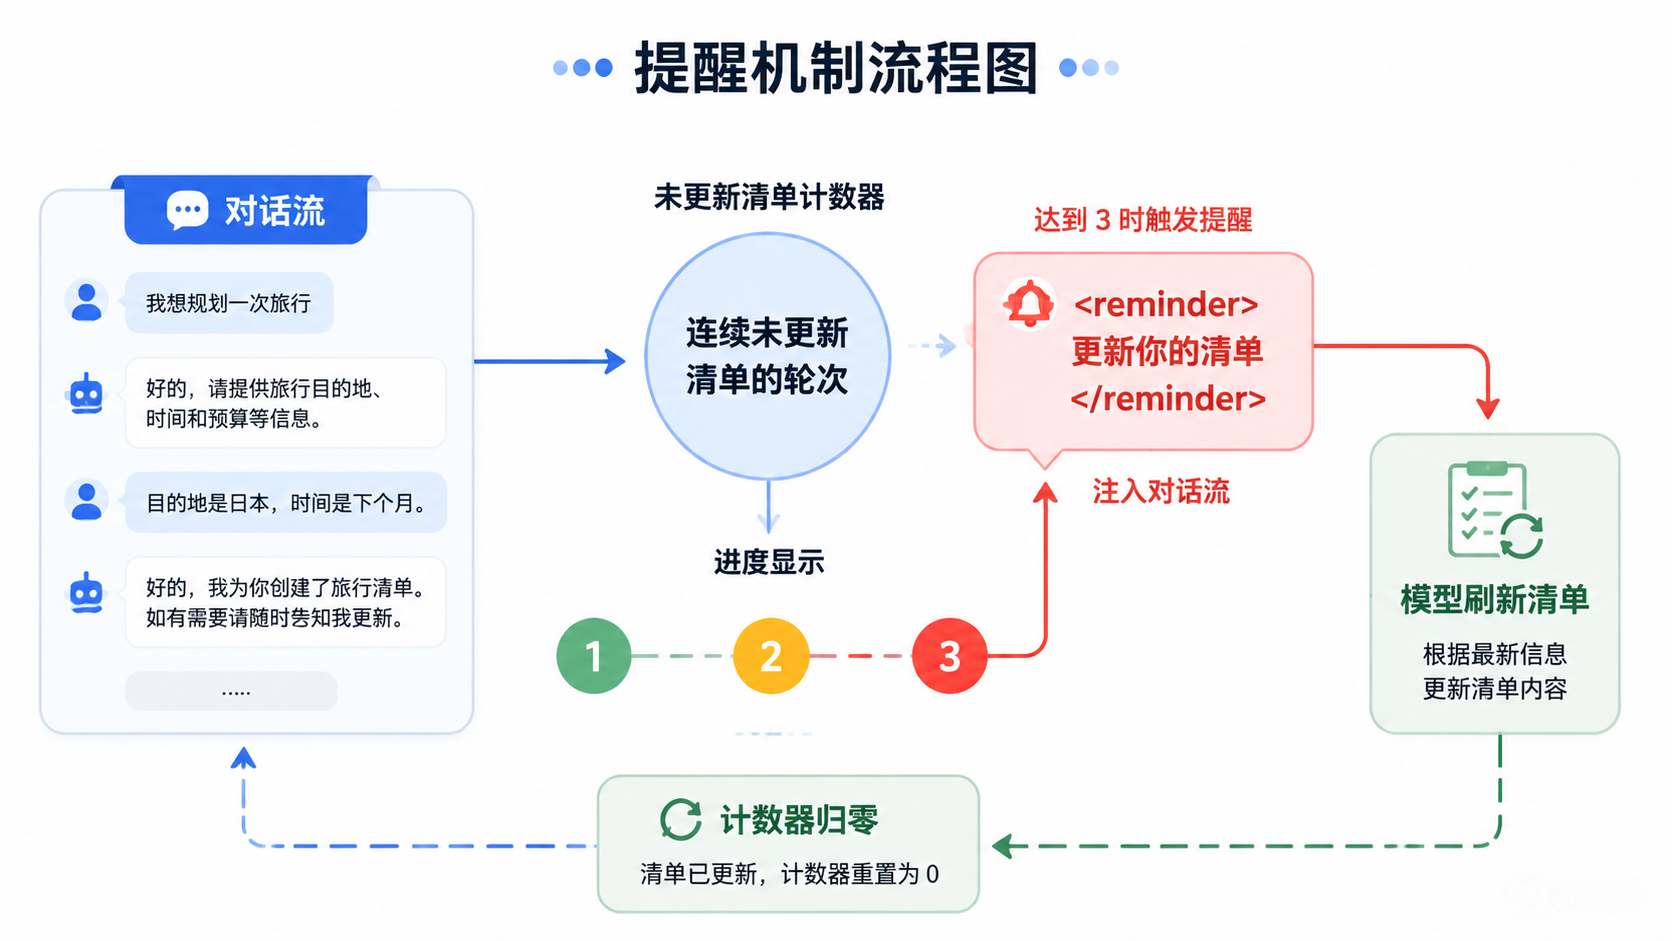
治这个病,靠模型自觉是没戏的,得靠 harness 出手。这就是本篇的高潮:reminder 机制。
rounds_since_todo = 0

# ...在 agent_loop 的每轮工具执行之后:
used_todo = any(b.name == "todo_write" for b in tool_calls)

rounds_since_todo = 0 if used_todo else rounds_since_todo + 1
if rounds_since_todo >= 3:
    results.append({"type": "text",
                    "text": "<reminder>Update your todos.</reminder>"})
    rounds_since_todo = 0
逻辑一句话讲完:一个计数器盯着每一轮工具调用——这轮碰过 todo_write,计数归零;没碰,计数 +1;连续三轮没更新清单,就在工具结果末尾追加一条提醒:<reminder>Update your todos.</reminder>,然后计数清零,重新开始盯。
再跑一遍那个十步任务,效果立竿见影。终端实录节选:
[>] Step 3: refactor parser module        # 计划停在第 3 步
> edit_file("src/parser.py", ...)
> bash("python -m pytest src/tests/")
> read_file("src/parser.py")              # 第 3 轮没碰 todo_write

## Current Tasks                          # 模型被戳醒,主动刷清单
[x] Step 1: scan codebase
[x] Step 2: write test harness
[>] Step 3: refactor parser module
[ ] Step 4: update call sites
...
(2/10 completed)
中间那个空行就是 reminder 落下的位置:模型闷头连干三轮,第四轮收到的工具结果末尾多了一行提醒——它"愣"了一下,下一轮老老实实调 todo_write,把清单刷到最新,计数器归零,继续干活。之后每隔三轮没更新,就会被这么戳一下。
而且你会观察到一个微妙的行为变化:被戳过几次之后,模型开始抢在提醒前头主动更新清单——干完一步就顺手勾一项。提醒从"被动挨戳"变成了"主动汇报"。这没有任何额外代码,纯粹是那句 reminder 在上下文里积累出来的习惯。
品味一下这个设计的站位。它没改模型,没加提示词,甚至没动任何工具——它只是往输入里塞了一句话。
上一篇讲 Stop hook 时说过一句话:拒绝也是一种输入。今天这条是它的姊妹篇:提醒,也是一种输入。你不需要重新训练模型、不需要改系统提示,在合适的时机往它的世界里放一句合适的话,行为就拐弯了。驯 Agent 的把手,从来都在输入侧。
两种失败模式,现在都有解了:没有清单,它会忘了目标——todo_write 治;有了清单不更新,它会骗自己——reminder 治。
PART 05:你天天见的那个勾选清单,底层就是这套
把我们的复刻和真实 Claude Code 对一下表,你会发现这次的映射近得有点过分。
TodoWrite 是真实存在的内置工具。你在 Claude Code 里干复杂任务时看到的那个任务清单——就是它。状态也一模一样:pending、in_progress、completed 三档,一次更新整张清单。
清单回流上下文,机制相同。每次打勾,都是一次真实的工具调用,工具结果里带着渲染后的最新清单,进上下文,模型下一轮看得见。你在界面上看到的打勾动画不是 UI 装饰——每一次打勾,都是模型在主动更新自己看得见的世界。
真实系统也有监工。Claude Code 同样会在模型忘了更新清单时,通过系统提醒催它——你偶尔会在输出里看到类似"You have unfinished todos"的提示,那就是它的 reminder 在戳。
边界也一致:清单太长会被建议拆分任务,同一时间只该有一个进行中——我们那三条校验的产品化版本。
还有一个真实系统里的细节,值得你亲手验证:Claude Code 并不是每次都掏清单。问它一句简单问题、改一行代码,它不会先列个三项清单再动手——简单任务直接干,复杂任务才开工单。判断"这个任务配不配一张清单",本身就是模型根据任务规模做的决策。我们的复刻版靠 SYSTEM 提示里那句"multi-step task"引导这个分寸,真实产品把这个分寸也打磨得更细。
顺便说个使用体感:清单还是你判断"这活还能不能交给它"的仪表盘。(3/10 completed) 停在原地五分钟没动,你就该过去看看它在干嘛了——是卡住了、跑偏了,还是正陷在某一步的细节里出不来。进度条不动,就是注意力又跑偏的信号。
| 我们的复刻 | 真实 Claude Code |
|---|---|
| TodoManager 内存清单 | 内置 TodoWrite 工具 + 状态管理 |
| render() 结果回流上下文 | 清单注入上下文,模型随时可见 |
| rounds_since_todo 计数器 | 系统 reminder 催更 |
| 最多 20 项 / 单 in_progress | 超长建议拆任务 / 单进行中 |
| SYSTEM 里一句引导 | 系统提示 + 工具描述共同引导 |
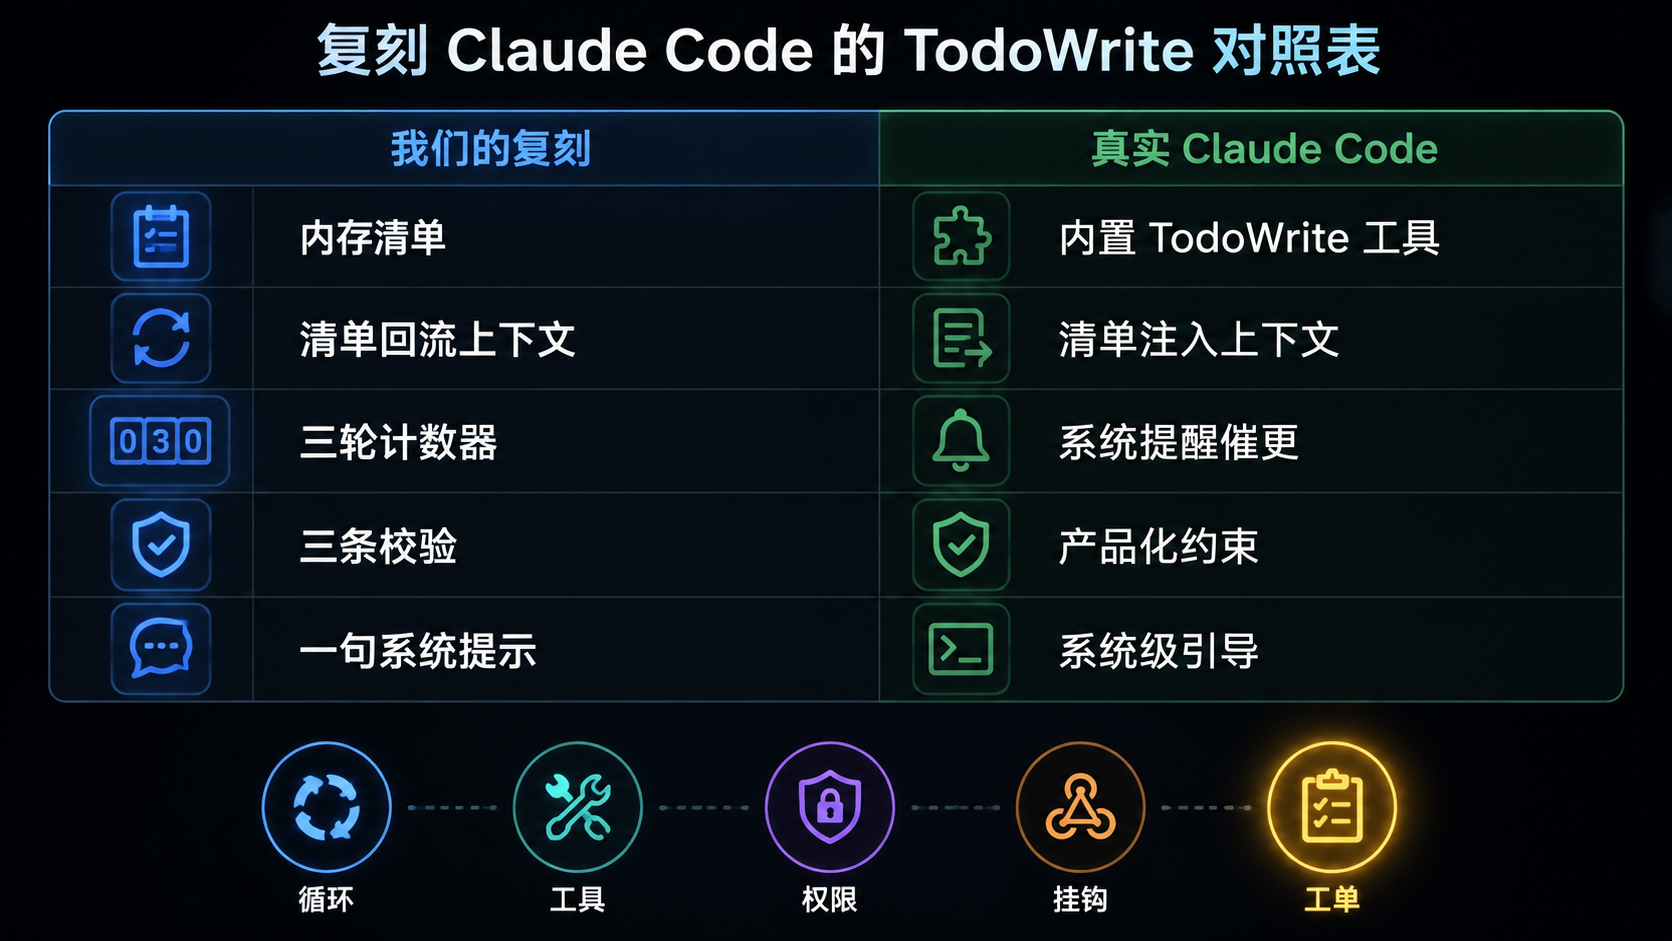
最后收一笔大账。五个模块连起来看:心脏(agent 循环)、双手(工具分发)、神经(权限系统)、挂钩(hooks 扩展)、今天的工单(TodoWrite)。
你会发现前四个模块解决的其实都是同一类问题——"怎么干":循环让它干起来,工具让它干得动,权限让它干得安全,hooks 让别人能管它怎么干。而今天这个模块,第一次碰到了另一类问题:
"还记得要干什么吗?"
执行能力齐活的一个 Agent,栽在"忘了初衷"上——这个教训不只适用于 Agent。
结尾:便利贴不是贴给眼睛的,是贴给注意力的
回到开头那个跑偏的现场。模型的注意力像一支手电筒,只照亮最近的东西——工具结果、报错堆栈、上一轮的输出,全都挤在光斑里,而任务目标缩在黑暗角落,喊破喉咙也没人听见。
清单解决的问题,从头到尾就不是"记忆"——它的硬伤一个都没治。它治的是锚点:每勾一项,光斑就扫回目标一次。手电筒还是那支手电筒,只是墙上多了一张它绕不开的纸。
所以这张工单,值钱的不是那二十来行代码,是一个认知:
执行能力决定它能不能做到,规划状态决定它还记不记得要做什么。
互动时间:你见过 Agent 跑偏最离谱的一次是什么?忘了跑测试?忘了格式化?还是改着改着把不相关的东西也顺手"重构"了?评论区聊聊——顺便说说,你觉得 reminder 几轮触发一次才合适?三轮太勤还是太懒?
下一篇预告:「从0学习 Claude Code」第六篇——Subagent,子代理。清单解决了"记得住",但一个任务大到几十步,全塞在一个对话里照样会淹没。下一篇把大任务拆开,每个子任务派一个独立上下文的子 Agent 去干——干完只把结论带回来,主 Agent 的上下文从此可以是干净的。
— END —
苦猿 · 帮普通人把 AI 学进简历

汇聚全球AI编程工具,助力开发者即刻编程。
更多推荐



 11
 0
- 0


 已为社区贡献5条内容

所有评论(0)