
码道:当 AI 主持人走进纯前端的谜题世界 —— 零依赖 AI 对话游戏的完整开发记录
本文详细记录了「谜弈AI乐园」项目的完整开发过程:从产品构想、Python 流式调用迁移为浏览器 JavaScript、系统提示词驱动的 JSON 数据协议设计,到游戏状态机与暗色霓虹风格 UI 的实现,以及历经真实 API 与无头浏览器双重验证的全流程。希望能够给同样想做「AI + 创意互动」前端项目的开发者一些启发。
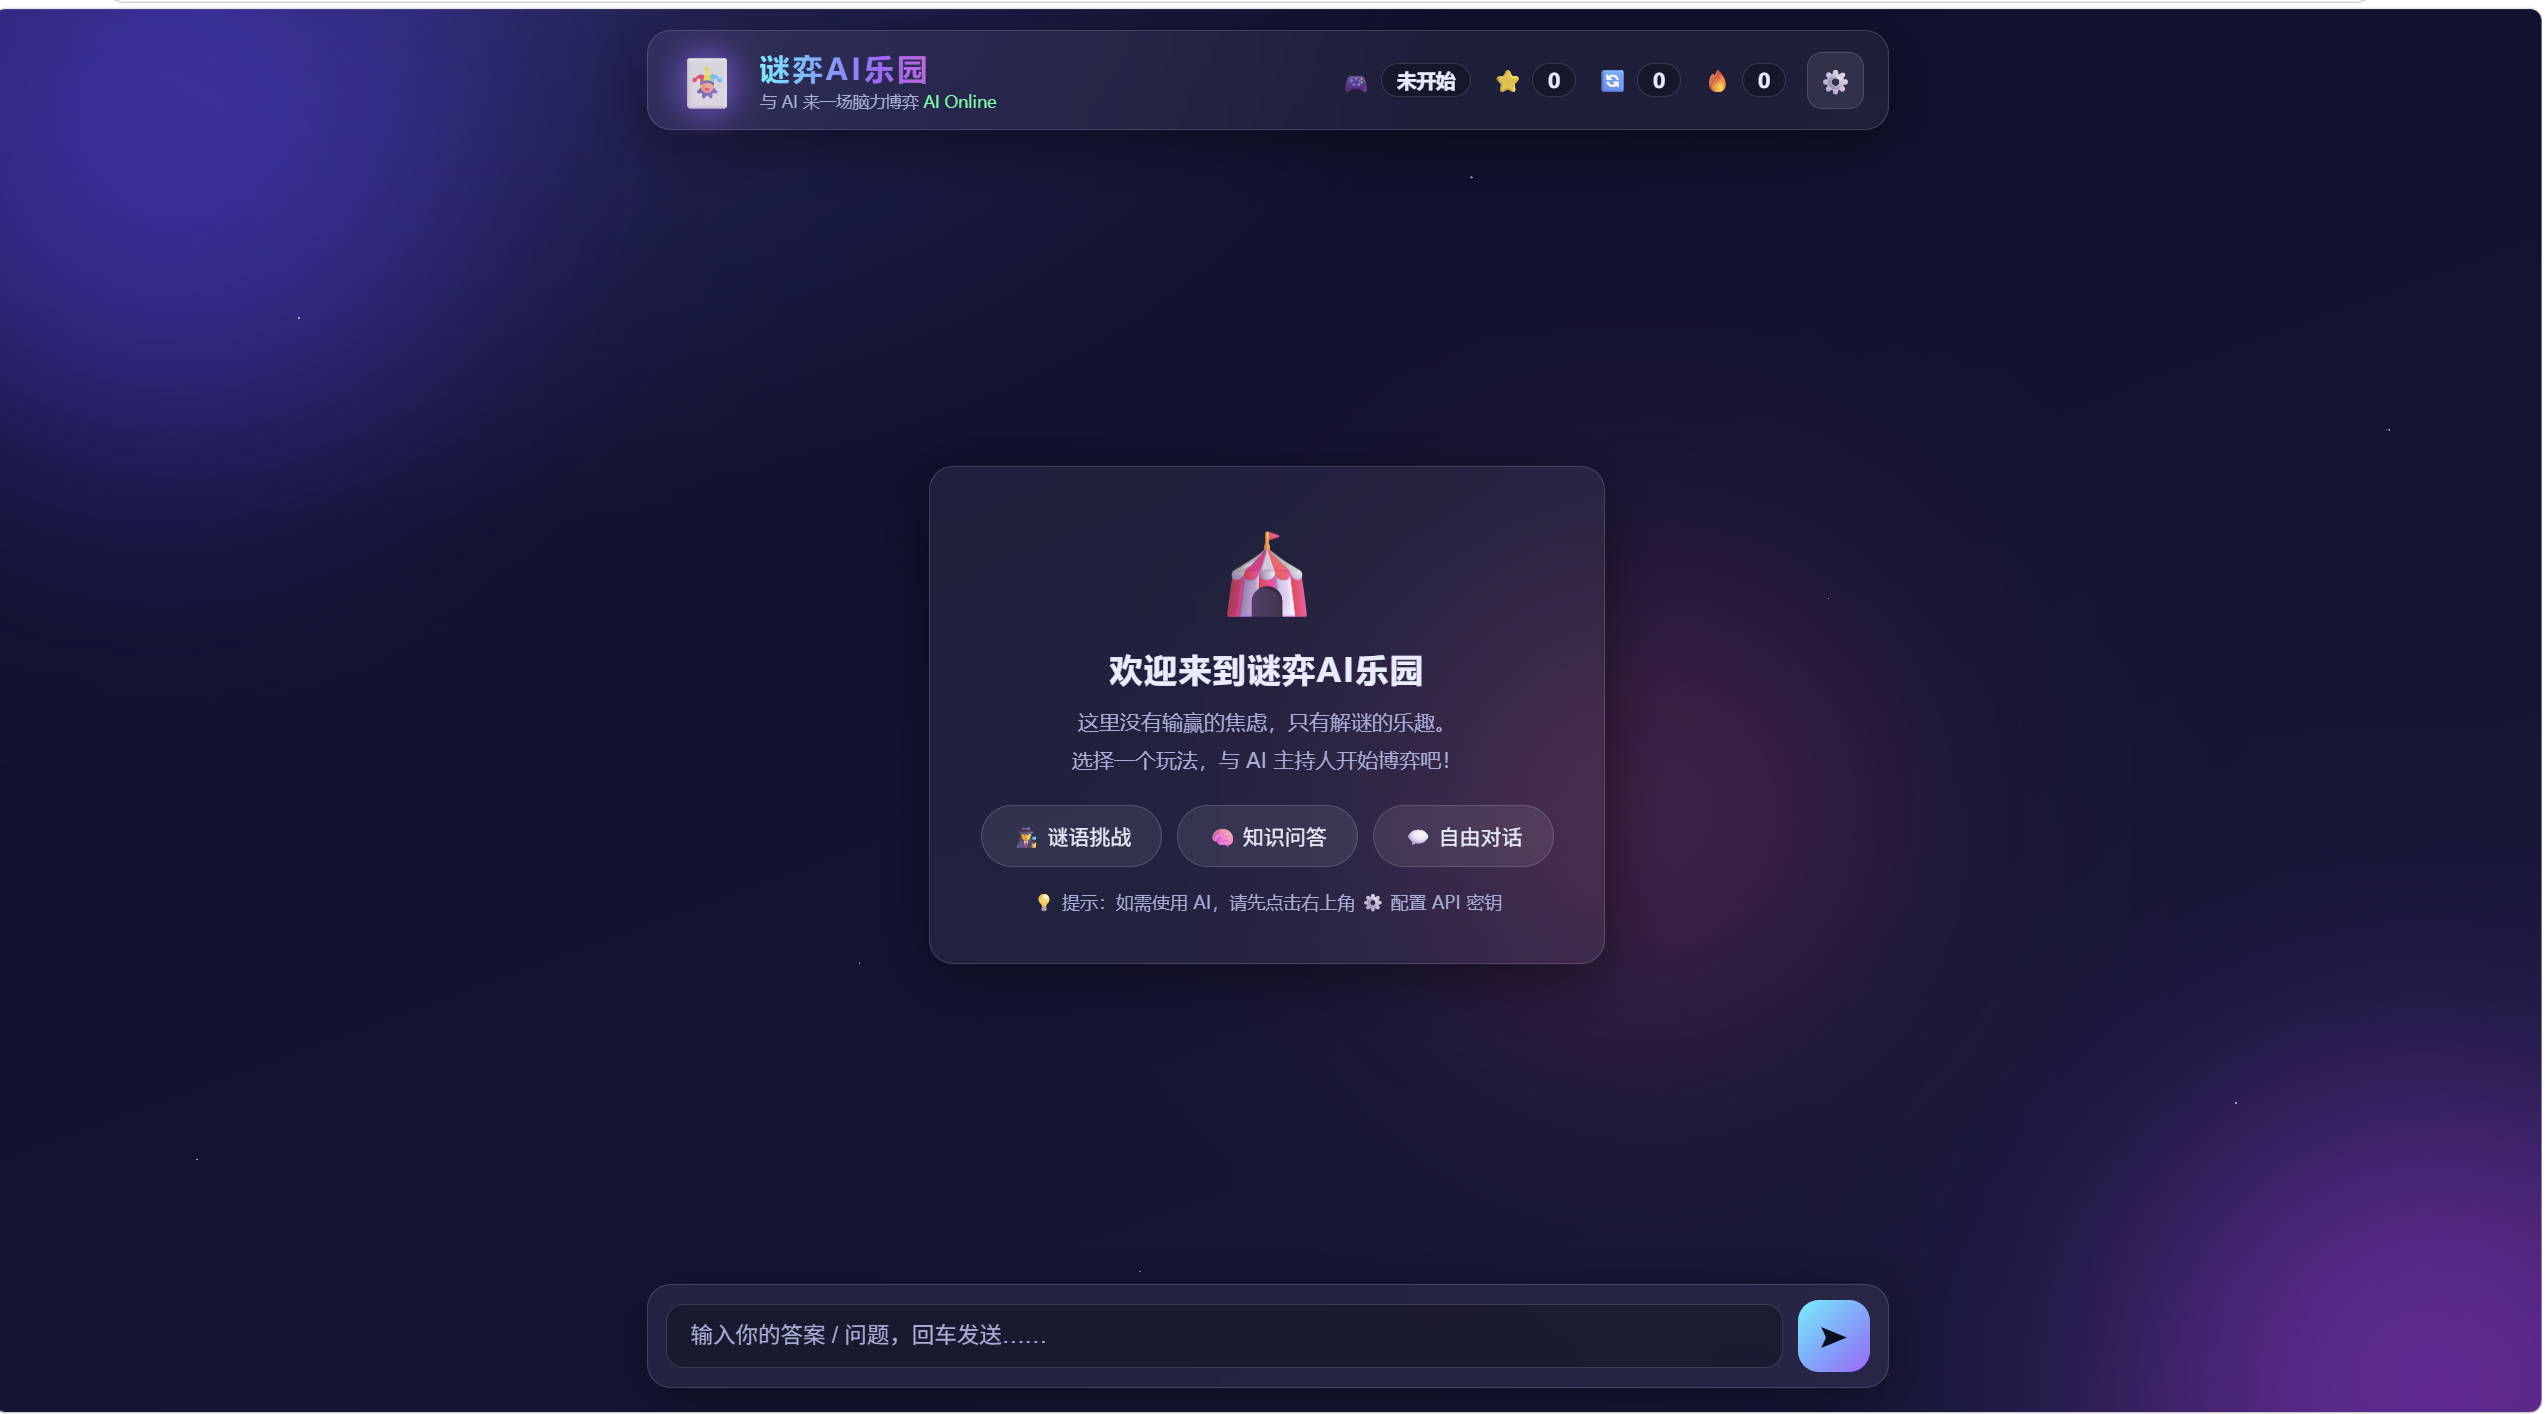
运行实例效果:
—
使用工具: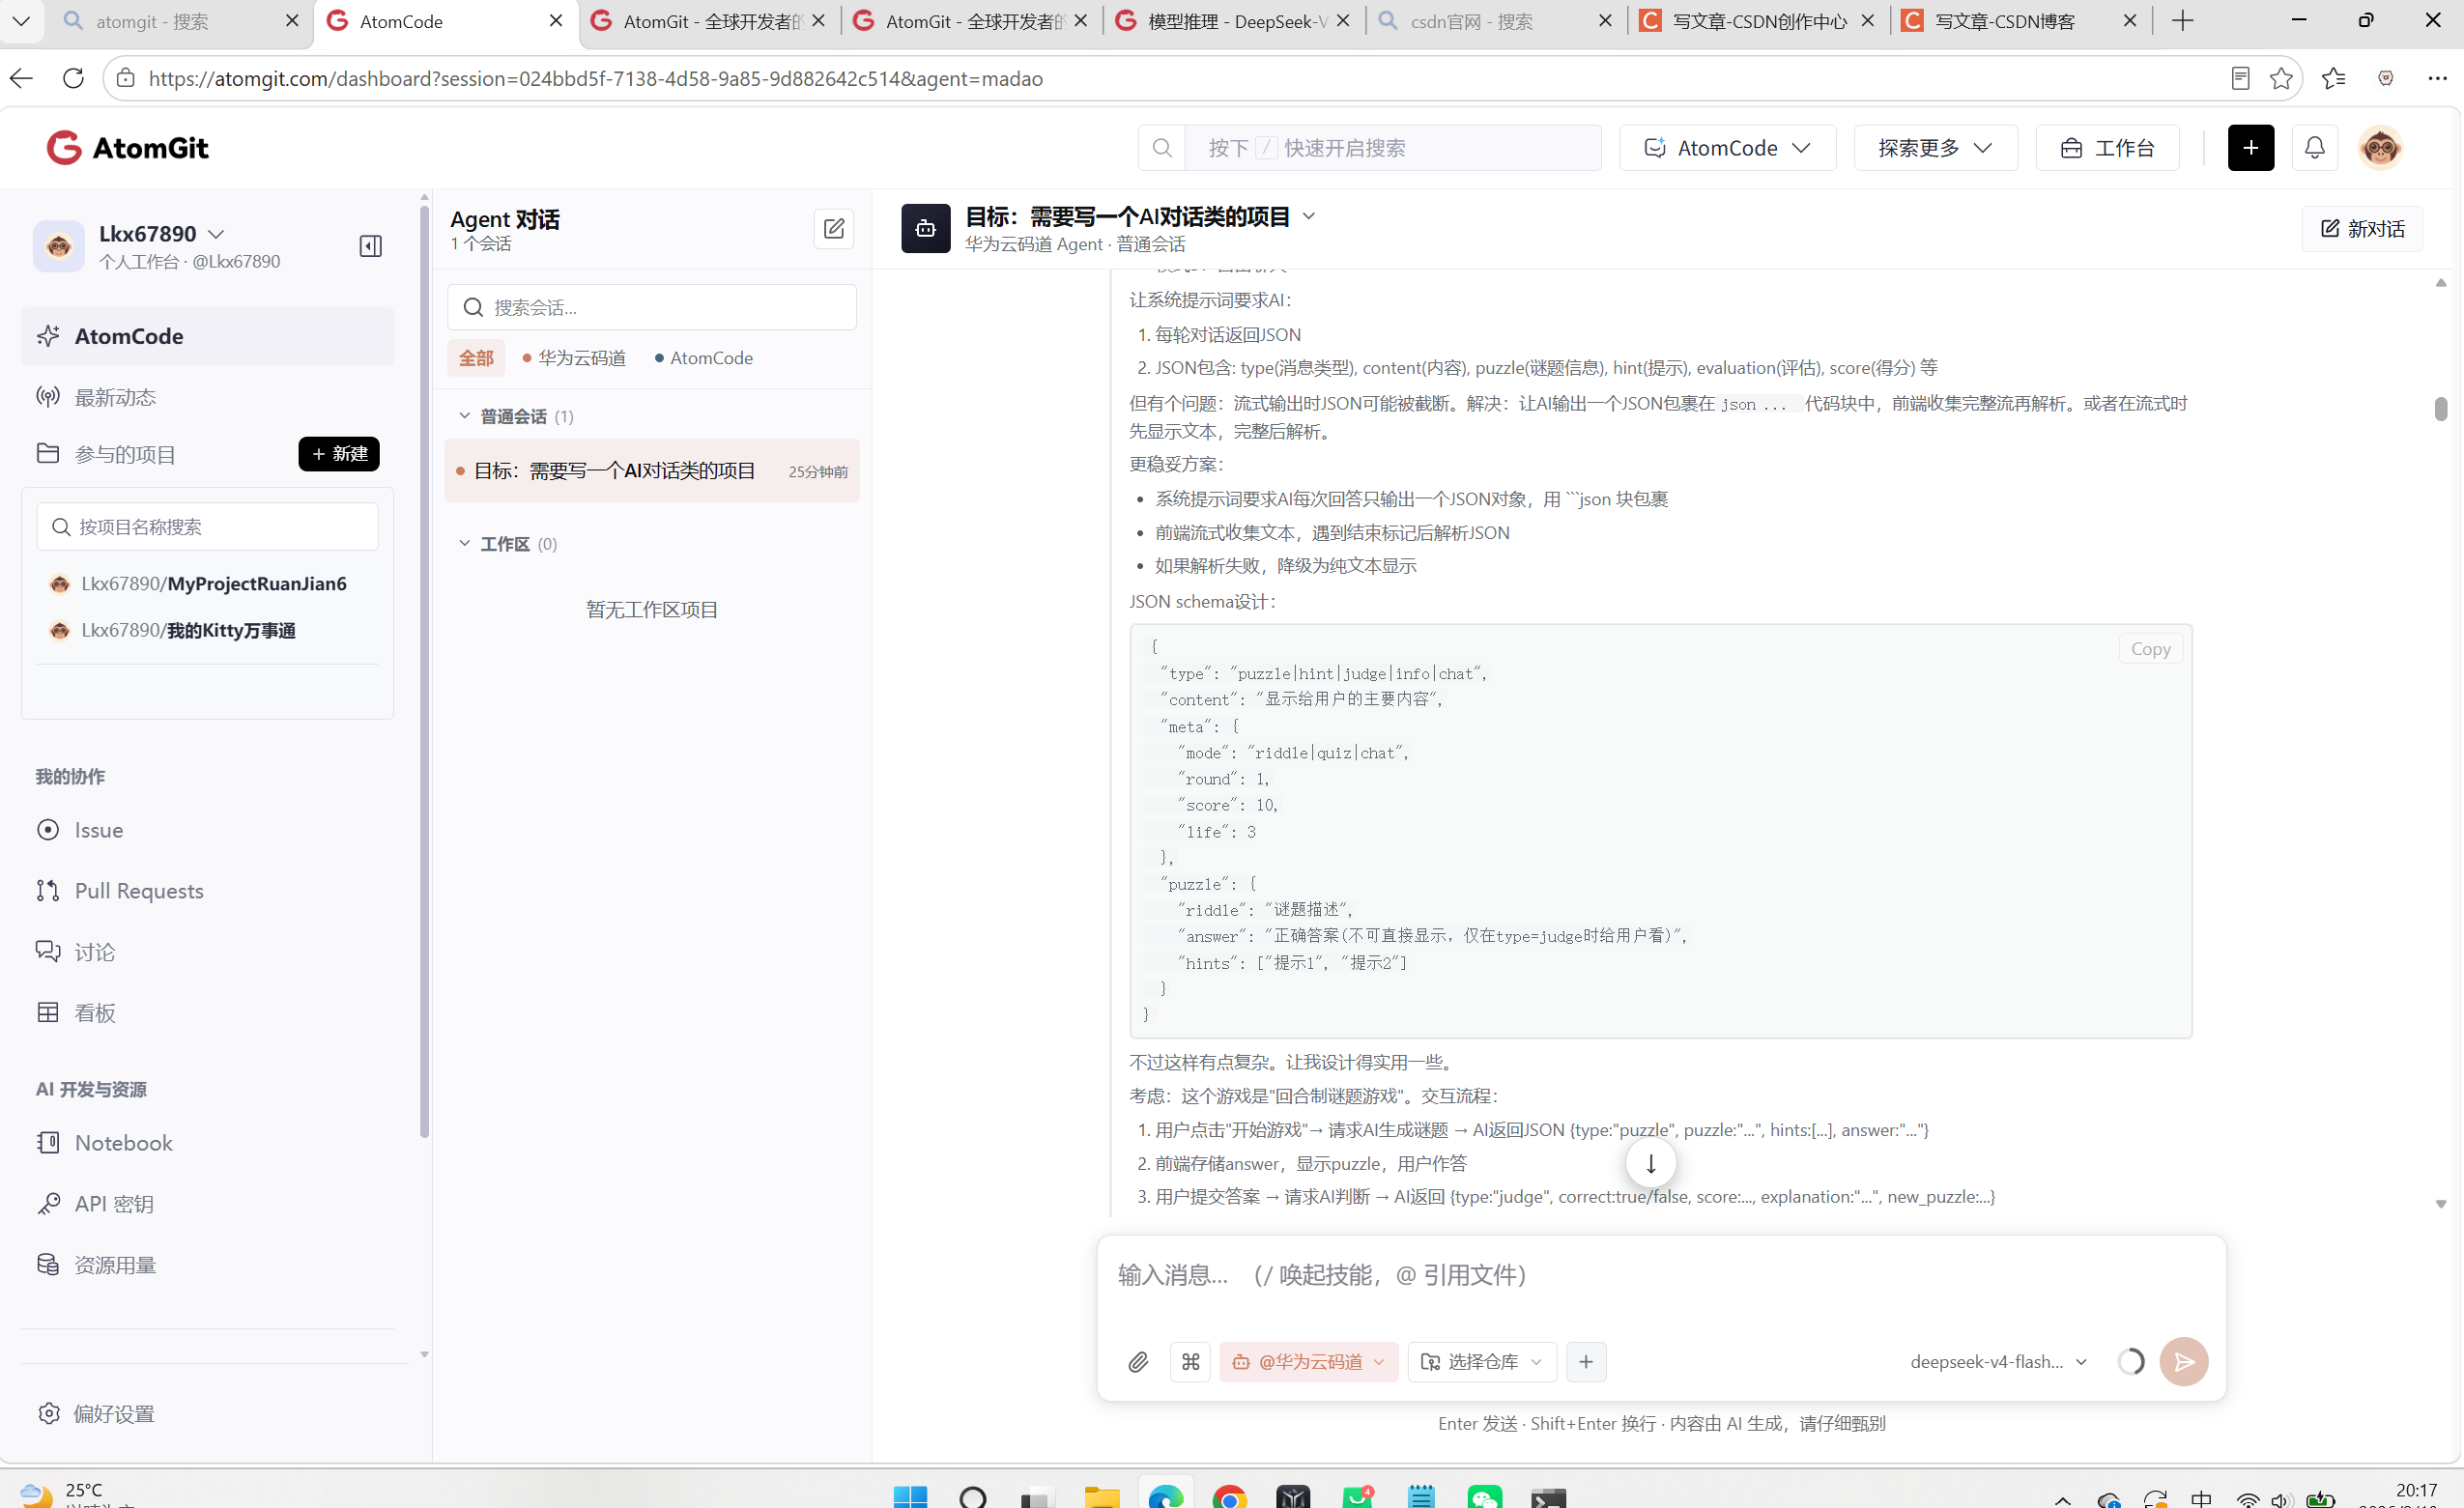
一、缘起:为什么想做一款 AI 谜题游戏
人工智能大模型的能力边界正在不断被普通人感知。过去一年里,我们见惯了「AI 助手」式的产品:你问一句,它答一段;你提需求,它给方案。这类对话形态固然强大,但它把 AI 定位成了一个「被动回答者」,用户与 AI 之间始终隔着一段距离,缺少参与感与即时反馈。
我在想:能不能让 AI 换一个身份,从「陪聊的助手」变成「陪你玩的对手」?
于是「谜弈AI乐园」这个想法就诞生了。它的核心不是让 AI 回答问题,而是让 AI 主持一场游戏:它出谜语,你猜;它出题目,你答;它来评判对错、计算分数、抛出提示、揭晓答案。整个交互过程依然是一段连续的对话,但对话的目的不再是「获取信息」,而是「完成一场脑力博弈」。
为什么选择谜题作为载体?因为谜题天然具备几个很好的特质:
- 短平快:一道谜题的交互粒度很小,用户的注意力可以轻松覆盖一个完整回合,不需要长时间阅读。
- 即时反馈:AI 给出题目后,玩家立刻作答,AI 立刻评判,成败在一瞬之间,反馈回路极短,容易产生「再来一题」的上瘾感。
- 容错空间大:猜错了不丢人,笑一笑,看答案,继续下一题,天然适合轻松向的产品调性。
- 适合全年龄:从文字谜语到知识问答,难度可以自由调节,受众覆盖面广。
当然,做产品不能只有情怀。我同时给这个项目设定了几条硬约束,用来倒逼自己做「减法」:
- 零依赖:不用任何前端框架,不引入构建工具,打开浏览器就能跑;
- 纯前端:不搭建后端服务,直接在前端调用大模型 API,让项目保持极简;
- 单文件思维:尽可能让交付物少而清晰,让别人 clone 下来五分钟就能看懂全貌。
这些约束最终决定了整个项目的技术走向。
二、项目概览:谜弈AI乐园长什么样
「谜弈AI乐园」(Riddle AI Park)是一款纯前端实现的 AI 互动对话游戏。打开页面,你会看到一个深色霓虹风格的聊天界面,AI 主持人「🤖」已经就位,顶部实时展示当前模式、累计得分、回合数与连胜纪录。
它提供了三种玩法:
- 🕵️ 谜语挑战:AI 出谜语,你直接作答。直接猜对得 10 分,请求过提示之后再猜对得 5 分,每题最多可以要 3 次提示;
- 🧠 知识问答:AI 出客观题,答对得分,答错则立即公布正确答案,寓教于乐;
- 💬 自由对话:放下得分与回合,和 AI 主持人闲聊放松。
除了这三种模式之外,项目还内置了一套完整的游戏化体系:累计得分、回合计数、连胜纪录都通过 localStorage 持久化,刷新页面之后战绩依然还在;流式输出配合打字机光标,让 AI 的回答像真人一样逐字出现;可选地展示 AI 的「思考过程」,把大模型的思维链条变成一种观赏体验。
值得一提的还有 UI 细节:AI 返回的谜题、判分、提示、答案并不会以一大段纯文本平铺在你的面前,而是被渲染成一张张结构清晰的「游戏卡片」——谜题卡上有题型标签与提示次数说明,判分卡上有醒目的绿色「回答正确」或红色「再想想看」徽章。这些设计都建立在同一个底层机制之上:AI 返回结构化 JSON,前端按数据驱动渲染。这也是本文后半部分要重点展开的内容。
三、技术选型与整体架构
在技术选型上,我最终确认了以下方案:
| 维度 | 选择 | 理由 |
|---|---|---|
| 前端 | 原生 HTML5 + CSS3 + JavaScript | 零依赖、零构建,任何人都能直接读懂 |
| AI 接口 | GitCode AI deepseek-ai/DeepSeek-V4-Flash | 支持流式输出与思维链(thinking) |
| 通信协议 | SSE(Server-Sent Events)流式返回 | 打字机体验 + 首字延迟低 |
| 数据协议 | AI 返回 JSON,前端解析渲染 | 解耦内容与展示,天然适合卡片化 UI |
| 存储 | localStorage | 战绩与设置的本地持久化 |
整体架构是一条非常简单的链路:
浏览器页面(HTML/CSS/JS)
      │  fetch  POST   {"model":..., "messages":[...], "stream": true}
      ▼
GitCode AI 接口(/v1/chat/completions)
      │  流式返回 data: {...chunk...}  ...  data: [DONE]
      ▼
前端 API 客户端(逐行解析 SSE,分离 thinking 与 content)
      ▼
游戏状态机(更新得分/回合/状态)← → JSON 解析 → 结构化卡片渲染
整个项目只有五个文件:index.html 负责页面骨架,css/style.css 负责视觉皮肤,js/config.js 负责配置与系统提示词,js/api.js 负责网络层与流式解析,js/game.js 负责游戏状态机,js/app.js 负责 UI 渲染与事件绑定。职责边界非常清楚,后面我会逐一说明每一个模块的设计思路。
四、从 Python 到 JavaScript:流式调用的迁移之路
这个项目有一个非常具体的起点:一份 Python 版的 API 调用示例。
import os
import requests
import json

API_URL = "https://api-ai.gitcode.com/v1/chat/completions"
headers = {"Authorization": "Bearer <API_KEY>"}

def query(payload):
    response = requests.post(API_URL, headers=headers, json=payload, stream=True)
    for line in response.iter_lines():
        if not line.startswith(b"data:"):
            continue
        if line.strip() == b"data:[DONE]" or line.strip() == b"data: [DONE]":
            return
        yield json.loads(line.decode("utf-8").lstrip("data:").rstrip("/n"))

chunks = query({
    "model": "deepseek-ai/DeepSeek-V4-Flash",
    "messages": [{"role": "user", "content": "告诉我一个有关宇宙的有趣事实?"}],
    "stream": True,
    "max_tokens": 2048,
    "temperature": 0.6,
    "top_p": 0.95,
    "frequency_penalty": 0,
    "thinking_budget": 2048
})

for chunk in chunks:
    print(chunk["choices"])
这段代码虽然只有几十行,却清晰地向我们展示了与流式 AI 接口打交道的全部要点:
- 请求头里必须携带
Authorization: Bearer <token>,这是所有大模型 API 的标准认证方式; - 请求体必须显式声明
"stream": true,服务端才会以流的方式逐块返回; - 服务端每行返回一段
data: {...json...},最后以data: [DONE]宣告结束; - 每一段 JSON 中,
choices[0].delta携带增量内容。
Python 版的 requests 库对这类场景的支持极其丝滑:iter_lines() 自动按行切分,yield 可以边收边吐。但浏览器端没有 requests,我需要用标准 Web API 把它完整复刻。最终的迁移结果是 js/api.js 里的 streamChat() 函数:
async function streamChat(payload, opt) {
  const headers = {
    "Authorization": "Bearer " + opt.apiKey,
    "Content-Type": "application/json"
  };
  const response = await fetch(AI_CONFIG.API_URL, {
    method: "POST", headers, body: JSON.stringify(payload), signal: opt.signal
  });
  if (!response.ok) throw new Error(`HTTP ${response.status} - ${await response.text()}`);
  if (!response.body) throw new Error("当前浏览器不支持流式读取");

  const reader = response.body.getReader();
  const decoder = new TextDecoder();
  let buffer = "";
  while (true) {
    const { value } = await reader.read();
    if (!value) break;
    buffer += decoder.decode(value, { stream: true });

    // 按行切分,最后一行可能不完整,留到下一次循环
    const lines = buffer.split("\n");
    buffer = lines.pop();
    for (const line of lines) {
      if (!line.startsWith("data:")) continue;
      const data = line.slice(5).trim();
      if (data === "[DONE]") return { content };
      const delta = JSON.parse(data).choices[0].delta;
      if (delta.reasoning_content) { thinking += delta.reasoning_content; opt.onThinking?.(thinking); }
      if (delta.content) { content += delta.content; opt.onContent?.(content); }
    }
  }
  return { content, thinking };
}
4.1 三个迁移关键点
第一个关键点,是「UTF-8 分块解码的粘包问题」。ReadableStream 的 read() 返回的字节块边界,与 SSE 的行边界完全不对齐。一个 data: 数据包可能被切成两半,跨两次 read() 才能到齐。传统做法是一次性 await response.text() 把全文读完再解析,但那会彻底牺牲流式体验。我的解法是维护一个 buffer 字符串,每读到新数据就往里追加,用 split("\n") 切出游刃有余的完整行,而把「最后一行」留回 buffer 等待下一次拼接——经典的「半行缓冲」模式。
第二个关键点,是 Delta 里其实藏着两种内容。当 thinking_budget 大于零时,模型会先输出一段「思维链」,这段内容出现在 delta.reasoning_content 字段中;而给用户看的内容出现在 delta.content 字段中。两者必须分离:前者可以用作「AI 思考中」的趣味展示,后者才是真正要渲染的正文。如果图省事只拼接 delta.content,界面会在模型思考的几十秒里一片空白,体验非常糟糕。
第三个关键点,是取消机制。用户点击「停止生成」按钮时,应该立刻中断网络请求。fetch 原生支持 AbortController,我把 controller 挂在全局,点按钮时调用 abort(),配合 try/catch 里的 AbortError 判定,优雅地终止流式输出。
4.2 与 Python 版本的行为等价性
为了确保迁移「行为等价」,我针对 js/api.js 写了一套纯逻辑单测:手工构造一段模拟的 SSE 文本(包含 thinking 增量、content 增量与 [DONE] 结束标记),喂给 parseSSE(),验证 thinking 与 content 是否被正确分离、结束标记是否被识别。测试通过后又用 Node.js 直接调用真实 API,把完整响应体拉下来逐行比对,最终确认迁移后的结构与 Python 版 chunk["choices"] 完全一致。这一步「先测解析器,再测真联调」的做法,省去了后续大量排查问题的时间。
五、系统提示词:让 AI 只说 JSON
如果说流式调用是项目的骨架,那系统提示词就是项目的灵魂。初次把 API 跑通时,AI 输出的是一大段口语化的自然语言,排版全靠 Markdown,前端想要做结构化卡片简直无从下手。
我当时的想法很明确:为什么不让 AI 自己输出 JSON,把「展示什么」和「怎么展示」都交给协议来约束?
5.1 协议设计要解决的三件事
设计这个 JSON 协议之前,我先想清楚了它必须解决的三件事:
- 消息类型:AI 这一回合到底在做什么——是出题、判分、给提示,还是单纯聊天?这是前端渲染逻辑的分发依据,我用
type字段表达。 - 游戏状态:当前总分、当前回合数,AI 必须持续维护并回传。前端拿到后直接同步 UI,不需要自己在两套计分逻辑之间来回折腾。
- 题型细节:不同
type需要携带完全不同的细节字段。出题要带答案和三条提示,判分要带对错和得分变化,给提示要带剩余次数。这些细节统一放进detail对象,互不干扰。
最终的协议长这样:
{
  "type": "puzzle | judge | hint | reveal | greeting | chat",
  "content": "展示给玩家的主要文本",
  "score": 0,
  "round": 1,
  "detail": { "...": "不同类型的详情字段" }
}
其中 detail 在不同 type 下的字段规范为:
| type | detail 字段 | 语义 |
|---|---|---|
puzzle | question category answer hints[] | 题目、题型、答案、三条由浅入深的提示 |
judge | correct gained explanation reveal_answer answer | 对错、得分变化、点评、是否揭晓答案 |
hint | hint hints_left | 本条提示内容、剩余提示次数 |
reveal | answer explanation | 答案与解析 |
greeting / chat | hint_text 或空 | 引导文本、普通聊天 |
5.2 提示词里写清楚的「规则」
协议定好了,还得让 AI 严格执行。我在系统提示词里明确了三条硬约束:
第一,永远只输出 JSON。 提示词原文是:「必须【只】返回一个合法的 JSON 对象,禁止输出任何 JSON 以外的字符、注释、Markdown 代码块标记或多余说明。」同时补充了「JSON 中可以包含换行和转义引号,但整体必须是合法 JSON」,避免模型因为害怕转义而擅自退化成自然语言。
第二,状态连续。 前端在每条用户消息前都附带一行会话前缀:
[mode:谜语挑战|score:10|round:2|hints_left:1] 用户输入内容
AI 据此知道当前处于什么模式、多少分、第几回合、还剩几次提示,从而把 score、round 字段一路维护下去,不会出现「这局分数记着记着就丢了」的错乱。
第三,指令与普通消息分流。 用户点击界面按钮时,前端会发送带标签的指令:[指令]开始谜语挑战、[指令]提示、[指令]揭晓答案、[指令]下一题。系统提示词逐一规定了这些指令对应的返回 type。而普通文本则被视作「玩家的答案」,AI 判分并返回 judge。这样一个简单的约定,就把「按钮交互」和「自由输入」两种交互形态统一到了同一条消息通道上。
写提示词时还有两个细节值得分享。一是要让模型「一句话说清玩法」:直接猜对得 10 分,提示后猜对得 5 分,每题最多提示 3 次等等,规则冗余一点没关系,模型不怕啰嗦,只怕含糊。二是在文件里用一个 AI_SYSTEM_PROMPT 常量集中管理提示词,把它当作「可版本化的配置」对待——后面调整计分规则时,只需要改这一个字符串。
5.3 前端不能只赌模型「听话」
最后,也是很重要的一条工程经验:面对大模型的输出,永远要有容错心理。 即使提示词写得再严格,模型偶尔也会跑题:有时输出 Markdown 代码块包裹的 JSON,有时在 JSON 前后多加几句话,罕见情况下甚至完全不是 JSON。为此我在 js/api.js 里实现了一个层级递减的 extractJSON() 解析器:
function extractJSON(text) {
  try { return JSON.parse(text.trim()); }            // 1. 纯 JSON
  const fence = text.match(/```(?:json)?\s*([\s\S]*?)```/);
  if (fence) try { return JSON.parse(fence[1]); }    // 2. 代码块包裹
  const start = text.indexOf("{"), end = text.lastIndexOf("}");
  if (start !== -1 && end > start)
    try { return JSON.parse(text.slice(start, end + 1)); } // 3. 截取花括号区间
  return null;                                        // 4. 彻底失败则降级为纯文本
}
它的解析策略从严格到宽松共四层:先试整体解析,再试去掉代码块围栏,再试截取首尾花括号区域,最后实在不行就返回 null,由上层把内容当作普通聊天文本展示。有了这层兜底,即使 AI 偶发「叛逆」,用户的体验也不会瞬间崩坏。
六、游戏状态机:把规则写进代码
JSON 协议负责「AI 说什么」,而「玩家怎么玩」则交给前端的游戏状态机来维护。js/game.js 用一个立即执行函数包裹出独立命名空间,对外暴露一组纯粹的函数式接口,核心状态包括:
mode:当前玩法(谜语挑战 / 知识问答 / 自由对话);score:累计得分;round:总回合数(每出一道新题加一);streak:当前连胜数;solving:是否存在进行中的题目;hintsUsed/maxHints:本题已用提示次数与上限(3 次)。
围绕这些状态,我定义了五个核心操作,它们也是整个游戏的命脉:
setMode:切换玩法。切到自由对话时清空战绩,因为「聊天不该有输赢」;startQuestion:开始新题。置位solving、归零hintsUsed、回合数加一;useHint:消耗一次提示机会,返回是否还有剩余;applyJudge:根据判分结果更新得分与连胜:猜对连胜加一,猜错连胜归零;得分下限为零,防止模型给出负分把分数扣穿;statePrefix:把当前状态序列化成[mode:...|score:...|round:...|hints_left:...]前缀,注入下一条用户消息。
这里有个关键的设计决策:最终计分以后端 AI 返回的 score 字段为准,前端只是同步展示,并在状态前缀里把当前估值传给 AI。 这避免了两套计分逻辑互相打架——前端算一套、AI 算一套,必然出现偏差。由 AI 统一维护分数,再加上系统提示词里的明确计分规则,整体一致性要好得多。当然这也有代价:AI 偶尔会算错分,但作为一款轻松向的小游戏,这是可以被接受的「人工智障」美学。
同时,整个状态机与渲染是彻底分离的。所有状态修改后调用 persist() 写入 localStorage,页面启动时 load() 恢复战绩;UI 层完全通过 updateStats() 把状态同步到顶部状态栏。这样即使以后想引入后端持久化,只需要替换 persist/load 两个函数就够了。
七、UI 与交互:暗色霓虹游戏风
游戏面向的是轻松娱乐的受众,UI 设计上我选择了「暗色霓虹」风格,希望在打开页面的一瞬间,就让人感受到「这里是一个游乐场,而不是一个工具」。
7.1 视觉体系
配色上以深空蓝紫为底,辅以青、紫、粉三种霓虹高光。背景通过三颗模糊的大光球外加一层 CSS 生成的星光点阵来营造深邃感,而顶栏、弹窗、输入栏统一使用毛玻璃(backdrop-filter: blur())材质,让界面在深色背景上依然有通透的层次。品牌标题使用渐变色文字,在暗色底上足够显眼。
我把视觉强调色与语义一一绑定:青色代表「信息」(谜题、链接),金色代表「提示」,粉色代表「揭晓」,绿色代表「答对」,红色代表「答错」。这些颜色不仅出现在卡片标签上,也贯穿按钮 hover 状态与光晕效果,形成一套语义自洽的视觉语言。
7.2 三个有记忆点的交互细节
第一个细节是「气泡里的卡片化渲染」:AI 的消息内容并不只是一段文字,而是由 renderFrame() 根据 type 动态拼装的 DOM 结构。谜题卡带有题型标签与「第 N 关」标题,判分卡带绿/红徽章与得分变化,提示卡带左侧金色竖条。数据与视图彻底解耦,加一种新的卡片类型,只需要在 renderFrame 里多写一个分支。
第二个细节是「流式打字机 + 思考指示」:请求发出后,界面上先是「🤔 AI 主持人思考中」的动效,思考字样会随 reasoning_content 滚动更新;当第一个 content 分块到达后,正文开始逐字上屏,末尾跟随一个闪烁的青色光标(.caret),营造出真人打字的临场感。
第三个细节是「动态快捷操作栏」:底部按钮区不是写死的,而是根据游戏状态实时渲染。未开始时显示三个玩法入口;出题后变成「提示 / 揭晓答案 / 换一题」;提示次数用尽时「提示」按钮自动禁用;判分结束后自动出现「换一题」。用一句话概括:状态决定了你能做什么,按钮永远不多不少。
7.3 响应式与细节打磨
CSS 里针对窄屏做了媒体查询,移动端隐藏副标题、收紧间距,保证小屏上主要操作依旧顺手。整个界面没有引入任何图标字体,全部使用 emoji 表达视觉意像,省去资源加载的同时也自带了一股轻松的游戏感。输入框的聚焦光晕、按钮的悬浮上浮与阴影扩散、弹窗的弹出动画,这些细微之处共同构成了产品的「手感」。
八、开发过程中的问题与反思
每个项目都会踩坑,这个项目也不例外。这里挑几个印象最深的记录如下:
坑一:模式状态没有即时同步。 早期版本中,玩家点击「谜语挑战」按钮后,界面顶部的模式徽章仍显示「未开始」——因为模式信息要等 AI 返回帧之后才能确定,而 AI 出题需要好几秒。修复方案是在 command() 函数中根据指令文本提前推断并设置前端模式(setMode),按钮一按下 UI 立即切换,AI 返回后再做二次校准。这是一个「乐观更新」的典型应用:先给用户反馈,再等待事实收敛。
坑二:思维链导致界面长时间空白。 调试时发现开启 thinking_budget 后,模型的「思考」可能持续数十秒,如果界面只渲染 content,用户会以为程序卡死了。这个坑在第四章已有论述——分离 reasoning_content 并做「思考中」展示,顺势把「看 AI 思考」变成了一项观赏功能。
坑三:偷偷跑题的 JSON。 哪怕提示词写得再严格,真实线上也会偶发非 JSON 输出。教训有两条:一是在提示词里明确「可以在 JSON 内使用转义引号与换行」,降低模型为了克制而跑题的概率;二是必须在解析侧做 extractJSON() 的降级容错,两条腿走路,缺一不可。
坑四:临时文件里的密钥。 开发调试阶段,我把真实 API 密钥写进了本地测试脚本,脚本放在 /tmp 下不影响仓库。这件事提醒了我:密钥管理是前端 AI 项目的最大安全议题,详见后文。切莫把真实密钥写进公开仓库的代码或 README,哪怕它只是一个「示例」。
九、验证:从接口测试到无头浏览器全流程
写代码只是一半工作,另一半是验证。这个项目的验证分了四个层次,逐层递进。
第一层:语法与静态检查。 对四个 JS 文件执行 node --check,确认没有语法错误。
第二层:解析器单元测试。 手工构造 SSE 模拟数据(含 thinking 与 content 双通道、含 [DONE] 结束标记),喂给 parseSSE(),断言双通道内容与结束标志。再对 extractJSON() 跑六组用例:纯 JSON、代码块包裹、前后缀文字干扰、多重嵌套、非法内容,确认每一类的降级路径都符合预期。
第三层:真实 API 端到端联调。 用真实密钥与完整系统提示词发起多轮对话,模拟「开始玩法 → 要提示 → 作答 → 揭晓答案」的完整对局,逐个解析响应体并核对字段完整性与类型。这一层直接验证了系统提示词的设计是否真的有效。测试结果令人满意:
{ "type": "puzzle", "content": "好嘞!谜语挑战开始!…",
  "score": 0, "round": 1,
  "detail": { "question": "一个小姑娘,生在水中央,身穿粉红衫,坐在绿船上。打一植物。",
    "category": "文字谜语", "answer": "荷花",
    "hints": ["它是一种水生植物", "它的花朵通常呈粉红色,也常见白色", "古人常称它为“莲”"] } }
第四层:无头浏览器全流程。 我用 Puppeteer 驱动真实的 Chromium 打开本地服务器,脚本化完成全套用户操作:打开页面 → 打开设置弹窗 → 填写 API 密钥 → 保存 → 点击「谜语挑战」→ 等待谜题卡渲染 → 点击「提示」→ 等待提示卡 → 输入答案 → 等待判分卡 → 校验得分与快捷按钮。全程监听页面错误与 console error,最终结果全流程通过、零 JS 报错。这一步把「代码能跑」升级成了「用户能玩」。
四层验证的顺序也暗合我的工程习惯:先静态、再单元、再联调、后集成,每一层都在为下一层扫清障碍,排查成本逐层递减。
十、项目展示与使用指南
项目已托管在 AtomGit:
https://atomgit.com/Lkx67890/wangjiaxin6
本地运行非常简单,任选其一启动静态服务器:
python3 -m http.server 8899
# 或
npx serve .
然后访问 http://localhost:8899。首次使用请点击右上角 ⚙️,在设置弹窗中填写你的 GitCode AI API 密钥(仅保存在浏览器 localStorage),按需调整模型、temperature 与思考预算,保存后即可开始对局。
值得强调的是,整个项目零依赖、零构建、纯静态,五个文件加起来不到 40KB。无论是上传到任意静态托管平台,还是塞进一个 USB 随身携带,都可以即插即用。这恰恰是「纯前端 + API」组合的魅力所在:客户端只是大模型的遥控器,而灵魂在生产者的提示词协议里。
十一、安全与合规思考
作为一款直接在前端调用付费 API 的应用,我必须认真对待密钥安全。项目最终采取的策略是:
- 默认不把密钥写入代码。
js/config.js中DEFAULT_API_KEY为空字符串,密钥通过设置弹窗输入; - 密钥只存浏览器本地。通过
localStorage持久化,既不进入仓库,也不上送任何第三方服务器; - 仓库层面兜底。
.gitignore与 README 双保险,明确警告切勿把真实密钥提交到公开仓库。
同时必须坦诚地说明其局限性:浏览器端的一切密钥,对具备一定技术能力的用户都是可见的(浏览器的开发者工具可以轻易读出)。所以这个方案只适合个人娱乐项目。若要将项目部署到公网服务大量用户,正确姿势应当是:前端只负责对话,密钥存于后端,由后端代理转发 API 请求,必要时再做频控与计费治理。我在 README 里也明确标注了这一点。
安全之外,还有一层合规意识:大模型输出可能包含不确定内容,游戏场景应在产品文案中给出适当引导;调用外部 API 时,务必遵守服务商的使用条款,控制调用频率,避免对他人接口造成压力。做一个对用户、对服务商都负责的开发者,比写出炫酷的代码更重要。
十二、总结与展望:下一次什么样的博弈
「谜弈AI乐园」从一条 Python 示例出发,最终长成为一个五脏俱全的小型产品,这段旅程本身就像一场解谜:流式迁移是解开编码之迷,协议设计是解开沟通之迷,状态机是解开规则之迷,UI 是解开体验之迷。而我很确信,这正是「码道」所倡导的创作方式——让 AI 不止于回答问题,而是成为作品的一部分。
回看整个项目,有三个设计心得希望与读者共勉:
- 给 AI 立规矩,比给 AI 写更多指令更有效。 一份强约束的输出协议 + 一套容错解析链路,是「模型输出不可控」时代最好的工程护栏。
- 状态即产品。 一个游戏给玩家的「手感」,本质上来自状态机的完备程度——什么时候该出现什么按钮、什么反馈,想清楚这些,产品就有了骨架。
- 验证不止于编译通过。 从解析器单测到真实联调再到无头浏览器全流程,四层验证层层递进,才敢把一个"会说话的界面"交付出去。
而对未来,这个项目的想象力才刚刚打开:可以增加「双人 PK」模式,让 AI 轮流给两位玩家出题;可以引入难度分级与段位系统,让连胜带来段位晋升的成就感;可以做一个「AI 出的题」排行榜,让全服玩家挑战 AI 生成的另类难题;甚至可以让 AI 根据玩家画像定制专属谜题——每个人都会遇到专属于自己的那道题。而我计划先把这份代码开源,让更多「码道」同路人一起把这座乐园扩建得更大。
这就够了。下一篇博客,我们下个项目再见。
附:本博客对应项目全部源码已公开于 AtomGit,欢迎 Star / Fork / Issue。

汇聚全球AI编程工具,助力开发者即刻编程。
更多推荐

 1
 0
- 0


 已为社区贡献1条内容

所有评论(0)