
码道 : 用 HTML/CSS/JS 打造“AI 家乡文旅对话导游“:从 Python 流式调用到 JSON 结构化渲染的完整实践
项目仓库:https://atomgit.com/W823711/ruanjianjishu6ban–wz
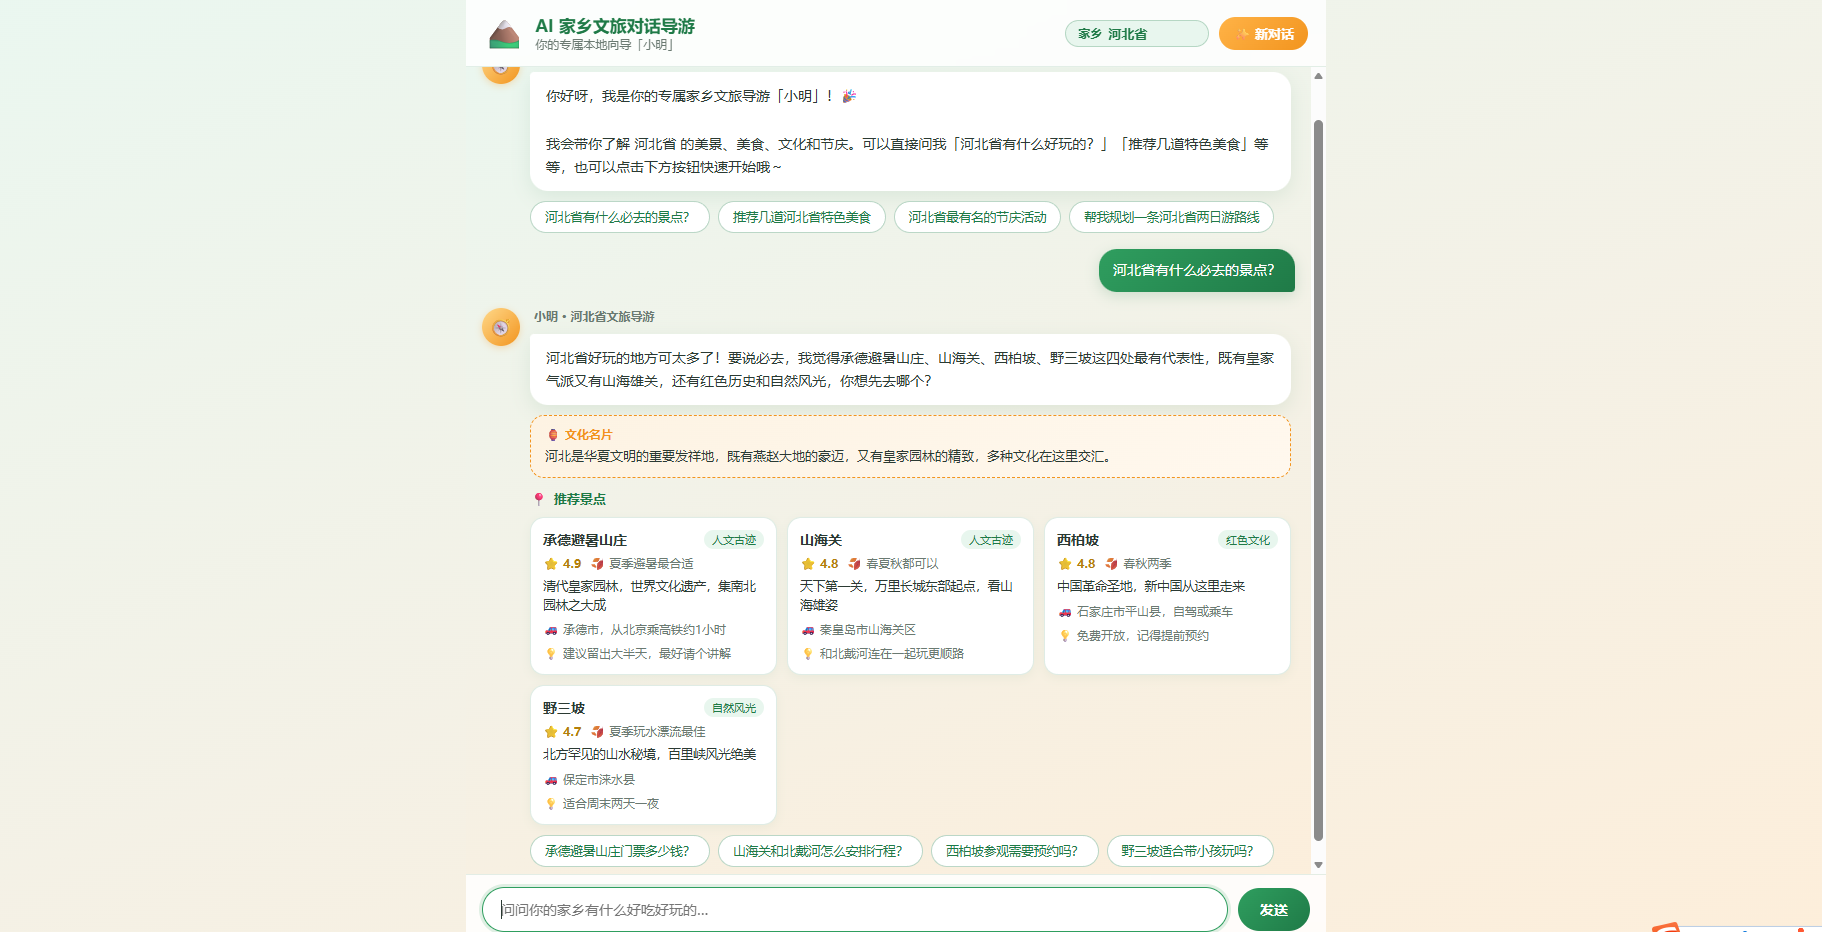
运行实例效果:
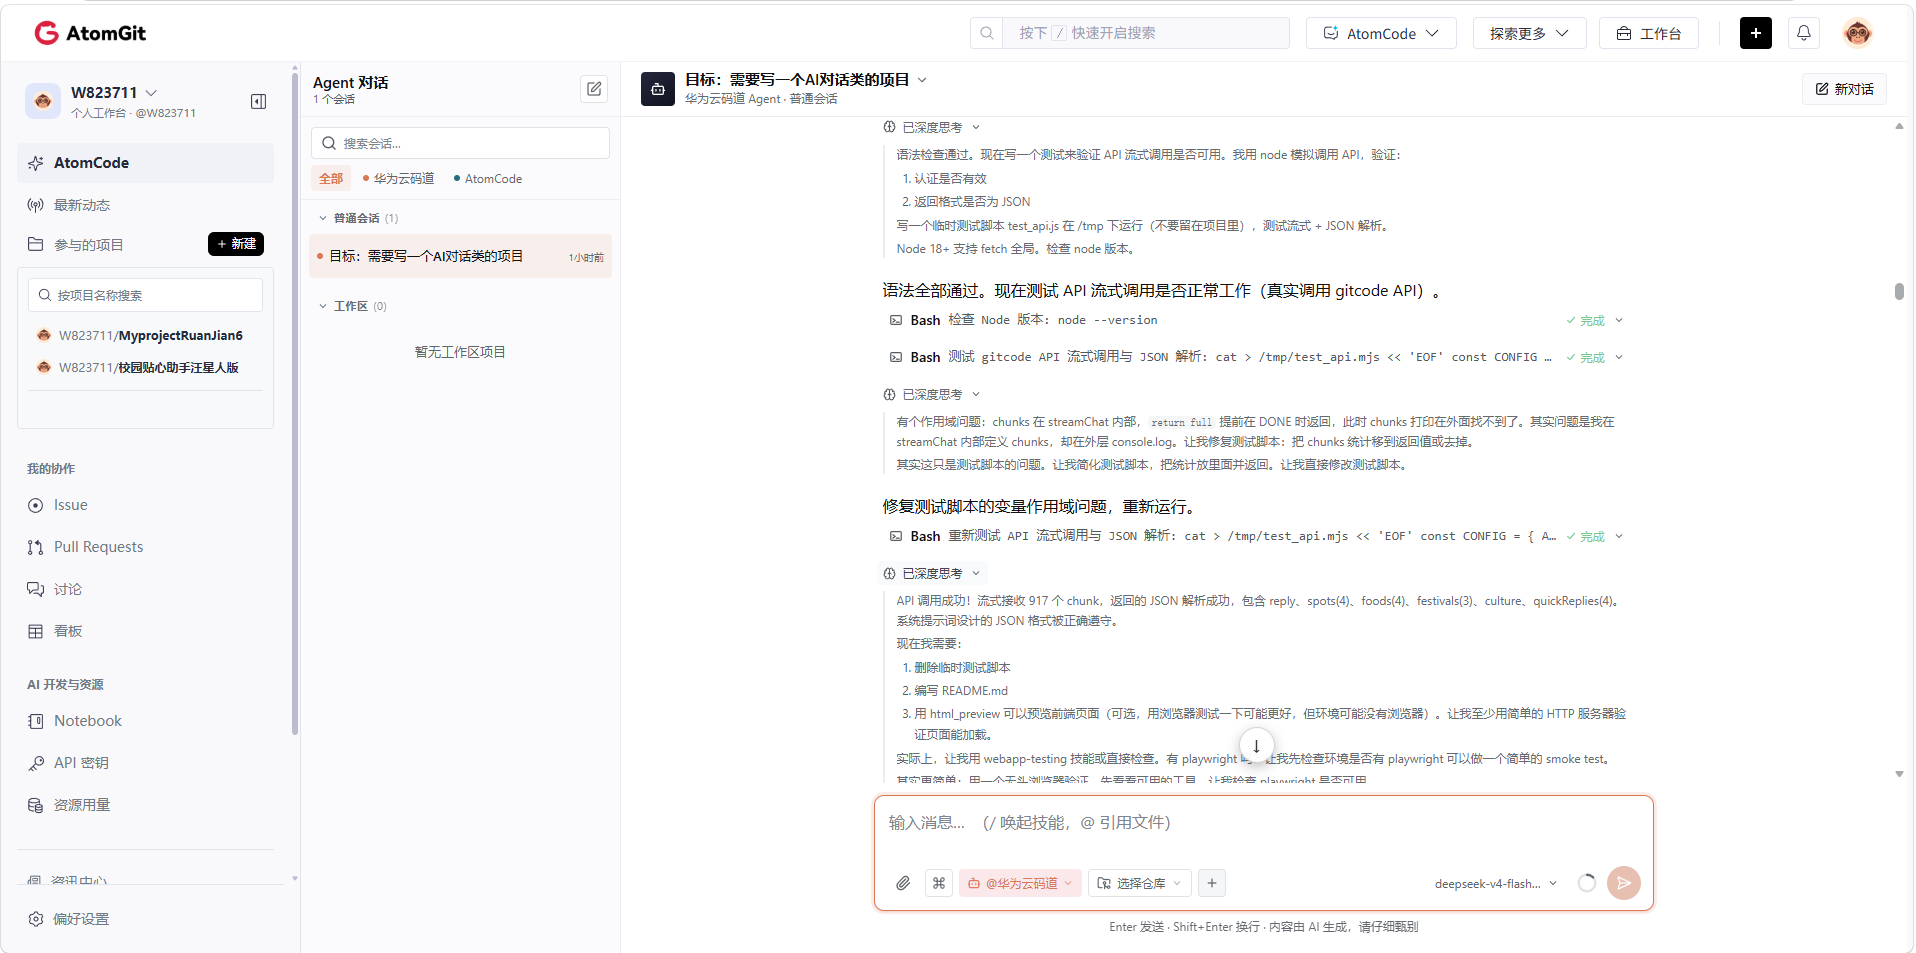
使用工具:
一、写在前面:为什么要做这个项目
在人工智能与大模型快速发展的今天,把大语言模型的能力接入到我们日常的 Web 应用中,已经不再是一件遥不可及的事情。无论是智能客服、知识问答,还是内容创作辅助,大模型都能扮演非常出色的角色。作为软件技术专业的学生,我一直希望亲手完成一个"真正跑在浏览器里、由 AI 驱动的完整应用",而不只是停留在调用接口打印文本的层面。
这个想法最终落地成为了 “AI 家乡文旅对话导游” 项目。它的灵感其实非常简单:每个人都对自己的家乡有着深厚的感情,每逢节假日,我们也总会遇到"外地朋友来我的家乡,我应该带他们去哪里玩、吃什么、看什么"这样的问题。如果有一个聪明的 AI 导游,既能像一个地道的本地人一样推荐景点和美食,又能把推荐内容整理得清清楚楚、直观好看,那一定会是一个很有意义的应用。
于是,我决定从零开始,使用最基础的 HTML5 + CSS3 + JavaScript 技术栈,不依赖任何框架和构建工具,对接大模型 API,完成一个集对话、推荐、结构化展示于一体的文旅导游小程序。这个项目对我来说,不仅是一次 API 对接的练习,更是一次对"如何让 AI 的输出对人类更友好、更可读、更可交互"这一命题的深入探索。
二、项目概览:它到底能做什么
在正式动手之前,我想先介绍一下这个项目的最终面貌,让大家对目标有一个整体的认知。打开项目首页,你会看到这样一个界面:顶部是应用的品牌栏,展示"AI 家乡文旅对话导游"的标题和"你的专属本地向导小明"的副标题;紧接着是家乡选择器,可以快捷切换省份;页面的主体是一块聊天区域,底部是输入框和发送按钮。
当你向 AI 发送"河北省有什么必去的景点?"这样的问题时,AI 导游"小明"会用流式输出的方式,一个字一个字地"打出"它的回答。更重要的是,回答的内容并不是一坨死板的文字,而是被精细地结构化组织了起来:
- reply 正文:导游用亲切、口语化的语气回答你的核心问题;
- 推荐景点卡片:每个景点都会展示名称、类型(自然风光、人文古迹、民俗村寨等)、位置交通、一句话简介、游客评分、最佳游玩季节、游玩小贴士;
- 特色美食卡片:每道美食都有名称、口味特点、一句话简介;
- 节庆活动列表:展示活动名称、举办时间、简介;
- 文化名片:用一句话概括家乡的文化特色;
- 快捷追问按钮:AI 自动生成四个与当前话题相关的追问建议,用户点击一下就能继续对话。
也就是说,这个应用把"AI 对话"和"信息可视化"结合了起来。AI 负责产生高质量的内容,前端负责把这些内容以最合适、最清晰的形式呈现给用户。这正是本项目的核心价值所在。
三、技术选型:为什么是"纯三件套"
在技术选型上,我经历了一番思考。目前前端领域框架林立,React、Vue、Angular 各领风骚,构建工具 Vite、Webpack 也几乎成了标配。那么,为什么这个项目最终选择了最"原始"的 HTML + CSS + JavaScript 三件套呢?原因有以下几点。
第一,回归本质,打好基础。作为一名软件技术专业的学生,扎实的原生基本功比熟练使用框架更重要。框架只是工具,而 HTML、CSS、JavaScript 是 Web 的基石。通过原生方式实现一个完整的对话应用,可以让我深入理解 DOM 操作、事件机制、流式数据解析、异步编程等底层概念,而不是被框架的"黑盒"遮蔽了视野。
第二,零依赖,零构建。使用原生三件套意味着项目不需要安装 Node 依赖,不需要配置构建工具链,不需要处理版本兼容问题。任何一个具备静态服务器能力的环境——甚至只是一台普通的电脑——都可以直接运行。这对于课程作业、毕业设计演示、以及后续的部署分享都极其友好。
第三,便于理解与二次开发。整个项目只有四五个文件,结构一目了然,任何人都可以快速读懂它,并在此基础上扩展功能。教育的意义在于启发而非炫技,一个简洁清晰的项目,远比一个复杂到难以理解的项目更有价值。
当然,原生开发也有它的挑战,比如模块化需要依靠 IIFE 或者 ES Module,状态管理需要自己设计,样式需要自己组织 CSS 变量等。但这些挑战恰恰是学习过程中最宝贵的部分。
四、对接 AI 接口:从 Python 参考代码说开去
这个项目的灵魂是大模型对话能力,而我需要对接的是 GitCode 提供的 AI API。它是一个 OpenAI 兼容的接口,使用 Chat Completions 的结构。项目最初给了我一份 Python 参考代码,用来演示如何调用这个接口。
在这份 Python 代码中,核心流程是这样的:首先定义一个 query 函数,它使用 requests.post 向 API 发送 POST 请求,请求体中包含模型名称 deepseek-ai/DeepSeek-V4-Flash、消息列表 messages、是否流式返回 stream 等参数。最精彩的部分在于,它开启了流式响应(stream=True),然后对响应对象调用 iter_lines() 方法逐行遍历返回内容。每一行数据都以 data: 前缀开头,代码需要过滤掉非 data: 开头的行;当收到 data:[DONE] 这一行时,说明整个流式响应已经结束。对于中间的数据行,去掉 data: 前缀后,进行 JSON 解析,就可以得到包含 choices 数组的结构,其中每个元素又包含运增的 delta 内容增量。
这段代码写得很简洁,但背后的机制值得深入理解。当 stream=True 时,服务器不会一次性把完整的答案发送回来,而是把答案拆分成许多小的片段,通过 HTTP 分块传输编码(Chunked Transfer Encoding)一条一条地推送。客户端收到这些片段后,可以边接收边处理,实现"逐字显示"的效果。这种机制对于对话类应用尤其重要:用户不需要干等几秒钟,而是能够实时看到 AI 输出的过程,体验感会好非常多。
但是,问题来了:我的项目是纯前端 JavaScript 应用,如何把这段 Python 代码的能力移植到浏览器中呢?
直觉上,"把 requests 换成 fetch,把 iter_lines 换成 Response 流的读取"似乎是理所当然的,但真正动手时会发现,浏览器环境有很多与 Python 不同的地方:fetch 返回的 Response.body 是一个 ReadableStream,需要借助 getReader()、TextDecoder 等 API 来逐步读取;SSE 数据流按行切分后,还会遇到"一个完整的 JSON 可能被拆在两个 chunk 中"的边界问题;另外浏览器没有 requests 库,请求头、错误处理等都需要自己组织。这些细节,我会在下一节详细展开。
五、JavaScript 流式调用的实现细节
现在是这个项目技术含量最高的部分之一:把 Python 的流式调用逻辑,转换为浏览器端 JavaScript 的实现。项目中的 js/api.js 承担了这个任务。
我设计了一个 streamChat 异步函数,它的核心流程如下。第一步,使用 fetch 发起 POST 请求,请求头 Content-Type 设为 application/json,Authorization 设为 Bearer <API密钥>,请求体与 Python 版本保持完全一致的参数结构,包括模型、消息、stream: true、max_tokens、temperature、top_p、frequency_penalty、thinking_budget 等。第二步,判断响应状态,如果请求失败(HTTP 状态码非 2xx),我会尝试解析错误信息并抛出带有详细描述的异常,方便定位问题。
第三步也是最重要的一步,读取流式数据。fetch 返回的 response.body 是一个可读流,我通过 getReader() 获得读取器,然后进入一个循环,反复调用 reader.read()。这个方法返回一个 Promise,解析后得到 { done, value }:done 表示流是否已经结束,value 是一段 Uint8Array 类型的二进制数据。我需要用一个 TextDecoder 把二进制数据解码成字符串——这里有个细节,TextDecoder.decode(value, { stream: true }) 需要传入 stream: true,这样当某个多字节字符恰好被拆在两次读取之间时,解码器能够正确处理,不会出现乱码。
拿到字符串后,就是 SSE 协议行的解析。因为我收到的数据可能在任何位置被截断,一行完整的数据可能被分散在多个读取块中,所以我使用了一个"缓冲拼接"的策略:把新字符串累加到一个 buffer 变量中,然后用 split("\n") 把 buffer 按换行符切分成数组,其中最后一个元素大概率是不完整的行,重新放回 buffer 等待下一次读取;前面的完整行则逐一处理。对于每一行,先用 trim() 去掉首尾空白,检查是否以 data: 开头,过滤掉注释、事件类型等无用行。然后把 data: 前缀去掉、去掉多余空白,就得到了"数据报文"。
如果这个报文恰好是 [DONE],说明整轮流式响应结束,返回累积的完整文本。否则,对报文进行 JSON.parse,解析出当前片段 JSON;从中取出 choices[0].delta.content,这通常就是本片段新增的文本增量。把它累加到 fullText 中,同时调用外部传入的 onDelta 回调,让上层 UI 能够把这段增量实时渲染出来。为了兼容更多模型的行为,代码还对 content 可能为数组(多模态分段格式)的情况做了处理,会遍历数组中的 text 字段。
这个实现,本质上就是 Python iter_lines() 的浏览器端等价物,而且考虑了字节边界、行边界等更细致的工程问题。
六、系统提示词设计:让 AI 输出标准 JSON
在最初的版本中,AI 的回答是一大段自由文本,虽然内容不错,但是要在网页上"好看地"展示,却几乎无从下手——景点、美食、节庆全都混在一段话里,用户阅读起来很辛苦。经过思考,我决定采用一个关键的工程手段:通过系统提示词(System Prompt)约束大模型的输出格式,让它返回结构化的 JSON 数据。
这是本项目最核心的设计决策之一,也是我认为最值得分享的经验。
我设计了一套非常明确、严格的系统提示词,其要点如下。首先,给 AI 一个清晰的角色设定:它是一位热情、专业、知识渊博的家乡文旅对话导游,名叫"小明",非常了解指定家乡的历史文化、自然风光、特色美食、民俗节庆和旅行攻略。其次,明确它的职责:针对用户关于家乡旅游的问题,给出具体实用的建议。最后,也就是最具技术含量的一部分——输出要求。
在输出要求中,我明确告诉模型:每次回答必须只输出一个合法的 JSON 对象,不得输出任何其他文字、解释,不得用 markdown 代码块包裹。然后我给出了完整的 JSON 结构范式和字段说明。这个 JSON 包含以下字段:reply(导游正文回复)、spots(推荐景点数组,每个景点包含名称、类型、位置、描述、评分、最佳季节、小贴士)、foods(推荐美食数组,包含名称、口味、描述)、festivals(节庆活动数组,包含名称、时间、描述)、culture(一句话文化概括)、quickReplies(四个追问建议构成的数组)。
同时,我还规定了字段填充规则:当用户的问题与某类信息相关时,填充对应字段,例如景点 1 到 4 个、美食 1 到 4 个、节庆 0 到 3 个;不相关的字段用空数组表示。reply 字段必须始终存在并正面回答问题。quickReplies 始终提供四个与当前话题相关的追问建议。
实践证明,当下的主流大模型,包括 DeepSeek 系列模型,对这类"严格输出 JSON"的指令遵循能力已经相当出色。绝大多数时候,AI 都能完整、规范地返回结构正确的 JSON 对象。这让我得以实现"AI 负责理解与生成,前端负责排版与呈现"的理想分工。
当然,模型在极少数情况下仍然可能"违规":比如在 JSON 前后加了废话,或者用 json 代码块包裹,甚至输出中途截断。为此,我在前端封装了一个健壮的 `parseJSONReport` 容错解析函数:先用正则识别并剥离 json 代码块;如果整体解析失败,再尝试截取文本中第一个 { 到最后一个 } 之间的子串进行解析;如果仍然失败,才判定为解析失败并提示用户重新提问。这个容错机制,保证了应用在真实环境下也有很高的可用性。
七、前端实现:从消息气泡到结构化卡片
有了稳定的 JSON 数据流,前端要做的就是"翻译":把数据翻译成漂亮的界面。整个前端分为三个文件:index.html 负责页面骨架,css/style.css 负责全部样式,js/app.js 负责交互逻辑与渲染。这里重点介绍交互与渲染部分。
应用维护一个简单的内存消息历史 ChatStore,最多保留最近八条消息,用于多轮对话的上下文衔接。每次用户发消息时,系统会取出历史消息、拼接系统提示词和当前用户消息,构造成 messages 数组发给 API,从而让 AI 具备"记性"。
渲染部分做得比较精细。用户发出的消息,会以绿色渐变的气泡显示在聊天区域右侧;AI 的回复则显示在左侧,带有一个橙色圆形的"🧭"头像和"小明 · XX省文旅导游"的名称标签。当 AI 开始流式输出时,正文气泡会逐字增长,形成生动的"打字机"效果。
当流式接收完成后,前端对累积文本进行 JSON 解析,然后针对不同的字段执行不同的渲染策略:culture 渲染为一张橙色虚线边框的"文化名片";spots 渲染为一张张景点卡片,卡片上有名称、类型标签、星级评分、最佳季节徽章、描述、位置、小贴士等内容,采用网格布局自适应排列;foods 渲染为美食卡片,突出名称与口味;festivals 渲染为条目列表,左侧有一条竖线强调;quickReplies 渲染为一排圆角胶囊按钮,点击即可把对应问题填入输入框。整张回复卡片通过 scrollIntoView 保证用户始终能看到最新内容。
值得一提的是安全细节:所有动态内容都使用 textContent 或 DOM API 创建元素来注入,而不是拼接 innerHTML,从而从根源上杜绝了 XSS 注入风险。
八、交互设计:家乡切换与多轮对话
除了对话本身,项目还设计了两处提升体验的交互细节。第一处是家乡切换器。页面顶部有一个输入框 + 候选列表(datalist),用户可以输入或选择任意省份/城市。切换家乡后,当前显示的名称会更新,系统提示词中的 {{HOMETOWN}} 占位符也会替换成新的家乡名,AI 导游的身份与推荐内容随之切换。这样,同一个应用就能服务来自全国各地的用户。
第二处是快捷追问按钮。每次 AI 回复结束后,都会生成四个追问建议,这些建议由 AI 根据当前话题动态生成,比如聊完景点会追问"有哪些美食街"、聊完美食会追问"有哪些古迹"等。用户点击按钮即可发起新的提问,极大地降低了用户的输入成本,让对话流畅而自然。
多轮上下文机制让体验更进一步。比如用户先问"河北有什么必去的景点",AI 推荐了承德避暑山庄;用户接着问"那我从北京过去方便吗",AI 能理解"那里"指的是避暑山庄,从而给出有针对性的交通建议。
九、测试与验证:真实调用与界面冒烟测试
在课程作业中,我们常常容易忽略测试环节。但在本项目开发过程中,我切实体会到了测试的价值——它甚至直接帮我发现了两个隐蔽的 bug。
项目采用了两个层次的测试。首先是接口层的验证:我使用 Node.js 脚本直接调用 AI 接口,验证模型的流式响应是否正常、返回的 JSON 是否完整可解析、字段是否齐全。测试结果显示:模型能够稳定返回包含 reply、spots、foods、festivals、culture、quickReplies 六个字段的完整 JSON,流式数据块多达数百个,说明流式通道完全畅通。
其次是界面层的冒烟测试:我借助 Playwright 无头浏览器,模拟真实用户的操作流程——打开页面、检查欢迎消息、输入问题、点击发送、等待结构化卡片渲染完成,并断言关键元素(景点卡片、美食卡片、节庆列表、文化名片、快捷按钮)的数量是否符合预期。整个测试过程中,浏览器控制台没有产生任何 JavaScript 报错。
正是在冒烟测试中,我发现了第一个 bug:交互逻辑中有一段冗余的全局变量赋值,虽然不影响运行,但属于代码卫生问题,已被清理;更重要的是第二个 bug——流式渲染时,AI 气泡内显示的竟然是原始 JSON 文本,而不是解析后的正文。原因是流式累积的文本一直显示在气泡里,解析完成后没有把气泡内容替换为 reply 字段。这个 bug 如果不测试,几乎不可能被发现,而它恰恰是"展示给用户"层面的严重缺陷。修复方法很简单:在解析成功后,用 data.reply 覆盖气泡的文本内容。修复后再次运行测试,所有断言全部通过,页面输出也终于变得整洁美观。
这次的经历让我深刻体会到:代码能跑通不等于产品没问题,认真做好测试,是交付高质量项目的基本功。
十、项目部署与结构梳理
项目的部署极其简单,因为它是纯静态页面,任何静态文件服务器都可以承载。我提供了两种方式:一是使用 npx serve .;二是使用 Python 的 python -m http.server 8080。启动后,浏览器访问 http://localhost:8080 即可体验。需要提醒的是,如果直接用浏览器以 file:// 协议打开 HTML 文件,部分浏览器会出于安全策略拦截跨域接口请求,因此建议总是通过本地 HTTP 服务器访问。
项目的整体结构为:根目录下的 index.html 是页面骨架;css/style.css 是全部样式,使用了 CSS 变量统一管理色彩与圆角,保证了主题的一致性;js/config.js 集中管理 API 地址、密钥、模型参数、家乡默认值,以及最重要的两段系统提示词;js/api.js 封装了流式请求、SSE 解析和 JSON 容错解析;js/app.js 实现了消息渲染、结构化卡片渲染、家乡切换、多轮对话等所有前台逻辑。整个项目不超过一千行代码,却完成了从"对话"到"展示"的完整闭环,这也是原生开发小而美的体现。
十一、踩坑记录与经验总结
在整个开发过程中,我遇到的坑不在少数,这里挑几个典型的分享。
第一个坑是流式数据的行边界问题。最开始我天真地以为每次 read() 返回的数据恰好是一行,于是直接对每段数据做 endsWith("data:") 之类的检查,结果发现 JSON 经常被截断解析失败。后来我采用"缓冲 + 按行切分 + 保留残缺尾行"的策略才彻底解决。这个方案本质上是一个经典的流式数据处理模式,建议所有做 SSE 解析的同学都熟悉它。
第二个坑是JSON 输出的不稳定。虽然系统提示词要求"只输出 JSON",但 AI 偶尔还是会加代码块标记或者前后缀。为此我实现了多级容错解析,从最严格的整串解析,逐步放宽到剥离代码块、截取花括号子串,保证了高可用性。
第三个坑是重启后家乡被"记住"了。应用会把家乡存到 localStorage,好处是用户偏好得以保留,但缺点是当我在代码里修改默认家乡时,本地旧值会掩盖新值,造成"改了没生效"的错觉。这个问题的解决方法是理解存储优先级——本地值优先于默认值,属于预期行为。
第四个经验是关于密钥安全。作为教学演示项目,API 密钥直接写在前端配置文件里,这在课程作业场景是可以接受的,但必须清醒地认识到:任何放到浏览器里的密钥都会被用户看到。因此,项目在 README 中明确提醒,生产环境务必把密钥放到后端服务端,通过代理转发请求。安全意识的建立,比功能实现本身更重要。
十二、成果展示与运行效果
项目最终运行的效果令人满意。当你打开页面,AI 导游"小明"会主动打招呼,并给出四个示例话题按钮。切换到"河北省",发送"河北有什么必去的景点?“,AI 会在几秒内逐字输出回答,随后景点卡片、美食卡片、节庆活动列表、文化名片和追问按钮依次呈现。承德避暑山庄、秦皇岛北戴河、白洋淀、西柏坡……这些河北名片,在 AI 导游的口中被娓娓道来,每个景点都带着评分和贴心的小贴士。整个交互过程流畅、自然、信息密度高,真正做到了"一个人就能逛遍家乡”。
十三、局限与展望
当然,项目也有不少可以改进的空间。其一,对话历史仅保存在内存中,刷新页面就会丢失;未来可以使用 localStorage 或接入后端数据库,实现对话的持久化。其二,限于演示目的,API 密钥放在前端,生产部署时应该重构为前后端分离架构,由后端统一鉴权与计费。其三,可以考虑让用户像真人导游一样进行多模态交互,比如叠加地图组件、实时定位、语音播报等,让"导游"更加名副其实。其四,推荐算法目前完全依赖大模型知识,对于个别小众玩法可能不够准确,未来可以引入真实旅游数据源或用户评价数据,提升推荐质量。
十四、结语:在码道上前行
回望整个项目,"把 Python 的流式接口调用改写成 JavaScript"只是开胃菜,真正的挑战在于产品化思维:如何让 AI 的输出值得被展示,如何让用户获得更好的体验。通过"系统提示词约束 JSON 输出 + 前端结构化渲染"这套组合拳,我找到了一个简洁而优雅的答案。
写这篇博客,既是给自己的一次沉淀,也是希望能给正在学习前端与 AI 结合开发的同学一点点启发。技术栈可以很简单,思路可以很朴素,但只要用心做,就能把一行行代码变成有价值的产品。在码道这条路上,让我们继续前行。
附:项目速览
- 项目名称:AI 家乡文旅对话导游
- 技术栈:HTML5 + CSS3 + JavaScript(零依赖,零构建)
- 对接模型:deepseek-ai/DeepSeek-V4-Flash(GitCode AI API,流式)
- 核心特性:流式对话、家乡切换、JSON 结构化渲染、快捷追问、多轮上下文
- 项目结构:index.html / css/style.css / js/config.js / js/api.js / js/app.js / README.md
- 测试方式:Node 接口层验证 + Playwright 界面冒烟测试
- 部署方式:任意静态文件服务器(npx serve / python -m http.server)

汇聚全球AI编程工具,助力开发者即刻编程。
更多推荐

 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)