
码道:从零构建一个带 Swagger 文档的学生管理 API:FastAPI + 内存存储实战
一、写在前面
在日常开发中,我们经常会遇到一个尴尬的场景:前端同学已经写好页面了,后端接口却还在评审中;产品想要快速验证一个想法,数据库表结构却还没定下来。这时候,一个"轻量到看一眼就能跑起来"的接口服务就显得尤为重要。
本文要分享的,就是这样一个基于 FastAPI 的学生信息管理接口项目。它实现了对学生表的完整增删改查(CRUD)操作,数据存储只用了一个内存列表,不需要安装任何数据库;更贴心的是,FastAPI 内置的 Swagger UI 会自动生成一份可交互的接口文档,让接口调试变得前所未有的直观。整个项目代码量不大,但五脏俱全,非常适合作为学习 RESTful API 设计、FastAPI 框架入门的实战素材,也可以直接改造成团队内部接口联调的 Mock 服务。
二、为什么选择 FastAPI
在选择技术栈时,我对比过 Flask、Django 和 FastAPI 这三条最常见的 Python Web 开发路线。
Flask 以"微框架"著称,灵活小巧,但很多能力需要自己手动拼装,比如序列化、参数校验、接口文档,每一样都要引入第三方库或自己造轮子。
Django 功能强大,自带 ORM、Admin 后台、用户认证等一整套体系,是大型项目的首选;但对于一个演示性质的小项目来说,它显得有些"重量级",起步成本较高。
FastAPI 则恰好站在两者的中间位置:它基于现代化的 Python 类型注解(Type Hints)构建,天生自带三大杀手锏——自动数据校验(通过 Pydantic)、自动生成 OpenAPI 规范文档(Swagger UI 和 ReDoc 是免费的)、异步高性能(基于 Starlette 和 ASGI,吞吐能力在纯 Python 框架中名列前茅)。换句话说,只要你写出类型注解,文档、校验、序列化这些"麻烦事"框架全都替你包办了。这正是我选择 FastAPI 的核心原因。
三、项目整体设计
在设计上,我参考了企业级应用的常见分层思路,把项目拆成了三个职责清晰的模块:
app/
├── main.py          # 应用入口,负责组装路由、配置文档信息
├── models.py        # Pydantic 数据模型,定义请求体和响应体
├── database.py      # 内存存储层,封装全部数据操作
└── routers/
    └── students.py  # API 路由层,只负责"接请求、调存储、返结果"
这样的分层带来一个非常明显的好处:路由层和存储层彻底解耦。未来如果要把内存存储替换成 MySQL 或 PostgreSQL,只需要改动 database.py 一个文件,路由层和模型层完全不用动。这也体现了"面向接口编程"的思想——上层的调用者只依赖存储层暴露的方法签名,而不关心底层数据到底放在内存、文件还是数据库里。
四、核心代码逐层拆解
4.1 数据模型层(models.py)
这一层用 Pydantic 定义了四类模型:StudentBase 定义学生共有的基础字段,StudentCreate 用于新增请求,StudentUpdate 用于更新请求,Student 则是完整的响应模型。
Pydantic 最强大的地方在于声明式校验。比如年龄字段,我只写了一句 age: int = Field(..., ge=0, le=150),年龄范围校验就自动生效了——传入负数或者 200 岁都会被框架拦截,返回 422 校验错误。这在传统框架里往往要手写一堆 if 判断,在 FastAPI 里只需一个类型注解。
更新的部分字段特性也很值得一提。StudentUpdate 里所有字段都是可选(Optional)的,配合存储层的 exclude_unset=True,可以实现"传哪个字段就更新哪个字段"的局部更新语义,而不是要求前端每次都必须提交完整对象。这在真实业务中非常实用。
4.2 存储层(database.py)
存储层用 Python 内置的 list 作为容器,为了模拟数据库的自增主键,使用了 itertools.count 这个无限计数迭代器,每次新增自动 next() 得到一个新 ID。
这里有一个容易被忽略但很重要的细节:线程安全。虽然我们用的是内存列表,但 Web 服务通常是多线程并发处理请求的,如果多个请求同时读写这个列表,可能出现数据不一致甚至崩溃。所以我引入了 threading.RLock(可重入锁)保护所有写操作,读操作也统一加锁保证可见性。代码虽小,但"并发安全"这个意识值得每一位后端开发者刻在脑子里。
存储层的增删改查方法非常直白:
def create(self, payload) -> Student: ...
def list_all(self, keyword, page, page_size) -> dict: ...
def get_by_id(self, student_id) -> Student | None: ...
def update(self, student_id, payload) -> Student | None: ...
def delete(self, student_id) -> bool: ...
其中 list_all 还支持关键字过滤和分页:先用列表推导式按姓名或班级做模糊匹配,再按页码切片。分页返回的总数 total、页码 page、每页数量 page_size 一起打包给前端,方便前端渲染分页控件。
另外,构造方法里我预设了三条种子数据,让项目克隆下来就能立刻在 Swagger 里看到数据,省去手动造数据的步骤。演示项目,体验很重要。
4.3 路由层(routers/students.py)
路由层是标准的 RESTful 风格设计:
| 方法 | 路径 | 作用 |
|---|---|---|
| POST | /students | 新增学生 |
| GET | /students | 查询列表(支持搜索、分页) |
| GET | /students/{id} | 查询单个学生 |
| PUT | /students/{id} | 更新学生 |
| DELETE | /students/{id} | 删除学生 |
RESTful 的核心思想是"用 HTTP 方法表达动作,用资源路径表达对象"。同样的资源 /students,GET 表示查询、POST 表示新增、PUT 表示整体/局部更新、DELETE 表示删除,语义一目了然。
每个路由函数都很"薄",典型的 Controller 职责:接收参数 → 调用存储层 → 处理结果 → 返回响应。比如查询详情时,如果存储层返回 None,就抛出 HTTPException(404);更新删除同理。这种"薄路由 + 厚服务"的结构,让每个函数都短小精悍,可读性和可测试性都很好。
接口文档的描述也很完善。我给每个接口都写了 summary(标题)和 description(详细说明),这些会在 Swagger UI 中直接展示,等于把接口的"使用说明书"写进了代码里,一份改动一份同步,永不脱节。
4.4 应用入口(main.py)
入口文件负责创建 FastAPI 实例并配置文档元信息。你可以给整个服务设置标题、版本、联系方式和描述,这些信息都会呈现在 Swagger 页面上。然后通过 app.include_router(students.router) 把路由挂载进来,一个完整的服务就组装完成了。
4.5 从发起到返回:一次请求的完整旅程
为了更直观地理解这个项目,不妨跟着一条真实的 POST 请求走一遍完整链路。当前端调用 POST /students 并提交 JSON 请求体后,FastAPI 首先会根据路由表找到 create_student 这个处理函数;接着,框架依据 StudentCreate 的类型声明自动完成请求体解析与校验——如果 name 缺失或者 age 超出了 0 到 150 的范围,请求在此处就会被拦截,直接返回 422 校验错误,根本不会进入业务代码。
校验通过后,处理函数调用存储层的 create 方法,拿到自增 ID 并组装成完整的 Student 模型;FastAPI 再根据响应模型 response_model=Student 对返回对象做一次过滤序列化,确保响应中不会多出任何未声明的字段,最后以 201 状态码把 JSON 返回给前端。在这条链路里,框架替我们承担了路由、校验、序列化三件最琐碎的工作,而业务代码只需要关注"数据怎么存、怎么查"。
另外值得一提的是全局错误处理。存储层返回 None 表示资源不存在时,路由层统一抛出带中文提示的 404 异常,例如"学生 ID=1 不存在"。这种统一、可读的异常信息,对前端联调和排查问题非常友好。
五、Swagger 文档,零成本获得
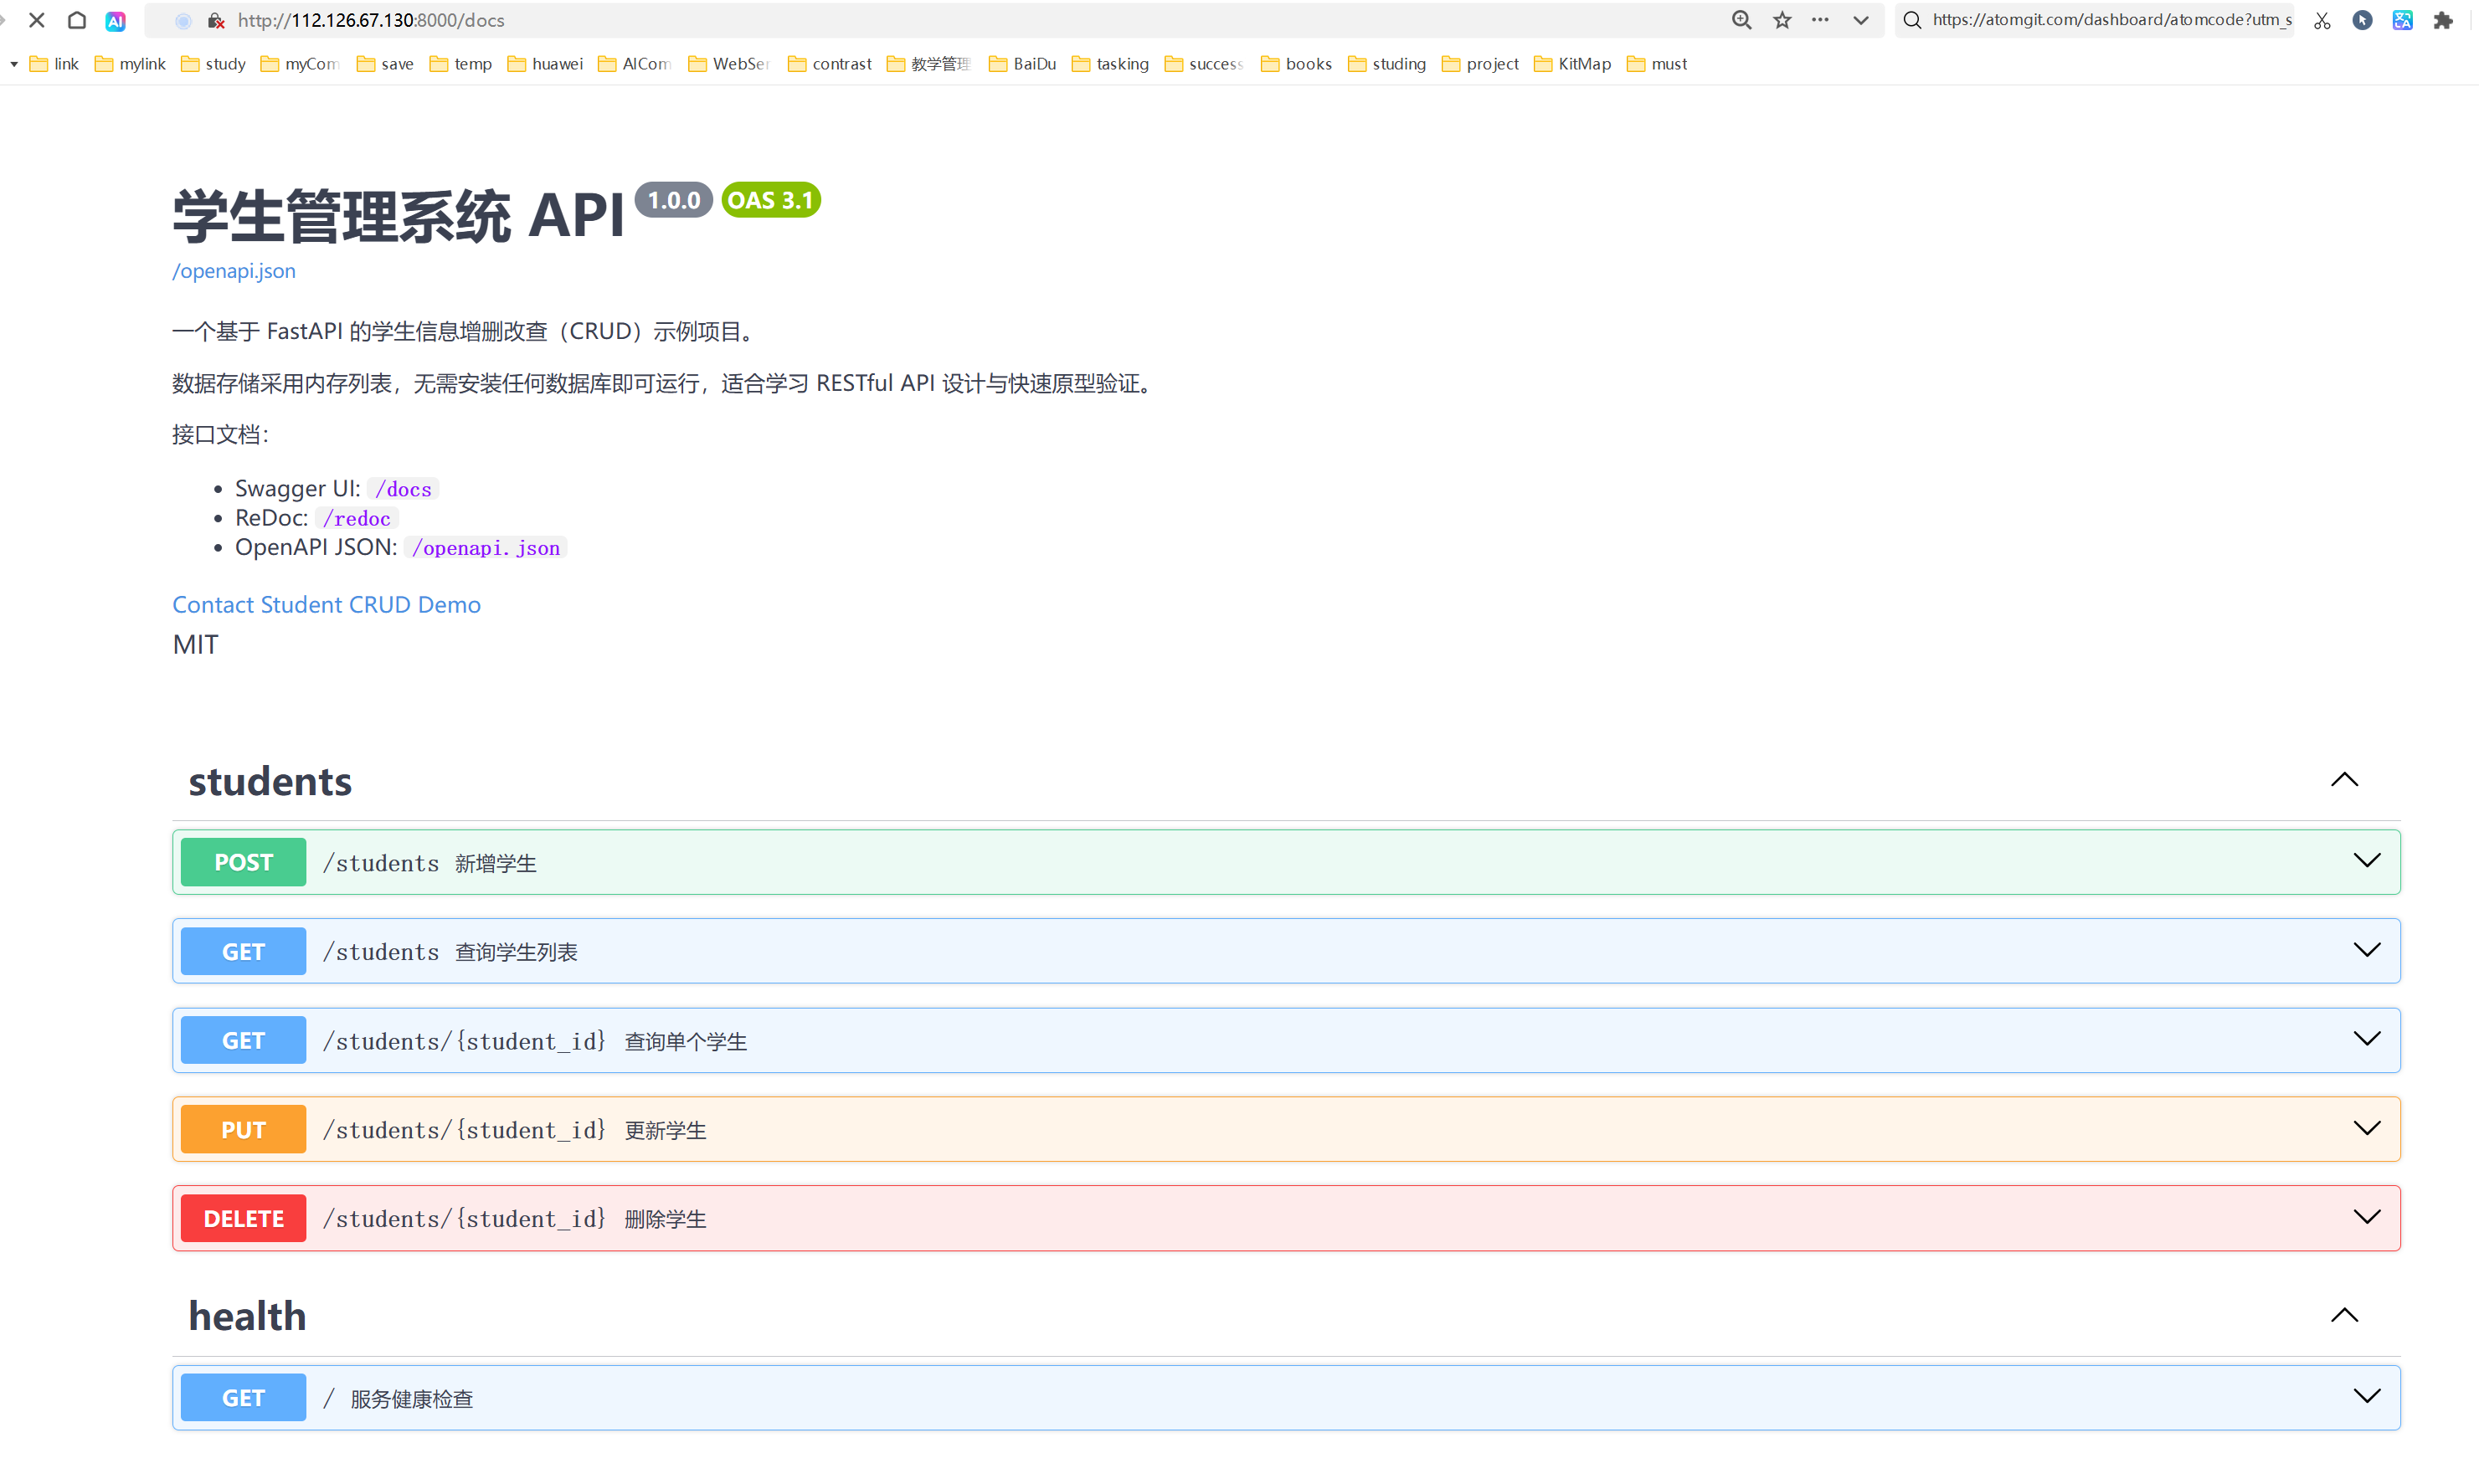
这是 FastAPI 最让我惊艳的部分。我们一行文档代码都没写,仅仅运行服务,访问 http://localhost:8000/docs,一份完整、可交互的 API 文档就自动生成了。
打开 Swagger UI,你会看到:
- 所有接口按 Tag(标签)分组展示,标题、描述齐全;
- 每个接口的请求参数、请求体结构、响应结构一目了然,字段说明来自我们写的
Field(description=...); - 点击 “Try it out” 按钮,可以直接在网页里填入参数、发送真实请求、查看响应结果——接口调试器的功能基本齐了,无需 Postman 也能完成完整的功能验证。
这背后是 FastAPI 基于 Pydantic 模型自动推导出的 OpenAPI 规范(旧称 Swagger)。除了 UI,还有 /openapi.json 直接暴露机器可读的规范文件,可以导入 Postman、Apifox 等工具;/redoc 则提供另一种更偏阅读型的文档排版。也就是说,从接口定义到文档、到测试工具对接,整条链路都是自动化的。
六、测试:给代码上保险
只有代码没有测试,就好像开车不系安全带。这个项目我写了 11 个单元测试用例,覆盖了完整的使用路径:
- 正常流程:新增成功、列表查询、关键字搜索、部分字段更新、删除成功;
- 异常流程:查询/更新/删除不存在的 ID 返回 404;
- 参数校验:年龄为负数时返回 422;
- 元信息:OpenAPI 规范中确实包含
/students路径。
测试用 FastAPI 自带的 TestClient 实现,不需要真的启动服务,直接在进程内模拟 HTTP 请求和响应,速度快、隔离性好。值得一提的是,每个用例执行前都会重置内存数据(setup_function),保证用例之间互不干扰——这是单元测试的基本原则,否则测试结果会随机波动。
在 CI 流水线里加上 pytest -v 这么一行,每次提交代码都会自动跑一遍全量回归,心里就踏实多了。
七、快速上手指南
想让这个项目在本地跑起来只需三步:
# 1. 安装依赖
pip install -r requirements.txt

# 2. 启动服务
uvicorn app.main:app --host 0.0.0.0 --port 8000 --reload

# 3. 打开浏览器访问 http://localhost:8000/docs
--reload 参数会在代码修改后自动重启服务,开发调试非常方便。配合 README 里提供的 curl 命令示例,前后端联调、接口自测都不在话下。
用 curl 做一轮完整 CRUD 演练也非常直观,比如新增一条学生记录:
curl -X POST http://localhost:8000/students \
  -H "Content-Type: application/json" \
  -d '{"name":"张三","age":18,"gender":"男","class_name":"一年级一班"}'
返回的 JSON 里自动带上了自增 ID(id: 1)和创建时间,一条记录就稳稳地躺进了内存列表。
八、收获与展望
写这个小项目,与其说是在"写代码",不如说是在验证一套工程化的方法论:
第一,利用框架的生态红利。FastAPI 把类型系统利用到了极致,让校验、序列化、文档、测试这些原本耗时的工作全部自动化。作为开发者,与其重复造轮子,不如站在框架的肩膀上,把精力花在真正的业务逻辑上。
第二,分层与解耦的价值。三个模块各司其职,任何一个都可以独立替换。这种"高内聚、低耦合"的设计,让项目从第一天起就具备了演进的能力。
第三,文档即代码。把接口描述写在模型的 description 里,让文档与代码永远同步,比维护一份独立的 Word 接口文档可靠得多。
与此同时,我们也必须清醒地认识到内存存储方案的边界与局限。列表数据只存活于进程内,服务一重启数据就烟消云散;实例只开一个进程时没问题,一旦横向扩容成多实例,各实例之间的数据就完全无法共享;更不用说并发量上来之后,内存容量的上限近在眼前。因此这个项目定位清晰:它是学习脚手架、是原型验证工具、是联调 Mock 服务,而不是生产级数据系统。理解了它"能做什么、不能做什么",我们才能在未来选择合适的技术方案时更加从容。
当然,这个项目还只是一个"骨架",有很多可以继续优化的方向:比如加入 SQLite/MySQL 等真实持久化存储;增加 JWT 用户认证与权限控制;补充分页游标、排序、批量操作等高级接口;部署到 Docker 容器并接入 CI/CD 流水线。如果你感兴趣,完全可以顺着这条路径把它扩展成一个完整的生产级系统。
项目代码已开源托管在 AtomGit,欢迎克隆学习、提出建议,也欢迎把你的奇思妙想 Fork 出来继续改造。希望这篇小小的分享,能给你带来一点点启发。

汇聚全球AI编程工具,助力开发者即刻编程。
更多推荐

 0
 0
- 0


 已为社区贡献10条内容

所有评论(0)