
码道:从零打造一个 AI 猜谜小游戏「趣猜小馆」
项目仓库:https://atomgit.com/gcw_YN1BNv05/ruanjian6demo_0918
一次完整的前端项目实践记录:纯 HTML + CSS + JavaScript 对接大模型接口,让 AI 扮演茶馆掌柜,与玩家玩猜谜游戏。本文记录从创意萌发、架构设计、接口对接、协议设计到测试上线的全部过程与踩坑心得。
运行实例效果: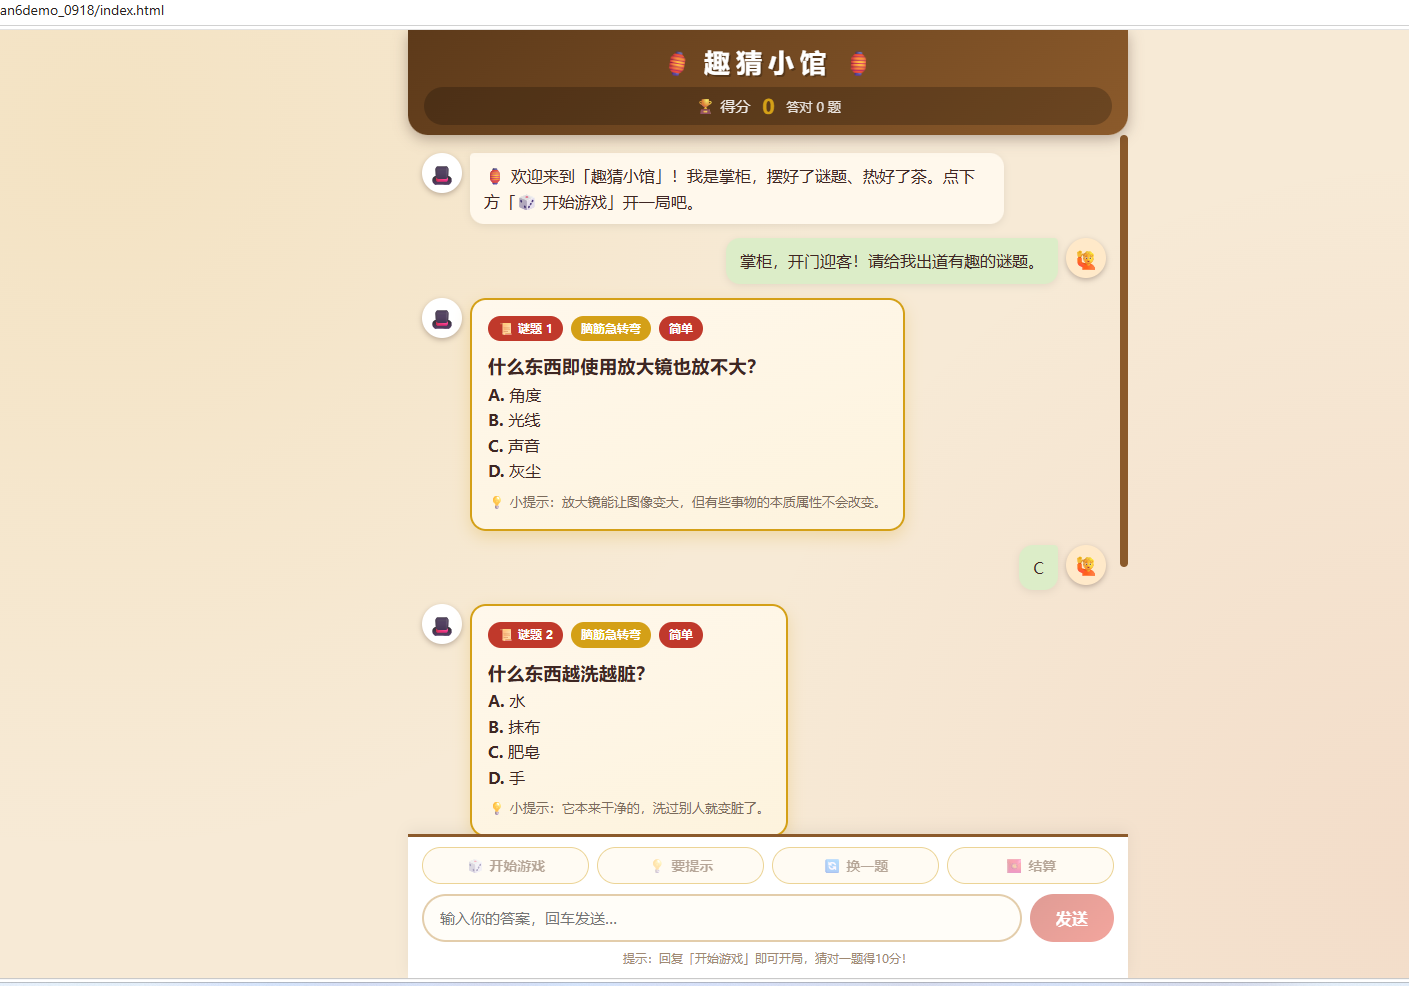
使用工具: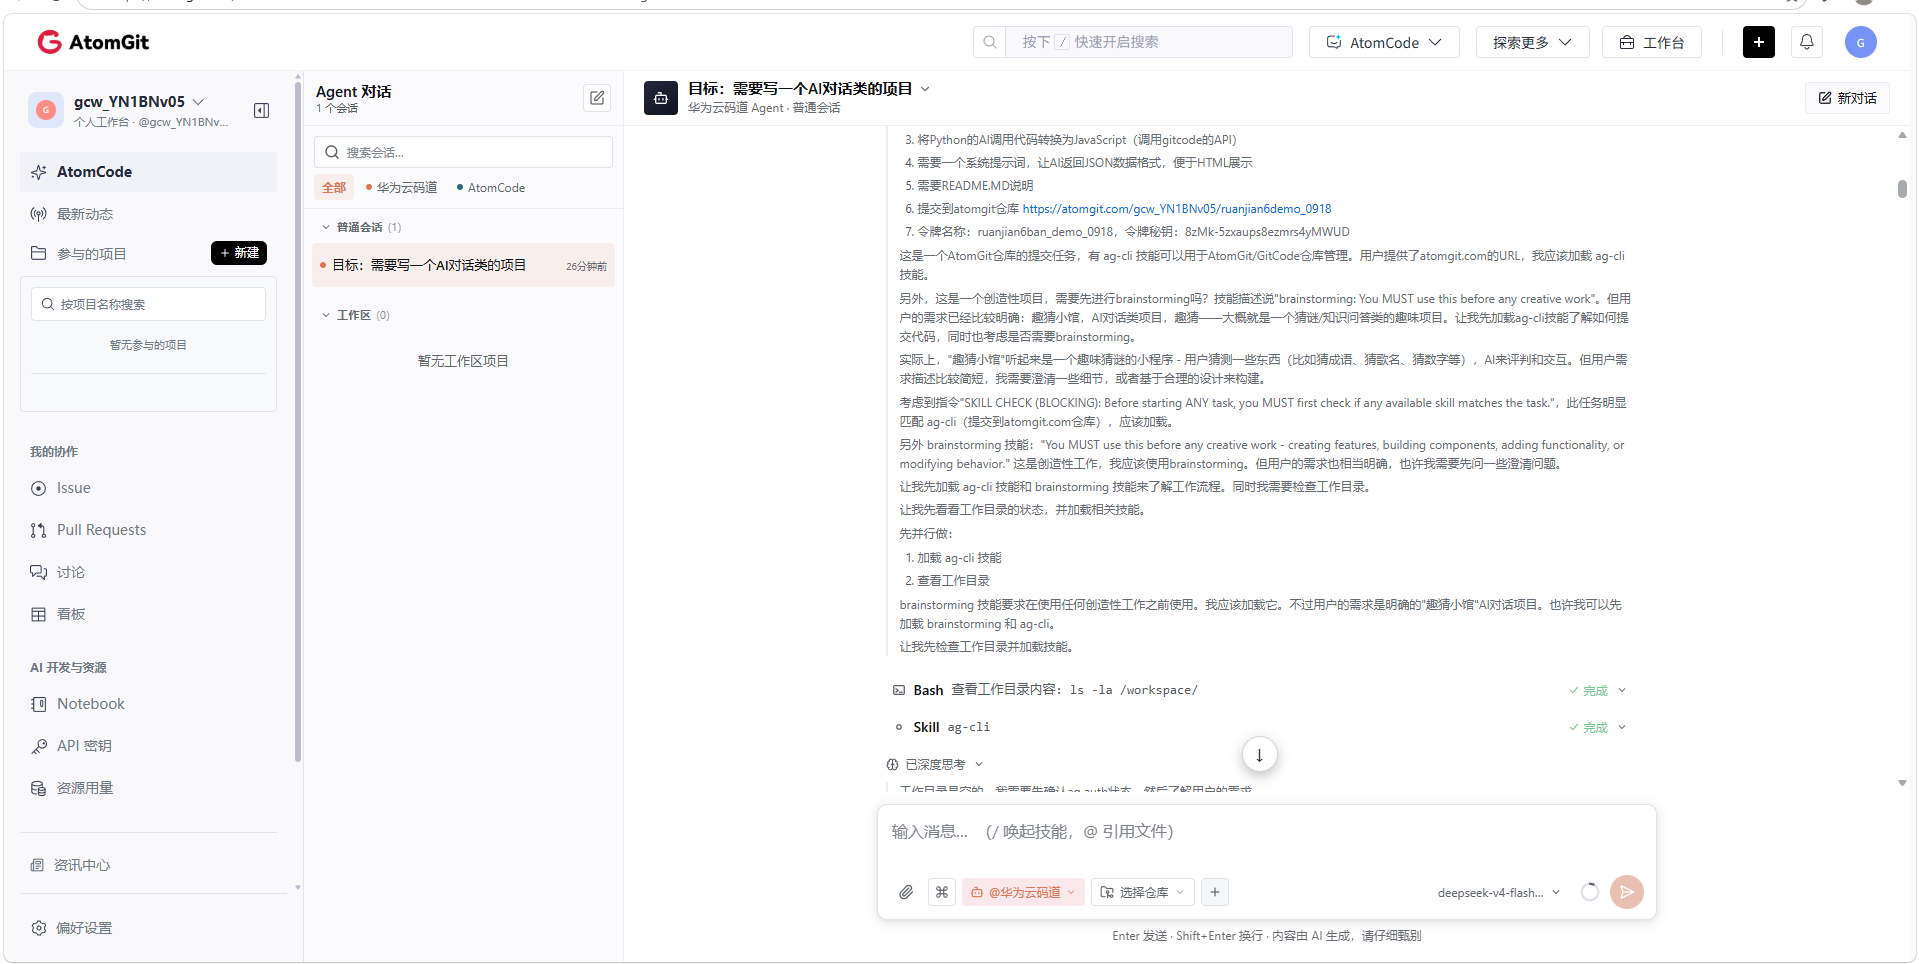
一、缘起:为什么想做「趣猜小馆」
作为一名软件专业的学生,我一直在思考一个问题:如何把大模型的能力真正放进一个让人愿意打开、愿意玩下去的产品里。市面上对话机器人很多,但大多数聊天界面千篇一律——输入框在底部,消息一上一下,AI 顶多换个皮。这样的产品很容易做完就忘。
我想做一个有场景、有人设、有正反馈的 AI 小应用。
于是「趣猜小馆」这个概念在我脑海里逐渐成型:一间开在巷子口的中国风小馆,掌柜是一位风趣幽默的老先生,专给来往客人出谜题。客官(玩家)进店,掌柜出题,玩家猜答案,猜对了掌柜热情表扬,猜错了掌柜给台阶提示。整个体验如同一场轻松愉快的茶馆对话。
选择猜谜作为核心玩法,我有三点考虑:
- 交互密度高。猜谜天然是"一问一答、判断对错"的闭环,非常契合对话式 AI 的节奏,不需要复杂的多轮状态机。
- 正反馈明确。猜对加分、猜错给提示,玩家长久停留的动机来自"下一题我能不能答对"。
- 题材广阔。脑筋急转弯、字谜、成语谜、生活冷知识、谐音梗、数学小趣题……AI 大模型的生成能力在这里可以充分释放。
项目名最终定为「趣味」+「小馆」的组合,透着一股烟火气,也和掌柜的设定自洽。
二、技术选型:为什么是纯前端
这个项目的技术选型其实非常简单,就三个词:HTML5、CSS3、JavaScript。没有任何框架,没有任何构建工具,也没有任何后端服务。打开 index.html 就能玩。
有人可能会问:对接大模型接口,密钥放前端不是会泄露吗?这确实是生产环境必须面对的问题。但作为课程演示项目,纯前端方案有三个不可替代的优点:
- 零成本部署。GitHub Pages / Gitee Pages / 本地双击即可运行,不需要服务器、不需要域名、不需要运维。
- 学习价值最大化。没有框架黑盒,每一个 DOM 操作、每一次事件绑定都是手写的,最能巩固基本功。
- 演示方便。答辩、演示、发给同学看,一个文件拖进浏览器就完事。
当然,我在 README 里明确写了生产环境注意事项:密钥应放在后端、由服务端转发请求。演示归演示,安全意识不能丢。
界面风格我选了中国风茶馆主题:深棕木纹配色、米黄纸张质感、红灯笼元素、楷书风格的标题。原因很朴素——「小馆」两个字天然就该配这种调性,视觉风格和玩法能够互相强化,玩家第一眼就能读出"这是家猜谜茶馆"。
三、参考代码与核心挑战:Python 到 JavaScript 的转换
项目启动时,我拿到了一段现成的 Python 参考代码,它演示了如何调用大模型接口:
import os
import requests
import json

API_URL = "https://api-ai.gitcode.com/v1/chat/completions"
headers = {
    "Authorization": f"Bearer {API_KEY}",
}

def query(payload):
    response = requests.post(API_URL, headers=headers, json=payload, stream=True)
    for line in response.iter_lines():
        if not line.startswith(b"data:"):
            continue
        if line.strip() == b"data:[DONE]" or line.strip() == b"data: [DONE]":
            return
        yield json.loads(line.decode("utf-8").lstrip("data:").rstrip("/n"))

chunks = query({
    "model": "deepseek-ai/DeepSeek-V4-Flash",
    "messages": [{"role": "user", "content": "告诉我一个有关宇宙的有趣事实?"}],
    "stream": True,
    "max_tokens": 2048,
    "temperature": 0.6,
    "top_p": 0.95,
    "frequency_penalty": 0,
    "thinking_budget": 2048
})

for chunk in chunks:
    print(chunk["choices"])
这段代码的思路非常清晰:向接口发起 POST 请求,开启流式传输(stream=True),然后逐行读取响应体,只处理以 data: 开头的行,解析其中的 JSON,直到遇到结束标记 data:[DONE]。
但浏览器环境和 Python 环境有本质区别:Python 的 requests 库在本地直接建立 TCP 连接、按行迭代即可;而浏览器中的 JavaScript 不能写原生 socket,只能通过 fetch API 发起请求,并且必须借助 ReadableStream 配合 TextDecoder 才能逐块读取响应体。
所以我设计了下面这张转换对照表:
| Python(requests) | JavaScript(fetch + ReadableStream) |
|---|---|
requests.post(..., stream=True) | fetch(url, { method: "POST", body }) |
response.iter_lines() | response.body.getReader() 循环 reader.read() |
| 字节解码 | new TextDecoder("utf-8") |
line.startswith(b"data:") 过滤 | line.startsWith("data:") 过滤 |
line.strip() == b"data:[DONE]" | data === "[DONE]" |
json.loads(...) | JSON.parse(...) |
yield 逐块产出 | fullContent += delta.content 累积 + 回调 |
转换过程中有个容易踩的坑:SSE 流是按字节切割的,一个 JSON 行可能被拆成两半。Python 里 iter_lines() 会自己处理这个边界,而 JavaScript 需要手动维护一个 buffer(缓冲区):
const reader = resp.body.getReader();
const decoder = new TextDecoder("utf-8");
let buffer = "";
let fullContent = "";

while (true) {
  const { done, value } = await reader.read();
  if (done) break;
  buffer += decoder.decode(value, { stream: true });

  const lines = buffer.split("\n");
  buffer = lines.pop();   // 最后一段可能是不完整行,留到下一轮拼完

  for (const rawLine of lines) {
    const line = rawLine.trim();
    if (!line.startsWith("data:")) continue;
    const data = line.slice(5).trim();
    if (data === "[DONE]") return fullContent;
    try {
      const chunk = JSON.parse(data);
      const delta = chunk.choices[0].delta;
      if (delta && delta.content) {
        fullContent += delta.content;
        if (onProgress) onProgress(fullContent);
      }
    } catch (e) { /* 忽略无法解析的碎片 */ }
  }
}
这段代码的精髓在于 buffer = lines.pop():每次把按换行符切好的完整行拿出来处理,把最后可能残缺的半行留在 buffer 里,等下一次 reader.read() 的数据到来再拼接。这个"留半行"的技巧,是整个流式解析正确性的关键。
我把完整的接口封装抽取为 js/api.js,包含三个函数:buildHeaders()(构造请求头)、buildPayload(messages)(构造请求体)、chatStream(messages, onProgress)(核心流式对话方法)。三者各司其职,职责清晰。
四、最核心的设计:让 AI 输出结构化 JSON
把 Python 代码转成 JavaScript 只是热身,真正的设计难点在于:如何让 AI 的输出不再是自由文本,而是一份前端可以直接消费的结构化数据?
如果 AI 每次自由发挥,前端就只能做"显示一大段文字"这一件事,谈不上"更好的展示"。我的解决方案是:用系统提示词(System Prompt)与 AI 约定一套 JSON 协议,强制它按协议输出。
这个思路在工程上很常见——把语言模型当作一个"结构化的函数",输入是对话历史,输出是符合 schema 的 JSON。大模型经过系统提示词的强约束后,通常能稳定地输出想要的结构。
4.1 协议设计
我设计了一套 5 种类型的 JSON 协议,对应前端 5 种不同的卡片渲染:
类型一:welcome(开场欢迎)
{
  "type": "welcome",
  "data": {
    "text": "热情的开场白,向客人介绍小馆和玩法"
  }
}
类型二:question(出题)
{
  "type": "question",
  "data": {
    "category": "脑筋急转弯",
    "question": "谜题正文",
    "options": ["选项A", "选项B", "选项C", "选项D"],
    "hint": "一句不直接透露答案的提示",
    "difficulty": "简单 | 中等 | 困难"
  }
}
其中 options 是可选字段:当题目是选择题时带上,是填空题时省略。
类型三:result(判定答案)
{
  "type": "result",
  "data": {
    "correct": true,
    "correctAnswer": "正确答案",
    "userAnswer": "玩家刚才输入的内容",
    "feedback": "风趣点评",
    "explanation": "为什么是这个答案",
    "hint": "答错时的下一步提示,答对时留空字符串"
  }
}
类型四:chat(普通对话)
{
  "type": "chat",
  "data": {
    "text": "掌柜说的话"
  }
}
类型五:gameover(结算)
{
  "type": "gameover",
  "data": {
    "correctCount": 本局答对题数,
    "totalCount": 本局共出题数,
    "comment": "对本局表现的整体点评"
  }
}
4.2 系统提示词的措辞技巧
协议设计出来了,关键问题是:怎么让 AI 稳定遵守协议,不输出 JSON 以外的废话?
通过多轮实验,我总结了系统提示词的三个措辞要点:
- 明确"必须"与"禁止"。不能说"你可以输出 JSON"(太弱),要说"你的每一次回复都必须是【单个合法 JSON 对象】“,同时声明"禁止输出 JSON 以外的任何文字、解释、注释,禁止使用 Markdown 代码块包裹”。
- 给出完整的示例结构。模型对"说清楚格式"比"说清楚规则"更敏感,把每个类型的完整 JSON 示例贴进提示词,命中率会大幅提升。
- 补充语义级约束。比如"出题后,下一轮才能判定答案,中间别自言自语",这能防止模型在一次回复里连出多题或自问自答。
最终的系统提示词长这样(节选):
你的每一次回复都必须是【单个合法 JSON 对象】,禁止输出 JSON 以外的任何文字、解释、
注释,禁止使用 Markdown 代码块包裹。JSON 只有以下 5 种结构,按场景二选一输出:

1. 出题(收到"开始"、"换一题"、"出题",或一局完成后再接新题时):
{"type":"question","data":{...}}

2. 判定客人答案(收到答案,或点了"结算"之前最后判定):
{"type":"result","data":{...}}

3. 普通对话(闲聊、求助、回答一般性问题):
{"type":"chat","data":{...}}

4. 结算(客人要求结算,或连续答对 3 题时主动提议结算):
{"type":"gameover","data":{...}}

5. 开场欢迎(客人第一次进入,或说"在吗""你好"时):
{"type":"welcome","data":{...}}
4.3 前端容错:不信任模型的每一次输出
尽管有系统提示词强约束,我还是写了 parseAiJson() 容错函数。原因很简单:模型输出虽然稳定,但不是绝对可靠的。在实际测试中,偶尔会出现这些情况:
- 输出被意外包裹在 Markdown 代码块里(` ```json … ````)
- JSON 前面有零星补充说明文字
- 极少数情况拼接错误导致 JSON 直接解析失败
我的容错方案有三级:
- 先
trim()清洗首尾空白。 - 用正则剥掉可能的 Markdown 代码块围栏。
JSON.parse失败时,尝试截取第一个{到最后一个}之间的子串再解析。
如果三级都失败,就降级为"纯文本气泡"显示原始输出,保证用户永远不会看到白屏或报错。这个"尽力解析 + 优雅降级"的思路,是接入大模型接口时最值得借鉴的工程习惯。
五、前端界面实现
5.1 HTML 骨架
页面结构分三块区域:
<header class="topbar">    <!-- 顶部:招牌 + 计分板 -->
<main class="chat-panel">  <!-- 中间:消息流 -->
<footer class="control-panel">  <!-- 底部:快捷按钮 + 输入框 -->
顶部是店铺招牌「趣猜小馆」,两侧各挂一盏红灯笼(用 emoji 🏮 + CSS 摇摆动画实现,氛围感直接拉满),下面是一行计分板,实时显示「🏆 得分」和「答对 N 题」。
中间是消息流区,所有消息卡片都在这里按时间顺序渲染。底部是控制区:四个快捷按钮(开始游戏 / 要提示 / 换一题 / 结算)加输入框和发送按钮。
5.2 卡片化渲染:同一份数据,不同种形态
前端把 AI 的 JSON 响应对应为不同类型的卡片,这是整个"更好的显示"的核心:
| JSON 类型 | 渲染的卡片 | 视觉特点 |
|---|---|---|
welcome | 欢迎气泡 | 普通对话气泡,加粗欢迎语 |
question | 题目卡片 | 金黄色描边、三个彩色小标签(题号 / 分类 / 难度)、大号加粗谜题、下方灰字小提示 |
result | 结果卡片 | 答对绿色边框(🎉 猜对啦!+加分),答错红色边框(🤔 可惜没猜中 +正确答案 + 台阶提示) |
chat | 普通气泡 | 掌柜 🎩 头像 + 白纸气泡 |
gameover | 结算红包卡 | 暖金色渐变背景、居中大字"打烊结算"、得分面积最大 |
渲染函数统一放在 app.js 中,每个 renderXxx() 函数接收 JSON 的 data 部分,拼出对应 HTML。所有用户可控制的内容都经过 esc() 函数做 HTML 转义,防止 XSS 注入——比如玩家故意输入 <script> 标签,也会被原样当作文本显示。
5.3 交互状态机
纯前端项目最容易被忽视的就是状态管理。我设计了一个简单的状态机来约束交互流程:
const state = {
  score: 0,            // 总得分
  correctCount: 0,     // 本局答对题数
  totalCount: 0,       // 本局出题总数
  gameStarted: false,  // 是否已开局
  waitingAnswer: false,// 是否在等玩家答当前题
  busy: false,         // AI 是否正在回复
  history: []          // 发送给 API 的完整消息历史
};
busy 标志尤其重要:AI 请求是异步的,如果玩家在等待期间狂点发送,会发出大量并发请求导致消息错乱。所以所有按钮和输入框都绑定在 refreshButtons() 上——busy 为真时全部禁用,为假时按当前游戏状态放开对应按钮的权限。
游戏流程是这样的:
- 首次点击「🎲 开始游戏」:
gameStarted = true,重置分数,初始化包含系统提示词的history,发送"掌柜,开门迎客!请给我出道有趣的谜题。" - AI 返回
question:totalCount++,waitingAnswer = true,渲染题目卡片。 - 玩家输入答案发送:追加到
history,AI 返回result,根据correct字段加分并更新计分板。 - 玩家可随时「💡 要提示」「🔄 换一题」「🧧 结算」。
- 结算:AI 返回
gameover,渲染结算红包卡,gameStarted复位。
这里有个细节:AI 的记忆靠 history 数组。每次对话后我都把 {role: "user"} 和 {role: "assistant"} 两条消息追加进数组,下次请求时连同系统提示词一起发给接口。这样掌柜才能记得住是他在出题、玩家答过什么。这是对话式应用最基本也最重要的机制。
5.4 加载状态与反馈
异步请求期间,如果界面毫无反应,玩家会以为卡死了。我加了一个"掌柜正在酝酿"的加载气泡:一盏摇晃的红灯笼,配三个跳动的打字圆点,外加一行会变化的提示文字。虽然是细节,但对整体体验的提升非常明显。
六、测试过程与踩坑记录
写代码只是第一步,真正让项目成立的是测试环节。我先后做了三轮验证:
6.1 第一轮:接口连通性测试
首先用 curl 直接向接口发请求,验证接口可用、模型可用、鉴权正确。这一步能快速排除"密钥错了"“模型名错了”"网络不通"等低级问题。
curl -s -X POST "https://api-ai.gitcode.com/v1/chat/completions" \
  -H "Authorization: Bearer $API_KEY" -H "Content-Type: application/json" \
  -d '{ "model": "deepseek-ai/DeepSeek-V4-Flash", "messages": [...], "stream": true }'
6.2 第二轮:流式解析验证
用 Node.js 写了一个临时测试脚本,模拟浏览器环境调用 fetch,验证 SSE 流解析逻辑是否正确。重点验证三点:
- 是否能把流式片段正确累积成完整 JSON;
- 是否能在
[DONE]时正确终止; - 是否能在 JSON 前出现废话时正确容错。
6.3 第三轮:端到端对话验证
这是最关键的验证。我用 Node 跑了一个完整的模拟对话,把系统提示词原封不动塞进去,依次发送三句话:
- “掌柜,开门迎客!请给我出道有趣的谜题。” → 期待
question - “我的答案是:蝙蝠!” → 期待
result - “掌柜,今天玩够啦,帮我结算!” → 期待
gameover
实测结果全部命中,且字段完整:
→ 掌柜,开门迎客!请给我出道有趣的谜题。
  type: question | 字段: category,question,options,hint,difficulty
---
→ 我的答案是:蝙蝠!
  type: result | 字段: correct,correctAnswer,userAnswer,feedback,explanation,hint
---
→ 掌柜,今天玩够啦,帮我结算!
  type: gameover | 字段: correctCount,totalCount,comment
6.4 踩过的坑
坑一:JS 字符串里的中文引号。 系统提示词里原本写了半角双引号,直接把一整段 JS 字符串搞砸,Node 报 SyntaxError。排查后发现是中文内容里的 "阿宝" 与 JS 字符串定界符冲突。改成书名号 『阿宝』 解决。这个坑提醒我:中文文案里的引号,一定要用中文引号字符,别用英文双引号。
坑二:SSE 流按字节切割。 见第三节所写,必须维护 buffer 处理残缺行。这在纯用 Python iter_lines() 时完全无感,是浏览器环境独有的坑。
坑三:模型偶尔不守 JSON 协议。 容错解析函数因此诞生,实测确实抓回了好几次本会渲染失败的输出。
坑四:TextDecoder 的 stream 参数。 如果 decoder.decode(value) 不加 { stream: true },遇到多字节 UTF-8 字符被截断在块边界时,会解出乱码。加上后它会缓存残字节,保证中文永远完好。
七、代码组织与可维护性
虽然是一个前端演示项目,我依然保持了清晰的文件结构:
ruanjian6demo_0918/
├── index.html        # 页面骨架
├── css/style.css     # 全部样式
├── js/
│   ├── config.js     # 配置(API 地址、密钥、模型参数、计分规则)
│   ├── api.js        # 网络层(构造请求 / 流式解析)
│   └── app.js        # 业务层(状态管理 / 协议解析 / 卡片渲染 / 事件绑定)
└── README.md         # 项目说明
这种"配置 → 网络 → 业务"的分层,即使没有框架也能保持良好的可读性。config.js 把所有可调参数集中管理,改模型、调温度、改每道题的分值,都只需要动一个文件。
在 app.js 内部,我也坚持一条原则:一个函数只做一件事。渲染函数 renderQuestion 只管拼题目卡片的 HTML,parseAiJson 只管解析,refreshButtons 只管按钮状态。函数名即注释,整个文件虽然有三百多行,但读起来依然顺畅。
八、收获与思考
「趣猜小馆」这个项目虽小,但五脏俱全,让我重新理解了"用小成本验证大想法"的魅力。
第一个收获:大模型应用的核心是"约束"而非"放开"。 同样的接口,裸聊只会得到一堆自由文本;加一道 JSON 协议的系统提示词,AI 立刻变成一台结构化的业务机器。学会用提示词规范模型的输出形态,是把大模型工程化的第一课。
第二个收获:异步编程的边界感。 浏览器的 fetch 是异步的、流式读取是异步的、按钮点击是异步的。做好 busy 状态、管好并发、设计好加载反馈,用户的体验才有保障。
第三个收获:容错意识。 依赖外部模型的输出,就等于依赖一个"概率正确"的系统。任何一步都要假设"它可能出错"并在前端消化掉。三级容错 + 优雅降级,是最好的保险丝。
第四个收获:视觉风格是产品的另一半。 同样的猜谜逻辑,换成默认白底黑字的聊天框,和换成一间有灯笼、木质招牌、金币红包的小馆,玩家体验天差地别。中国风主题不是花架子,它让产品的性格立了起来。
第五个收获:端到端验证比"感觉写完了"可靠得多。 从 curl 到 Node 模拟,再到浏览器实测,每一层验证都提前暴露了一批问题。这个"先分层验证、再整体联调"的习惯,值得带到所有项目里。
九、可能的优化与展望
项目虽然完成了,但我也清楚地看到它未来可以走得更远:
- 分类精细化:在
question里增加难度分档接口,让玩家可选"休闲 / 烧脑"模式。 - 错题本:答错的题本地存储,方便回顾复习。
- 题库主题包:古风诗人、科幻迷、体育达人……按主题定制掌柜的出题风格。
- 语音交互:接上 Web Speech API,掌柜用嘴念题,玩家用嘴回答。
- 排行榜与邀请:接入轻量后端,让朋友之间互相 PK。
- 安全加固:密钥后移,改为服务端转发,这是上生产的必做项。
十、结语
从一段 Python 参考代码,到一个能跑、能玩、有性格的网页应用,「趣猜小馆」的路程不算长,但每一步都踩得实实在在。我把它完整地推到 AtomGit 仓库,也把过程中的思考写进这篇手记分享出来。
如果你也正在学习前端,或者想试试把大模型接进自己的小项目,这套"纯前端 + JSON 协议 + 流式解析"的组合值得抄走。下一次再见面,欢迎来「趣猜小馆」坐坐,掌柜我请你喝茶。
技术栈:HTML5 · CSS3 · JavaScript · DeepSeek-V4-Flash · fetch / SSE
关键词:AI 对话 · 流式请求 · 提示词工程 · JSON 协议 · 纯前端

汇聚全球AI编程工具,助力开发者即刻编程。
更多推荐

 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)