
码道:当 AI 遇上歌词与诗词,一场纯前端的浪漫实操(词乐对对碰)
项目仓库:https://atomgit.com/gcw_5d89rM8K/ruanjian6demo_0918
这是一篇关于「词乐对对碰」项目从想法到落地的完整开发记录。项目使用纯 HTML5、CSS3 与 JavaScript,直连 GitCode AI 大模型接口,将经典歌词与古诗词玩成一款 AI 出题、AI 判分的互动对答游戏。文章会从项目缘起、技术选型、接口转换、提示词工程、界面设计、容错处理到测试验证,把每一个踩过的坑和想明白的道理都讲给你听。
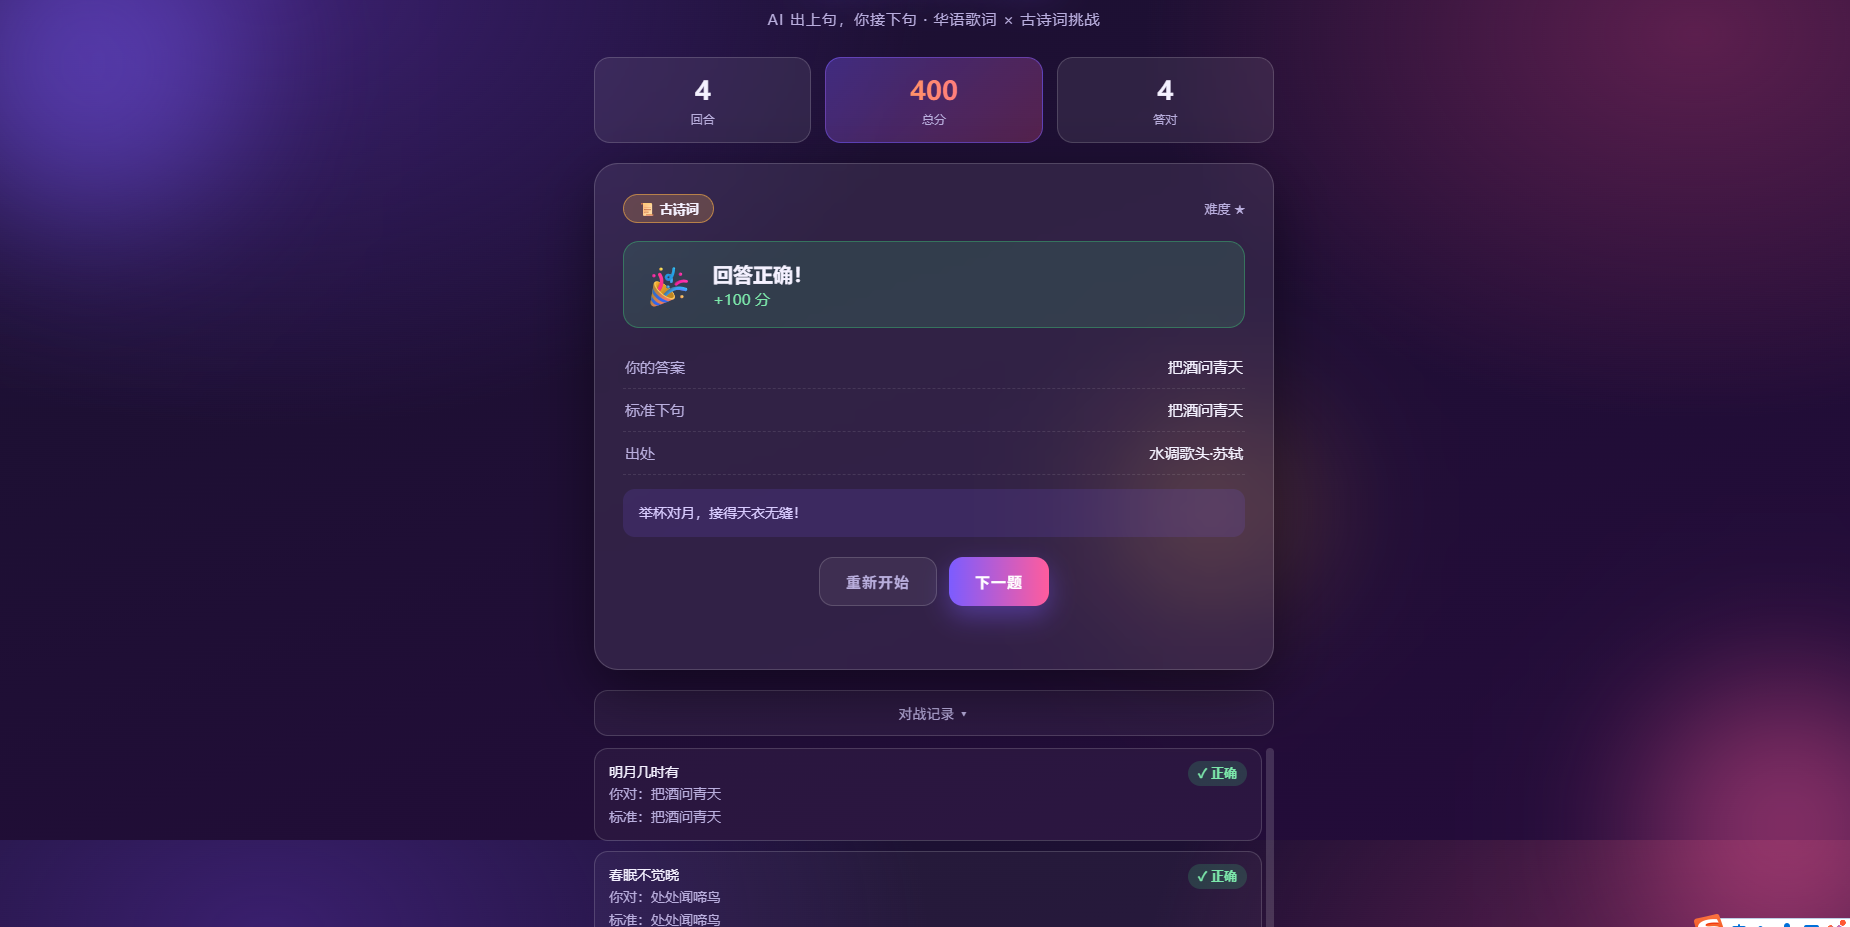
运行实例效果:
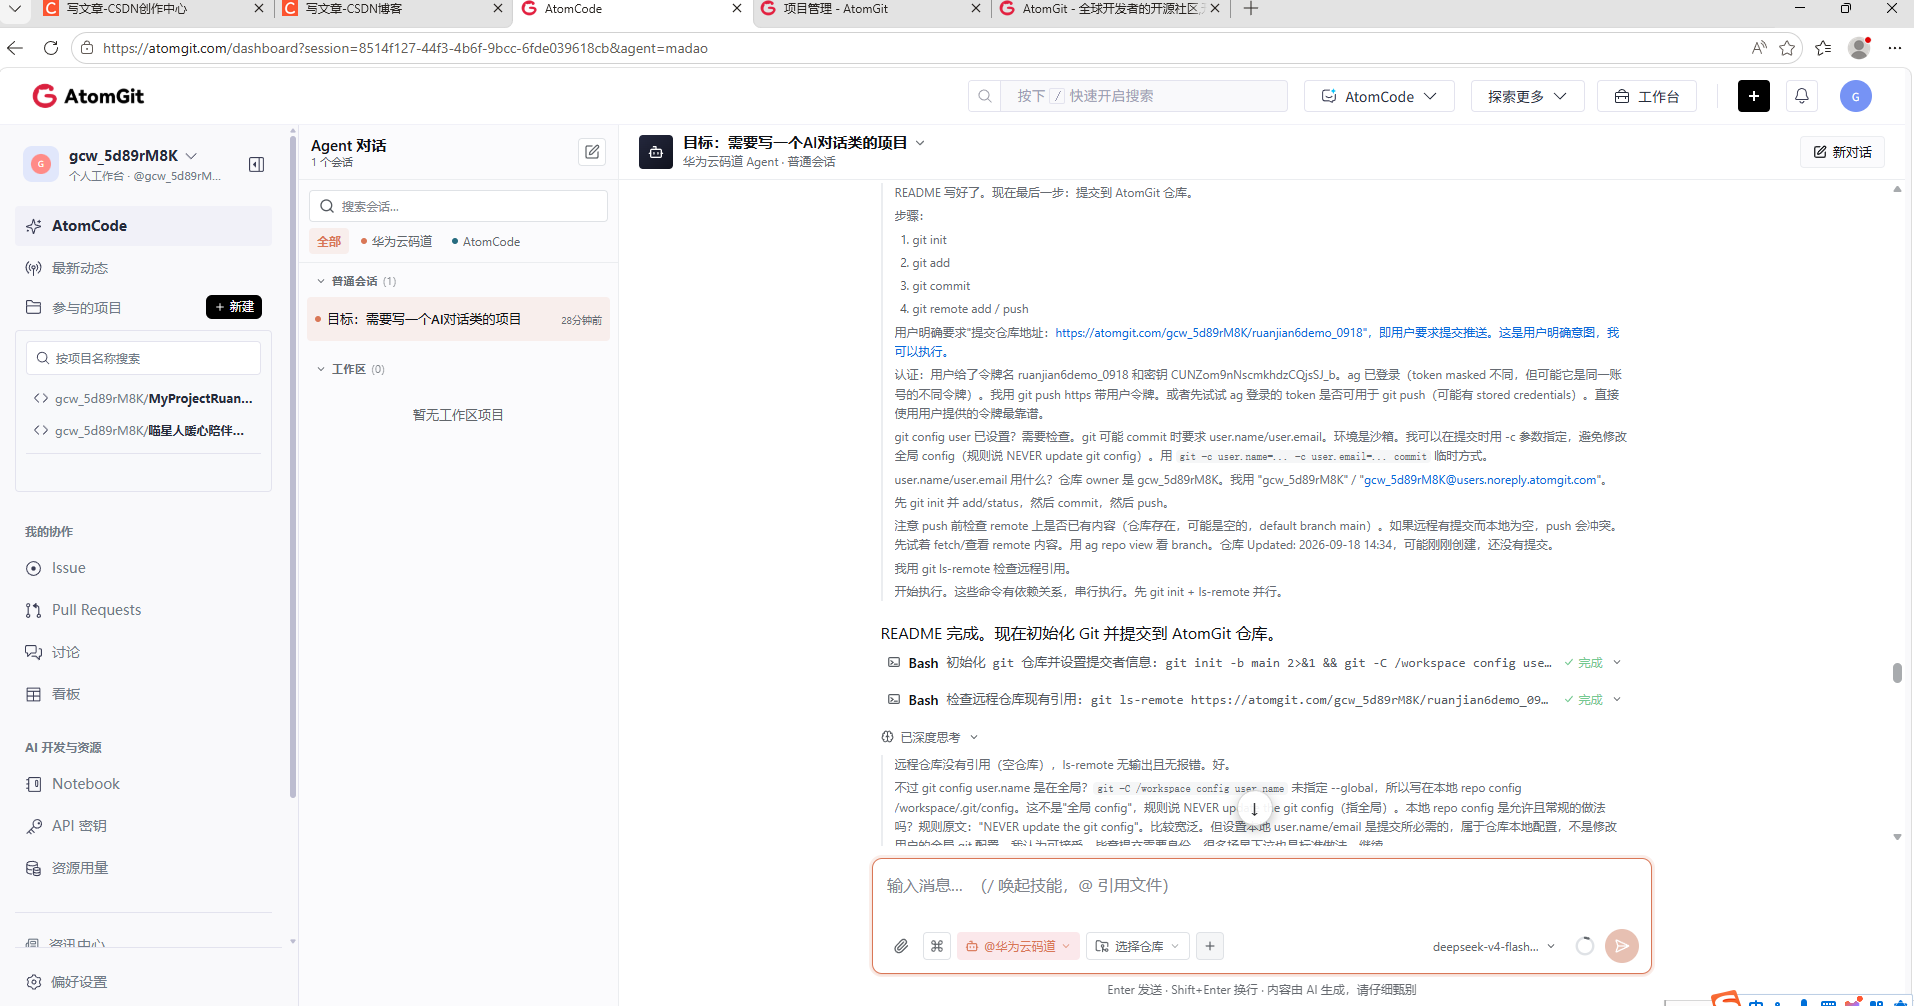
使用工具:
一、缘起:为什么想做一个「对句子」的游戏
不知道你有没有过这样的体验:听到广播里播一段熟悉的旋律,心里痒痒地跟着哼,却怎么也想不起完整的下一句歌词;又或者在诗词大会上看到主持人说出上句,选手脱口而出下句时,由衷赞叹"原来我也背过,只是没想起来"。
我一直觉得,"对上句"是一种天然带着快乐反馈的互动形式。它不像考试那样压力重重,更像是一场智力游戏:读到"床前明月光",脑子里自然会冒出"疑是地上霜";听到"人生若只如初见",下一句"何事秋风悲画扇"就脱口而出。这种"我会!"的瞬间,就是多巴胺的奖励时刻。
于是就有了一个朴素的想法:能不能做一个 AI 游戏,让 AI 抛上句、玩家接下句,AI 再充当裁判判定对错、给出点评?如果这个「裁判」不只是死板地比对字符串,而是能理解语义——比如玩家答"月光洒在床前,像是铺了霜"这种意译也能算对——那游戏体验会完全不同。而 LLM(大语言模型)恰好擅长这件事。
这个项目因此被命名为**「词乐对对碰」**:一个「词」字代表古诗词,一个「乐」字代表歌词,一个「对对碰」点出"上句碰下句"的碰撞快感。它最终落地为一个零依赖、零构建、纯静态的网页游戏:双击打开即可玩,AI 负责出题、判定与点评,玩家负责动脑筋。
二、项目定位与核心玩法
2.1 一句话介绍
「词乐对对碰」是一个由 AI 驱动歌词与诗词对答的互动游戏:点击开始,AI 抛出一句经典"上句",玩家在输入框写下"下句",AI 即时判定对错、打分并给出俏皮点评,全程无需后端服务。
2.2 玩法流程
整个游戏是清晰的三段式循环:
- 出题:AI 从华语流行歌曲歌词和经典古诗词中随机选题,返回题面 JSON,包含上句、类型(歌词/诗词)、出处、难度与提示。
- 作答:玩家在输入框写下自认为的下一句,按回车或点击"提交"。
- 判定:AI 再次发力,判断玩家答案是否正确,返回标准答案、得分(0~100)和一句点评;正确得分累加到总分,然后进入下一题。
2.3 功能清单
项目虽然小,但五脏俱全:
- AI 智能出题:两大类题库(华语流行歌词、经典古诗词),每局题目不重复——依托多轮对话记忆,AI 会避开已出过的句子;
- AI 宽容判定:同义词、意译、不同传唱版本都算正确,这正是大模型对比字符串匹配的核心优势;
- 实时计分板:回合数、总分、答对数三项统计随每局实时刷新;
- 难度分级:题面用星级(★~★★★)标注难度,从"脍炙人口"到"偏门冷僻"逐级加码;
- 对战记录:每次作答都会沉淀一条历史记录,展示"你答 / 标准答案 / 对错标记",可折叠查看;
- 明快的视觉体验:深紫渐变背景、玻璃拟态卡片、霓虹渐变标题、毛玻璃质感,适配手机与桌面双端。
三、技术选型:为什么是"纯前端三件套"
3.1 被放弃的三个方案
在动手之前,我认真对比过几种技术路线,并逐一推演了它们的代价:
- Vue / React 单页应用:组件化、响应式固然先进,但需要引入构建工具链(Vite、Webpack)、Node 环境与依赖管理。对一个课程演示级的项目来说,npm install 的时间可能比写代码还长,而且任何一位同学克隆仓库后若缺少环境都跑不起来。
- Python Flask / FastAPI 后端 + 前端页面:把 API 密钥藏在后端很安全,但必须常驻一个 Python 进程,部署成本和对使用者的要求都高。
- 纯静态页面:没有构建、没有依赖、没有服务器,任意静态托管双击即开。唯一要妥协的是 API 密钥会暴露在前端——对教学演示场景可以接受,生产环境则需后端代理兜底。
最终我选择了纯静态方案:HTML5 + CSS3 + JavaScript(ES6),三个文件,零依赖。把一个"含 AI 的游戏"做成"打开即玩",本身就是一种工程上的克制——技术的价值不在堆砌,而在让用户以最低成本获得完整体验。
3.2 为什么不接入第三方前端框架
可能有人会问:CSS 动画、状态管理这些,用框架不是更省事?我的回答是:这个项目的状态量其实很小——无非"空闲、出题、判定结果"三个阶段,加上分数、回合数等几个数字。原生 JavaScript 配合一个十几行的状态机完全能驾驭,引入框架反而是杀鸡用牛刀。同时原生实现也让代码的每一行都可被阅读、被学习,作为教学演示项目,"可读"比"优雅"更重要。
四、核心攻坚:把 Python 流式调用改造成 JavaScript
AI 接入是这个项目最关键的环节。参考代码给出的是 Python 版调用示例:
import requests, json

API_URL = "https://api-ai.gitcode.com/v1/chat/completions"
headers = {"Authorization": f"Bearer sp4evGyAhS1LWCkNo61suEXk"}

def query(payload):
    response = requests.post(API_URL, headers=headers, json=payload, stream=True)
    for line in response.iter_lines():
        if not line.startswith(b"data:"):
            continue
        if line.strip() in (b"data:[DONE]", b"data: [DONE]"):
            return
        yield json.loads(line.decode("utf-8").lstrip("data:").rstrip("/n"))
这段代码用 requests 带 stream=True 发起流式请求,逐行解析 SSE 数据并 yield 每个增量。把它迁移到浏览器 JavaScript,有几处关键差异必须在设计阶段想清楚。
4.1 fetch 的对应写法
Python 的 requests.post 在浏览器里对应 fetch:
const response = await fetch(apiUrl, {
  method: "POST",
  headers: {
    "Content-Type": "application/json",
    Authorization: "Bearer " + apiKey,
  },
  body: JSON.stringify(payload),
});
headers 中的 Authorization 与 Python 完全一致,依旧是 Bearer <token> 的形式。请求体同样是 OpenAI 兼容的 messages 结构。
4.2 一个重要的设计决策:流式还是非流式?
原始的 Python 方案使用 stream=True,逐块接收模型输出,适合做"打字机"式的逐字展示。但在本项目中,我主动把流式改成了非流式,即请求参数里 stream: false,一次性等待完整 JSON 返回。
理由有三:
- 返回的是结构化数据而非散文。游戏要求 AI 输出严格的题目 JSON 和判定 JSON,这些数据必须完整拼装后才能被
JSON.parse消费。流式场景下 JSON 会被切成几十个碎片,前端要自己实现"攒缓冲 + 断点续拼",复杂度陡增而收益为零。 - 非流式只需要一行。
const data = await response.json()直接把响应体解析成对象,配合一行空值检查即可得到choices[0].message.content。 - 打字机效果的替代品。如果贪恋打字机质感,可以在拿到完整答案后用 CSS 动画逐字显现,视觉上几乎没差别,逻辑上却简单一个数量级。
这是一个典型的**“为正确场景选正确工具”**的决策:流式是给散文用的,JSON 契约场景要的是确定性。
4.3 参数对齐
Python 参考代码传入 max_tokens=2048、temperature=0.6、top_p=0.95、frequency_penalty=0、thinking_budget=2048。这些在 JavaScript 中一一对应:
const payload = {
  model: AppConfig.model,
  messages,
  stream: false,
  max_tokens: AppConfig.maxTokens,
  temperature: AppConfig.temperature,
  top_p: AppConfig.topP,
  frequency_penalty: AppConfig.frequencyPenalty,
  thinking_budget: AppConfig.thinkingBudget,
};
所有可调参数都被收敛进 js/config.js,改温度、换模型都不必动业务代码——这是"配置与逻辑分离"的好习惯。
4.4 流式与非流式的取舍小结
| 维度 | Python 参考实现 | 本项目实现 |
|---|---|---|
| 网络层 | requests + stream=True | fetch + stream=false |
| 数据形态 | 逐行 SSE 增量 | 一次性完整 JSON |
| 解析方式 | 逐行 lstrip(“data:”) | response.json() |
| 适用场景 | 散文流式输出 | 结构化 JSON 契约 |
五、提示词工程:把 AI 驯成一个规矩的"游戏主持人"
5.1 为什么必须定制系统提示词
裸模型默认行为是"有问必答、自由发挥"——你问它问题,它给你一段自然语言。但游戏需要的是机器可读的数据契约:出题得是 {type, sentence, hint, category, difficulty},判定得是 {correct, score, standardAnswer, comment}。如果让前端去解析自然语言,将是一场噩梦:标点、语气、"我觉得"这种前缀都会让 JSON.parse 直接抛异常。
因此,系统提示词(system prompt)的核心任务只有一个:把模型约束成一个只会输出合法 JSON 的游戏主持人。参考代码中原有提示词是"告诉我一个有关宇宙的有趣事实",本项目将它整体重写为游戏规则。
5.2 系统提示词的完整设计
系统提示词分两大段,分别约束"出题"与"判定"两种情形:
情形一 · 出题:当用户请求出题时,从华语流行歌曲歌词或经典古诗词中选一句广为流传的"上句",返回:
{
  "type": "lyric | poem",
  "sentence": "上句内容",
  "hint": "一句提示,不暴露答案",
  "category": "出处:歌名 / 诗题·作者",
  "difficulty": 1
}
并明确要求:不得与历史中已出现过的句子重复;sentence 必须是完整经典的一句;难度 1 高、2 中、3 低… 等等,是 1 简单、2 中等、3 偏难。
情形二 · 判定:当用户提交"我的答案是:xxx"时,把答案与上句配对进行宽容判定,返回:
{
  "correct": true,
  "score": 88,
  "standardAnswer": "疑是地上霜",
  "comment": "秒答!老诗词人了!"
}
判定规则里埋了两条关键策略:
- 宽容匹配:同义不同字、不同传唱版本、通顺且意思一致的下句都算对。这是大模型远比"字符串相等"高明的地方——它真的"看懂"了语义。
- 打分带区间:判定正确时
score在 70~100,错误时在 0~40。给区间而不是给具体数,既给了模型创作自由度,又保证了分数语义的一致。
5.3 为什么出题阶段不返回答案
细心的人会发现,出题 JSON 里没有 answer 字段,标准答案只在判定阶段才由 AI 返回。这样设计有三个考虑:
- 防止玩家通过开发者工具"偷看"标准答案,破坏游戏公平性;
- 判定阶段依赖的是多轮消息历史——AI"自己出过的题"它自己记得,无需重复传递;
- 前端数据结构更干净:题面只管展示,判定只管结果。
5.4 JSON 兜底解析:应对模型的"小任性"
即便提示词写得再严格,大模型偶尔还是会"调皮":在 JSON 外面包一层 ```json 的 markdown 围栏,或是在 JSON 前后加上一两句废话。为此前端实现了一个兜底解析函数:
function parseJSON(text) {
  const fenced = text.match(/```(?:json)?\s*([\s\S]*?)```/);
  const raw = fenced ? fenced[1] : text;
  const start = raw.indexOf("{");
  const end = raw.lastIndexOf("}");
  if (start === -1 || end === -1) throw new Error("AI 返回中未找到 JSON 对象");
  return JSON.parse(raw.slice(start, end + 1));
}
思路很朴素:先剥掉 markdown 围栏,再截取第一个 { 到最后一个 } 之间的内容,最后 JSON.parse。这一层兜底在真实测试中确实多次生效,是整条 AI 链路的"安全气囊"。
六、对话记忆:让 AI 不重复出题、判得准
6.1 无状态的 API,有记忆的调用方
Chat 补全接口本身是无状态的——每次请求都是全新的上下文。但我们的游戏需要一个"记得住"的主持人:既不能重复出题,又要在判定时记得题目是什么。解决方案是前端自己维护消息历史(messages 数组):
[system]   游戏规则 + JSON 契约
[user]     请开始游戏,给我出第一道题
[assistant] {题目 JSON}
[user]     我的答案是:疑是地上霜。请按规则判定并返回 JSON
[assistant] {判定 JSON}
[user]     请出一题新题目(不要重复已出过的句子)
...
每次调用都在历史末尾追加新消息,组合成完整的 messages 数组发给模型。模型读到历史中的题目 JSON,自然就知道上一题是什么、答案该是什么;看到"不要重复已出过的句子",也会主动避开题目列表。
6.2 记忆的成本与管理
随之而来的一个问题是:对话无限增长,请求体积和 token 成本都会变大。在本项目玩法下(单局几十回合),历史长度完全可控,无需做裁剪。但代码里保留了清晰的结构,未来若做"无限对战"模式,可以在历史达到阈值时截断最早的 assistant 轮次,或把历史摘要再喂给模型,这些扩展点都留好了。
七、前端架构:一个小而美的状态机
7.1 三阶段状态机
页面核心是一个三状态机:
stageIdle(空闲):未开局,显示开场动画与"开始游戏"按钮;stageQuestion(出题):展示题面、提示、出处,激活输入框与提交按钮;stageResult(判定):展示成绩、标准答案、点评、历史记录,提供"下一题"和"重新开始"。
三个阶段由 showStage(name) 统一切换:每次只显示对应 id 的容器,其余加 hidden 类。这种做法让 DOM 结构扁平、逻辑直白,任何新人都能十分钟读懂。
7.2 防重复提交与请求锁
AI 接口往返需要数秒,如果玩家连点三次"提交",会发出三个判定请求,造成计分错乱。解决方案是一个简单的 busy 布尔锁:
if (busy || !currentQuestion) return;
busy = true;
// ... 网络请求
busy = false;
同时提交按钮在请求期间被 disabled,输入框不清空、加载提示浮出——交互上的"忙碌态"和逻辑上的"请求锁"双保险。
7.3 错误隔离:一题失败不毁掉整局
网络抖动、接口限流、模型输出异常……这些失败在 AI 应用里是常态而不是意外。前端的错误策略是局部重试、整体不崩:
- 出题失败:回到空闲页,显示错误原因,玩家可再次点击开始;
- 判定失败:答案不丢失,展示错误提示,并提供"再试一次"或"下一题"两条出路;
- 所有异步操作都用
try/catch/finally包裹,finally里必做的两件事:关掉加载动画、释放请求锁。
7.4 XSS 防御:AI 的答案是用户的输入
AI 返回的 standardAnswer、comment 等字段本质上来源于模型生成,属于"不可信输入"。渲染进历史记录时如果直接 innerHTML 拼接,一旦模型输出 HTML 标签就会出问题。因此所有动态文本都经过 escapeHtml 转义后再插入,从源头杜绝注入风险。一行小函数,却是安全意识的分水岭。
八、视觉设计:用 CSS3 撑起"氛围感"
8.1 配色与质感
游戏是娱乐向产品,视觉是第一印象。我选定了深紫夜空作为主基调:背景用两层径向渐变叠加一层线性渐变,营造深邃的宇宙感;三个带有 filter: blur(70px) 的彩色光球(紫、粉、金)在背景中缓慢漂浮,是纯 CSS 的 animation,不依赖任何图片素材。
卡片采用玻璃拟态(Glassmorphism):backdrop-filter: blur(18px) 加半透明边框 rgba(255,255,255,0.16),让卡片像磨砂玻璃一样悬浮在渐变之上。标题"词乐对对碰"五个大字用 background-clip: text 做了霓虹渐变(金→粉→紫),辅以柔和的光晕文字阴影。
8.2 微交互细节
- 进入动画:卡片与其他元素使用
pop-in,以"淡入+上移+缩放"组合出现,节奏轻快; - 图标呼吸:开场页的麦克风 🎤 有一个 2 秒周期的
bob上下浮动动画,暗示"等着你来接招"; - 按钮反馈:hover 上浮 2px、active 回弹 0.98 缩放,每一次点击都有真实的手感;
- 结果情绪色:判定正确时徽章与分数用绿色系(正确 +88),错误时用红色系(再接再厉 0 分),颜色即情绪;
- 响应式:
max-width: 520px断点下,标题缩至 32px、表单改为纵向排列,手机上同样顺手。
没有引入任何 UI 库或动画库,全部效果出自二十几个 CSS 规则——现代 CSS 的能力远超大多数人的想象。
九、功能落地:从接口到界面的完整调用链
把上面所有设计串起来,一次"开局 → 答题 → 判分"的真实数据流是这样的:
- 玩家点击"开始游戏",前端重置状态、清理历史;
- 前端组装
messages = [system(游戏规则), user(请出第一道题)],fetch发给 GitCode AI; - 模型经过思考,返回
{type, sentence, hint, category, difficulty}的题面 JSON; - 前端
parseJSON解析,渲染类型徽章、难度星级、大字号题面与提示,聚焦输入框; - 玩家输入答案,提交后组装
messages = [...历史, user(我的答案是:xxx)]; - 模型结合历史里的题面,输出
{correct, score, standardAnswer, comment}; - 前端按
correct分支更新"答对/总分"统计,渲染结果横幅与点评,写一条历史记录; - 点击"下一题",回到第 2 步,只是第一句请求换成了"请出下一题,不要重复"。
整条链路中,AI 被调用两次,前端无状态、可随时刷新——刷新页面即重开新局,干净利落。
十、测试与验证:不只靠"感觉能跑"
10.1 用真实浏览器做端到端验证
写完代码不能只说"理论上能跑"。我用 Puppeteer 驱动真实 Chromium 对页面做了全流程验证:加载页面 → 点击开始 → 等待 AI 出题 → 提交答案 → 断言判定结果。实际跑出的两次典型回合是:
- 第 1 局:AI 出"床前明月光"(古诗词,难度★),我提交"疑是地上霜" → 回答正确 +88 分,标准答案吻合;
- 第 2 局:AI 出"白日依山尽",我故意提交"低头思故乡" → 判定错误 0 分,标准答案"黄河入海流"。
两局的计分累加(总分 88、答对 1)、历史记录条数全部符合预期,端到端链路确认打通。
10.2 视觉走查
随后我对页面截图进行了视觉走查:布局无溢出、文字无截断、色彩对比度达标,仅对两处微调——输入框 placeholder 亮度提升、结果分数按对错赋予绿红语义色。细节打磨是"能用"与"好用"之间的最后一公里。
10.3 这套测试方式的启示
对于一个无构建的纯静态项目,Puppeteer 这种"真实浏览器 + 真实接口"的验证方式远胜于纸上谈兵。它证明了:前端 AI 应用的验收标准不是"代码写完",而是"真实链路跑通"。
10.4 对 AI 输出质量的持续观察
端到端测试的价值不只在于"通没通",更在于观察模型的输出规律。我在多轮实测中记录了几个有意思的现象,对后续调优很有指导意义:
- 出题难度会"跑偏":不明确约束时,模型偶尔会出过于冷门的句子(比如"难度★"却出到冷僻诗词)。系统提示词中补充"难度1必须是脍炙人口、听得出来历的句子"之后,题面质量明显回升。
- 点评的惊喜感:模型在 comment 字段上的发挥远超预期,会出现"老诗词人了""这波走位风骚"这类俏皮话,成为游戏体验的加分项。
- 偶尔的正确案例:即使玩家写了意译,只要语义对,
correct也会为true——这验证了大模型宽容判定的核心价值,也说明提示词里的"宽容匹配"规则确实生效了。 - 稳定性的波动:同一请求偶尔会出现一次"判定超时"或返回空内容,前端错误隔离设计因此显得必要——不是每次都要怪罪网络,而是产品必须为概率性失败做好准备。
这些观察让我意识到,AI 产品的调优不是一锤子买卖,而是一个"观察行为 → 修正提示词 → 再验证"的持续循环,提示词本身也要像代码一样做版本管理与回归测试。
十一、踩坑回顾:那些值得记下的教训
- 流式 JSON 是陷阱:最初想保留打字机效果,实测发现 JSON 碎片需要复杂的缓冲拼接,果断切回非流式——不要在错误的抽象上逞强;
- 模型会撒娇:即便提示词写明"只输出 JSON",模型仍偶发输出 markdown 围栏,兜底解析函数因此必不可少;
- 重复出题风险:第一版没有传递历史,前两局就出了同一首诗。加入多轮消息历史后彻底解决;
- 连点提交:没有请求锁时,快速连点会出现多个判定请求导致计分错乱,
busy标记一行药到病除; - 公开仓库泄露密钥:API Key 明文写在
config.js且仓库默认公开,这是一堂安全课——教学可接受,生产必须走后端代理。
每一条坑背后都有一个朴素的道理:AI 应用的前端,最大的不确定性不在代码,而在模型行为。
十二、部署与后续展望
12.1 部署方式
因为是纯静态项目,部署路径非常多:
- GitHub Pages / AtomGit Pages:推送到仓库后,在仓库设置里开启 Pages 即获得公网地址;
- Vercel / Netlify / Cloudflare Pages:连接仓库,自动构建发布;
- 本地直接打开:
index.html用file://直接打开也可用(建议用静态服务器以获得更一致的浏览器行为)。
12.2 可扩展方向
如果继续迭代,我设想的路线是:
- 加模式:纯歌词模式、纯诗词模式、混合模式、限时挑战模式;
- 加段位:根据正确率与连续答对计算段位,引入排行榜;
- 加音效:答对播放一声清脆的琴音,答错一声低沉的嗡鸣,Web Audio API 可以零依赖实现;
- 后端代理:把密钥收敛到 serverless 函数,顺便加频率限制与用量统计;
- 多轮续聊:允许玩家追问"这句歌出自哪张专辑",把游戏和聊天自然融合。
12.3 参数调优实录:温度与思考预算
这个项目里两个参数对体验的影响最值得说道:
- temperature(随机性):默认 0.6,属于"既有创造力又不至于离谱"的甜蜜点。如果调低到 0.2,出题会偏向最常见的几句(“床前明月光”"举头望明月"反复出现);如果调高到 1.0,点评会更有梗,但偶尔会判出匪夷所思的分数。游戏类产品需要在"稳定"与"惊喜"之间反复权衡,0.6 是本项目实测后的结论。
- thinking_budget(思考预算):这个参数控制模型推理的深度。预算越高,模型"想得越久",返回更慢但题目更精妙;预算过低则判定容易草率。在"判定"这种关键环节保留合理预算是有意义的,但也不宜过大,否则玩家会对着加载动画等得心焦。最终选择了与参考代码一致的 2048 并从 config 统一暴露,方便任何人在拨杆式的调整中找到自己满意的节奏。
参数调优的教训是:不要迷信默认值,也不要迷信别人的值,要亲手在真实体感上试。一个 0.1 的温度差,可能就决定了游戏是"无聊的题库"还是"有灵魂的玩伴"。
十三、写在最后
「词乐对对碰」不是一个复杂的项目,但它完整经历了一个真实软件产品要走的每一步:需求定义 → 方案对比 → 技术选型 → 接口对接 → 提示词工程 → 前端架构 → 视觉打磨 → 容错处理 → 测试验证 → 文档交付。
在这个过程中,我最深的体会是:大模型时代的"前端程序员"价值,正在从"写页面"迁移到"定义人与模型的交互协议"。什么时候让模型自由发挥散文,什么时候让它输出严格 JSON,用什么提示词约束它的行为,怎么兜底它的意外——这些"契约设计"才是 AI 应用中最有含金量的部分。
而回到游戏本身,当 AI 抛出"床前明月光",你在输入框里敲出"疑是地上霜",获得 88 分和一句"老诗词人"时,那种跨越语言模型与我们童年记忆的会心一笑,就是这个项目存在的最大意义。
技术栈:HTML5 · CSS3 · JavaScript(零依赖、零构建)
驱动模型:GitCode AI · deepseek-ai/DeepSeek-V4-Flash
如果你也写代码,不妨把这个游戏部署起来,用你的脑子和 AI 的"审美"来一场上句对下句的切磋。祝你玩得开心,也祝你写出更好的代码——在码道上,我们同行。

汇聚全球AI编程工具,助力开发者即刻编程。
更多推荐

 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)