
码道 · 让AI替你吵架:「脑内会议」零依赖网页应用诞生记
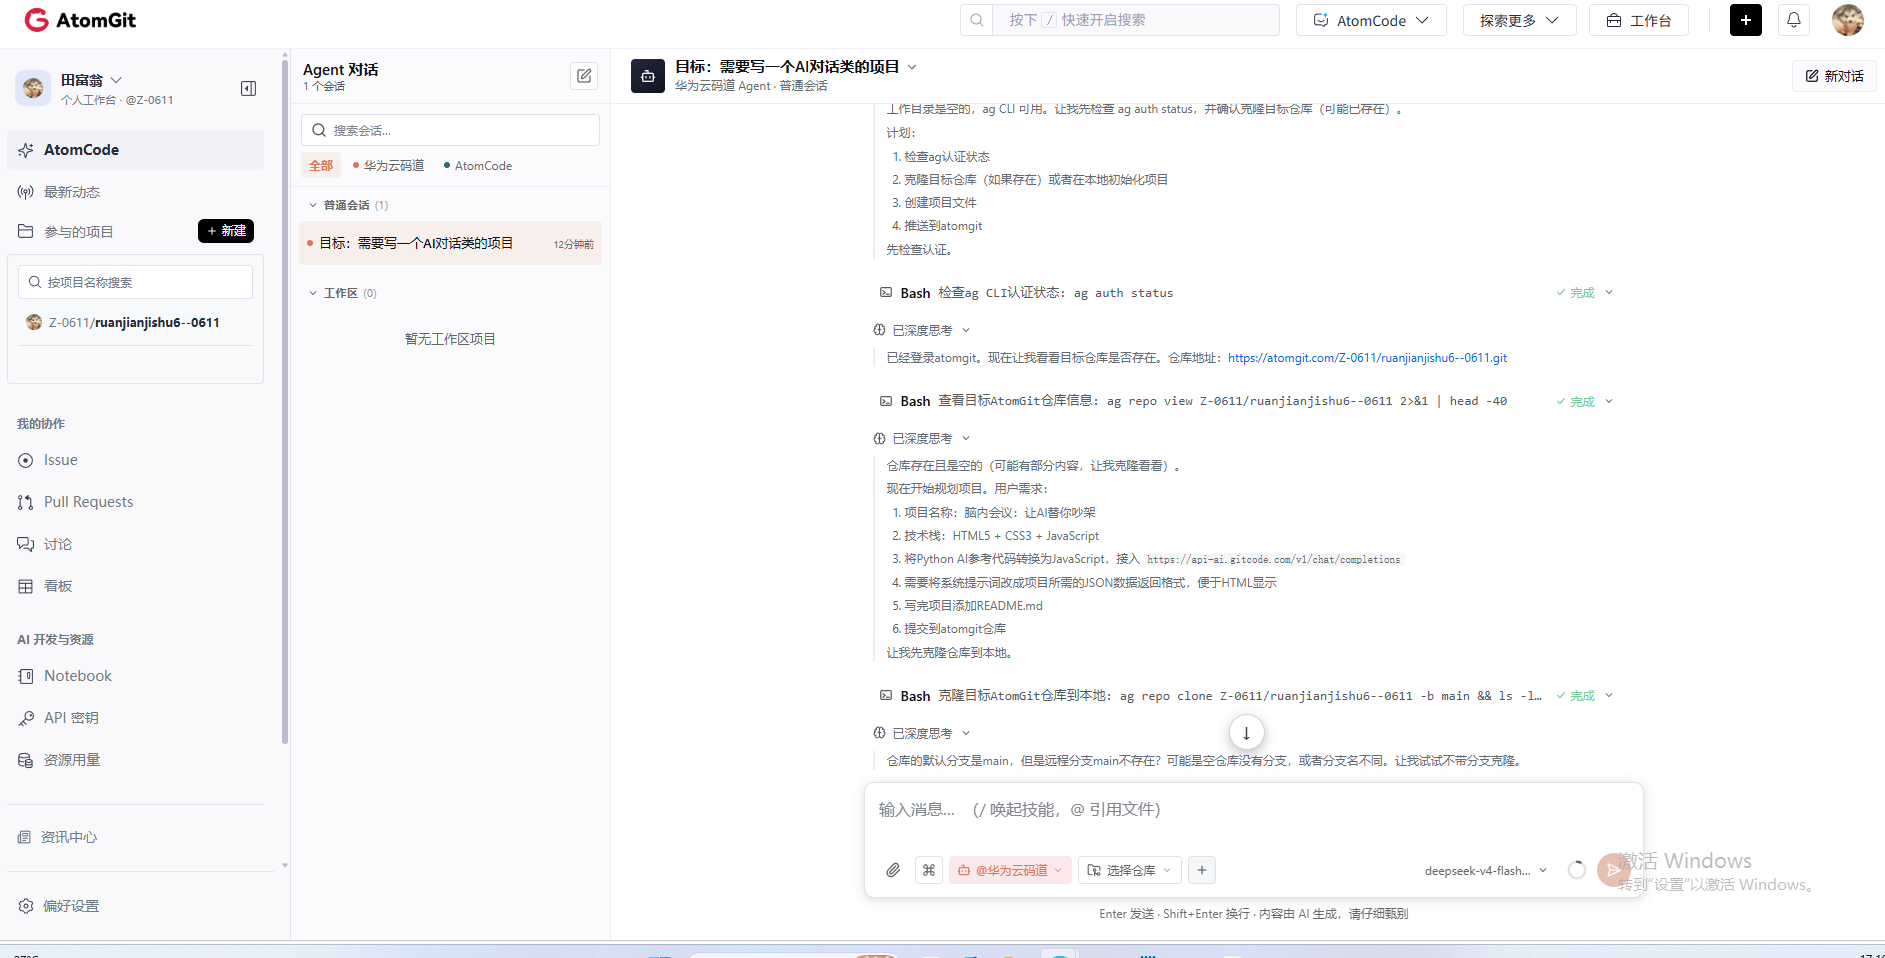
使用工具:
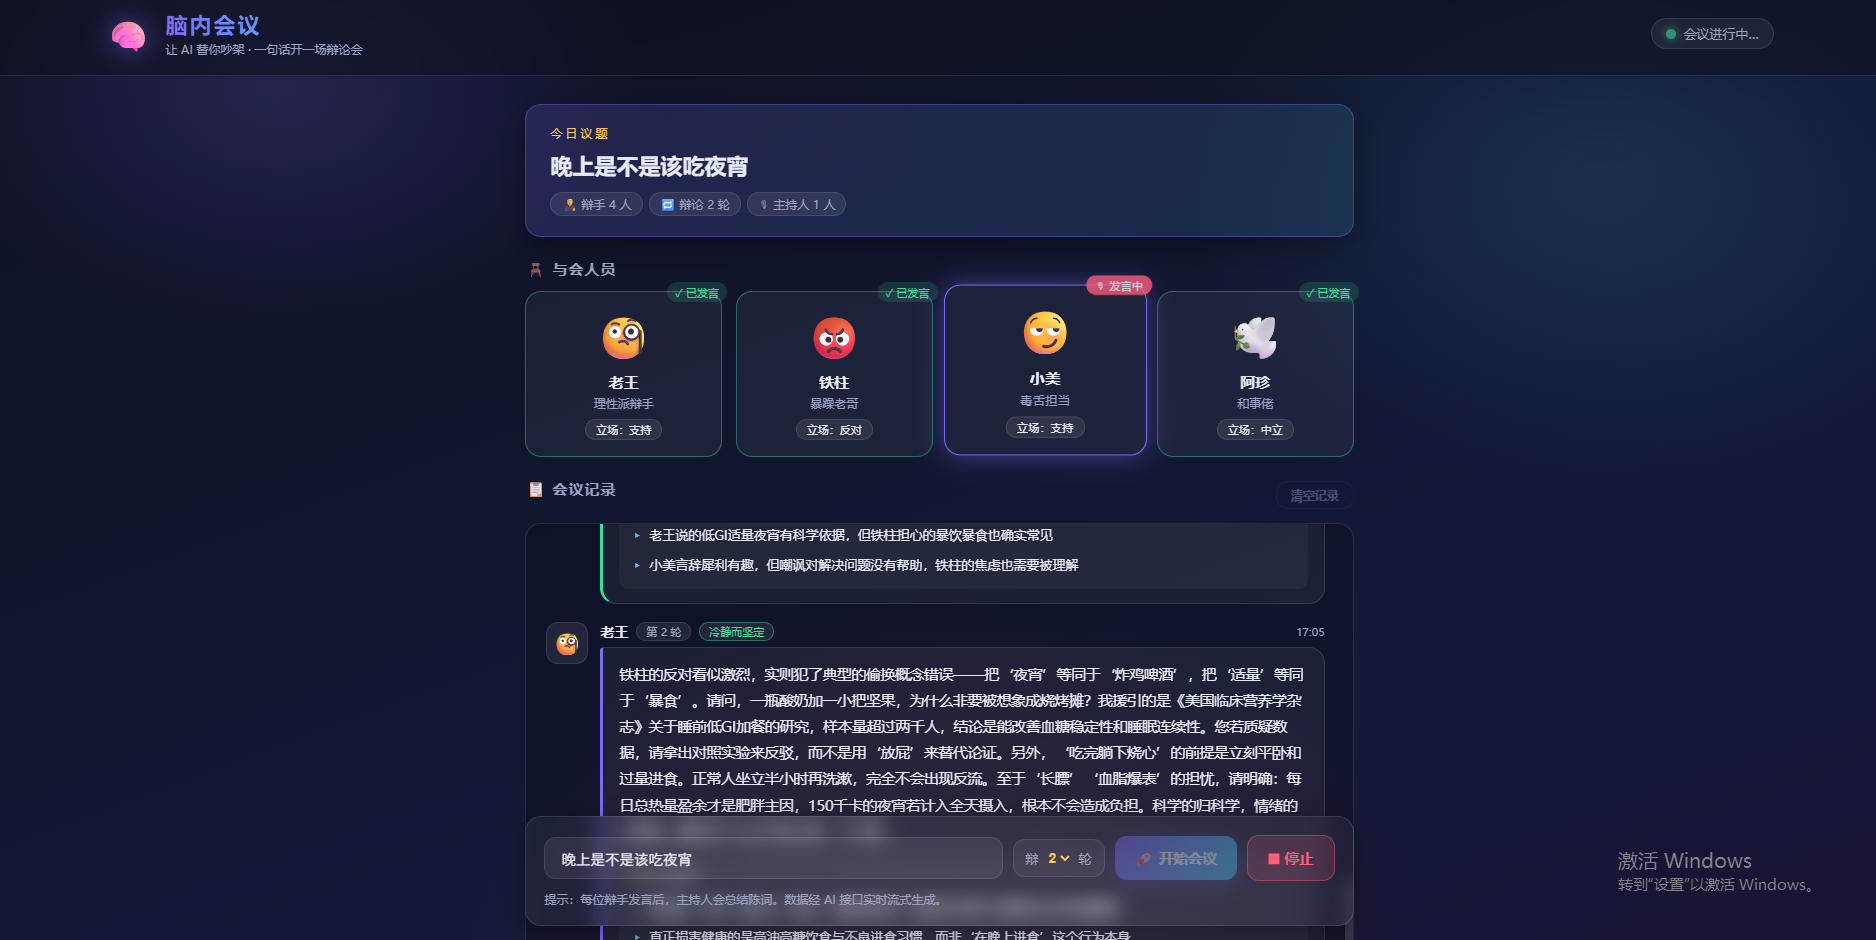
运行实例效果:
一、为什么会有「脑内会议」
1.1 一个成年人最高频的糟心事:吵架吵不赢
先别急着反驳,扪心自问一个问题:上一次你和别人争论、对线、抬杠,是不是越说越气,回到家躺在床上才想起「我刚才应该这么回他」?
吵架这件事,最吃亏的不是没理,而是嘴笨。明明占着理,一到临场就大脑空白、面红耳赤、词不达意;明明对方逻辑稀碎、满地打滚,你却被他绕进去了。事后诸葛亮人人都会,当场发挥千难万难。
我曾经无数次在深夜复盘白天的争论,脑补出一百种更漂亮的反击话术,然后在后悔中失眠。这种经历你一定也有。于是我想:如果不靠嘴呢?
1.2 灵光一闪:让 AI 替我吵
2026 年,大语言模型早已不是什么新鲜事。写文案、写代码、翻译、总结——AI 几乎什么都干。那……能不能让 AI 帮我吵架?
当然,这里的「吵架」是打引号的:不是让 AI 去攻击某个真人,而是让 AI 扮演多个不同立场、不同性格的角色,针对同一个议题展开辩论。我坐在屏幕前,就像坐在自己的「脑内会议室」里,看着精分出来的四个自己互相抬杠:
- 有人引经据典、摆数据讲逻辑;
- 有人拍桌子、吼嗓子、输出情绪;
- 有人阴阳怪气、看似笑嘻嘻实际句句扎心;
- 还有人扮演老好人,各打五十大板试图和稀泥。
这画面感一下子就出来了。而且妙的是,我把现实里所有的「吵不赢」都挪到 AI 身上——让 AI 替我吵,本质上是在帮我「预演」一场辩论:所有的反驳都替你提前想好,所有的逻辑漏洞都替你提前踩过。这既解压,又能倒逼自己把话说圆。
1.3 从想法到 MVP:技术上的三个问题
把想法落地成产品,我立刻遇到了三个技术问题:
- 角色人格从哪来?——答案很清晰:靠「系统提示词」。大模型天然擅长角色扮演,只要把人设写清楚、把输出格式约束死,它就能稳稳地演出一个暴躁老哥。
- 流式打字效果怎么做?——我要的是「AI 一边想一边说」的现场感,而不是转圈圈等半天后哗啦弹出全部文字。这要求接入模型的 SSE(Server-Sent Events)流式接口。
- 网页上怎么调用模型?——我没有后端服务器,希望纯前端搞定。这意味着要用浏览器原生的
fetch去请求流式接口,这比后端requests要绕一些,但完全可行。
三个问题想清楚后,我立刻开始动手。项目的名字也定下来了:「脑内会议:让AI替你吵架」。
二、项目长什么样
2.1 整体观感:一间深夜会议室
打开页面,你会看到一间「深夜会议室」:深蓝紫色的背景铺着一层柔和的光晕,顶部是项目标题和状态灯,中间是四位与会者的「座位席」,再往下是一块滚动的会议记录区,底部则是固定在面板里的控制台——输入议题、选择辩论轮数、开始或停止会议。
设计上我刻意选择了深色调 + 玻璃拟态:半透明的卡片、微弱的描边、悬浮的渐变光斑,让整个界面有「脑海里的会议室」那种既克制又带点戏剧性的气质。每个角色的座位在发言时会亮起霓虹边框、贴上「🎙 发言中」的标签,说完则变成「✓ 已发言」,像开会时真有人在下边悄悄记录一样。
2.2 四位辩手与主持人
整个会议班底一共五位「AI 员工」:
| 角色 | 头像 | 人设定位 | 立场 |
|---|---|---|---|
| 老王 | 🧐 | 理性派辩手:冷静、逻辑严密、爱引数据与常识 | 支持 |
| 铁柱 | 😡 | 暴躁老哥:火爆冲动、嗓门大、爱拍桌子、反问句连发 | 反对 |
| 小美 | 😏 | 毒舌担当:阴阳怪气、句句扎心、用反讽式比喻立论 | 支持 |
| 阿珍 | 🕊️ | 和事佬:温和理性、各打五十大板、推动共识 | 中立 |
| 主持人 | 🎙️ | AI 主持人:总结陈词、评定战果、提炼金句 | 中立 |
四个辩手的立场刻意设计成「两两对立 + 一个和稀泥」:老王和小美主「挺」,铁柱主「踩」,阿珍居中调停。立场一旦对立,辩论的火药味就出来了——这正是「吵架」的灵魂。
2.3 一次完整的会议流程
用户的操作路径非常短:
- 在底部输入框输入议题,比如「香菜是不是反人类食材?」或者「晚上到底该不该吃夜宵?」;
- 选择辩论轮数(1~3 轮),点击「🚀 开始会议」;
- 四位辩手按照 老王 → 铁柱 → 小美 → 阿珍 的顺序轮流发言,每人发言时对应的座位发光,内容实时流式输出;
- 全部轮次结束后,主持人出场,输出工作总结、谁吵赢了、全场金句以及可以「继续吵」的延伸话题;
- 也可以随时点「⏹ 停止」,AI 立即闭嘴,会议中断。
从输入议题到拿到整场辩论的完整纪要,全程不用动一行后端代码。
三、技术选型:为什么是零依赖原生三件套
3.1 一个「不需要安装」的产品
做这个项目时,我给自己定了一条近乎苛刻的纪律:不引入任何框架,不依赖任何 CDN,不搞任何构建工具。
为什么?因为我想让任何人拿到这个项目,双击 index.html 就能跑起来。不需要 npm install、不需要 pnpm、不需要 vite、不需要 webpack——不需要任何先决条件。
这在 2026 年听起来有点「返祖」,但仔细想想是划算的:
- 零维护成本:没有依赖树,就不会有供应链漏洞,也不会有「三天不更新就一堆 CVE」的焦虑;
- 零学习成本:熟读 HTML/CSS/JS 三件套的人,看完代码就能改;
- 极轻量:整个项目连 CSS 带 JS 不到两千行,一个文本编辑器足以撑起全部开发。
当然,框架有框架的好处,但在这个「一个小小的辩论应用」的粒度上,原生三件套带来的敏捷是任何框架都比不上的。
3.2 CSS 完成「会议室」氛围
界面视觉全靠手写 CSS 撑着。我提炼了一套设计令牌(Design Tokens):
:root {
    --bg: #0d1021;            /* 深蓝夜底色 */
    --card: rgba(255,255,255,.05);  /* 玻璃拟态卡片 */
    --primary: #7c6cf6;       /* 主紫色 */
    --primary-2: #4ac8f5;     /* 辅青色 */
    --danger: #ff5d7a;        /* 暴躁红 */
    --ok: #3ddc97;            /* 表决绿 */
    --gold: #ffc857;          /* 金句黄 */
}
背景的三团渐变光斑用 radial-gradient 叠加实现的,既有「脑海里灵光一闪」的暗示,又不会抢走正文的注意力;气泡、卡片、按钮全部走半透明 + backdrop-filter: blur() 的玻璃拟态路线;发言状态用 box-shadow 发光 + transform: translateY(-4px) 抬升来模拟「站起来说话」。
CSS 里我最得意的一个小细节是打字光标:
.cursor {
    width: 8px; height: 15px;
    background: var(--primary-2);
    animation: blink .8s infinite;
}
@keyframes blink { 50% { opacity: .1; } }
在正文还没流出来之前,一个闪烁的小竖条先占住「正在打字」的位,等待 AI 的第一句话——这个几行 CSS 的小元素,撑起了整个流式体验的仪式感。
3.3 响应式:会议室也得上手机
虽然叫「会议室」,但没人规定会议室只能在电脑上开。我用一条媒体查询把布局从四席并排切成两行两列,把底部控制台从横向排列改为纵向堆叠,状态栏自动适配。手机上个厕所的功夫,也能看完一场辩论。
四、核心战斗:Python 请求转成浏览器流式请求
4.1 难题:浏览器里没有 requests
项目要接的 AI 接口是 OpenAI 兼容协议(/v1/chat/completions),原本的参考实现是 Python:
import requests

API_URL = "https://api-ai.gitcode.com/v1/chat/completions"
headers = {"Authorization": "Bearer 你的密钥"}

def query(payload):
    response = requests.post(API_URL, headers=headers, json=payload, stream=True)
    for line in response.iter_lines():
        if not line.startswith(b"data:"):
            continue
        if line.strip() == b"data:[DONE]" or line.strip() == b"data: [DONE]":
            return
        yield json.loads(line.decode("utf-8").lstrip("data:").rstrip("\n"))
Python 这段代码写得非常干净:stream=True 打开长连接,iter_lines() 一行行吐数据,遇到 data: 前缀就解码成 JSON,碰到 [DONE] 就收工。
但问题来了:浏览器里没有 requests。前端与模型的桥梁只有原生 fetch,而 fetch 处理流式有自己的玩法。
4.2 用 ReadableStream 手搓一个 SSE 解析器
fetch 返回的 response.body 是一个 ReadableStream,我们可以通过 getReader() 拿到一个读取器,一帧一帧地 read() 数据。SSE 协议本质上就是「按行传送、每行以 \n 结尾、以空行分隔事件」的文本流,所以解析思路非常朴素:
const reader = response.body.getReader();
const decoder = new TextDecoder("utf-8");
let buffer = "";

while (true) {
    const { done, value } = await reader.read();
    if (done) break;

    // 把新读到的字节解码后拼进缓冲区
    buffer += decoder.decode(value, { stream: true });
    // 按换行符切出完整的行,留在 buffer 里的可能是半行
    const lines = buffer.split("\n");
    buffer = lines.pop();

    for (const line of lines) {
        const trimmed = line.trim();
        if (!trimmed.startsWith("data:")) continue;   // 只关心 data: 事件

        const data = trimmed.slice(5).trim();
        if (data === "[DONE]") return;                // 流结束标记

        try {
            const parsed = JSON.parse(data);
            const delta = parsed.choices?.[0]?.delta;
            if (delta?.content) fullText += delta.content;   // 累积正文
        } catch (_) { /* 半行 JSON 忽略 */ }
    }
}
这段代码有几个精心设计的点,每一个都是从实战里踩出来的:
第一,缓冲区不能丢。 网络字节是「一帧一帧」来的,没有人保证一个完整的 SSE 事件恰好落在同一帧里。有可能一个 JSON 事件被劈成两半,前半截到了、后半截还在路上。所以必须先拼到 buffer 里,按 \n 切分,只处理「完整的行」,剩下的尾巴留在 buffer 等待下一次读取拼接。这就是 buffer = lines.pop() 那一行的意义。
第二,TextDecoder 要开 { stream: true }。 这一点特别容易被忽略!如果不开这个选项,一个多字节的 UTF-8 字符(比如「吵」字)恰好被切成两帧,decoder 就会按替换字符处理,直接乱码。开了 { stream: true } 之后,decoder 会内部缓存未完成的码元,跨帧拼接后再输出,中文永远不会裂。
第三,[DONE] 有两种空格形式。 参考代码里已经提醒了:data:[DONE] 和 data: [DONE] 都可能出现。所以我先 trim() 再去 slice(5),彻底抹平差异。
4.3 这条鱼还有一半:reasoning_content
接这个模型时我发现一个有趣现象:它是一颗带「思维链」的 reasoning 模型。流式返回的 delta 里有两个字段:
{"choices": [{"delta": {"reasoning_content": "模型正在内部思考…", "content": "这才是正式的发言正文"}}]}
也就是说,请求发出后,模型会先「想」很久(reasoning_content 哗啦啦地吐思考过程),然后才开始输出正式内容(content)。这对产品形态影响很大:
- 如果直接把两块内容混着显示,用户会看到模型的「内心 OS」全部暴露在大庭广众之下,观感炸裂;
- 正确的做法是:只把
content当作正文累积,reasoning_content单独回调,我甚至可以利用「正在思考」这段时间在前端显示一点小状态,避免用户干等。
所以在正式的 js/api.js 里,我把它俩彻底分离:
// reasoning 模型的思考过程(可选展示)
if (typeof delta.reasoning_content === "string" && delta.reasoning_content) {
    onReasoning?.(delta.reasoning_content);
}
// 正文内容(流式累积)
if (typeof delta.content === "string" && delta.content) {
    fullText += delta.content;
    onContent?.(delta.content);
}
实测我的「老王」角色 4.8 秒完成一轮回答,其中思考和生成各占一半——reasoning_content 全程在跑,而用户界面只看到正文的流式输出,体验非常顺滑。
4.4 让用户随时「闭嘴」:AbortController
会议进行到一半,用户忽然不想听了怎么办?浏览器给 fetch 提供了原生的「钳制」能力——AbortController。
state.abortController = new AbortController();
// 请求时把 signal 传进去
fetch(url, { signal: state.abortController.signal });
// 用户点停止时
state.abortController.abort();
abort() 一调用,正在挂起的网络读取立刻抛出 AbortError。我在 streamChat 里专门捕获了这个异常并返回「已经收到的部分文本」,然后在 UI 层判定:一旦会议被中断,当前发言气泡直接显示「⏹ 发言被打断」,后续轮次全部不再启动。这一套组合拳下来,「停止」功能稳定得几乎不像前端。
五、核心战斗:JSON 输出契约(系统提示词工程)
5.1 为什么不能让 AI 自由发挥
如果直接让模型自由辩论,输出的内容会是一坨格式随意的大白话——有换行、有 emoji、有「呃」「那个」,甚至直接给你输出一段 Markdown。鉴于本项目是前端渲染,如果任由模型自由发挥,用户看到的将是一堆无法结构化的文字墙。
所以我做了一件在整个项目里最关键的事:在系统提示词里给 AI 立下一条铁律——只输出 JSON,格式严格按我给的契约来,不多不少。
5.2 辩手契约
每位辩手发言,模型必须返回这样的结构:
{
  "speaker": "老王",
  "stance": "支持",
  "emotion": "冷静",
  "points": ["论点1", "论点2"],
  "response": "100~200字的完整发言正文"
}
系统提示词的写法则采用「人设 + 契约」双段拼接:
你是"脑内会议"中的理性派辩手【老王】。
性格:冷静克制、逻辑严密、喜欢引用数据事实和常识,发言有理有据,从不骂人。
你在此次辩论中扮演的立场是:支持议题。
……
请严格按照以下 JSON 格式输出(不要输出任何其他文字、不要使用 markdown 代码块):
{"speaker":"你的名字","stance":"你的立场","emotion":"一句话描述情绪","points":["论点1","论点2"],"response":"100~200字的完整发言正文"}
这里面有几句措辞是反复调教过的:
- 「不要输出任何其他文字」——堵住模型开场白「好的,那我开始发言了」之类废话的嘴;
- 「不要使用 markdown 代码块」——很多模型默认会体贴地把 JSON 包在
json块里,这会破坏直接JSON.parse; - 给出具体的中文标签示例(如「论点1」「论点2」),避免模型自己想当然换 key 名;
- 把立场也放进传输层——因为前端要用它渲染红绿徽章,赌模型答自动产出比自己猜的准得多。
5.3 主持人契约
主持人作为收官角色,输出的是更高层的信息提炼:
{
  "summary": "对整场辩论的总结",
  "winner": "谁吵赢了或哪一方更占上风",
  "golden_line": "全场最经典的一句话",
  "followups": ["延伸话题1", "延伸话题2"]
}
前端拿到这份 JSON,直接渲染成一张「总结陈词卡片」:战果、金句、还能继续吵的延伸话题一目了然。产品的「人文关怀」全靠这几个字段:没人想看干巴巴的纪要,但人人都想看到「谁赢了」和「那句最叼的话」。
5.4 容错解析:永远不要相信模型
提示词写得再绝,模型偶尔也会抽风。所以解析层必须做成「防弹衣」——extractJSON 做了三件脏活:
function extractJSON(text) {
    let t = text.trim();
    // ① 剥离可能包裹的 markdown 代码块
    t = t.replace(/^```(?:json)?\s*/i, "").replace(/```\s*$/i, "");
    // ② 只取第一个 { 到最后一个 } 之间的内容
    const start = t.indexOf("{");
    const end = t.lastIndexOf("}");
    if (start === -1 || end === -1 || end <= start) return null;
    // ③ 尝试解析,失败就返回 null 交给上层降级
    try { return JSON.parse(t.slice(start, end + 1)); }
    catch (e) { return null; }
}
对应的降级策略:解析失败时,不崩溃、不黑屏,直接把模型的原始输出原样展示,并贴一张「⚠ 格式异常」的标签。用户的体验不会断,只是少了几张漂亮的卡片而已。
为什么极端情况下确实可能失败?因为 thinking_budget 较大的模型偶尔会把「内部思考」和「最终答案」混淆。虽然系统提示词约束了,但兜底永远比侥幸更专业。
六、核心战斗:会议状态机与前端渲染
6.1 一场会议 = 若干次串行 API 调用
整个会议流程是一个确定性极高的状态机:
用户输入议题 → 循环 ROUNDS 轮:
    按顺序让 4 位辩手各自发言(每次 = 一次完整流式请求)
→ 主持人总结(最后一次流式请求)
→ 会议结束
为什么不让模型一次性输出「整场会议」?因为那样会丢失「依次发言、互相反驳」的动态性——后发言的人必须看到前面的人都说了什么,才能怼得起来。所以我用的是串行、带记忆的调用方式:每一轮发言的 user 消息里都塞进「到此为止的完整辩论记录」,让模型永远站在最新的战况上开口。
const payload = {
    messages: [
        { role: "system", content: char.system + JSON_TEMPLATE_DEBATER },
        { role: "user", content: `本次会议议题:「${state.topic}」\n\n在此之前其他辩手的发言记录:\n${formatHistory(state.history)}` },
    ],
};
历史记录格式化长这样:
【第1轮 · 老王(支持)】我认为晚上该不该吃夜宵,关键在"适度"与"选择"……
【第1轮 · 铁柱(反对)】吃个屁!……
这相当于给模型喂了一个不断累加的「会议纪要」,每一句新发言都是在前面所有发言的基础上生成的——互怼的因果感就是这么来的。
6.2 DOM 渲染与打字机
前端渲染走的是「先骨架、后填充」的思路:
- 创建一条消息的骨架(头像 + 名字 + 徽章位 + 气泡);
- 气泡里先放一个闪烁光标占位;
- 流结束后解析 JSON,把气泡内容清空,用打字机效果逐字打出
response正文; - 正文结束后,再追加「💡 论点提炼」列表——论点让争论显得有结构,假装我们有在讲道理。
打字机效果是一个定时器驱动的 textContent 切片:
function typeText(node, text, interval = 10) {
    return new Promise(resolve => {
        let i = 0;
        const timer = setInterval(() => {
            i++;
            node.textContent = text.slice(0, i);
            if (i >= text.length) { clearInterval(timer); resolve(); }
        }, interval);
    });
}
每打一个字滚动一次 scrollTop,保证观众永远看到最新一行。10 毫秒一个字,一句话打下来刚好十几秒,配合座位席的「🎙 发言中」霓虹亮起——这就是一场合格的「会议直播」。
6.3 安全渲染:永远 textContent
有一个红线我必须强调:所有动态内容(角色名、发言、论点、总结)一律通过 textContent 写入 DOM,绝不使用 innerHTML 拼接模型输出。理由很简单——模型输出是不可信的,如果哪天真发生了提示词注入,innerHTML 会直接落地一个 XSS。用 textContent 是从根上断掉这条路。
七、踩坑实录:这些问题每一个都真实发生过
写代码没有一帆风顺,这个项目我踩过的坑能开一场分享会。挑几个最典型的:
坑 1:跨域(CORS)
第一版写完,我直接双击 index.html 用 file:// 协议打开,fetch 瞬间被浏览器拦截。解决方案有两个:
- 本地起一个静态服务(
python3 -m http.server或npx serve),用http://localhost访问; - 或者接受
file://的限制,改用与接口协议一致的托管地址部署。
我在 README 里把这两种方式都写清楚了,避免后来者重复踩。
坑 2:UTF-8 多字节字符被帧切碎
排查中文乱码时我一度怀疑是接口的问题,最后发现是 TextDecoder 忘了开 { stream: true }。一个「吵」字在 UTF-8 里占 3 个字节,Z 帧边界刚好把它劈成 1+2,不开 stream 模式就直接变异体字符。修法是加一个参数,代码一行,教训一节。
坑 3:模型偷偷包 markdown 代码块
某次联调,模型非常「贴心」地把 JSON 包在 ```json 代码块里还带语言标注,浏览器 JSON.parse 直接当场阵亡。后来我把「不要使用 markdown 代码块」写进了铁律,同时还在 extractJSON 里做了剥壳兜底——双保险。
坑 4:thinking 模型的「内心独白」突然混进正文
reasoning 模型的 content 偶尔会先空一段,或者把想法泄漏到身体里。所以 api.js 必须只认 delta.content,对 reasoning_content 视而不见,并在 UI 层显示「正在组织语言…」作为过渡期安抚观众。
坑 5:停止按钮的状态竞态
最早期版本里,用户点「停止」之后,跑到一半的 await speak() 还会继续往下走,把「已停止」的状态又覆盖回去。后来我把「是否运行中」提升为全局状态 state.running,每一个 await 之后都检查一次,任何一个环节发现已停止就立刻退出循环,收尾时统一根据 running 判定文案是「会议结束」还是「会议已停止」——从此告别竞态。
八、怎么证明它真的能跑:三层验证
作为一个程序员,说一千道一万不如跑一遍。我给自己上了三道验证关卡:
第一关:本地 mock 流式测试
写了一个临时脚本,手工构造一条模拟 deepseek 的 SSE 流——先吐两段 reasoning_content,再按 7 字节一帧地把 JSON 正文切得稀碎喂给解析器,最后抛一个 [DONE]。验证项包括:reasoning 片段是否数对、content 是否按帧累积完整、[DONE] 是否触发 onDone、最终 JSON 字段是否齐全。结果是六项全绿——这证明了「切帧 → 拼流 → 解析 → 累积」整条链路在逻辑上是可靠的。
第二关:真实 API 端到端
mock 过关不等于真实能跑。我又用真实密钥调了一次真实接口,让「老王」正儿八经地辩论「晚上该不该吃夜宵」。结果:
- 4.8 秒完成一轮完整回答,流式输出顺畅;
reasoning_content被正确捕获且与正文分离(思考 172 字符,正文 177 字);- 模型严格遵循 JSON 契约:
speaker / stance / emotion / points / response五个字段全齐,直接JSON.parse成功。
这一关直接证明了「提示词契约 + 前端解析」这套方案的有效性。
第三关:全量语法检查
最后把所有 JS 文件跑一遍 node --check,确保语法零错误,然后推上线。
九、安全与部署:一个必须交代的话题
9.1 API 密钥不能裸奔
说个严肃的话题:当前版本的 js/config.js 里,API Key 是明文写在浏览器里的。这在本地演示、学习场景没问题,但一旦部署到公网,等于把密钥公开给了全世界,任何人打开开发者工具都能偷走它去刷你的额度。
所以我的建议非常明确:
- 学习/演示:保持现状,够用;
- 正式部署:一定要加一层薄薄的后端代理(Node/Go/Python 都行),让前端只请求自己的
/api/chat,由后端持有密钥并转发模型接口。
这个项目尊重用户选择,但 README 里必须把风险讲透。
9.2 部署到哪
因为零依赖、纯静态,它的部署选项堪称奢侈:GitHub Pages、Gitee Pages、对象存储静态托管、Nginx 目录……随便挑。整个项目打包后就是几个文本文件,没有一步构建,rsync 或者 git push 完事。
十、总结与展望
10.1 这次开发最大的收获
这个项目让我在三个维度上有了实实在在的积累:
- 前端 × AI 的握手:把「后端世界里的 requests 流式请求」翻译成「浏览器世界里的 ReadableStream」,从此任何 OpenAI 兼容的流式接口在前端都能手到擒来;
- 提示词即接口:用「JSON 输出契约」把大模型的自由文本驯化成结构化数据,前端渲染、测试验证全部建立在契约之上——这可能是现阶段 AI 应用工程化性价比最高的一件事;
- 用户体验的仪式感:一个闪烁光标、一条状态灯、一个渐显的光晕,这些「小动作」把一次普通 API 调用包装成了一场有现场感的「会议直播」。
10.2 未来还能怎么玩
「脑内会议」的想象力远不止于此,我给自己列了一份愿望清单:
- 更多人格:毒舌律师、哲学家、程序员、杠精祖师爷……人人都能进会议室;
- TTS 语音:让铁柱真的吼出来,小美真的阴阳起来,会议变成有声剧;
- 多线程并行:让角色们「同时对喷」而不是排队,还原真实的混乱;
- 自定义角色:用户自己捏一个辩手人设,参加混战;
- 会议记忆:把历史会议沉淀成档案,下次开会引用上次的「判决」。
10.3 结语
写到这里,这篇博客已经足够长,但项目的故事还在继续。如果你也被「AI 替你吵架」这个点子逗笑了,不妨克隆下来,亲手上一次战场:
git clone https://atomgit.com/Z-0611/ruanjianjishu6--0611.git
双击 index.html,输入一个议题,然后看你脑内的四位朋友如何替你厮杀。愿你从此吵架不再吵不赢——毕竟,你脑内可是养着一整个会议室的 AI。
附录:快速上手指南
# 1) 克隆项目
git clone https://atomgit.com/Z-0611/ruanjianjishu6--0611.git && cd ruanjianjishu6--0611

# 2) 配置密钥(可选,仓库已内置示例 Key)
#    修改 js/config.js 中的 apiKey

# 3) 本地启动(二选一)
python3 -m http.server 8080
npx serve .
# 浏览器访问 http://localhost:8080

# 4) 玩耍:输入议题 → 选择轮数 → 开始会议
项目文件速览
ruanjianjishu6--0611/
├── index.html      # 页面结构:议题横幅 + 座位区 + 会议记录 + 控制台
├── style.css       # 深色会议室视觉:玻璃拟态 / 发光动画 / 响应式
├── js/
│   ├── config.js   # AI 接口配置:地址 / 密钥 / 模型 / 采样参数
│   ├── api.js      # SSE 流式请求:fetch + ReadableStream 解析
│   └── app.js      # 核心逻辑:角色人设、状态机、JSON 渲染
└── README.md       # 项目文档
*本文由码道人工智能编程助手的开发实践整理而成。欢迎到仓库提 Issue、提 PR,给「脑内会议」加新人格。*OC](这里写自定义目录标题)
欢迎使用Markdown编辑器
你好! 这是你第一次使用 Markdown编辑器 所展示的欢迎页。如果你想学习如何使用Markdown编辑器, 可以仔细阅读这篇文章,了解一下Markdown的基本语法知识。
新的改变
我们对Markdown编辑器进行了一些功能拓展与语法支持,除了标准的Markdown编辑器功能,我们增加了如下几点新功能,帮助你用它写博客:
- 全新的界面设计 ,将会带来全新的写作体验;
- 在创作中心设置你喜爱的代码高亮样式,Markdown 将代码片显示选择的高亮样式 进行展示;
- 增加了 图片拖拽 功能,你可以将本地的图片直接拖拽到编辑区域直接展示;
- 全新的 KaTeX数学公式 语法;
- 增加了支持甘特图的mermaid语法1 功能;
- 增加了 多屏幕编辑 Markdown文章功能;
- 增加了 焦点写作模式、预览模式、简洁写作模式、左右区域同步滚轮设置 等功能,功能按钮位于编辑区域与预览区域中间;
- 增加了 检查列表 功能。
功能快捷键
撤销:Ctrl/Command + Z
重做:Ctrl/Command + Y
加粗:Ctrl/Command + B
斜体:Ctrl/Command + I
标题:Ctrl/Command + Shift + H
无序列表:Ctrl/Command + Shift + U
有序列表:Ctrl/Command + Shift + O
检查列表:Ctrl/Command + Shift + C
插入代码:Ctrl/Command + Shift + K
插入链接:Ctrl/Command + Shift + L
插入图片:Ctrl/Command + Shift + G
查找:Ctrl/Command + F
替换:Ctrl/Command + G
合理的创建标题,有助于目录的生成
直接输入1次#,并按下space后,将生成1级标题。
输入2次#,并按下space后,将生成2级标题。
以此类推,我们支持6级标题。有助于使用TOC语法后生成一个完美的目录。
如何改变文本的样式
强调文本 强调文本
加粗文本 加粗文本
标记文本
删除文本
引用文本
H2O is是液体。
210 运算结果是 1024.
插入链接与图片
链接: link.
图片:
带尺寸的图片:
居中的图片:
居中并且带尺寸的图片:
当然,我们为了让用户更加便捷,我们增加了图片拖拽功能。
如何插入一段漂亮的代码片
去博客设置页面,选择一款你喜欢的代码片高亮样式,下面展示同样高亮的 代码片.
// An highlighted block
var foo = 'bar';
生成一个适合你的列表
- 项目
- 项目
- 项目
- 项目
- 项目1
- 项目2
- 项目3
- 计划任务
- 完成任务
创建一个表格
一个简单的表格是这么创建的:
| 项目 | Value |
|---|---|
| 电脑 | $1600 |
| 手机 | $12 |
| 导管 | $1 |
设定内容居中、居左、居右
使用:---------:居中
使用:----------居左
使用----------:居右
| 第一列 | 第二列 | 第三列 |
|---|---|---|
| 第一列文本居中 | 第二列文本居右 | 第三列文本居左 |
SmartyPants
SmartyPants 是一个文本转换工具,主要功能是将普通的 ASCII 标点符号自动转换为更美观的印刷体标点符号。例如:
| 原始符号 | 转换后 | 说明 |
|---|---|---|
"引号" | “引号” | 直引号变弯引号 |
'单引号' | ‘单引号’ | 直单引号变弯单引号 |
-- | – | 两个连字符变短破折号 |
--- | — | 三个连字符变长破折号 |
... | … | 三个点变省略号 |
创建一个自定义列表
-
Markdown
- Text-to- HTML conversion tool Authors
- John
- Luke
如何创建一个注脚
一个具有注脚的文本。2
注释也是必不可少的
Markdown将文本转换为 HTML。
KaTeX数学公式
您可以使用渲染LaTeX数学表达式 KaTeX:
Gamma公式展示 Γ ( n ) = ( n − 1 ) ! ∀ n ∈ N \Gamma(n) = (n-1)!\quad\forall n\in\mathbb N Γ(n)=(n−1)!∀n∈N 是通过欧拉积分
Γ ( z ) = ∫ 0 ∞ t z − 1 e − t d t . \Gamma(z) = \int_0^\infty t^{z-1}e^{-t}dt\,. Γ(z)=∫0∞tz−1e−tdt.
你可以找到更多关于的信息 LaTeX 数学表达式here.
新的甘特图功能,丰富你的文章
- 关于 甘特图 语法,参考 这儿,
UML图表
可以使用UML图表进行渲染,例如下面产生的一个序列图:
- 关于 UML图表 语法,参考 这儿,
流程图
- 关于 Mermaid 语法,参考 这儿,
FLowchart流程图
我们依旧会支持flowchart.js的流程图语法:
- 关于 Flowchart流程图 语法,参考 这儿.
导出与导入
导出
如果你想尝试使用此编辑器, 你可以在此篇文章任意编辑。当你完成了一篇文章的写作, 在上方工具栏找到 文章导出 ,生成一个.md文件或者.html文件进行本地保存。
导入
如果你想加载一篇你写过的.md文件,在上方工具栏可以选择导入功能进行对应扩展名的文件导入,
继续你的创作。
注脚的解释 ↩︎

汇聚全球AI编程工具,助力开发者即刻编程。
更多推荐

 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)