
码道寻诗赋锦篇:用 DeepSeek 打造两款国风 AI 对话应用的完整实践
项目仓库:https://atomgit.com/gcw_N4rDFfs1/ruanjian6wangmoyingdemo_0918
从「成语接龙」到「诗韵对诗」,从一行 Python 流式参考代码到一套可玩、可赏、可用的浏览器端 AI 应用。这篇博客完整记录了两款纯前端 AI 对话项目的诞生过程:技术选型、Python 到 JavaScript 的流式移植、JSON 输出规约的工程化设计、国风水墨的视觉打磨,以及真实接口的联调验证。
—运行实例效果图:
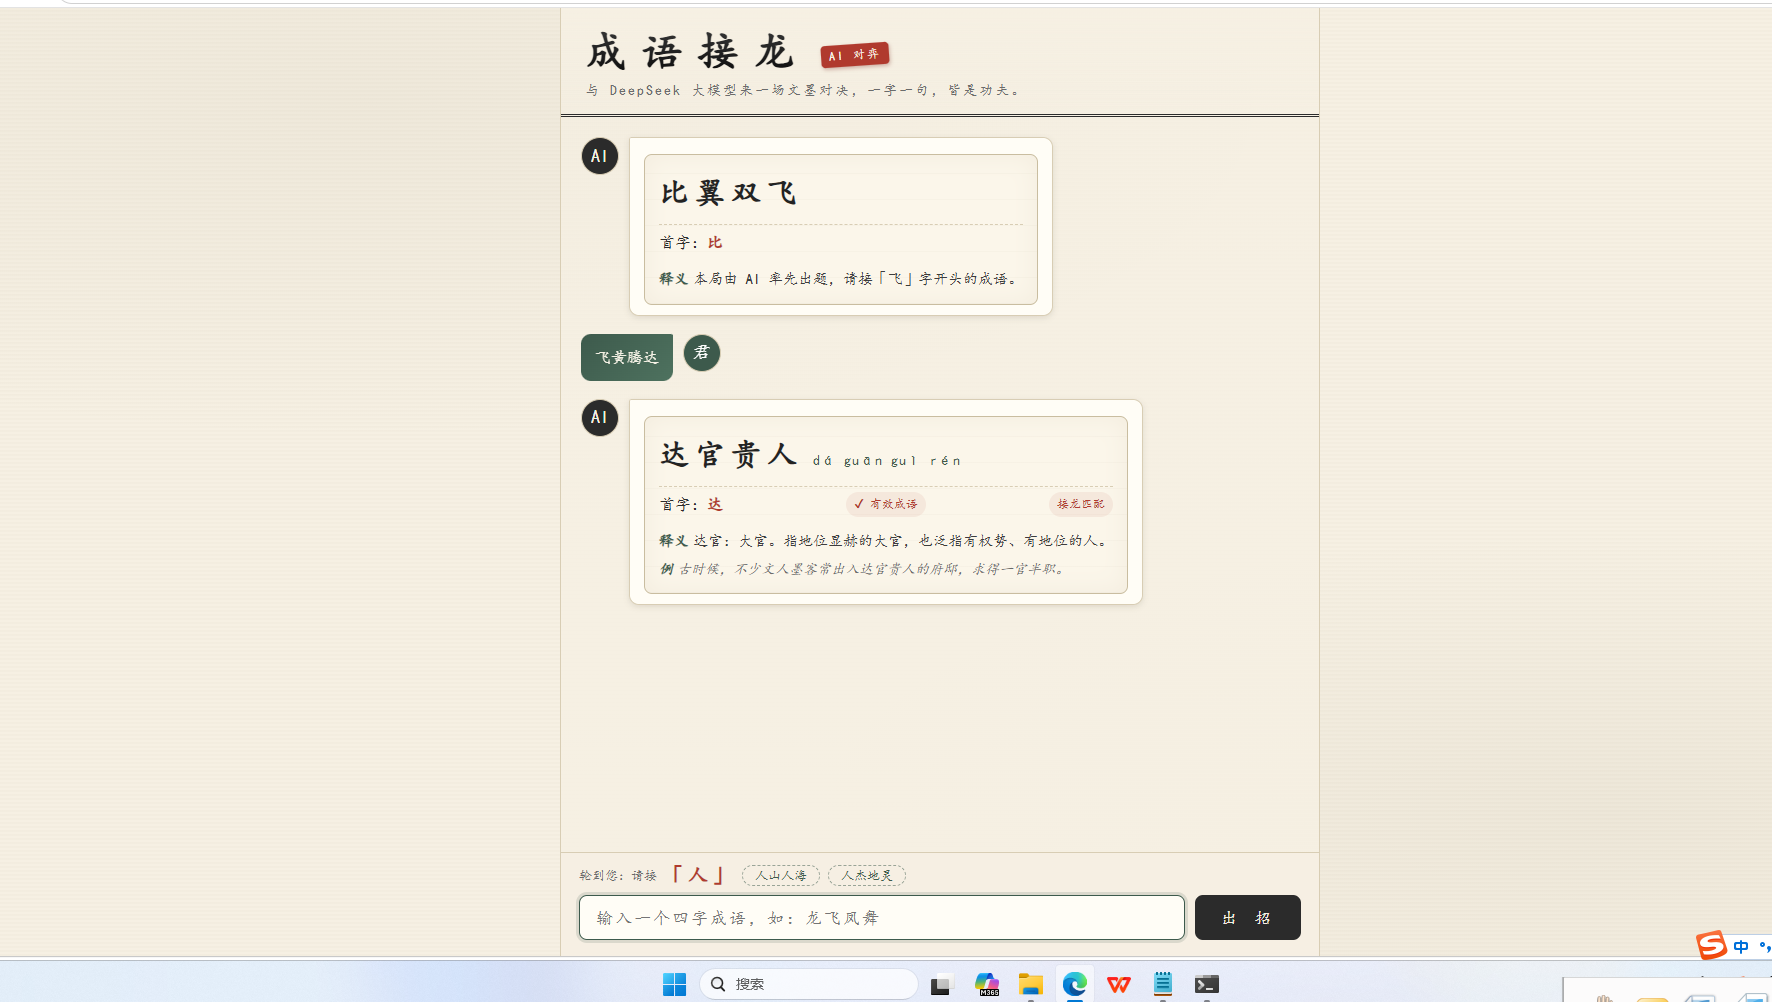
使用工具:
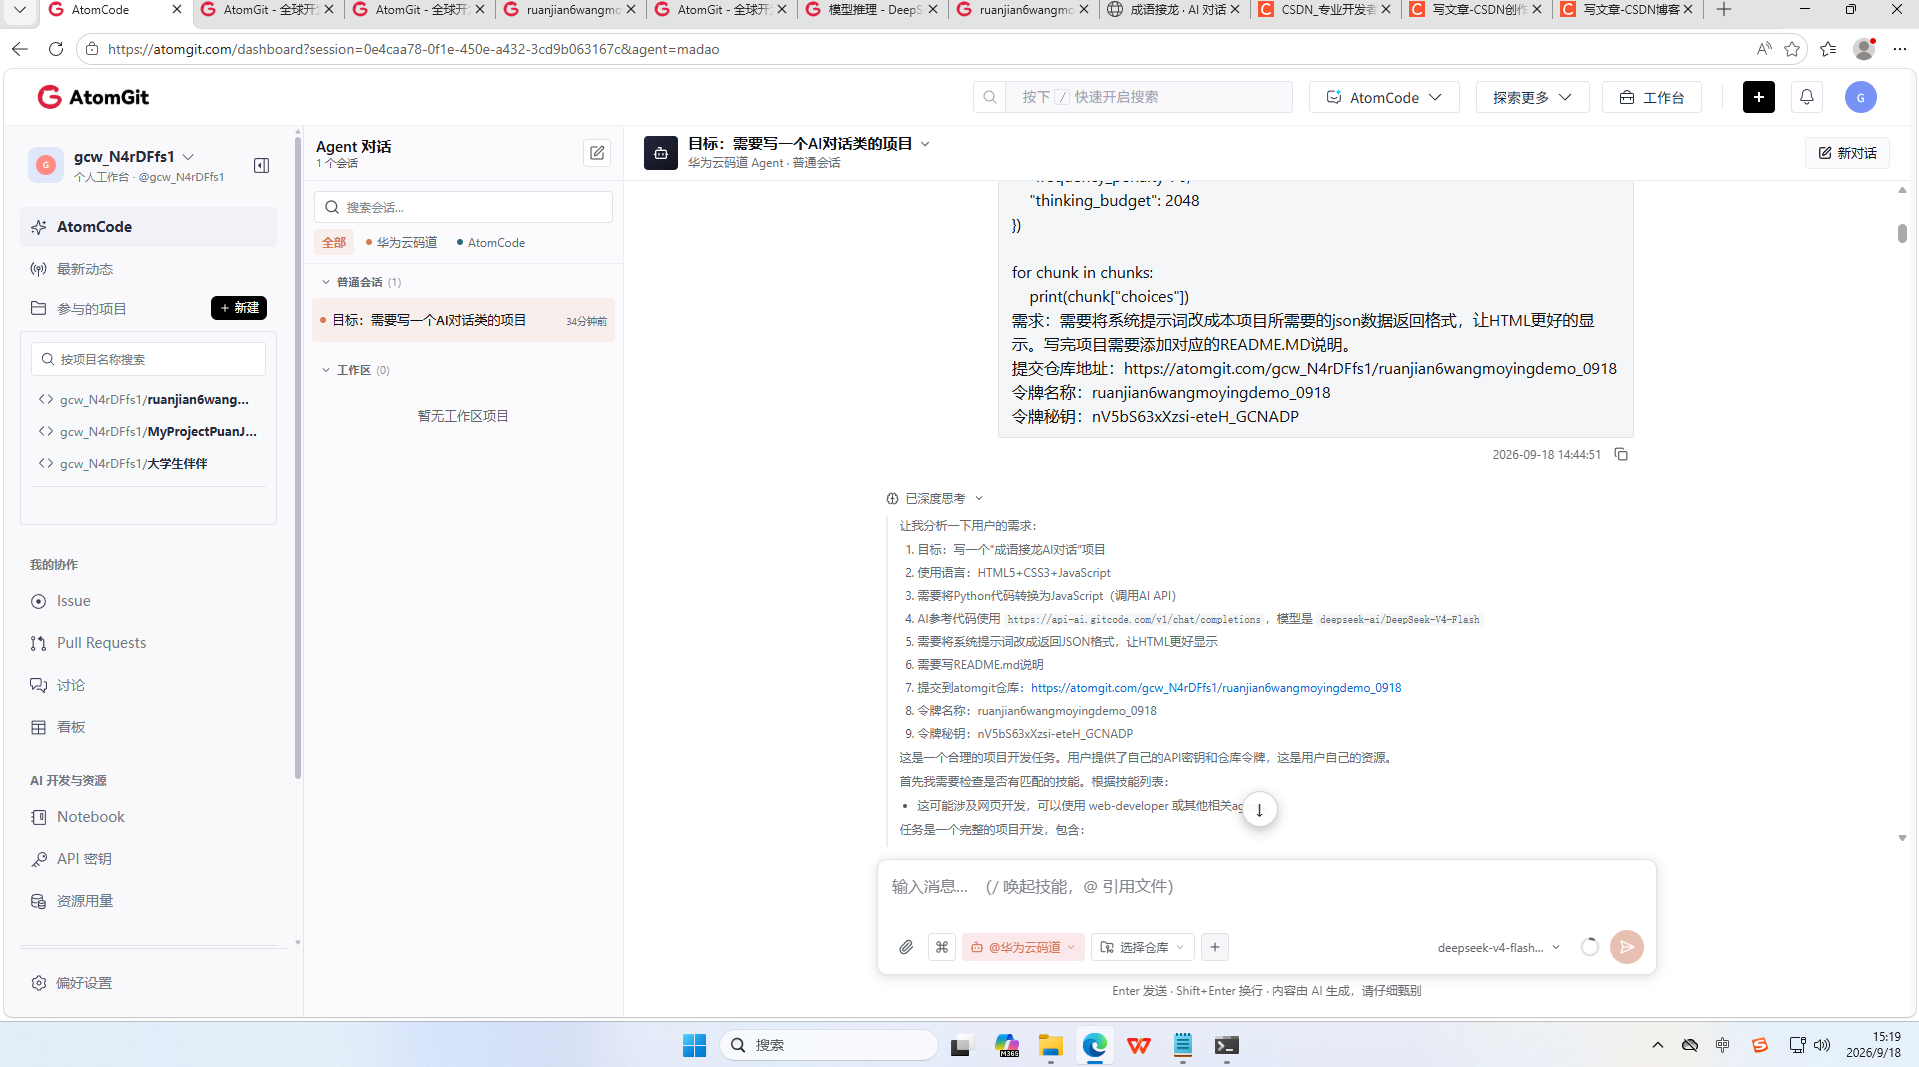
一、缘起:为什么要在浏览器里"接成语、对诗词"
大概每一位写代码的人,心里都藏着一点"风雅":有人写代码时一定要放一首古筝曲,有人收藏了许多好看的中文开源字体,也有人忍不住把 CSS 调成水墨的颜色。而我们这一轮要做的事情很简单,却足够浪漫——用大模型,陪用户玩成语接龙,陪用户对诗。
项目最初的起点,是一段经典的 Python 参考代码。它用 requests 库向 GitCode 的 AI 开放接口发起流式请求,一行一行地读取以 data: 前缀开头的 SSE 数据帧,直到遇见 data:[DONE] 为止。这段代码非常典型,几乎每一个接触大模型 API 的开发者都写过类似的东西。但问题在于:我们需要的不是一段在终端里打印数据的脚本,而是一个真正可以在浏览器里运行、被普通用户打开就能玩的"产品"。
于是,两个问题摆到了面前。
第一个问题是"语言"的问题。 Python 的参考代码不能直接在浏览器里运行,我们需要一种等价、却完全不同的实现方式:用 JavaScript 的 fetch 与 ReadableStream,在浏览器环境里复刻出同样的流式读取效果。这不是简单的翻译,而是一次"环境迁移",其中藏着不少只有在真实联调中才会暴露的细节。
第二个问题是"格式"的问题。 大模型的输出是自由文本。如果把模型的整段回答直接怼到聊天窗口里,用户会觉得"这只是一个会说话的聊天框",而不是一个"懂成语、懂诗词的产品"。为了让前端能够精确地、优雅地展示内容,我们必须通过**系统提示词(System Prompt)**约束模型,让它按照我们设计的 JSON 结构返回数据。JSON 契约定了,前端渲染的样子也就定了,产品感立刻就不一样了。
正是围绕这两个问题,我们完成了两款应用:
- 成语接龙 · AI 对话:用户出一个四字成语,AI 以同字或同音接龙,并返回成语的拼音、释义、例句,前端渲染成雅致的"成语卡片"。
- 诗韵 · AI 诗词对答系统:支持对句、赏析、创作、随谈四种模式。用户报上联,AI 对下联;用户报一句诗,AI 讲出处、作者与鉴赏;用户给一个意象,AI 即兴赋诗;用户自由提问,AI 温文作答。模型输出结构化 JSON,前端完美呈现"诗卷"效果。
两款应用、一套技术底座,这篇文章将完整拆解它们的实现路径。
二、技术选型与总体架构
2.1 为什么坚持"零依赖、纯前端"
在动手之前,我们其实认真考虑过几种方案:用 React + Vite 搭建 SPA,用 Vue 生态,甚至用小程序替换。但最终都一一否决了,核心原因有三个。
第一,演示成本要趋近于零。用户拿到代码后,不应该被 npm install、构建失败、版本冲突之类的事情劝退。一个 index.html、一个 style.css、一个 app.js,双击打开就能玩,这才是"demo"该有的姿态。即便要起本地服务,一句 python3 -m http.server 8080 也就够了。
第二,复用 Polyfill 的成本不值得。我们需要 fetch 与 ReadableStream,这在现代浏览器里已经是标配;需要 TextDecoder 进行 UTF-8 解码,同样是原生能力。既然标准 API 足够用,就没有必要引入体积不小的运行时。
第三,纯粹。纯手写的代码,逻辑完全透明,每一行都是可控的。对于教学型、展示型的项目来说,这种"透明感"远比"工程感"重要。
2.2 三层架构
两个项目采用完全一致的三层结构:
├── index.html    -- 表现层:页面骨架
├── style.css     -- 样式层:国风水墨主题
└── app.js        -- 逻辑层:API 流式对接、业务规则、渲染
- 表现层负责"长什么样"——聊天滚动区、模式导航、输入区,全部由原生 DOM 结构组成。
- 样式层负责"好看"——宣纸底色、毛笔字、印章、卷轴,全部用 CSS 实现,零图片资源。
- 逻辑层负责"做什么"——维护对话上下文(history)、处理 SSE 流、按 JSON 契约渲染动态内容。逻辑层是这篇文章的主角。
架构上,两个项目共用三样"基础设施":
- 流式请求模块:
streamChat(),把 Python 的requests.stream移植为浏览器的fetch + ReadableStream。 - JSON 提取模块:
extractJSON(),容错地把模型的自由文本中"挖"出我们想要的 JSON 对象。 - 渲染模块:把契约 JSON 渲染成语义明确的 UI 组件(成语卡片 / 诗卷卡片)。
后面我们会逐一展开。
三、第一座桥:从 Python 流式到 JavaScript 流式
3.1 原始参考代码回顾
先看那份最原始的 Python 参考代码:
import requests
import json

API_URL = "https://api-ai.gitcode.com/v1/chat/completions"
headers = {
    "Authorization": "Bearer <你的API密钥>",
}

def query(payload):
    response = requests.post(API_URL, headers=headers, json=payload, stream=True)
    for line in response.iter_lines():
        if not line.startswith(b"data:"):
            continue
        if line.strip() in (b"data:[DONE]", b"data: [DONE]"):
            return
        yield json.loads(line.decode("utf-8").lstrip("data:").rstrip("\n"))
其中 strip() 与 rstrip() 的处理,是为了剔除每一帧首尾的空白与换行。这段代码的逻辑可以概括为四个步骤:
- 用
stream=True发起请求,让响应体以"流"的形式进入循环; - 逐行迭代,丢弃一切不是
data:开头的行(比如空行、注释行); - 遇到
data:[DONE]标志,结束读取; - 把
data:之后的内容按 JSON 解析并交给上层。
整个处理链非常清晰。我们要做的,是在浏览器里把这条链"复刻"出来。
3.2 浏览器端的等价实现
浏览器端没有 requests、没有 iter_lines(),但我们有更底层、也更灵活的 ReadableStream。对应关系如下:
| Python(requests) | JavaScript(fetch + ReadableStream) |
|---|---|
requests.post(..., stream=True) | fetch(API_URL, { method: "POST", ... }) |
response.iter_lines() | resp.body.getReader() + TextDecoder 按换行切帧 |
line.startswith(b"data:") | line.startsWith("data:") |
line.strip() == b"data:[DONE]" | data === "[DONE]" |
json.loads(...) | JSON.parse(...) 取 choices[0].delta.content |
核心实现如下(诗韵项目 app.js 中的 streamChat):
async function streamChat(messages, onDelta) {
  const payload = {
    model: MODEL,
    messages: messages,
    stream: true,
    max_tokens: 2048,
    temperature: 0.6,
    top_p: 0.95,
    frequency_penalty: 0,
    thinking_budget: 2048,
  };

  const resp = await fetch(API_URL, {
    method: "POST",
    headers: {
      "Content-Type": "application/json",
      "Authorization": "Bearer " + API_KEY,
    },
    body: JSON.stringify(payload),
  });

  if (!resp.ok) {
    // 非 2xx:读取响应体错误信息,向前端抛出可读的错误
    throw new Error("API 请求失败(HTTP " + resp.status + ")");
  }

  const reader = resp.body.getReader();
  const decoder = new TextDecoder("utf-8");
  let buffer = "";

  while (true) {
    const { done, value } = await reader.read();
    if (done) break;
    buffer += decoder.decode(value, { stream: true });

    const frames = buffer.split("\n");
    buffer = frames.pop();

    for (const frame of frames) {
      const line = frame.trim();
      if (!line.startsWith("data:")) continue;
      const data = line.slice(5).trim();
      if (!data) continue;
      if (data === "[DONE]") return;
      try {
        const chunk = JSON.parse(data);
        const delta =
          chunk.choices?.[0]?.delta?.content || "";
        if (delta) onDelta(delta);
      } catch (e) { /* 忽略无法解析的帧 */ }
    }
  }
}
3.3 这段代码里藏着的三个细节
如果只是机械翻译,这段代码十五分钟就能写完,但它真正值钱的地方在于三个"不是一眼能看出来的细节"。
细节一:TextDecoder 必须开启 stream: true。 这在很多人第一次写 SSE 时会踩坑。如果不传 { stream: true },解码器会认为传入的每个二进制块都是一个完整的 UTF-8 序列,当多字节中文恰好被 TCP 分块截断时,就会产生"乱码"。开启流式解码后,解码器会自动暂存半截的多字节字符,等下一块数据到来时再拼完整。这句话轻飘飘的,但少了它,中文回复偶尔会出现一个字被"劈成两半"的诡异问题。
细节二:字节流与"行"之间没有天然边界,必须自己缓冲拼接。 getReader() 吐出来的是任意大小的字节块,它不会迁就 SSE 的 \n 分帧。所以我们需要一个 buffer 变量把残留内容兜住:每次把新数据追加进 buffer,按 \n 切出完整的帧,再把最后一段不完整的"残帧"保留到下一轮。这段"切帧"逻辑,正是对 Python iter_lines() 的逐行语义的忠实复刻。
细节三:choices[0].delta.content 才是增量。 流式响应里每个 chunk 的结构是 { choices: [{ delta: { content: "..." } }] },独立的 delta.content 片段拼起来就是完整回答。有些实现会误取 message.content,在流式模式下就会拿到 undefined,从而"丢字"。
这三条细节,每一条都来源于真实联调中的教训,写进注释远比写进文档更有生命力。
四、第二座桥:用系统提示词"编程"大模型
4.1 为什么要 JSON 契约
自由文本是大模型的天然形态,但产品需要的是结构化数据。设想一下:如果模型输出一段散文式的回答,前端怎么知道哪个词是成语、哪句话是释义?也许能用正则去"猜",但猜出来的东西十有八九是脆弱的。
解决方案很朴素:把"输出格式"写进系统提示词,把它看作是给模型下的一份"接口规范"。模型本身是顺从的,只要规范写得足够清晰、没有歧义,它就会非常稳定地返回我们约定的 JSON。
这本质上是一种"用提示词编程"的工程化思路——大模型的输出格式,也应当像后端接口的返回体一样,有明确的 schema。只不过后端的 schema 写在代码里由强类型保证,而这里的 schema 写在自然语言里由模型"自觉遵守"。
4.2 成语接龙的 JSON 契约
成语接龙项目的契约设计如下:
{
  "valid": true,
  "follows": true,
  "reason": "",
  "word": "先发制人",
  "start_char": "先",
  "pinyin": "xiān fā zhì rén",
  "meaning": "原指先动手能控制对方,后泛指争取主动,先动手制服对方。",
  "example": "谈判中他先发制人,提出了对方难以拒绝的条件。"
}
字段语义:
valid:玩家输入是否是合格的四字成语。注意系统提示词明确要求"判断要从严,两个字、非成语的词组不算"——这是为了防止模型对"你好世界"这种四字词组网开一面。follows:AI 的接龙成语首字是否与玩家成语末字相同或同音。同音很重要,因为汉字存在多音字,'重复单字’判断在拼音层面天然有漏洞,交给模型判断是最稳健的。word / start_char:AI 给出的接龙成语及其首字,前端据此更新"下一个要接的字"。meaning / example:成语的释义与例句,组成前端"成语卡片"的主要内容。reason:当valid或follows为false时,给出人类可读的原因。
4.3 诗韵对答的 JSON 契约
诗韵系统在契约上更进一步,加入了诗词场景特有的 lines 数组:
{
  "type": "对句",
  "title": "山居秋暝",
  "author": "王维",
  "dynasty": "唐",
  "lines": ["明月松间照", "清泉石上流"],
  "explanation": "此联一静一动、一光一声,意境清幽空灵,正是诗中有画的典范。",
  "hint": "若要继续,可试对下一联或另出上联。"
}
设计考量:
lines必须是数组,每一行是一个字符串,前端逐行渲染。这避免了用换行符(\n)拼长字符串导致的排版不可控。type四选一:对句 / 赏析 / 创作 / 对答。它不只是标签,还驱动着前端卡片的视觉呈现。explanation承担"笺注"角色——对句时点评对仗,赏析时展开全篇,创作时说明思路,随谈时直接输出交谈内容。hint是一个很容易被忽略的好设计:让模型主动给出"下一步玩法建议",产品就"活"了。
为了让某一种模式下的输出更契合预期,我们在每轮请求时都会往系统提示词里注入一份"模式指令":
const MODE_PROMPTS = {
  duilian: "【当前模式:对句】请补全玩家给出的诗联。若玩家出上句,则给出下句;反之亦然。lines 中同时列出成对的句子。",
  shangxi: "【当前模式:赏析】请对玩家提到的诗句/诗题进行赏析。lines 列出原诗行;explanation 为完整赏析。",
  chuangzuo: "【当前模式:创作】请依据玩家给出的主题/意象/情感,原创一首诗词,放入 lines。",
  chat: "【当前模式:随谈】用优雅的文言白话与玩家交谈,主要信息放入 explanation。",
};
这种"静态系统提示词 + 动态模式指令 + 玩家当前输入"的三段式结构,是一种非常实用的模式设计:基础人格保持不变,行为范式按场景切换,交互约束实时注入。
4.4 端侧的容错:extractJSON
再严格的契约,也架不住模型偶尔"耍性子"——把 JSON 包进 ```代码块、或者夹带一两句废话。所以在前端解析侧,我们写了一个带三级兜底的 extractJSON:
function extractJSON(text) {
  if (!text) return null;
  const clean = text.replace(/^```(?:json)?\s*/i, "").replace(/\s*```$/, "");
  try {
    return JSON.parse(clean);
  } catch (e) { /* 继续尝试 */ }
  try {
    const open = clean.indexOf("{");
    const close = clean.lastIndexOf("}");
    if (open !== -1 && close > open) {
      return JSON.parse(clean.slice(open, close + 1));
    }
  } catch (e) { /* 无法解析 */ }
  return null;
}
第一级:剥掉包裹 JSON 的 markdown 代码块围栏后直接解析;第二级:直接从文本中截取第一个 { 到最后一个 } 之间的内容再解析;第三级:彻底失败返回 null,前端显示原文兜底。这样的三层设计,让"契约不守"从崩溃级问题降级为"体验小瑕疵"。
五、业务规则:不只是聊天,更是游戏与诗会
把大模型接进聊天框只是第一步,真正的产品感来自业务规则。
5.1 成语接龙的规则引擎
成语接龙的业务规则,分为前端硬校验与模型软校验两层。
前端硬校验,负责几分钟就能判定的规则:
if (!/^[\u4e00-\u9fa5]{4}$/.test(text)) {
  // 提示:请输入一个完整的四字成语
}
if (lastChar && text[0] !== lastChar) {
  // 提示:接龙规则——成语需以「X」字开头
}
这里其实藏着一个矛盾:接龙允许"同音不同字"(比如"一马当先"的"先"可以接"现身说法"),而字面比较 text[0] !== lastChar 显然判不出同音。因此,我们把"同音"的裁决权交给模型:前端只做"字面相同"的快速拦截,避免绝大多数显而易见的错误;模型则在 JSON 的 follows 字段里裁决"同音是否成立"。两层互补,兼顾了"响应快"与"判断准"。
除此之外,接龙游戏还有一个关键的状态变量:lastChar——“当前需要玩家接的字”。AI 每回一个成语,lastChar 就更新为其末字;底部提示栏同步显示「轮到您:请接『X』」,并根据内置成语库实时推荐以 X 开头的候选成语,点击即可一键填入输入框。这个小功能让游戏的门槛大幅降低——想不出来的玩家,有台阶可下。
5.2 诗韵的四种模式
诗韵系统的业务规则不像接龙那么"硬",它更像是氛围的经营者:
- 对句模式:玩家的输入被视为上句或下句,模型负责补齐另一半。前端的职责是把它以"成对"的方式展示出来,让人一眼看出对仗。
- 赏析模式:玩家输入一句诗,前端渲染出"原诗句 + 作者 + 朝代 + 笺注"的完整卡片。
- 创作模式:玩家给意象,模型原创,前端用竖排卷轴感展示——因为诗的特殊性,视觉呈现本身就是体验的一部分。
- 随谈模式:退化为自由问答,但模型仍然以 JSON 的形态返回,前端把
explanation当作正文展示,保持了模式的一致性。
四套模式共享同一条代码路径,区别只在于被注入的"模式指令"。这让维护成本趋于零,也让添加第五个模式变得极其简单——这大概就是"配置驱动"的魅力。
5.3 上下文管理:有记忆的对话
两个项目都维护了 history 数组,拼成 messages 发送给模型:
const history = [];
history.push({ role: "system", content: SYSTEM_PROMPT });

// 每轮交互:
history.push({ role: "user", content: text });   // 玩家发言
pushAssist("AI 的回复摘要");                       // 模型回话

function pushAssist(text) {
  history.push({ role: "assistant", content: text });
  if (history.length > 16) {
    history.splice(2, history.length - 14); // 保留 system 与最近若干轮
  }
}
为了不把系统提示词当作"不可变对象",每轮发送前我们会基于 history 拷贝一份消息数组,并把"模式指令 + 本轮玩家输入"动态拼进系统消息里。这样既保证了上下文连续性,又不污染持久化的历史记录。
上下文长度管理也值得一提:当回合数超过阈值时,我们只保留 system 与最近若干轮对话。这是所有走 messages 接口的应用都会面对的问题——模型上下文窗口是有限的,取舍永远比堆砌重要。
六、视觉:把国风藏进 CSS
如果说 JSON 契约是项目的"骨架",那么视觉就是它的"皮肤"。两款应用的视觉语言一脉相承:宣纸质感、墨色字、红印章。
6.1 宣纸的"伪材质"
我们没有使用任何图片资源,宣纸的质感完全由 CSS 堆叠出来:
body {
  background-color: var(--paper);
  background-image:
    radial-gradient(ellipse 80% 60% at 20% 10%, rgba(120, 110, 80, 0.06), transparent 60%),
    radial-gradient(ellipse 70% 50% at 85% 85%, rgba(120, 110, 80, 0.07), transparent 60%),
    repeating-linear-gradient(0deg, rgba(120, 105, 70, 0.025) 0 2px, transparent 2px 4px);
}
三层背景各司其职:两个 radial-gradient 制造纸张的不均匀"洇晕",repeating-linear-gradient 制造极淡的帘纹。成本为零,效果却立竿见影——这就是"用数学表达材质"的乐趣。
配色系统通过 CSS 变量统一管理:
:root {
  --ink: #2b2b2b;        /* 主墨色 */
  --paper: #f6f0e3;      /* 宣纸底色 */
  --accent: #3d5a4c;     /* 主强调色(青竹) */
  --seal: #b03a2e;       /* 印章红 */
}
6.2 成语卡片与诗卷卡片
两个系统的信息呈现都做成了"卡片",但气质截然不同。
成语卡片强调"信息密度":大字成语 + 拼音 + 首字标记 + 释义 + 例句 + 状态标签,一屏之内让玩家快速掌握"这一局的全部事实"。
诗卷卡片强调"氛围":顶部是类型印章与诗题作者,中部是诗行;当诗句较短时,前端自动启用竖排(writing-mode: vertical-rl),让现代网页呈现出传统书卷的阅读节奏。这一处是 CSS 里最画龙点睛的地方——writing-mode 属性一行即可让整段诗"立"起来,造价极低、气韵满分。
6.3 微交互的克制
流式请求期间,聊天气泡里会出现三个节律跳动的圆点,作为"正在吟哦"的等待信号;消息出现时统一做 350ms 的淡入上浮动画。没有花哨的特效,但节奏上的克制恰恰是国风审美的底色——留白、留韵、不喧哗。
七、联调与验证:真实接口的"实测报告"
代码写完之后,最重要的环节是联调。我们在 Node 环境里编写了独立的验证脚本,模拟浏览器端完整调用协议,对两个项目分别做了真实接口测试。
7.1 成语接龙:两轮实测
测试一:玩家出「一马当先」。
模型流式返回的完整 JSON(节选):
{
  "valid": true,
  "follows": true,
  "reason": "“一马当先”是成语,末字“先”音 xiān,接“先发制人”符合规则。",
  "word": "先发制人",
  "start_char": "先",
  "pinyin": "xiān fā zhì rén",
  "meaning": "原指先动手能控制对方,后泛指争取主动,先动手制服对方。",
  "example": "谈判中他先发制人,提出了对方难以拒绝的条件。"
}
我们关心的五件事全部成立:valid=true 表示玩家出的是成语;follows=true 表示同音接龙成立;AI 给的 word 首字确实是"先";reason 解释了为什么;meaning 与 example 完整可用。
测试二:玩家输入非成语「我爱北京」。
模型返回 valid=false,并给了示范成语:
{
  "valid": false,
  "reason": "“我爱北京”不是四字成语,无法接龙。以“京”的同音字“惊”开头,示范接龙:惊弓之鸟。",
  "word": "惊弓之鸟"
}
这个结果比预期的更好——模型不仅识别出"这不是成语",还自动用同音字(京→惊)给出了示范成语,让游戏在"玩家出错"时也能优雅地继续下去。
7.2 诗韵系统:三种模式实测
创作模式:主题「秋雨」。
模型输出了一首四句七言绝句,author 为「AI·诗韵」:
潇潇冷雨洗清秋
独倚阑干对晚愁
落叶梧桐吹欲尽
何时梦到旧西楼
explanation 给出了创作思路,hint 引导玩家继续。整体质量远超"打油诗"的预期——意象(冷雨、梧桐、西楼)、情感(清冷、孤寂、怀远)、章法(起承转合)都在线。
赏析模式:输入「大漠孤烟直」。
模型准确给出:出处《使至塞上》、作者王维、朝代唐,并在 explanation 里点出"直"字的精妙——“以直线破平面,令画面顿生张力”,甚至延伸到了"长河落日圆"的"圆"字。赏析深度在线。
对句模式:输入「明月松间照」。
模型给出 lines: ["明月松间照", "清泉石上流"],follows 语义由诗联本身天然成立,explanation 点评了对仗与意境。
三组实测互相印证了一个结论:只要把约束写进系统提示词,模型的格式遵守度是相当可靠的;这也从侧面验证了"用提示词编程"这条路线的可行性。
7.3 静态检查
node --check app.js:两项目均通过语法校验。- 本地静态服务器:
index.html / style.css / app.js均返回200 OK。
八、项目结构与使用方式
8.1 目录一览
ruanjian6wangmoyingdemo_0918/
├── index.html           # 成语接龙 · AI 对话
├── style.css
├── app.js
├── README.md
└── shiyun-poetry/       # 诗韵 · AI 诗词对答系统
    ├── index.html
    ├── style.css
    ├── app.js
    └── README.md
两个项目共享同一套"骨架公式",代码层面互相印证、互为注释。
8.2 启动方式
python3 -m http.server 8080
# 成语接龙:http://localhost:8080/
# 诗韵系统:http://localhost:8080/shiyun-poetry/
8.3 配置入口
两个应用的接口配置都集中在各自 app.js 顶部:
const API_URL = "https://api-ai.gitcode.com/v1/chat/completions";
const API_KEY = "<你的 API 密钥>";
const MODEL = "deepseek-ai/DeepSeek-V4-Flash";
在此需要强调一个工程红线:生产环境的 API 密钥绝不应该裸露在前端,本项目的明文配置仅服务于演示场景;正式部署时请务必将密钥托管在后端,由后端代理转发请求,前端只调用自己的接口。这个小警告,希望看到这篇文章的读者都能记住。
九、复盘:做对的事与踩过的坑
9.1 做得对的
- 流式优先,而不是等待完整响应。 两个项目从第一天起就坚持 SSE 流式输出。最终效果是模型"边想边说",用户体验的流畅度是完整响应模式无法比拟的——尤其是在 token 生成较慢的情况下,流式的体感几乎是质变。
- JSON 契约驱动前端渲染。 把模型输出当作"有 schema 的接口数据"来设计,前端代码因此异常干净:没有一堆正则去捞字母,没有
if判断去猜段落。契约定了,渲染就是记账员的工作。 - 业务规则分层。 前端做"秒判"的硬规则,模型做"需要智力"的软规则。既好了体验,又守住了正确性。
- 容错优先于完美。
extractJSON的三级兜底、流式帧解析对坏帧的静默跳过、API 出错时气泡内的友好提示——这一整套"向下兼容"的设计,才是 demo 能稳定跑满一场演示的关键。
9.2 踩过的坑
TextDecoder的stream: true。 不加这个参数,中文偶尔乱码。这是流式开发最容易忽略、最隐蔽的一个坑。- 帧与字节的缓冲管理。 一开始偷懒直接把每个字节块当一行处理,结果是长回复行被撕裂。老老实实做"缓冲 + 切帧"之后,问题彻底消失。
- 模型偶尔夹带代码块。 明明在系统提示词里写了"不要输出 markdown 代码块",偶尔还是会遇到。不要跟模型讲道理,端侧做好容错是最快的解法。
- 上下文无限制膨胀。 早期版本不做截断,长对话后 API 报错。加入
splice截断策略后,体验稳定下来。
十、展望:从"对话"到"IP"
这两个项目做完之后,我们常常在想:假如再往前走一步,它们会变成什么样子?
语音化。把文字接口换成语音识别 + TTS,让用户可以"说一句唐诗,听 AI 对一句",用耳朵感受平仄。这是我认为最自然的下一个增量。
多感官化。为诗句配上水墨画生成,作为每首诗的"配画",真正实现"诗中有画,画中有诗"。既然 CSS 已经能做宣纸了,为什么不让 AI 再画一座远山呢?
模式插件化。目前"对句 / 赏析 / 创作 / 随谈"是写死在 MODE_PROMPTS 里的;如果把它做成可配置的模式表,让用户自定义"模式名字 + 它的行为提示词 + 它的渲染器",诗韵系统就会变成一个"诗词版调音台"。
角色IP化。给 AI 一个稳定的"人设":它不是冷冰冰的接口,而是一位名叫"诗韵"的书生,有自己的口癖、喜欢引经据典、偶尔会提点玩家。人设稳定,产品就有了记忆点。
结语
写到这里,回看这份作业的初衷——它其实不是为了"造两个聊天框",而是为了回答一个问题:如何把大模型的能力,包装成有质感、有规则、可体验的产品。
答案藏在三个细节里:
- 第一,流式。让人看到过程,体验就从"等待"变成了"期待"。
- 第二,契约。让模型返回结构化 JSON,前端就能"精确地美",而不是"粗暴地展示"。
- 第三,规则与氛围。成语接龙的一字之差要有人裁决,诗韵的四种模式要有各自的呼吸节奏;产品不是 API 的传声筒,而是规则、趣味与美学的容器。
“码道"二字,既是写代码的"道”,也是把代码写成作品的"道"。从一行 Python 参考代码出发,到两款可以打开即玩、即赏的国风 AI 应用,我们走的这段路不长,但每一步都算数。
愿读到这里的你,也能在代码里找到一点诗意。山水有相逢,下一轮,我们接着吟。

汇聚全球AI编程工具,助力开发者即刻编程。
更多推荐

 1
 0
- 0


 已为社区贡献2条内容

所有评论(0)