
一文读懂DALL·E 2图像生成大模型核心基础知识
写在前面
【WeThinkIn出品】栏目专注于分享Rocky的认知思考与经验感悟,范围涵盖但不限于AI行业。
欢迎大家关注Rocky的公众号:WeThinkIn
欢迎大家关注Rocky的知乎:Rocky Ding
AIGC算法工程师/开发工程师面试面经秘籍分享:WeThinkIn/Interview-for-Algorithm-Engineer欢迎大家Star~
AIGC时代的 《三年面试五年模拟》AI算法工程师求职面试秘籍独家资源: 【三年面试五年模拟】AI算法工程师面试秘籍
Rocky最新撰写AI Agent(AI智能体)的深入浅出全维度解析文章: 深入浅出完整解析AI Agent(AI智能体)的核心基础知识
AIGC算法岗/开发岗面试面经交流社群(涵盖AI Agent、AIGC图像创作、AI视频、LLM大模型、AI多模态、数字人、传统深度学习、具身智能等AIGC面试干货资源)欢迎大家加入:https://t.zsxq.com/33pJ0
大家好,我是Rocky。
核心导读
如果只把 DALL·E 2 理解成“更会画图的 DALL·E”,其实会错过这篇论文最本质的东西。Rocky 认为,这篇工作的关键不在于单张样例有多惊艳,而在于它把文本生成图像从“直接把文本翻译成像素”推进到一个更清晰的系统范式:先在 CLIP 的语义空间里生成一个图像表征,再由扩散解码器把这个表征还原成图片。
这件事看似只是多加了一个中间层,实际改变了三个问题的解法。第一,生成模型不再只是在像素空间里追求更逼真的图,而是在一个语义压缩空间里先决定“这张图应该是什么”。第二,图像编辑、变体生成、插值这些能力不再是额外插件,而是从 CLIP latent 的结构中自然长出来。第三,扩散模型的 classifier-free guidance 不再必然把多样性压塌,因为语义内容已经被前面的 CLIP 图像嵌入“冻结”了一部分。
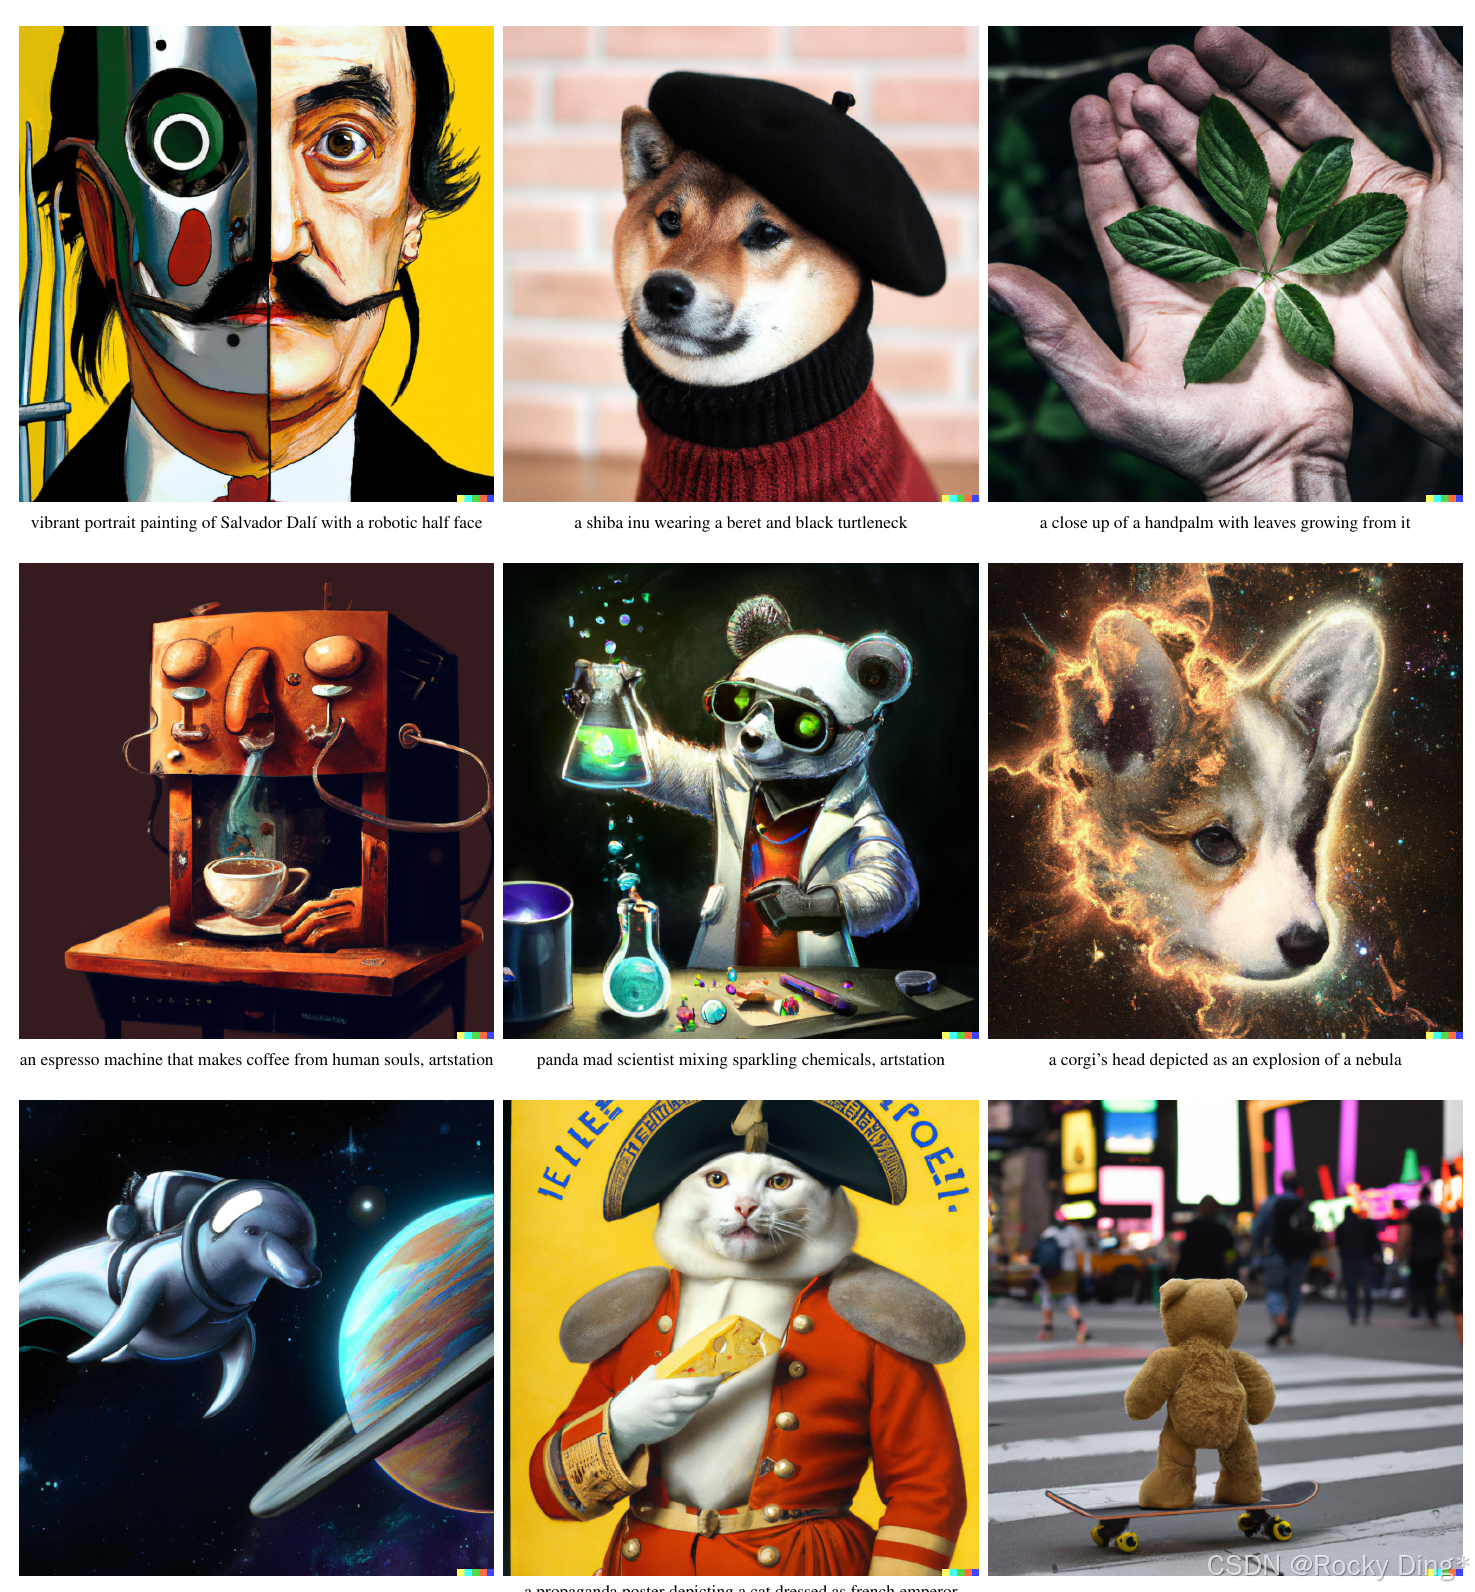
图 1 展示的是生产版本模型的 1024×1024 样例。它的视觉冲击力很强,但更值得注意的是:这些图并不是论文论证的全部。论文真正想证明的是,CLIP 图像嵌入可以作为一个生成系统的语义中枢;只要这个中枢足够好,系统就可以在画质、多样性、图像变体、语言编辑之间获得一种新的平衡。
用今天的眼光回看,这篇论文的跨周期价值在于:它不是单纯堆模型规模,而是在“表征模型”和“生成模型”之间建立了一条可复用的桥。后来的很多多模态生成系统,无论是否沿用 unCLIP 这套具体实现,都会反复面对同一个问题:语义应该在哪里被建模?像素应该在哪里被生成?可控性应该依附在哪一层表征上?
问题背景:作者到底想解决什么
论文开篇其实站在两个技术潮流的交叉点上。一边是 CLIP 这类大规模图文对比学习模型,它们在互联网图文数据上学到鲁棒的图像与文本共同表征;另一边是扩散模型,它们在图像生成质量上快速接近并超越早期 GAN、VQ-VAE、autoregressive image token 等路线。
但这两条路线各有短板。CLIP 很会“看懂”图文关系,却不是生成模型;扩散模型很会把噪声还原成图像,但如果直接用文本条件做生成,在高 guidance scale 下常常出现 fidelity 和 diversity 的冲突:图更清楚、更像 prompt 了,但结果也更容易收敛到少数相似模式。
作者要解决的问题可以概括为一句话:能不能让 CLIP 负责语义表征,让扩散模型负责视觉渲染,从而构建一个既能生成高质量图片,又能保留语义多样性和图像操作能力的文本生成图像系统?
这也是标题里 “Hierarchical Text-Conditional Image Generation with CLIP Latents” 的含义。所谓 hierarchical,不只是分辨率从低到高的层次,而是生成链条本身被拆成了语义层和视觉层:先生成 CLIP image embedding,再生成图像。
核心思路:用一句主线串起来
unCLIP 的主线非常清楚:冻结一个已经训练好的 CLIP,把它的图像嵌入空间当作中间语义空间;训练一个 prior 从文本生成 CLIP 图像嵌入;再训练一个 diffusion decoder 从 CLIP 图像嵌入生成图片。
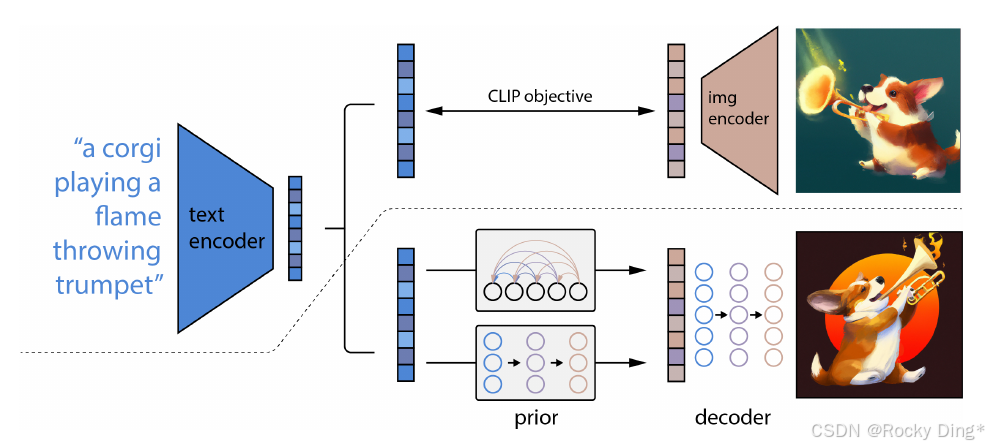
图 2 是整篇论文最重要的结构图。虚线以上是 CLIP 的训练:图像编码器和文本编码器被拉到同一个表征空间里。虚线以下是 unCLIP 的生成:文本先经过 CLIP text encoder 得到文本嵌入,再由 prior 生成一个可能的 CLIP image embedding,最后 decoder 根据这个图像嵌入生成图片。
这套设计的微妙之处在于,CLIP 在 prior 和 decoder 训练时是冻结的。换句话说,作者没有让生成模型重新发明一套语义空间,而是承认 CLIP 已经学到了一种足够有用的图文语义压缩方式。Rocky 认为,这里体现的是一种很典型的 AI 系统工程思路:不是所有能力都要在一个模型里端到端硬学,有时更稳的路线是把已被验证的表征能力变成系统中的基础设施。
论文把整个生成过程写成如下分解:
P ( x ∣ y ) = P ( x , z i ∣ y ) = P ( x ∣ z i , y ) P ( z i ∣ y ) P(x|y)=P(x,z_i|y)=P(x|z_i,y)P(z_i|y) P(x∣y)=P(x,zi∣y)=P(x∣zi,y)P(zi∣y)
这里 y y y 是文本 caption, x x x 是图像, z i z_i zi 是由 CLIP image encoder 得到的图像嵌入。因为 z i z_i zi 是图像 x x x 的确定性函数,所以可以把文本到图像的生成拆成两个阶段:先从文本采样一个图像语义嵌入 P ( z i ∣ y ) P(z_i|y) P(zi∣y),再从这个嵌入生成图像 P ( x ∣ z i , y ) P(x|z_i,y) P(x∣zi,y)。
这不是一个纯数学上的漂亮分解,而是系统设计上的关键决定。它把“语义生成”和“像素生成”分开了:prior 负责在 CLIP latent 里决定图像大意,decoder 负责把大意渲染成具体视觉结果。
方法展开:沿着论文原始逻辑拆解
1. Decoder:把 CLIP 图像嵌入反演成图像
论文首先训练的是 decoder,因为只有能够把 CLIP image embedding 反演回图像,CLIP latent 才能成为可用的生成中间层。作者使用扩散模型作为 decoder,并在 GLIDE 架构基础上加入 CLIP embedding 条件:一方面把 CLIP embedding 投影后加到 timestep embedding 上,另一方面把它投影成额外的 context token,与 GLIDE text encoder 输出拼接。
这里要注意一个细节:decoder 仍然保留文本条件路径。作者的直觉是,CLIP embedding 可能会丢掉一些自然语言细节,比如变量绑定、属性与对象关系,额外的文本路径也许能补上。但论文后面的限制分析显示,这条路径并没有真正解决 binding 问题。这一点很关键,因为它说明 CLIP latent 的优势和短板都会沿着系统传递。
为了生成高分辨率图像,系统采用分层扩散上采样:基础 decoder 生成 64×64 图像,再用两个 upsampler 分别放大到 256×256 和 1024×1024。上采样阶段不使用文本条件,也不使用 attention,而是通过训练时加入 blur 或 BSR degradation 提高鲁棒性。
Rocky 认为,这里已经能看到 DALL·E 2 的工程取向:它不是把所有复杂度塞进一个巨大模型,而是把任务拆成“语义 latent 生成、低分辨率视觉生成、高分辨率修复/放大”几个职责明确的模块。这样的系统更复杂,但也更可控。
2. Prior:从文本生成 CLIP 图像嵌入
有了 decoder 还不够。如果没有 prior,系统只能做图像反演、变体和编辑,不能真正从文本生成图像。因此 prior 是 unCLIP 作为文本生成图像系统的核心。
论文比较了两类 prior:
| Prior 类型 | 建模对象 | 主要做法 | 论文中的结论 |
|---|---|---|---|
| Autoregressive prior | 离散化后的 CLIP image embedding 序列 | PCA 降维到 319 维,再量化成 1024 个 bucket,用 Transformer 自回归预测 | 可行,但训练与采样成本更高 |
| Diffusion prior | 连续 CLIP image embedding | 在 latent 空间上训练高斯扩散模型,直接预测去噪后的 z i z_i zi | 相同规模下更高效,质量更好 |
AR prior 的设计很有意思。作者发现使用 SAM 训练后的 CLIP 表征秩显著降低,于是将 1024 维 CLIP image embedding 用 PCA 压缩到 319 个主成分,并且仍能保留几乎全部信息。然后按照主成分重要性排序、离散化、用 Transformer 逐 token 预测。
Diffusion prior 则更直接:把 CLIP image embedding 当作一个连续向量,在 latent 空间上做扩散。模型输入序列包含文本、CLIP text embedding、diffusion timestep、加噪后的 CLIP image embedding,以及一个用于输出预测的最终 embedding。训练目标不是预测噪声 ϵ \epsilon ϵ,而是直接预测未加噪的 z i z_i zi:
L p r i o r = E t ∼ [ 1 , T ] , z i ( t ) ∼ q t [ ∥ f θ ( z i ( t ) , t , y ) − z i ∥ 2 ] L_{\mathrm{prior}}=\mathbb{E}_{t\sim[1,T],z_i^{(t)}\sim q_t} \left[\|f_\theta(z_i^{(t)},t,y)-z_i\|^2\right] Lprior=Et∼[1,T],zi(t)∼qt[∥fθ(zi(t),t,y)−zi∥2]
这个选择也很有启发:当生成目标不是图像像素,而是一个高层语义向量时,扩散模型不一定要完全照搬图像扩散的噪声预测范式。论文中 diffusion prior 在计算效率和样本质量上都优于 AR prior,这也预示了后续“latent space diffusion”会成为一个非常重要的路线。
3. 图像变体:CLIP latent 保留什么,就能稳定什么
unCLIP 不只是文本生成图像。因为 decoder 学会了从 CLIP image embedding 生成图像,所以给定一张图像,把它编码到 CLIP latent 后再解码,就可以产生语义相似但细节不同的变体。
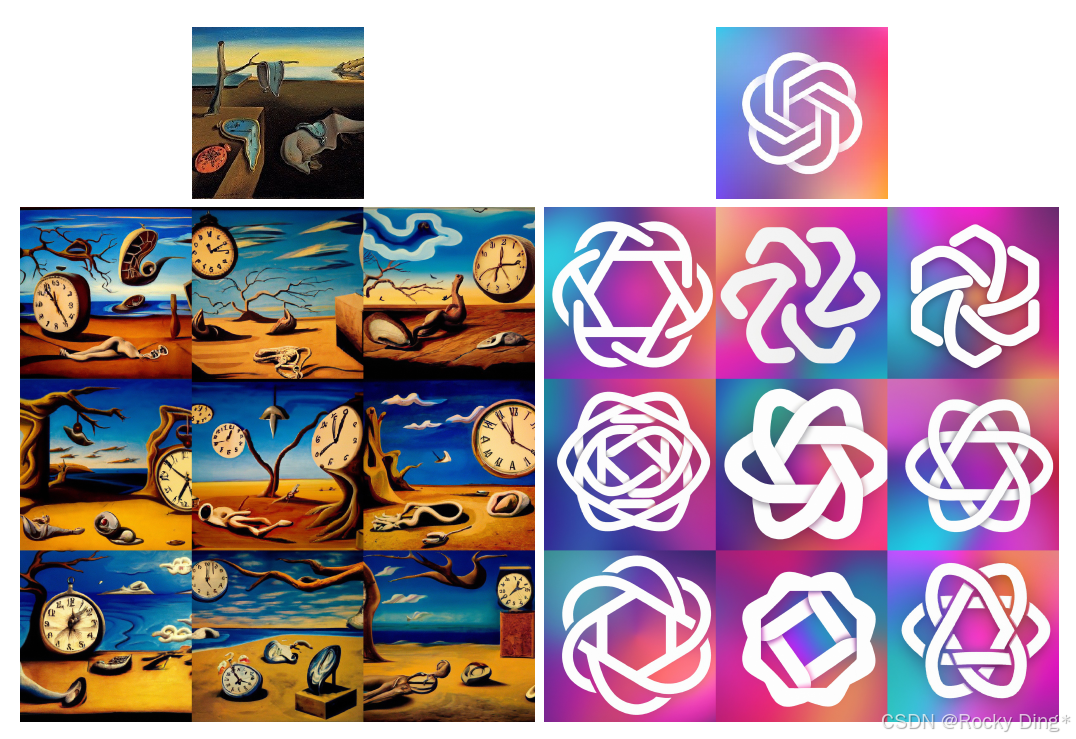
图 3 展示的是同一输入图像经过 CLIP 编码和 diffusion decoder 解码后的多种变体。它们保留了被 CLIP 认为重要的内容和风格,比如画面里有钟、logo 中的重叠笔触、画作的超现实风格、色彩渐变等;但具体形状、朝向、局部纹理会变化。
这张图真正说明的不是“模型会生成相似图”,而是 CLIP latent 是一种有损语义压缩。它保留的是 CLIP 识别到的语义和风格,不保留所有像素级细节。Rocky 认为,这就是这篇论文最有解释力的地方:模型的可控性来自 latent 的信息瓶颈,而不是来自某个后处理技巧。
论文进一步把图像表示为一个二元 latent: ( z i , x T ) (z_i,x_T) (zi,xT)。其中 z i z_i zi 是 CLIP image embedding,表示 CLIP 看到的东西; x T x_T xT 是通过 DDIM inversion 得到的扩散初始噪声,保存 decoder 重建原图需要的残差信息。令 DDIM 采样参数 η = 0 \eta=0 η=0 时,decoder 近似确定性重建输入图;增大 η \eta η 时,采样引入随机性,生成围绕原图语义的变体。
4. 图像插值:CLIP 空间里的语义路径
如果一张图可以编码进 CLIP latent,那么两张图之间也可以在 CLIP latent 中做插值。论文使用 spherical interpolation,在两个图像嵌入之间旋转:
z i θ = s l e r p ( z i 1 , z i 2 , θ ) z_{i_\theta}=\mathrm{slerp}(z_{i_1},z_{i_2},\theta) ziθ=slerp(zi1,zi2,θ)
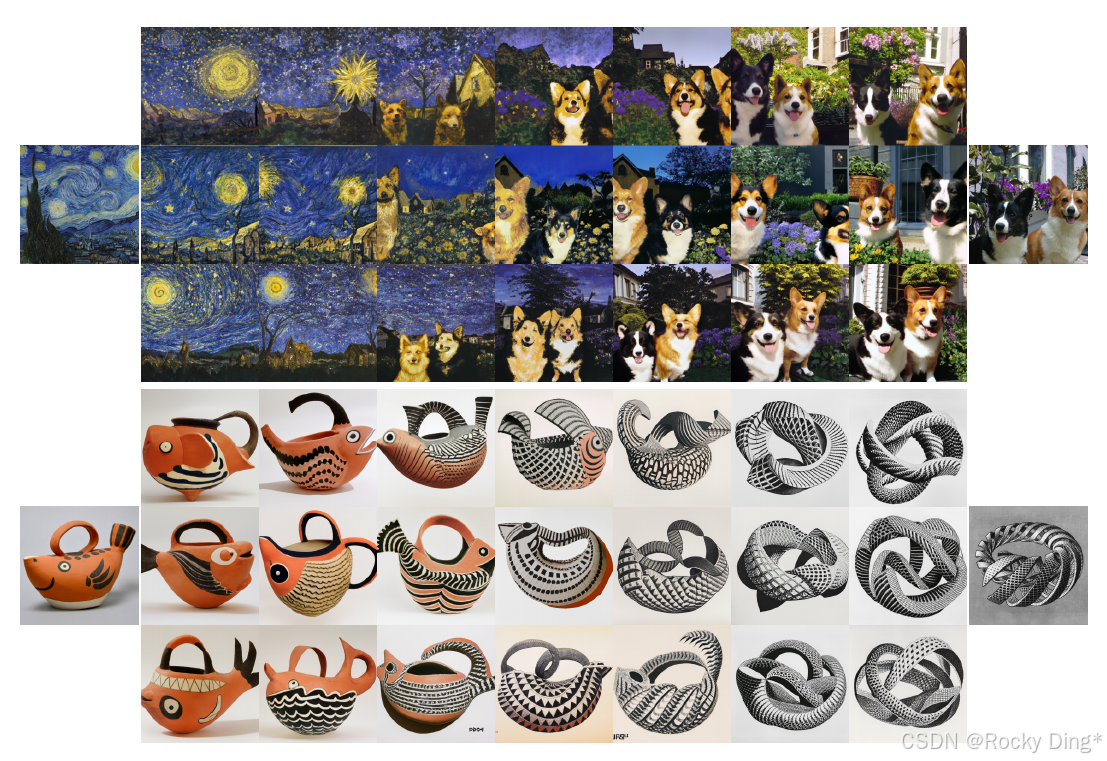
图 4 展示的是两个输入图像之间的连续变化。这里的重点不是简单 morph,而是内容和风格在 CLIP 的语义空间中自然混合。作者还区分了两种 DDIM latent 处理方式:一种是同时插值 x T x_T xT,让路径端点更接近原图;另一种是固定随机采样的 DDIM latent,使每条路径不必严格复原端点,但可以产生无限多条语义过渡轨迹。
这背后的产品含义很直接:一旦生成系统拥有一个语义连续的 latent 空间,“生成”就不再是一次性抽卡,而可以变成探索、调节、导航。今天很多图像生成产品里的 variation、style blending、reference mixing,其实都在解决同类问题。
5. Text Diffs:语言编辑为什么能在图像 latent 上成立
CLIP 的特殊之处在于图像和文本共享一个表征空间。因此,作者可以用文本嵌入之间的差向量来做图像编辑。给定原始描述 y 0 y_0 y0 和目标描述 y y y,先得到二者的 CLIP text embedding z t 0 z_{t_0} zt0 与 z t z_t zt,再构造 normalized text diff:
z d = n o r m ( z t − z t 0 ) z_d=\mathrm{norm}(z_t-z_{t_0}) zd=norm(zt−zt0)
然后在图像嵌入 z i z_i zi 和文本差向量 z d z_d zd 之间做球面插值:
z θ = s l e r p ( z i , z d , θ ) z_\theta=\mathrm{slerp}(z_i,z_d,\theta) zθ=slerp(zi,zd,θ)
其中 θ \theta θ 通常从 0 增加到 0.25 到 0.50 之间。最终 decoder 使用固定的 DDIM noise 解码这些中间表示,从而让图像沿着语言指定的方向变化。
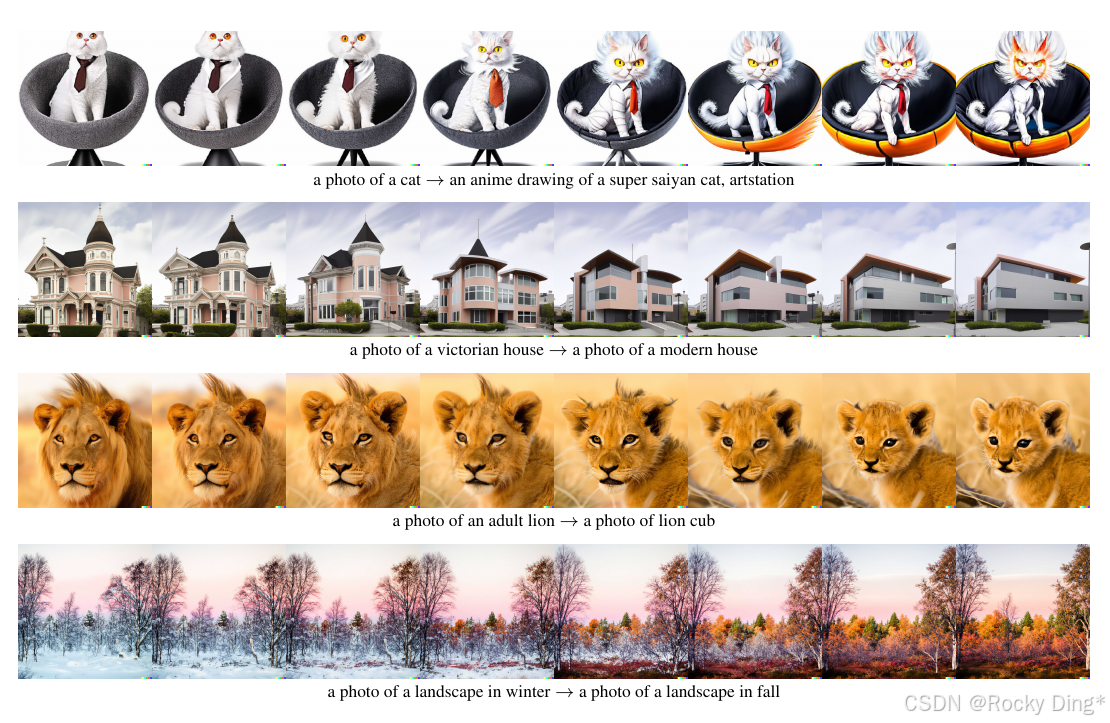
图 5 是很早期但很重要的语言引导图像编辑案例。它说明,只要文本和图像在同一个语义空间里,语言就可以不只是 prompt,而可以成为 latent space 中的操作向量。这里有一个很本质的判断:真正有长期价值的 AIGC 编辑能力,不只是“把 prompt 写得更准”,而是让用户能在可理解的语义维度上移动图像。
当然,这种编辑不是完美的。因为 CLIP latent 本身是粗语义压缩,它对对象关系、文字拼写、局部几何并不精确,所以 text diff 更适合风格、概念、类别、氛围等方向,不适合需要强绑定和精确结构的编辑。
Probing CLIP Latent Space:把生成模型变成表征显微镜
论文第 4 节非常有意思:作者不只是用 CLIP latent 生成图像,还用 decoder 观察 CLIP 到底“看见”了什么。这个思路值得单独强调,因为它把生成模型变成了表示学习的解释工具。
1. Typographic attack:分类概率错了,latent 里还藏着什么
CLIP 过去被指出容易受到 typographic attack 影响:在物体上覆盖文本,模型可能会被文字诱导,把苹果识别成 iPod 或 pizza。论文用 unCLIP decoder 去可视化这些 adversarial image 的 CLIP latent。
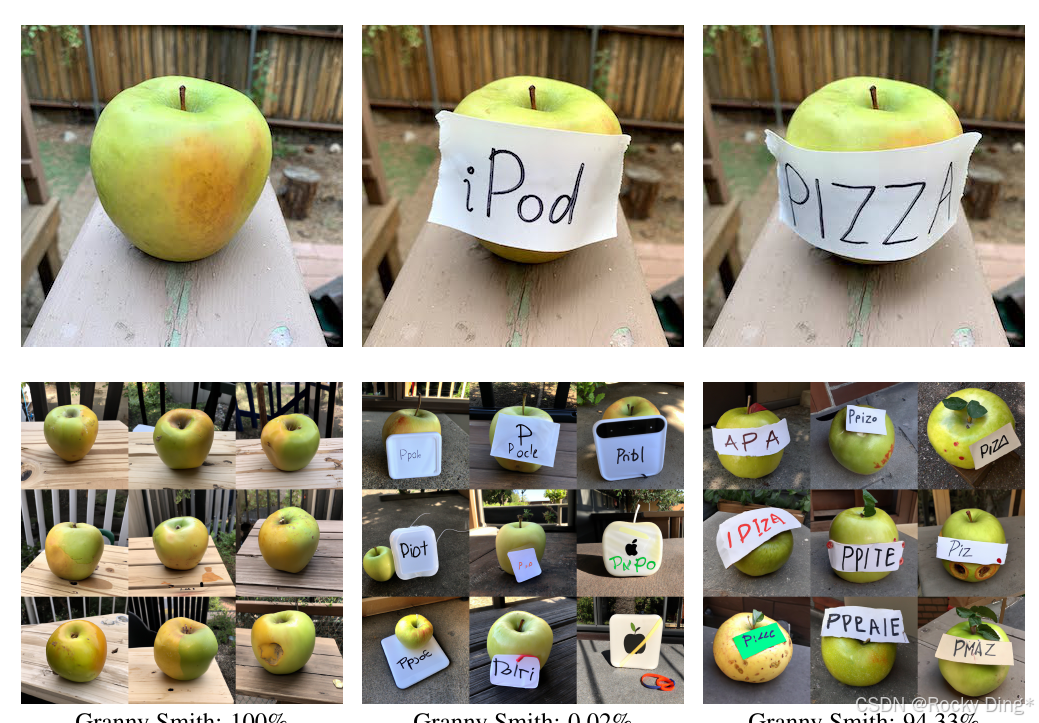
图 6 的反直觉之处在于,即便 CLIP 对 “Granny Smith” 的分类概率接近 0%,decoder 仍然高概率重建出苹果,而不是 iPod。这说明 CLIP 的最终分类概率并不等价于 embedding 中包含的全部信息。文字攻击可能改变了 label probability 的排序,但图像 embedding 里仍然保留了苹果的视觉语义。
这点很重要。它提醒我们,不要把一个模型的外部输出当成它内部表征的全部。Rocky 认为,这也是今天理解大模型和多模态模型时容易犯的错误:输出层是决策,embedding 层是压缩后的世界模型片段,两者有联系,但不能画等号。
2. PCA 维度:CLIP latent 的粗语义和细节如何分布
论文还用 PCA 主成分重建来观察 CLIP latent 中的信息层级。
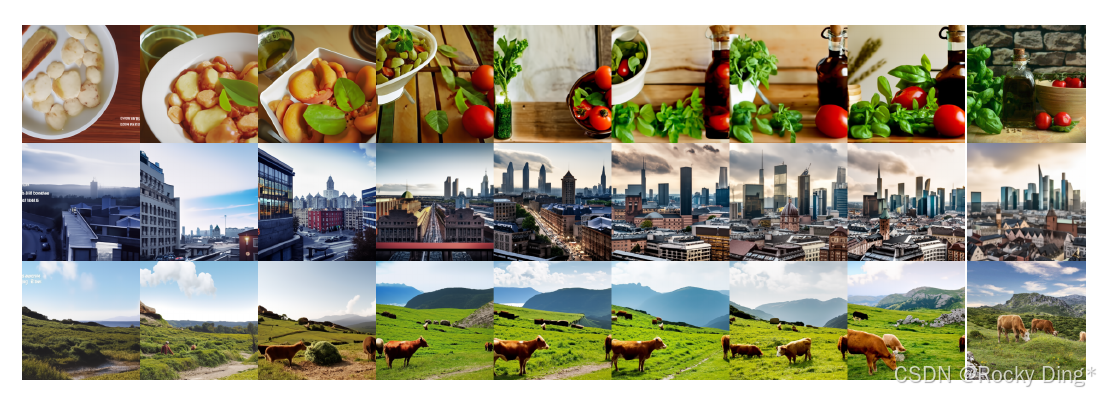
图 7 从 20、30、40、80、120、160、200、320 个 PCA 维度逐步重建 CLIP latent。低维度已经能保留场景中的粗粒度语义,比如有食物、有容器、有动物、有城市;更高维度则逐步恢复对象形态、布局和更细节的视觉线索。
这张图同时解释了 AR prior 为什么要按主成分顺序建模。早期主成分更像“语义骨架”,后期主成分更像“细节补充”。如果从产品体验看,这也是为什么生成图像先要“像那么回事”,再追求细节准确。语义骨架错了,细节越精美反而越违和。
Text-to-Image Generation:为什么 prior 是系统的灵魂
论文第 5 节进入真正的文本生成图像评估。这里作者先问了一个关键问题:既然 decoder 也能接收文本,那 prior 是否真的必要?
答案是必要。
1. 只给文本、给文本 embedding、给 prior 生成的 image embedding,有什么差别
作者比较了三种条件信号:第一,只给 caption,把 CLIP image embedding 置零;第二,把 CLIP text embedding 当成 image embedding 直接喂给 decoder;第三,用 prior 根据 caption 生成 CLIP image embedding,再交给 decoder。
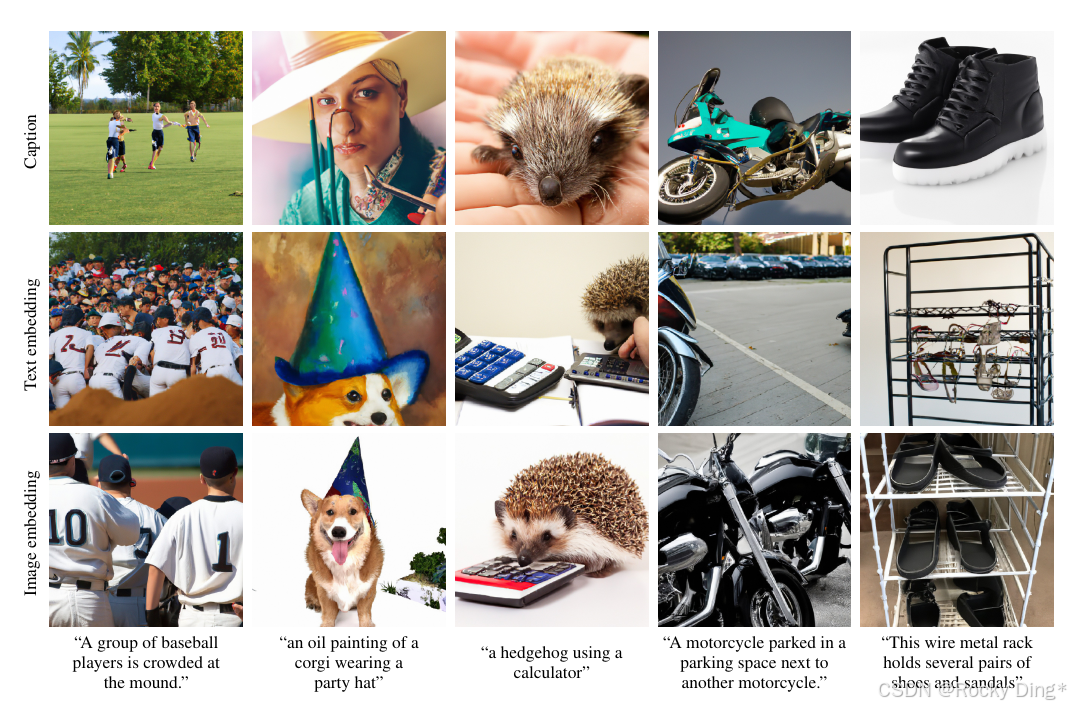
图 8 展示得很直观:只靠 caption 的结果最弱;把 text embedding 直接当 image embedding 可以生成合理结果,但质量不如完整 unCLIP;prior 生成的 image embedding 明显更适合作为 decoder 的条件。定量结果也支持这个结论:text-embedding decoder、完整 unCLIP、zero-shot text embedding 输入 unCLIP decoder 的 FID 分别是 9.16、7.99、16.55。人类评估中,完整 unCLIP 在 photorealism 上以 57.0% ± 3.1% 被偏好,在 caption similarity 上以 53.1% ± 3.1% 被偏好。
这说明一个很关键的事实:CLIP text embedding 和 CLIP image embedding 虽然处在同一空间,但并不意味着它们在生成任务中可以无损互换。prior 的作用不是机械地“把文本翻译成向量”,而是把文本映射到更像真实图像分布的 image embedding 区域。
2. Human evaluation:unCLIP 换来的不是全面碾压,而是多样性的结构性优势
论文比较 unCLIP 与 GLIDE,在 photorealism、caption similarity、diversity 三个维度做人类评估。
| unCLIP Prior | Photorealism | Caption Similarity | Diversity |
|---|---|---|---|
| AR | 47.1% ± 3.1% | 41.1% ± 3.0% | 62.6% ± 3.0% |
| Diffusion | 48.9% ± 3.1% | 45.3% ± 3.0% | 70.5% ± 2.8% |
表 1 的数字很诚实:unCLIP 并没有在 photorealism 和 caption similarity 上全面击败 GLIDE。尤其 caption similarity,GLIDE 仍然更强。但 unCLIP 在 diversity 上明显占优,diffusion prior 版本被偏好的概率达到 70.5% ± 2.8%。
Rocky 认为,这恰恰是这篇论文最值得读的地方。它不是用一个单点指标讲“我全赢了”,而是提出了一个更本质的问题:在图像生成里,质量、多样性和文本匹配不是同一个东西。一个模型如果只追求 prompt adherence 和 photorealism,很容易把采样空间压窄;而 unCLIP 通过 CLIP image embedding 先决定语义,再让 decoder 做视觉 refinement,使 diversity-fidelity trade-off 发生了变化。
3. Guidance 为什么不再那么容易压塌多样性
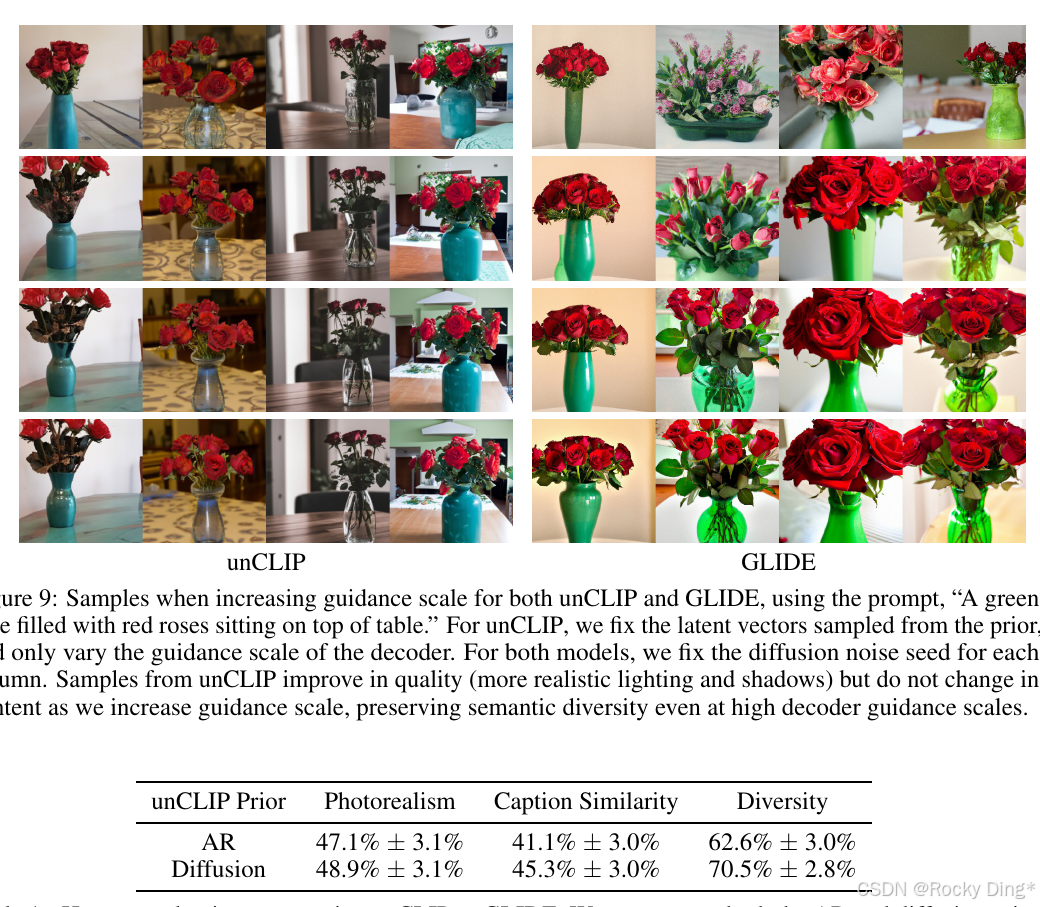
图 9 是理解 unCLIP 的关键证据。随着 guidance scale 增大,GLIDE 的语义内容、角度、颜色、物体大小等会逐渐趋同;而 unCLIP 在固定 prior 采样得到的 latent 后,只调整 decoder guidance,图像质量提高,但语义内容没有明显坍缩。
这里的机制是:GLIDE 的 guidance 直接作用在文本到图像的扩散采样过程中,语义和视觉一起被拉向高置信区域;unCLIP 的语义多样性已经由前面的 CLIP image embedding 承载,decoder guidance 更多是在已有语义内容上提升图像质量。因此高 guidance 不必同等程度地牺牲语义多样性。
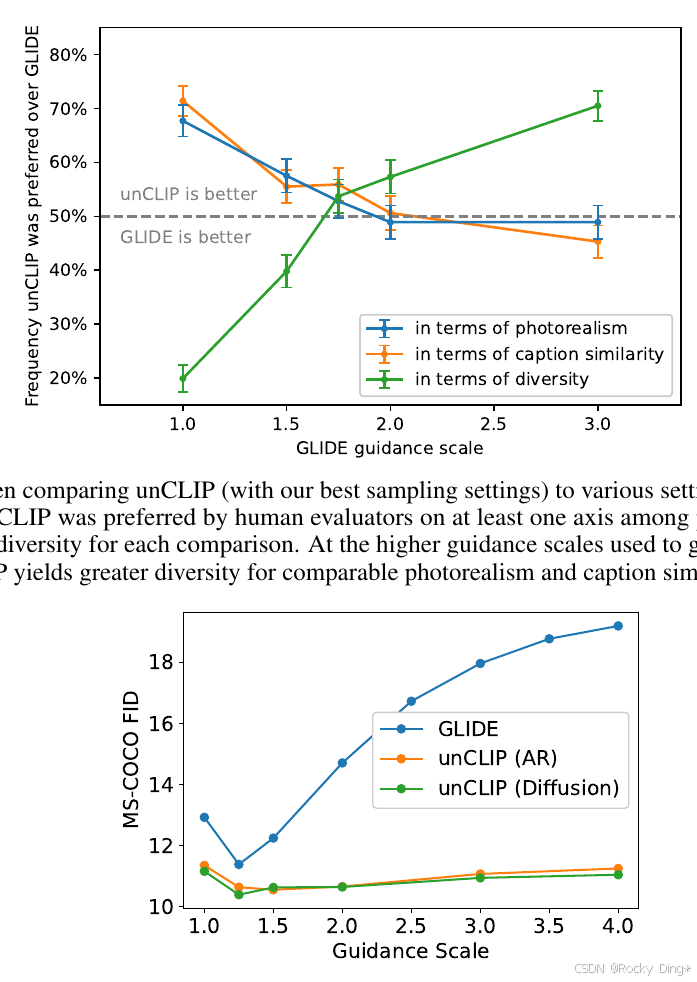
图 10 进一步比较了 unCLIP 与不同 guidance scale 的 GLIDE。结果显示,在 GLIDE guidance scale 2.0 左右,photorealism 和 caption similarity 与 unCLIP 接近,但 diversity 仍然不如 unCLIP。也就是说,GLIDE 可以通过降低 guidance 挽回一部分多样性,但难以同时保持质量、文本匹配和多样性。
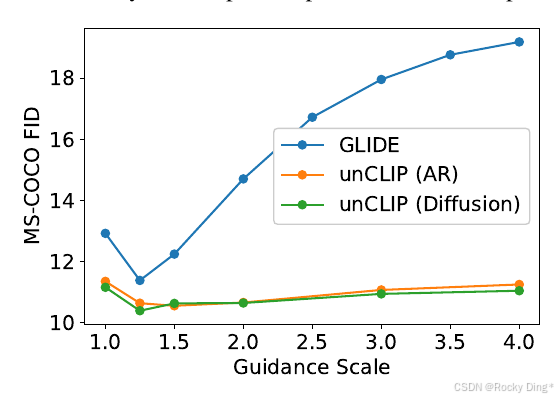
图 11 用 FID 从另一个角度说明同一件事。GLIDE 的 FID 随 guidance scale 增大显著变差,而 unCLIP 的 FID 更稳定。这并不是因为 FID 完美衡量生成质量,而是因为 FID 会惩罚多样性不足;当 guidance 压缩生成分布时,FID 会受到影响。
实验与证据:结果能支撑到什么程度
1. MS-COCO FID:unCLIP 在 zero-shot 设置下达到当时更强结果
论文在 MS-COCO 256×256 上比较了多个文本生成图像模型的 FID。
| Model | FID | Zero-shot FID | Zero-shot FID (filt) |
|---|---|---|---|
| AttnGAN (Xu et al., 2017) | 35.49 | ||
| DM-GAN (Zhu et al., 2019) | 32.64 | ||
| DF-GAN (Tao et al., 2020) | 21.42 | ||
| DM-GAN + CL (Ye et al., 2021) | 20.79 | ||
| XMC-GAN (Zhang et al., 2021) | 9.33 | ||
| LAFITE (Zhou et al., 2021) | 8.12 | ||
| Make-A-Scene (Gafni et al., 2022) | 7.55 | ||
| DALL-E (Ramesh et al., 2021) | ~28 | ||
| LAFITE (Zhou et al., 2021) | 26.94 | ||
| GLIDE (Nichol et al., 2021) | 12.24 | 12.89 | |
| Make-A-Scene (Gafni et al., 2022) | 11.84 | ||
| unCLIP (AR prior) | 10.63 | 11.08 | |
| unCLIP (Diffusion prior) | 10.39 | 10.87 |
表 2 显示,diffusion prior 版本 unCLIP 的 zero-shot FID 为 10.39,优于 GLIDE 的 12.24,也优于 AR prior 版本。这里要注意评估语境:unCLIP 没有直接在 MS-COCO training set 上训练,而是 zero-shot 泛化到验证集。
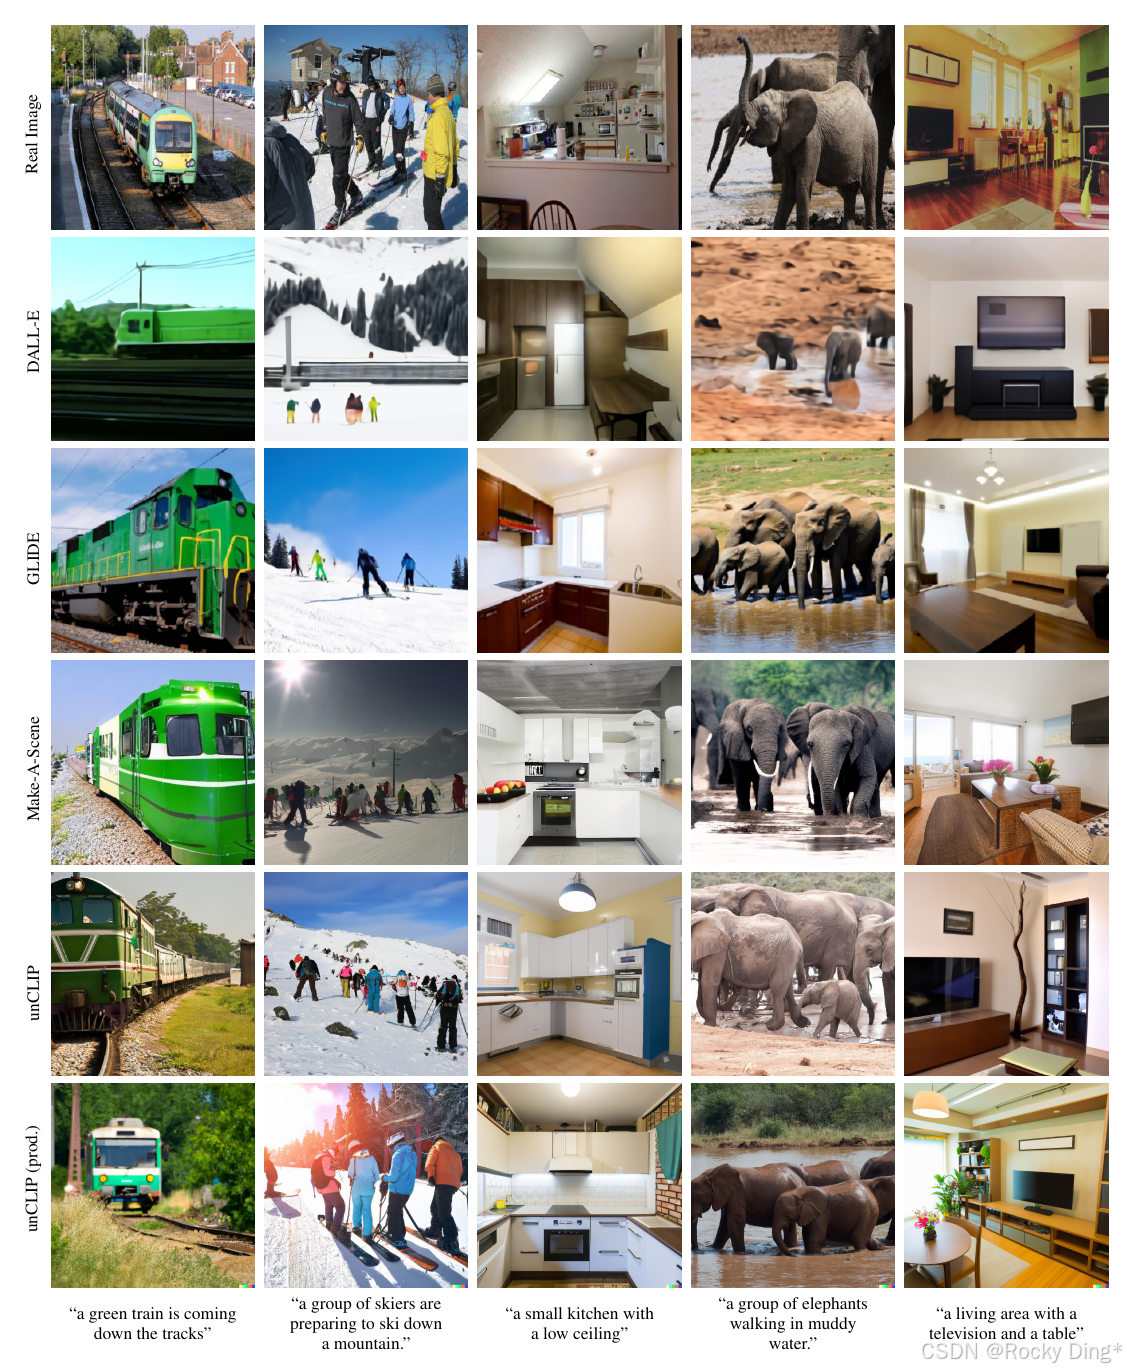
图 12 给出了一组 MS-COCO prompts 上的样例。它们说明 unCLIP 能生成合理场景并覆盖文本描述,但这类样例仍然是质性展示,不能替代表格中的系统性评估。
2. Aesthetic quality:更像产品指标,但仍是代理指标
论文还使用 512 个由 GPT-3 自动生成的 artistic prompts,比较 unCLIP 与 GLIDE 的 aesthetic quality。作者训练了一个基于 CLIP 的线性探针,用 AVA 数据集预测人类审美评分,并观察 aesthetic score 与 recall 的关系。
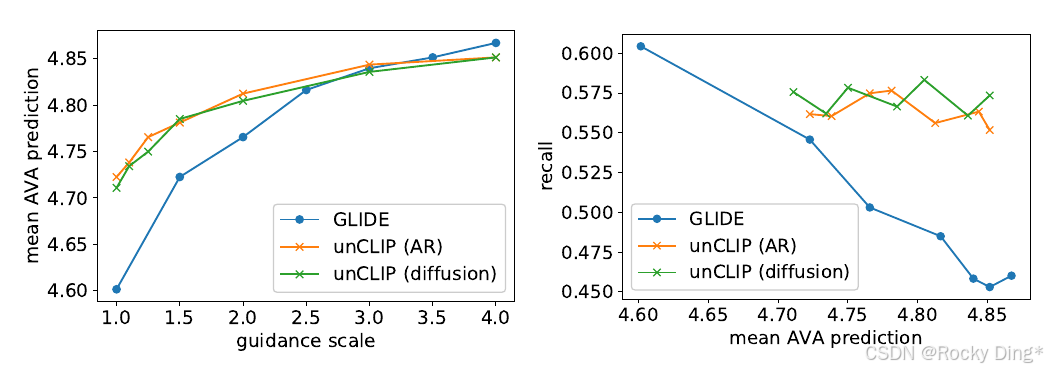
图 13 的结论是:GLIDE 和 unCLIP 都受益于 guidance,但 unCLIP 在提高审美质量时没有明显牺牲 recall。这个结果很符合前面关于 diversity-fidelity trade-off 的机制解释。
不过 Rocky 会把这类结果看得更谨慎一些。审美预测器、GPT-3 生成的艺术 prompt、CLIP 线性探针,本质上都是代理评估。它们对产品方向有参考价值,但不能等同于真实用户偏好,更不能覆盖所有文化语境和审美风格。
3. 训练规模与可复现性:这不是普通实验室能轻易复刻的路线
论文 appendix 给出了较完整的训练细节。
| 模块 | 关键配置 |
|---|---|
| CLIP image encoder | ViT-H/16,输入 256×256,width 1280,32 个 Transformer block |
| CLIP text encoder | Transformer causal mask,width 1024,24 个 block |
| CLIP 训练数据 | CLIP 与 DALL-E 数据集等概率采样,总计约 650M images |
| generative stack 训练数据 | 仅使用 DALL-E 数据集,约 250M images |
| decoder | 3.5B 参数 GLIDE 架构,64×64 基础生成 |
| AR prior | 1B 参数,text encoder width 2048,24 blocks;latent decoder width 1664,24 blocks |
| diffusion prior | 1B 参数,Transformer width 2048,24 blocks;64 sampling steps |
| upsampler | 64→256 为 700M 参数,256→1024 为 300M 参数 |
完整超参如下:
| AR prior | Diffusion prior | 64 | 64 → 256 | 256 → 1024 | |
|---|---|---|---|---|---|
| Diffusion steps | - | 1000 | 1000 | 1000 | 1000 |
| Noise schedule | - | cosine | cosine | cosine | linear |
| Sampling steps | - | 64 | 250 | 27 | 15 |
| Sampling variance method | - | analytic | learned | DDIM | DDIM |
| Crop fraction | - | - | - | 0.25 | 0.25 |
| Model size | 1B | 1B | 3.5B | 700M | 300M |
| Channels | - | - | 512 | 320 | 192 |
| Depth | - | - | 3 | 3 | 2 |
| Channels multiple | - | - | 1,2,3,4 | 1,2,3,4 | 1,1,2,2,4,4 |
| Heads channels | - | - | 64 | - | - |
| Attention resolution | - | - | 32,16,8 | - | - |
| Text encoder context | 256 | 256 | 256 | - | - |
| Text encoder width | 2048 | 2048 | 2048 | - | - |
| Text encoder depth | 24 | 24 | 24 | - | - |
| Text encoder heads | 32 | 32 | 32 | - | - |
| Latent decoder context | 384 | - | - | - | - |
| Latent decoder width | 1664 | - | - | - | - |
| Latent decoder depth | 24 | - | - | - | - |
| Latent decoder heads | 26 | - | - | - | - |
| Dropout | - | - | 0.1 | 0.1 | - |
| Weight decay | 4.0e-2 | 6.0e-2 | - | - | - |
| Batch size | 4096 | 4096 | 2048 | 1024 | 512 |
| Iterations | 1M | 600K | 800K | 1M | 1M |
| Learning rate | 1.6e-4 | 1.1e-4 | 1.2e-4 | 1.2e-4 | 1.0e-4 |
| Adam β 2 \beta_2 β2 | 0.91 | 0.96 | 0.999 | 0.999 | 0.999 |
| Adam ϵ \epsilon ϵ | 1.0e-10 | 1.0e-6 | 1.0e-8 | 1.0e-8 | 1.0e-8 |
| EMA decay | 0.999 | 0.9999 | 0.9999 | 0.9999 | 0.9999 |
表 3 说明,这项工作虽然概念上清晰,但工程门槛非常高。3.5B decoder、1B prior、两级 upsampler、数亿级图文数据,这不是一个“按论文复现即可”的项目。它更像是一个产业级图像生成系统的公开技术切片。
因此,读这篇论文时不要只问“我能不能复现 DALL·E 2”,更应该问:“哪些设计思想可以迁移?”答案包括:用强表征模型作为中间层、在 latent 空间建模高层语义、把生成系统拆成职责清楚的模块、用 human evaluation 和 proxy model 组合评估多维指标。
这篇工作的边界与可复现性
论文第 7 节很诚实地讨论了 unCLIP 的局限。它的短板几乎都与 CLIP latent 的信息瓶颈有关。
1. 属性绑定:CLIP latent 不擅长精确关系
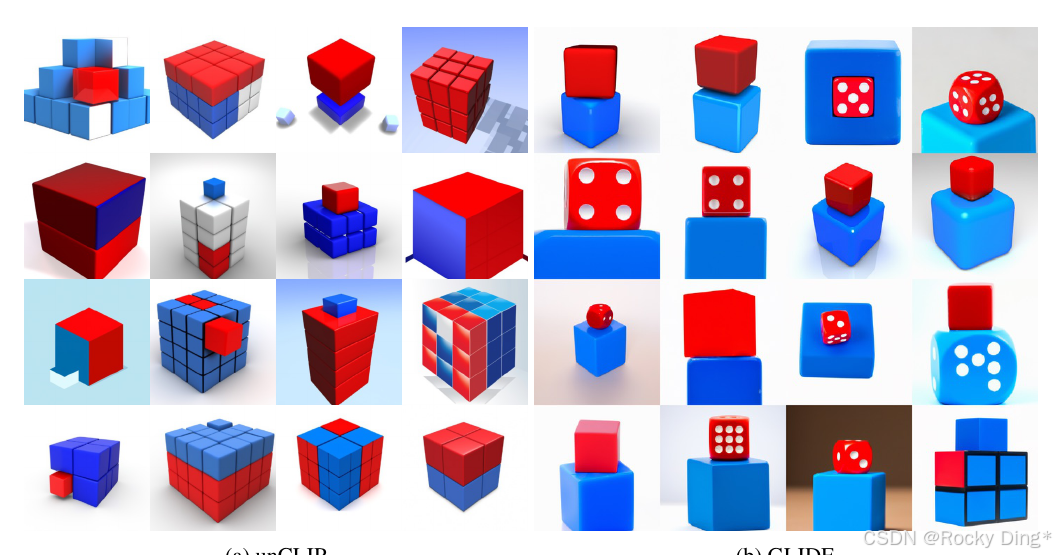
图 14 使用 prompt “a red cube on top of a blue cube” 比较 unCLIP 与 GLIDE。unCLIP 更容易混淆红蓝方块的位置和属性,说明它在 object-attribute binding 上弱于 GLIDE。
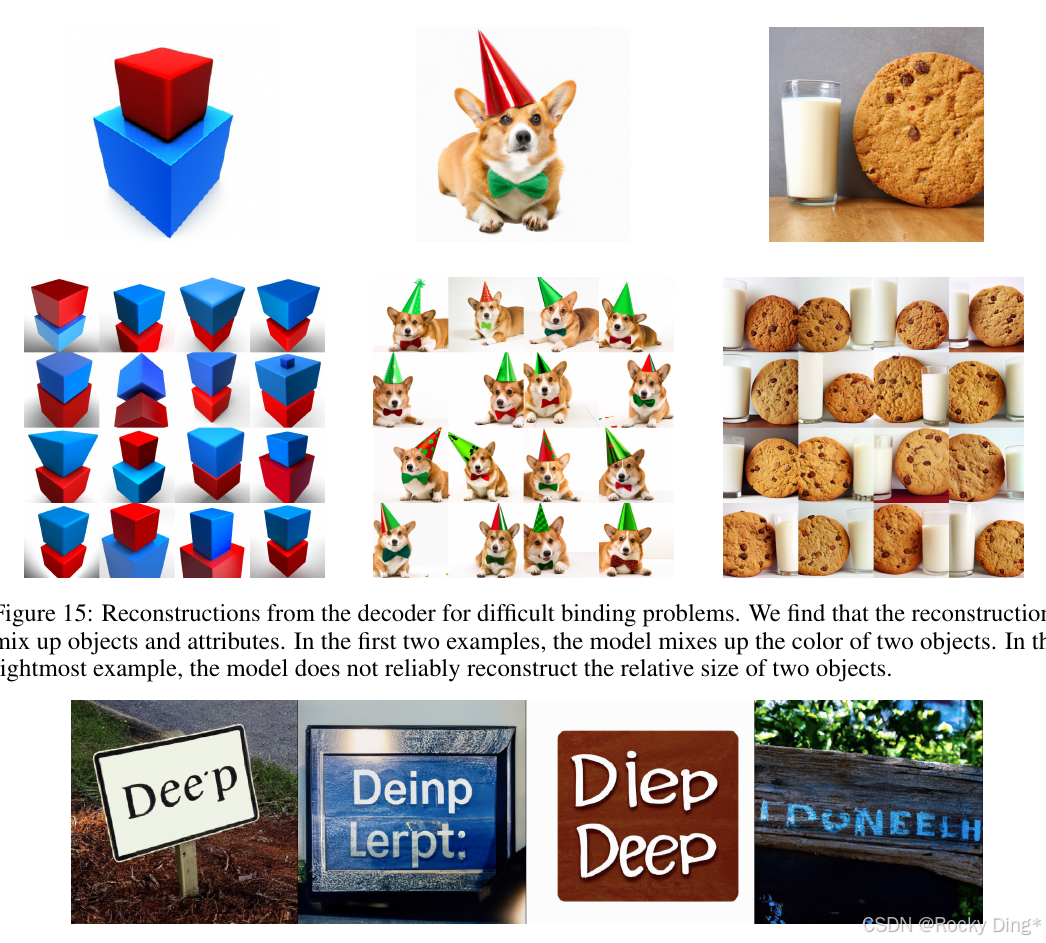
图 15 进一步说明,即便从已有图像重建,decoder 也会把属性和对象混在一起,例如两个物体的颜色互换、相对大小不稳定。作者推测这是因为 CLIP embedding 没有显式编码属性与对象之间的绑定关系。
这点非常关键。CLIP latent 强在语义压缩,弱在组合结构。它知道“红色”“蓝色”“方块”“上下关系”这些概念,但不一定以足够精细的方式保存“哪个颜色绑定到哪个对象”。这也是后来多模态生成模型反复要补的能力:更强的文本理解、更明确的布局建模、更细的 attention control、更好的视觉语言 grounding。
2. 文字生成:CLIP 不是 OCR,更不是排版引擎
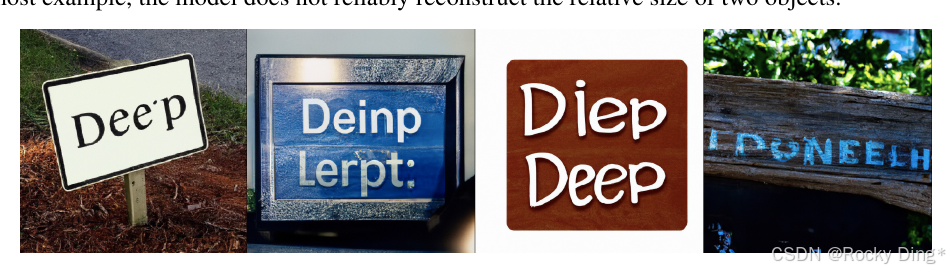
图 16 展示了 prompt “A sign that says deep learning” 的生成结果。模型知道要生成一个写着字的牌子,但无法稳定拼出正确文本。作者认为原因可能包括:CLIP embedding 没有精确编码 spelling 信息,以及 BPE 编码会遮蔽单词拼写结构,模型必须在训练图像中见过对应 token 的视觉呈现才能学会渲染。
Rocky 认为,这也是一个长期规律:语义模型天然不等于结构生成模型。文字、图表、几何布局、UI、数学公式,这些都需要比“图像像什么”更强的符号与结构控制。后来的图像模型之所以不断补文本渲染能力,本质上是在补 CLIP 时代表征压缩留下的洞。
3. 复杂场景细节:64×64 基础生成的上限
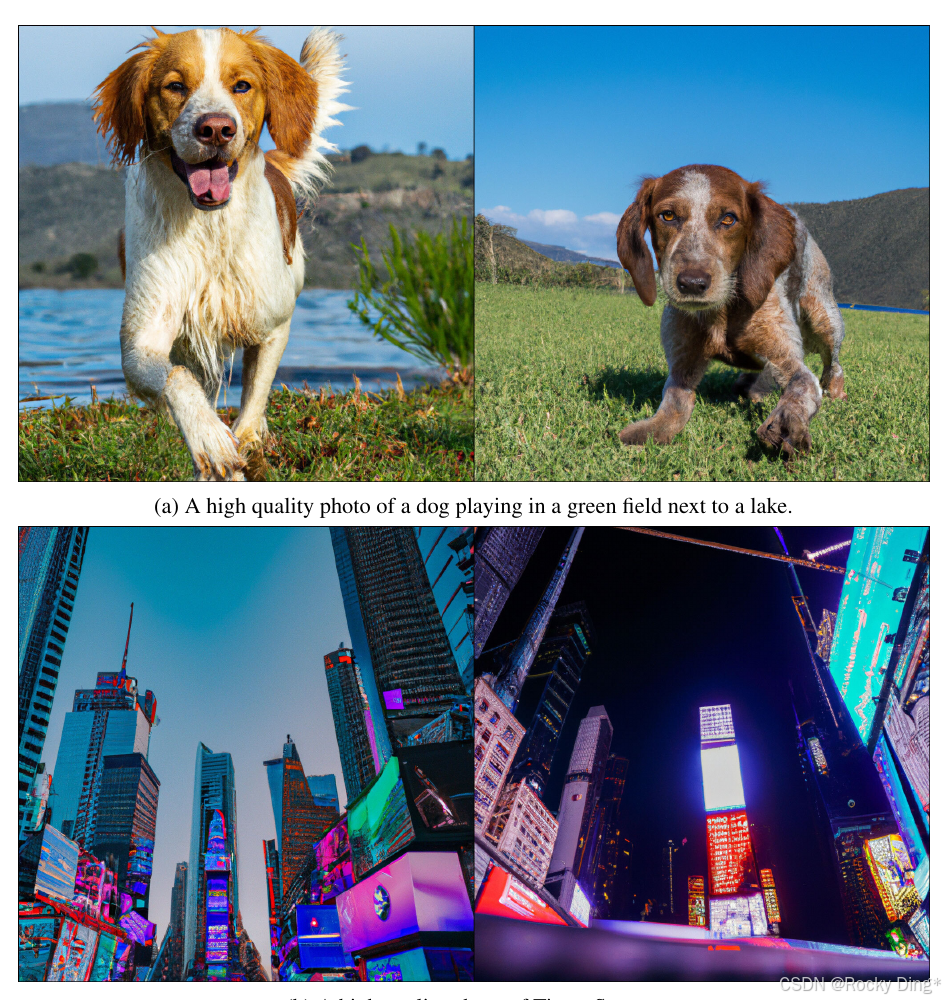
图 17 显示 unCLIP 在复杂场景细节上仍然不足。作者推测这与 decoder hierarchy 的基础分辨率只有 64×64 有关;如果提高基础生成分辨率,可能缓解问题,但会增加训练和推理成本。
这里的工程取舍很现实。低分辨率基础生成更省算力、更容易建模全局结构,但会把许多细节压力交给 upsampler;高分辨率基础生成更细,但成本显著上升。对产品来说,这类取舍会直接影响速度、价格、稳定性和最终体验。
4. 风险:越逼真,越需要部署语境约束
论文还指出,图像生成模型带来虚假内容、欺骗性内容和偏见传播等风险。unCLIP 相比 GLIDE 的性能提升会提高风险,因为生成图像更少留下明显 AI 痕迹,用户更容易混淆生成图像和真实图像。
这部分今天看并不过时。越强的生成模型越不是单纯的技术 API,而是一个部署系统:训练数据、过滤策略、访问权限、内容审核、溯源水印、用户场景都会影响真实风险。模型能力本身不是产品责任的终点,而是责任链条的起点。
如果继续研究/落地,应该关注什么
第一,继续研究更好的中间表征。CLIP latent 证明了“语义表征层”有价值,但也暴露了 binding、spelling、layout、fine-grained geometry 的不足。后续模型如果想提升可控性,就需要更丰富的视觉语言表征,或者把 scene graph、layout、region-level grounding 等结构信息引入生成链条。
第二,继续研究 latent-space generation。unCLIP 的 diffusion prior 说明,在高层 latent 上做扩散既高效又有效。后来 latent diffusion、DiT、rectified flow、consistency model 等路线虽然形式不同,但都在回答同一个工程问题:我们到底应该在哪个空间里生成,才能兼顾语义、效率和画质?
第三,评估要从单指标走向多维体验。unCLIP 与 GLIDE 的比较告诉我们,photorealism、caption similarity、diversity、aesthetic quality 不是同一个指标。对产品而言,还要加上编辑可控性、重复生成稳定性、失败可解释性、用户偏好一致性、成本和延迟。
第四,把图像生成当作 workflow,而不是一次性模型调用。CLIP latent 带来的 variation、interpolation、text diff 能力,其实已经把图像生成推向交互式创作。真正的产品价值不只在于第一张图有多漂亮,而在于用户能否沿着自己的意图持续收敛。
第五,不要把论文里的 production model 样例误读成完全可复现结果。论文明确区分了实验模型和生产版本模型,生产版本有更长训练、更大或调整后的数据、更复杂的产品与安全要求。做研究分析时要看机制,做工程落地时要看资源边界。
术语与概念速查
| 术语 | 解释 |
|---|---|
| CLIP | 通过图文对比学习训练的多模态表征模型,把图像和文本映射到共同语义空间 |
| CLIP image embedding | CLIP 图像编码器输出的图像语义向量,论文中记为 z i z_i zi |
| CLIP text embedding | CLIP 文本编码器输出的文本语义向量,论文中记为 z t z_t zt |
| unCLIP | DALL·E 2 的核心生成栈,通过生成并反演 CLIP image embedding 来生成图像 |
| prior | 从文本 caption 生成 CLIP image embedding 的模型 |
| decoder | 从 CLIP image embedding 生成图像的扩散模型 |
| diffusion prior | 在 CLIP latent 连续向量空间上训练的扩散 prior |
| AR prior | 将 CLIP image embedding 降维、量化后用自回归 Transformer 预测的 prior |
| classifier-free guidance | 训练时随机丢弃条件,使模型可在推理时通过有条件和无条件预测差异提升条件一致性 |
| DDIM inversion | 将图像反推到扩散过程中的 latent/noise 状态,以便重建或编辑 |
| text diff | 两个文本嵌入的差向量,用来在 CLIP 空间中引导图像语义变化 |
| FID | 衡量生成图像分布与真实图像分布差异的指标,常用于生成模型评估 |
| Recall | 用于衡量生成样本覆盖真实数据分布程度的指标,常用于观察多样性 |
拓展思考:值得继续扩展研究与思考的创新点
1. 这篇论文的跨周期价值是什么
Rocky 认为,这篇论文最值得保留的不是具体的 DALL·E 2 工程配方,而是“用表征模型搭建生成模型中间语义层”的思想。它把图像生成从单纯像素建模,推进到一个更系统化的问题:先学世界的压缩表征,再学如何从表征中还原世界。
这也是为什么它有跨周期价值。模型架构会迭代,prior 可能从 AR 到 diffusion 再到 flow,decoder 可能从 U-Net 到 Transformer,评估指标也会变化;但“语义空间如何组织生成过程”这个问题不会消失。
2. 它和后续主流路线的关系
这篇论文与 latent diffusion 并不是同一条具体路线。latent diffusion 通常在 VAE latent 空间里做图像扩散,重点是降低像素空间扩散成本;unCLIP 则在 CLIP semantic latent 上先生成图像嵌入,再由 decoder 生成图像,重点是把图文语义表征显式纳入生成链条。
但二者共享一个更高层的方法论:不要在像素空间里解决所有问题。把图像生成拆到合适的 latent 空间,可以显著改善效率、可控性和系统结构。今天很多多模态模型把文本、图像、视频、3D、动作统一到更抽象的 token 或 latent 表示上,本质上也在延续这个方向。
3. 它为什么仍然不够
unCLIP 的短板也很清楚:CLIP latent 太语义化,所以弱于精确绑定、文字拼写、空间布局和复杂细节。这提醒我们,表征不是越抽象越好。真正强的生成系统需要多层表征:高层语义负责概念,中层结构负责对象关系和布局,低层视觉负责纹理、光照和细节。
这也是后续研究可以继续推进的方向:把 CLIP 式全局表征扩展到 region-level、object-level、layout-level、3D-aware、temporal-aware 的层级表征,让模型既能理解“画什么”,也能稳定控制“谁和谁是什么关系”“写什么字”“物体在哪”“动作如何连续”。
4. 对工程团队和创业者的启发
如果把这篇论文放到产品与商业视角看,它的启发不是“复刻一个 DALL·E 2”,而是:好的 AIGC 产品往往不是一个模型按钮,而是一套围绕用户意图持续收敛的生成系统。
variation、interpolation、text diff、本质上都是让用户从随机生成走向可控探索。今天做图像、视频、数字人、商品图、设计工具,如果只追求单次生成效果,很快会被底层模型迭代吸收;真正能沉淀下来的,是对某个工作流的理解:用户怎么描述需求、怎么选择结果、怎么局部修改、怎么保持风格一致、怎么进入交付链条。
工具红利退潮之后,认知红利会上升。DALL·E 2 这篇论文给我们的不是一个永远领先的模型,而是一种系统判断:表征、生成、编辑、评估和部署风险必须被放在同一张图里看。能看懂这张图的人,才有机会在下一轮多模态生成浪潮里做出真正有复利的东西。
附录:论文随机样例补充
论文 appendix 中还给出了三个 production model 的随机样例,用来展示同一 prompt 下的样本多样性。这些图不承担主要机制论证,但有助于理解 unCLIP 在复杂艺术风格、概念组合和场景生成上的表现。
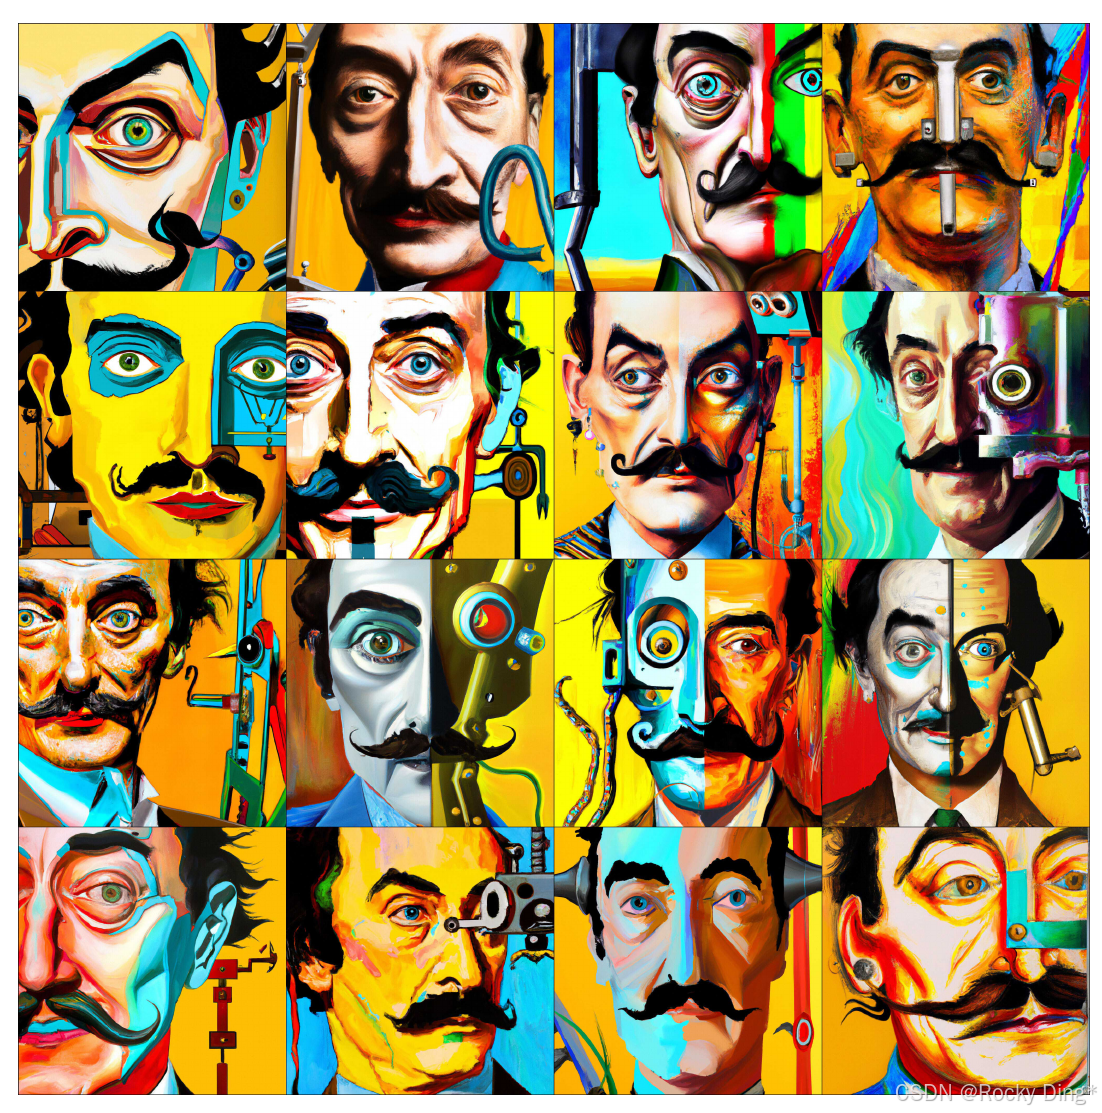
图 18 对应 prompt “Vibrant portrait painting of Salvador Dali with a robotic half face”。它展示了模型在艺术风格、人脸概念和机械元素组合上的多样表达。
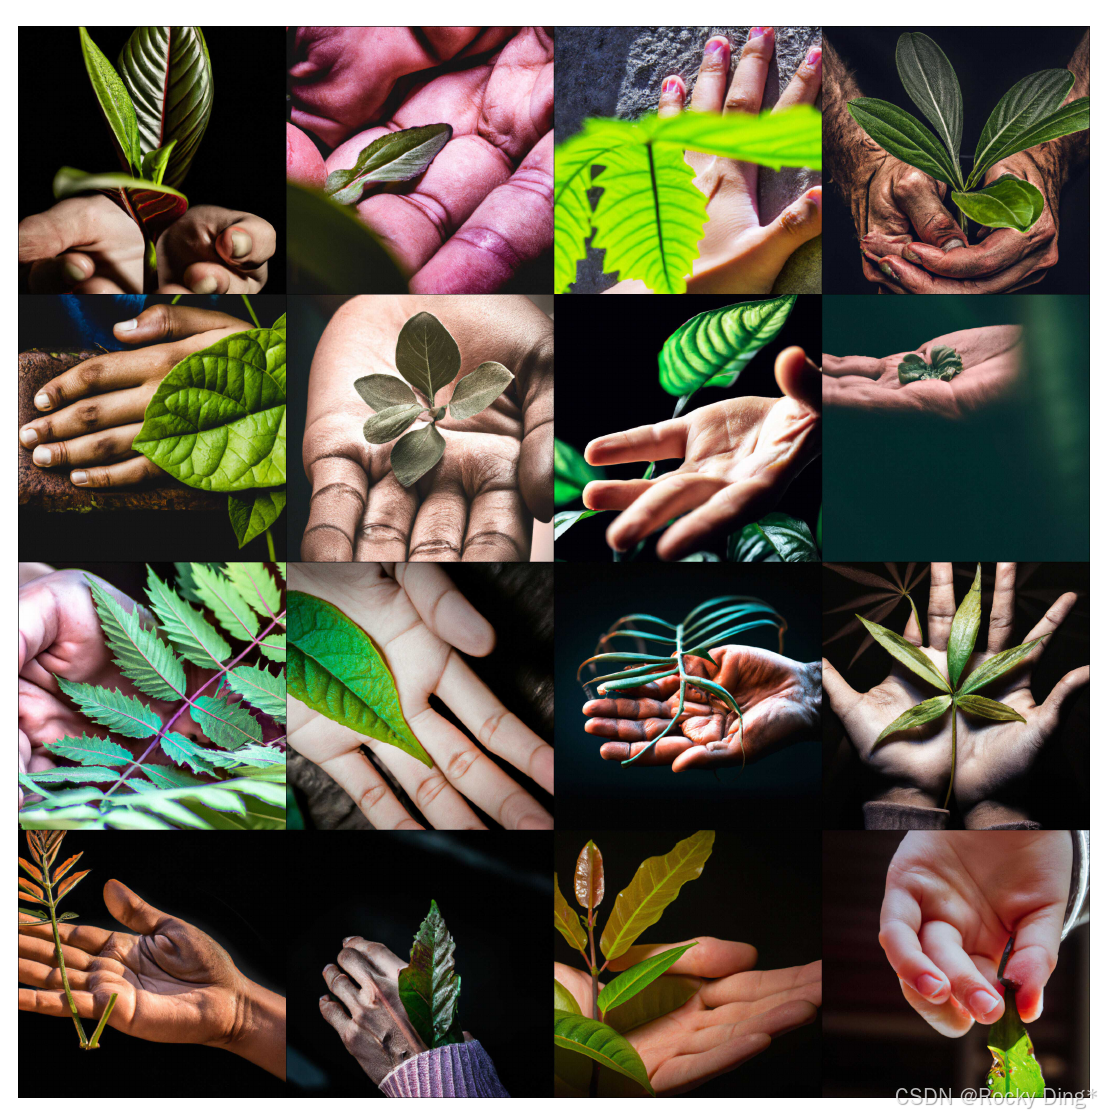
图 19 对应 prompt “A close up of a handpalm with leaves growing from it”。这个例子更接近概念摄影和超现实组合,说明模型能把人体局部和植物生长概念融合。
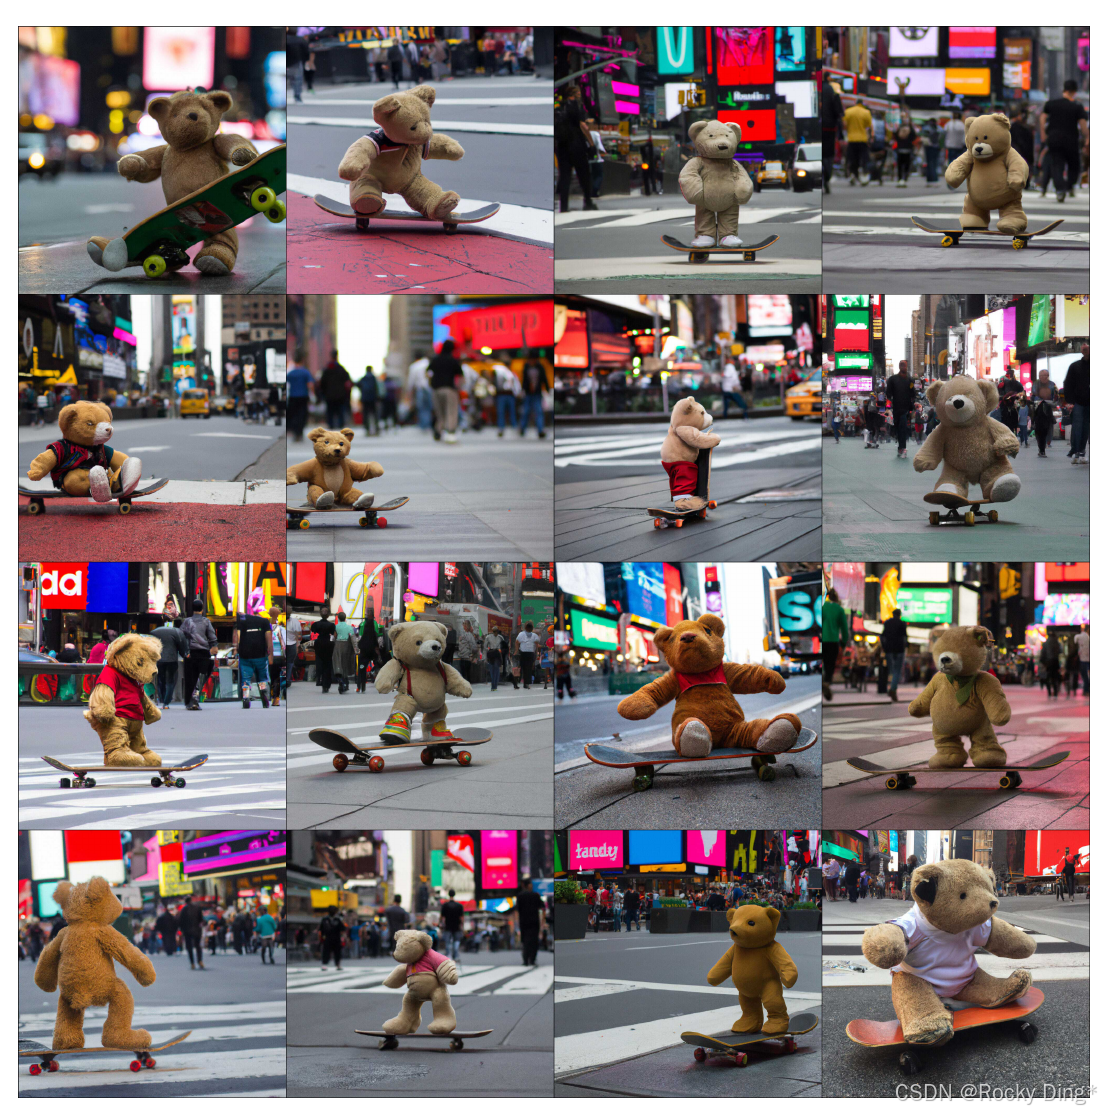
图 20 对应 prompt “A teddybear on a skateboard in Times Square”。它展示了同一语义条件下场景、姿态、街景细节的多样采样,也呼应了论文关于 unCLIP diversity 的主张。
推荐阅读
Rocky一直在运营技术交流群(WeThinkIn-技术交流群),这个群的初心主要聚焦于技术话题的讨论与学习,包括但不限于算法,开发,竞赛,科研以及工作求职等。群里有很多人工智能行业的大牛,欢迎大家入群一起学习交流~(请添加小助手微信Jarvis8866,拉你进群~)
1. 深入浅出完整解析AI Agent(AI智能体)的核心基础知识
2025年可以说是AI Agent全面落地应用的元年,因此Rocky在持续撰写对AI Agent的全维度解析文章:https://zhuanlan.zhihu.com/p/1919046969076195976
2. 深入浅出完整解析扩散模型DDPM、DDIM、Classifier/Classifier-Free Guidance、Rectified Flow核心基础知识
和Rocky一起学习探究扩散模型的本质原理与和核心基础知识,同时不断跟进扩散模型的最新发展。Rocky在本文中对扩散模型的本质做了全面系统的梳理与讲解:https://zhuanlan.zhihu.com/p/1964029619658261252
3、Sora等AI视频大模型的核心原理,核心基础知识,网络结构,经典应用场景,从0到1搭建使用AI视频大模型,从0到1训练自己的AI视频大模型,AI视频大模型性能测评,AI视频领域未来发展等全维度解析文章正式发布!
码字不易,欢迎大家多多点赞:
Sora等AI视频大模型文章地址:https://zhuanlan.zhihu.com/p/706722494
4、Stable Diffusion 3和FLUX.1核心原理,核心基础知识,网络结构,从0到1搭建使用Stable Diffusion 3和FLUX.1进行AI绘画,从0到1上手使用Stable Diffusion 3和FLUX.1训练自己的AI绘画模型,Stable Diffusion 3和FLUX.1性能优化等全维度解析文章正式发布!
码字不易,欢迎大家多多点赞:
Stable Diffusion 3和FLUX.1文章地址:https://zhuanlan.zhihu.com/p/684068402
5、Stable Diffusion XL核心基础知识,网络结构,从0到1搭建使用Stable Diffusion XL进行AI绘画,从0到1上手使用Stable Diffusion XL训练自己的AI绘画模型,AI绘画领域的未来发展等全维度解析文章正式发布!
码字不易,欢迎大家多多点赞:
Stable Diffusion XL文章地址:https://zhuanlan.zhihu.com/p/643420260
6、Stable Diffusion 1.x-2.x核心原理,核心基础知识,网络结构,经典应用场景,从0到1搭建使用Stable Diffusion进行AI绘画,从0到1上手使用Stable Diffusion训练自己的AI绘画模型,Stable Diffusion性能优化等全维度解析文章正式发布!
码字不易,欢迎大家多多点赞:
Stable Diffusion文章地址:https://zhuanlan.zhihu.com/p/632809634
7、ControlNet核心基础知识,核心网络结构,从0到1使用ControlNet进行AI绘画,从0到1训练自己的ControlNet模型,从0到1上手构建ControlNet商业变现应用等全维度解析文章正式发布!
码字不易,欢迎大家多多点赞:
ControlNet文章地址:https://zhuanlan.zhihu.com/p/660924126
8、LoRA系列模型核心原理,核心基础知识,从0到1使用LoRA模型进行AI绘画,从0到1上手训练自己的LoRA模型,LoRA变体模型介绍,优质LoRA推荐等全维度解析文章正式发布!
码字不易,欢迎大家多多点赞:
LoRA文章地址:https://zhuanlan.zhihu.com/p/639229126
9、Transformer核心基础知识,核心网络结构,AIGC时代的Transformer新内涵,各AI领域Transformer的应用落地,Transformer未来发展趋势等全维度解析文章正式发布!
码字不易,欢迎大家多多点赞:
Transformer文章地址:https://zhuanlan.zhihu.com/p/709874399
10、最全面的AIGC面经《手把手教你成为AIGC算法工程师,斩获AIGC算法offer!(2024年版)》文章正式发布!
码字不易,欢迎大家多多点赞:
AIGC面经文章地址:https://zhuanlan.zhihu.com/p/651076114
11、50万字大汇总《“三年面试五年模拟”之算法工程师的求职面试“独孤九剑”秘籍》文章正式发布!
码字不易,欢迎大家多多点赞:
算法工程师三年面试五年模拟文章地址:https://zhuanlan.zhihu.com/p/545374303
《三年面试五年模拟》github项目地址(希望大家能多多star):https://github.com/WeThinkIn/Interview-for-Algorithm-Engineer
12、Stable Diffusion WebUI、ComfyUI、Fooocus三大主流AI绘画框架核心知识,从0到1搭建AI绘画框架,从0到1使用AI绘画框架的保姆级教程,深入浅出介绍AI绘画框架的各模块功能,深入浅出介绍AI绘画框架的高阶用法等全维度解析文章正式发布!
码字不易,欢迎大家多多点赞:
AI绘画框架文章地址:https://zhuanlan.zhihu.com/p/673439761
13、GAN网络核心基础知识,网络架构,GAN经典变体模型,经典应用场景,GAN在AIGC时代的商业应用等全维度解析文章正式发布!
码字不易,欢迎大家多多点赞:
GAN网络文章地址:https://zhuanlan.zhihu.com/p/663157306

汇聚全球AI编程工具,助力开发者即刻编程。
更多推荐

 8
 0
- 0


 已为社区贡献5条内容

所有评论(0)