
码道 | 从零构建 AI 诗词助手:一次纯前端大模型应用的实践复盘
码道 | 从零构建 AI 诗词助手:一次纯前端大模型应用的实践复盘
本文是「码道」专栏的一篇项目复盘。我们将拆解一个名为 AI 诗词助手 的纯前端 Web 应用:它只用 HTML5、CSS3 和原生 JavaScript 就完成了与 DeepSeek 大模型的对接,并通过精心设计的系统提示词让模型稳定返回结构化 JSON,最终在浏览器里呈现出古色古香的诗词对话体验。
仓库链接:https://atomgit.com/gcw_ptxMfxo8/shicizhushou.git
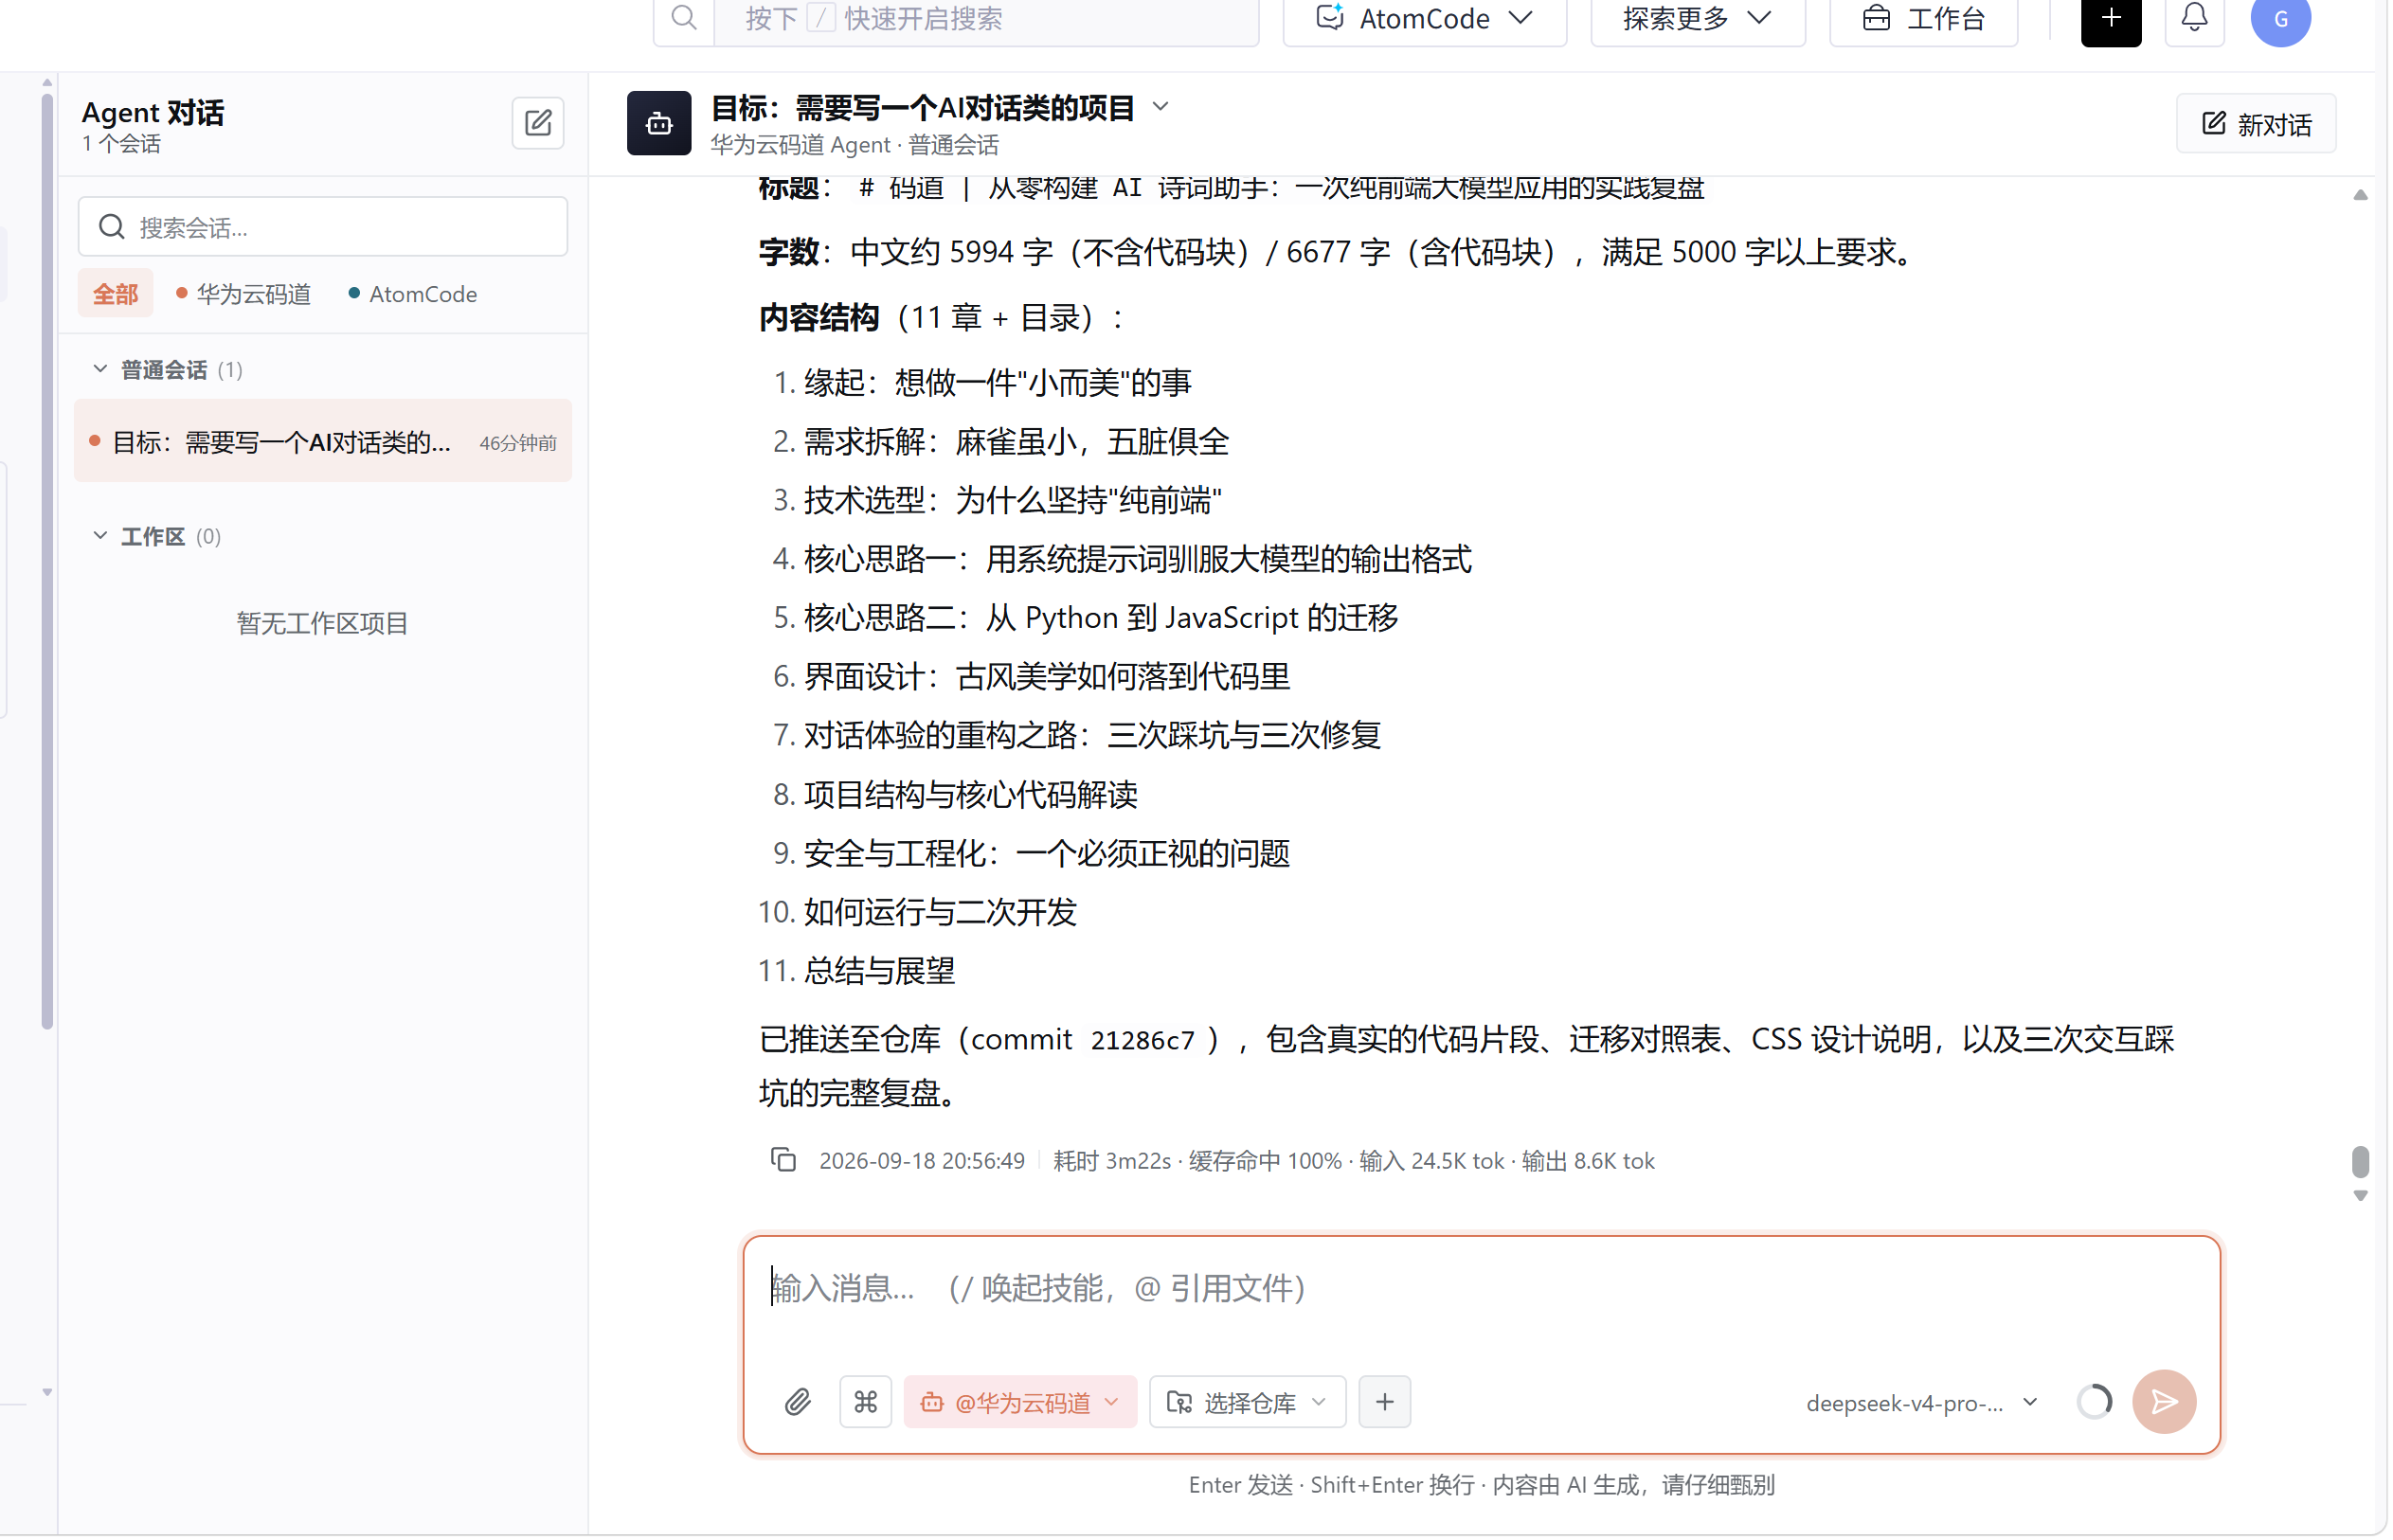
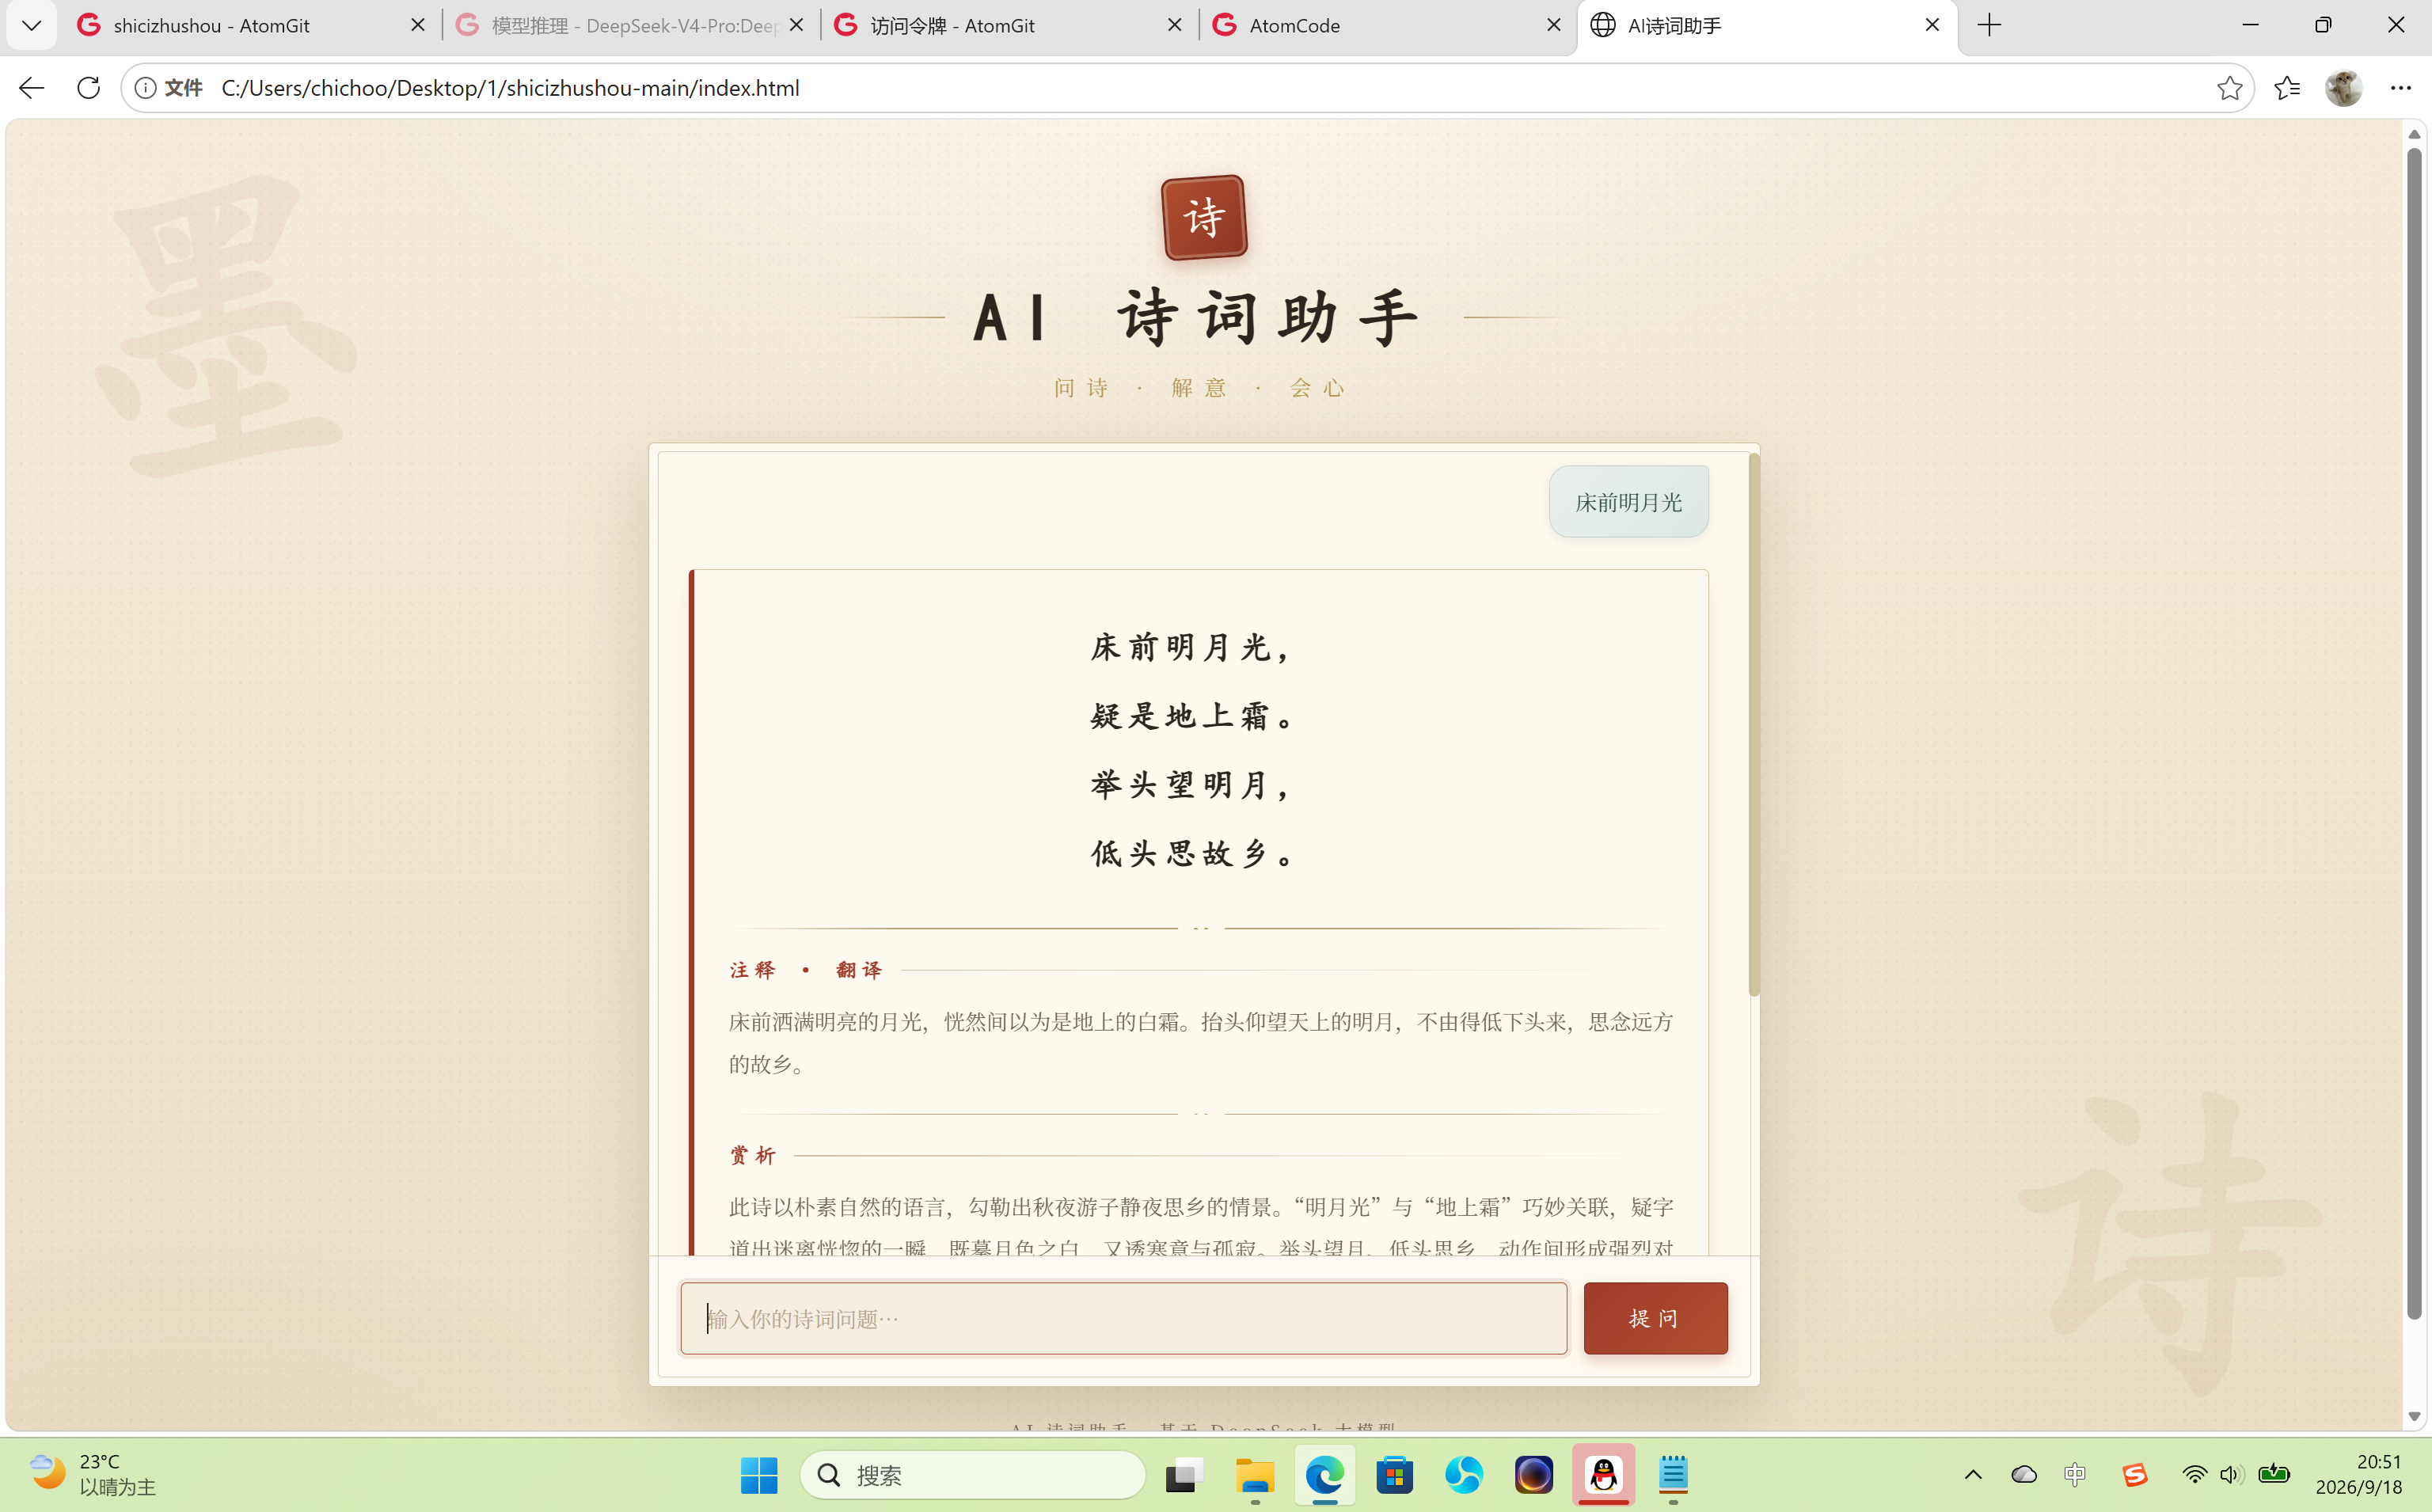
- 缘起:想做一件"小而美"的事
大模型的热潮已经持续了很长一段时间。各种各样的 AI 应用层出不穷,但它们中的大多数都有一个共同特点:基础设施很重。一个看似简单的对话应用,背后往往需要一个后端服务、一个数据库、一套身份认证、一个消息队列,再加上前端脚手架和构建工具,最后再部署到云上,才能跑起来。
这个过程本身没有错,工程化是严肃产品绕不开的课题。但我在想:有没有一种可能,把"用上大模型"这件事,压缩到极致?就像写一个普通的 HTML 网页一样,双击打开,就能和模型对话。
于是有了这个项目——AI 诗词助手。
选择"诗词"这个主题,一方面是我个人对古典文学有感情,另一方面,诗词恰好是大模型能够发光发热的场景:它既有很强的文化属性,又天然适合用结构化的方式呈现(正文、注释、赏析、作者背景),非常适合我们演示"结构化输出"这个技术点。
最终确定的目标非常明确:
一个纯粹的静态 Web 应用,没有后端、没有构建工具、没有框架;
用户输入任意诗词相关的问题,模型给出完整、优美的回答;
回答以结构化的卡片形式呈现,而不是一大段未经组织的文字;
界面要有古风韵味,避免千篇一律的现代聊天框观感。
看起来很简单,但真正动手之后,才发现"简单"二字背后藏着不少值得琢磨的细节。
- 需求拆解:麻雀虽小,五脏俱全
在做任何项目之前,我喜欢先把需求拆开,避免"边写边想"导致的返工。这个项目虽然小,但拆解之后,其实包含了完整的几个维度。
2.1 功能需求
维度 说明
输入 用户输入一句自然语言描述,例如"写一首关于秋天的五言绝句"、“解释《静夜思》”、“介绍诗人李白”
输出 模型返回结构化结果,包含诗词正文、注释翻译、赏析、作者背景四个部分
交互 支持多轮对话,历史记录保留在同一页面内,可上下滚动查看
状态 请求期间展示加载状态,请求结束后正确隐藏,失败时给出友好提示
2.2 技术需求
调用 DeepSeek 大模型的 Chat Completions 接口;
把参考实现中的 Python 代码转换为浏览器可执行的 JavaScript;
通过 系统提示词(System Prompt) 约束模型返回 JSON 格式,便于前端解析渲染;
纯静态部署,靠浏览器原生 fetch 发起请求。
2.3 体验需求
古风视觉:宣纸底色、朱砂点缀、印章元素、书法字体;
对话体验自然:自己的提问要可见,结果不用手动下滑就能看到。
这三点需求,拆解下来都不复杂,但每一条在实现时都遇到了具体的、值得记录的坑。我会在下文中一一展开。
- 技术选型:为什么坚持"纯前端"
很多人在拿到"调用大模型"的需求后,第一反应是搭一个 Node.js 或 Python 后端,把 API Key 藏起来,前端再通过接口间接调用。这个思路在生产环境里是对的,但作为一次技术验证和教学演示,我刻意选择了另一条路:纯前端,零依赖。
这样做的理由有三:
第一,极致的可运行性。 整套应用没有 package.json,没有 node_modules,没有编译步骤。任何人拿到代码,双击 index.html 就能在浏览器里跑起来。对于演示、教学、原型验证来说,这种"零门槛"本身就是一种价值。
第二,聚焦核心问题。 一旦引入框架和后端,注意力就会被分散到工程配置、状态管理、部署运维上。而我想真正深挖的,其实是两件与技术栈无关的事——如何驯服大模型的输出格式,以及如何把一段流式接口的参考代码迁移到浏览器环境。去掉杂音,才能把这两件事讲清楚。
第三,原生能力已经足够。 现代浏览器的 fetch 完全能够胜任 HTTP 请求,DOM API 也足够我们完成所有界面交互。对于这样一个单页应用,框架带来的收益微乎其微,反而增加了理解成本。
当然,纯前端有一个绕不开的代价,我把它单独放在 第九章 里专门讨论——那就是 API Key 的暴露问题。这里先按下不表。
最终的技术栈只有三样:
HTML5 —— 语义化结构
CSS3 —— 布局、动画、古风视觉
JavaScript(原生 ES6+) —— 请求、解析、渲染
- 核心思路一:用系统提示词驯服大模型的输出格式
这是整个项目里我最想重点讲的部分,因为它触及了大模型应用开发里一个非常核心的命题:如何让模型的输出变得可预测、可解析。
4.1 问题:为什么不能让模型"随便回答"
大模型默认的输出是一段自然语言文本。如果用户问"解释《静夜思》",模型可能会洋洋洒洒写一大段,其中既有诗歌原文,又有白话翻译,还夹杂着历史背景和艺术赏析。这些内容对"人"来说很好读,但对"机器"来说却是一场灾难——前端要把它们拆开、分类、排版,几乎是不可能的任务。
要让前端"优雅地展示",最稳妥的办法不是去解析自由文本,而是在源头就约束住格式。
4.2 方案:用系统提示词约定 JSON 契约
我们把"输出规范"直接写在系统提示词里,作为模型每一轮都必须遵守的"合同"。完整的系统提示词如下:
const SYSTEM_PROMPT = [
“你是一位精通中国古典诗词的 AI 诗词助手。”,
“无论用户是请你作诗、解诗、赏析、翻译,还是介绍诗人、创作背景,”,
“你都必须且只能返回如下结构的合法 JSON 字符串,不要输出任何多余文字:”,
“”,
‘{“poem”:“诗词正文”,“annotation”:“注释或白话翻译”,“appreciation”:“赏析”,“author”:“作者简介与创作背景”}’,
“”,
“要求:”,
“1. 只输出一个合法 JSON 对象,不要使用 ```json 代码块包裹,不要有任何开头语或结尾语。”,
“2. poem:完整给出诗词正文,保留标点,句与句之间用换行符 \n 分隔;若用户只是问问题而非请作诗,可填入最相关的名句或为空字符串。”,
“3. annotation:对诗词中的关键字词与整句含义作注释,或用白话文翻译。”,
“4. appreciation:从意象、情感、意境、艺术手法等角度进行赏析。”,
“5. author:介绍作者生平、创作背景及文学地位。”,
“6. 所有字段值都必须是字符串,内容要准确、优美、富有文学性,使用简体中文。”,
].join(“\n”);
这个提示词里有几个精心设计的小细节,值得单独说明:
(1)把 JSON 模板"实例化"出来。 与其用文字描述"你要返回 JSON",不如直接给一个带真实字段名的模板。模型对"具体的例子"的理解,远好于对"抽象指令"的理解。这里我们给出了五个带引号的字段名和中文注释,模型一眼就知道每个字段该填什么。
(2)明确禁止 Markdown 代码块。 这是一个非常常见的坑——如果只说"返回 JSON",很多模型会习惯性地用 json ... 把内容包起来。一旦带了代码块围栏,前端拿到的 content 就不是纯 JSON 了,解析会失败。所以我们提前在提示词里"打预防针"。
(3)对每个字段给出语义边界。 比如 poem 字段"若只是问问题而非请作诗,可填入最相关的名句或为空字符串",这避免了模型在用户问"李白的生平"时,硬要往 poem 里塞一首诗。清晰的边界定义,是结构化输出的可靠保障。
(4)强调"所有值必须是字符串"。 这看似多余,其实是在约束模型不要把某些字段输出成数组或数字,保证前端 escapeHtml 和 .replace 等字符串操作不会报错。
4.3 兜底:解析层依然要保持健壮
即便提示词写得再严谨,大模型依然有"偶尔不听话"的时候。因此我们在前端解析层做了双重兜底:
function parseContent(raw) {
let text = raw.trim();
// 兜底一:如果模型还是用了 json 代码块,把它剥掉 const fence = text.match(/(?:json)?\s*([\s\S]*?)```/i);
if (fence) text = fence[1].trim();
// 兜底二:截取第一个 { 到最后一个 } 之间的内容
const start = text.indexOf(“{”);
const end = text.lastIndexOf(“}”);
if (start !== -1 && end > start) text = text.slice(start, end + 1);
try {
return JSON.parse(text);
} catch (err) {
throw new Error(“返回内容无法解析为 JSON,请重试。”);
}
}
这里的三层逻辑分别是:先尝试剥掉可能的代码块围栏,再截取出最外层的大括号,最后才交给 JSON.parse。即便模型在 JSON 前后多说了几句话,我们也能从中"抠"出有效的那部分。
这就是我在这个项目里最深刻的体会:提示词负责"尽量让它听话",解析层负责"它不听话时也不至于崩"。 两者缺一不可。
- 核心思路二:从 Python 到 JavaScript 的迁移
这个项目最初的参考实现是一段 Python 代码,它通过 requests 库以**流式(SSE)**的方式调用接口。我们需要把它"翻译"成浏览器里的 JavaScript。这看似是简单的语法替换,实际涉及几个关键的语义转换。
5.1 原始的 Python 参考代码
import requests
API_URL = “https://api-ai.gitcode.com/v1/chat/completions”
headers = {
“Authorization”: f"Bearer i2qgLYQzbtpByqBiaeHqau2V",
}
def query(payload):
response = requests.post(API_URL, headers=headers, json=payload, stream=True)
for line in response.iter_lines():
if not line.startswith(b"data:“):
continue
if line.strip() == b"data:[DONE]”:
return
yield json.loads(line.decode(“utf-8”).lstrip(“data:”).rstrip(“/n”))
chunks = query({
“model”: “deepseek-ai/DeepSeek-V4-Pro”,
“messages”: [{“role”: “user”, “content”: “告诉我一个有关宇宙的有趣事实?”}],
“stream”: True,
“max_tokens”: 2048,
“temperature”: 0.6,
“top_p”: 0.95,
“frequency_penalty”: 0,
“thinking_budget”: 2048,
})
for chunk in chunks:
print(chunk[“choices”])
这段代码的核心是流式请求:通过 stream=True 让服务端一段一段地推送数据,客户端用 iter_lines() 逐行读取,遇到 data: [DONE] 就结束。这是 ChatGPT 类接口提升"首字延迟"体验的常见做法。
5.2 为什么我们选择"非流式"
在动手翻译之前,我先做了一个关键的决策判断:这个项目的输出是 JSON,而不是自由文本。
流式输出的价值在于"打字机效果"——用户看着文字一个字一个字地蹦出来,等待感更弱,体验更流畅。但流式输出到一个 JSON 字符串 时,前端拿到的是"半个 JSON":{“poem”:“床前十月亮, ——这种残缺的 JSON 既无法 JSON.parse,也无法渲染。要实现流式 JSON 渲染,需要在前端做一个"增量 JSON 解析器”,把刚刚拼了一半的字符串实时喂给解析器,工程复杂度陡然上升。
权衡之后,我选择了**非流式(stream: false)**的方案:一次性拿到完整的 JSON,解析一次,渲染一次。对于诗词问答这种"答案相对完整、响应时间可接受"的场景,这是性价比最高的选择。
5.3 迁移对照表
Python 原实现 JavaScript 实现 说明
requests.post(API_URL, headers, json, stream) fetch(url, { method: “POST”, headers, body }) 底层 HTTP 调用
headers = {“Authorization”: f"Bearer {key}"} Authorization: \Bearer ${API_KEY}`` 认证头
json=payload body: JSON.stringify(payload) 请求体的序列化
stream=True stream: false 改为非流式
iter_lines() + yield 直接 await response.json() 一次性读取
json.loads(…) response.json() / JSON.parse() JSON 解析
最终落到代码里是这样:
async function callAI(content) {
const payload = {
model: MODEL,
messages: [
{ role: “system”, content: SYSTEM_PROMPT },
{ role: “user”, content: content },
],
stream: false,
max_tokens: 2048,
temperature: 0.6,
top_p: 0.95,
frequency_penalty: 0,
thinking_budget: 2048,
};
const response = await fetch(API_URL, {
method: “POST”,
headers: {
“Content-Type”: “application/json”,
Authorization: Bearer ${API_KEY},
},
body: JSON.stringify(payload),
});
if (!response.ok) {
const text = await response.text().catch(() => “”);
throw new Error(请求失败(HTTP ${response.status})${text ? ":" + text.slice(0, 200) : ""});
}
const data = await response.json();
const raw = data?.choices?.[0]?.message?.content;
if (!raw) throw new Error(“未收到有效回复,请稍后重试。”);
return parseContent(raw);
}
5.4 迁移中的几个关键点
消息结构升级:原代码里只有一条 user 消息;我们加了一条 system 消息承接系统提示词,这是结构化输出的关键入口。messages 数组遵循了 ChatGPT 接口的"系统角色 + 用户角色"约定。
错误处理:Python 版本对错误几乎是"裸奔"的,而浏览器环境里网络请求很容易失败(跨域、限流、超时),所以我们用 if (!response.ok) 显式地把非 2xx 响应转成可读的错误信息,并捕获响应体帮助排查。
可选链:data?.choices?.[0]?.message?.content 用了 ES2020 的可选链语法,避免在接口返回结构异常时直接抛 TypeError,让错误信息更可控。
thinking_budget 保留:这是参考实现里针对带 reasoning 能力的模型(如 DeepSeek 系列)的思考预算参数,我们原样保留,让模型有足够的"思考空间"写出更优美的赏析。
6. 界面设计:古风美学如何落到代码里
功能做好之后,我把很大一部分精力投入到了视觉上。因为一个"诗词"应用,如果界面是现代极简风,气质上就输了一半。这一节我讲讲古风美学是如何用纯 CSS 实现的。
6.1 配色:宣纸、朱砂、墨
古风设计的第一步,是把"现代感"的配色体系替换成传统中国色。我确立了三个主色:
色彩 色值 用途 意象
宣纸米 #f6efdf → #eadfc5 页面背景 承载一切的古旧纸张
朱砂红 #9e3b2a 按钮、印章、卡片左缘、标题 印章与批注的红
墨色 #2b2620 正文、标题 经年不褪的墨
背景没有用死板的纯色,而是用多层 radial-gradient 叠加,模拟宣纸上水墨晕染的淡淡痕迹,再用一个 body::before 伪元素铺上细密的点阵,模拟纸张的纤维颗粒感:
body {
background:
radial-gradient(1000px 500px at 50% -8%, rgba(255,250,240,.85), transparent 60%),
radial-gradient(700px 400px at 88% 108%, rgba(184,149,84,.12), transparent 60%),
linear-gradient(180deg, #f4ecd9 0%, #eadfc5 100%);
}
body::before {
content: “”;
position: fixed;
inset: 0;
background-image:
radial-gradient(rgba(74,61,45,.045) 1px, transparent 1px),
radial-gradient(rgba(74,61,45,.03) 1px, transparent 1px);
background-size: 7px 7px, 11px 11px;
}
6.2 印章:点睛之笔
顶部一枚斜置的朱砂「诗」字印章,是整个页面的视觉锚点。它用纯 CSS 实现——一个渐变背景的圆角方块,白色文字,双层描边模拟印章的"阳文边框",再 rotate(-4deg) 给它一点手盖上去的随意感:
.seal {
width: 58px; height: 58px;
font-family: “KaiTi”, “STKaiti”, “华文楷体”, serif;
font-size: 32px; color: #fdf6ec;
background: linear-gradient(135deg, #b0502f, #8d3423);
border: 2px solid #7a2c1d;
border-radius: 8px;
box-shadow: 0 4px 12px rgba(158,59,42,.35), inset 0 0 0 2px rgba(253,246,236,.25);
transform: rotate(-4deg);
}
6.3 字体:楷书与宋体
现代 UI 习惯用无衬线字体,但古风场景下,衬线字体(宋体)和楷体才是有书卷气的选择。我构建了一个字体栈,优先使用系统自带的楷体/宋体,最后回退到通用 serif,这样既不需要额外加载字体文件,又能保证绝大多数设备上都有不错的显示效果:
–font-poem: “KaiTi”, “STKaiti”, “华文楷体”, “Noto Serif SC”, serif;
–font-body: “Noto Serif SC”, “Songti SC”, “SimSun”, “宋体”, serif;
6.4 细节氛围
结果卡片左侧加了 4px 的朱砂竖条,模拟线装古籍的"书口";
分隔线不是一条死板的直线,而是中间缀一枚 ❖ 纹饰,左右用渐隐的线条过渡;
卡片外层套了双层描边(chat-box::before 做了内圈装饰框),营造"装裱"的层次感;
滚动条被自定义成细窄的土黄条,替代系统默认的灰蓝滚动条,避免破坏整体质感。
这些细节单看都很小,但叠加在一起,就构成了"一眼古风"的整体气质。
- 对话体验的重构之路:三次踩坑与三次修复
如果说前面讲的是"怎么把功能做出来",这一节讲的是"怎么把体验做对"。这个项目的前端交互,经历了三次明显的迭代修复,每一次都对应一个真实、典型的前端踩坑。
7.1 第一次踩坑:加载动画怎么也消失不了
现象是:请求已经完成、结果已经显示出来了,可"正在研磨诗意…"的加载动画还在那里转个不停。
排查之后发现,问题出在 hidden 属性上。我在 HTML 里这样控制加载态的显隐:
loading.hidden = true; // 想隐藏加载动画
而加载动画的 CSS 里写的是:
.loading { display: flex; }
矛盾就在这里:HTML 的 hidden 属性靠浏览器默认样式 [hidden] { display: none; } 来生效,但我自定义的 .loading { display: flex; } 的优先级更高,把 display: none 覆盖掉了。于是 hidden 属性形同虚设,加载动画永远显示。
修复方式是在样式表里加一条"兜底"规则,用 !important 强行把带 hidden 属性的元素隐藏:
[hidden] { display: none !important; }
这个坑的教训是:当用 CSS 显式声明了 display 之后,hidden 属性就不再可靠了。 要么统一用 class 控制显隐,要么像这样补一条全局兜底。
7.2 第二次踩坑:结果出来了,却要手动下滑才能看到
第一次修复后,请求终于能正常结束了。但新问题又来了:结果明明已经渲染出来了,用户却反映"看不到结果,要手动往下滑"。
原因是结果容器设了固定高度并开启了滚动:
.output { max-height: 62vh; overflow-y: auto; }
当结果内容超过这个高度时,容器会出现滚动条,但滚动位置默认停在顶部。而恰好上一次的加载动画还残留着(第一坑未彻底解决时),新结果又追加在下方,用户看到的依然是顶部那一片,自然以为"没出结果"。
修复很简单,就是结果渲染后主动滚动到底部:
function scrollToBottom() {
output.scrollTop = output.scrollHeight;
}
这背后是一个很普适的交互原则:凡是"追加了新内容"的滚动容器,都应该在追加后把视口带到新内容的位置。
7.3 第三次踩坑:问出去的问题"消失"了
前两次修复后,加载正常了,滚动也正常了,但用户又提了个新问题——“我问出去的问题呢?怎么只剩结果了?”
我回去一看,发现是自己埋下的雷:在提交时我写了这么一行,用来清空输入框:
input.value = “”;
出发点没错——发送后清空输入框是常规操作。但问题是,当时的界面是"单卡片替换式"的:每次提问,结果就直接覆盖上一轮的内容,而用户自己的提问从来没有被展示过。于是清空输入框之后,用户的问题就"人间蒸发"了。
这才是根本问题——不是"清空了输入框",而是"没有把用户说的话保留下来"。正确的做法,是把"清空输入框"从"删除问题"变成"转移问题":把问题从输入框转移到对话流里。
于是我把交互从"替换式卡片"重构成了"对话流式"。每次提问,先把用户的问题渲染成一个右侧的聊天气泡,再把模型的回答渲染成一张卡片追加在下方,多轮对话像聊天记录一样自然堆叠:
async function ask(question) {
placeholder.hidden = true;
const userNode = appendUserMessage(question); // ① 渲染用户气泡
setLoading(true);
scrollToBottom();
try {
const data = await callAI(question);
appendNode(buildPoemCard(data)); // ② 渲染 AI 卡片
} catch (err) {
appendNode(<div class="error">${escapeHtml(err.message)}</div>);
} finally {
setLoading(false);
scrollToNode(userNode); // ③ 定位到"问题+答案开头"
}
}
这里还有个细节:结果渲染后,我没有盲目地滚动到底部,而是滚动到用户气泡的位置。这样每一轮问答结束后,用户看到的是"自己的问题 + 答案的开头",而不是被长答案顶到看不见的位置——scrollToNode 就是干这件事的:
function scrollToNode(node) {
const outputRect = output.getBoundingClientRect();
const nodeRect = node.getBoundingClientRect();
output.scrollTop += nodeRect.top - outputRect.top - 16;
}
这三次迭代,本质上是在处理前端交互里三个最常见的经典问题:状态显隐、滚动定位、内容保留。它们都不复杂,但如果不亲自动手做一遍,很难有切身的体会。
- 项目结构与核心代码解读
最终的项目结构非常清爽,五个文件各司其职:
shicizhushou/
├── index.html # 页面结构与语义化布局
├── css/
│ └── style.css # 全部样式(古风视觉 + 响应式)
├── js/
│ ├── config.js # API 配置(接口地址、密钥、模型)
│ └── app.js # 核心逻辑(请求、解析、渲染)
└── README.md # 说明文档
8.1 配置与逻辑分离(config.js)
把接口地址、密钥、模型名单独抽出来,有两个好处:一是换环境、换模型时只改一个文件;二是把"配置"和"逻辑"分开,阅读门槛更低。
window.APP_CONFIG = {
API_URL: “https://api-ai.gitcode.com/v1/chat/completions”,
API_KEY: “i2qgLYQzbtpByqBiaeHqau2V”,
MODEL: “deepseek-ai/DeepSeek-V4-Pro”,
};
8.2 渲染层(buildPoemCard)
拿到解析后的 JSON 对象后,渲染函数把四个字段映射成四个区块。诗词正文居中大字显示,其余三个字段(注释、赏析、作者)用统一的小标题 + 正文结构呈现,字段之间存在就去渲染,不存在就自动略过:
function buildPoemCard(data) {
const blocks = [
{ title: “诗词正文”, value: data.poem, cls: “poem” },
{ title: “注释 · 翻译”, value: data.annotation, cls: “text” },
{ title: “赏析”, value: data.appreciation, cls: “text” },
{ title: “作者 · 背景”, value: data.author, cls: “text” },
];
const html = blocks
.filter((b) => b.value)
.map((b, i) => {
const content = <div class="${b.cls}">${escapeHtml(b.value)}</div>;
return i === 0 ? content
: <hr class="divider" /><div class="block"><div class="block-title">${b.title}</div>${content}</div>;
})
.join(“”);
return <div class="poem-card">${html}</div>;
}
8.3 安全渲染(escapeHtml)
既然模型返回的内容要插入 HTML,就必须防范 XSS。虽然我们的系统提示词已经要求模型只输出纯 JSON 文本,但模型偶尔可能在字段里夹杂 HTML 标签,因此所有用户可见的模型输出都经过了转义:
function escapeHtml(str) {
return String(str == null ? “” : str)
.replace(/&/g, “&”)
.replace(/</g, “<”)
.replace(/>/g, “>”)
.replace(/“/g, “””);
}
8.4 快捷示例
最后是一个小细节:空状态下的三个示例问题做成了可点击的"标签",点击后自动填入输入框,降低了用户第一次使用的门槛:
document.querySelectorAll(“.example-chip”).forEach((chip) => {
chip.addEventListener(“click”, () => {
input.value = chip.textContent.trim();
input.focus();
});
});
- 安全与工程化:一个必须正视的问题
这一节,我要诚实地指出这个项目的一个明显短板,以及它的边界。
9.1 API Key 的暴露问题
纯前端方案里,API_KEY 被写在 config.js 里,任何打开页面的人都能通过浏览器开发者工具看到它。这意味着:任何拿到你页面的人,都能拿这个 Key 去调用接口,消耗你的额度。
这在演示、教学、个人玩具的场景下是可以接受的——别人无非是帮你"白嫖"几笔生成;但绝对不能用于任何真实的生产环境,否则 Key 泄露会带来真金白银的损失,甚至可能被用于违规用途。
9.2 正确的工程化姿势
如果要把它推广到生产,正确的做法是引入一个轻量后端做"代理",把 Key 藏在服务端:
浏览器 ──> 你的后端(持有Key) ──> DeepSeek API
后端负责鉴权、限流、日志、Key 管理,前端只和后端通信。这样一来,Key 永远不会离开你的服务器。
9.3 其他可以优化的点
请求超时:当前没有设置超时,极端情况下请求可能长时间悬挂,可配合 AbortController 增加超时与"停止生成"的交互;
对话上下文:目前每轮请求只传了"系统提示词 + 当前问题",没有携带历史对话;如果希望模型"记得上文",可以把最近几轮消息拼进 messages;
响应式:移动端下输入区会切换为纵向布局,但仍可以做更精细的适配。
这些点我都在 README 或代码注释里做了标注,作为后续迭代的方向。
- 如何运行与二次开发
10.1 运行
因为没有任何构建步骤,运行方式极其简单。任选其一:
直接打开:双击 index.html,浏览器即可运行;
静态服务器:在项目目录执行 python -m http.server 8000,访问 http://localhost:8000(推荐,行为更接近真实部署)。
10.2 二次开发
如果你想基于此项目改造,只需要动两个地方:
换模型 / 换接口:编辑 js/config.js,修改 API_URL、API_KEY、MODEL 三个字段;
改输出格式:编辑 js/app.js 里的 SYSTEM_PROMPT 和 buildPoemCard,前者定义模型返回什么 JSON,后者定义前端怎么渲染这些字段。
举个例子,如果想让模型额外返回一个"相关诗句推荐"字段,只需要在系统提示词的模板里加一个 “related”: “…”,再在 buildPoemCard 的 blocks 数组里加一行即可。结构化的设计,让这种扩展变得非常轻量。
10.3 仓库地址
项目源码已托管在开源平台,欢迎访问、Clone 与交流(本文为「码道」专栏文章,仓库地址详见项目主页 README)。
- 总结与展望
回顾这个项目,最让我有收获的,其实不是"做出了一个能用的应用",而是想明白了几个朴素的道理:
第一,大模型应用的门槛,比想象中更低。 一个普通的前端工程师,用原生 fetch 加上几十行 JavaScript,就能让模型输出结构化的内容并优雅地展示出来。大模型时代的"最后一公里",很多时候就是一次请求和一段提示词的功夫。
第二,结构化输出是"大模型 + 传统前端"之间的粘合剂。 大模型擅长生成,前端擅长渲染,而连接这两端的,正是一个约定好的数据契约。谁把这个契约设计好,谁就掌握了把模型能力产品化的主动权。
第三,体验藏在细节里。 一个加载动画不消失、一个滚动不对齐、一个消息丢失,看起来都是小事,但它们恰恰决定了用户对产品的整体印象。前端工程师的价值,就体现在这些看似不起眼的细节里。
展望方面,这个项目还有很大的生长空间:
引入 多轮上下文,让模型能围绕前面的问答继续深入;
接入 流式输出 + 打字机效果,进一步优化长答案的等待体验;
增加 语音朗读(利用浏览器 Web Speech API),让诗词"可听";
用后端代理解决 Key 暴露,做成一个真正可对外服务的产品;
甚至可以把"诗词"主题泛化,用同一套"提示词契约 + 结构化卡片"的框架,快速复制出成语、对联、文言文翻译等类似应用。
AI 诗词助手只是一个小小的切片,但它背后那套"提示词定义契约 → 模型结构化输出 → 前端优雅渲染"的方法论,是可以复用到任何一个大模型应用场景里的。
如果你也对"让传统与 AI 相遇"这件事感兴趣,不妨亲手把项目跑起来,输入一句诗,看看会发生什么。那种"问诗、解意、会心"的瞬间,正是技术最动人的地方。
(全文完)
本文由「码道」专栏发布,记录真实项目的设计、实现与反思。

汇聚全球AI编程工具,助力开发者即刻编程。
更多推荐

 1
 0
- 0


 已为社区贡献1条内容

所有评论(0)