
码道:从 Python 到前端 ——「文韵图文AI对话」的诞生之旅
@[# 码道手记:从 Python 到前端 ——「文韵图文AI对话」的诞生之旅
以文会友 · 以图传韵
一、写在前面:一次跨语言的探索
在人工智能飞速发展的今天,大语言模型(LLM)已经不再是一个遥远的技术概念,而是我们日常开发中触手可及的伙伴。无论是代码补全、文档生成,还是智能问答,AI 都在以前所未有的方式改变着我们的工作流。然而,当我们真正想要把一个 AI 能力落地成一个可以展示、可以交互、可以交付的作品时,却发现从"调用一个接口"到"做出一件像样的产品",中间还有相当长的路要走。
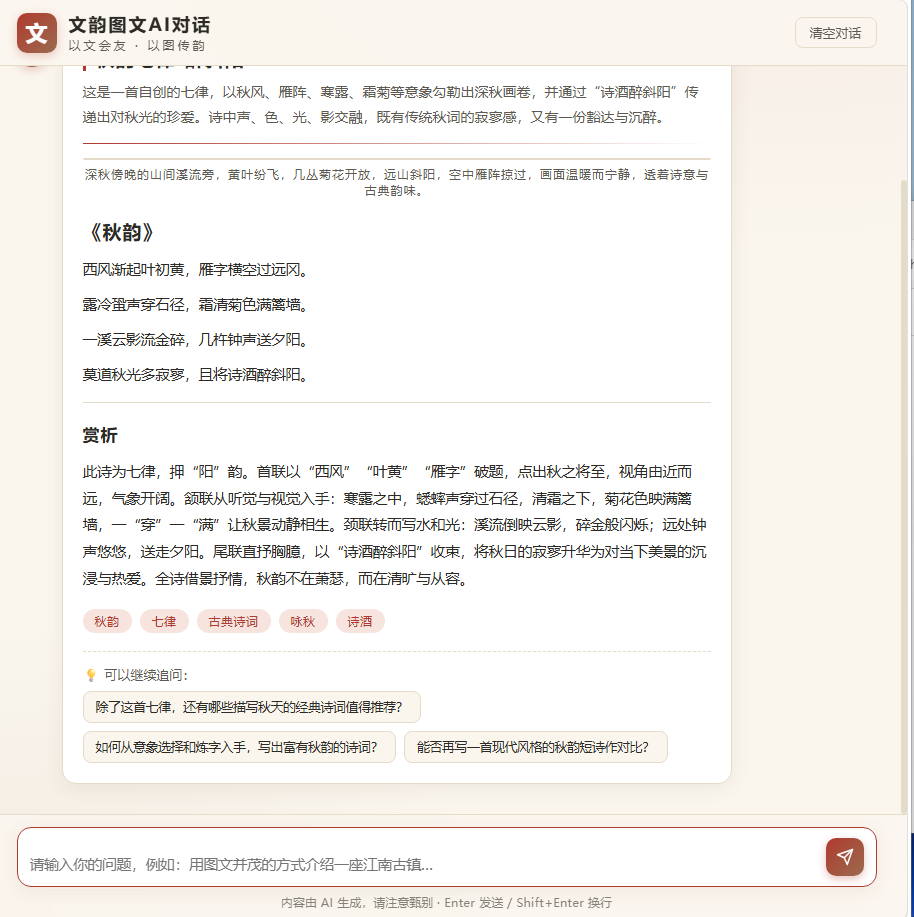
这篇文章要记录的,正是这样一次完整的实践:我使用纯前端技术栈(HTML5 + CSS3 + JavaScript),将一个基于 Python 的 AI 对话参考代码,从零开始转化为一个功能完整、界面优雅的 Web 应用 —— 「文韵图文AI对话」。整个过程不使用任何第三方框架、不依赖任何构建工具,全部代码以最朴素的原生 Web 技术完成,却实现了流式对话、结构化图文卡片渲染、Markdown 排版、多轮上下文记忆等一套相当完整的功能。
为什么选择纯前端?为什么要把 Python 代码转换成一个浏览器应用?在这一过程中遇到了哪些坑,又是如何解决的?系统提示词(System Prompt)应当如何设计,才能让模型的输出"恰好"成为前端可以直接渲染的 JSON 数据?这些问题的答案,都写在下面这五千字里。
二、项目缘起:从一段 Python 参考代码说起
一切从一段 Python 代码开始。那是一个典型的调用大模型接口的示例,使用了 requests 库发起流式请求:
import os
import requests
import json

API_URL = "https://api-ai.gitcode.com/v1/chat/completions"
headers = {
    "Authorization": f"Bearer 你的API密钥",
}

def query(payload):
    response = requests.post(API_URL, headers=headers, json=payload, stream=True)
    for line in response.iter_lines():
        if not line.startswith(b"data:"):
            continue
        if line.strip() == b"data:[DONE]" or line.strip() == b"data: [DONE]":
            return
        yield json.loads(line.decode("utf-8").lstrip("data:").rstrip("/n"))

chunks = query({
    "model": "deepseek-ai/DeepSeek-V4-Flash",
    "messages": [{"role": "user", "content": "告诉我一个有关宇宙的有趣事实?"}],
    "stream": True,
    "max_tokens": 2048,
    "temperature": 0.6,
    "top_p": 0.95,
    "frequency_penalty": 0,
    "thinking_budget": 2048
})

for chunk in chunks:
    print(chunk["choices"])
这段代码虽然简洁,却包含了理解 AI 接口调用几乎所有的关键要素:
第一,流式(Stream)请求的本质。 当 stream=True 时,服务端不再等待全部内容生成完毕后一次性返回,而是通过 HTTP 的 chunked transfer 机制,将生成结果以"事件流"(SSE,Server-Sent Events)的形式逐片段推送。每个片段以 data: 前缀开头,内容是一段独立的 JSON。当所有内容生成完毕,服务端会发送一个特殊的 data: [DONE] 标记表示结束。这种机制让用户在数百上千字的长回答生成过程中,无需长时间干等,而是能像看到打字机一样,看着文字一个字一个字地跳出来——这正是现代 AI 对话应用体验上不可或缺的一环。
第二,请求参数的意义。 temperature(温度)、top_p(核采样)、frequency_penalty(频率惩罚)、max_tokens(最大输出长度),这些参数共同控制着模型生成行为的"性格":温度越高,输出越发散、越有创造性;温度越低,输出越保守、越贴近训练数据中的常见模式。而非常有意思的是 thinking_budget 这个参数——它允许模型在正式回答之前,先投入一定的"思考预算"进行推理,从而在复杂问题上给出更缜密的答案。
第三,参考代码的局限。 这段代码运行在命令行环境里,输出是原始的 JSON 结构。普通用户看到的是 {'choices': [{'delta': {'content': '在浩瀚的宇宙中…'}}]} 这样的一堆键值对,既不美观,也不可交互。一个真正可用的 AI 产品,需要把这些原始输出变成一个友好的用户界面:漂亮的对话气泡、实时的打字机效果、结构化的内容布局……而这一切,恰恰是前端最擅长的事情。
于是,一个清晰的目标在我脑海中浮现:把这段 Python 参考代码,转化为一个纯前端、开箱即用、界面优雅的 AI 对话网页应用。 项目命名为「文韵图文AI对话」,寓意"以文会友,以图传韵"。
三、技术选型:为什么是纯前端?
在动手之前,最值得反复思量的一个问题就是技术选型。市面上有太多现成的方案:React、Vue、Next.js,以及各色各样的 UI 组件库和聊天框架。为什么最终选择了最朴素的原生 HTML5 + CSS3 + JavaScript?
3.1 零构建、零依赖、零门槛
原生三件套最大的优势是"零门槛"。不需要 Node.js 环境,不需要 npm install,不需要 webpack 打包配置,不需要处理跨域代理等复杂工程问题。一个静态 HTML 文件,配上 CSS 和 JS,双击就能在浏览器里跑起来。这意味着:
- 对学习前端的人来说,这是最直观的入门路径——所有逻辑都写在眼前,没有框架的黑魔法;
- 对演示和交付来说,任何一个同学、同事,拿到项目文件放到任意静态服务器上就能立即体验;
- 对代码量来说,整个项目只有 5 个源码文件、一千余行代码,却完整落地了一个 AI 对话应用,清晰体现了原生 Web 能力的边界与可能。
3.2 跨语言转换本身就是一次深度学习
把 Python 的流式请求转换为 JavaScript,这件事本身价值非凡。它逼迫我去理解流式传输的底层机制,而不能只是"照抄 API"。requests 的 iter_lines() 在 Python 底层做了什么?在 JavaScript 里对应什么 API?TextDecoder 如何处理 UTF-8 编码在多字节边界被切断的情况?缓冲区如何管理才能保证行不丢失、不残缺?当这些问题一个个被解开,一个程序员对 HTTP 流式协议的理解就真正深入到了底层。
3.3 前端能做 AI 产品吗?—— 能,而且很优雅
也许有人会质疑:AI 应用不都应该有后端吗?密钥放前端多不安全!这个观点本身没错,但对于学习、演示、课程设计这类场景,纯前端方案有着无可替代的轻便性。它还让我们把 100% 的注意力集中在两件最有价值的事情上:如何与模型高效对话(API 调用层),以及如何把模型输出变得赏心悦目(表现层)。至于密钥安全、鉴权等生产级问题,我在 README 中用专门的章节做了说明,并给出了"后端网关转发密钥"的升级路径——这本身就是一次很好的工程权衡思考。
四、架构设计:五个文件,一条清晰的主线
整个项目的架构可以浓缩为一张图:
index.html          → 页面骨架(顶部栏 / 对话区 / 输入区)
css/style.css       → 水墨文韵主题样式
js/config.js        → 全局配置(密钥 / 模型参数 / 系统提示词)
js/markdown.js      → 轻量级 Markdown 渲染器
js/app.js           → 核心逻辑(SSE 流式请求 + JSON 解析)
js/ui.js            → UI 渲染与交互
依据单一职责原则,我将不同关注点拆成了独立模块:config.js 管配置,app.js 管数据与接口,ui.js 管界面,markdown.js 管文本渲染。它们之间的依赖是单向的:ui.js 调用 app.js 和 markdown.js,app.js 使用 config.js 中的配置。这种清晰的模块划分让代码极易维护——比如想换个模型,只需要改 config.js 一个文件;想换界面皮肤,只需要动 style.css。
同时,我刻意保证了 config.js 与 markdown.js 不依赖 DOM,这为将来的单元测试和逻辑复用留下了空间。真正与界面耦合的只有 ui.js,而 app.js 甚至可以在 Node.js 环境中直接运行测试——这一设计在后面"测试与验证"一章发挥了重要作用。
五、核心攻坚:Python 流式调用 → JavaScript 流式调用
这是整个项目最核心、也最考验功底的部分。让我们逐层拆解转换过程。
5.1 请求发起:从 requests 到 fetch
Python 端用 requests.post(url, headers=headers, json=payload, stream=True) 发起请求。JavaScript 端的对应物是浏览器的原生 fetch API:
const response = await fetch(CONFIG.API_URL, {
  method: "POST",
  headers: {
    "Content-Type": "application/json",
    "Authorization": `Bearer ${CONFIG.API_KEY}`
  },
  body: JSON.stringify(payload),
  signal
});
需要注意的是,requests 默认会处理很多传输细节,而 fetch 更"裸":请求体必须自己 JSON.stringify,状态码需要自己检查 response.ok。同时我额外传入了 signal(AbortController 的信号),这是为了支持"停止生成"功能——用户随时可以中断正在进行的请求,这种细节对于体验的提升不可忽视。
5.2 流式读取:从 iter_lines 到 ReadableStream
Python 的 response.iter_lines() 会按行迭代响应体。JavaScript 的对应机制是 response.body.getReader(),它返回一个 ReadableStreamDefaultReader,可以持续 read() 数据块。这两者在理念上相似,但有一个关键的实现差异需要处理。
观察这段核心代码:
const reader = response.body.getReader();
const decoder = new TextDecoder("utf-8");
let buffer = "";
let done = false;

while (!done) {
  const { value, done: readerDone } = await reader.read();
  if (readerDone) break;
  buffer += decoder.decode(value, { stream: true });

  const lines = buffer.split("\n");
  buffer = lines.pop();   // 最后一段是不完整行,留到下一轮

  for (const line of lines) {
    const trimmed = line.trim();
    if (!trimmed.startsWith("data:")) continue;
    const data = trimmed.slice(5).trim();
    if (data === "[DONE]") { done = true; break; }
    try {
      const json = JSON.parse(data);
      const delta = json.choices?.[0]?.delta;
      if (delta?.content) onDelta(delta.content);
      if (delta?.reasoning_content) onReasoning(delta.reasoning_content);
    } catch (e) { /* 跳过碎片 */ }
  }
}
这段代码解决了一个"教科书不会告诉你"的问题:网络数据块和文本行并不对齐。浏览器每次 read() 返回的 Uint8Array 大小是不确定的,可能一个块里含多行,也可能一个块只含半行。再加上 UTF-8 是变长编码,一个汉字由三个字节组成,如果某个字符的字节被恰好切分到两个块中,直接解码就会产生乱码。
解决方案是"缓冲区 + TextDecoder 流式解码":
- 用
TextDecoder("utf-8", { stream: true })按块解码——它能在内部妥善处理多字节字符跨块切断的问题; - 把解码后的文本追加到
buffer; - 用
split("\n")分行;每次都把最后一段(可能不完整的行)pop()出来留在缓冲区,供下一轮拼接; - 只处理完整行,不完整行永远等下一个数据块到来后再处理。
如此一来,无论网络如何分块,数据都永远是完整、正确、不重复、不遗漏的。整个逻辑与 Python 的 iter_lines() 在语义上完全等价,而底层的字节处理比 Python 版本更加精细。
5.3 结束标记与错误容忍
Python 参考代码里检查了 data:[DONE] 和 data: [DONE] 两种写法(冒号后带不带空格),说明真实世界的接口实现并不总是规范。我在 JavaScript 端同样做了宽容处理:先 trim() 再去掉 data: 前缀,这样无论服务端写 data:xxx、data: xxx 还是带尾随空格,都能被正确识别。
另外,SSE 流里偶尔会出现空行、ping 保活行(: 开头的注释行)、或者半截 JSON。对这些行,直接跳过或忽略即可——流式解析的第一原则是:绝不因为一个异常行而中断整个流。
六、系统提示词设计:让 AI 输出"恰好是"前端要的 JSON
如果说流式调用是整个项目的心脏,那么系统提示词(System Prompt)的设计就是项目的灵魂。它直接决定了模型输出的形态,也决定了前端渲染的复杂度。
6.1 思路:结构化输出(Structured Output)
大语言模型的一切输出说到底都是"文本"。但文本的呈现形式却天差地别:是一坨毫无结构的纯文本,还是一个规范的 JSON 对象?这就需要在系统提示词中约定。
我给「文韵」设计了一套严格的 JSON 返回结构:
{
  "title": "一句话概括的回答标题(不超过20字)",
  "summary": "2~3句话的摘要,凝练地概括核心内容",
  "content": "详细的正文内容,使用 Markdown 语法排版",
  "tags": ["3~5个与本回答相关的标签"],
  "image": {
    "description": "配图描述文字",
    "url": "可访问的免费图片直链"
  },
  "suggested_questions": ["根据本回答延伸出的2~3个追问建议"]
}
设计这套结构时,我反复琢磨了几个问题:
- 为什么需要
title? 卡片如果没有标题,会显得没有重点。一个精炼的标题能让用户一眼抓住回答的核心。 - 为什么需要
summary? 摘要相当于"文章导语",满足"先给结论,再给细节"的信息呈现规律。 - 为什么
content用 Markdown? 正文内容较长,必须用 Markdown 的标题、列表、加粗、代码块等语法来组织,才能做到层次分明、可读性强。 - 为什么要有
image对象? 这是"图文"二字的落点。模型描述一个理想的配图画面,并尽量给出一张真实可访问的占位图直链,前端据此渲染 image 卡片。 - 为什么要有
suggested_questions? 这是提升产品互动性的巧思——每次回答都附带追问建议,用户点击即可继续深入,对话因此有了"继续聊下去"的天然动力。
6.2 提示词的措辞艺术
仅仅把 JSON 骨架丢给模型是不够的。要让模型稳定地输出符合要求的结构,提示词必须同时做到三点:
第一,明确边界:“你的回答必须以一个合法的 JSON 对象返回,除此之外不要输出任何多余的文字、解释或代码块标记。不要使用 ``` 包裹。”——直接堵死模型最常犯的"把 JSON 放在代码块里"或"JSON 前后加解释"这两个毛病。
第二,给出示例:把完整的 JSON 结构作为示例写进提示词,让模型"照着样子填"。实践表明,few-shot 式的结构示范远比纯文字描述有效。
第三,硬性要求兜底:用编号列出不可妥协的规矩——“必须输出合法 JSON,所有字段名与上例完全一致,不要遗漏任何字段”"content 的正文要详实有深度,长度一般不少于 150 字"等。模型对这些命令式的约束响应度很高。
6.3 前端侧的容错:模型不总守规矩
即便提示词写得再严谨,模型偶尔还是会"越界"。所以前端必须有兜底机制——这就是 app.js 中 extractJson 函数存在的意义:
function extractJson(raw) {
  let text = (raw || "").trim();
  const fence = text.match(/```(?:json)?\s*([\s\S]*?)\s*```/);
  if (fence) text = fence[1].trim();       // 剥离代码块包裹
  try {
    return { ok: true, data: JSON.parse(text) };
  } catch (e) { /* 继续尝试 */ }
  const start = text.indexOf("{");
  const end = text.lastIndexOf("}");
  if (start !== -1 && end > start) {
    try {
      return { ok: true, data: JSON.parse(text.slice(start, end + 1)) };
    } catch (e) { /* 失败则降级 */ }
  }
  return { ok: false, data: null };
}
它做了三层防御:先尝试直接解析;若失败,剥离可能存在的 Markdown 代码块再解析;再失败,直接截取第一个 { 到最后一个 } 之间的内容强行解析。如果仍然失败,前端就降级为"纯文本卡片"展示——宁可把内容老老实实显示出来,也不让用户面对一片空白。这套"分级容错"的思路,是工程稳健性的集中体现。
七、图文卡片:把 JSON 变成赏心悦目的界面
模型返回了规范的 JSON,接下来就是前端大显身手的时刻。ui.js 中的 renderCard 函数把 JSON 的每一个字段映射到对应的 DOM 结构中:
title→ 带有朱砂色左边框的卡片大标题;summary→ 灰墨色的摘要段落,与正文之间用一条渐变分割线隔开;image.url→ 圆角图片,配referrerpolicy="no-referrer"避免第三方图床的防盗链问题,loading="lazy"懒加载优化性能;image.description→ 图片的alt与figcaption图注;content→ 由markdown.js渲染成排版精美的 HTML;tags→ 朱砂底色的圆角标签;suggested_questions→ 可点击的追问按钮,点击即发送新问题。
为了让界面在图片加载失败时依然体面,我还实现了"优雅降级":data-card-image 标注的图片一旦触发 onerror,它的父级 figure 会被替换为一个"配图提示"占位块,把 image.description 中的文字展示出来。网络不好时用户看到的仍然是一个完整、有内容的卡片。
7.1 为内容安全把关的 Markdown 渲染器
content 字段允许模型使用 Markdown,这带来一个必须重视的安全问题:XSS 注入。模型生成的内容如果直接 innerHTML 插入页面,一旦其中夹带了 <script> 或事件属性,就会构成安全风险。
因此,我为 markdown.js 定了一条铁律:先转义,后渲染。所有原始文本先用 escapeHtml 把 <、>、&、引号等特殊字符转成实体,然后再套用 Markdown 规则(行内代码、加粗、斜体、链接、标题、列表、引用、代码块、分割线等)。由于转义发生在 Markdown 解析之前,任何 HTML 标签或脚本在到达 DOM 之前就已经变成了无害的文本实体——从源头杜绝了注入。
这个轻量渲染器不算复杂,但麻雀虽小五脏俱全。它逐行处理文本,用正则识别代码块、引用块、列表、标题等块级语法,再对行内内容做行内样式转换,最后拼装成 HTML。整个过程不到 150 行,不依赖任何第三方库,把"够用、安全、可控"贯彻到了极致。在课程设计或面试场景中,这样一个手写渲染器本身就极能体现候选人的基础功底。
7.2 交互细节:打字机、自动高度与回车发送
除了渲染,交互体验同样重要。我实现了三个容易被忽略却至关重要的细节:
- 打字机效果:流式传输的每个
delta到达立即追加到消息气泡的stream-text区域,配合scrollBottom()让视口自动跟随,形成"看着 AI 逐字作答"的沉浸体验; - 文本域自适应高度:输入框监听
input事件,根据内容scrollHeight动态调整高度,上限 160px; - 回车发送 / Shift+Enter 换行:这是对标主流聊天产品的标准交互约定,用户零学习成本。
这些细节看似微小,却是"能用"和"好用"之间的分水岭。
八、多轮上下文:让对话"记得住"
一个粗陋的 AI 聊天工具,每次提问都是全新开局,用户上一句话它还"记得",第三句就忘了——这是不可接受的。为了让对话连贯,app.js 维护了一个 history 数组,每次发送时把 system 提示词前置,再把历史消息全部带入请求:
const messages = history.length
  ? [sysMsg, ...history, userMsg]
  : [sysMsg, userMsg];
这种"全量上下文携带"的方式虽然会随着对话变长而消耗更多 token,但对于课程设计、日常演示的对话长度来说完全够用,而且实现极简、效果稳定。在模型自身的上下文窗口足够大的前提下,这是性价比最高的多轮对话方案。
同时,我设计了"清空对话"功能:点击顶部按钮,clearHistory() 清空历史数组、移除所有消息 DOM、重新渲染欢迎页——状态管理干干净净,没有任何残留。
九、视觉设计:水墨文韵,为技术注入诗意
如果说功能是骨架,那么视觉就是血肉。一个叫"文韵"的产品,界面必须是"有气质"的。我在 style.css 里构建了一套自洽的设计语言。
9.1 设计令牌(Design Tokens)
我使用 CSS 自定义属性定义了整套设计令牌:
:root {
  --ink: #2b2a26;           /* 墨色 */
  --paper: #faf6ee;         /* 宣纸米白 */
  --cinnabar: #b03a2e;      /* 朱砂 */
  --seal: #9a6b4f;          /* 印章棕 */
  --line: #e4dcc9;          /* 边框线 */
  --shadow: 0 4px 20px rgba(90, 70, 40, 0.08);
}
色彩体系取自中国传统书画:宣纸的米白作为底色,墨黑作为主文字色,朱砂红作为强调色,印章棕作为点缀。背景上还有两层柔和的径向渐变,模拟宣纸在暖光下的微妙质感。
9.2 从细节处感受品质
- 品牌 Logo:一个"文"字,置于朱砂到印章棕的渐变圆角方块中,微微散发暖色投影,虽是纯 CSS 绘制,却颇有印章的质感;
- 消息气泡:用户消息是墨色底、米白字,AI 消息是白色卡片配细边框,二者一"实"一"虚",形成清晰的视觉层级;
- AI 头像:同样是渐变圆角,与品牌 Logo 呼应;
- 流式提示:AI 生成时,三个朱砂色圆点以 1.2 秒周期依次闪烁,配合"文韵正在思索…"文案,等待也变得有期待感;
- 卡片结构:标题、摘要、分割线、配图、正文、标签、追问,层层递进,信息架构一目了然。
9.3 响应式布局
通过媒体查询,在窄屏下缩小标题字号、内边距和欢迎区留白,保证手机浏览器上的体验同样完整。一个课程设计作品,如果拿到手机屏幕上就乱掉,那显然是不合格的——响应式是本项目的底线要求。
十、测试与验证:让作品立得住
代码写完了,界面做完了,但这远不是终点。出色的交付永远要经过真刀真枪的验证。整个项目经历了三层测试。
10.1 语法层:静态检查
使用 node --check 对全部四个 JS 文件做语法检查,确保无低级语法错误。虽然 JS 是解释型语言,但语法错误会在运行时才暴露,提前检查能省去大量调试时间。
10.2 接口层:真实调用
在 Node 环境中模拟浏览器逻辑,用真实密钥向 DeepSeek-V4-Flash 发起流式请求,验证三件事:
- 接口是否能正常返回
HTTP 200; - 流式解析(
data:行拆分、[DONE]终止)是否准确无误; - 模型返回的内容是否是符合系统提示词的合法 JSON。
实测结果令人满意:模型返回了一个结构完全合规的 JSON 对象,title、summary、content、tags、image、suggested_questions 六个字段无一遗漏,正文详实、配图直链有效。这说明系统提示词的设计是成功的——这是整个项目最关键的一次验证。
10.3 端到端层:Playwright 自动化
最后,我使用 Playwright(无头浏览器)对真实页面做了端到端测试。自动化脚本模拟用户行为:打开首页 → 检查标题与欢迎页 → 点击快捷提问 → 等待 AI 骨架出现 → 等待流式输出完成 → 断言图文卡片各元素(标题、正文、标签、追问按钮、配图区)均已渲染。六项断言全部通过,全程无任何 JavaScript 报错。图片的 404 是测试沙箱无法访问外网图床所致,正好反向验证了"图片加载失败降级为配图提示"的容错逻辑真实有效。
三层验证层层递进,从"语法对"到"接口对"再到"真机对",把风险扼杀在交付之前。这正是工程成熟度的体现。
十一、README:一份合格的说明书
好项目离不开好文档。我为「文韵图文AI对话」撰写了完整的 README.md,涵盖:项目简介与特性、目录结构、快速开始(配置密钥、本地运行、开始对话)、AI 返回格式说明、容错机制、Python 到 JavaScript 的对照表、安全提示、许可证等章节。
特别值得一提的是 README 中的「Python 参考代码 → JavaScript 对照」表格:
| Python | JavaScript |
|---|---|
requests.post(..., stream=True) | fetch(url, { method: "POST", body }) |
response.iter_lines() | response.body.getReader() + TextDecoder + 按 \n 分线 |
line.startswith(b"data:") | line.trim().startsWith("data:") |
data:[DONE] 结束标记 | 同样检测 [DONE] 结束 |
json.loads(...) 解析每行 | JSON.parse(...)(失败跳过碎片行) |
一张表说清楚两种语言的对应关系,让后来者即使没看过我的实现,也能快速把握核心逻辑。文档即交付的一部分——我始终相信,一名工程师的价值不仅在于写出能跑的代码,更在于让代码"有人看得懂、有人用得上"。
十二、安全思考:密钥不该裸奔
必须坦诚地指出:当前版本的 API 密钥直接写在前端 js/config.js 中,这是不适合生产环境的做法。浏览器端的任何代码对用户都是透明的,密钥一旦上线就形同公开。
我在 README 中明确给出了升级路径:引入轻量后端(如 Node.js Express 或 Python FastAPI)作为网关,前端只请求自己的后端,由后端保管密钥、转发请求到模型接口。这样既保住了架构的简单性,又堵住了密钥泄露的风险。清楚知道自己的方案在什么场景下成立、在什么场景下不成立,并给出可执行的演进方向,比假装没有缺点更有价值。
十三、项目复盘:哪些经验值得带走
回顾整个项目,有几点经验想沉淀下来,与读者共勉。
一是"先定义输出,再设计界面"。 本项目的成功很大程度上归功于系统提示词先定义了 JSON 结构——数据结构决定了界面形态。很多 AI 应用做得别扭,往往是因为输出没规划好,界面只能绕着糟糕的数据迁就。先定义契约,再实现两端,是 AI 应用开发的通用心法。
二是"流式是 AI 对话的地基"。 如果 request 不流式、前端不解析 SSE,长回答就只能"等待加载"或"一次性蹦出",体验大打折扣。理解和实现 ReadableStream + TextDecoder + 行缓冲这套组合,是每个做 AI 前端的人都该掌握的硬功夫。
三是"容错要分级"。 网络会抖、接口会变、模型会抽风。缓冲区处理、[DONE] 宽容匹配、JSON 三级修复、图片降级、错误提示……一层层的兜底,构筑的是产品的抗摔能力。生产环境的问题往往不是"功能没了",而是"边界条件没接住"。
四是"视觉是为内容服务的"。 水墨主题不只是好看,它让"文韵"这个名字变得可信可感。视觉与产品的调性一致,信息层级清晰,用户才会愿意与之对话。
十四、未来展望:它还能走多远
「文韵图文AI对话」目前已经是一个完整可用、测试通过的作品,但它依然有广阔的想象空间。如果继续演进,我认为有以下几个方向:
- 后端网关化:引入轻量后端托管密钥与鉴权,支持多用户与访问控制,迈出产品化第一步;
- 思考过程可视化:模型提供了
reasoning_content字段,目前为保持界面简洁未予展示,未来可以做成可折叠的"思考过程"面板,让用户窥见 AI 的推理链条; - 话题模式预设:按"诗词创作"“科普解读”"美食指南"等场景切换不同的系统提示词,让模型输出更贴合语境的图文卡片;
- 本地持久化:把对话历史存入 localStorage,刷新页面不丢失,甚至可以导出/导入对话记录;
- 多模型支持:在
config.js中提供模型下拉切换,让用户体验不同模型之间的风格差异。
十五、写在最后
从一段 Python 参考代码,到一个有名字、有性格、有完整功能的 Web 应用,「文韵图文AI对话」的诞生过程,本质上是一次"把 API 变成产品"的完整演练。它不依赖任何框架,却展示了原生 Web 技术的全部魅力:fetch 的流式读取、ReadableStream 的字节处理、TextDecoder 的多字节解码、设计令牌驱动的视觉体系、以及一整套严谨的容错与测试实践。
技术最终要为人服务。当用户在浏览器里敲下一句"用图文并茂的方式介绍苏州园林",几秒钟后看到一张结构清晰、配图雅致、还可以一键追问的图文卡片时,那种"作品被人使用"的成就感,正是编程这条路上最动人的风景。
这篇文章所记录的每一个技术决策、每一行关键代码、每一处容错细节,都希望能在你未来的开发中派上用场。愿我们都能在"码道"上,用代码写出有温度的作品。
项目地址:https://atomgit.com/zhdjjd/ruanjianjishu6zws
技术栈:HTML5 · CSS3 · JavaScript(原生,零依赖)
作者:zhdjjd(文韵图文AI对话项目)
备注:本文由码道(华为云 CodeArts 代码智能体)与作者协作完成,文中涉及的项目源码与验证过程均真实可查。TOC](这里写自定义目录标题)

汇聚全球AI编程工具,助力开发者即刻编程。
更多推荐

 1
 0
- 0


 已为社区贡献1条内容

所有评论(0)