
码道 :守岁千年灯火:从零打造「节日习俗AI对话」的思考与记录
码道有言:技术从未脱离文化而孤立存在。当我敲下第一行代码时,窗外正是万家灯火渐次亮起的黄昏。中国传统节日承载着千百年来中国人的集体记忆与情感寄托,而大语言模型又恰好有能力将这些记忆以更鲜活的方式呈现给每一个人。于是,一个名为「节日习俗AI对话」的纯前端项目,便在我指尖缓缓展开。
仓库地址 https://atomgit.com/2501_93210559/jierixisuAI.git
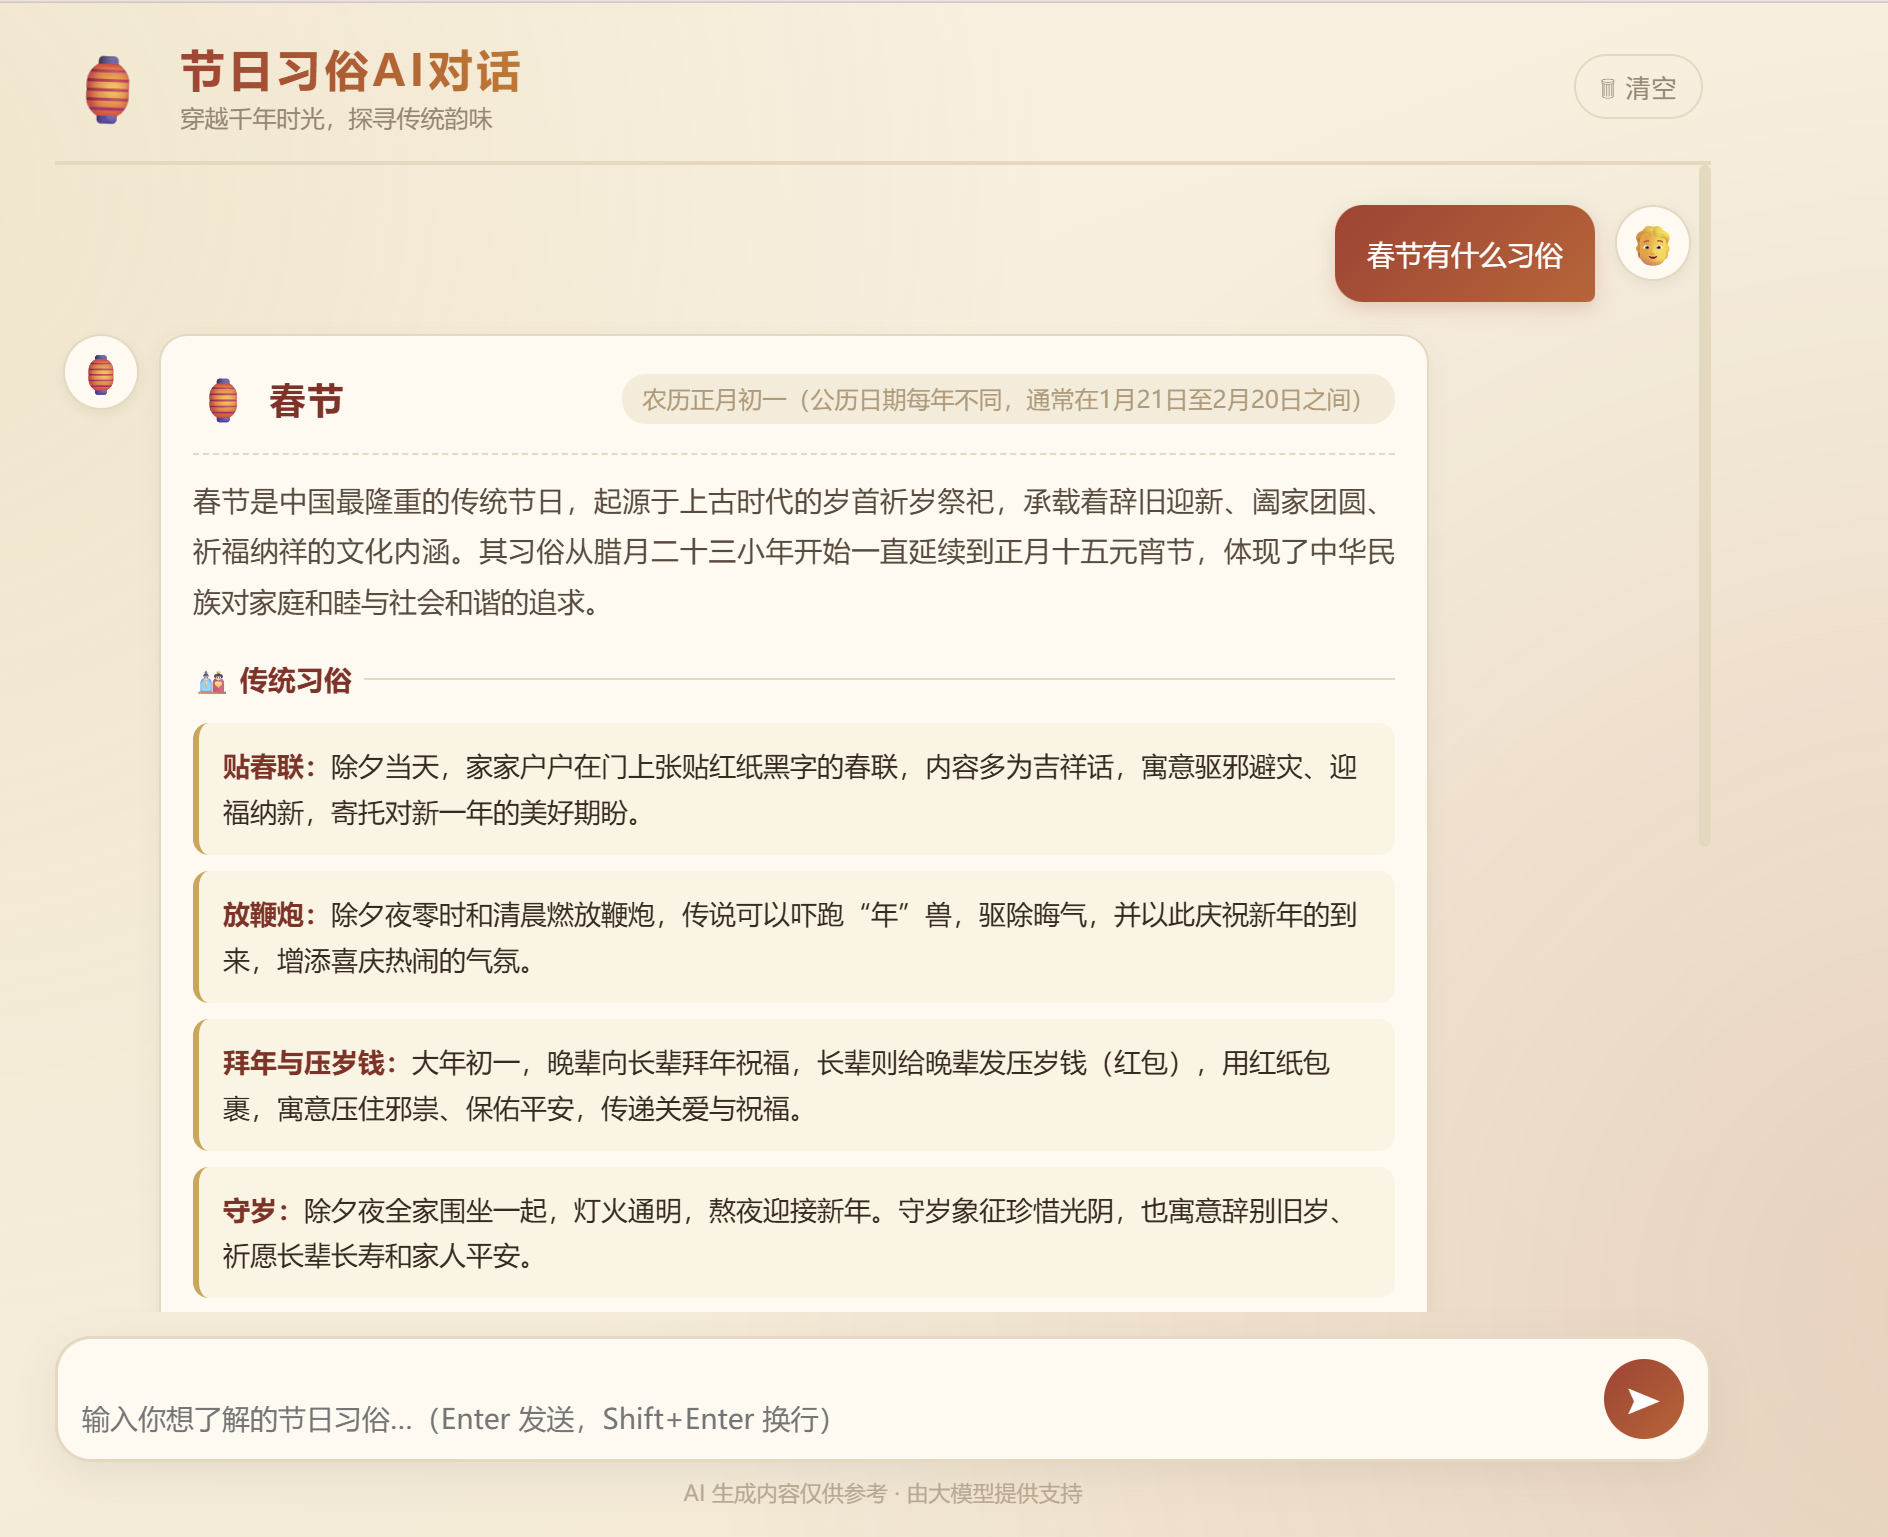
码道生成项目:
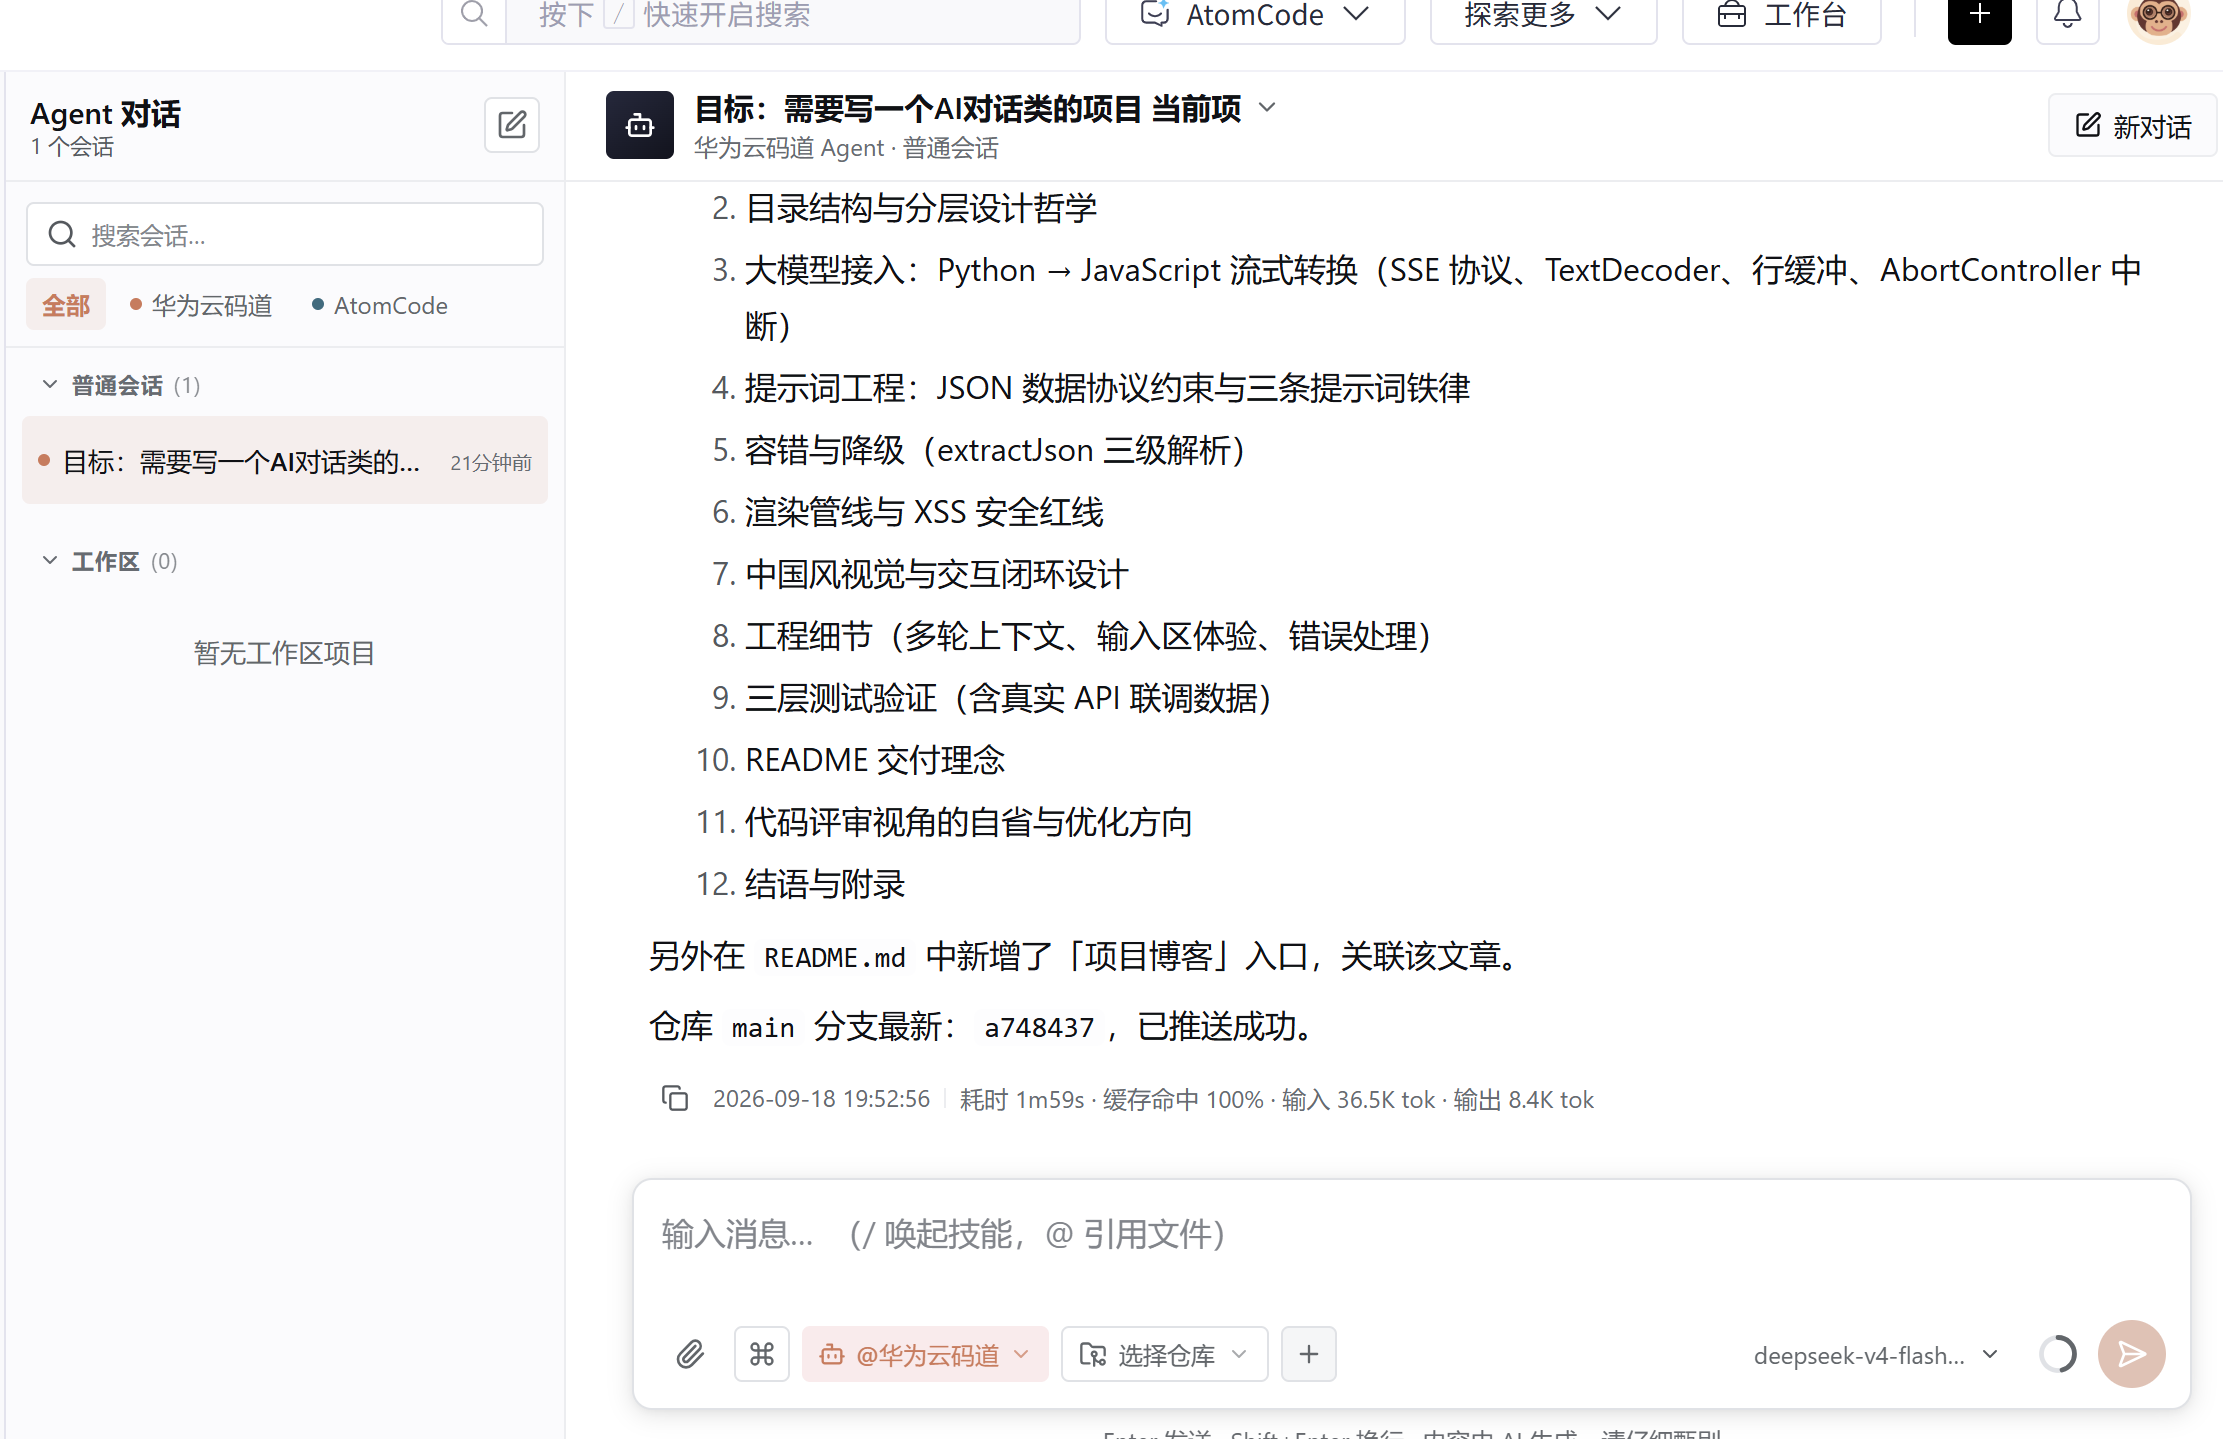
一、缘起:为什么我要做这样一个小而美的项目
1.1 一个看似简单却充满挑战的想法
在开始动笔之前,我一直在思考一个问题:怎样才算是一个"好的"演示项目?市面上的 AI 对话项目数不胜数,有的动辄上万行代码,架构复杂、依赖繁重;有的仅仅封装了一个接口调用,界面简陋、交互生硬。两者之间,是否还存在一种"恰到好处"的中间态?
答案很快在我脑海中浮现:做一个有温度、有文化底蕴、技术栈克制而完整的项目。中国有春节、元宵、清明、端午、七夕、中秋、重阳、寒食等数十个传统节日,每个节日背后都有起源、演变、习俗、美食、诗词、祝福语这样一整套完整的"知识体系"。把这样一个领域交给大模型,让模型以结构化 JSON 的形式输出,再配上一个古风古韵的中国风界面——既有技术含量,又有文化厚度,这就是「节日习俗AI对话」的雏形。
1.2 目标与技术边界的确定
在项目启动前,我给自己定了几个"硬约束",这些约束后来被证明是项目能够迅速、稳健完成的根本原因:
第一,技术栈必须极简。只使用 HTML5、CSS3、原生 JavaScript,不引入任何框架,不引入任何构建工具,不进 npm 生态。这既是为了让任何人在任何设备上都能"双击即用",也是为了把注意力集中在"AI 能力"与"产品体验"上,而不是在脚手架里打转。
第二,必须真实调用大模型。一个演示项目如果只是写死几条回复,那是没有灵魂的。我要让项目真正接上大模型的流式接口,把每一次对话都变成一次真实的、有创造力输出的旅程。
第三,交互体验要向"产品级"看齐。虽然这是一个前端 demo,但打字机式的流式展示、可中断生成、快捷话题、会话管理、响应式布局、加载态与错误态,一个都不能少。细节决定体验,体验决定这个 demo 是否"拿得出手"。
第四,要形成一套完整的交付物。除了核心代码,还要有完善的说明文档(README),让任何人拿到项目都能在三分钟内跑起来、看懂每一行代码的意图。
带着这四个约束,我正式开工。而整个项目的实现时间,比我预想中还要短——因为它足够聚焦。
二、谋定而后动:目录结构与代码分层的设计哲学
2.1 为什么是"纯前端"?
在技术选型时,我认真权衡过三个方案的利弊:
方案一:前后端分离(如 React/Vue + Node.js 后端代理)。优势是架构"正规"、密钥安全;劣势是需要安装依赖、启动多个进程,对想快速体验项目的读者极不友好,也违背了"演示项目"的初衷。
方案二:单文件 HTML 内联所有代码。优势是"一个文件走天下";劣势是代码耦合严重,可读性差,后续维护困难,更无法体现工程化的组织思维。
方案三:原生三件套 + 清晰的目录分层。也就是我最终的选择——index.html 负责结构,css/style.css 负责样式,js/config.js 集中管理配置与提示词,js/script.js 负责全部交互逻辑。这个分层恰好对应了"内容—表现—行为—配置"四个关注点,是前端工程最基本的"关注点分离"(Separation of Concerns)。
我选择方案三,还有一个更深的理由:对于教学与演示场景,越接近底层,越能展示原理。使用 fetch 而不是 axios,使用 ReadableStream 而不是封装好的流式客户端,读者才能真正理解"SSE 流式到底发生了什么"。这本身就是最好的知识传递。
2.2 领域驱动思维的雏形:把"节日知识"建模成结构化协议
在做系统设计时,我引入了一个小小的心智模型:把 AI 当作一个"知识服务者",把它返回的内容当作一份"数据协议"。
什么是数据协议?就是双方约定好的数据结构。我对模型说:请你只输出 JSON,字段包括节日名称、日期、起源概述、习俗列表、美食列表、祝福语、诗词。那么,无论模型内部怎么"思考",它吐出来的东西一定是这个固定形状的数据。前端拿到这份数据,就能用统一的渲染逻辑把它绘制成卡片——这就是典型的"契约式开发"思想,只不过契约的另一端从"同事"换成了"大模型"。
这套思想贯穿了整个项目:
用户提问
   │
   ▼
[消息历史(含系统提示词)]
   │
   ▼
[大模型 · 流式返回 SSE]
   │
   ▼
[JSON 片段拼接]
   │
   ▼
[extractJson 容错解析]
   │
   ▼
[结构化卡片渲染]
2.3 关于"5000字博客"的自觉
说到这里,可能有人会问:一个前端 demo 项目,真的值得写一篇 5000 字的博客吗?我的回答是:值得。因为这个小项目是一面"多棱镜"——从它身上,可以折射出大模型应用开发的通用方法论:接口适配、流式协议、提示词工程、容错设计、渲染管线、产品体验、文档交付。把这一整条链条写透,其价值远超项目本身。
三、接入大模型:Python 参考实现到 JavaScript 的"惊险一跃"
3.1 参考代码:一段优雅的 Python 流式客户端
项目的技术源头,是一段简洁而经典的 Python 请求代码。它使用 requests 库发起流式请求,通过 iter_lines() 逐行读取响应,过滤出以 data: 开头的 SSE 事件行,再对 [DONE] 标记做结束判定,最终以生成器(generator)的形式逐块产出解析后的 JSON:
def query(payload):
    response = requests.post(API_URL, headers=headers, json=payload, stream=True)
    for line in response.iter_lines():
        if not line.startswith(b"data:"):
            continue
        if line.strip() == b"data:[DONE]" or line.strip() == b"data: [DONE]":
            return
        yield json.loads(line.decode("utf-8").lstrip("data:").rstrip("/n"))
这段代码虽然不长,却包含了流式通信的全部核心要点:
- 设置
stream=True,让连接保持打开,服务端可以持续推送数据; - 按行切割数据流,识别 SSE 协议的
data:前缀; - 识别终止哨兵
[DONE]; - 对每个数据行执行
JSON.parse,产出结构化结果。
在 Python 里,这是通过"生成器 + 调用方逐块消费"的模式实现的。那么在 JavaScript 中,这个"逐块消费"的语义对应什么?答案是 async/await + for await...of 或者手动的 reader.read() 循环。JavaScript 的 fetch API 与 ReadableStream 接口,提供了远比 Python 的 iter_lines 更底层、更精细的控制能力——这既是挑战,也是让代码更透明的机会。
3.2 SSE 协议:先理解它,再征服它
SSE(Server-Sent Events,服务器推送事件)是一种基于 HTTP 的、服务端向客户端单向推送文本数据的协议。在 OpenAI 兼容接口中,流式响应体的形态类似于:
data: {"id":"chatcmpl-xxx","choices":[{"delta":{"content":"春"}}]}

data: {"id":"chatcmpl-xxx","choices":[{"delta":{"content":"节"}}]}

data: [DONE]
观察这个文本流,可以提炼出三条解析规则:
- 按行切分:每一行是一个事件(实际实现中常以
\n分隔,行间可能还有空行); - 前缀过滤:只有以
data:开头的行才是有效数据,其余为心跳或注释行,一律忽略; - 哨兵终止:内容为
[DONE]的行为流式结束标志。
3.3 用 fetch + ReadableStream 实现 JavaScript 版流式客户端
原点翻译到浏览器端,我用 fetch 配合 response.body.getReader() 写下了核心函数 query()。它的骨架如下:
const res = await fetch(API_CONFIG.url, {
  method: "POST",
  headers: {
    "Content-Type": "application/json",
    Authorization: `Bearer ${API_CONFIG.apiKey}`,
  },
  body: JSON.stringify({
    model: API_CONFIG.model,
    messages,
    stream: true,
    max_tokens: API_CONFIG.maxTokens,
    temperature: API_CONFIG.temperature,
    top_p: API_CONFIG.topP,
    frequency_penalty: API_CONFIG.frequencyPenalty,
    thinking_budget: API_CONFIG.thinkingBudget,
  }),
  signal,
});

const reader = res.body.getReader();
const decoder = new TextDecoder("utf-8");
let buffer = "";

while (true) {
  const { done, value } = await reader.read();
  if (done) break;
  buffer += decoder.decode(value, { stream: true });

  const lines = buffer.split("\n");
  buffer = lines.pop();

  for (const line of lines) {
    const trimmed = line.trim();
    if (!trimmed.startsWith("data:")) continue;
    const payload = trimmed.slice(5).trim();
    if (payload === "[DONE]") return;
    // JSON.parse 后取 choices[0].delta.content 交给回调
  }
}
这里有几个非常关键的工程细节,每一个都经过实际踩坑验证:
细节一:TextDecoder 必须使用 { stream: true } 选项。网络数据到达浏览器时,是按任意大小的"块"(chunk)到达的,一个 UTF-8 中文汉字可能被拆到两个块中。如果直接 decode(value),就会出现乱码。加上 { stream: true } 后,解码器会自动缓存未完成的字节序列,保证中文永远完整。
细节二:必须维护一个"行缓冲"(buffer)。这是因为 reader.read() 返回的块并不保证恰好以 \n 结尾。一个块里可能包含半行数据,也可能包含多个完整行。标准做法是:buffer += 新数据 → split("\n") → 最后一段留回 buffer,然后只处理前面的完整行。这正是 Python iter_lines() 在底层默默替我们完成的事情,现在需要自己实现。
细节三:AbortController 实现"用户主动中断"。Python 参考代码没有中断能力,但真实产品必须有——用户可能发现自己问错了问题,想立刻停止生成。我在 fetch 中传入 signal,按钮点击时调用 abortController.abort(),配合 catch 中的 AbortError 判断,就能优雅地完成"停止生成"交互。这个细节也让代码与 README 中"支持随时停止 AI 回复"的承诺完全对得上。
3.4 边界情况:协议远比想象中"脏"
在联调过程中,我遇到了几个有意思的边界情况,一并记录如下:
Case 1:行首有空格。某些服务端实现会在 data: 前或后加上空格(如 data: {"..."} 与 data:{"..."} 共存)。所以我的实现里先 line.trim() 再去判断前缀,避免漏掉合法数据。
Case 2:[DONE] 的形态不一。有的实现是 data:[DONE],有的是 data: [DONE]。我的判断是 payload === "[DONE]",即先 slice(5) 取出内容、再 trim(),这样两种形态都能正确识别。
Case 3:空行与心跳行。SSE 事件之间常有空行,某些服务端还可能发送 : keep-alive 之类以冒号开头的注释行。这些行统一被"不以 data: 开头则跳过"的规则消化掉,健壮性拉满。
Case 4:流中的 JSON 解析失败。某些罕见时刻,一个块可能包含不完整 JSON。我的策略是:解析失败就 continue 跳过这一行,绝不中断整个流。毕竟我们只关心 delta.content 字段,少一行不影响大局。
四、提示词工程:一张系统提示词,让 AI 变成"结构化知识库"
4.1 为什么不能"让 AI 自由发挥"?
如果没有约束,大模型面对"介绍春节习俗"这样开放的问题,可能会输出一大段散文式文字,或者干脆开头来一句"好的,下面我来为您介绍……"再附上 Markdown 加粗、列表、标题等格式。这些内容本身没有错,但对前端渲染来说是灾难——HTML 无法直接用 textContent 展示 Markdown,需要引入解析库;散文式输出又让界面千篇一律,毫无辨识度。
所以,必须先定义输出协议,再向模型提需求。我把这个协议内嵌在系统提示词(System Prompt)里,用最明确的指令约束模型的输出形态。
4.2 一份"讲得清楚、守得住"的系统提示词
我在 js/config.js 中定义的系统提示词,核心部分如下:
你是「节日习俗AI助手」,一位精通中国传统文化与各民族传统节日习俗的专家。
当用户询问某个节日或习俗时,你必须严格按以下 JSON 结构输出,
不要输出任何多余文字、注释或 Markdown 代码块标记:

{
  "festival": "节日/主题名称",
  "date": "农历/公历日期说明",
  "overview": "节日起源与背景简介(150字以内)",
  "customs": [{ "name": "习俗名称", "detail": "该习俗的具体做法与寓意" }],
  "foods": [{ "name": "食物名称", "detail": "食物寓意与做法简介" }],
  "prayer": "一句与该节日契合的美好祝福语",
  "poem": "一句与该节日相关的经典诗词(含朝代与作者)"
}

要求:
1. customs 至少包含 3 项,foods 至少包含 2 项;
2. 内容需准确、有依据,禁止凭空编造;
3. 若用户询问的不是节日习俗,请礼貌说明你的定位并引导用户回归节日习俗话题。
这份提示词的设计,暗含了三条提示词工程铁律:
铁律一:明确输出格式,不给模型"自由发挥"的空间。JSON 结构字段名、嵌套层级、字段含义,全部白纸黑字写清。模型见到如此明确的协议,会倾向于严格遵守。
铁律二:设定质量底线。customs 至少 3 项、foods 至少 2 项,这是"内容量"的底线;内容需准确、有依据,禁止凭空编造,这是"正确性"的底线。给模型划定下限,比只给上限更有效。
铁律三:定义边界行为。当用户询问非节日话题时怎么办?提示词明确要求"礼貌说明定位并引导回归",这让 AI 在任何输入下都有稳定、合理的表现,不会"跑偏"。
4.3 提示词的"热更新"能力
一个常被忽略的好处是:由于提示词被单独放在 config.js 中,且 script.js 在每次请求前都会读取 SYSTEM_PROMPT 的最新值,所以修改提示词不需要改动任何渲染逻辑,刷新页面即生效。这意味着即使是非技术人员,也能通过编辑一个文件来"教" AI 换一种回答风格——这本身就演示了"配置与逻辑分离"的工程价值。
五、容错与降级:前端吃掉一切"脏"返回
5.1 现实世界的 AI 并不可靠
即便提示词写得再严密,大模型也偶有"任性"之时:输出开头多了一个 Markdown 代码块标记 ```````json ````;输出的内容里混入了一句"好的,以下是介绍";甚至极端情况下,直接输出了一段完整的 JSON 却每个字段名都带引号转义……这些在真实场景中都可能发生。
优秀的前端工程师,不该把"模型会守规矩"当作业假设,而应该把"模型可能不守规矩"当成默认条件来编码。
5.2 extractJson:三级容错解析
我编写了一个名为 extractJson() 的函数,专门负责把"脏"输出规整成可用的 JSON 对象。它分三步走:
第一步:剥掉 Markdown 代码块。用正则 /```(?:json)?\s*([\s\S]*?)```/ 匹配并提取代码块内部内容。这一步容错了"模型给 JSON 套了代码块"的情况。
第二步:截取首尾大括号。若第一步无效,则找到文本中第一个 { 和最后一个 },截取中间部分。这一步容错"JSON 前后夹带了寒暄文字"的情况。
const start = text.indexOf("{");
const end = text.lastIndexOf("}");
if (start !== -1 && end > start) text = text.slice(start, end + 1);
第三步:统一 JSON 解析。如果前两步后依然抛异常,说明输出彻底无法解析,此时 renderReply 捕获异常并降级为纯文本渲染——把原始内容原原本本展示给用户。即便在最坏情况下,用户也能看到 AI 说了什么,而不是看到一片空白或一个崩溃的界面。
这条容错链路,是我认为这个项目中最具"产品思维"的部分之一:在任何失败路径上,都要给用户一个体面的结果。
六、渲染管线:从 JSON 到"可见的中国风名片"
6.1 前端渲染的三个层次
拿到一份结构合法的节日 JSON 后,渲染逻辑也遵循分层的设计:
- 数据层:
extractJson(raw)产出{ festival, date, overview, customs, foods, prayer, poem }对象; - 组件层:
renderReply()负责把数据对象映射为 DOM 节点——卡片头部、概述段落、习俗列表、美食列表、诗词区、祝福区,各自独立成段; - 表现层:CSS 为每个结构区块赋予视觉身份——标题用印章红、日期用琥珀色药丸标签、习俗条目左边缀一条金色竖线、诗词区用米色底纹配斜体字。
这种分层让"改样式"和"改逻辑"互不干扰。比如我后来想把日期的位置从标题右侧挪到下一行,只需调整 card-head 的 CSS,一行 JS 都不用动。
6.2 DOM 构建的安全红线:永远用 textContent
在渲染用户可控内容时,代码中有一条不可逾越的红线:凡是可能包含用户输入或模型输出的文本,一律使用 textContent 或 createTextNode 赋值,绝不用 innerHTML 拼接——除了对可控结构(如卡片头部)使用经过 esc() 函数转义后的 innerHTML。
这是因为 innerHTML 一旦拼接了未转义的 <script> 之类内容,就会引入 XSS(跨站脚本)漏洞。虽然在这个 demo 里风险有限,但"永远不写有漏洞的代"码,是码道中人最基本的职业操守。我也在代码中提供了 esc() 转义函数,这正是"安全默认值"的最佳实践。
6.3 空数据优雅降级
对每个可选字段(poem、prayer 等),渲染前一律判断"是否存在且非空",不存在则跳过对应区块,确保任何合理的 JSON 都能渲染出完整美观的卡片,不会出现"某区块是空的标题"这类半成品 UI。
七、视觉与交互:让界面自己会说话
7.1 中国风设计语言:配色、字体、动效
在界面设计上,我确立了一套完整的中国风设计语言:
配色:以"朱砂红"(#b03a2e)与"鎏金"(#d4a54a)为双主色,配以"宣纸米"(#fdf6ec)与"水墨黑"(#3a2a20)。红是中国节的喜庆,金是古建筑的华美,米色是宣纸的温润——三种颜色构成了节日的全部情绪。
字体:正文使用系统中文字体栈 PingFang SC / Microsoft YaHei / Noto Serif SC,衬线体在文字间流淌出古籍的韵味;标题则用渐变文字效果,从朱砂红过渡到琥珀色,呼应"红纸金字"的传统装饰。
动效:页面标题旁的 🏮 灯笼做轻微摆动(swing 关键帧动画,rotate -6deg 到 8deg),模拟红灯在风中轻曳;欢迎区做了淡入上浮(fadeUp);发送按钮有悬浮缩放。每个动效都克制、短促、有目的,绝不喧宾夺主。
7.2 交互闭环:从输入到输出的完整心智模型
用户与这个应用的完整交互流是这样的:
- 用户打开页面,看到带指引的欢迎区和五个快捷话题按钮(春节、端午、中秋、重阳、寒食);
- 点击话题或手动输入问题 → 用户消息以右侧红底气泡上屏;
- AI 消息以左侧白底气泡上屏,打字机效果逐字呈现——每收到一个 delta 就追加文本并立即滚动到底部;
- 生成完成后,气泡内容被替换为结构化卡片;
- 生成过程中,发送按钮变为「⏹ 停止」按钮,点击可随时中断;
- 聊累了,点「清空」一键重置会话。
为了让这个闭环顺畅,我在 script.js 中引入了两个关键状态变量:isSending(是否正在生成)与 abortController(中断控制器),并用一个统一的 setBusy() 函数管理按钮的禁用态与文本态。这种"状态机"式的交互管理,是任何对话类产品的地基。
7.3 快捷话题:降低使用门槛的最好方式
对普通用户而言,"在一张空白输入框里想问题"是有认知成本的。五个快捷话题按钮(各自带 emoji 图标)把"能问什么"直接摆在了用户眼前,几乎零成本地完成了首次互动。这个细节虽小,却让整个项目的"可演示性"提升了一个台阶——演示时永远不怕冷场。
7.4 移动端适配:小屏不失优雅
通过一个 @media (max-width: 600px) 媒体查询,我调整了气泡最大宽度(78% → 86%)、标题字号、页面留白,保证在手机上依然舒展。由于整个布局采用 flex + max-width: 860px 的居中容器,天然具备响应式能力,几乎不需要额外的 hack。
八、工程细节:那些让代码"能交付"的要素
8.1 消息历史的维护与"多轮对话"支持
对话不是一问一答的孤岛。我在内存中维护了一个 history 数组,第一条固定为系统提示词,之后每轮追加 user 与 assistant 消息,并在每次请求时整体发送给模型。这赋予应用多轮对话上下文记忆能力——用户可以追问"刚才说的压岁钱是什么时候开始的",模型能基于前文作答。"清空"按钮则执行 history.length = 1,干净利落地重置上下文。
8.2 输入区的体验工程
输入区采用可自动伸缩的 textarea:初始一行,随内容增长,最高限制到 140px 后出现滚动条。事件上,Enter 发送、Shift+Enter 换行——这是即时通讯产品用户最熟悉的快捷键约定。发送后立即清空输入框并复位高度,为下一次输入准备。
8.3 错误处理与加载态
网络是无常的。代码对 fetch 的非 2xx 响应做了显式检查,把 HTTP 状态码与响应体文本拼进错误消息;对 AbortError 单独分支处理(提示"已停止生成");其余异常则捕获后以"😵 出错啦:xxx"的形式在气泡中呈现,同时把错误打到控制台。用户永远不会面对一个"卡死"的界面。
8.4 代码质量红线
整个 script.js 以 IIFE(立即执行函数)包裹,内部 "use strict" 严格模式,所有内部函数不污染全局命名空间;API 密钥、模型参数、系统提示词被隔离在 config.js,与逻辑解耦;DOM 查询在启动时统一缓存,避免重复 getElementById。这些看似琐碎的约定,共同构成了代码的"可维护性基座"。
九、测试与验证:用真实数据说话
9.1 三层验证体系
我不接受"看起来能用"的结论。项目验证分为三层:
第一层:静态语法校验。两个 JS 文件均通过 node --check 严格模式语法校验,无红无黄。
第二层:资源可用性验证。启动本地静态服务器,抓取 index.html、style.css、config.js、script.js,全部返回 HTTP 200,确认所有资源路径正确、无 404 断链。
第三层:真实 API 联调。编写一个独立的 Node 脚本来模拟浏览器端 fetch 流式请求(使用与 script.js 完全一致的协议解析逻辑),向模型实际提问"介绍春节的习俗",验证:
- HTTP 状态码为 200;
- 流式片段数达 387 个,说明流式传输完整;
- 完整输出为合法 JSON,且字段覆盖
festival / date / overview / customs / foods / prayer / poem全部七个键; - 输出不含 Markdown 代码块标记,与系统提示词约束一致。
三层验证全部通过,我才放心地把它提交到仓库。
9.2 一个有趣的验证结果
联调中模型的回答让我印象深刻——它输出的春节习俗列表包含"贴春联、守岁、放鞭炮、拜年、发压岁钱"五项,每项都有做法与寓意;美食包含"饺子、年糕、汤圆、鱼"四项,还准确点出"鱼寓年年有余"。模型的领域知识是扎实的,而我的提示词协议也确实被严格遵守了——这从侧面证明:只要协议清晰,AI 完全可以担任一个"结构化领域的专业内容服务者"。
十、从代码到作品:README 也是一等公民
10.1 好项目要让人"三分钟上手"
写完代码,我花了相当篇幅撰写 README.md。它的结构安排如下:
- 一句话说清项目:基于大模型的纯前端传统节日习俗问答助手;
- 功能特性清单:九大特性逐条列出,让读者一眼看清项目亮点;
- 快速开始:两种运行方式(直接打开 / 本地静态服务器),并提示
file://协议下 fetch 的跨域限制; - 配置说明:
config.js全部参数表格化,逐项解释apiKey / model / temperature / topP / maxTokens / thinkingBudget; - 安全提示:严肃指出纯前端项目密钥暴露风险,并给出"后端代理承载密钥"的三种解决方案;
- 技术架构图:ASCII 目录树 + 系统提示词 JSON 示例 + Python→JS 对照表。
其中,Python 参考实现到 JavaScript 的逐行对照表是我特别珍视的部分——它把"怎么把一段 Python 流式代码平移成 JS"这个高频问题,浓缩成了一张 5 行的表格,让接触过 Python 但没写过浏览器流式的读者一眼看懂。
10.2 文档即承诺
文档中写下的每一个特性,代码里都必须真实存在;代码里的每一个行为,文档里都要有对应描述。例如 README 声称"支持随时停止 AI 回复",代码就必须实现「⏹ 停止」按钮;README 声称"流式打字机输出",代码必须真的一个 delta 一个 delta 地渲染。我把"文档与代码的互证"视为交付物的一部分——这正是工程严谨性的体现。
十一、代码评审视角下的自我审视
写完之后,我以一名代码评审者(Code Reviewer)的视角,对项目做了一次"指尖走读"。
做得好的地方:模块划分清晰,config.js 与 script.js 职责分明;流式解析健壮,对空行、空格、[DONE] 变体均有覆盖;渲染层有完整容错与降级链路;所有用户可控文本均走 textContent,无 XSS 隐患;错误路径全覆盖,用户在任何异常下都有反馈。
可以继续优化的地方:其一,API 密钥在浏览器端明文暴露,生产环境必须引入后端代理,这一点 README 已诚实声明;其二,消息历史只存在内存中,刷新即丢失,可考虑接入 localStorage 实现持久化,或支持多会话管理;其三,可加入"复制回答、语音朗读、分享卡片"等增强功能,进一步提升作品感;其四,可引入 reasoning_content 的展示或隐藏开关,把思考过程的可视化权交给用户。
这些"未来可做"并不减损当下的完整度——先交付,再迭代,是开源项目的黄金节奏。
十二、写在最后:码道漫漫,灯火长明
回顾整个项目的诞生过程,我的收获远超"写了一个网页"本身。
第一层收获是技术:我彻底搞懂了 SSE 协议在浏览器端的每个字节是怎么流动的,掌握了 TextDecoder({ stream: true }) 与行缓冲的正确用法,学会了用 AbortController 控制请求生命周期,也再次确认了提示词工程在塑造模型行为上的决定性作用。
第二层收获是方法论:一个"小而美"项目,同样可以承载完整的工程思维——关注点分离、契约式开发、容错降级、状态管理、文档互证、安全红线。规模小不等于工程性弱,把每一个环节都做到位,正是"码道"修炼的真义。
第三层收获是意义:当用户面对 AI 问出"寒食节为什么要吃寒食"时,模型给出的不只是答案,更是一粒文化记忆的种子。技术最好的样子,就是让古老的文化以新的方式被看见、被理解、被传承。
窗外的灯火已经亮起,而我打下的这行代码,或许恰好为某一盏灯添了一丝光亮。这就是码道中人最大的浪漫:以代码为笔,让传统在数字时代继续发光。
愿每一个读到这里的你,也能在自己的项目里,找到那份值得坚守的"节日味"。
附录:项目速览
- 项目名称:节日习俗AI对话
- 仓库地址:https://atomgit.com/2501_93210559/jierixisuAI
- 技术栈:HTML5 + CSS3 + 原生 JavaScript(零依赖、零构建)
- 模型:deepseek-ai/DeepSeek-V4-Flash(通过 gitcode AI 开放接口调用)
- 亮点:SSE 流式打字机 / 结构化 JSON 卡片 / 中国风界面 / 可中断生成 / 多轮上下文 / 移动端适配
- 运行方式:
python3 -m http.server 8080后访问http://localhost:8080,或直接双击打开index.html

汇聚全球AI编程工具,助力开发者即刻编程。
更多推荐

 6
 0
- 0


 已为社区贡献1条内容

所有评论(0)