
码道:当古诗词遇上大模型——诗歌接龙 AI 对话项目从零到发布全记录
一、缘起:为什么要做"诗词接龙"
大约在一个月前的某个夜晚,我在整理书架时翻出一本泛黄的《唐诗三百首》。随手翻开一页,读到李白那句"床前明月光",脑海中忽然浮现一个念头:如果有一位精通诗词的"AI 诗友"坐在对面,我出一句诗,它顺着末字接下一句,一来一往,那该是怎样一幅画面?
诗词接龙,又称"衔字诗"“续句”,是中华传统文化中一种极具趣味性的文字游戏。古人宴饮时行之,谓之"飞花令";文人雅集时行之,谓之"联句"。它考验的不仅是诗词储备量,更是对韵律、平仄、对仗和意境的综合把握。一句"床前明月光",接续者必须以"光"字起头,或求工整,或求意境,一脉相承又别开生面。
而 2026 年的今天,大语言模型已经能够熟练地吟诗作对。把这两者结合起来——让 AI 成为一位既懂格律、又懂意境的"诗友",用最熟悉的编程语言将它带到浏览器里——便成了我这个项目最初的灵感来源。
这个项目被我命名为"诗词接龙 AI 对话"。它的目标非常朴素:打开一个网页,输入一句诗,AI 以末字为引接出下一句,并附上释义与出处,如同一位端坐案前的鸿儒,与你隔屏对诗。
仓库地址:https://atomgit.com/2501_94636742/wdqimozuoye
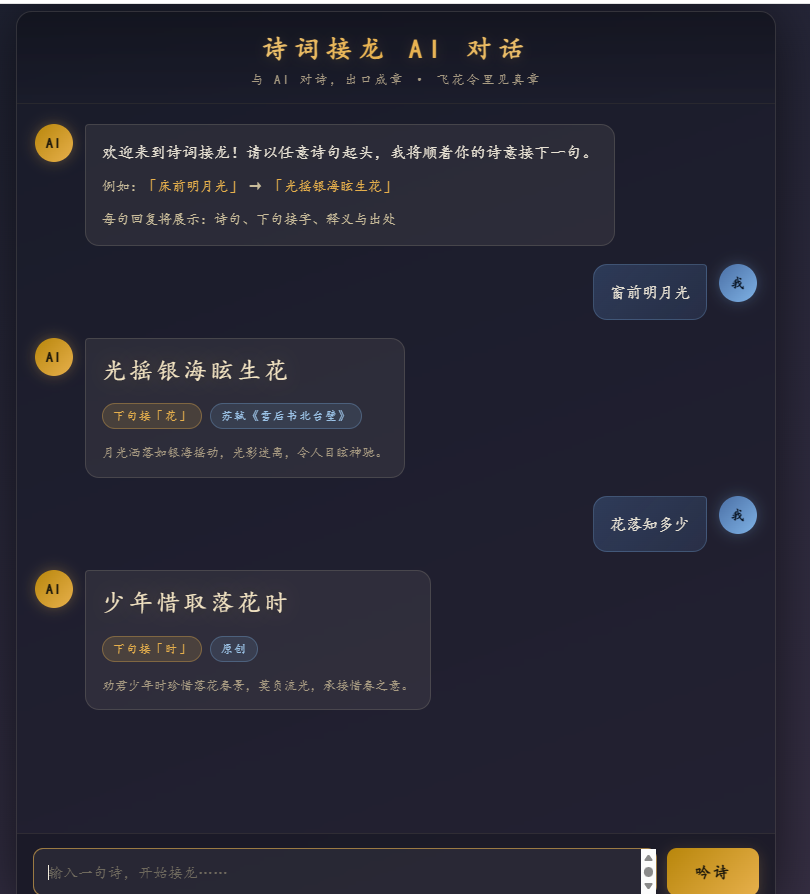
码道流程截图:
经过一番思考,我为这个项目定下了三条核心原则:
第一,纯前端,零依赖。项目使用最本原的 HTML5、CSS3 与 JavaScript 实现,不引入任何框架与构建工具,做到"打开即用",让任何人复制过去都能直接运行,降低学习与复现的门槛。
第二,流式体验。AI 的回答不是"转完圈一次性跳出",而是像真人打字一样逐字逐句"吟"出来。这种即时反馈带来的沉浸感,是传统"等待—加载—显示"所无法比拟的。
第三,结构化输出。让大模型不仅"会说话",更要"说对话"。通过精心设计的系统提示词,让 AI 每次只返回一段干净的 JSON,前端按字段渲染成精美的"诗词卡片"——诗句、下句接字、释义、出处,一目了然。
这三条原则,构成了整个项目的骨架。接下来,请随我一同回顾这条从一行 Python 参考代码开始,到最终成品发布的完整旅程。
二、项目定位与技术选型
在正式动手之前,我需要对项目的技术路线做一个清晰的判断。
2.1 为什么选择纯前端?
很多人在构建这类 AI 应用时,第一反应是"要用 React/Vue + Node.js 后端"。但仔细想想,这个项目的本质需求其实非常简单:一个聊天界面、一次 HTTP 请求、一段流式响应解析。它并不涉及复杂的用户系统、数据库或服务端渲染。
选择纯前端有三大好处:
其一,零成本部署。 一个静态目录,随便扔到任意静态服务器、对象存储,甚至用 file:// 协议直接双击打开,都能跑起来。企业里经常要求"最小可行产品"(MVP),纯前端方案是验证想法的绝佳选择。
其二,原理透明。 没有框架的魔法,没有依赖树的黑盒。fetch 怎么发请求、ReadableStream 怎么逐块读取、SSE 协议怎么解析,每一个环节都清清楚楚。对于想学习"大模型接入前端"这条技术路线的人来说,这是一份极佳的活教材。
其三,极致的可移植。 整个项目就三个核心文件——HTML、CSS、JS。想改成移动端适配、想嵌入别的页面、想做成 Electron 桌面应用,都可以无缝迁移。
2.2 技术栈清单
| 技术 | 用途 |
|---|---|
| HTML5 | 页面结构、语义化标签、<textarea> 自适应输入框 |
| CSS3 | 古风视觉、Flex 布局、渐变、动画、响应式设计 |
| JavaScript (ES2020+) | AI 调用、SSE 流式解析、JSON 解析容错、DOM 渲染 |
| Fetch API + ReadableStream | 替代 Python requests,实现浏览器端流式请求 |
| DeepSeek API | 大模型对话能力(模型:deepseek-ai/DeepSeek-V4-Flash) |
这个组合干净、清晰,没有一寸多余的脂肪。它让我可以把全部注意力放在两件最重要的事情上:如何让 AI 说出符合格律的诗句,以及如何让页面把这句诗最美地呈现出来。
三、把 Python 参考代码"翻译"成 JavaScript
项目的起点,是一段 Python 参考代码。它演示了如何调用大模型接口并获取流式响应,核心逻辑如下:
import os
import requests
import json

API_URL = "https://api-ai.gitcode.com/v1/chat/completions"
headers = {
    "Authorization": f"Bearer sZzKos_vnLL7xcgwNaGTARHX",
}

def query(payload):
    response = requests.post(API_URL, headers=headers, json=payload, stream=True)
    for line in response.iter_lines():
        if not line.startswith(b"data:"):
            continue
        if line.strip() == b"data:[DONE]" or line.strip() == b"data: [DONE]":
            return
        yield json.loads(line.decode("utf-8").lstrip("data:").rstrip("/n"))

chunks = query({
    "model": "deepseek-ai/DeepSeek-V4-Flash",
    "messages": [{"role": "user", "content": "告诉我一个有关宇宙的有趣事实?"}],
    "stream": True,
    "max_tokens": 2048,
    "temperature": 0.6,
    "top_p": 0.95,
    "frequency_penalty": 0,
    "thinking_budget": 2048
})

for chunk in chunks:
    print(chunk["choices"])
这段代码虽然短小精悍,却蕴含了与大模型交互的两个关键工程要点:SSE 流式协议与逐块增量解析。由于项目是纯前端,我必须把这段 Python 逻辑完整地移植到浏览器环境。
3.1 一对一的转换对照
| Python 参考 | JavaScript 实现 |
|---|---|
requests.post(url, ..., stream=True) | fetch(url, { method: "POST", body: JSON.stringify(payload) }) |
response.iter_lines() | response.body.getReader() + TextDecoder 按行切分 |
line.startswith(b"data:") | line.trim().startsWith("data:") |
data:[DONE] 结束标记 | 检测 [DONE] 后 return |
json.loads(...) 逐块解析 | JSON.parse(...) 逐块解析后 yield |
其中最重要的一处移植是"异步生成器"。Python 的 query() 是一个生成器函数,用 yield 逐块吐出解析后的 JSON。JavaScript 同样支持生成器与异步迭代,于是我可以写出几乎一一对应的版本:
async function* query(payload) {
    const response = await fetch(API_URL, {
        method: "POST",
        headers: {
            "Authorization": `Bearer ${AUTH_TOKEN}`,
            "Content-Type": "application/json"
        },
        body: JSON.stringify(payload)
    });

    if (!response.ok) {
        const errText = await response.text().catch(() => "");
        throw new Error(`请求失败 (HTTP ${response.status}): ${errText.slice(0, 200)}`);
    }

    const reader = response.body.getReader();
    const decoder = new TextDecoder("utf-8");
    let buffer = "";

    while (true) {
        const { done, value } = await reader.read();
        if (done) break;

        buffer += decoder.decode(value, { stream: true });
        const lines = buffer.split("\n");
        buffer = lines.pop();

        for (const line of lines) {
            const trimmed = line.trim();
            if (!trimmed.startsWith("data:")) continue;

            const data = trimmed.slice(5).trim();
            if (data === "[DONE]") return;

            try {
                yield JSON.parse(data);
            } catch {
                // 忽略无法解析的分片
            }
        }
    }
}
3.2 移植过程中踩过的三个坑
坑一:中文编码与分行边界。 TextDecoder.decode(value, { stream: true }) 的 stream: true 参数极其关键。它告诉解码器:当前数据块可能只是某个 UTF-8 字符的一部分,先缓存,等后续字节到达后再完整解码。如果不加这个参数,遇到多字节的中文字符恰好被网络包"拦腰截断"时,就会出现乱码。
坑二:分片可能在任意位置断开。 网络传输不会乖乖地把完整的 data: 行交给你——一个 JSON 片段可能被截成两半,分属两个网络包。我的处理方式是维护一个"缓冲串",每次收到新字节就拼进缓冲,然后按 \n 切行,把最后一行(可能不完整)留在缓冲中继续拼接。这正是 iter_lines() 在 Python 内部也在做的事情。
坑三:[DONE] 标记的两种形态。 原始 Python 代码同时判断了 data:[DONE] 和 data:[DONE] 前面的空格,即 b"data:[DONE]" or b"data: [DONE]"。在 JavaScript 端,我统一先 trim() 再去掉 data: 前缀,就能优雅地兼容这两种形态,避免漏判导致解析器在流结束后还傻等着。
3.3 多轮上下文的累积
对话系统与单次问答最大的区别,在于状态。我维护了一个 messages 数组,其结构就是 OpenAI 兼容的对话格式:
let messages = [{ role: "system", content: SYSTEM_PROMPT }];
每次用户发言,先 push({ role: "user", content: text }),AI 流式回复结束后再 push({ role: "assistant", content: fullContent })。下一次请求时把整个数组原样发送。这样,AI 就能"记得"此前对过的每一句诗,接龙可以无限延续,意境层层递进。
需要特别注意的是,系统提示词必须始终处于数组首位。它像是围棋中的"先手布势",确立了整场对弈的规则,绝不能因为对话轮次增加而被顶出上下文窗口。
四、用系统提示词"驯服"大模型:JSON 结构化返回
在最初版本中,AI 的回复五花八门:有时附上"以下是接龙……"的解释,有时用 Markdown 加粗,有时干脆写成一段赏析文章。这些"噪音"不仅破坏了界面的精致感,也给前端解析带来了巨大负担。
于是,改造的重心落在了系统提示词上。我的目标十分明确:让 AI 只输出一个干净的 JSON 对象,字段固定、语义清晰,前端拿到即可直接渲染。
4.1 系统提示词的设计
我给 AI 写下了这样一段"圣旨":
你是古代才情横溢的诗词大家,正在与人对诗接龙。

【接龙规则】
1. 严格以对方诗句的【最后一个字】作为你诗句的首字(或该字的同音近音字)续写;
2. 优先匹配五言/七言绝句或律诗的平仄韵律,工整对仗;
3. 内容需与上句意境连贯、浑然一体;
4. 每次只接一句诗。

【输出格式 - 必须严格遵守】
只输出一个合法的 JSON 对象,禁止输出任何其他文字、解释、Markdown 代码块标记。
JSON 字段说明:
{
  "poem": "你接出的诗句(一行)",
  "rhyme": "你诗句的最后一个字,即对方下一句需要以它(或同音字)开头",
  "notes": "对本句的简短释义或赏析,40 字以内",
  "source": "出处;原创则写"原创""
}

【示例】
对方输入:床前明月光
你的输出:{"poem": "光摇银海眩生花", "rhyme": "花", "notes": "月光如银海摇曳,波光潋滟令人目眩。", "source": "原创"}

【异常处理】
若对方输入的不是诗句,请在 notes 中礼貌提醒并请对方吟一句诗,poem 给出一句应景接龙诗。
这段提示词的设计有三处巧思:
其一,用"必须严格遵守"建立约束的语气。 大模型对指令中的"禁止"“必须”"只"等强约束词更为敏感,能明显降低输出偏离的概率。
其二,给出字段说明与完整示例。 大模型是"示例驱动"的。一个完整的输入→输出示例,比十句抽象的规则描述都有效。AI 看到"床前明月光"应该回什么 JSON,自然就会模仿这种格式。
其三,预设异常分支。 对话系统面对的输入千奇百怪,用户可能输入"今天天气怎么样"这种非诗句。我在提示词中预设了应对逻辑:poem 输出一句应景诗,notes 里礼貌提醒。这让系统即使在"失控场景"下也不会显得呆板。
4.2 四个字段的业务设计
| 字段 | 含义 | 界面呈现 |
|---|---|---|
poem | 接出的诗句 | 卡片主体,大字渲染,配金色光晕 |
rhyme | 诗句尾字 | 生成"下句接「×」"提示标签,引导用户继续接龙 |
notes | 释义与赏析 | 卡片底部浅色小字,提升文化质感 |
source | 出处 | 蓝色标签,标注原创或古籍出处 |
这四者的组合,让一条朴素的 AI 回复变成了三秒可读的知识卡片:一眼看到诗句,一瞟知道怎么接,一品懂得其中味。
4.3 宽容而稳健的 JSON 解析
尽管提示词已经竭尽全力约束格式,但大模型的输出依然具有一定的"随机性"。实践中,AI 偶尔会:
- 在 JSON 前后包裹
json ...代码块围栏; - 在 JSON 前多输出一句"好的,这是我的回答";
- 在 JSON 后附带一句"希望对你有帮助"。
如果前端直接 JSON.parse,这些情况必然抛异常。因此我编写了一个三层容错的解析函数 extractJson:
function extractJson(raw) {
    const text = String(raw).trim();
    if (!text) return null;

    // 第一层:剥离 ```json ... ```/ ```... ```代码块围栏
    const fenced = text.match(/```(?:json)?\s*([\s\S]*?)```/);
    const candidate = (fenced ? fenced[1] : text).trim();

    // 第二层:截取第一个 { 到最后一个 } 之间的内容
    const start = candidate.indexOf("{");
    const end = candidate.lastIndexOf("}");
    if (start === -1 || end === -1 || end <= start) return null;

    // 第三层:尝试 JSON.parse,失败返回 null
    try {
        return JSON.parse(candidate.slice(start, end + 1));
    } catch {
        return null;
    }
}
这套策略的稳健性在于层层降级:围栏剥不掉就截大括号,截完还解析失败就直接返回 null,交由调用方兜底——此时界面会退化为展示 AI 原文,绝不至于让页面"白屏"或报错。
同时,为了防止恶意脚本注入,所有字段在渲染前都经过 escapeHtml 转义,把 <、>、&、引号等危险字符全部替换为 HTML 实体,从源头杜绝 XSS 隐患。
五、界面设计:古风 UI 的打造
如果说 AI 是项目的"灵魂",那么界面就是它的"衣冠"。一个诗词接龙应用,若穿着现代的极简风外套,总显得不够地道。我决定让整个界面浸润在"明清书房"的古典氛围里。
5.1 色彩与质感
主背景采用深色水墨渐变:从 #1a1f2e 的墨蓝,流转到 #3a3146 的暮紫,营造深夜书房幽静深远的氛围。而在背景之上,一层 rgba(20,22,34,0.55) 的半透明毛玻璃卡片托起主体,配合 backdrop-filter: blur(6px) 的模糊,让内容区域从背景中"浮"出来,仿佛一方铺展在案头的宣纸。
金色是全局的点睛色。标题采用 linear-gradient(90deg, #f0d9a8, #e7b04c, #f0d9a8) 的金色渐变文字,再配合 text-shadow 的光晕,恰如烛光下鎏金的匾额。AI 的头像也镀上 #b8860b → #e7b04c 的暗金渐变,与用户头像清雅的 #4a6fa5 → #7fb2e5 冷蓝形成冷暖对仗——一金一蓝,正如"AI 诗友"与"我"的身份区隔。
5.2 字体与排版
字体选择了 "KaiTi", "STKaiti", "楷体", "Noto Serif SC", serif 的楷体系,回归书卷气。正文行高 1.9、字号 16px,在移动端自适应降至 15px,保证窄屏下的可读性。
用户消息与 AI 消息的圆角采用"不对称"设计:AI 气泡 border-top-left-radius: 4px,用户气泡 border-top-right-radius: 4px。这微小的不对称让气泡方向感清晰,一眼能分辨谁在说、谁在接。
5.3 接龙卡片的"高光时刻"
当 AI 返回 JSON 后,前端渲染出本项目最核心的视觉组件——诗词卡片。它在气泡内部以垂直布局呈现:
- 诗句:
24px大字、letter-spacing: 3px的字距拉开、#f5e6c4的暖白配金色微光,一句诗赫然立于卡片顶端,如宣纸上的墨宝; - 标签行:金色描边的"下句接「花」"标签,配合冷蓝描边的"原创/出处"标签,一暖一冷、一主一辅,信息层级一目了然;
- 释义:
13px的#a89b82浅色小字,如画卷边角的小楷题跋,克制而不喧宾夺主。
这三层结构自上而下形成了"冲击—引导—回味"的阅读节奏:先被诗句打动,再被接字吸引,最后在释义中慢慢品咂。
5.4 交互反馈的完整闭环
好的界面,反馈要环环相扣。我设计了三个关键反馈节点:
输入节点:<textarea> 自动增高(height: auto 后取 scrollHeight),键入时输入框如书信缓缓展开;支持 Enter 发送、Shift+Enter 换行。
生成节点:AI “思考"期间,显示由三个小金点组成的打字动画,用 blink 关键帧错落闪烁,暗示"诗友正在酝酿佳句”。
输出节点:流式字符逐字追加,聊天容器以 scroll-behavior: smooth 平滑跟随底部;新消息入场时带有 fadeIn(上浮+淡入)动画,让每一次对诗都有"翻开新页"的仪式感。
5.5 响应式适配
通过 max-width: 760px 的限制,桌面端呈现居中"卷轴"式布局;在 max-width: 560px 的媒体查询下,应用圆角归零、气泡最大宽度放宽至 88%、标题字号与字距收缩——确保在手机上,一手即可握持对诗。
六、工程细节与踩坑实录
一个项目的价值,很大程度藏在那些"看不见的细节"里。以下是几个值得记录的工程细节。
6.1 file:// 协议下的跨域泥潭
最初我把页面打包好,直接双击 index.html 发给朋友测试,结果 AI 毫无反应,控制台报出一串 CORS 错误。这是因为浏览器在 file:// 协议下对跨域请求有着更严格的限制。
解决办法并不是修改代码,而是"换一种打开方式":使用静态服务器。我给用户提供的启动方式有两种——python3 -m http.server 8080 一键起服后访问 http://localhost:8080,或直接双击文件(仅在允许跨域的环境下可用)。这个问题被写进了 README 的常见问题章节,避免后来者踩同样的坑。
6.2 思考区(reasoning)与内容区的剥离
在调试接口时我发现,DeepSeek 这类模型在生成过程中会先输出一段 reasoning_content(思考过程),再输出真正的 content(答案内容),两者都出现在 SSE 流的 delta 字段中,只是字段名不同。
如果前端把 delta 整体视为内容,思考过程就会"污染"页面。正确做法是只取 delta.content,对 delta.reasoning_content 视而不见:
const piece = choices[0]?.delta?.content || "";
同时,我在 CHAT_CONFIG 中保留了 thinking_budget: 2048 参数。这个"思考预算"让模型可以对诗斟酌再三,质量与响应速度之间取得理想平衡。
6.3 兜底策略:宁可不美,不可报错
大模型不是数据库,它总有"脱轨"的时候。我在 sendMessage 的完整流程里埋设了多层兜底:
- 流式为空 → 显示"(AI 未返回内容,请稍后再试)";
extractJson解析失败 → 直接展示原文,不阻塞对话;- 网络异常 / HTTP 非 200 → 捕获异常,在气泡内以红色小字展示错误摘要,同时保留控制台完整堆栈。
这套设计哲学可以概括为一句:把意外当成预期来对待。界面永远有路可走,用户永远知道发生了什么。
6.4 状态的原子化管理
isStreaming 布尔值守护着输入口:请求期间发送按钮禁用、sendMessage 直接 return,从根源上杜绝了"连点发送导致请求混乱"的竞态问题。流结束后的 finally 分支统一恢复界面状态,保证无论成功、失败还是中途异常,UI 都必然回到可用态。
七、端到端测试:让机器真正"对诗"
好酒需开坛,好诗需对吟。写完代码只是开始,我决定用自动化测试做一次真实的"对诗验证"。
环境是一个无头浏览器(Chromium),通过 Playwright 驱动整个流程:访问页面 → 输入"床前明月光" → 点击"吟诗" → 等待流式动画结束 → 断言卡片渲染结果。
await page.fill('#input', '床前明月光');
await page.click('#send');
await page.waitForFunction(() =>
    document.getElementById('typing').classList.contains('hidden'),
    { timeout: 90000 });
const cardCount = await page.locator('.poem-card').count();
第一次运行的结果让我兴奋不已:
诗词卡片数: 1
诗句: 光摇银海眩生花
标签: [ '下句接「花」', '原创' ]
释义: 月光如银海摇曳,波光潋滟令人目眩。
错误: 无
“床前明月光"对"光摇银海眩生花”——不仅工整扣住了"光"字,而且意境层层递进,从室内的一缕月色,写到银海般摇荡的月光。更妙的是,模型还贴心地标注了"下句接「花」",仿佛在邀请我继续这场文字游戏。
这行命令的背后,其实是一次完整的真实 API 调用,而非任何 Mock。它证明了:提示词约束生效、SSE 解析正确、JSON 容错到位、卡片渲染无误——整条流水线从浏览器到模型再到浏览器,畅通无阻。
八、发布与部署
8.1 文档的艺术
一个没有文档的项目是没有"售后"的。我专门编写了 README,覆盖了五个维度:
- 项目定位:一句话说清"是什么";
- 快速开始:两种打开方式,三分钟跑起来;
- 接口配置:
API_URL、AUTH_TOKEN、模型参数全部以表格呈现; - 格式规范:JSON 返回结构的字段说明与示例;
- 常见问题:把踩过的
file://跨域坑、卡片不渲染的兜底逻辑答疑预置其中。
文档的价值,不在于长,而在于"别人照着做,能不能成功"。README 的每一条,都是从真实踩坑中提炼的。
8.2 版本管理与远程托管
我把项目托管到了 GitCode/AtomGit 平台,遵循标准的 Git 工作流:git init → git add → git commit → git push。分支统一为 main,提交信息采用"动宾结构 + 结果"的规范写法,例如:
添加诗词接龙AI对话项目:JSON结构化返回格式与README文档
8.3 安全意识的补课
这个项目最需要警惕的,是令牌(Token)泄露问题。当前 AUTH_TOKEN 直接明文写在 script.js 中,这在个人学习与内网演示场景下尚可接受,但一旦公网部署,等于把"自家钥匙"挂在了门口。
我在 README 中专门以"⚠️ 安全提示"的形式强调了这一点,并给出两条演进建议:
- 后端代理方案:把请求转发到一个极简服务端(如一份几十行的 Node/Flask 代码),令牌只存在于服务端环境变量中。
- 短期令牌轮换:若坚持前端直连,则每次发布前更换令牌,并缩短令牌有效期。
安全意识不是"上线前最后一分钟的事",而应该成为每次代码提交前的肌肉记忆。
九、复盘与展望
9.1 项目的"得"
回望整个开发过程,这个项目带给我最深的三点收获:
第一,流式协议没那么神秘。 亲手用 ReadableStream 解析一遍 SSE,才真正理解了"流"的本质——它不是一段完整的数据,而是一条不断流淌的河。处理分片、维护缓冲、识别终止标记,这些功夫在日后任何流式应用中(如音视频、日志、WebSocket)都能复用。
第二,提示词工程 = 产品设计。 JSON 格式约定、字段业务语义、异常分支预设……系统提示词的每一行,背后都是对"用户体验"的思考。提示词工程师与产品经理之间,只隔着一张 PRD。
第三,兜底设计决定系统下限。 大模型输出的不确定性无法根除,但可以通过"层层降级、处处有路"的设计,把故障影响压到最低。一个"永不白屏"的界面,比一个"功能绚烂但偶发崩溃"的界面更让人信赖。
9.2 项目的"失"
坦白地说,项目仍有许多可以完善之处:
- 平仄校验缺失:目前依赖模型的格律能力,未做本地的平仄自动校验;
- 无成语/典故校验:无法确保每句诗都与历史文献可考;
- 令牌前端直连:教学场景可接受,生产场景需后端化;
- 无并发控制与速率限制:高频调用时可能被上游限流。
9.3 未来的"画"
如果把"诗词接龙 AI 对话"视作一枚种子,它其实可以长成一片森林:
- 声情并茂:接入 TTS 语音合成,让 AI 把诗句"读"给你听,配上琴箫背景乐;
- 飞花令竞技模式:限时接龙、轮流出题、积分系统,变成一款文化向小游戏;
- 诗词知识图谱:把接出的诗句关联到作者、朝代、主题标签,构建一座"掌上诗库";
- 多风格诗风:可切换"豪放派"“婉约派”"田园派"人格,让对诗风格随性而变;
- 离线缓存与历史:用 localStorage 保存每一场对诗记录,生成"今日诗单"。
十、结语:以代码为墨,与古今对谈
从最初的一个念头,到一行行代码落地,再到浏览器里那声恰到好处的"吟诗",这个项目最迷人的地方在于:它让千年之前的文字游戏,与现代最前沿的智能模型,在同一个页面上完成了握手。
你输入"床前明月光",它回你"光摇银海眩生花";你输入"欲穷千里目",它也许回你"目送归鸿手挥五弦"。技术没有温度,但文字有,意境有,文化也有。作为开发者,我们最幸运的事情之一,就是能用代码这种最理性的语言,去守护和传承一种最感性的文化。
这就是我的"码道"——以代码为墨,铺一条通往古今的诗路。
如果你也对诗词与 AI 的结合感兴趣,欢迎 clone 这个项目(http://localhost:8080 即可本地体验),在浏览器中亲手与"AI 诗友"对上一联。愿你我在代码与诗句之间,都能找到属于自己的那一片"银海"。
本文为"诗词接龙 AI 对话"项目的开发手记,项目代码同步托管于 GitCode/AtomGit,相关技术要点可在项目 README 中进一步查阅。
欢迎使用Markdown编辑器
你好! 这是你第一次使用 Markdown编辑器 所展示的欢迎页。如果你想学习如何使用Markdown编辑器, 可以仔细阅读这篇文章,了解一下Markdown的基本语法知识。
新的改变
我们对Markdown编辑器进行了一些功能拓展与语法支持,除了标准的Markdown编辑器功能,我们增加了如下几点新功能,帮助你用它写博客:
- 全新的界面设计 ,将会带来全新的写作体验;
- 在创作中心设置你喜爱的代码高亮样式,Markdown 将代码片显示选择的高亮样式 进行展示;
- 增加了 图片拖拽 功能,你可以将本地的图片直接拖拽到编辑区域直接展示;
- 全新的 KaTeX数学公式 语法;
- 增加了支持甘特图的mermaid语法1 功能;
- 增加了 多屏幕编辑 Markdown文章功能;
- 增加了 焦点写作模式、预览模式、简洁写作模式、左右区域同步滚轮设置 等功能,功能按钮位于编辑区域与预览区域中间;
- 增加了 检查列表 功能。
功能快捷键
撤销:Ctrl/Command + Z
重做:Ctrl/Command + Y
加粗:Ctrl/Command + B
斜体:Ctrl/Command + I
标题:Ctrl/Command + Shift + H
无序列表:Ctrl/Command + Shift + U
有序列表:Ctrl/Command + Shift + O
检查列表:Ctrl/Command + Shift + C
插入代码:Ctrl/Command + Shift + K
插入链接:Ctrl/Command + Shift + L
插入图片:Ctrl/Command + Shift + G
查找:Ctrl/Command + F
替换:Ctrl/Command + G
合理的创建标题,有助于目录的生成
直接输入1次#,并按下space后,将生成1级标题。
输入2次#,并按下space后,将生成2级标题。
以此类推,我们支持6级标题。有助于使用TOC语法后生成一个完美的目录。
如何改变文本的样式
强调文本 强调文本
加粗文本 加粗文本
标记文本
删除文本
引用文本
H2O is是液体。
210 运算结果是 1024.
插入链接与图片
链接: link.
图片:
带尺寸的图片:
居中的图片:
居中并且带尺寸的图片:
当然,我们为了让用户更加便捷,我们增加了图片拖拽功能。
如何插入一段漂亮的代码片
去博客设置页面,选择一款你喜欢的代码片高亮样式,下面展示同样高亮的 代码片.
// An highlighted block
var foo = 'bar';
生成一个适合你的列表
- 项目
- 项目
- 项目
- 项目
- 项目1
- 项目2
- 项目3
- 计划任务
- 完成任务
创建一个表格
一个简单的表格是这么创建的:
| 项目 | Value |
|---|---|
| 电脑 | $1600 |
| 手机 | $12 |
| 导管 | $1 |
设定内容居中、居左、居右
使用:---------:居中
使用:----------居左
使用----------:居右
| 第一列 | 第二列 | 第三列 |
|---|---|---|
| 第一列文本居中 | 第二列文本居右 | 第三列文本居左 |
SmartyPants
SmartyPants 是一个文本转换工具,主要功能是将普通的 ASCII 标点符号自动转换为更美观的印刷体标点符号。例如:
| 原始符号 | 转换后 | 说明 |
|---|---|---|
"引号" | “引号” | 直引号变弯引号 |
'单引号' | ‘单引号’ | 直单引号变弯单引号 |
-- | – | 两个连字符变短破折号 |
--- | — | 三个连字符变长破折号 |
... | … | 三个点变省略号 |
创建一个自定义列表
-
Markdown
- Text-to- HTML conversion tool Authors
- John
- Luke
如何创建一个注脚
一个具有注脚的文本。2
注释也是必不可少的
Markdown将文本转换为 HTML。
KaTeX数学公式
您可以使用渲染LaTeX数学表达式 KaTeX:
Gamma公式展示 Γ ( n ) = ( n − 1 ) ! ∀ n ∈ N \Gamma(n) = (n-1)!\quad\forall n\in\mathbb N Γ(n)=(n−1)!∀n∈N 是通过欧拉积分
Γ ( z ) = ∫ 0 ∞ t z − 1 e − t d t . \Gamma(z) = \int_0^\infty t^{z-1}e^{-t}dt\,. Γ(z)=∫0∞tz−1e−tdt.
你可以找到更多关于的信息 LaTeX 数学表达式here.
新的甘特图功能,丰富你的文章
- 关于 甘特图 语法,参考 这儿,
UML图表
可以使用UML图表进行渲染,例如下面产生的一个序列图:
- 关于 UML图表 语法,参考 这儿,
流程图
- 关于 Mermaid 语法,参考 这儿,
FLowchart流程图
我们依旧会支持flowchart.js的流程图语法:
- 关于 Flowchart流程图 语法,参考 这儿.
导出与导入
导出
如果你想尝试使用此编辑器, 你可以在此篇文章任意编辑。当你完成了一篇文章的写作, 在上方工具栏找到 文章导出 ,生成一个.md文件或者.html文件进行本地保存。
导入
如果你想加载一篇你写过的.md文件,在上方工具栏可以选择导入功能进行对应扩展名的文件导入,
继续你的创作。
注脚的解释 ↩︎

汇聚全球AI编程工具,助力开发者即刻编程。
更多推荐

 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)