
码道:从需求到上线,用纯前端打造「诗词飞花令」AI 对诗游戏
码道:从需求到上线,用纯前端打造「诗词飞花令」AI 对诗游戏
本文记录了我使用华为云 CodeArts 码道,从零开始完成「诗词飞花令 AI 对诗」项目的完整过程。从最初的念头发散,到玩法设计、技术选型、AI 接口接入、流式解析、提示词工程,再到踩坑、返工、最终上线的全链路实践。项目已开源于 AtomGit,纯前端、零依赖、单文件即可运行,欢迎体验。
仓库地址:https://atomgit.com/gcw_OeN3bheP/shigefeihualingai.git
一、缘起:一个念头的落地
一直想做一个「既有文化底蕴,又能真正用到 AI 大模型」的小项目。市面上的 AI 对话应用大多是「你问我答」的助手形态,做得再好也只是个更强的搜索引擎。我想要的是:把 AI 放进一个有规则、有胜负、有美感的场景里,让它不再只是个陪聊工具,而是能和用户「博弈」的对手。
思考方向时其实考虑过好几个备选:AI 围棋死活题讲解、AI 成语接龙、AI 诗词解读。围棋太专业,得引入大量外部资料;成语接龙太短平快,一局十几秒就结束;诗词解读偏单向输出,缺少「对战感」。横向比较下来,飞花令是平衡感最好的一个:文化底蕴足够深,规则简单好上手,而且天然是一个「对抗 + 裁判」的双层结构。
想到「飞花令」。
飞花令源自古人的酒宴雅戏,行令人轮流吟诵含有特定字的诗句,接不上者罚酒。它天然具备「回合制」「规则明确」「有裁判需求」三个特点,简直是 AI 应用的最佳剧本:出题人可以是 AI,玩家是用户,裁判也可以是 AI。一人分饰两角:既是守擂者,又是判官。
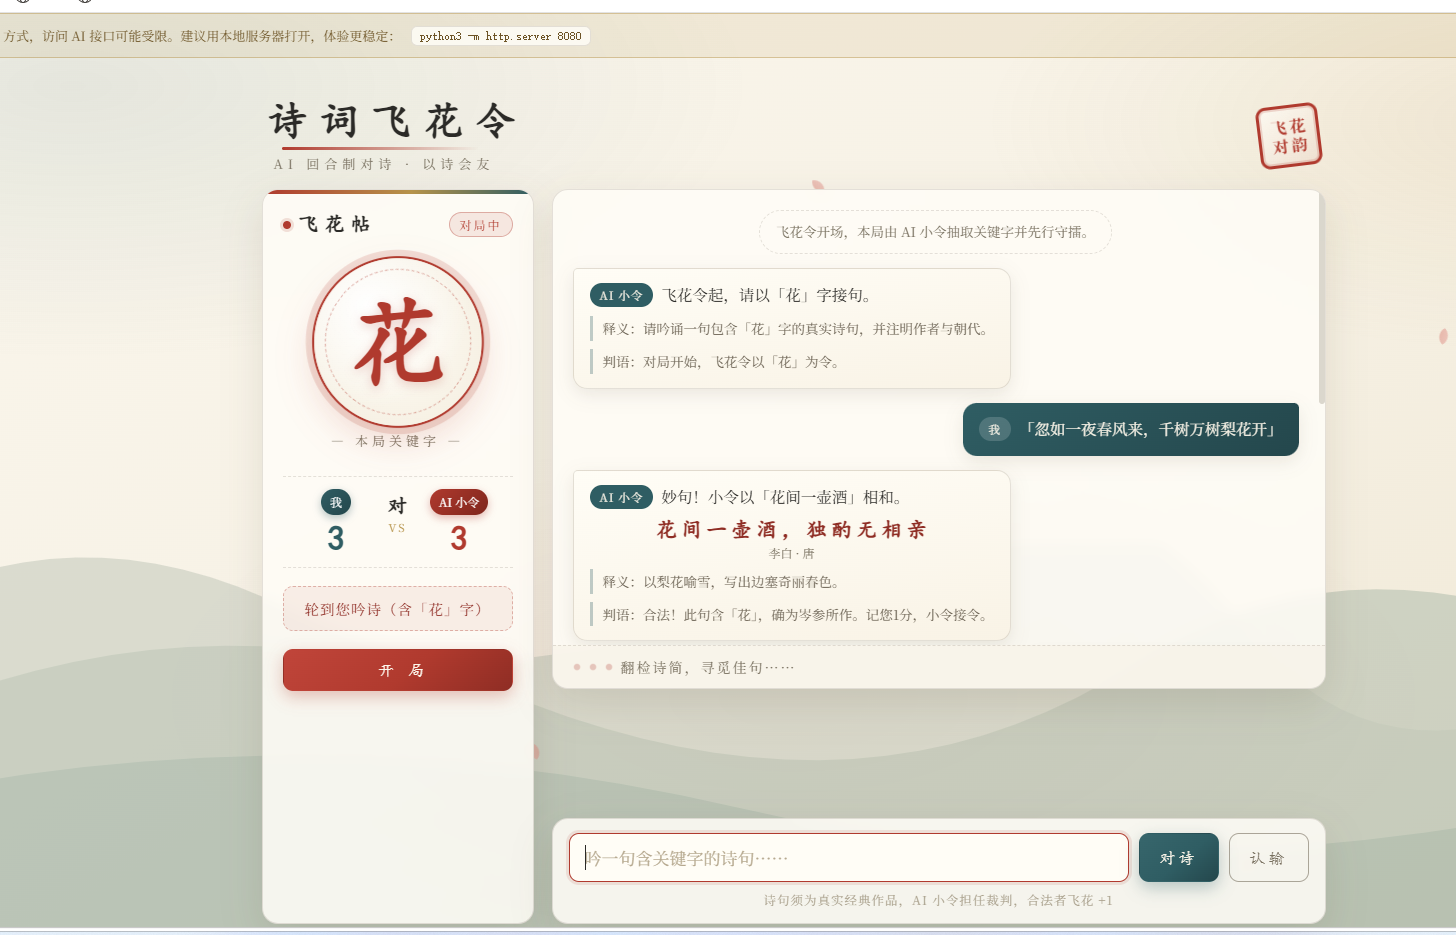
于是,「诗词飞花令 AI 对诗」这个项目诞生了。目标很朴素:用户在浏览器里打开一个页面,点一下「开局」,AI 抽出一个关键字(比如「花」),双方轮流吟诵含「花」字的真实诗句,AI 判定合法性并计分,最后决出胜负。全程零安装、零后端,打开即玩。它既是一个可以拿出去给朋友玩的小游戏,也是一份可读可改、结构清晰的技术演示——后续无论是做教学、做演讲,还是继续在上面长新功能,都有足够的余量。
二、需求拆解:把玩法翻译成技术语言
任何项目开工前,先把需求拆清楚。我把这个「小游戏」拆成了五个模块:
- 游戏编排:开局 → 轮流出招 → 终局,一个完整的状态机。
- AI 出题:随机抽取一个飞花令常用字,作为本局关键字。
- AI 裁判:判定玩家诗句是否包含关键字、是否为真实可考的作品,并给出判词。
- AI 对手:判定合法后,AI 自己也要接一句诗,保持对局进行下去。
- 计分与胜负:双方各累积飞花数,认输或词穷时由 AI 对比分数宣布结果。
这里有个关键的设计决策:裁判和对手是同一个 AI。它既要公正地裁判你,又要聪明地接你的招。为了让这个「双重身份」不露馅,我在提示词里给它立了人设——网名「小令」,谈吐古雅、不偏不倚。
再往细处拆分,规则上还有几个细节值得敲定:
- 关键字池:从「花、月、春、风、雪、山、水、云、雨、夜、酒、人、心、情、梦」这些古诗词出现频率最高的字里随机抽取,保证每局都有新意。
- 合法性判定:必须同时满足「含关键字」和「真实可考」两条。用户说了一句白话,裁判要能毫不留情地判负,并解释原因:『飞花令须为历代真实诗词佳句,而非即兴白话。』这既考验模型的诗词知识,也考验它「敢说真话」的能力。
- 计分口径:玩家合法一句记 1 分,AI 接龙一句也记 1 分,比分必须如实反映历史,不许凭空加减。模型偶尔会记错分,所以前端还要以协议里的
score字段为准进行二次校准。 - 认输与死局:任何一方都能认输;如果 AI 实在接不上来,会给出合理的死局结论,而不是无限循环。
这些细节看起来琐碎,但它们决定了游戏「能不能玩得下去」——空有华丽界面而没有严谨规则,三局就能把用户劝退。
三、技术选型:拒绝框架,回归本质
技术选型上,我几乎没有犹豫:纯 HTML5 + CSS3 + JavaScript,零框架、零依赖、零构建。
原因有三:
- 这类单页小游戏,用原生三件套完全够用,引入 React/Vue 反而是负担。
- 零构建意味着任何环境都能跑:本地双击、静态服务器、甚至拷给别人打开都行。
- 代码可控、百来行核心逻辑,方便后续讲解和修改。
项目最初的形态是三个文件分而治之:index.html 负责结构,css/style.css 负责样式,js/app.js 负责逻辑,另有一个 js/config.js 存放 AI 接口配置。结构清晰,各司其职。
四、AI 大脑:接入 DeepSeek-V4-Flash
AI 能力的接入是项目的核心。我使用了 GitCode AI 提供的 OpenAI 兼容接口,模型为 deepseek-ai/DeepSeek-V4-Flash,它是一个带思考能力(reasoning)的模型,这也决定了后边流式解析的复杂程度。
官方给了 Python 参考实现,用的是 requests 库的流式请求:
response = requests.post(API_URL, headers=headers, json=payload, stream=True)
for line in response.iter_lines():
    if not line.startswith(b"data:"):
        continue
    if line.strip() in (b"data:[DONE]", b"data: [DONE]"):
        return
    yield json.loads(line.decode("utf-8").lstrip("data:").rstrip("/n"))
而前端是 JavaScript,没有 requests,也没有 iter_lines。转换的思路是:
requests.post(...)→fetch(url, {method: 'POST', headers, body})response.iter_lines()→ 用ReadableStream的getReader()逐块读取字节,再由TextDecoder解码。- 逐行遍历 → 维护一个缓冲字符串,按换行符切分成行数组,逐行处理,最后把残留的尾部再处理一次。
参数层面,max_tokens 限制生成长度,temperature 控制随机性,top_p 做核采样,frequency_penalty 抑制重复。还有一个特别的 thinking_budget——这是 DeepSeek 思考模型的「思考预算」,模型会先花一部分 token 进行推理,再产出最终回答。
鉴权方式与 OpenAI 一致:请求头带上 Authorization: Bearer <token> 即可。我把这些参数集中收敛到一个 AI_CONFIG 配置对象里,URL、模型名、令牌、采样参数一目了然,将来换模型或者换供应商,只需改这一个对象,其余代码完全不动。这也是工程上的一个小习惯:把「会变的东西」和「不变的逻辑」分开。
这里还要提一个前端特有的考量:CORS。好在 GitCode AI 的接口已经在响应头里返回了 Access-Control-Allow-*,允许浏览器直接跨域调用,否则纯前端方案就要折中——要么加代理,要么放弃直连。我在开工第一天就用 curl 验证了这一点,算是提前排掉了一个大雷。
五、硬核部分:SSE 流式解析
接口返回的是标准的 SSE(Server-Sent Events)流,每一行的格式是:
data: {"choices":[{"delta":{"content":"你","reasoning_content":"..."}}]}
结束标记是 data: [DONE]。
这里有个很容易踩的坑:DeepSeek-V4-Flash 是思考模型,流式响应的前段会被 reasoning_content 占满——也就是模型的「内心独白」。如果你只取 content 字段,前几秒会一直收到空字符串,用户会以为卡死了。我做了两件事:
- 只累积
delta.content,把reasoning_content忽略掉,避免把「思考过程」当正文给用户看。 - 在等待期间给用户一个「正在斟酌」的动态提示,文案每隔 2 秒轮换:「小令凝神沉思……」「斟字酌句,推敲平仄……」,让等待不再焦虑。
用 ReadableStream 逐行解析的核心代码长这样(节选):
const reader = resp.body.getReader();
const decoder = new TextDecoder("utf-8");
let buffer = "";
while (true) {
  const { value, done } = await reader.read();
  if (done) break;
  buffer += decoder.decode(value, { stream: true });
  const lines = buffer.split("\n");
  buffer = lines.pop();
  for (const line of lines) {
    const piece = parseSseLine(line);
    if (piece === "__DONE__") return;
    if (piece) full += piece;
  }
}
顺带对比一下「流式」和「非流式」的取舍。非流式的实现简单到令人发指:发一个请求,等整段 JSON 回来,解析收工。但副作用是两个:第一,用户的体感是「点了按钮,屏幕安静几秒,然后啪地一下全部出现」,非常像传统网页的表单提交;第二,思考模型这玩意儿,上下文越长越想得久,最坏情况下用户会盯着一个空荡荡的页面干等几十秒。流式虽然解析逻辑复杂一些,换来的是「有来有回」的对话节奏,哪怕正文还没生成,滚动条和交互也始终让用户确信「系统活着」。在一个以「文本节奏感」为核心的诗词游戏里,这个体验差异是决定性的。
另一个值得一提的细节是:SSE 分包是任意的,一个 JSON 可能被切成几片,所以缓冲区的管理必须严谨——切完完整行之后,最后一块不完整的残留要保留到下轮读取时拼接。这个「留尾巴」的动作,写的时候很容易漏掉,漏掉的症状是偶发性的乱码和解析失败,特别难排查。
六、灵魂:系统提示词与 JSON 协议
这是整个项目最核心的工程决策:让 AI 每轮只返回一个严格定义的 JSON 对象。
为什么不直接让它返回文字?因为飞花令有强结构化的数据需求:关键字、诗句、作者、朝代、是否合法、判词、释义、比分、是否轮到玩家……如果让 AI 自由发挥文字,前端就得靠正则去猜,既脆弱又丑陋。让 AI 输出 JSON,前端把数据「喂」进对应的 UI 部件里,每个字段各归其位,简直是天然默契。
我设计的 JSON 协议如下:
{
  "action": "start | judge | opponent_poem | game_over | help",
  "keyword": "花",
  "poem": "花落知多少",
  "author": "孟浩然",
  "dynasty": "唐",
  "valid": true,
  "reason": "『花间一壶酒』出自李白《月下独酌》,含『花』字,合法。",
  "explanation": "春夜风雨后,花凋谢了多少,言春光易逝。",
  "message": "妙哉!且听我接——花落知多少。",
  "score": { "user": 1, "ai": 1 },
  "next_turn": true
}
为了让模型「乖乖听话」,系统提示词里写明了三件事:
- 人设与规则:你是裁判兼对手「小令」,精通中国古典诗词,判定诗句真伪与是否含关键字,计分规则白纸黑字。
- 硬性约束:每轮只允许输出一个合法 JSON 对象,禁止 Markdown 代码块、禁止 ```````json ````包裹、禁止任何 JSON 以外的文字。
- 字段说明:逐字段解释含义,特别是
action的枚举取值和每种取值下应填什么。
思想是:把模型当做一个「调用后端接口」的函数来用。只要协议清晰、约束严格,模型的行为就是可预测的。
那么,action 这个字段是怎么驱动前端的?我维护了一个非常直观的分支:
start:开局。面板亮起关键字,计分板归零,回合提示切到「轮到您吟诗」,输入框解锁——游戏正式进入对局状态。judge:裁判。这是最核心的动作。valid: true且带上了接龙的poem,前端就把玩家诗句、AI 接龙句、作者朝代完整渲染出来,比分更新;valid: false则把判词以醒目的方式呈现,并引导玩家重说。game_over:终局。比对score里的双方分数,宣布胜负或和局,按钮回到初始状态。opponent_poem/help:补充性动作,分别用于状态同步和答疑。
前端对「渲染」和「状态迁移」做了清晰的分离:handleAssistant 只干三件事——把数据喂给气泡组件、更新计分板与关键字、依据 action 迁移状态机。这样一来,哪怕以后要支持多语言显示、或者改成游戏大厅模式,改起来都有一条清晰的路径。
当然,也不能 100% 信任模型的输出。所以前端准备了容错解析:剥离开头的代码块标记、截取从第一个 { 到最后一个 } 之间的内容再 JSON.parse;如果还解析失败,就降级为普通文本气泡展示原文,绝不让页面崩溃。
实测效果很好。我做了四个典型场景的联调:开局、裁判合法句、裁判非法句、认输终局,模型全部按照协议返回了结构完整、语义准确的 JSON。最让我惊喜的是这种「接龙」质量——玩家说「花间一壶酒」,AI 返回判词「出自李白《月下独酌》,合法」,随即接龙「花落知多少(孟浩然·唐)」,并给出释义,比分同步为 1:1,逻辑缜密。
七、交互设计:游戏状态机与对话历史
游戏本质上是一个状态机:
- 待开局:只能点「开局」。
- 对局中:允许输入诗句、发送、认输。
- 请求中:所有操作锁定,等 AI 返回。
- 已终局:回到待开局,可重新开始。
前端用一个 state 对象记录 keyword、userScore、aiScore、started、running、history,每次 AI 返回后统一刷新计分板、关键字展示与回合提示。
对话历史的管理也值得一提。为了让裁判不出戏,每轮请求需要携带之前的上下文。我把历史压缩成「user / assistant」交替的干净文本(用户诗句、AI 的 JSON 转录),并限制最近 40 条,避免上下文无限膨胀、token 浪费。
八、水墨古风的 UI 设计
诗与酒,宜古色古香。视觉上我选择了「水墨古风」路线,目标是不俗气、不土味,做出「高级的新中式感」。
配色上用了朱砂红、青黛、赭石、淡金这组传统中国画颜料色系,背景是暖米色的宣纸质感,配上多层渐变晕染和淡淡的青绿远山剪影。我还在页面里加入了 8 片缓缓飘落的桃花瓣,为对诗场景平添了几分「落花时节又逢君」的意境。
布局采用了「飞花帖」式的左栏信息面板:关键字圆盘居中,用朱砂红双圈描边、内嵌一圈缓缓旋转的虚线金环,象一枚古印;计分板左右对称排布「我」与「AI 小令」的战绩;回合提示用朱笔勾边的提示框标出当前轮到谁。
对话气泡也做了差异化设计:AI 的回复是暖宣纸底的左对齐气泡,玩家的是青黛渐变底的右对齐气泡。判诗卡上,诗句用大字居中、朱红着色,作者与朝代以小字题款紧随其后,释义与判语则以「典籍批注」的样式附在底部——左竖线引文,古意盎然。
字体是国风设计里最容易翻车的环节。我没有依赖任何云字体(工信部环境下网络字体加载既不稳也慢),而是用了一套本地字体回退链:「楷体(Kaiti)→ 宋体 → 通用衬线字体」。标题走楷书的路子,正文走宋体,让「看字」这件事本身就带着墨香。印章、飞花帖、花瓣这些装饰元素也全部用 CSS 或内联 SVG 实现,没有一张图片资源——既保证单文件的初衷,也让整个包体只有几十 KB,一秒加载。
动画上我克制地用了三处:关键字圆盘弹出时有一个弹性回弹的 pop 效果;气泡入场有一个 rise 上浮淡入;飘落的花瓣匀速旋转翻飞。这些动效都不超过 600 毫秒,目的只是「点活」静态画面,绝不喧宾夺主。整体视觉评审下来,核心信息(关键字、比分、回合提示)在任意一屏都处于最显眼的位置——好看的前提是先好懂。
九、踩坑记录:从「无法开局」到单文件架构
这个项目最曲折的一段,是在交付后收到用户反馈:「页面不好看,而且无法开局」。
排查良久,最后发现:用户在一个无法加载相对路径外部资源的环境里打开了页面。css/style.css 和 js/app.js 都没有被加载,于是页面退化成黑白裸 HTML——我看见的调试截图正是如此:纯白背景、黑色大标题、灰色按钮,跟「水墨古风」毫不相干,JS 自然也没跑起来,「开局」形同虚设。
这个教训很深刻:你精心设计的样式和逻辑,只要有一个外部文件没被加载,一切归零。
排查的过程也算一波三折。最初收到反馈时,我第一反应是「代码有 bug」,先在新分支上翻了半天游戏逻辑;接着怀疑是接口鉴权过期,又用 curl 重新打了一遍接口,发现一切正常;再怀疑是浏览器缓存,让用户强制刷新也无济于事。直到用户把现场截图发过来——黑白裸页面瞬间让我意识到问题不在代码,而在资源的加载方式。用浏览器开发者工具一看,果然,页面请求的所有相对路径资源全部失败。问题的根因找到了。
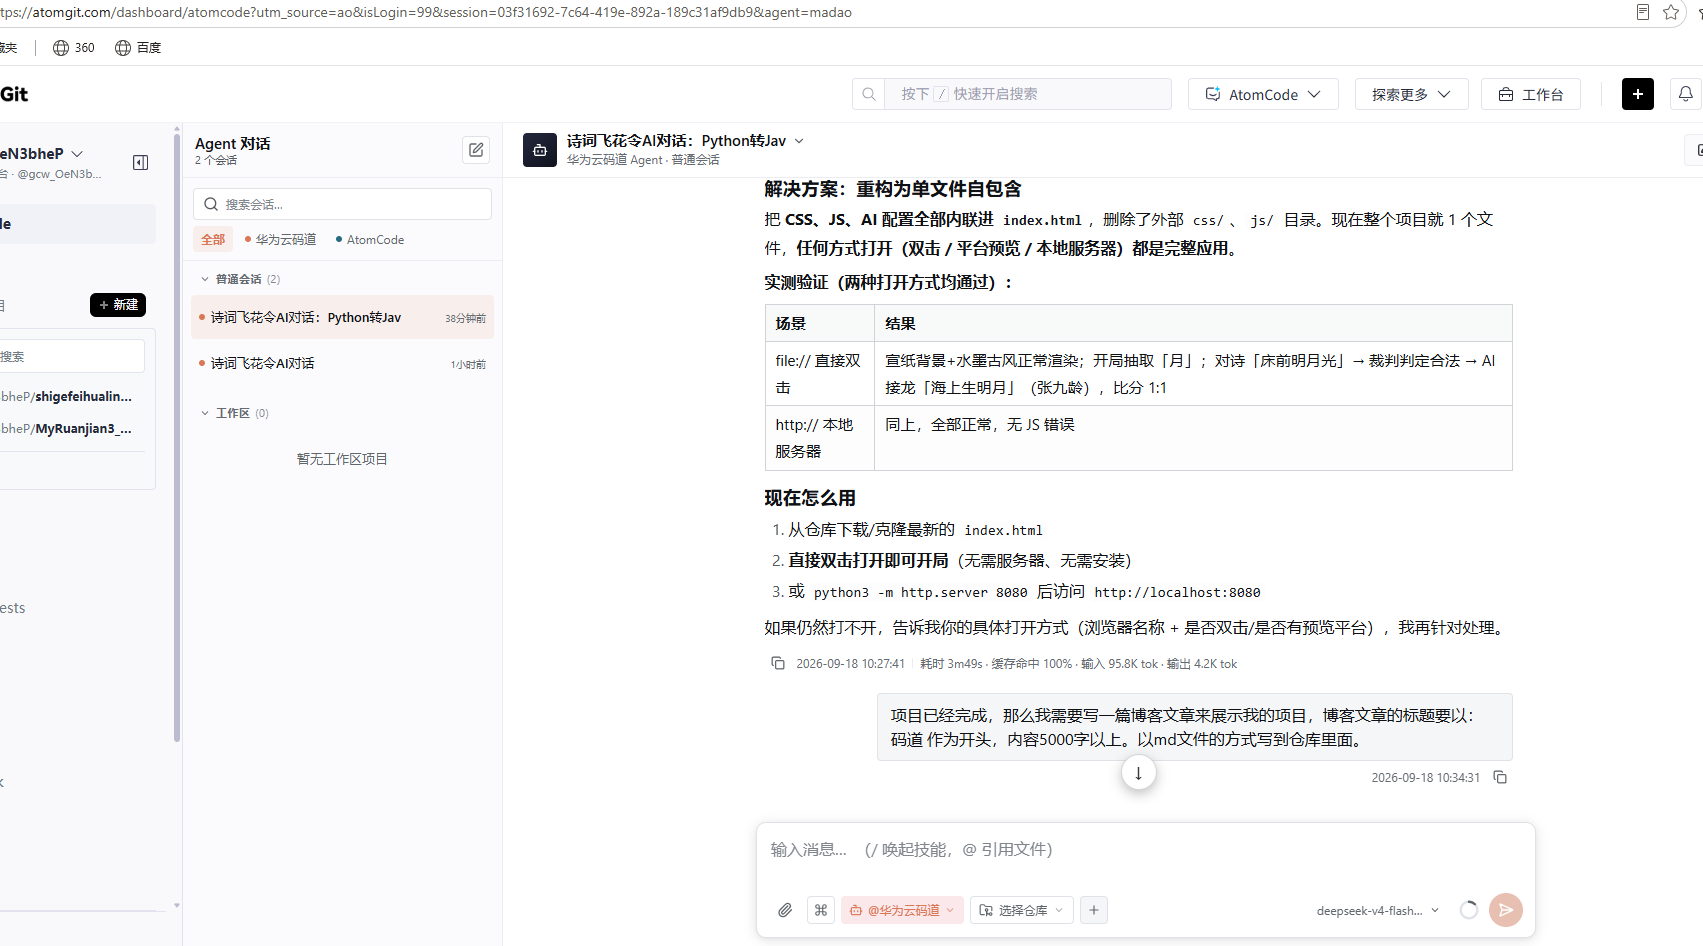
解决方案是釜底抽薪:把 CSS 和 JS 全部内联进 index.html,做成一个自包含的单文件。整个应用变成一个文件,不再依赖任何相对路径资源。任何环境打开,样式、逻辑、AI 配置都在,必然是完整的水墨古风页面,必然是可用可玩的。
重构后我做了双协议回归测试:file://(模拟双击打开)和 http://(模拟本地服务器)两条路径都跑通——宣纸背景正常渲染,开局成功抽出关键字,对诗流程 AI 正常裁判,无任何 JS 错误。这次重构还带来一个意外收获:项目结构从四处散落的四个文件,浓缩成了一个抽屉里的一件「成品」,拷贝、分发、演示都变得极其简单。这个改动是这次交付中最关键的一步。
十、测试与验证:眼见为实
代码写出来不算数,跑通了才算数。我的验证分三层:
第一层:接口连通性。 用 curl 直接压测 AI 接口,确认鉴权通过、模型响应正常、SSE 流格式符合预期,并检查了 CORS 响应头,确认浏览器可以跨域直连。
第二层:协议正确性。 写了一个 Node 脚本,模拟前端逻辑,用真实的 API 跑四个典型对局场景:
| 场景 | 输入 | 模型行为 |
|---|---|---|
| 开局 | 「请抽取关键字开局」 | 返回 start,抽取「月」,比分归零 |
| 裁判·合法 | 「花间一壶酒」 | valid: true,注明出处,接龙「花落知多少」,比分 1:1 |
| 裁判·非法 | 「今天月亮真漂亮」 | valid: false,判词指出非真实作品,请重吟 |
| 终局 | 「我认输」 | 返回 game_over,对比比分宣布胜负 |
四个场景全部通过,模型对协议的理解完全符合设计。
第三层:端到端 UI 测试。 用 Playwright 驱动无头浏览器,模拟真实用户操作:打开页面 → 点击开局 → 等待关键字 → 输入诗句 → 点击对诗 → 验证 AI 裁判回复与计分板更新。同时通过浏览器自动化复现 file:// 场景,确保双击文件也能完成整局对弈。
十一、使用与部署:打开即玩
最终交付的是一个零门槛的应用:
# 方式一:直接双击 index.html(推荐,单文件自包含)
# 方式二:本地服务器
python3 -m http.server 8080
# 浏览器访问 http://localhost:8080
AI 配置集中在文件尾部的 AI_CONFIG 对象中,改一行即可切换模型或令牌。注意:前端直连接口意味着令牌对用户可见,本项目定位于个人学习与演示,生产环境请务必通过自己的后端代理转发密钥。
十二、不足与展望
坦白讲,这个项目还有不少可以打磨的地方:
- 诗句去重不够严格:当前靠模型自觉避免重复吟诵,偶尔仍有重复。更稳妥的方案是前端维护一个「已出现诗句」的本地集合,在发送给裁判之前先做一次硬校验。
- 无持久化:刷新页面对局即重置,后续可加入 localStorage 存档与战报,让玩家能翻看过去几局的精彩对句。
- 题库增强:可以让裁判在禁止重复之外,增加「作者朝代问答」的附加彩蛋环节——玩家吟诗后 AI 追问作者出处,答对额外加分,让游戏更有层次。
- 难度分级:初级只要求「含关键字且真实」,高级则限定朝代或限定诗体(如只许五言、只许唐句),挑战性完全不同。
- 多人与观战模式:把「人机对弈」扩展成「观战大厅」,AI 同时担任两位 AI 棋手的裁判,玩家围观并竞猜比分,社交属性一下就上来了。
- 国际化:界面与判词目前仅支持中文,飞花令本就是中文独有的雅戏,也可设计英文对联玩法。
每一项单拎出来都不复杂,难的是如何在不破坏「单文件、零依赖」这个红线的同时优雅地加上去。这也正是开源和持续迭代的乐趣所在。
结语:一局飞花令的启示
回看这个项目,最值得记录的不是代码量,而是三件事:
第一,把大模型当成函数用。当你想让 AI 融入一个有规则的系统时,强制结构化输出(JSON 协议)比自由对话可靠得多。
第二,单文件是一种被低估的工程美德。少一个外部依赖,就少一种失败的可能。
第三,测试要贴近用户真实环境。我在标准服务器下测了无数遍,最后却是一个用户随手打开的方式暴露了致命问题。
飞花令里有一句诗,特别契合这个项目给我的感受:「花径不曾缘客扫,蓬门今始为君开。」技术它不是目的,让一个念头长出骨头、血肉与美感,才是做项目最快乐的地方。这局飞花令,我先执字,你且接招。

汇聚全球AI编程工具,助力开发者即刻编程。
更多推荐

 3
 0
- 0


 已为社区贡献1条内容

所有评论(0)