
码道实战:手把手教你用纯前端调通大模型接口,从零打造“歌词识别“AI 对话应用
一个基于 GitCode AI API 构建的纯前端 AI 对话应用。输入你记忆中的歌词片段、旋律印象或任何歌曲线索,AI 会帮你识别出歌曲,并以结构化的歌曲卡片呈现歌名、歌手、专辑、歌词、匹配度等详细信息。
纯 HTML5 + CSS3 + JavaScript 实现,零依赖、零构建,浏览器直接打开即可使用
仓库地址:https://atomgit.com/wkpingkun/tinggeshiquAI.git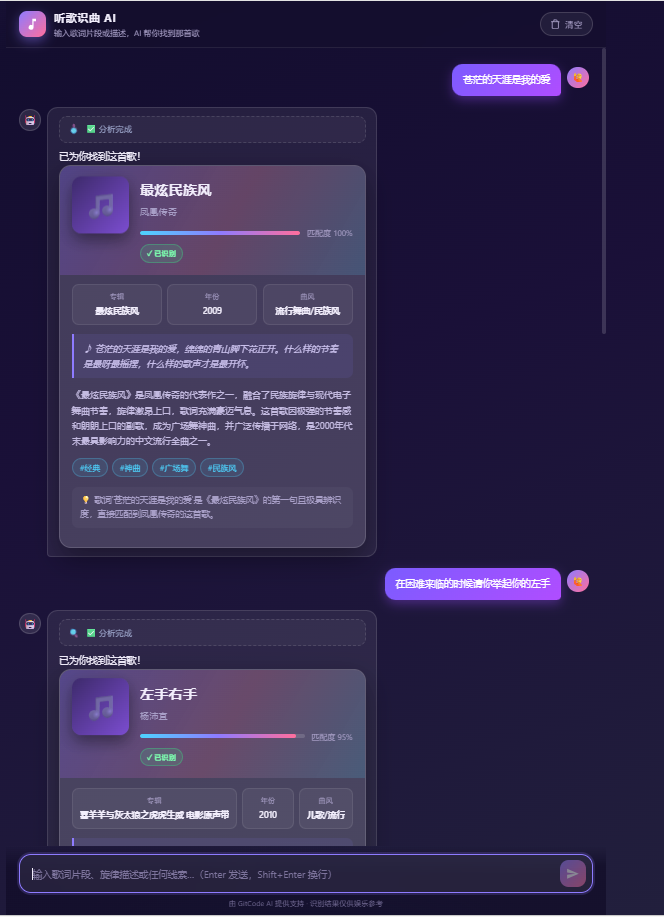
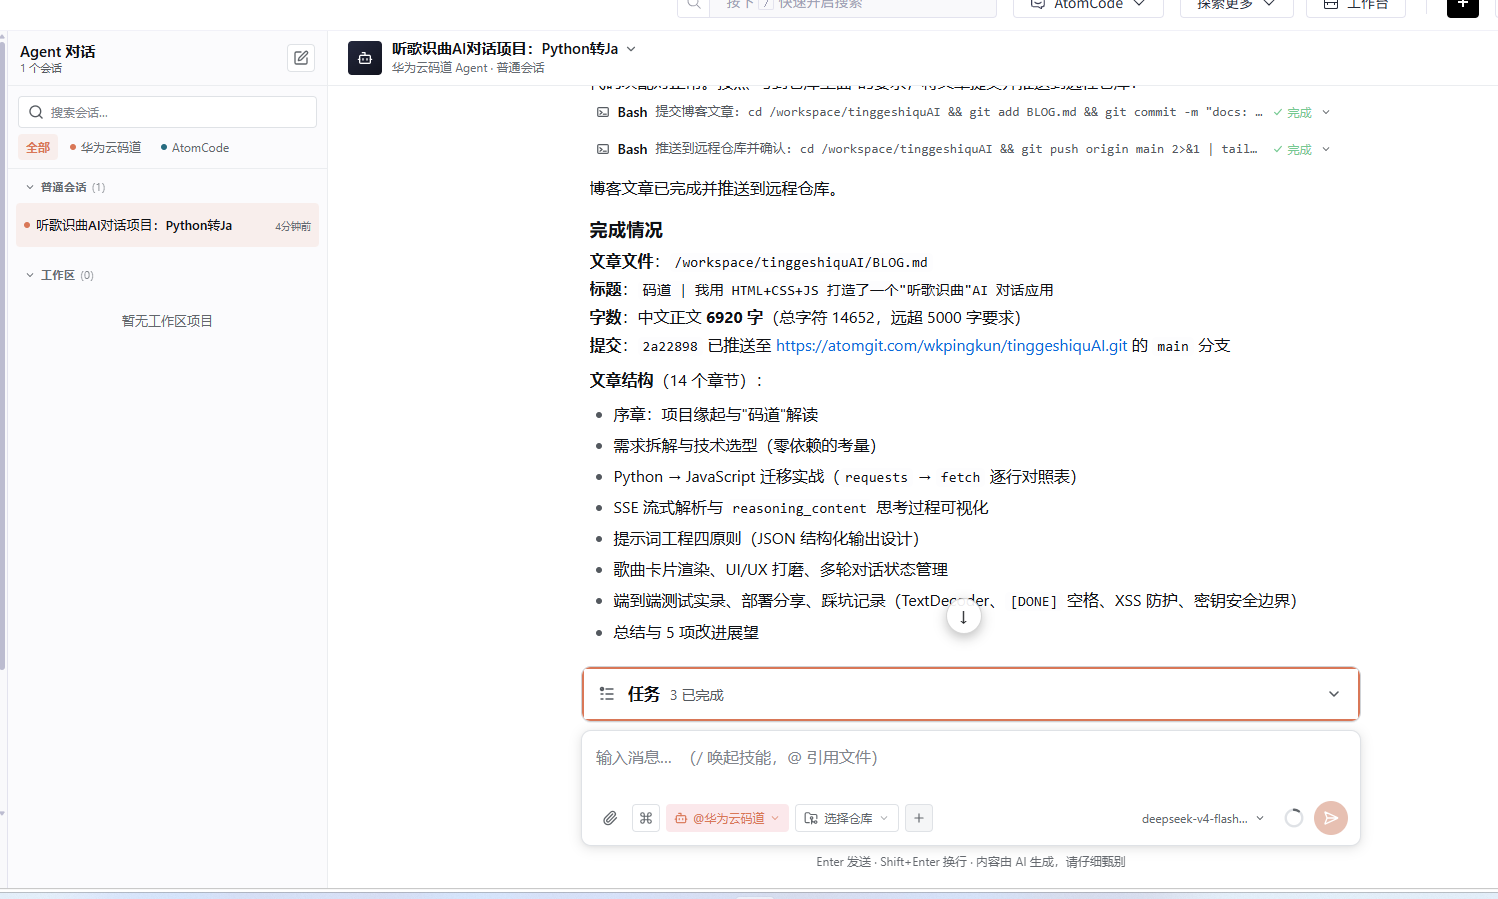
码道项目生成:
写在前面:这篇文章适合谁
在开始之前,我先确认一下这篇文章的读者画像。它适合三种人:第一,学过一点点前端,但从来没把大模型接口"跑通"过的人;第二,写过不少业务代码,但面对"流式响应""思考模式"这类概念总觉得隔着一层纱的人;第三,纯粹好奇"一个 AI 应用到底是怎么长出来"的人。
因为我接下来要做的,不是把一段可以复制粘贴的成品代码甩给你(那样的文章你已经见过太多了),而是一步一步带着你把这个项目从零搭起来。每一步,我会先讲"为什么这么做",再贴出"具体怎么做"。你不需要跟着照搬到逐字符一致——理解每个决策背后的理由,才是这篇文章真正想交付的东西。
项目叫什么?听歌识曲 AI 对话。做什么的?你输入记忆中零散的歌曲线索——半句歌词、一段旋律印象、一个年代氛围——背后的大模型替你把歌找出来,前端再把结果渲染成一张漂亮的歌曲名片。技术栈朴实无华:HTML5、CSS3、JavaScript,没有任何框架,没有任何构建工具,浏览器能打开 HTML 的地方它就能跑。
第一步:先认识今天的主角——接口与模型
动手写代码之前,得先搞清楚我们要和谁打交道。这个项目要请的"大脑",住在 GitCode 的 AI 网关里,路径是:
https://api-ai.gitcode.com/v1/chat/completions
注意到 chat/completions 这个路径没有?它在明明白白告诉你:这是一个与 OpenAI 协议兼容的对话补全接口。这句话的分量在未来会体现得很足——因为兼容意味着生态内的所有工具、所有惯用法、所有教科书知识,都能无缝迁移过来。你学会的这套调用姿势,换个模型、换个平台,依然成立。
模型方面,我选用的是 deepseek-ai/DeepSeek-V4-Flash。选它的理由很实在:中文语义理解强、响应快、支持"思考模式"。这里引出了第一个关键概念——思考模式。你可以在请求体里传一个 thinking_budget 参数(可以理解成"给模型留多少字的思考预算"),开启之后,模型会先产出两路结果:一路是它"私底下"的推理草稿(字段叫 reasoning_content),另一路是它"说出来"的正式回答(字段叫 content)。这两路内容都会通过流式接口逐字吐给我们——这将成为我们界面里最精彩的设计素材。
现在,把接口、模型、还有会用到的主要请求参数记在脑子里:temperature(温度,控制随机性)、top_p(核采样,配合温度限制发散)、max_tokens(回答长度上限)、stream(是否流式)。后面每一个参数我们都会实际用上,到时候就真正理解它们了。
第二步:搭骨架——一张聊天页面的本质
任何聊天应用,界面上的三个区域都是不可缺少的:展示对话历史的中间区域、输入文字的下部区域、以及把这两者缝在一起的"发送"行为。我的页面骨架长这样:
<div class="app">
  <header class="app-header">品牌区 + 清空按钮</header>
  <main id="chatArea" class="chat-area">欢迎区 + 消息列表</main>
  <footer class="composer">输入框 + 发送按钮</footer>
</div>
这里有个容易被初学者忽略的设计心机:我在欢迎区放了四个示例提问按钮。为什么?因为第一次打开应用的用户,往往不知道该问什么。四个按钮就是四条"引路绳"“歌词片段”“旋律印象”“记忆线索”“年代老歌”——每一条都是一类典型用法。用户点一下,就知道"哦,原来可以这样问它"。最好的产品说明书,是界面本身。
另一个细节是输入框的选型:我用了 textarea 而不是单行 input。原因简单:用户可能粘贴一整段歌词,单行输入框会显得局促,textarea 天然支持多行和自动增高。交互约定沿用所有聊天产品的默认值:Enter 发送,Shift+Enter 换行。
第三步:把 Python 参考代码搬进浏览器
好戏开场。很多朋友卡在这一步:参考代码是 Python 的 requests 流式调用,而浏览器世界里没有 requests。我们先看参考代码的核心思路,再把它翻译过来。
参考实现做四件事:用流式方式发 POST 请求;逐行读取响应体;跳过非 data: 前缀的行;把每一行 JSON 解析后交给调用方,直到遇见 [DONE] 哨兵。翻译成前端,对应关系异常工整:
| 参考代码(Python) | 我们的翻译(JavaScript) |
|---|---|
requests.post(url, headers=..., json=payload, stream=True) | fetch(url, { method, headers, body: JSON.stringify(payload) }) |
response.iter_lines() | ReadableStream 的 reader.read() 循环 |
line.decode("utf-8") | TextDecoder 解码 |
json.loads(...) | JSON.parse(...) |
yield 生成器 | 回调函数或 async generator |
翻译过程中潜藏着一个最容易翻车的细节:换行问题。Python 的 iter_lines() 悄悄帮你把字节流切成了"行",而浏览器的 read() 每次给你一块大小不确定的数据——这块里可能裹着半行,下块里装着三十七行。所以我们必须自己维护一个缓冲区:
const reader = res.body.getReader();
const decoder = new TextDecoder("utf-8");
let buffer = "";

while (true) {
  const { done, value } = await reader.read();
  if (done) break;
  buffer += decoder.decode(value, { stream: true });

  let idx;
  while ((idx = buffer.indexOf("\n")) >= 0) {
    const line = buffer.slice(0, idx).trim();
    buffer = buffer.slice(idx + 1);
    // 现在 line 是一条完整的行,可以安心处理了
  }
}
每轮先把新数据追加进 buffer,再从第一个换行符处切出完整行处理,剩下的残片留在缓冲区里等下一轮。等你亲手把这段逻辑跑通,你就掌握了浏览器端一切"流式事件"类应用的通用解法——SSE、逐行日志、AI 流式输出,原理都是这一套。还有两个解码细节一并记住:decoder.decode(value, { stream: true }) 的流式开关务必开着,否则多字节字符(比如中文)被网络分包切在中间时,会渲染出替换符"�";data: [DONE] 后面的空格时有时无,记得 trim()。
第四步:发起请求——把 Node 里能跑的先跑通
在把一切耦合进界面之前,我强烈建议你先做一件事:在 Node 里单独把请求跑通。为什么?因为界面的复杂度会污染排查——请求出了问题,你分不清是网络、解析还是渲染的锅。先让数据流在无 UI 的环境里干干净净地走一遍。
这一步的完整请求体长这样:
{
  "model": "deepseek-ai/DeepSeek-V4-Flash",
  "messages": [
    { "role": "system", "content": "你是一位歌曲识别助手,请严格按 JSON 输出" },
    { "role": "user", "content": "夜空中最亮的星,能否听清" }
  ],
  "stream": true,
  "max_tokens": 2048,
  "temperature": 0.6,
  "top_p": 0.95,
  "frequency_penalty": 0,
  "thinking_budget": 2048
}
messages 是对话历史的数组,每个元素有两个字段:role(角色)和 content(内容)。角色有三种:system 是幕后的"总导演",负责设定模型的行为模式;user 是用户的发言;assistant 是历史回复。在我们的请求里,system 消息就是那份至关重要的系统提示词,我们马上就会专门讲它。
做这件事的同时,我记得顺手验证了两件容易被忽略的事:一是CORS——浏览器跨域调用接口,需要服务端允许。我发了个带 Origin 头的预检请求(OPTIONS),确认响应里有 Access-Control-Allow-Origin 回显,服务端愿意放行浏览器直连,这才敢安心往下走;二是认证——请求头里要带 Authorization: Bearer <密钥>,密钥的管理后面会专门讲安全边界。这两件事如果在 Node 里先验证过,前端联调时就只剩"啊,真顺畅"的快乐,没有"怎么又 403"的痛苦。
第五步:提示词工程——和模型签一份"输出契约"
请求会发了,接下来是决定这个项目成败的一步:系统提示词怎么写。很多项目 Demo 阶段跑得通、一上真实场景就露馅,十有八九是栽在这一步——模型输出的东西,前端根本没法解析。
我的目标非常明确:模型必须严格输出一个结构固定的 JSON,字段完备、边界清晰。为此我在系统提示词里做了三件事。
第一件,给它"足本"。 我没有抽象地写"请返回歌曲信息",而是把完整的 JSON 结构直接铺写出来,字段旁还标注了含义和取值规范:
{
  "recognized": true,
  "text": "对用户说的一句话",
  "song": {
    "title": "歌名",
    "artist": "演唱者",
    "album": "所属专辑",
    "year": "发行年份",
    "genre": "曲风",
    "lyrics": "代表性歌词片段",
    "description": "歌曲简介",
    "tags": ["风格标签"]
  },
  "alternatives": [],
  "confidence": 95,
  "reasoning": "识别依据"
}
别小看这份"足本"。大模型是模仿大师,“给它看一千份笑话说’你写个笑话’”,远不如直接模仿来得稳定。字段注释更是代码思维的直接应用——我明确要求所有字段必须存在,拿不准就填"未知",否则前端的 null 处理会到处开花。
第二件,把规则穷举。 模型最擅长在你没规定的地方自由发挥。所以我把每一种边界都说得清清楚楚:置信度低于 60 时 recognized 必须为 false,还要尽力给出两到四首候选;没有候选时 alternatives 输出空数组;confidence 必须是 0 到 100 的整数;哪怕用户问的问题与识曲无关,也必须按这个 JSON 结构回复。这些规则本质上是把"异常分支"提前写进契约,让模型在任何输入下都行为一致。
第三件,控制住玄学参数。 temperature 压到 0.6、top_p 压到 0.95。识曲是"要么对要么错"的判断题,不是写诗,温度太高只会让 JSON 结构都跑形。你要的是模型"规矩地给出正确答案",而不是"放飞地给出创意答案"。
写提示词有一条心法可以送给所有读者:你的提示词,就是你和模型之间的合同。合同的每一处含糊,都会有模型替你把含糊变成事故。 把合同写到"没有任何一条规则需要临场发挥",你就赢了。
第六步:容错——假设模型一定会不乖
提示词写得再好,也要明白一个冷酷的事实:模型是概率机器,输出不可能 100% 稳定。 哪怕我们把规矩写到了极致,它偶尔还是会手滑——用 markdown 代码块把 JSON 包起来啦,前头多说了半句正事啦,甚至心情不好给了一坨格式化失败的文本。一个合格的前端,必须把这些意外当成"正常输入"来应对。
于是我写了 extractJson 函数,做三级降级容错:
function extractJson(text) {
  let cleaned = text.trim();
  const fence = cleaned.match(/^```(?:json)?\s*([\s\S]*?)\s*```$/);
  if (fence) cleaned = fence[1].trim();              // 第一级:剥掉代码块
  try {
    return JSON.parse(cleaned);                       // 第二级:整体解析
  } catch (_) {
    const start = cleaned.indexOf("{");
    const end = cleaned.lastIndexOf("}");
    if (start >= 0 && end > start) {                  // 第三级:掐尖去尾
      try {
        return JSON.parse(cleaned.slice(start, end + 1));
      } catch (_) { /* 实在不行返回 null */ }
    }
  }
  return null;
}
三级策略层层兜底:先剥 markdown 代码块,再试整体解析,最后退而求其次地从第一个 { 截到最后一个 } 暴力解析。如果连这都不行,就当普通文本展示,绝不因为一行脏数据让整个会话卡死。把"模型会不乖"当作默认前提来设计,你的产品才不会一崩就死。
顺带一提,渲染层还有一个安全必修课:所有动态内容一律用 textContent 而不是 innerHTML。因为模型输出的歌词、简介都是不可信内容,若夹带一段 <div onclick=...>,前者是纯文本,后者就是注入攻击的入口。一行 textContent,挡住一整类安全漏洞,这笔账怎么算都划算。
第七步:渲染——把 JSON 变成一张歌曲名片
数据干净了,流也通了,最后一步的"翻译"是:把 JSON 变成人愿意看的界面。 想象中的最终形态,是一张结构完整的歌曲名片。我把它拆成四个层次,从上到下就是一次完整的"心理旅程":
- 结论层:一张渐变色头图,左是音符封面,右侧歌名大字、演唱者、置信度进度条、识别状态徽章。一眼锁定"是哪首歌、把握多大"。
- 身份层:专辑、年份、曲风的三格信息网格,补齐"它是谁"。
- 共鸣层:代表性歌词做成一块带紫色竖线的斜体引文块,下配一段简介。把数据拽回"歌"的温度。
- 信任层:候选歌曲列表,每行一歌名、一歌手、一句"为什么也可能是这首"。诚实,是信任的起点。
这里有个实现上的趣味点:进度条动画。如果渲染完立刻设置宽度,动画往往失效——因为浏览器还没完成首次绘制。我的解法是套两层 requestAnimationFrame,让浏览器先"呼吸"一次,再让进度条用 transition 从 0 平滑生长到目标值。这个微小的细节,是"能用"和"好用"之间无数个细节之一。
第八步:界面质感——音乐氛围是怎么调出来的
功能全部跑通的那天晚上,我盯着满屏白底黑字的页面看了很久,然后沮丧地发现:它"能用",但它不"像一个音乐产品"。这一步说的不是功能,而是质感——那些说不清道不明、却让你觉得"这界面挺有感觉"的东西。
我把调质感的过程拆成四件事,每一件都有清晰的施工方法。
第一件,用 CSS 变量管住颜色。 我从不允许代码里出现裸的颜色值,所有颜色都先声明成变量——这在工程上叫"设计令牌"。底色是三层从墨蓝到深紫的渐变(#0f0c29 → #1a1038 → #24243e),点缀色是一组紫罗兰、暖粉、电光蓝的三元组合,分别负责品牌区、用户气泡和 AI 高亮。它的收益是长期的:想整体换色,改三个变量就够,不用满盘搜索 #。
:root {
  --accent: #8e7bff;      /* 品牌紫 */
  --accent-2: #ff6e9c;    /* 用户气泡暖粉 */
  --accent-3: #4dd4ff;    /* AI 高亮电光蓝 */
  --text-main: #f2eefc;
  --text-sub: #a89fc7;
}
为什么选深色底?因为"想不起歌名"这件事大多发生在夜里,深色底不刺眼;也因为深色背景天然衬托发光元素,音符、进度条、渐变文字在这些深色里才有"聚光灯"的感觉。
第二件,用多层渐变造纵深。 我给页面背景叠了四组不同位置、不同尺寸的径向渐变——左上角一团紫、右上角一团粉、底部一团蓝,再随手铺一层低透明度的噪点网格。效果是背景不再是一张平面的色卡,而像站立在演出舞台的灯光里。这个"廉价"到只有几行背景声明的技巧,能把页面气质从"后台系统"拉到"产品"。
第三件,用玻璃拟态做层次。 顶栏、气泡、输入框,我都用了 backdrop-filter: blur()。它让上层元素对下层产生"半透明磨砂"的效果,内容滚动时背景从毛玻璃里透出来,立体感瞬间就来了。注意一个性能细节:backdrop-filter 有渲染成本,只用在顶栏、气泡这类面积小、数量可控的元素上,不要给整页铺。
第四件,用动效控节奏。 我列了一份动效清单:欢迎页音符的浮动、思考图标的旋转、打字指示器的三点闪烁、消息入场的上浮淡入、置信度进度条的填充。清单之外的元素一律不动。为什么要"克制"?因为动效的用途是引导注意力,不是展览自己——满屏都在动,等于满屏都没动。设计准则只有一句话:同一时刻,屏幕上最多一到两处动效在发生。
最后,响应式这一课也不可跳过。我用 100dvh 替代 100vh 来撑满屏幕——这个单位能跟随移动端地址栏的收起与展开自动适配,避免页面高一块矮一块;窄屏下把消息气泡的最大宽度放宽、让卡片占满宽度;输入框自动增高但封顶在 140 像素,防止长文本把发送按钮挤出可视区。
掂量一下就会发现,这一章没有一行"逻辑代码",却决定了用户打开页面前三秒的感受。技术决定这个产品能不能用,而质感决定它让人想不想用。
第九步:打磨——关于状态、并发与边界
功能跑通只是起点,一个能长期使用的对话产品,还要翻越三座小丘。
第一个是上下文管理。 我维护一个 history 数组,system 消息永远打头,每轮对话按角色顺序追加。但羊不能无止境养——模型每轮要看全部历史,纯文本垃圾会白白烧掉 token。我的策略是:AI 回复不存原始 JSON,而是存压缩后的摘要(text 字段,即它跟用户说的那句话)。这样上下文既连贯又省钱,还避免了"模型看到自己上一轮输出的一大坨 JSON 后开始模仿满屏 JSON"的尴尬。
第二个是并发锁。 流式请求没结束时,用户连续按 Enter 会开出多个并行的流,界面瞬间群魔乱舞。一个 isStreaming 布尔值就能挡下所有问题:流进行中禁用发送按钮、忽略 Enter 事件。简单,但管用。
第三个是清空。 "清空对话"按钮把 history 重置成只含 system 的初态,清空消息列表,恢复欢迎页。这个按钮对长会话用户是刚需,也是产品"体面退出"的保障。
第十步:测试与验收——两首歌,一条链
我自己对"测试"的理解是:测试的目的不是证明没有 bug,而是给自己一个敢说"可以交付"的理由。 所以我把验收标准定得很具体:用真实接口、真实提示词、真实输入,跑通一条完整链路,并且正反两个用例都要过。
正面用例我选了一个非常经典的歌词片段,反面(指模糊输入)用例我选了一段凭印象的描述。结果是这样的:
用例一:夜空中最亮的星,能否听清,那仰望的人,心底的孤独和叹息
  ✅ recognized: true | confidence: 100 | song: 夜空中最亮的星 - 逃跑计划

用例二:一首前几年很火的英文女声歌,节奏感很强,歌词一直重复 work work
  ✅ recognized: true | confidence: 88 | song: Work - Rihanna (feat. Drake)
     alternatives: 2
两例都准确解析出了完整的 JSON 字段:recognized、text、song、alternatives、confidence、reasoning 一个不少。第二例尤其让人欣慰——模型给出 88% 的置信度,并诚实附带了两首候选。高置信时果断、低置信时诚实,这正是产品想要的行为。除了端到端联调,我还例行做了三件小事:node --check 过一遍 JS 语法、本地起 HTTP 服务确认三个静态资源全 200、预检 CORS 确认直连可行。
第十一步:往前走——五个可以落地的扩展方向
如果这个项目是你的练手作,你一定已经在琢磨"下一步还能做什么"。我列五个想得最清楚的方向,按性价比排序:
其一,后端代理收口。 把密钥从浏览器移到服务端,前端只请求自己的接口。这是从"演示"走向"可上线"的必经之路,也是安全边界的第一道闸。密钥放在前端,等于把钥匙挂在门把手上——能用,但你心里得清楚代价。
其二,真实声音识别。 用 getUserMedia 接麦克风,把哼唱的音频走一遍特征提取,交给模型辅助判断。文字识曲升级成声音识曲,产品的想象力会完全不同。
其三,联动音乐生态。 识别成功后,接入歌曲平台的封面、试听、完整歌词 API,卡片从"信息型"变"消费型",用户看完能直接听。
其四,多模型可切换。 把模型名做成配置甚至下拉框,让用户感受不同模型识曲风格的差异,顺便降低单一模型的依赖风险。
其五,PWA 化。 补一个 manifest 和 Service Worker,让它能装进手机主屏,向"原生应用"的体验逼近。
这五个方向没有一个需要推倒重来——架子搭得干净,扩展才不疼。
结语:拆掉心里的那堵墙
如果你从头读到这里,我希望你记住的不是这段代码怎么写的,而是三个认知:第一,大模型接口没那么神秘,它就是一个会聊天的 HTTP 接口,打开 DevTools 就能看到 TS;第二,提示词是真正的前沿技能,一份结构清晰的"输出契约",是 AI 应用质量和稳定性的分水岭;第三,前端不是 AI 的附庸,流式、渲染、状态、安全、动效——这门手艺的每一个细节,都在决定一个 AI 产品是"能用"还是"好用"。
码道二字,是我对"写代码这条路"的称呼。这条路没有捷径,但也没有想象的那么陡。你需要的,不过是把"我试试"三个字,变成打开编辑器敲下的第一行代码。
现在,轮到你了。去建立一个 index.html,去写下第一个 fetch 调用,去看模型把第一行思考内容滚进屏幕——然后,在某个深夜,替你记忆里那首卡了很久的歌,找到它的名字。

汇聚全球AI编程工具,助力开发者即刻编程。
更多推荐

 5
 0
- 0


 已为社区贡献1条内容

所有评论(0)