
码道:从零搭建我的AI助手——记录从零到发布全纪录
码道实战:让大模型返回 JSON,我用零依赖打通了 AI 问答到网页展示的全过程
一、起因:一次"能用但没法看"的调用
先交代一下这个项目的来历。前段时间我拿到一个 GitCode AI 的接口权限,模型是 deepseek-ai/DeepSeek-V4-Flash,标准 OpenAI 兼容格式,支持流式输出。拿到 Key 的第一反应就是写个脚本试试水。脚本不长,requests 一发,逐行读 SSE 流,把每个 chunk 的 delta 内容打出来,跑起来效果相当惊艳。我让它讲一个关于宇宙的有趣事实,它噼里啪啦回了一段几百字的话,逻辑清楚,语气友善。
仓库链接:https://atomgit.com/gcw_ARySt0OL/ciyujielong
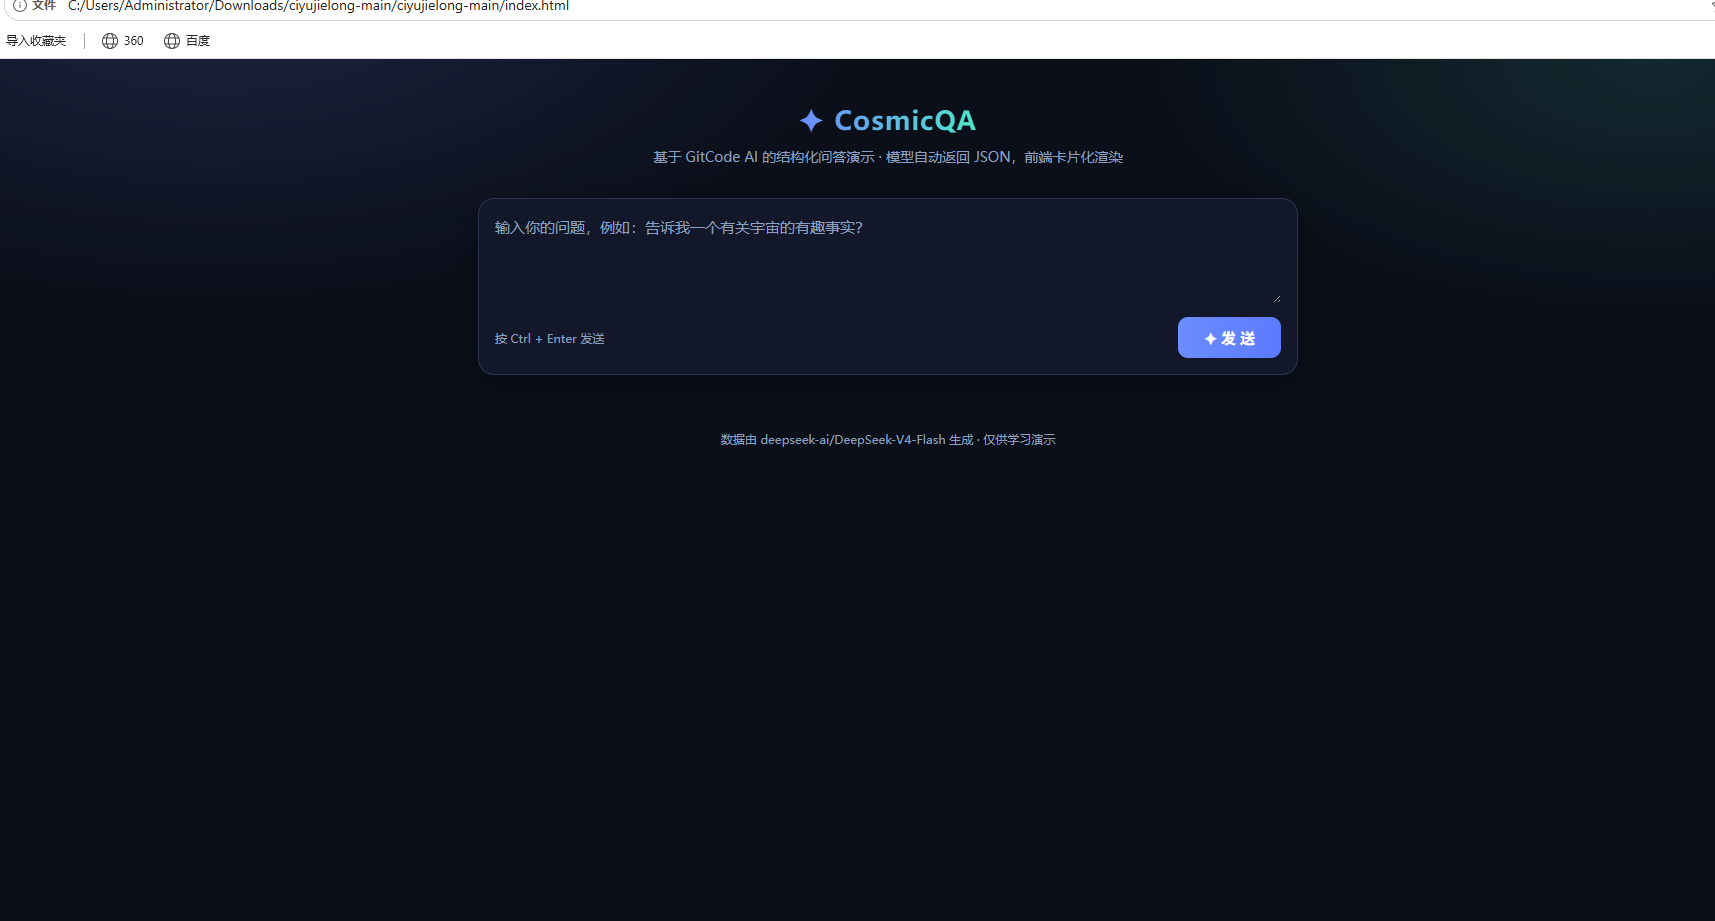
码道流程: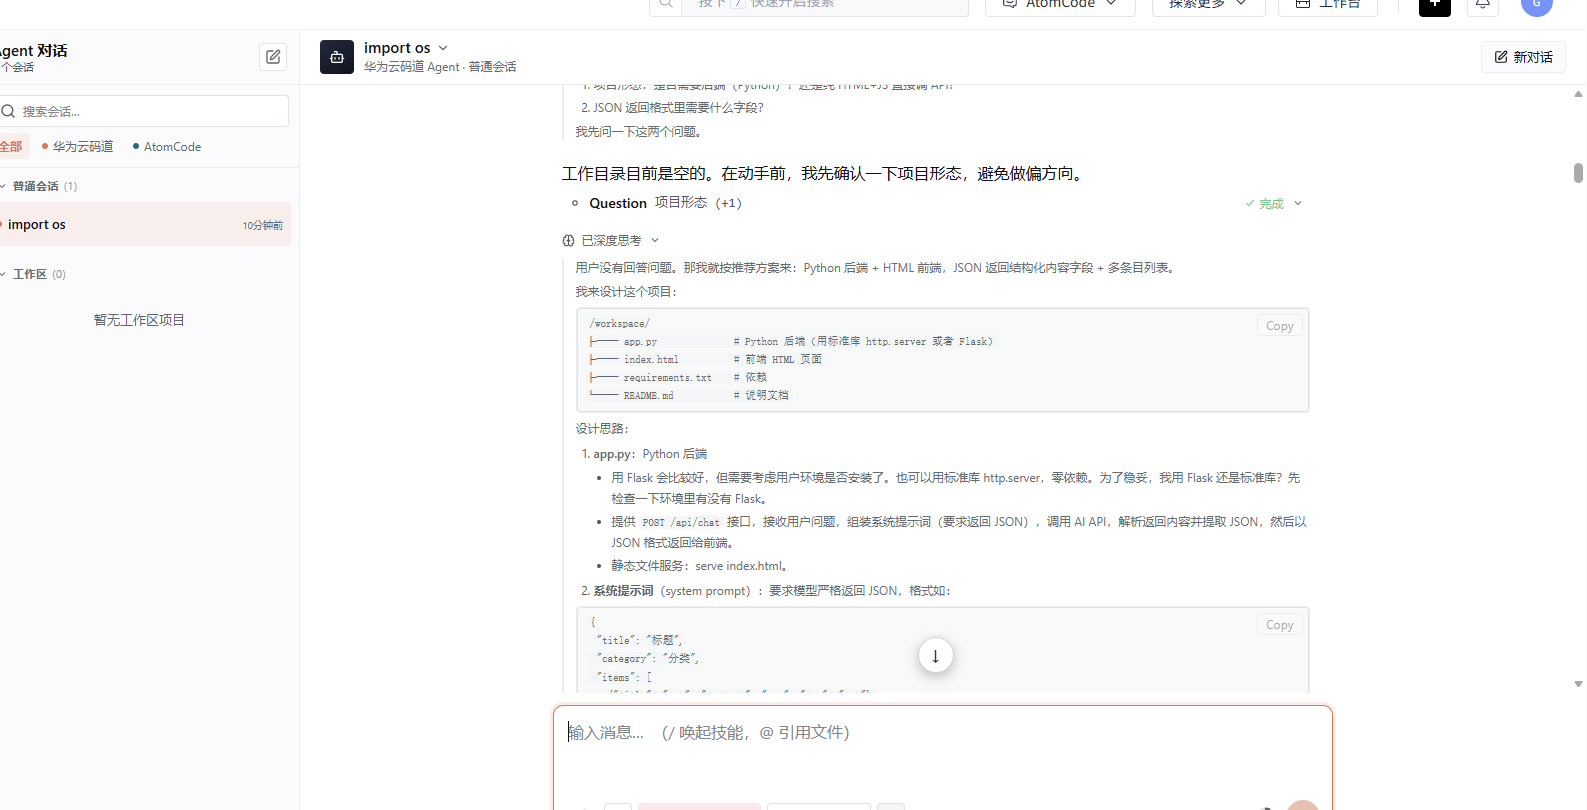
问题出在下一步。我想把这套东西做成一个能给别人看的东西,要从终端挪到网页上。麻烦立刻来了。
模型返回的是"一整坨"纯文本。好的情况是一问一答,问题简单,段落还规整;坏的情况是它自作主张给你分段落、加粗、列条目,有的地方还冒出个标题,所有的排版约定全靠它临时起意。把这样一段文本直接塞进 HTML 里,效果就是一面没有任何结构的文字墙。花哨一点的方案是前端写 Markdown 渲染器,但 Markdown 渲染只能解决"显示"的问题,解决不了"结构"的问题。我想做的不是显示一段话,而是把答案拆成可排版的模块:标题是标题,概述是概述,每条要点是独立的卡片,标签是标签。
换句话说,我需要的不是"一段文字",而是一个对象。
二、破题思路:把格式约束写进系统提示词
想通这一点之后,方案其实很朴素:既然模型的能力是"按指令生成文本",那我就在指令里把输出格式规定死。前端要什么结构,就让模型输出什么结构,中间不经过任何猜测。
有经验的读者会说,这不就是教模型返回 JSON 吗。对,就是这么回事,但做起来比听起来繁琐。模型不是程序,没有 strict mode 可开(至少这个接口没暴露),所谓"只输出 JSON"是请求,不是承诺。我用了一个多小时,反复调了几版提示词才找到一个相对稳定的写法,后面会详细拆解。
先说结论:与其前端用正则去猜文本里哪儿是标题、哪儿是列表,不如把这件事做成一道契约题。前端和后端约定好一份 JSON Schema,后端拿着这份 Schema 去约束模型,再拿着同一份 Schema 去解析结果,最后前端拿着 Schema 去渲染。三个环节用的是同一套结构,谁都不会错位。
这个设计思路,我给它取了个名字,叫"结构前移"。格式约束不再发生在展示层,而是发生在生成层。
三、系统提示词:一份能真正被遵守的 Schema
最终定稿的系统提示词长这样:
你是一个结构化内容助手。请严格按以下 JSON Schema 输出,只输出合法 JSON,
不要输出任何多余文字,不要使用 ```json 包裹:

{
  "title": "对用户问题的简要标题(字符串)",
  "summary": "核心回答概述,1~2 句话(字符串)",
  "items": [
    {
      "title": "要点标题(字符串)",
      "description": "要点的详细说明(字符串)",
      "tag": "要点分类标签,如 天文/物理/趣闻(字符串)"
    }
  ],
  "tags": ["内容相关标签,2~4 个(字符串数组)"],
  "tip": "延伸建议或趣味补充(字符串,可为空字符串)"
}

要求:
1. 根据用户问题生成 3~5 条 items,内容准确、条理清晰。
2. 所有键名保持英文原样,所有值使用 JSON 合法转义的双引号字符串。
3. 输出的 JSON 必须能被 json.loads 直接解析。
这份提示词的写法有讲究,我拆开说。
第一,Schema 要给具体的示例,不要抽象描述。如果你只写"请输出一个包含标题、摘要和列表的 JSON",模型大概率给你造出一些自定义键名,或者干脆把键名翻译成中文。"title" 和 "标题" 对模型来说都是合理的表达,但对代码来说只有一个是正确的。所以我直接把带英文键名、带类型的骨架整个贴进去,让模型照着填空。
第二,要显式声明"不要做什么"。不要输出任何多余文字,不要使用 ```json 包裹。模型会惯性把 JSON 放进 Markdown 代码块里,因为它在训练数据里见过太多这种用法。你不说,它就包;你说了,大部分情况下它就不包。但注意,是大部分情况,后面我会讲后端为什么还要做容错。
第三,要给数量约束。“生成 3~5 条 items”。没有这个约束,它可能只给一条,也可能给十几条,前端版面就会时疏时密。
第四,"tip" 被特别设计成"可为空字符串"。这行字很关键。模型有个毛病,如果某个字段是必填且没内容可填,它会硬凑一句正确的废话。把"可为空"写明白,等于给了它一个免责出口,实际效果是 tip 的质量反而上去了。
调提示词的过程不像写代码有编译期反馈,全靠肉眼观察输出。我每改一版就发同一个测试问题,比对返回的 JSON,来回试了差不多七八次。真正影响稳定性的主要是两件事:包不包代码块,以及有没有多余的前缀后缀。其余字段本身不太失手。
四、后端:标准库照样能干活
4.1 为什么没上 Flask
后端我选了两个依赖,requests 和标准库的 http.server。没有 Flask,没有 FastAPI,连 uvicorn 都没有。
原因很现实。这是一次演示性质的项目,我想让拿到的同学只需要 pip install requests 就能跑起来。Flask 本身不难装,但把一个演示项目包装进"装框架、起服务、配路由"的流程里,学习成本就变高了。http.server 对静态页面和两个接口这种负载绰绰有余,虽然它不漂亮,但它真的存在,每个 Python 环境里都有。
我用 ThreadingHTTPServer,每个请求一个线程,足够应付本地演示。API 因为绑定了外部 AI 接口,天然带几十秒的网络延迟,如果再用单线程串行服务器,一个用户在等 AI 回复的时候,另一个用户连页面都打不开,这才是我换多线程的真实动机。
4.2 两个核心函数
后端逻辑可以压缩成两个函数,stream_chat 负责跟模型要内容,extract_json 负责把模型吐的文本收拾成干净的对象。
stream_chat 做的事情和最初那个测试脚本基本一样:拼接 payload,带 stream=True 发起请求,然后逐行读响应。区别在于我不再边读边打印,而是把每个 chunk 里 delta.content 的片段全部收集起来,拼成一个完整的字符串。
这里有个值得说道的设计决策。流式接口传来的是成千上万个碎片,为什么不在前端做流式渲染,而是后端攒齐了再一次性返回?
原因是 JSON 是整体结构。模型生成 JSON 的中间 token 大部分时候是残缺的,比如 {"tit、"summary": "宇宙 这种,中间任何一帧都解析不了。你想边流边渲染,要么做增量 JSON 解析器,要么做状态机去猜,这两种方案都复杂,收益却只是省那几秒的等待时间。权衡之后,我选择让后端攒齐、解析、再返回,前端拿到一个完整的对象直接渲染。这个"先攒后析"的思路,是整条链路稳定性的地基。
extract_json 是容错核心,它处理三类不规矩的输出:
- 模型没听劝,把整个 JSON 用三个反引号包了起来。先拿正则把首尾的代码块标记剥掉。
- 模型在 JSON 前面或后面多说了句话,比如"好的,这是你要的内容:"。那就找到第一个左花括号和最后一个右花括号,只截取中间的部分。
- 剥完截完还解析失败,说明模型这次真的放飞了,返回 None,走降级逻辑。
降级逻辑也简单,把原始文本塞进 summary 字段,返回一个空 items 的对象。这样即使用户遇到完全不守规矩的一次输出,页面上依然能看到正常标题和正文,只是没有卡片而已。用户感知到的只是一个"排版比较简单"的页面,而不是一个报错页面。
4.3 接口与安全
接口就两个。GET / 把 index.html 读出来发回去;POST /api/chat 接收 {"question": "..."},校验非空,调用模型,返回 {"success": true, "data": {...}}。
有一件事我特别在意,就是 API Key 的处理。最初版脚本是把 Key 直接写在代码里的,毕竟是自己的实验脚本,无所谓。但写成可分享的项目之后,明文 Key 就成了雷。我改成从环境变量读取,os.environ.get("GITCODE_API_KEY", ...),代码里保留默认值是为了开箱即用,但 README 里专门写了一节提醒使用者:上生产环境务必用环境变量注入,别再让 Key 出现在代码里。
顺带说,这个项目后来是要推到公开仓库上的,如果 Key 残留,等于把凭证公开挂出来,这是比代码里留密码更难看的错误。换环境变量这一步,我认为是整个项目里做的最对的几个决定之一。
接口层还有一套约定,简单到不需要文档就能记住。success 字段始终存在,为 true 时 data 里是完整的结构化对象;为 false 时 error 里是可读的中文错误描述,比如"question 不能为空"或者"调用 AI 接口失败:xxx"。前端只认 success 和 error 两个字段,不关心具体的异常类型,这让前后端联调的成本低了很多。另外还有一个 GET /health 健康检查接口,返回 {“status”: “ok”}。它最初的用途就是验证进程有没有在监听,后来发现配合 curl 做冒烟测试特别好用,就一直留着了。用 curl 发一个非法请求体、发一个空 question、发一个正常问题,三个请求互相比较返回,整个服务的健壮性一目了然。
五、前端:不写框架,一页 HTML 搞定
前端我没有用任何框架,一个 HTML 文件,带内联 CSS 和原生 JavaScript。这不是返祖,是为了让整个项目的依赖清单保持干净到可以一行写完。
页面结构坦白说很简单:上面一个输入卡片,textarea 配一个发送按钮,下面一个结果容器。所有逻辑都围绕 renderResult(data) 一个函数展开。
这个函数写的非常"契约式"。Schema 定义了五个字段,它就把五个字段各归其位:
title渲染成页面的主标题,字号最大。summary渲染成标题下方的引言段落,灰色弱化处理。items是一个响应式网格,每条渲染成一张卡片,卡片左上角是tag徽章,标题在中间,正文在下面。tags是标题下方的一排小圆点标签。tip是底部一条带淡绿色背景的提示条。
有一个细节值得一提。我渲染卡片正文时写了 it.description || it.content。这个双保险是有教训的,模型在个别轮次里会把字段名吐成 content 而不是 description,如果代码只认一个键名,那次输出就缺了一块内容。用兜底写法之后,最多是场景里极少出现的键名差异也不至于白屏。
交互上做了三件事。发送时按钮置灰并展示转圈动画;请求失败时渲染红色错误卡片,并且把后端返回的原始 JSON 用等宽字体展示出来,方便出问题时排查;支持 Ctrl+Enter 快捷发送。后两个都是很基础的功夫,但能明显提升使用手感。
样式方面我花了点时间做暗色主题,深蓝背景配两块径向渐变光晕,黑白灰的卡片配上蓝色和青色两个点缀色。好看是有用的,演示项目尤其要好看,因为看的人第一眼只会注意到两件事,界面好不好看,结果规不规整。恰好这两个点都直接受益于 JSON 结构这条路。
六、跑起来看效果
服务启动之后,我在页面里输入了最初那个问题:“告诉我一个有关宇宙的有趣事实?”
模型在系统提示词的约束下,返回了一份异常工整的 JSON。这里贴一段真实的返回,我做了删减,保留了结构:
{
  "title": "宇宙加速膨胀与暗能量",
  "summary": "宇宙不仅在膨胀,而且膨胀速度在加快,驱动这现象的神秘力量被称为暗能量。",
  "items": [
    {
      "title": "膨胀的发现",
      "description": "1929年哈勃通过观测星系红移发现宇宙在膨胀,这一发现奠定了现代宇宙学的基础。",
      "tag": "天文"
    },
    {
      "title": "意外的加速",
      "description": "1998年两个独立团队通过研究Ia型超新星发现宇宙膨胀并未减速,而是在加速,该发现荣获2011年诺贝尔物理学奖。",
      "tag": "物理"
    },
    {
      "title": "有趣比喻",
      "description": "把宇宙比作一个正在充气的气球,表面上的所有点都相互远离,而暗能量就像某种持续吹气的神秘机制。",
      "tag": "趣闻"
    }
  ],
  "tags": ["宇宙", "暗能量", "膨胀"],
  "tip": "可以搜索\u201c哈勃红移\u201d或\u201cIa型超新星\u201d进一步了解宇宙膨胀的观测证据。"
}
页面上呈现的效果比这段 JSON 本身有说服力。标题横在最上面,两行概述跟在下面,五张卡片(原文实际生成五条,上文只摘了三张)排成两行三列的网格,每张卡片左上角自带着天文、物理、宇宙学、趣闻这样的分类标签,底部一排小巧的标签圆点,最下面一条淡青色的提示条,写着建议你去搜哪些关键词。
那一刻的体验和第一版脚本完全不同。终端里读文本,你是"读到"一个答案;页面上看卡片,你是"看到"一个答案。同样的内容,后者直观得多。这也是整个项目最直接的产出。
另外补一句,页面的响应式是顺手做掉的。网格用了 auto-fill 和 minmax,窗口变窄时卡片会自动从三列收成一列或两列,手机上看也不会破版。虽然演示场景多半在电脑上,但这个细节几乎不花成本,也就没偷懒。
七、踩过的坑
写到这里,把过程中真正卡过我的问题整理一遍,对后来者应该有点用。
第一个坑,模型输出被 Markdown 代码块包裹。这是我遇到频率最高的问题。系统提示词里写了不要用三个反引号,但总有那么几次它就是要包。解决办法就是后端剥,正则 ^```(?:json)?\s* 和 \s*```$ 两个方向都剥一次,覆盖 、json 两种写法。
第二个坑,模型在 JSON 前后夹带说明文字。表现形式是 好的,为你整理如下: 开头,或者结尾来一句 希望这些对你有帮助!。这跟包代码块是两个独立问题,剥离代码块之后依然可能存在,所以必须先剥代码块,再截大括号区间,两步缺一不可。顺序反了也不行,如果先截区间,代码块标记如果恰好在前缀里会被一并截走,后面剥代码块就无从谈起。
第三个坑,流式解析 JSON 的诱惑。开发中段我一度想做一个"边输出边渲染"的版本,在服务端把流式 token 实时推给前端。试了两个小时,放弃了。增量 JSON 解析要做字符串拼接、括号配对、字符串边界识别,模型还会在 JSON 里生成 Unicode 转义,边界情况多到离谱。最后我老老实实回到"攒齐再解析",这条最朴素的路在稳定性上是碾压级的。
第四个坑,thinking_budget 参数带来的杂音。这个接口支持 thinking_budget,模型会先输出一段思考过程再输出正式答案。SSE 流里思考内容和正文是分开的,前者出现在 delta.reasoning_content 之类的字段,后者在 delta.content。如果不加过滤直接拼 full 文本,思考内容全混进来,JSON 直接解析失败。解决方式是只收集 delta.get("content"),其它字段一律无视。
第五个坑,编码。http.server 的默认行为对中文不怎么友好,响应头里如果不声明 charset=utf-8,浏览器可能会按系统默认编码去猜,中文页面直接乱码。我统一在 Content-Type 里显式带上编码,并且所有 JSON 序列化都走 ensure_ascii=False 加 UTF-8 编码,一次到位。
第六个坑,表单校验。最初版本对请求体的处理非常乐观,假设客户端一定会发合规 JSON。后来用 curl 乱敲了几个非法请求,发现服务端直接 500。补上了 try-except 和字段校验,现在空问题返回 400 和明确的中文错误提示,非法 JSON 同样返回 400。给客户端写好错误信息,也是项目健壮性的一部分。
八、这个项目教会我的事
项目本身不大,但做完之后有几条体会,比代码更值得记下来。
第一条,提示词是可以"测试"的。以前总觉得提示词是个玄学,写完了没法验证。这次的经验是,只要给提示词定一个可机检的输出格式,它就能被自动化测试。把返回结果交给 json.loads,一个被正确约束的模型应该在绝大多数情况下通过。一旦格式可机检,调参就有了反馈回路,不再是瞎子摸象。
第二条,前后端要共享同一份契约。这个项目里 Schema 同时出现在系统提示词、后端解析逻辑、前端渲染逻辑三个地方,虽然是手写的三份,但结构必须一致。如果将来要扩展,最应该做的是把 Schema 抽成一份独立配置,提示词从配置生成,前后端从配置读取,这样契约就真正唯一化了。
第三条,最小依赖是有实际价值的。整个项目用到的第三方依赖只有 requests 一个。这意味着任何人拿到代码,装一个包就能跑;也意味着我对整个运行链路有完全的控制力,任何一个环节出问题,都能在几行代码内定位。演示项目尤其适合这种克制的选型。
第四条,结构化的收益是几何级的。同样一次模型调用,纯文本只能给用户一堵墙,而结构化数据可以给用户一套界面。花的成本只是系统提示词里多写几行 Schema,值得反复强调。
九、后续想做的
这个项目目前的状态适合作为演示和学习材料,但离"能用"还有几步。我给自己列了几个明确的方向。
首先是流式实时渲染。前文说"攒齐再解析"是为了稳定,但这不意味着放弃体验。如果要认真做流式,更现实的做法是后端仍然流式转发原始 token,前端做一个轻量增量解析器,先渲染已经完整闭合的子树。这个方向有挑战,但没有第一个版本那么赶。
其次是多轮对话。当前每次请求都是单独的会话,模型不记得上一轮。加个对话历史列表,把 messages 数组存下来来回传,改动不大,效果立竿见影。
再次是 Schema 可配置化。把结构描述和数据源解耦,同一个页面框架换上不同的 Schema,就能变成菜谱生成器、旅行攻略器、每日日报生成器。这个方向最贴近"模板化应用"的想象力。
最后,等这个接口稳定一点,我计划补一轮并发与限流测试。演示归演示,如果真要被公开访问,接口鉴权和频控是必须先补齐的功课。
十、结语
回头总结这个项目,真正有价值的东西其实不是代码本身。代码只有一个后端文件、一个前端文件、一份依赖清单,规模小得可怜。真正有价值的是那条被验证过的路径:把模型输出格式变成长久的契约,让生成环节、解析环节、展示环节共享同一份结构。
做之前我以为难点在"让模型听话",做完才明白难点在"让整个链路围绕结构工作"。模型那一环反而是最省心的,给它一份好的 Schema,它大部分时候会给你惊喜;而后端容错、前端渲染、错误处理这些看起来不起眼的环节,才是决定一个演示项目能不能拿出去见人的关键。
如果你手头也有一份 AI 接口在手里吃灰,不妨照着这个思路折腾一版。先想清楚你想要什么结构,再让模型照着填,比拿到一段漂亮的文本再想办法拆解,省心得多。代码已经开源在仓库里,整个流程从环境准备到页面展示,README 里写得很清楚,欢迎拿去看,也欢迎挑毛病。
有一次我在给这个页面做演示的时候,朋友在旁边问了一句,说这不就是个聊天框吗。我说你仔细看,聊天的响应是结构化卡片,每条内容都有自己的位置,这不是聊天框,这是把模型的输出变成了界面。他看了一会儿,没再说话。我觉得这一秒的沉默,就是对这个项目最好的评价。

汇聚全球AI编程工具,助力开发者即刻编程。
更多推荐

 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)