
码道 · 飞花令AI对诗:当千年前的诗词游戏遇上大模型
楔子:一次酒令,千年风雅
「飞花令」这个名字,相信很多人都不陌生。它源自古人的雅集酒令,行令者轮流吟诵含有指定字的诗句,接不上的便罚酒。唐代诗人元稹有诗云:「筹筋随宜设,觥筹逐次行」,说的便是这种往来酬唱的热闹场面。千年之后,当我把这个古老的文字游戏与当下最前沿的大语言模型放在一起时,一个念头冒了出来:为什么不让 AI 陪我对一场飞花令?
于是便有了今天的项目「飞花令 · AI 对诗」:一个纯前端实现的诗词对战小游戏,你与 AI 以飞花令的形式来往接句,AI 既是你的对手,也是你的裁判。
这篇文章,我想完整记录这个项目从灵感到落地的全过程,包括技术选型的思考、流式接口从 Python 到 JavaScript 的移植、系统提示词与数据契约的设计、古风界面的构建,以及一路踩过的坑。希望它对同样想用 AI 做点有趣事情的朋友有所启发。
一、项目背景:为什么是飞花令,为什么是 AI
1.1 飞花令的魅力
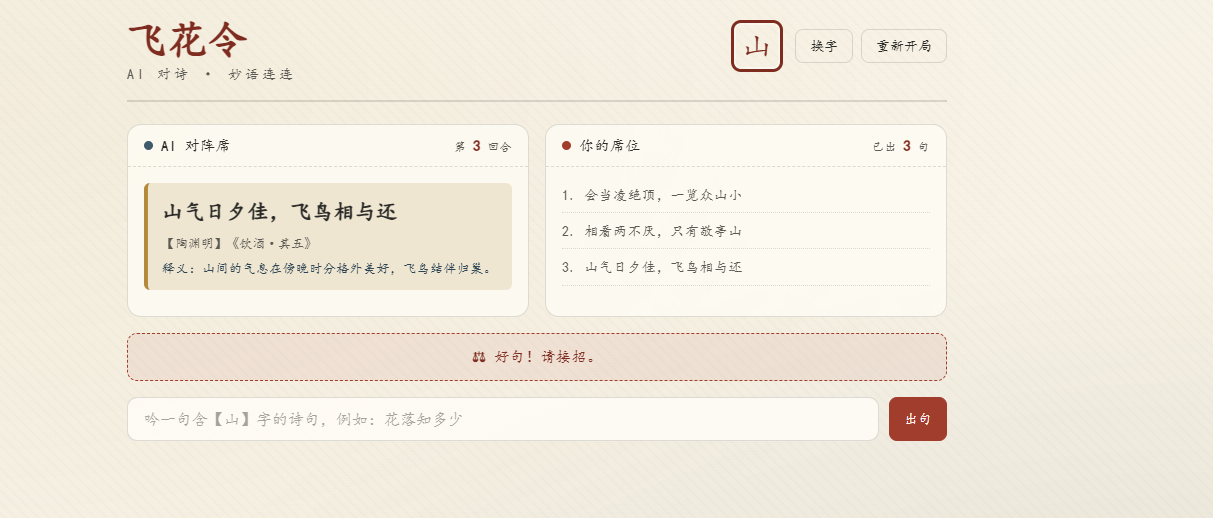
飞花令之所以流传千年,魅力在于它同时考验记忆、联想与文字运用能力。给定一个「花」字,你要在脑海中快速检索与「花」有关的诗句,而且要避免与前面人说过的重复。一句「花落知多少」,一句「花重锦官城」,一来一往之间,既是文采的较量,也是知识的比拼。
这种「检索记忆 + 即时联想 + 规则约束 + 防止重复」的组合,天然适合作为大语言模型的展示场景。它不像聊天那样随性,有明确的规则和判定标准,能让用户直观感受到大模型对中文古典诗词的掌握程度。
1.2 为什么选择大模型
传统方案通常用本地诗句库 + 关键词匹配来实现飞花令机器人,但这种方案有明显的天花板:诗句库规模有限、无法灵活评判用户输入的合法性、不能给出有温度的点评。而大模型的出现改变了这一切:
其一,大模型预训练语料中蕴含海量古诗词,无需预先建库,天然具备「诗句记忆」能力;
其二,模型具备推理与理解能力,可以充当裁判,判断你的出句是否合格、是否重复;
其三,模型的语言生成能力可以让对战变得有温度,每一句点评都像是与一位博学的诗友交谈。
基于这三点,我决定以对话式大模型能力为核心来构建这个项目。
二、技术选型:为什么是 HTML5 + CSS3 + JavaScript
项目定位是一个轻量的展示型应用,我最终选择「纯前端、无构建、无后端」的架构,原因如下:
-
零部署成本。三个核心文件(HTML、CSS、JavaScript),一个静态服务器即可运行,甚至直接双击 HTML 文件也能打开。
-
上手门槛低。不需要安装 Node、不需要运行构建工具,把仓库克隆下来就能跑。
-
AI 能力通过 HTTPS 接口直接调用。OpenAI 兼容的 Chat Completions 接口天然支持浏览器直接请求,只要在请求头带上鉴权信息即可,前端就能完成全部交互闭环。
-
便于分享与演示。一个仓库就是一个完整项目,尤其在类似 CodeArts 码道这样的平台上,别人看到仓库就能立刻体验,无需复杂的环境说明。
当然,纯前端方案也有其固有的缺陷,比如 API 密钥会暴露在浏览器端(这个问题后面会专门讨论),比如无法做复杂的服务端鉴权与会话持久化。但对于一个「演示 + 娱乐」导向的项目来说,利远大于弊。
三、整体架构总览
项目结构非常简单清晰:
feihualingAIduihua/
├── index.html          # 页面入口
├── css/
│   └── style.css       # 古风样式(水墨 / 朱砂 / 靛青配色)
├── js/
│   ├── config.js       # 接口地址、鉴权信息、模型参数、关键字池
│   ├── api.js          # AI 流式调用封装(fetch + ReadableStream 解析 SSE)
│   ├── game.js         # 飞花令对局逻辑与系统提示词(JSON 输出契约)
│   └── ui.js           # 页面渲染、事件绑定、交互控制
└── README.md
从职责上看:
config.js统一管理一切「写死」的配置:接口地址、鉴权 Token、模型名、生成参数(温度、top_p、max_tokens 等)、可用的飞花令关键字池;api.js负责与 AI 接口通信,将流式输出一段一段地送回给上层;game.js是整个游戏的「大脑」,负责构造系统提示词、维护对局状态(关键字、已用诗句、回合数)、解析 AI 的结构化返回;ui.js负责把状态渲染成页面,处理用户的输入与交互事件;index.html与style.css提供骨架与视觉呈现。
五个模块各司其职,彼此通过简单的对象引用协作,没有任何框架依赖,也没有任何第三方库,全部是浏览器原生能力。
四、核心难点一:把 Python 流式调用移植到 JavaScript
4.1 原始 Python 原型
项目的 AI 接口调用原型是用 Python 写的,这也是很多 AI 开发者最熟悉的形态:
import os
import requests
import json

API_URL = "https://api-ai.gitcode.com/v1/chat/completions"
headers = {
    "Authorization": f"Bearer csRseW3DJ-2EPSsdbexF3tjc",
}

def query(payload):
    response = requests.post(API_URL, headers=headers, json=payload, stream=True)
    for line in response.iter_lines():
        if not line.startswith(b"data:"):
            continue
        if line.strip() == b"data:[DONE]" or line.strip() == b"data: [DONE]":
            return
        yield json.loads(line.decode("utf-8").lstrip("data:"))

chunks = query({
    "model": "deepseek-ai/DeepSeek-V4-Flash",
    "messages": [{"role": "user", "content": "告诉我一个有关宇宙的有趣事实?"}],
    "stream": True,
    "max_tokens": 2048,
    "temperature": 0.6,
    "top_p": 0.95,
    "frequency_penalty": 0,
    "thinking_budget": 2048
})

for chunk in chunks:
    print(chunk["choices"])
这段代码的核心逻辑非常清晰:以流式方式发送 POST 请求,逐行读取返回内容,只处理 data: 前缀的行,遇到 [DONE] 标记即结束,每一行数据都是一个 JSON,取其中的 choices 字段即可拿到增量内容。
4.2 浏览器端需要什么
浏览器与 Python 环境有几个显著差异:
- 没有
requests,也没有iter_lines()。需要改用fetch配合流式读取; - 浏览器端的流式读取要借助
ReadableStream+ReadableStreamDefaultReader; - 因为是 SSE(Server-Sent Events)格式,每个数据块之间以
\n\n分隔,而且一个数据行可能被网络传输切成多段,需要做缓冲拼接; - 文本解码需要
TextDecoder,并且要设置{ stream: true }以正确处理跨块的多字节字符。
4.3 移植后的核心实现
js/api.js 最终实现如下:
const AI = (function () {
  const API_URL = CONFIG.API_URL;

  async function queryStream(payload, { onDelta, onDone, onError, signal } = {}) {
    const body = Object.assign({}, CONFIG.PARAMS, {
      model: CONFIG.MODEL,
      messages: payload.messages,
    });

    let response;
    try {
      response = await fetch(API_URL, {
        method: "POST",
        headers: CONFIG.HEADERS,
        body: JSON.stringify(body),
        signal,
      });
    } catch (err) {
      if (err && err.name === "AbortError") {
        onDone && onDone("");
      } else {
        onError && onError("网络请求失败:" + err.message);
      }
      return;
    }

    const reader = response.body.getReader();
    const decoder = new TextDecoder("utf-8");
    let buffer = "";
    let done = false;
    const content = [];

    while (!done) {
      const { value, done: readerDone } = await reader.read();
      done = readerDone;
      if (!done) {
        buffer += decoder.decode(value, { stream: true });
        const lines = buffer.split("\n");
        buffer = lines.pop();
        for (const rawLine of lines) {
          const line = rawLine.trim();
          if (!line.startsWith("data:")) continue;
          const dataStr = line.slice(5).trim();
          if (dataStr === "[DONE]") { done = true; break; }
          try {
            const chunk = JSON.parse(dataStr);
            const piece = chunk && chunk.choices && chunk.choices[0] && chunk.choices[0].delta;
            const text = (piece && piece.content) || "";
            if (text) {
              content.push(text);
              onDelta && onDelta(text);
            }
          } catch (e) { /* 忽略不完整的 JSON 行 */ }
        }
      }
    }
    onDone && onDone(content.join(""));
  }

  return { queryStream };
})();
这里有几个工程细节值得展开说明:
细节一:缓冲行。 SSE 的行可能被 TCP 分片切断,所以这里维护了一个 buffer,每次读取后按 \n 切分,最后一段(可能不完整)留在 buffer 里等下一次读取拼接。这正是 Python iter_lines() 在底层做的事情,浏览器端必须自己实现。
细节二:data: 前缀处理。 每一行要先 trim() 再判断是否以 data: 开头,取 slice(5) 获得真正的数据部分。注意不同实现可能在 data: 与内容之间有空格差异,所以 trim() 是必须的。
细节三:[DONE] 哨兵。 遇到结束标记时立即跳出循环,这是流式协议的约定,必须尊重。
细节四:AbortController。 通过外部传入 signal,可以让用户在请求返回前主动取消(比如点了「换字」或「重新开局」)。取消时主动调 onDone(""),让上层走「空结果」分支,而不是报错。
这个模块最终表现得非常稳定,实际测试中无论网络波动还是跨块汉字,都能完整还原出 AI 的完整回复。
五、核心难点二:系统提示词与 JSON 数据契约
「让 HTML 更好地显示」是本项目最初的一个明确需求,落到工程上其实就一句话:控制 AI 的输出格式。模型默认返回自然语言文本,但如果我们要在页面上把「诗句」「作者」「出处」「释义」分字段展示,就必须让模型输出结构化数据。
5.1 系统提示词的构造
js/game.js 中的 buildMessages 函数负责在每次请求时构建完整的消息序列。其系统提示词非常详尽,包含以下部分:
- 角色设定:「你是一位精通古典诗词的裁判兼对手,主持一场飞花令诗词对战」;
- 游戏规则:轮流吟诵含关键字的真实古诗、开局 AI 先出句、无效出句的判定标准(不含关键字 / 非真实古诗 / 重复)、AI 词穷需主动认输、已用诗句严禁重复;
- 当前战况:动态注入「已用诗句」列表,让 AI 在全局拥有「防重复」的知识;
- 当前回合的指令:开局时要求 AI 先出第一句;对战中要求 AI 先评判玩家上句再回新句;
- 输出要求:写明必须输出的 JSON 结构,逐字段说明含义。
这样一份提示词让 AI 的一次调用同时完成了「评判 + 接句 + 状态更新」三件事,把回合推进所需的全部信息打包在一个 JSON 里返回。
5.2 JSON 数据契约
前端与 AI 之间约定的数据结构如下:
{
  "valid": true,        // 玩家上一句是否有效(开局恒为 true)
  "reason": "点评内容",  // 对玩家上句的点评,无效时说明原因
  "verse": {
    "text": "白日依山尽",          // 诗句正文
    "author": "王之涣",            // 作者
    "title": "登鹳雀楼",           // 诗名
    "meaning": "夕阳依傍着西山慢慢沉没。" // 释义
  },
  "game_over": false,   // 对局是否结束
  "winner": null,       // "player" / "ai",未结束为 null
  "message": "给玩家的状态提示语"
}
这个契约的设计有几点考虑:
- 用
valid + reason承载裁判职能,前端可以根据valid === false高亮显示点评; - 用
verse对象承载诗句的完整元信息,前端据此渲染卡片; - 用
game_over + winner传递对局终局状态,前端据此弹出胜负宣告; - 用
message承载一句引导语,始终给玩家明确的方向感。
5.3 流式数据的聚合与健壮解析
由于我们采用流式返回,AI 的 JSON 是逐字符、逐 token 传送过来的,不可能在中间时刻解析。所以前端采取「流式累积、结束后解析」的策略:onDelta 把文本累积起来,onDone 时统一解析。
解析使用 extractJson 函数:
function extractJson(text) {
  if (!text) return null;
  const cleaned = text.replace(/```json|```/g, "").trim();
  const start = cleaned.indexOf("{");
  const end = cleaned.lastIndexOf("}");
  if (start === -1 || end === -1 || end <= start) return null;
  try {
    return JSON.parse(cleaned.slice(start, end + 1));
  } catch (e) {
    return null;
  }
}
这个函数非常实用,原因在于:
- 有些模型不守规矩,会在 JSON 外面包一层代码围栏(
json ...),所以先replace把围栏剔除; - 取第一个
{到最后一个}之间的内容,可以容忍模型前后夹带少量废话; - 即使这样仍解析失败,就返回 null,由上层走错误提示分支,绝不会让页面崩溃。
实际联调中,这套「格式化要求 + 容错解析」的组合拳效果非常好,模型绝大多数情况都能精确返回既定 JSON 结构。
5.4 一次完整的链路
把一次玩家出句的完整链路串起来看:
- 玩家在输入框输入「举头望明月」,前端本地先校验是否含关键字,不含则提前拦截提示;
- 校验通过后,
GAME.ask构造消息序列(包含最新的已用诗句列表),调用AI.queryStream; - 流式响应逐段累积,结束后
extractJson解析出结构化结果; - 若 AI 诗句非空,则追加进
usedVerses,回合数 +1; onResult回调触发 UI 渲染:AI 席显示「点评 + 诗句卡片」,历史列表刷新,公告栏显示提示语;- 若
game_over为 true,则打开胜负宣告。
整个过程无感流畅,用户更像是在与一位诗友对谈。
六、核心难点三:对局状态与竞态处理
6.1 状态管理
游戏状态只有三个变量:
keyword:当前关键字;usedVerses:已用诗句数组;round:当前回合数。
这三个变量被封装在 GAME 模块内部,通过 getter 暴露读取接口,操作全部收敛在内部函数中(reset、ask、start、changeWord),杜绝了状态被随意改写的风险。
6.2 竞态:用户连点「换字」会怎样
在线程模型上,JavaScript 单线程,但异步请求是并发的。如果用户在 AI 回复前点了「重新开局」,理论上会出现「旧请求的回归结果覆盖新对局界面」的竞态。
解决方案是 AbortController:
function startNew(changeKeyword) {
  cancelStream();                    // abort 旧请求
  setBusy(true);
  abortController = new AbortController();  // 新建可取消句柄
  ...
}
旧请求被 abort 后,api.js 会走 onDone("") 分支,game.js 识别到空文本直接走 onAbort 回调,不触发任何 UI 更新。同时 ui.js 用 busy 标志锁定按钮,避免重复提交。两层防护基本消除了竞态问题。
6.3 防重复的「内」与「外」
防止重复诗句,项目做了两道防线:
- 内部防线:
usedVerses列表随每次请求注入系统提示词,AI 在生成时必须参考已用列表避免重复; - 外部兜底:前端在玩家提交时只校验关键字,诗句重复与否交由 AI 裁判判定,因为模型借助已用列表通常能给出准确判断,且会将重复信息写入
reason告知玩家。
七、界面设计:让古风触手可及
一个飞花令项目如果界面是现代扁平风,多少会有些违和。所以在视觉上我倾注了不少心思,目标是「打开页面就仿佛铺开一卷宣纸」。
7.1 配色系统
- 宣纸底:
#f7f2e7打底,模拟熟宣的颜色与质感,再用两层径向渐变模拟「旧纸泛光」; - 墨色文字:
#2b2b28作主文字,#5c5a54作辅助文字,浓淡两墨相映; - 朱砂点缀:
#a13d2d用于标题与主按钮,呼应印章的赭红色; - 靛青辅助:
#3f5a6b用于 AI 席位标识,形成冷暖对撞; - 鎏金描边:
#b5893a用于 hover 高亮与诗句卡片左边条,低调而有质感。
7.2 版式与细节
- 左右双席位布局:AI 对阵席(蓝)与玩家席位(红),中间以回合计与公告栏衔接,战斗氛围十足;
- 关键字印章:一个 52×52 的「朱砂色字块」,像钤在宣纸上的印章,一眼可见当前关键字;
- 诗句卡片:左侧鎏金竖条 + 大号诗句 + 作者/诗名小字 + 释义灰字,信息层级分明;
- 历史列表:玩家已出诗句以编号清单形式实时滚动展示,成就感可视化;
- 楷体字体栈:
Kaiti SC / STKaiti / KaiTi / Noto Serif SC,从系统楷体到思源宋体兜底,最大程度保持书写感; - 宣纸肌理背景:用 CSS 径向渐变加微小的点缀伪随机分布,模拟纸张的纤维颗粒。
7.3 交互反馈
- 「出句」按钮在请求期间变为「对诗中…」并禁用,避免连点;
- 无效出句用 toast 提示「你的诗句里没有『花』字,再想想~」;
- AI 点评用斜体灰字呈现,与诗句卡片区分;
- 对局结束弹出胜负横幅,胜者用 🏆 标记,仪式感拉满;
- 输入框始终自动聚焦,回车即发送,操作路径极短。
所有这些细节加起来,最终呈现的是一个「打开即是画卷」的沉浸式体验。
八、踩坑记录与工程化反思
这个项目虽小,但过程中踩的坑不少,值得记录:
8.1 SSE 行缓冲的「幽灵问题」
第一个版本没有按行缓冲,直接 dataStr = value.split,导致中文字符被 TCP 分片切断时出现乱码。排查后发现两个问题叠加:一是 stream 需要按行拼接缓冲,二是 TextDecoder 必须传 { stream: true } 才能在跨块字符上正确解码。修复后乱码彻底消失。
8.2 JSON 围栏问题
部分模型返回时会习惯性给 JSON 包一层 ```````json ````代码围栏。如果前端直接 JSON.parse 必然失败。后来的 extractJson 兼容处理解决了这个问题,而且顺带容忍了模型夹带的任何前后缀文本。这是「让模型守格式」与「前端兜底」两条腿走路的典型场景。
8.3 abort 后的空回调
初版在用户主动 cancel 时会走到 onError,弹出一个生硬的错误提示。后来把「用户主动取消」与「真实错误」区分开:取消走 onDone("") + onAbort,只有真正的网络异常或 HTTP 非 2xx 才走 onError。这个区分让换字、重开等操作变得丝滑无感。
8.4 缓存导致的「旧版设置面板」
开发后期发现有些用户打开页面仍能看到旧版的「对局设置」弹窗(要求填写密钥与温度)。排查确认是新版本已经将 API 地址、鉴权 Token、温度等参数全部写死在 config.js 中,但浏览器缓存了旧版 HTML。解决方式是给 HTML 增加 no-cache 相关 meta,并给静态资源追加版本号查询参数(?v=2),强制刷新拿到最新版。这个细节提醒我:前端页面在更新迭代时,缓存策略必须一并进行。
8.5 配置写死的权衡
最终版把 API_URL 与 Authorization 完全写死在 js/config.js 中。这有利有弊:
- 利:开箱即用,用户零配置;
- 弊:密钥在前端必然暴露。任何打开页面的访问者都能在 DevTools 网络面板里看到 Bearer Token。
因此 README 中特别注明:该方案仅适合演示场景,生产环境应使用带额度限制的临时令牌,或改为服务端代理转发。这个权衡必须如实告知使用者,这也是一种工程诚信。
九、效果展示与体验
项目部署后,实际操作体验如下:
- 打开页面,AI 自动开局,随机抽到关键字(如「山」),并率先出句:「相看两不厌,只有敬亭山。」带作者、出处与释义卡片;
- 玩家输入「空山不见人」,回车提交,AI 席显示「评委:妙哉!」点评,并回一句「千山鸟飞绝」,同时标注柳宗元《江雪》与释义;
- 玩家输入不含关键字的句子会被前端直接拦截;输入重复诗句时 AI 会指出重复并判定无效;
- 多轮之后,若 AI 词穷会主动认输,弹出「🏆 AI 认输,这一局你赢了!」的胜局宣告;
- 点击「换字」可随机切换关键字开新局,点击「重新开局」则换回流程再战。
整套体验流畅自然,AI 对古诗词的掌握程度远超预期,它甚至能引用冷门诗句,并给出颇为准确的释义与出处,很多本地诗库方案完全无法比拟。
十、延伸思考:用数据契约驯服对话模型
这个项目最大的方法论收获,是「结构化输出」的价值。
很多人把大模型当作聊天机,认为它只能输出自然语言。但通过精心设计的系统提示词,完全可以要求模型输出指定 Schema 的 JSON,从而把模型能力接入更复杂的应用逻辑。这套方法可以推广到很多场景:
- 让模型输出函数调用参数(Function Calling 的轻量版);
- 让模型输出数据库查询条件(NL2SQL 的雏形);
- 让模型输出多字段表单信息(信息抽取);
- 让模型输出状态机的转移条件(游戏逻辑、对话流程编排)。
关键在于三点:Schema 要简单明确、字段要有详尽的中文说明、前端要有容错解析兜底。三者缺一不可。本项目就是这套方法论最小而完整的示范。
十一、未来规划
项目目前已完成核心闭环,未来如果继续演进,方向大约有四个:
- 引入差异化难度:按关键字生僻度分级(「花月春风」为入门,「龙、鹤、舟」为进阶),挑战性更强;
- 多人联机:利用轻后端或 WebRTC 局域网能力,实现真正的人人对战,AI 只做裁判;
- 语音交互:通过 Web Speech API 支持「口吟诗句」,进一步还原宴席间的行令氛围;
- 诗文知识库增强:在提示词之外挂载本地经整理的诗句索引,提升对冷门诗句判定的准确性。
结语:让代码也有一颗诗心
从一段 Python 流式调用的小原型,到一个可以顺畅对战、界面雅致的完整前端项目,整个过程让我最深的感受是:技术在干巴巴的接口和繁琐的工程之外,也可以很有趣、很有温度。
飞花令是千年前中国人的浪漫,大模型是这个时代最前沿的智慧结晶。把它们放在一起,无非是想说:技术的终点永远是服务于人与文化的需求。当我们用代码描述「落霞与孤鹜齐飞」时,代码本身也就有了一颗诗心。
感谢「码道」平台提供了如此便捷的托管与协作环境,让这个小小的项目可以轻松地被更多人看见、体验与改进。如果你也感兴趣,欢迎克隆仓库,与 AI 来一场跨越千年的飞花令对决——说不定,你能赢过它呢。
项目地址:https://atomgit.com/gcw_QdkCfEgt/feihualingAIduihua
技术栈:HTML5 + CSS3 + JavaScript(原生,零依赖)
核心能力:SSE 流式对话、结构化 JSON 输出、古风交互界面

汇聚全球AI编程工具,助力开发者即刻编程。
更多推荐

 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)