
码道实践录:从零打造校园知识问答 AI 对话应用 —— 零依赖纯前端与大模型流式接入实战
关键词:校园 AI 助手、纯前端、SSE 流式、DeepSeek、结构化输出、零依赖
一、缘起:为什么会有这个项目
在校园里,知识和信息总是分散的:专业课的复习重点、考研英语的备考策略、毕业论文的选题技巧、大四学长的选课经验、社团竞赛的报名时间……它们零散地分布在课件、论坛、学长学姐的口碑和各种公众号推送里。学生想要一个"任何时候都能问、且回答靠谱"的入口,却很难找到这样的工具。
随着大模型能力的快速普及,「对话即服务」成为可能。于是我想,能不能做一个面向校园场景的 AI 知识助手,让学生可以像和学长聊天一样,随时提问、快速得到结构化、可执行的学习建议?这个想法沉淀成了本项目:校园知识问答 AI 对话(campus-ai-chat)。
本项目选择了一条与众不同的技术路线:不写一行后端代码,完全用 HTML + CSS + 原生 JavaScript 构建。整个应用只有三个 JS 文件、一个 CSS 文件和一个 HTML 页面,零框架、零依赖、零构建工具,打开浏览器即可使用,部署时扔到一个静态服务器上就完事。这种做法在当前"万物皆框架、随手一个项目就 npm install 出几百 MB 依赖"的背景下,显得格外轻盈,也格外有意思。
本文将完整复盘这个项目的设计思路、核心实现、踩坑记录与工程化思考,希望能给想做类似「包装大模型能力」的小工具的同学一些参考。
二、项目概览:它是什么,能做什么
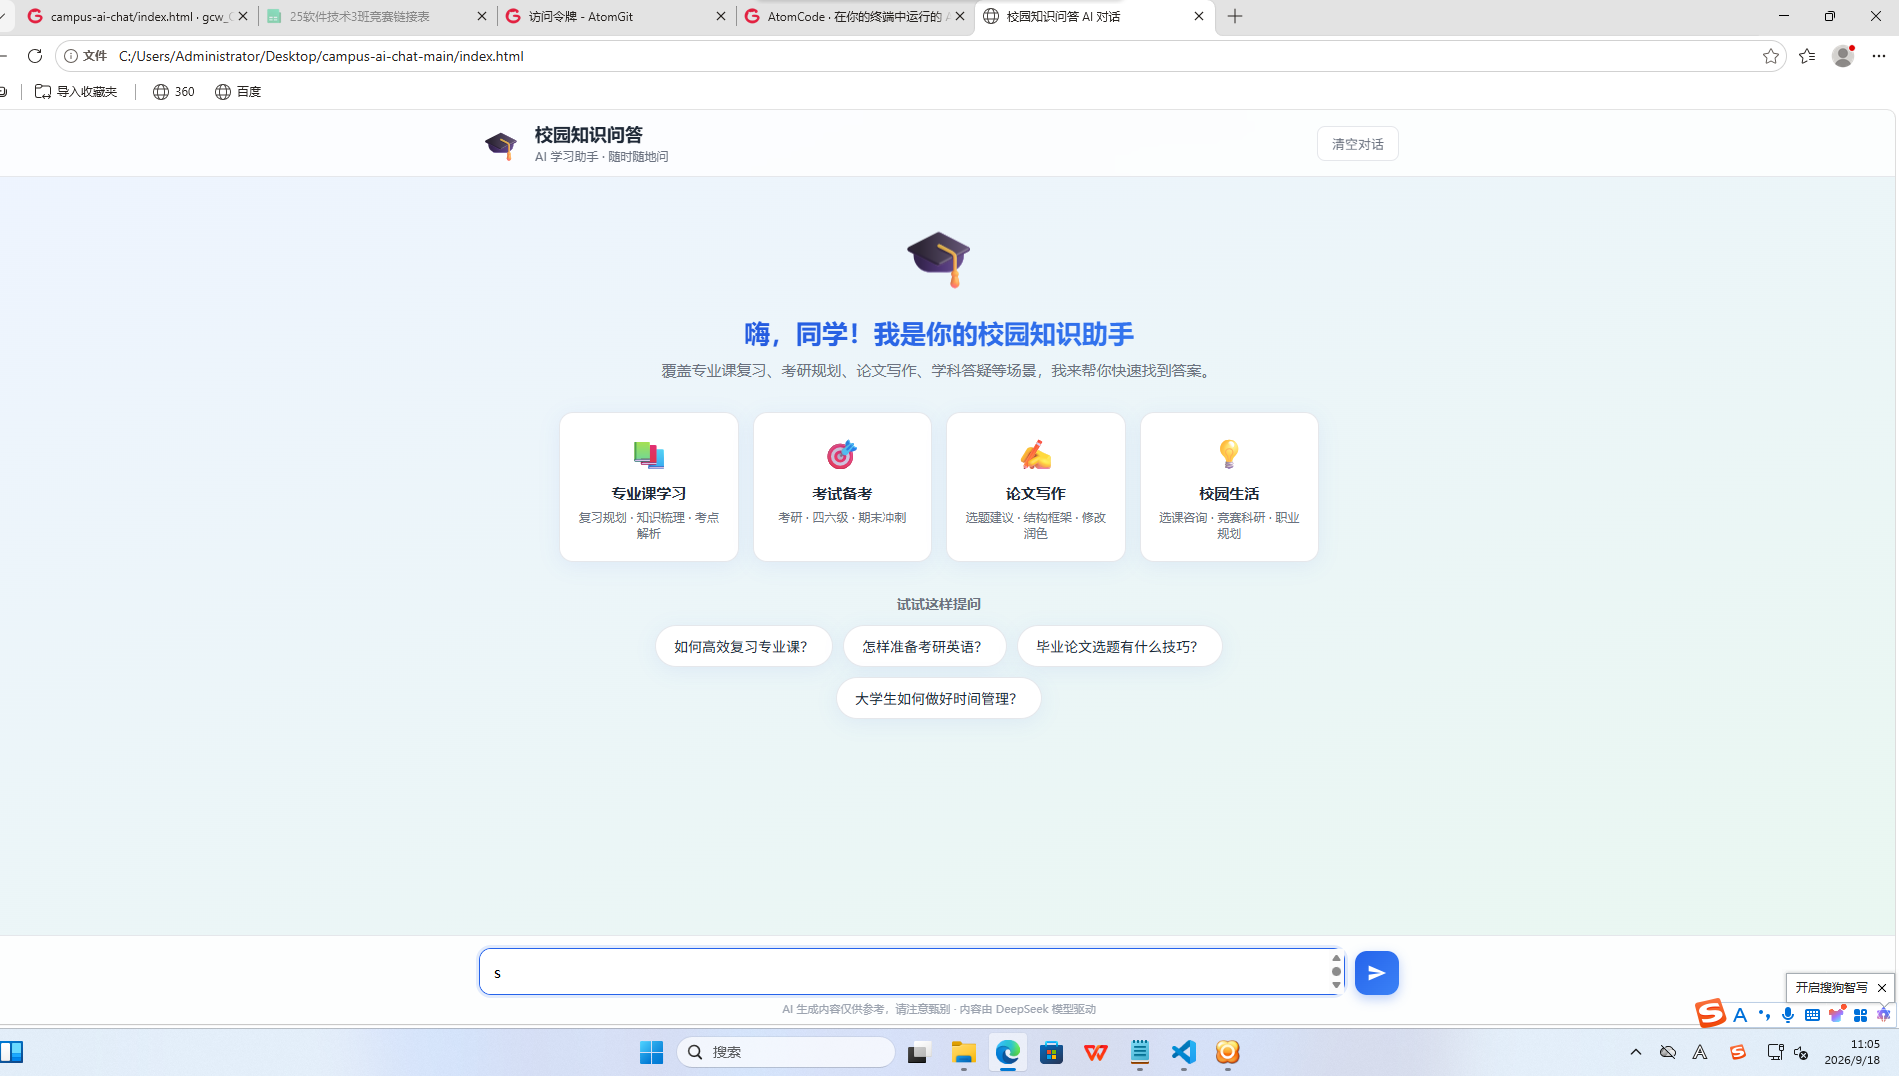
先看整体形态。项目是一个单页应用(SPA),主界面由四个部分组成:
- 顶部导航栏:左侧是品牌标识「🎓 校园知识问答 · AI 学习助手」,右侧提供「清空对话」按钮;
- 欢迎区(Welcome):首次进入时展示四个功能卡片——专业课学习、考试备考、论文写作、校园生活,以及四个"试试这样提问"的快捷问题按钮,降低用户上手的门槛;
- 对话区(Chat Messages):用户与 AI 一来一回的对话流,支持流式打字效果、思考过程折叠展示、结构化结果卡片渲染;
- 底部输入栏:单行自动增高的文本框,支持 Enter 发送、Shift+Enter 换行,右侧圆形发送按钮,底部有「AI 生成内容仅供参考」的提示语。
从功能维度看,它覆盖了这些能力:
- 流式对话:基于 fetch + ReadableStream 逐行解析 SSE,正文内容像打字机一样流式呈现,而不是等待全部生成完毕;
- 思考过程展示:DeepSeek 模型会返回
reasoning_content(推理过程),前端以可折叠的「🧠 思考过程」卡片展示,让回答"可解释"; - 结构化输出:通过系统提示词约束模型严格输出 JSON,前端把 answer 解析为「核心结论 / 详细解答 / 关键要点 / 例子与场景 / 行动建议」五个结构化卡片,信息密度高、阅读体验好;
- 多轮上下文:自动携带最近 12 轮对话作为上下文,让 AI 具备"记得住"的连续对话能力;
- 历史记录:对话自动持久化到 localStorage,刷新页面不丢失,最多保留最近 50 条;
- 中断生成:生成过程中发送按钮切换为「停止」图标,点击即可通过 AbortController 中断请求;
- 轻量 Markdown 渲染:自研了一个高约 100 行的迷你 Markdown 渲染器,支持标题、列表、加粗、行内代码,不引入任何第三方库;
- 安全转义:所有模型输出在渲染前经过 HTML 转义,从源头杜绝 XSS 注入。
三、技术选型:为什么是"纯前端 + DeepSeek"
技术选型往往是项目里最值得写的一笔。这个项目的选型逻辑可以概括为三句话:场景决定形态,成本决定路线,体验决定细节。
3.1 为什么放弃前后端分离
传统 AI 应用的标准架构是"前端页面 + 后端网关 + 模型服务"。后端承担 API Key 保护、限流、对话管理、日志等职责。但同样地,后端也带来了部署成本、运维成本和开发复杂度。
本项目在权衡后选择把后端完全省掉,直接由浏览器向模型服务商提供的 OpenAI 兼容接口发起请求。这样做的好处立竿见影:
- 部署零成本:一个静态页面,HTML/CSS/JS 三个目录,扔到任意静态托管即可运行,甚至可以直接用
file://协议打开; - 开发路径极短:从想法到可用 Demo 只需要一个下午;
- 非常适合校园场景的教学与演示:学生可以一行行读懂所有代码,理解"大模型 API 到底是怎么被调用的",这本身就是最好的教材。
当然,这个取舍也带来明确的代价——API Key 会暴露在浏览器端,任何使用者都能从 DevTools 里看到。这一点我在项目的 config.js 注释里做了明确提示,也在本文的安全章节再展开讨论。
3.2 为什么选择 DeepSeek 模型
模型选择上采用了 deepseek-ai/DeepSeek-V4-Flash,理由很实际:
- OpenAI 兼容协议:接口形态与 OpenAI 的 Chat Completions 一致,社区生态成熟,前端侧只需要一次 fetch 封装;
- 支持流式与思考过程:
reasoning_content字段让"AI 是如何思考的"可视化,这对教学场景是巨大的加成——学生不仅看到答案,还能看到推理链路; - 中文能力强:面向中文校园问答场景,中文理解和生成的稳定性非常关键;
- 成本友好:低成本的 Flash 级模型足以支撑校园问答这种中等复杂度的任务,性价比高。
四、架构设计:三个文件的职责边界
整个前端按职责拆分为三个 JS 文件,这个拆分是刻意的:
campus-ai-chat/
├── index.html      # 页面骨架与语义化结构
├── css/style.css   # 视觉系统与交互细节
└── js/
    ├── config.js   # 配置层:API 地址、密钥、模型参数、系统提示词
    ├── parser.js   # 纯函数工具层:SSE 解析、JSON 提取、Markdown 渲染、HTML 转义
    └── app.js      # 应用层:DOM 操作、状态管理、请求编排、渲染编排
config.js —— 配置与提示词。所有"会变的东西"集中在同一处:API 地址、模型名、温度、max_tokens 等采样参数,以及最重要的系统提示词(SYSTEM_PROMPT)。系统的提示词是整个产品形态的灵魂,它约定了模型必须输出 JSON 结构,从而让前端能做结构化渲染。这体现了"提示词即产品设计"的思路——不写后端解析逻辑,而是让模型输出形态与前端渲染一一对应。
parser.js —— 纯解析工具。这一层的设计原则是"不碰 DOM、不发请求、不读状态",只包含可独立测试的纯函数:HTML 转义、行内代码/加粗渲染、轻量 Markdown 渲染、JSON 提取、SSE 单行解析、增量提取、时间格式化。值得强调的是,它采用了 UMD 包装:在浏览器里挂到 window.ChatParser,在 Node.js 里走 CommonJS module.exports,因此可以直接被 Node 环境做单元测试,无需任何测试框架的额外配置。这个细节我在后面「可测试性」一节再展开。
app.js —— 应用编排。负责一切的"胶水":状态对象(消息列表、加载态、AbortController)、DOM 元素引用、消息渲染(结构卡片/普通文本)、流式请求的发起与消费、历史记录的读写、事件绑定与初始化。它依赖 config.js 的配置和 parser.js 的工具,形成单向依赖,职责清晰。
CSS 方面,采用 CSS 变量(Design Token)集中管理主题色、圆角、阴影、渐变,换肤只需要改 :root 里的十几个变量;响应式断点保证移动端可用。视觉上采用清爽的蓝绿渐变背景、毛玻璃吸顶栏、圆角气泡、悬浮卡片动效,整体走"清新校园风"。
五、核心实现:五个关键技术点拆解
下面进入本文最硬核的部分,逐一拆解五个关键技术点的实现思路。
5.1 系统提示词:让模型输出"前端可以直接吃的 JSON"
大模型 API 返回的是自然语言,而前端想要的是结构化数据。两种常见做法是:要么前端去 parse 自然语言并尝试提取信息(脆弱且不可控),要么用"GJSON + JSON Schema"等工具(需要额外依赖)。本项目的选择是第三条路——用系统提示词约束输出格式。
看一下 config.js 中的系统提示词设计,它做了三件事:
- 角色设定:声明 AI 是"校园知识问答 AI 助手",回答要专业、准确、有条理、贴近校园实际;
- 硬性格式约束:只允许输出一个 JSON 对象,禁止输出 JSON 之外的任何文字、解释或代码块标记,且承诺"JSON 必须能被 JSON.parse 直接解析";
- 字段契约:规定输出必须包含五个字段——
summary(一句话核心结论)、answer(详细解答正文,可分段)、key_points(3~5 个关键要点)、examples(1~3 个具体例子)、tips(1~3 条可执行建议)。
这五个字段直接对应前端渲染的五个结构卡片。也就是说,产品想呈现什么信息结构,提示词就约定什么 JSON 形态,前后端(其实是"提示词契约"与"渲染层")完全对齐。
当然,模型偶尔也会不听话,包一层 ```json 代码块、或在 JSON 前后夹带文字。为此 extractJSON 做了容错处理:先去首尾去除 fenced code block,再直接尝试 JSON.parse,失败则截取第一个 { 到最后一个 } 之间的子串再次尝试。这套"双保险"策略能让解析成功率大大提升,是生产级健壮性的一个小缩影。
5.2 SSE 流式解析:从网络字节流到打字机效果
流式是大模型体验的关键。等全部生成完再一次性展示,首字延迟高、等待感强;而流式输出则让用户几秒内就能看到第一个字,感知"AI 在思考、在回答"。
前端使用 fetch + ReadableStream 实现流式读取:
const response = await fetch(AIConfig.apiUrl, {
  method: "POST",
  headers: headers,
  body: JSON.stringify(buildPayload()),
  signal: signal
});
const reader = response.body.getReader();
const decoder = new TextDecoder("utf-8");
let buffer = "";
核心难点在于字节流与行的边界不对齐:网络包可能把一行 SSE 数据切成若干段,也可能一次携带多行。处理方式很经典——维护一个 buffer,每次读取后按 \n 切分,split 得到的最后一段(可能不完整)留回 buffer,等待下一次读取再拼接:
buffer += decoder.decode(value, { stream: true });
const lines = buffer.split("\n");
buffer = lines.pop();
for (const line of lines) { /* 逐行解析 */ }
逐行解析交给 parser.js 的 parseSSELine:忽略不以 data: 开头的行;data: [DONE] 表示流结束;其余则把 data: 之后的内容 JSON.parse 成 chunk 对象。随后 extractDelta 从 choices[0].delta 中取出 content(正文增量)和 reasoning_content(思考增量),一边累积、一边回调外部渲染。整个过程与 requests.iter_lines() 的 Python 版本逻辑一一对应,代码注释里也保留了这个对照,方便后来者理解。
5.3 思考过程:把"AI 的内心戏"变成可折叠的卡片
深度推理模型(如 DeepSeek 的 R1 系/V4 系)会先产出推理过程再产出答案。这个推理过程是很好的教学素材,如果直接扔掉很可惜,但全量平铺又喧宾夺主。本项目的处理是:默认不展示,一旦检测到 reasoning_content 就以 <details> 可折叠卡片插入正文之前,用户按需展开。
实现上有两个值得记录的细节:
- 出现即插入:
showThinking标志位避免重复插入;若最终模型没产出任何思考内容,则把占位的<details>节点移除,保证空白不残留; - 流式刷新:思考内容本身也是流式累积的,回调里持续把累积文本写入卡片内容区,用户能看到思考过程一行行"长出来",体验非常真实。
这个设计让"黑盒的大模型"变得透明——学生可以直观看到模型如何从题目联想到知识点、如何组织答案,这在教育场景里价值很高。
5.4 自研迷你 Markdown 渲染器:够用就好
如果引入 marked、markdown-it 之类的库,渲染能力自然强大,但项目坚持零依赖,于是动手写了一个约百行的轻量渲染器。它支持的能力与使用场景完全匹配:
# ~ ####四级标题(内部还做了层级偏移,避免与页面 h1/h2 冲突);-/*/•无序列表与1.2.有序列表;**加粗**与反引号`行内代码`;- 空行分段。
实现思路是逐行扫描 + 状态机:用 inList 和 listType 跟踪当前是否处于列表上下文,遇到空行或非列表行时自动闭合列表标签。渲染前先统一做 escapeHTML,再对反引号包裹的代码做还原式处理(转义后再包 <code>),保证任何用户输入或模型输出都不会执行成 HTML——这是 XSS 防护的第一道闸门。
这个渲染器最值得称道的地方是"克制":没有为这些不存在的能力付费,代码量极小、逻辑一眼可读,且每个函数都是纯函数,天然可测。
5.5 结构化卡片与整体渲染编排
当流的 onDone 回调触发时,app.js 进入 finishBubble 统一收尾流程:
- 对累积的完整文本调用
extractJSON尝试解析为对象; - 若解析成功且包含任意一个契约字段,则走
renderStructured:按 summary / answer / key_points / examples / tips 的顺序构建五色卡片(蓝色结论卡、绿色要点卡、琥珀例子卡、紫色建议卡),每张卡片复用同一个 Markdown 渲染器做内层渲染; - 若解析失败或正文为空,则降级为普通 Markdown 文本渲染,或给出明确占位提示("模型未返回有效内容,请重试")。
这种"结构化优先、普通文本兜底"的双轨策略让系统在任何异常情况下都能给出可读的反馈,而不是白屏或报错,容错设计贯穿始终。
此外,每条 AI 消息右下角还有一个「复制」按钮:结构化消息复制格式化 JSON,普通消息复制原文,方便学生把重点内容带走。
六、工程细节:健壮性与可维护性的用心之处
一个项目能不能撑过真实使用,往往不在炫技的功能点,而在这些角落细节。
6.1 中断与竞态
生成过程中用户随时可能点"停止"。项目用 AbortController 把信号透传给 fetch,抛出 AbortError 时在 catch 分支里保留已生成内容并标注"⏹️ 已停止生成",而不是清空或报错。同时发送按钮在加载态切换为方块"停止"图标,状态与交互强一致,杜绝了"停止后按钮失灵"的体验断层。
另一个容易被忽略的竞态是重复点击:isLoading 标志位保证请求进行中再次点击只触发停止而非重复发请求,从状态机层面消灭了并发发送的可能。
6.2 上下文管理
buildPayload 里把系统提示词放最前,然后取最近 24 条消息(12 轮对话)作为上下文,最后拼上用户最新提问。之所以有"截断",是因为对话越长 token 开销越大、模型注意力也越分散——这个 12 轮的经验值在成本和效果之间取了平衡。历史记录同时按"最多保留最近 50 条"做裁剪,防止 localStorage 无限膨胀。
6.3 状态持久化的容错
saveHistory / loadHistory 都套了 try/catch:隐私模式下 localStorage 可能写入失败,损坏数据会导致 JSON.parse 抛错,加载时也做了 Array.isArray 校验和字段级过滤(只接收结构合法的 user / assistant 消息)。这种"写数据假设会失败,读数据假设会被污染"的防御式编程,是本地存储类功能的基本素养。
6.4 视觉系统与交互体验的打磨
一个 AI 工具若只有功能没有质感,学生是不会愿意天天打开的,所以视觉与交互的打磨同样是工程的一部分。项目用 CSS 变量定义了完整的 Design Token:主色 --primary: #2563eb 与浅蓝 --primary-light、深蓝 --primary-dark 构成层级;页面背景使用 #eef4ff 到 #e9f7f0 的 160 度渐变,蓝绿过渡既贴合"校园清新"的调性,又保持长时间阅读的舒适度,且通过 background-attachment: fixed 固定背景避免滚动时的撕裂感。
三个交互细节很能体现"懂产品":
- 毛玻璃吸顶栏与输入栏:页面顶部与底部输入区都用了
backdrop-filter: blur(12px)的毛玻璃效果,在长对话滚动时保持导航和输入入口始终在视野内,视觉上又不会生硬遮挡内容; - 打字指示器与流式正文:等待期间显示三点跳动动画(typing-indicator),第一个增量到达即在正文区域实时渲染并平滑滚动到底部;一旦有内容就移除指示器,中间还做了"避免重复 removeChild 报错"的防御判断——这类小坑,不做流式应用根本不会遇到;
- 微动效的克制运用:欢迎页图标 3 秒浮沉、功能卡片 hover 上浮 4px、消息插入 0.3 秒 fadeUp、快捷提问胶囊按钮 hover 上浮并变色。动效都控制在 0.2~0.5 秒的短时区内,不拖沓、不眩晕,符合"学习工具"的气质。
响应式适配也做了充分的取舍:max-width: 960px 的内容栅格保证桌面端阅读宽度适中;700px 以下断点时,四宫格功能卡降为两列、气泡最大宽度放宽到 85%、快捷按钮整行铺满。整体在手机和电脑上都能获得完整的对话体验。
6.5 可测试性设计
parser.js 的 UMD 包装是刻意的工程决定:运行时挂 window.ChatParser,测试时 require 同一份代码。配合 escapeHTML、parseSSELine、extractJSON、extractDelta 这些"无副作用、输入输出可预期"的纯函数,开发者完全可以用 Node 自带断言在几行代码内写出覆盖核心逻辑的单元测试,而无需拉起浏览器。这是"纯函数隔离 + 依赖注入"思想在无框架项目里的优雅落地。
七、安全与工程化反思:密钥暴露问题必须讲清楚
这是本项目最需要"说真话"的地方。由于是纯前端直连 API,API Key 必然暴露在浏览器端。任何人打开页面、打开 DevTools 的 Network/Application 面板,都能拿到 Key。因此:
- 绝不使用高权限密钥。config.js 注释里已经写明:此类密钥只能用于低配额、无支付的开发/演示场景,泄露了也不至于造成资损;
- 生产级方案是加一层薄后端代理。由后端持有 Key、做限流和鉴权,前端只请求自己的域名,这是标准的补救路径;
- 考虑 IP 白名单 / 域名白名单。模型服务商的密钥通常支持限定来源,若服务商支持,可在密钥侧配置白名单做兜底。
安全问题不解决不让上生产,这是铁律;但作为教学和 Demo 项目,这种"明牌"的架构反而让学习者看得更清楚:浏览器端做不了什么、为什么必须有后端、代理层该挡什么。把风险晾在台面上,本身就是最好的安全启蒙。
八、从做demo到做好用:复盘与展望
回头看,这个项目最成功的地方不是某一个炫酷的功能,而是"克制"——克制地选型(零依赖)、克制地造轮子(迷你 Markdown 渲染器)、克制地设计交互(可折叠思考过程、自动增高的输入框、恰到好处的快捷提问)。它证明了一件事:在 2020 年代做 AI 应用,不一定需要重型工程栈;把几千行的现代框架换成一百行自研工具函数,项目反而更好维护、更好懂、更好讲。
当然,它的边界也很清楚。目前它是"单机版":没有多用户、没有服务端会话、没有知识库 RAG。如果作为正式产品继续演进,我设想的路线是:
- 增加后端代理层:解决密钥安全、支撑多用户和用量统计;
- 引入校园专属知识库(RAG):把课程资料、选课数据、社团公告等私有资料向量化,让回答"接地气"而不是泛泛而谈;
- 多模型路由:按问题类型选择不同模型(简单问答走 Flash、深度推理走大模型,控制成本);
- 移动端适配与小程序入口:贴近学生使用习惯;
- 更细的流式解析:支持 Markdown 表格、数学公式等富格式。
九、写在最后:给同样在做 AI 小工具的同学
如果你也想做一个"包装大模型能力"的小项目,这个项目的经验可以浓缩成五条建议:
- 先定义"回答长什么样",再写提示词:本项目的 JSON 字段契约,本质上就是产品信息架构的一次表达;
- 流式是体验的底线:不要偷懒用一次性请求,SSE 解析的投入产出比极高;
- 容错做在渲染层:模型输出是不可控的,extractJSON 的双保险解析 + 普通文本兜底是必备的;
- 纯函数和单向依赖让千行代码也不乱:parser / config / app 三层拆分是这个项目最值得复用的架构决策;
- 直面安全,不回避:前端直连 API 是教学捷径,就把它讲清楚;要做生产,就勇敢加一层后端代理。
最后,欢迎 Star、Fork 这个项目,也欢迎在评论区交流你的 AI 小工具踩过的坑。校园里从来不缺问题,缺的是顺手可用的答案——希望你也能做出让别人"觉得好用"的那一个。
项目地址:校园知识问答AI对话:基于HTML+CSS+javaScript开发的校园知识问AI对话网页 - AtomGit

汇聚全球AI编程工具,助力开发者即刻编程。
更多推荐

 2
 0
- 0


 已为社区贡献1条内容

所有评论(0)