登录社区云,与社区用户共同成长
邀请您加入社区
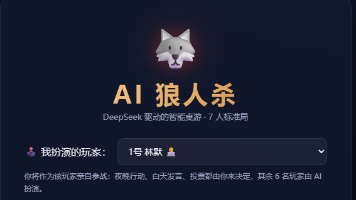
亮点说明提示词即引擎游戏规则通过提示词描述给 AI,AI 输出 JSON 指令驱动游戏,而非硬编码逻辑JSON 协议设计7 种动作类型覆盖全部游戏阶段,AI 100% 遵循格式差异化 AI 人格7 名 AI 玩家拥有不同性格和发言风格,对局生动不重复流式打字机实时提取 speech 字段,只显示发言内容,不暴露原始 JSON身份保密机制两层保密(座位卡 + 日志),参与模式下不剧透优雅中断 AI
聊完"是什么",该聊聊"为什么"。项目立项时,技术选型其实经过了反复权衡,最终决定用最朴素的 Web 三件套,理由如下。不知道你有没有经历过这样的夜晚:台灯亮着,书桌前摊开的作文本上一片空白,笔尖悬在纸面上,迟迟落不下去。审题审了二十分钟,立意改了三次,列出的提纲写了一半又划掉——距离交卷的时间一分一秒地迫近,而你大脑里那些关于"青春"“奋斗”"担当"的素材,像被打乱的拼图一样,怎么也拼不成一篇像
技术选型往往是项目里最值得写的一笔。场景决定形态,成本决定路线,体验决定细节。先定义"回答长什么样",再写提示词:本项目的 JSON 字段契约,本质上就是产品信息架构的一次表达;流式是体验的底线:不要偷懒用一次性请求,SSE 解析的投入产出比极高;容错做在渲染层:模型输出是不可控的,extractJSON 的双保险解析 + 普通文本兜底是必备的;纯函数和单向依赖让千行代码也不乱:parser /
耳遇是一款基于AI的智能音乐推荐应用,通过“场景×性格”双维度匹配(8×8=64种组合),结合DeepSeek-V4-Flash大模型实现流式对话生成结构化歌单。支持实时对话、动态卡片渲染、离线兜底与响应式布局,打造沉浸式音乐体验。零构建部署,纯前端运行,可本地快速体验。
大学英语一直是很多同学心里的"老大难"。四六级、考研英语、雅思托福,每一场考试都像一座山。而背单词更是其中最枯燥、最劝退的环节:拿着一本厚厚的单词书,从 abandon 开始背,背到第三天还是 abandon。背单词纯靠死记硬背,没有词根、联想、谐音这些记忆技巧,背了就忘;语法知识碎片化,定语从句、非谓语动词、虚拟语气这些概念分开都认识,放在句子里就懵;长难句无从下手,考研英语里的句子动辄三四十个
技术选型是项目立项后的第一个决策。方案 A:Python 后端 + 网页前端。这是很多人会走的路线——Flask 或 FastAPI 起一个服务,后端负责转发 AI 请求,前端负责展示。好处是逻辑清晰,坏处是用户要装 Python 环境、要起服务、要管 CORS,对"打开就能玩"这个目标极不友好。方案 B:Node.js 中间层。思路和 A 类似,只是换了个运行时,至少不需要 Python 环境,
当粒子接近时,它们的相位会相互干涉——建设性干涉产生明亮的节点,破坏性干涉产生空洞。每一个种子都会产生独特的晶体美——这是一种大师级生成算法的标志。该 HTML 工件包含所有内容:p5.js(来自 CDN)、算法、参数控制和用户界面——所有内容都在一个文件中,可立即在 claude.ai 工件或任何浏览器中使用。像爵士乐手通过算法和声引用另一首歌曲一样思考——只有懂的人会察觉,但每个人都会欣赏这种
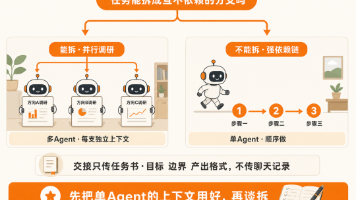
多 Agent 该不该拆,你可能见过两种截然相反的答案。2025 年 6 月 12 日,Cognition 公开劝人别在生产里搭;隔一天 Anthropic 却贴出评测,多 Agent 比单跑 Claude Opus 4 高 **90.2%**。
9月同一周,OpenAI发布GPT-6 Astra、Anthropic发布Claude Fable 5.1、谷歌推出Gemini 3.8 Flash,全球大模型进入密集发布期。本文基于多家外媒对比数据,分析各家在数学、编程、计算机使用、创意写作等维度的长短板,研判中国大模型的差异化机会,并过渡至11月奇点大会的产业对话。
刷了三天八股,结果一面面试官上来就甩给我一段AI生成的虚拟滚动组件:“Claude写的,10分钟,边讲边改。「空」包含了:空数组、空对象、空字符串、0、undefined、nul、空map、空set都属于为空的数据[热度:640】50.[React]如何避免使用context 的时候,引起整个挂载节点树的重新渲染[热度:420】面试官最后说了一句话我记到现在:“我们要的不是会用AI写代码的人,是能
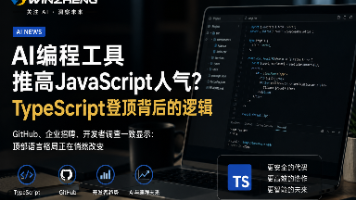
AI新闻指出,这一变化发生在编码AI代理采用最快的时期,其背后深意值得我们持续观察。TypeScript的登顶或许只是开始,未来AI工具与语言生态的互动将更加复杂而微妙。作为开发者,了解这些趋势不仅有助于技术选型,也能帮助我们更深刻地理解AI工具如何重塑软件工程的底层逻辑。本文编译自AI News本文首发于赢政天下(https://www.winzheng.com),获取更多深度技术内容与资源,欢
大模型每轮对话都是"失忆"的,于是我们把技术选型、编码规范、业务流程全塞进 CLAUDE.md 之类的 System Prompt。项目一大,三笔账就还不上了:
每周一个新框架,每月一个"革命性"发布,口号永远是"这回真不一样了"。结果呢?你刚装好 Claude Code,Cursor 又出新功能了;你刚搞懂 ReAct,隔壁团队已经开始吹多智能体协作了。说白了,追工具就是死循环——你永远在切换配置,永远没时间真正干活。
MiniMax H3、V4-Flash-0731、Seedance 2.5 轮番登场,你跟上了吗?
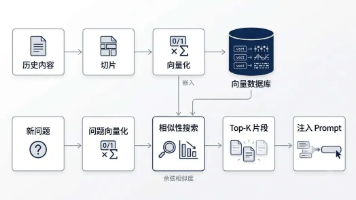
本文系统解析了Agent记忆机制的完整技术框架。从最基础的上下文窗口记忆,到短期记忆、长期记忆、向量检索、结构化profile、知识图谱等高级应用,层层深入剖析了记忆系统的核心设计原理。文章特别指出向量检索只是记忆系统的一个环节,而非全部,强调记忆管理需要解决信息时效性、冲突处理、可编辑性等关键问题。通过分析Claude Code、OpenClaw等主流框架的内存设计思路,为开发者构建高效可靠的A
本文横评7款AI编程工具的前端能力,涵盖Figma2Code精准度、多文件联动、多框架支持等核心维度,数据驱动给出前端工程师的选型建议。
本文探讨了列表页加载状态的分层管理策略,将加载场景划分为三个层级:页面级(首屏遮罩)、按钮级(提交节流)和局部级(区域独立加载)。每层具有明确的生命周期控制:触发源、等待目标和终止条件。关键点在于避免层级混淆(如翻页误触全局遮罩)和并发冲突(旧响应提前关闭新状态)。实施要点包括:独立状态管理、finally复位机制、请求资格校验,以及通过实际操作验证而非仅代码审查。文章强调分层核心是职责隔离而非命
本文针对开发中常见的日志混乱问题,提出结构化日志管理的解决方案。通过分析console.log滥用的弊端,指出线上日志应具备可搜索、可关联、可解释的特性。文章详细介绍了21条日志优化原则,包括使用TraceID串联请求、结构化日志格式、统一事件命名规范、合理分级日志、错误信息完整记录、敏感数据脱敏等核心方法,并提供了标准日志结构示例。这些实践能有效解决多请求日志混淆、调用链断裂、敏感信息泄露等问题
最近 Claude Code 和 Codex 这类 AI 编程工具热度很高,很多人从个人试用转向团队协作时才发现,Demo 能跑和项目能上线完全是两回事。我带团队做了一轮接入,踩了几个坑后意识到,Agent 的核心能力从来不是工具调用本身,而是记忆管理和任务规划这两个容易被忽视的底层机制。Agent 的三大核心能力——规划、工具调用、记忆——看起来各自独立,但实际上紧密关联。规划决定做什么,工具调
文章摘要: Codex的子代理功能允许将复杂任务分解为多个子任务并行处理。通过配置[max_threads]、[max_depth]等参数,用户可以创建具有特定角色的子代理(如代码审查、测试等),并通过@提及或命令手动/自动调用。子代理支持并行和顺序工作模式,主代理负责结果汇总。最佳实践包括合理分解任务、优化配置参数和实时监控代理状态。该功能适合处理大型项目,但建议用户先掌握基础操作后再使用。
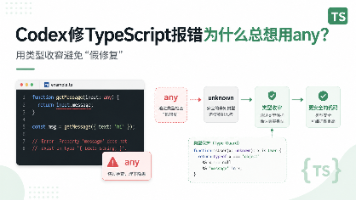
Codex修复TypeScript类型错误时容易过度使用any,虽然能快速消除报错,但会削弱类型系统的保护作用。本文分析了any的危害,并推荐更安全的替代方案:1) 优先使用unknown而非any;2) 为API响应定义精确类型;3) 使用类型守卫和运行时校验;4) 合理应用泛型;5) 避免滥用类型断言。同时强调类型错误应被理解而非简单消除,建议通过联合类型、类型收窄等方式确保类型与真实数据结构
就是 ReAct 的"工作记忆"。它之所以成为 90% 生产级 Agent 的默认架构,就是因为这个"想→做→看"的循环足够通用——不管你的任务是查天气、做研究、写代码还是排查 bug,都可以用这个模式来处理。比如工具返回了一堆 HTML 或者报错的 stack trace,LLM 不知道该怎么理解这个结果,就决定"再试一次"——然后又得到一样的结果——然后又"再试一次"……:给 Agent 提供
下载好后进行安装(如果本地有,可能安装不成功可能是因为版本太低导致,直接下载高版本);,改成。
问题在于,你不可能穷举所有的 X,而且「不要做 X」「不要做 Y」「不要做 Z」堆在一起,Claude 要在这个「禁令列表」里工作,认知负担很高,反而可能导致它在「有没有违反某条禁令」这件事上花太多注意力,而不是在「把这个任务做好」这件事上。让它修一个 Bug,它在修 Bug 的同时,顺手把旁边的函数重构了,把一个变量名「改得更规范了」,把一段死代码删了。生产环境里最难维护的代码,往往不是逻辑复杂
我做论文科普这么久,最反感的就是那种"用工具=学术不端"的论调。工具是工具,人是人。你用书匠策AI降重降AIGC,是为了让自己的真实研究成果用更规范、更自然的方式呈现出来,而不是去抄别人的东西。微信公众号搜:书匠策AI与其熬夜手动改到崩溃,不如让AI帮你把最烦的那一步干掉,把时间省下来去打磨你真正的研究内容。这才是聪明写论文的方式。🫡。
原因是第一次提问的目标就错了,工作时间显示是正确的,结果一直在思考哪里错了,循环思考。结果运行了半个小时没有运行出来。运行不到5分钟,就改好了。把配置文件地方标记上。