登录社区云,与社区用户共同成长
邀请您加入社区
在 FastAPI 中,数据模型通常用 Pydantic 的 BaseModel 来定义。id:学生唯一标识,由系统自动分配,无需调用方传入;name:姓名,必填,长度限制在 1~50 个字符;age:年龄,必填,范围限制在 0~150;gender:性别,可选,取值限定为 male / female / other,通过正则表达式约束;email:邮箱,可选;grade:年级/班级,可选;maj
8月3日发布旗舰模型Qwen3.8-Max,总参数2.4万亿,在Arena榜单中仅次于Claude,在CodeArena编程竞技场排名全球第三,在Artificial Analysis Agentic智能体评测中排名全球第一。然而,受解禁等因素影响,公司股价曾从1330港元跌至297港元,跌幅高达77%,折射出二级市场对AI估值的剧烈分歧。本季度资本性支出676.78亿元,同比增长75%。新结构下
<think>我们只需要根据内容生成一篇≤150字的摘要。内容是关于上下文压缩技术的介绍,包括Claude Code、Codex、Pi agent的压缩方法,以及作者自己的设计原则。摘要要简洁,涵盖主要点。</think>上下文压缩是Coding Agent的核心技术。Claude Code采用分支压缩;Codex分本地与远程压缩,远程压缩对高敏感数据有风险;Pi强调历史树结构。设计压缩策略应因用
跨 Session、Sandbox 和 Executor 的持久 Workspace,版本、分支、Checkpoint、Rollback、权限、配额与多租户隔离——全部由 Agent 完成,人类没有写一行代码,也没有审一行 PR。它不是提前设计好的,而是在项目不断遇到瓶颈、定位问题、调整执行方式的过程中,被一步步“逼”出来的。产品级的 Harness 不能让模型随便改自己,得有个受控的闭环:先发现
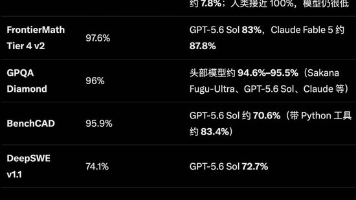
Astra配合工具拿到95.9%的几何重合度,GPT-5.6 Sol为83.3%,Claude Fable 5.1为84.3%。按照OpenAI给出的测试配置,Astra的估算API成本比Sol低约43%,比Fable 5.1低约86%。Terminal-Bench 4.0上,Astra拿到57.7%,GPT-5.6 Sol为37.3%,Claude Fable 5.1为55.8%。即便在较低算力
2026 年 9 月,OpenAI 发布 GPT-6 Astra(Computer Use 成熟落地、105 万上下文),Anthropic 发布 Claude Fable 5.1(缓存读取降价 75% 至 $0.25/百万)。两者标价完全相同($10/$50),但缓存读取差 4 倍,Agent 长任务实际成本天差地别。附完整价格对比表、官方评测数据、五个"看起来是升级实际是坑"的细节(Astra
一位测试者在推文中惊呼:「我注意到这两个模型的一个共同点,它们使用了海量的思考token,以至于我在测试时,多次直接触发了 <max-tokens>(最大token数)的上限!想象一下,未来的游戏开发者只需要用自然语言描述:「帮我生成一个中世纪风格的要塞,包含三个防御塔和一个隐藏的地下通道」,Claude就能直接输出完美的3D模型代码或布局参数。Sonnet 5.1?也有测试者认为,考虑到其惊人的
摘要: 开源AI模型Ornith-1.5通过自我改进循环技术实现突破:它能够自主识别能力短板,生成适配难度的训练任务,并自我验证与优化。其397B参数版本在编程测试(SWE-bench)中以86分追平商业巨头Claude Opus,而仅9B参数的轻量版性能甚至超越Google Gemma 4-31B。这一成果标志着开源模型首次逼近闭源顶尖水平,且揭示了AI进化的新范式——无需海量人工标注数据,通过
《AI时代后端工程师的核心价值:从代码实现到工程判断》 本文通过一个订单接口案例,深刻揭示了AI编程工具普及后后端工程师的角色转变。作者发现AI能快速生成语法正确、功能完整的代码,但真正的工程挑战在于处理现实世界的复杂性:重复请求、并发冲突、部分失败等情况下的系统行为。 文章指出,现代后端开发的核心已从"代码实现"转向"工程判断",工程师需要专注于: 定义业
上周一个读者找我复盘字节面试,二面面试官问了一个看似简单的问题:"你们团队提示词膨胀得厉害,你打算怎么精简?"我当时想都没想就回:"模仿Claude Code的思路呗,把冗余的示例删掉,过时的硬性规则清理掉,剩下按需加载。"面试官听完点点头,又追问了一句:"那删完之后,你怎么验证没翻车?"
文章摘要: 在AI编程中,明确区分Brainstorming(发散思维)和Grill-me(决策压实)两种工具至关重要。前者用于探索未知可能性(如初期场景、功能设计),后者用于在已有方向中细化关键决策(如技术选型、优先级)。混淆两者会导致方案虚浮或过早收敛。Brainstorming适合“无方案阶段”,摊开选项;Grill-me适合“有方向阶段”,通过压力测试逐项确认取舍。AI编程需注重“薄上下文
当前 AI 编程赛道卷得飞起,但工具层普遍存在贵、闭源、数据不透明、供应商锁定等痛点。本文介绍国产平台 MonkeyCode:免费即用、全量主流大模型随意切换、完全开源、支持私有化离线部署,并给出真实使用场景与主流工具对比,聊聊它为何敢免费还开源。
你用 Claude Code(或anthropic。
根据 SpaceXAI 最新收购的 Cursor 官方介绍,新模型基于 Grok 4.5 打造,重点强化了长时间运行的 Agent,以及更复杂的交互和视觉任务,能够处理研究、信息分析、跨代码库开发等需要多步骤完成的工作。自己公布的测试结果最终能够得到第三方验证,那么这一次真正值得关注的,将是一个越来越明显的变化:顶级闭源模型与高性价比开源模型之间的性能差距,可能正在进一步缩小。值得一提的,也就是在
摘要: 实验对比了国产模型GLM5.1/5.2在使用Fable5优化提示词前后的网页生成效果。结果显示,加入Fable5提示词(CLAUDE-FABLE-5-DEV.md)后,生成的页面在视觉层次、文案精准度、排版逻辑和交互设计上显著提升。例如,GLM5.1优化后的页面(glm51-fp.html)展现出苹果风格的精简美学,而默认生成的页面(glm51.html)则呈现扁平化布局和泛化文案。开源代
1973年,Montgomery研究零点之间的配对相关,并在假设黎曼猜想成立的条件下,得到一个关于简单零点比例的2/3结果。Claude提出的秩—迹不等式可以同时处理这两类贡献,再利用已经能够从素数一侧计算的一阶矩和二阶矩,估计临界线上零点的数量。9天后,Anthropic公开了这次结果:Claude把黎曼ζ函数临界线零点比例的纪录,从41.67%提高到67.25%。真正需要黎曼猜想的地方,是如何
GPT、Claude、LLaMA、DeepSeek……这些名字背后,都是这套骨架。看懂 Transformer,你就看懂了大模型的一半。2026 年一晃已经过半,AI 大模型的热潮不仅没有降温,反而持续升温!金融行业用大模型做风控、医疗依靠 AI 解析影像,电商、制造、教育各行各业,都在把 AI 融入日常业务。曾经热闹的 “百模大战”,早就告别单纯比拼模型参数,正式进入落地应用时代。懂业务、懂 A