
码道-诗词飞花令AI对战
码道·诗词飞花令 AI 对战 —— 当千年雅令遇上大模型
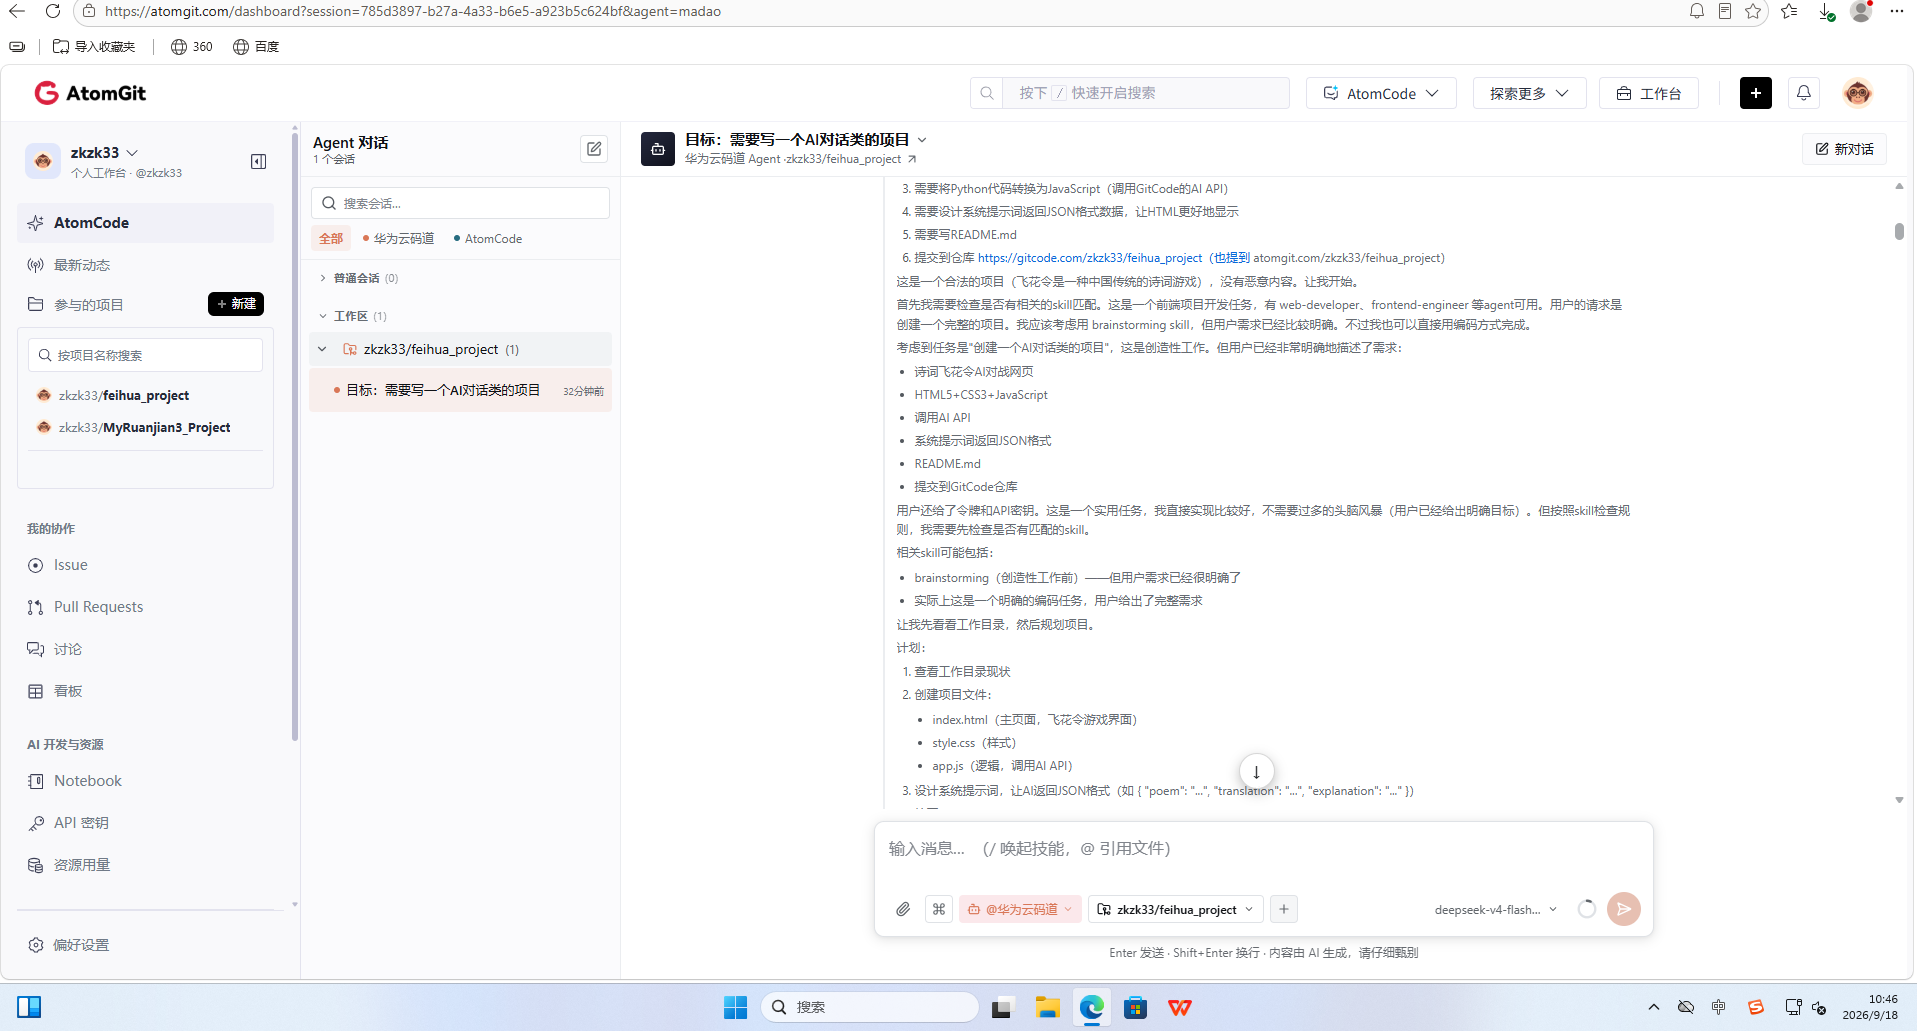
从一句"花间一壶酒"开始,我把流传千年的飞花令搬进了浏览器,并请来 DeepSeek 当裁判兼对手。这篇文章完整记录了「诗词飞花令 AI 对战网页」从想法、设计、编码到验证交付的全过程:纯前端零构建的技术选型、Python 示例到 JavaScript 流式调用的移植、一套让 AI"说人话"的 JSON 协议、水墨古风的界面打磨,以及一路踩过的坑。愿它能为同样想用浏览器直连大模型做点有趣事情的你,提供一份完整可复用的参考。
一、缘起:从一句"花间一壶酒"说起
"花间一壶酒,独酌无相亲。"李白《月下独酌》的这句千古名句,是很多人接触飞花令时最先想到的诗句。飞花令,这个起源于古代文人酒宴上的即兴游戏,规则简单却极见功力:大家约好一个字,轮流说出包含这个字的诗句,接不上者即为输。
它简单到一句话就能讲清规则,又深厚到足以承载上千年的诗词记忆。正是这种"规则极简、上限极高"的特质,让它天然适合成为一个人机对战的载体——我只需要把一个清晰的规则约定告诉大模型,它就能化身合格的对手。
做这个项目的初衷其实很简单:我一直想亲手把一个完整的大模型应用落地成浏览器里真正能玩的东西,而不是停留在 API 调试器里的 curl 命令。飞花令是一个绝佳的切入点:传统文化题材自带感染力,规则明确适合结构化协议,流式输出又能带来"人来诗往"的临场感。于是就有了这个"诗词飞花令 AI 对战网页"。
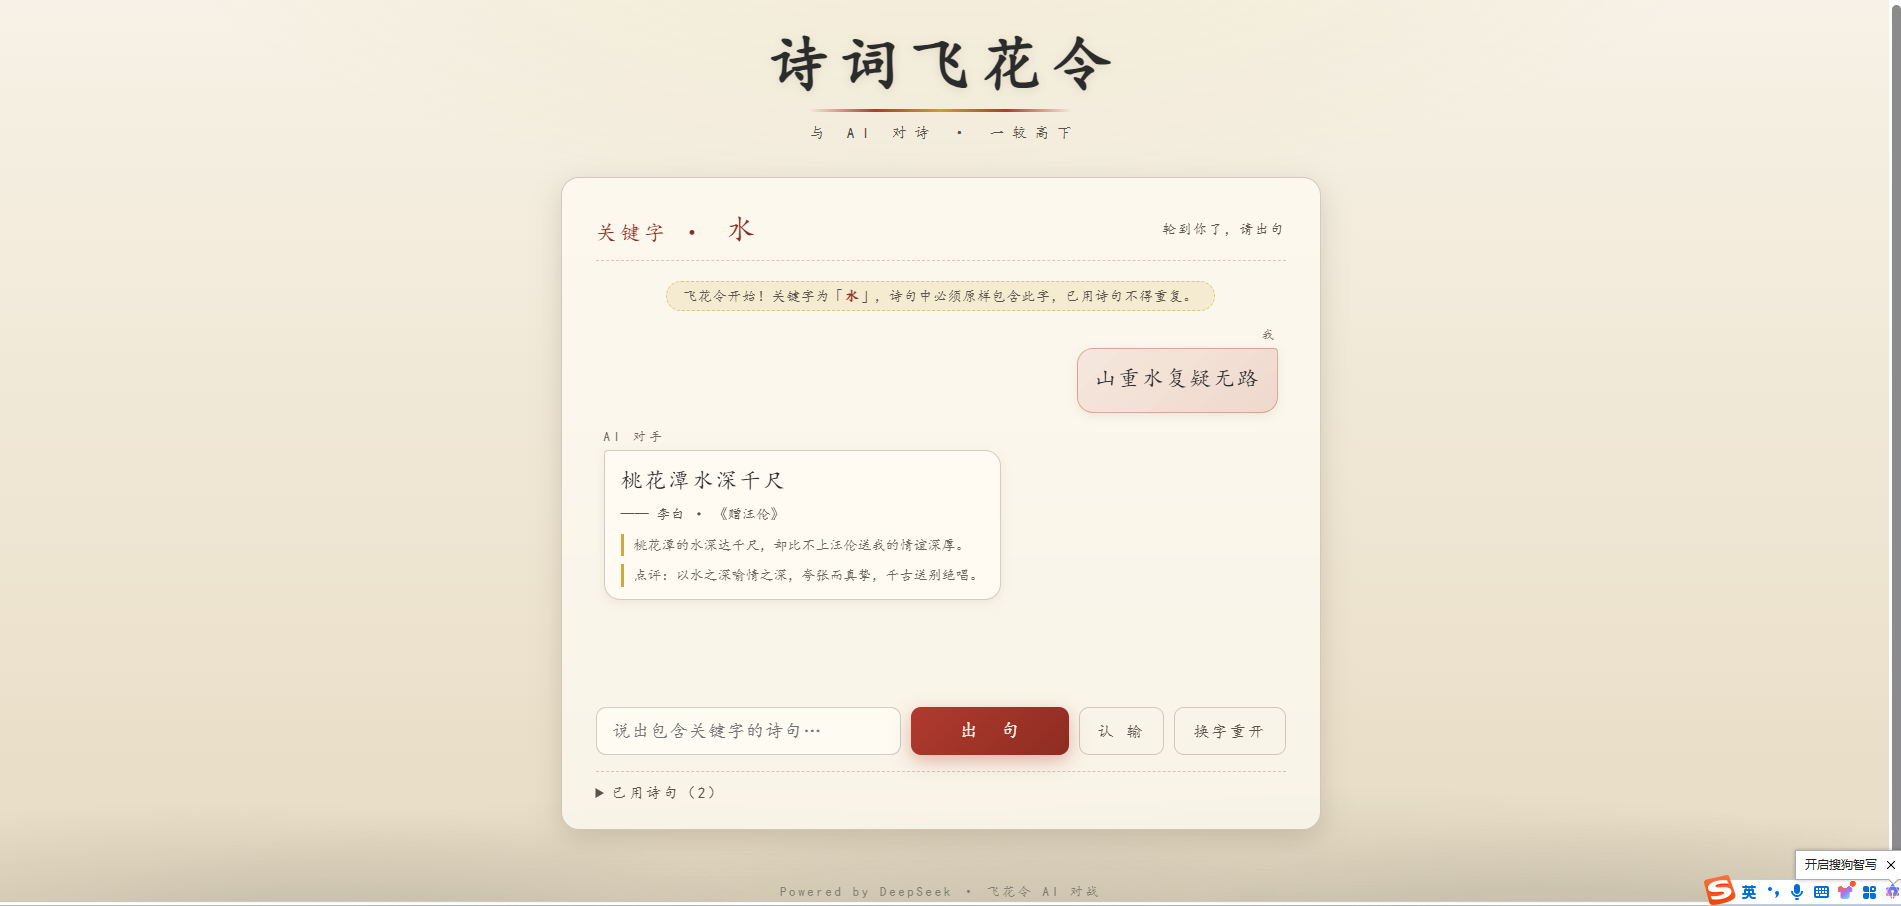
项目从零开始,最终交付为一个零构建、零后端的纯前端网页:选一个字,点开始,AI 与玩家你一句我一句地对诗,附上作者、出处、释义与点评;说不上来的那一方认输,游戏结束,随时可以换字重开。
二、项目速览:它到底能做什么
在展开技术细节之前,先看看这个项目交付了哪些能力:
- 关键字自由选择:内置十五个常用飞花字(花、雪、月、风、云、山、水、春、秋、夜、江、天、酒、雨、心),也支持直接输入任意汉字,满足自定义难度。
- 双先手模式:玩家先出句,或者让 AI 先手开局,两种节奏各有趣味。
- 流式对答:对接 GitCode AI 开放接口,采用 SSE 流式传输,AI 的诗句逐字"写"在屏幕上,像真人吟诗一样有节奏感。
- AI 双重身份:AI 既是你的对手,也是这一局的裁判——它会判定你的出句是否合规(是否包含关键字、是否重复、是否疑似杜撰),不合规时明确说明原因。
- 结构化展示:AI 按约定的 JSON 协议返回诗句、作者、出处、白话释义与点评,页面分栏渲染,读起来像一本小型的诗词鉴赏卡。
- 诗句去重:对局中所有用过的句子都会被记录,无论玩家还是 AI 都不可重复使用。
- 完整胜负闭环:玩家可以随时认输;AI 在若干回合之后有小概率"江郎才尽"主动认输,让玩家有真切取胜的机会。
- 换字重开与再来一局:一局结束随时换题目、换对手,对战节奏完全由玩家掌控。
整个页面在移动端与桌面端都有良好的响应式表现,打开即是水墨画卷风。
三、技术选型:为什么是"零构建"纯前端
在技术选型上,我几乎没有犹豫地选择了最朴素的一条路:原生 HTML5 + CSS3 + JavaScript,不引入任何框架、任何构建工具。
理由有三。
其一,单页即用。飞花令本身是一个轻量、有趣的单场景应用,不需要路由、不需要组件状态管理复杂体系。用原生三件套,整个项目就是一个可以双击打开的目录,部署到任何静态托管平台都能秒级上线。对于展示性的小项目,"拿起来就能跑"比"架构先进"重要得多。
其二,学习与演示价值。这个项目的一个重要用途是展示"浏览器如何直连大模型",过多的工程封装反而会掩盖核心脉络。把 API 调用、流式解析、协议设计这些东西平铺在几个 JS 文件里,读者可以顺着代码把整条链路看得明明白白。
其三,可控性。浏览器直连大模型本身就充满了不确定性——CORS 策略、流式解析的边界、AI 输出的稳定性,这些都需要精细地逐行处理。原生环境让我们对每一行代码都有完整的掌控,排查问题也最直接。
当然,“零构建"不等于"零设计”。界面上我投入了相当多的心思:宣纸底色的渐变、朱砂色的印章感按钮、金山色的分隔线,以及用多层 radial-gradient 叠加出的山峦剪影背景,都是为了营造"诗会"的古雅氛围,让玩家在动笔之前就进入状态。
四、让 AI 开口之前:从 Python 到 JavaScript 的接口迁徙
4.1 GitCode AI 开放接口
项目背后对接的是 GitCode AI 开放接口,协议上与 OpenAI 的 Chat Completions 兼容:
POST https://api-ai.gitcode.com/v1/chat/completions
Authorization: Bearer <API_KEY>
Model: deepseek-ai/DeepSeek-V4-Flash
选它看中的是两点:接口完全兼容 OpenAI 生态,资料可参考、工具可复用;模型能力足够支撑"裁判 + 接诗"这种需要理解和创作并重的任务。
4.2 原始的 Python 示例
这套方案的官方示例是 Python 的,使用 requests 库以流式方式读取:
def query(payload):
    response = requests.post(API_URL, headers=headers, json=payload, stream=True)
    for line in response.iter_lines():
        if not line.startswith(b"data:"):
            continue
        if line.strip() == b"data:[DONE]":
            return
        yield json.loads(line.decode("utf-8").lstrip("data:").rstrip("/n"))
这段代码的骨架是清晰的:逐行读取、过滤非 data 前缀、识别结束标记、逐条 yield。真正的挑战在于把它搬到浏览器里——浏览器没有 requests,没有迭代器语义的流式读取,跨域、断流、解码都是新问题。
4.3 JavaScript 版的等价实现
浏览器端的答案组合拳是:fetch 发起流式请求 + ReadableStream 逐块读取 + TextDecoder 增量解码 + 手工的行缓冲解析。移植后的核心如下:
const reader = resp.body.getReader();
const decoder = new TextDecoder("utf-8");
let buffer = "";
while (true) {
  const { done, value } = await reader.read();
  if (done) break;
  buffer += decoder.decode(value, { stream: true });
  let idx;
  while ((idx = buffer.indexOf("\n")) !== -1) {
    const line = buffer.slice(0, idx).replace(/\r$/, "").trim();
    buffer = buffer.slice(idx + 1);
    const chunk = parseLine(line);   // 解析单行 SSE
    if (chunk === "DONE") return;
    if (chunk) onDelta(chunk);       // 增量交付给 UI
  }
}
三处移植要点值得展开:
一是行缓冲。网络报文不可能恰好按行到达,半行数据会残留在 buffer 里,必须积攒到换行符才能切出一条完整的 SSE 行,切完要记得把已消费部分从 buffer 移除。这是流式解析最容易出错的地方。
二是结束与空行。SSE 协议的标准结束标记是 data: [DONE],而官方 Python 示例里还兼容了不带空格的 data:[DONE],两者都要识别。此外标准 SSE 每两条数据之间会有空行,必须跳过长度为零的行,否则会被误判。
三是增量结构。每个 chunk 的 payload 形如 choices[0].delta.content,内容会以切片形式陆续送达。翻译成人话:AI 每生成几个字,就推一次,我们收到多少就渲染多少,于是有了"打字机"效果。顺带一提,实测中这个模型还会先输出 reasoning_content(思考过程)再输出正文,解析时只取 content 即可,思考部分既不需要展示也不必打断。
至此,一行 requests 的流式迭代,等价地长成了浏览器里十几行 fetch + 手工解析。语境的转换如此之大,而接口骨架上竟保持了惊人的对称——这本身就是一件值得记录的事。
五、核心设计:一套"讲得清楚"的 JSON 协议
让大模型"开口"容易,让它"好好说话"却需要精心设计。最初我试过直接让 AI 自由发挥回答,结果是输出里夹杂点评、符号和无关文字,前端很难稳定地拆解成"诗句 / 作者 / 出处 / 释义 / 点评"这样整齐的卡片。
于是我把系统的规范核心改成了结构化输出协议:在系统提示词里,明确要求 AI 只输出一个合法 JSON 对象,并逐字段约束含义与边界。协议如下:
{
  "player_passed": true,
  "fail_reason": "",
  "poem": "你接的诗句",
  "author": "作者",
  "source": "作品名",
  "translation": "该句白话释义",
  "comment": "一句简短点评"
}
各字段的分工,其实就是整个游戏规则的形式化:
| 字段 | 职责 |
|---|---|
player_passed | 裁判判定:玩家本轮诗句是否合规(布尔值) |
fail_reason | 不合规时的原因:未含关键字、重复、疑似杜撰等 |
poem | 对手的接句:新的、不重复的、必须含关键字的真实诗句 |
author / source | 诗句的作者与作品名,用于生成鉴赏卡片 |
translation | 白话释义,帮助玩家理解句意 |
comment | 一句话点评,让对局带点人味儿 |
为了让 AI 稳定地遵守协议,系统提示词里写了五条硬约束:
- 只输出 JSON:禁止任何解释、前后缀与 Markdown 代码块;
- 规则先行:重申飞花令的两条铁律——句中必须原样包含关键字、不得重复已出现诗句;
- 判定与接诗的双重义务:玩家出句后,先判定其合规性,再完成自己的接句;
- 诚实的认输出口:实在无诗可接时,允许输出空 poem 并在 comment 中坦率认输;
- 字段的极端情况:判定不合规时其他字段填空字符串,避免产生脏数据。
设计这套协议时,我特别在意"把脏情况前置处理":与其相信模型永远输出完美 JSON,不如在协议里就把各种边界情况预订好位置——empty 字段、fail_reason、认输出口,这些都是在真实对局中必然会发生的情况。
5.1 容错解析:把 AI 的"任性"兜住
即使有了清晰的协议,大模型的输出依然可能带点"小脾气":偶尔包裹 ```json 代码块围栏,偶尔在 JSON 前后夹带一句解释。因此前端在解析上做了三层容错:
function extractJson(text) {
  let s = (text || "").trim();
  const fence = s.match(/```(?:json)?\s*([\s\S]*?)```/i);
  if (fence) s = fence[1].trim();     // 第一层:剥掉代码块围栏
  const start = s.indexOf("{");
  const end = s.lastIndexOf("}");
  if (start !== -1 && end > start) s = s.slice(start, end + 1); // 第二层:截取 JSON 主体
  try {
    return JSON.parse(s);              // 第三层:严格解析
  } catch (e) {
    return null;
  }
}
解析失败也预留了妥帖的降级路径:该轮不计入对局,把 AI 的原文原样展示出来,再提示玩家重新出句。宁可让一局暂停,也不让脏数据破坏对局的状态。
六、飞花令的游戏逻辑与前端渲染
6.1 一段清晰的回合状态机
整个对局可以抽象成三个阶段的循环:准备(选关键字、定先手)、对战(轮流出句)、结算(一方认输)。在代码里我维护了一个轻量的全局状态对象,记录关键字、先手方、历史诗句、对话上下文与忙碌标记:
const state = {
  keyword: "",
  playerFirst: true,
  history: [],      // { by: 'player'|'ai', poem, author, source, translation }
  messages: [],     // 传给 AI 的对话上下文
  busy: false,      // 请求进行中,锁定输入
  ended: false,     // 对局是否已结束
};
busy 这个标志位非常重要:AI 流式对答期间必须锁住输入框与按钮,否则玩家手快连点,多个请求并发,状态必然错乱。
6.2 本地优先:把规则前置校验
对战开始后,玩家的每次出句都要先过一遍本地校验,规则有三条:诗句不能为空;必须包含当前关键字;必须是本局尚未出现过的句子。前两条即时拦截明显违规的回车,第三条则依赖一个持续增长的 history 数组做查重。
这个"本地优先"的设计有一个直接收益:大多数明显违规(不含关键字、重复)根本不需要浪费一次 AI 调用,既省流量又省时间,玩家马上能获得即时反馈。
6.3 AI 的双重身份:裁判与对手
每一轮对战,前端构造的用户消息都会附上当前的历史诗句清单,并要求 AI 完成两件事:先判定玩家出句是否合规,再给出自己的接句。于是 AI 在一次对话里同时履行了裁判与对手的双重义务。
这个设计有一个微妙的好处:判定权在 AI 手里,但标准是透明的。当 AI 判定玩家诗句不合规(例如疑似杜撰)时,会把原因写进 fail_reason,前端以系统消息的形式展示出来。玩家得到的不是一个生硬的"你错了",而是一句具体的理由——这更有裁判的质感。
值得注意的是,我在规则里做了一个刻意的"宽容"处理:玩家被判不合规不会直接判负,只是提示原因并允许重新出句。这样对局更像耐心的陪练而非冷酷的裁决,对新手友好得多。真正的胜负只发生在两种情形:玩家主动认输,或 AI 无诗可接。
6.4 让玩家有赢面的小机关:“江郎才尽”
这里必须坦白一个有趣的工程决策。纯粹按真实飞花令规则对弈,以深谙全唐诗库的大模型之博闻强识,人类玩家几乎永远没有赢面——那不是"对战",而是单方面的碾压,游戏性为零。
为了让玩家拥有真实的胜利体验,我加入了一个小机关:开局若干回合(默认 8 回合)之后,AI 每轮有 15% 的概率"江郎才尽",坦率认输。输赢机制由此形成了一个完整环:玩家认输则 AI 胜,AI 认输则玩家胜;而短短的认输台词也用数组做了随机,每次认输的理由都不重样。
这个设计是否"作弊"?我认为不算。它本质上是把"对手强度"做成了可配置的游戏参数——AI_SURRENDER_AFTER 与 AI_SURRENDER_CHANCE 都暴露在配置文件中,想要一个永不言败的 AI,把概率设为 0 即可。真正的游戏设计,本来就应该为玩家保留"赢的可能性"。
6.5 水墨界面:让浏览器"雅"起来
视觉上,我刻意避开了科技感的冷白与霓虹,转而打磨一套水墨古风的视觉语言:
- 色彩体系:宣纸米白渐变打底,墨色为正文,朱砂红做主按钮与关键字,点缀金色分隔线;
- 背景层次:四层
radial-gradient叠加,在页面底部渲染出淡墨山峦的剪影; - 字体选择:优先楷体(KaiTi),退而求其次用宋体系,从字形上自带书卷气;
- 交互细节:关键字做成"印章"式的圆角按钮,点击有上浮反馈;AI 思考时使用三圆点呼吸动画,诗句逐字涌现。
对整个对局包了一个"键盘斜纹"式的心思:玩家气泡偏右、带朱砂浅染底,AI 气泡偏左、留白底带黑墨边框——一左一右,像对坐饮酒的两个人。
6.6 一局对弈的完整回放
用最传统的关键字「花」来模拟一局。开局若选择玩家先手,你在输入框敲下"花间一壶酒",这句诗会以玩家气泡出现在右侧,随后进入 AI 的思考时间:状态栏亮起"AI 对诗中…",气泡里三个朱砂色圆点一明一灭地呼吸,大约一两秒后,诗句像被人提笔书写一般逐字出现在左侧气泡里——“花开堪折直须折”,下方跟着一行小字标注作者与出处,再往下是白话释义的墨绿引用条,最后缀上一句俏皮的点评。一气呵成,像极了一场真正的以诗会友。
之后的回合循环往复:玩家再说一句,AI 判断、点评、再回一句;底部"已用诗句"的计数不断跳动,防重复的枷锁也就越来越紧。若玩家一时接不上,可以痛快地点击"认输",结算弹层会拱手把胜利判给 AI;若对战进行到第七八个回合,AI 偶尔会在这时显出"江郎才尽"之态,留下一句"才疏学浅,这一局我接不上了,甘拜下风",主动认输——那一刻,玩家会真切地感到,自己用诗词逼退了对手。
值得一提的是,整个对局中玩家说出的每一句诗,其实都在接受双重审查:前端即时拦截不含关键字与重复的明显错误,后端再由 AI 判断诗句是否真实可信。两道审查之间,玩家对"规则"的感受是透明的:被驳回时,永远看得到具体理由。
七、踩过的坑与解决思路
没有哪个真实项目是"一次写对"的,这个项目也不例外。几个值得一提的坑:
7.1 流式解析的"半行"陷阱
第一版解析器直接把每次读到的一段文本按行切分去解析,结果 AI 回复经常莫名其妙地"卡壳"——原因就是网络块边界切在了行中间,后半行被丢弃。解决方式就是前文提到的行缓冲:把未消费的尾部保存下来,与下一次读取拼接后再继续切行。这个 bug 几乎每个手写流式解析的人都会踩一遍,教训是:网络层交付的是"块"(chunk),应用层需要的才是"行"(line),中间的转换必须显式完成。
7.2 思考字段的噪音
实测发现该模型输出会先走一段 reasoning_content(内部思考),若解析逻辑不加以过滤,思考文字会被当成正文渲染到气泡里,用户会看到"我们只需要输出 JSON "之类的碎语。处理很简单:增量解析只认 delta.content,其余字段一律忽略。
7.3 AI 输出不稳定
即便是经过严格提示词约束的模型,偶尔也会输出代码块围栏或夹带解释。前文的容错解析(剥围栏、截主体、严格解析三级降级)已托底,同时在代码里为"解析失败"准备了完整的异常分支:撤销本轮玩家诗句、展示原文、提示重试——任何一层保护,都可能是一次真实救场。
7.4 CORS:浏览器直连的天然屏障
这是纯前端方案绕不开的痛点。浏览器对跨域 fetch 自带同源限制,当页面部署在本地服务器上直接请求 api-ai.gitcode.com 时,会受到目标站点 CORS 策略的约束。项目在 README 中明确给出了三条备用路径:本地反向代理(如 nginx)、把密钥转发收敛到自建后端、或借助允许自定义请求头的跨域调试工具。这条"坑"严格说不算项目缺陷,而是所有纯前端大模型应用必须面对的先天约束,值得每个开发者提前知晓。
7.5 明文密钥的风险意识
另一个必须正视的问题是:纯前端代码里的 API 密钥对用户完全可见。本项目的密钥以示例配置内置于 js/config.js,这在教学与演示场景下是合理的,但 README 里我也诚实地标明了生产环境的三条改进路径:更换为个人密钥、收敛到后端代理、或迁移到服务端调用。技术文章有责任把"可以这样做"和"应该怎样做"一起讲清楚。
八、验证与测试:让每一步都有据可依
项目交付前,我做了三层验证:
第一步,语法层:三个 JS 文件全部通过 node --check 语法检查,确保没有低级错误。
第二步,合约层:写了一个独立的验证脚本 test_api.mjs,用与页面一致的系统提示词与参数真实调用接口,核对返回内容。实测结果是一次标准的协议输出:
{
  "player_passed": true,
  "fail_reason": "",
  "poem": "花开堪折直须折",
  "author": "杜秋娘",
  "source": "《金缕衣》",
  "translation": "花开时可以折取就要折取,不要等到花谢时只折空枝。",
  "comment": "劝人惜时,与李白的独酌之趣相映成趣。"
}
七个字段无一缺失,parsed 成功。这一步的意义在于:接口契约是否成立,不靠猜,靠跑。 脚本现在也保留在仓库里,之后任何一次改动,都可以用它做回归验证。
第三步,资源层:本地起静态服务器逐资源核对,五个页面资源全部返回 200,确保部署后没有任何一个文件路径断裂。
第四步,体验层:在多种窗口尺寸(桌面宽屏与手机窄屏)下反复试玩,重点核对三类场景——AI 先手开局、玩家长句输入、以及"AI 认输"结算弹层的展示效果。响应式断点下的按钮换行、气泡宽度、关键字印章的缩放都在这一轮做了收尾打磨。这份手测清单没有自动化,但对交互类项目而言,真实的点击与等待本身就是最好的回归测试。
九、项目结构与你该如何上手
最终交付的目录结构如下:
feihua_project/
├── index.html          # 页面骨架:准备 / 对战 / 结算三阶段
├── css/
│   └── style.css       # 水墨古风样式
├── js/
│   ├── config.js       # 配置:接口地址、密钥、模型参数、认输概率
│   ├── ai.js           # 接口封装:fetch + SSE 流式解析
│   └── game.js         # 游戏逻辑、AI 裁判协议、渲染
├── test_api.mjs        # 独立接口验证脚本
└── README.md           # 玩法、协议契约、部署与常见问题
想要亲手玩一局,只需要三行:
git clone https://atomgit.com/zkzk33/feihua_project.git
cd feihua_project
python -m http.server 8000
然后打开 http://localhost:8000,选一个心仪的字,点击"开始对战"。想部署上线,整个目录直接拖到任意静态托管平台即可。
十、写在最后:一条可以复用的路线图
回看这个项目,它最有价值的产出或许不是飞花令本身,而是一条**"浏览器直连大模型做交互应用"的完整路线图**:选一个规则清晰的玩法(飞花令)、约定一套结构化的输出协议(JSON 契约)、适配流式传输的解析链路(SSE)、设计托底的异常处理(容错与降级),最后用恰当的视觉语言包裹起来(水墨风)。
这套方法论完全可以迁移到任何题材:成语接龙、对联生成、诗词翻译、故事接龙……协议换一换,玩法换一换,骨架几乎原样可用。
未来如果继续演进,我有三个方向:一是把密钥收敛到后端代理,解决明文与 CORS 两个痛点;二是引入难度分级与计分系统,让对战更有竞技感;三是支持多关键字与"行飞花令"等变体玩法,让千年雅令在数字时代焕发更多生命力。
最后,也把这句话送给每一位读到这里的开发者:好玩的项目,通常都始于一个"如果……会怎样"的念头。 如果你也跃跃欲试,不妨从选一个字开始。
—— 飞花令开源仓库:https://atomgit.com/zkzk33/feihua_project

汇聚全球AI编程工具,助力开发者即刻编程。
更多推荐

 1
 0
- 0


 已为社区贡献1条内容

所有评论(0)