
码道 · 我把「故事接龙」变成了一款纯前端 AI 应用
项目:故事接龙 AI 对话 | 技术栈:HTML5 + CSS3 + 原生 JavaScript | 2026-09-18
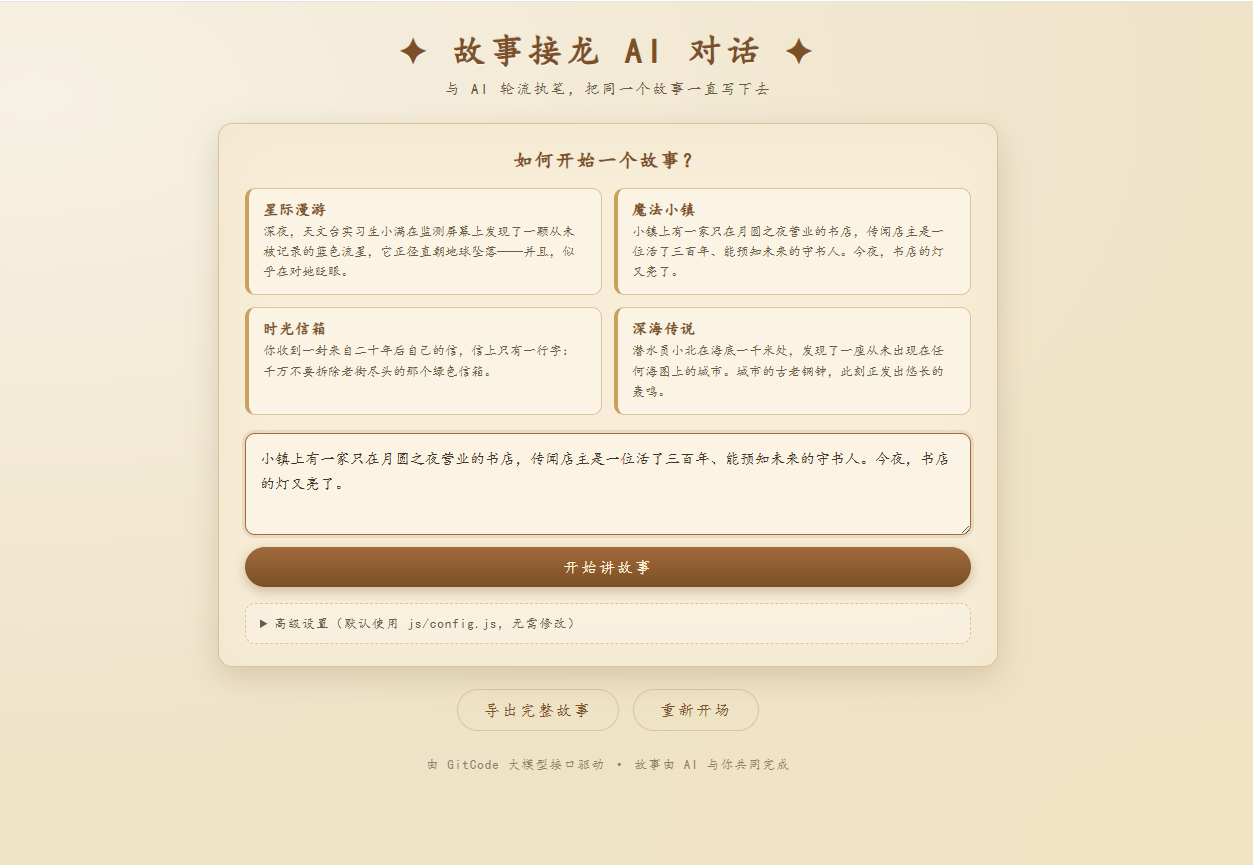
项目实例图:
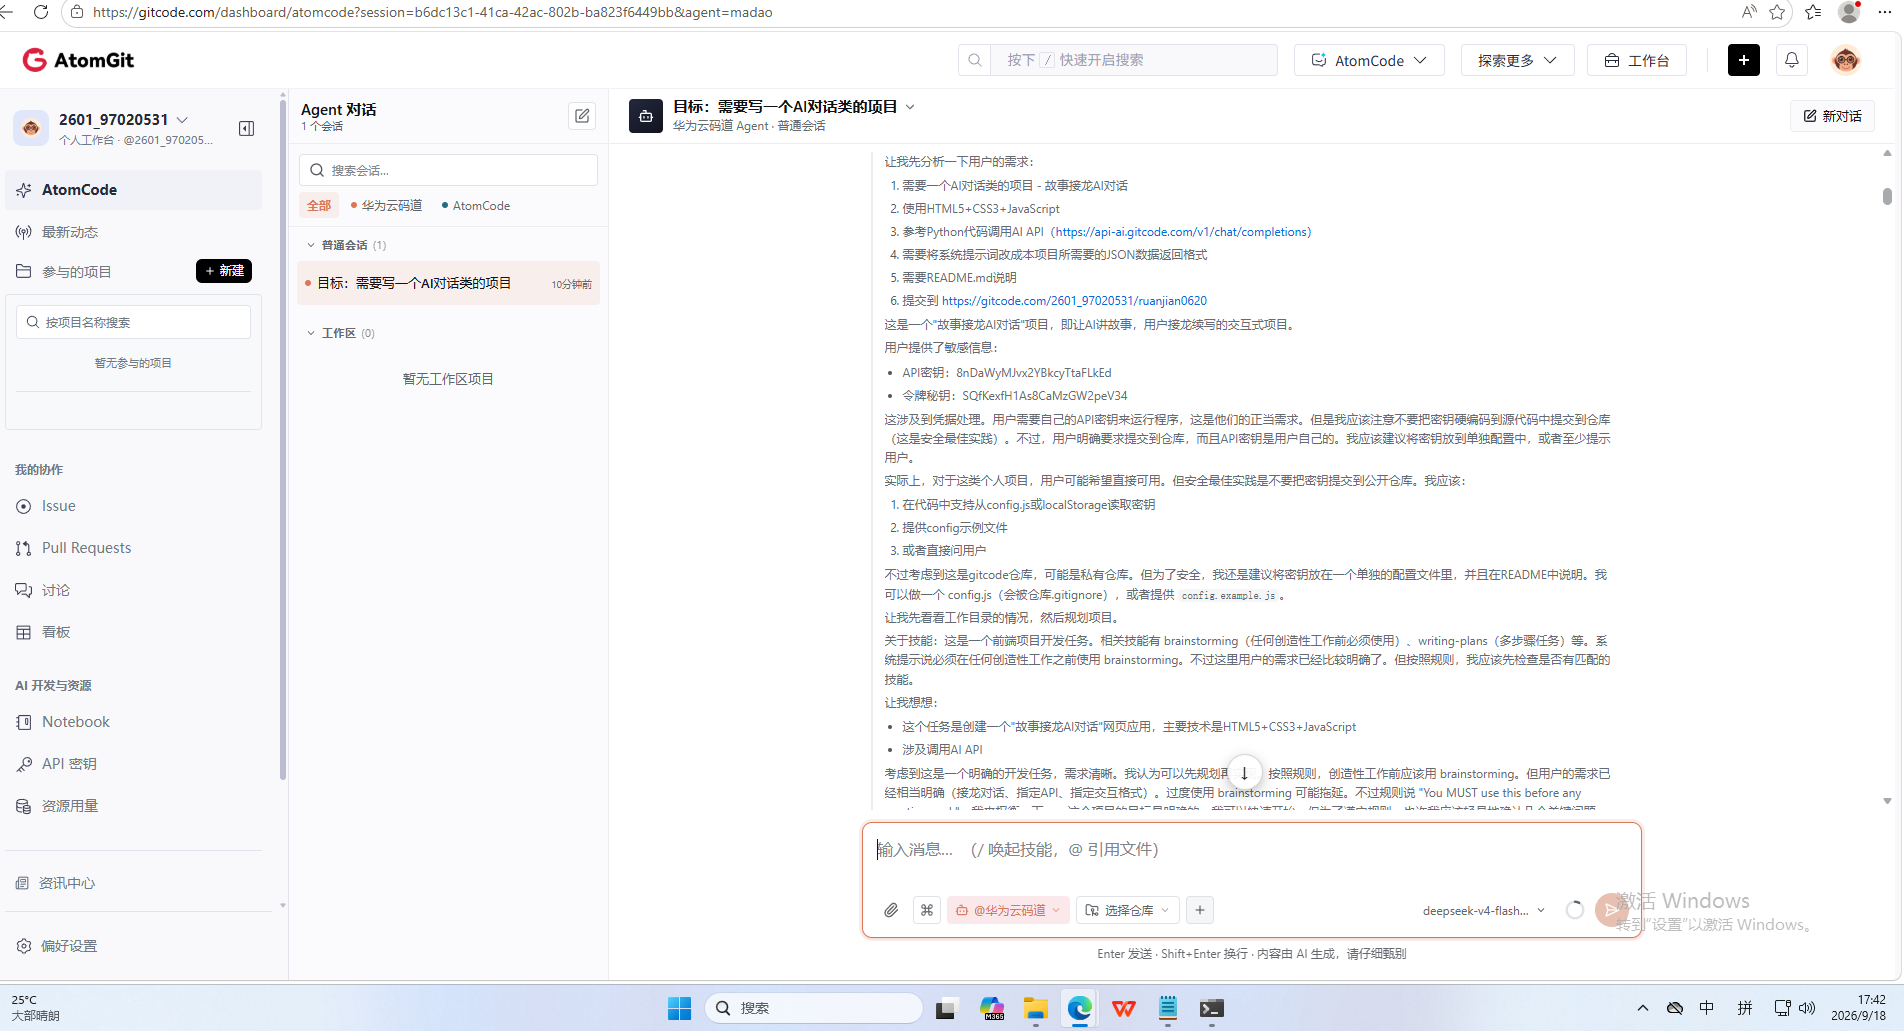
使用工具:
一、故事的种子:为什么要做这个故事接龙项目
小时候我们大概都玩过一种游戏:一群人围坐成一圈,第一个人起个头,第二个人顺着这个开头编下去,第三个人再接着第二个人往下讲……一个谁也不知道结局的故事,就这样在七嘴八舌中一点一点长出来。有人把情节拐去外太空,有人让主角突然学会魔法,跑题了也不怕,因为接龙的美妙之处就在于「意想不到」。
我一直想把这种游戏搬到电脑上,让 AI 来做那个最会讲故事的队友。恰好手里有一份 GitCode 大模型接口的调用示例,接口是 OpenAI 兼容协议,支持流式输出,读起来顺手。于是我问自己:能不能只用最简单的前端技术,做出一个体验完整的「故事接龙 AI 对话」应用?
答案是可以,而且可以做得相当完整。本文就把这个项目的完整思路、关键实现和踩过的坑记录下来,既是技术笔记,也是这份作品的自白。
二、需求拆解:先把「接龙」这件事讲清楚
接手一个需求之前,先不要急着写代码,先把需求本身翻译清楚。我把这个项目拆成了几层:
第一层是「玩法」。故事接龙的核心是轮流执笔:AI 讲一段,用户续写一段,AI 再顺着用户的剧情往下讲,循环往复。注意这里强调的是「顺着」,而不是「重写」。AI 不能每次重新起一个炉灶,需要承接上文,保持人物、地点、情绪的连贯。这决定了系统提示词和上下文历史的设计方式。
第二层是「数据」。如果 AI 每次只甩来一段光秃秃的文字,页面就只能把它整段贴出来,谈不上什么「更好的显示」。所以我希望 AI 除了讲故事,还能顺便结构化地告诉你:这段故事里都有哪些角色、当前适合往哪个方向续、能给用户一句什么样的接龙提示。这些信息以 JSON 的形式返回,前端拿到之后就可以把「正文」「角色标签」「提示」「建议按钮」分开展示。
第三层是「体验」。流式输出意味着 AI 一边打字一边出内容,体验上要比「等待十秒然后整段闪烁出现」舒服得多;还需要能中途停止生成;故事结束之后最好能一键导出,把一晚上的心血存下来。
第四层是「工程」。这个项目要能随手运行,不能要求用户装 Node、装构建工具。通篇只有 HTML、CSS、JavaScript 三个文件,打开浏览器就能用,这才是它的气质。
三、技术选型:为什么是「零依赖的纯前端」
选型这件事,我几乎没有犹豫。
首先是前端框架的问题。Vue、React 都很成熟,但这个项目的交互复杂度其实不高:一个轮流出场的故事流、一个输入框、一组建议标签。用框架会引入构建链,用户拿到源码还得 npm install、npm run build,推广成本立即上升。原生 JavaScript 的代码量完全能驾驭这个规模,还保留了「任何一个会打开浏览器的同学都能读懂源码」的朴素价值。
其次是后端的问题。故事接龙需要一个对话式的大模型服务,而 GitCode 提供了 OpenAI 兼容的 HTTP 接口,天然可以被浏览器直接调用。这样就省掉了自己搭中转服务的环节,真正做到「前端直连大模型」。虽然纯前端意味着 API Key 会暴露在浏览器里,但对于个人/教学项目来说,这是可以接受的权衡——只要用安全的方式管理 Key(后面专门讲)。
最后是构建的问题。零依赖、零构建、无框架、无后端,双击 index.html 就能跑,这是我给自己定下的验收标准。后来的事实也证明,这个标准让项目的「可移植性」变得极高。
四、系统提示词:让 AI 学会「结构化地说故事」
项目最核心、也最有趣的设计,是系统提示词。看过参考示例之后我发现:如果直接把一条「告诉我一个有趣的事实」这样的消息丢给模型,它确实会回复大段文字,但那些文字是「散文」,不是数据。我的页面需要的是能拆解的信息。
于是我在系统提示词里对模型做了两个约定:
第一,约定角色和玩法。提示词里写明——你是一位温暖而富有想象力的中文故事讲述者,我们在玩故事接龙,你要承接用户上一段情节继续叙述,不要重复,不要另起炉灶,每次讲 150 到 350 字。
第二,约定返回格式。字面意义上的「格式即协议」。我要求模型必须只输出一个 JSON 对象,不允许输出任何多余的文字、解释或者 Markdown 代码块标记,并且字段名固定如下:
{
  "response_type": "story_segment",
  "story": "本次讲述的故事段落文本",
  "narration_tips": "给用户的一句简短接龙提示",
  "characters": ["当前登场的主要角色名"],
  "suggestions": ["续写方向一", "续写方向二", "续写方向三"]
}
其中 response_type 用于区分「故事继续」和「故事自然收尾」两种状态;story 是给用户读的正文;narration_tips、characters、suggestions 则是喂给页面排版的数据——它们分别对应 UI 里的提示气泡、角色标签和可点击的续写建议芯片。
前端的解析器也做了防御设计:自动剥离可能出现的 ```json 代码块包裹,从第一个 { 截取到最后一个 },这样即使模型偶尔「不守规矩」多说了几个字,我们也能把 JSON 主体完整拎出来。万一整个解析彻底失败,页面不会崩溃,而是把原始输出降级当作普通故事段落展示。好用和健壮,在这里是一体的。
五、前端如何调用大模型:把 Python 流式示例翻译成 JavaScript
参考示例是一段 Python 代码:用 requests 向接口发起流式请求,再逐行解析 data: 前缀的 JSON。把它翻译成浏览器环境的 JavaScript,其实并不困难,核心就三步。
第一步,构造请求。用 fetch 发 POST,请求头带上 Content-Type 和 Authorization: Bearer <KEY>,请求体是大模型接口认识的 JSON:模型名、消息数组、流式开关、温度、top_p 一类的采样参数。
fetch(API_URL, {
  method: "POST",
  headers: {
    "Content-Type": "application/json",
    "Authorization": "Bearer " + API_KEY
  },
  body: JSON.stringify({
    model: MODEL,
    messages: buildMessages(),
    stream: true,
    max_tokens: 2048,
    temperature: 0.6,
    top_p: 0.95
  }),
  signal: controller.signal
});
第二步,读流。响应体是一个 ReadableStream,我用 getReader() 拿到读取器,配合 TextDecoder('utf-8') 做字节到字符串的解码。流式数据是分块到达的,一个 chunk 里可能包含半行、一行甚至多行,所以必须用缓冲区把不完整的残片攒起来,凑成完整的行再处理——这是流式解析最容易踩的坑。
第三步,解析行。接口的每一条消息都以 data: 开头,我把前缀剥掉之后 JSON.parse,取 choices[0].delta.content 累加成全文。那句 Python 里 if line.startswith(b"data:")、判断 [DONE] 的逻辑,到这里就等价变成了一个小状态机。
真正的翻译工作没有悬念,动静皆宜,几天之内就把参考代码稳稳地「搬」进了浏览器。
送请求之前还有一个绕不开的环节:组装 messages 数组。我维护的对话历史是一条条结构化的记录,但在接口眼里它们只是一份有序的消息清单。组装函数的逻辑很直白:头部永远放系统提示词,然后按时间顺序把过去每一轮的用户输入和 AI 原始输出依次放进去。注意 assistant 消息放的必须是 AI 上次输出的原始 JSON 全文,而不是解析之后抽出来的 story——只有原始形态才能让模型「看到」我们上一轮到底给出了怎样结构完整的回复,上下文才完整。这个小细节在初版里被忽略了,当时的直接后果是故事从第二回起就明显「接不上」,修正之后才恢复连贯。写在这里,算是给后来者的一份避坑提示。
六、意外的惊喜:reasoning_content 与思维链的分离
调试流式输出的时候,我注意到接口返回的 delta 里其实有两个字段:一个是 content,一个是 reasoning_content。前者是模型最终说出来的话,后者是模型「内心的小剧场」——也就是常说的思维链。
对绝大部分场景来说,我们并不想让用户看到模型内心的嘀咕,用户要的是干净利落的故事情节。好在这个接口把两路内容分得很干净:思考过程走 reasoning_content,真正的话走 content。我的解析器只认 content,天然就把思维链过滤掉了。
我用一次真实请求验证了这个结论:2182 行的流式响应里,有 1053 个片段带着 reasoning 字段,而我关心的 content 只有 35 个片段,拼起来正好是一段完整的 JSON。页面上用户看到的,永远只有成文的故事情节,清爽且专注。这算是实现过程中一次意外的收获——不需要任何额外代码,就把「思考」和「讲述」隔离开来。
七、对话历史:怎么让 AI 记住我们接过的龙
故事接龙有一个天然要求:AI 必须记得此前所有的情节。如果每次请求都只带用户最新的一句话,AI 就会失忆,接出来的故事前后矛盾。
我的方案是在前端用一个 storyLog 数组记录整场对话。数组里每条记录要么是 { role: 'user', text },要么是 { role: 'ai', story, tips, characters, suggestions, raw }。raw 字段保存 AI 当时输出的原始 JSON 文本。
每次发起新的请求之前,我扫描一遍 storyLog,把它组装成 OpenAI 风格的 messages 数组:第一条永远是 system 系统提示词,然后按时间顺序交替追加 user 消息和 assistant 消息。这里有一个细节值得说明:发给模型的 assistant 消息,我用的是 raw 原始 JSON 全文,而不是解析之后的 story 字段。理由很简单——模型的上下文必须保持它「讲的话」的原始形态,这样才能看到完整的、结构化的上一轮输出,而不是我们阉割后的摘要。
对话历史的完整接入,让多轮接龙真正成立:AI 记得开场的星空,记得中段的转折,当下的续写才会自然。
八、界面:把页面做成一本书
技术之外,这个项目还有一个想要被记住的点:它的气质。我在设计阶段就决定了要做一个「暖色故事书风」的界面,把页面当成一本真正的书来排版。
配色上,整体走米黄纸感:深一层的纸面是羊皮纸色,页面正文是略微发白的书页色,文字用浓墨般的深棕,点缀用胡桃木棕和一点金棕。背景我叠加了一层 SVG 噪点纹理,配合径向渐变,模拟纸张纤维和旧书的质感。
字体的选择也花了心思。正文和标题都倾向于楷体、行楷一类的中文字体,浏览器找不到时回退到衬线字体。段落的排版参考了书刊:首字下沉,第一段的第一个字被放大成三倍字号,像古书的「卷首字」;正文两端对齐,行距拉大,营造舒适而悠闲的阅读节奏。AI 的段落和用户的接力段落用不同的样式区分——AI 执笔是正文,你的接力则用斜体加左边线的形式呈现。
交互细节上也有小设计:开场区给了四张主题卡,星际漫游、魔法小镇、时光信箱、深海传说,点击即可把故事开头填入输入框,降低「从空白开始」的门槛;AI 生成时显示一支轻轻摇曳的羽毛笔和「AI 正在书写」;生成完毕,页面会在故事下方渲染出角色标签、接龙提示和三个续写方向芯片,点芯片就能一键填入输入框。
响应式布局同样被认真对待。手机屏上的排版和桌面端是两套逻辑:主题卡从两列收成单列,按钮的圆角与字号略微缩小,底部的「导出」和「重新开场」按钮会在窄屏下拉伸成等宽的胶囊,方便单手点击。配色上我刻意不做成纯白的高对比样式,而是让纸面、书页、文字三者构成一种温和的明暗层次,长时间阅读也不刺眼。虽然只是一个教学项目,但我希望它打开的第一眼,能让人愿意多停留十分钟。
一本书,一杆笔,一段好故事——这就是我希望用户打开页面时得到的第一印象。
九、密钥管理:既不泄露,又要能用
纯前端直连大模型,最刺手的问题就是 API Key。浏览器里的一切代码用户都能看到,Key 藏在源码里等于公开。
我给项目定的规矩是这样的:密钥单独存放于本地的 js/config.js,只存在于开发者的电脑上;仓库里提交的是 js/config.example.js 模板,里面的 API_KEY 是占位符。.gitignore 明确排除了 js/config.js,从根子上防止密钥被顺手提交进仓库。
与此同时,页面还保留了一个「高级设置」折叠面板,允许用户临时粘贴自己的 Key,并支持覆盖模型名称。这样即使分发出去的源码里没有任何真实密钥,拿到项目的同学也能在页面上填入自己的 Key 直接开玩。
另外说一句题外话:如果你的项目要公开发布且对安全性有更高要求,可以用后端代理转发请求,或者使用网关托管密钥。但对这个教学向的项目来说,「本地配置文件 + 示例模板 + 页面覆盖」的组合已经足够优雅。
十、遇到的问题与对策
任何一个能跑起来的项目,背后都有几个绊脚石。这个项目也不意外,挑三个有代表性的说说。
一是 file:// 协议下的跨域问题。有些同学拿到代码后习惯双击 index.html 直接打开,结果发现请求发不出去。原因在于本地文件协议的 Origin 是 null,部分浏览器会因此拦截跨域请求。解决办法是引导用户用本地静态服务器方式运行——python -m http.server 8000 一行命令即可,我在 README 里写清楚了。实测接口对 localhost 的跨域预检是放行的,Access-Control-Allow-Origin 正确返回了来源,所以用本地服务器跑一切正常。
二是模型偶尔「不守格式」。虽然系统提示词三令五申只能输出 JSON,但模型是概率引擎,总有调皮的时候。我的对策前面提过:解析器做三层防御——剥代码块、截花括号、失败降级为纯文本。这套兜底让「格式事故」永远到不了用户面前。
三是流式中途停止。用户点击「停止生成」之后,如果响应已经累积了一部分内容,直接扔掉非常可惜。我的处理是:中止请求后,若已有内容则把它作为该回合的段落收尾并正常渲染;若尚无任何内容,则干净地移除生成中的空段落,恢复可编辑状态。两种情形都保证界面状态机不会卡死。
十一、验证:不止能跑,还要能看
写代码只是第一步,验证是更重要的半步。语法层面,我用 Node 对三个 JavaScript 文件做了 node --check,全部一次通过。
接口层面,我用 curl 同真实接口做了连通性测试,确认 HTTP 200 和 CORS 预检通过;随后用真实的系统提示词发起请求,验证了三点结论:模型确实会输出带思维链前缀的 JSON;防御式解析能从杂文中精确提取 JSON 主体;流式模式下 content 与 reasoning_content 分离干净。
我甚至用脚本完整模拟了 app.js 的流式解析程序,逐行消费真实接口返回的 2182 行 SSE 数据,最终还原出的 JSON 与模型输出完全一致。这一整套验证跑完,我才放心地把项目提交到仓库。
十二、把故事存下来:导出与收尾
故事的最后一环是「存档」。我在底部工具栏放了一个「导出完整故事」按钮,点击后前端会把整场接龙整理成一篇结构完整的 Markdown 文档:开头是你的开场白,之后是 AI 每个段落和小结,穿插你的每一次接力,末尾缀上「故事完」的落款。
实现上非常简单——遍历 storyLog 拼成 Markdown 文本,用 Blob 包装,再通过临时 a 标签触发下载,文件名自动带上当天日期。整个导出过程纯前端完成,不经过任何服务器,用户的每一个故事字都留在自己的电脑里。
导出机制虽然轻,但它把「玩」变成了「收藏」:一个晚上讲出来的故事,从此可以像真正的书一样被打开、被重读。
十三、总结与展望
回头看这个项目,它的价值不在于技术的炫技——JavaScript 翻译一位 Python 的流式调用,本身不算什么高深的事情;它的价值在于一套完整的「产品意识」:从玩法设计到数据结构,从系统提示词到前端解析,从界面气质到密钥管理,每一个环节都在为一个朴素的目标服务——让用户和 AI 轻松地、开开心心地合写一个故事。
如果要挑一两个值得记住的设计,我会选这两个:一是「格式即协议」的思维方式,用结构化 JSON 把模型输出和页面渲染解耦,让「AI 的输出」变成「可排版的素材」;二是「防御式解析」的工程态度,永远假设模型会犯错,并让前端在被冒犯时依然体面。
下一步,如果还有机会继续打磨,我想给角色标签加一点「人物档案」——让 AI 记住每个角色的性格,续写时保持一致;还想加入「多分支」玩法:AI 每段结尾给出三个岔路口,用户选择后走向不同结局,那将是另一种游戏;也想做一个轻量的本地历史存档,让之前的接龙可以随时被翻出来继续。
当然,最重要的从来不是功能列表,而是故事本身。当深夜的天文台、月圆的书店、无人的深海城市在页面上一段一段长出来的时候,我知道这个项目成了。
如果你也拿到了这份代码,不妨打开 index.html,输一句「深夜,我捡到一张通往月球的旧车票」,剩下的,交给 AI。
附:给代码阅读者的一张地图
如果你打算阅读这份代码,这里给你画一张小地图,帮你快速找到每一块重要的拼图。
整个页面只有三个文件。index.html 最薄,它只负责搭骨架:开场区、书页区、接龙输入区、底部工具栏,所有后续要操作的元素都通过 id 暴露出来。你要关心的样式全在 css/style.css 里,从页面配色到首字下沉,从主题卡到羽毛笔动画,都在这里面,改起来就像改一本书的装帧。
核心逻辑集中在 js/app.js,我按阅读顺序给你指几个函数名。入口是文件末尾的 init(),它负责挂事件和铺主题卡;startStory() 是整场游戏的第一声发令枪,把开场白写进 storyLog 之后调起 generateStory();generateStory() 负责创建本回合的故事段落容器,并调用 streamChat() 发起流式请求。streamChat() 是整个项目的心脏:它完成 fetch、按行解析 SSE 数据、把 delta.content 一点点累加,同时通过回调把增量推给渲染函数。等流结束,parseAIResponse() 对完整文本做防御式 JSON 提取,finishGeneration() 再负责把解析结果落位到页面:故事正文进书页,角色标签和接龙提示进信息面板,续写方向变成可点击的芯片。
值得停下来多看一眼的地方有两处。第一处是 clearStatus() 那几行:它负责在首个增量到达时把「AI 正在书写」的提示从段落里优雅地摘掉,避免生成中提示和正文混在一起。第二处是错误总入口 showError():页面顶部那条红色横幅的所有手动关闭逻辑都收拢在这里,统一了出错体验。
最后提醒一句:js/config.js 不随仓库提交,本地首次运行时请复制 js/config.example.js 改名成它,再填入你的密钥。
附录:项目信息
- 项目名称:故事接龙 AI 对话
- 技术栈:HTML5、CSS3、原生 JavaScript,零依赖、零构建
- 接口:GitCode 大模型接口(OpenAI 兼容协议)
- 仓库:https://gitcode.com/2601_97020531/ruanjian0620
- 文件结构:index.html / css/style.css / js/app.js / js/config.example.js / README.md / docs

汇聚全球AI编程工具,助力开发者即刻编程。
更多推荐

 1
 0
- 0


 已为社区贡献1条内容

所有评论(0)