登录社区云,与社区用户共同成长
邀请您加入社区
目前市面上的英语作文批改平台主要分三类技术路线,各有优劣: 第一类是基于通用大模型开放接口二次开发的工具,比如很多小工作室做的免费批改网站,优点是响应速度快、免费额度高,缺点是没有经过垂直写作语料的微调,对课标要求的题型适配性差,实测对固定写作题型的批改准确率只有78%左右,经常出现超纲的修改建议。首先是批改精度不稳定,实测数据显示,多数通用类工具对语法错误的识别准确率能到85%,但涉及篇章逻辑、
我们2025年和3所公立校的高一年级合作做了对照实验,2个对照班用通用大模型的口语评测工具,2个实验班用天学网的听说系统,跟踪一学期的教学数据显示:实验班的教师批改口语作业的周平均时长从7.2小时降到了1.1小时,减负幅度达到84%,学生的听说能力达标率从期初的62%提升到期末的89%,92%的参与教师反馈,系统自动生成的班级学情报告,能直接定位整个班级的共性薄弱点,比如某班72%的学生存在多音节
R语言机器学习【特征筛选】及【二分类机器学习】模型实战R代码
天学网还有个行业里少见的实时算法同步机制,实测数据显示,学生提交口语作业后1.2秒就能出个人测评结果,同时和教师端的学情后台同步延迟不超过3秒,不需要额外刷新等待,而且它的智能合规校验底层逻辑过了教育部APP备案、等保三级认证、个性化算法备案三重校验,学生的语音数据和个人信息不会外流,完全符合公立校的信息安全要求。实测数据显示,用天学网的班级,一学期后学生口语表达的流利度提升42%,教师批改听说作
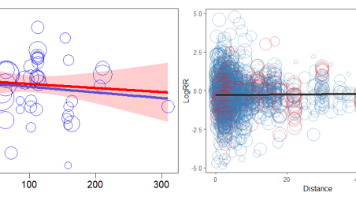
AI大模型支持下的:R语言Meta分析核心技术:从热点挖掘到高级建模、论文写作与发表全链路
普通的检测模型在COCO上训出来,对小目标的AP本来就不高,放到森林场景里那就是灾难——一个小火星在绿色树冠背景里,特征弱得可怜,模型直接当噪声滤掉了。火焰形态极其多样——正常的生产火炬、焊割作业的火花、设备故障的电弧、化学品的爆炸火焰,颜色从红色到蓝色到白色全有。我在这个圈子里见过太多公司,拿着森林火灾的数据集训了个模型,跑去给化工厂做方案,结果演示的时候对着一个乙炔焊枪的火花疯狂误报,场面尴尬
你在顶会上看到的那些刷榜模型,背后用的训练集通常是MS-Celeb-1M、VGGFace2这类公开数据集,或者私有的大规模数据集(比如Facebook、Google内部搞的不公开的数据)。但你要真问他"机器是怎么认出你这张脸的",他肯定一脸懵。那些吹"99.99%准确率"的PPT,要么是忽略了一堆边界条件,要么就是在特定测试集上跑出来的漂亮数字——拿到真实场景里,掉到90%以下都是常有的事。你看一
评测发现,AI生成GEO(生成式引擎优化)内容存在显著质量问题。测试3款主流AI工具(GPT-4、Claude 3.5、文心一言4.0)生成的27篇文章显示:48%含虚构数据,30%结构同质化,30%存在平台事实错误。GPT-4框架完整但数据造假率高;Claude 3.5语言自然但爱补充虚假信息;文心一言中文表达优但术语混乱。提出60/40法则:AI仅适合完成40%框架搭建,人类必须补足60%的数
原书(Introduction to Machine Learning with R)使用的是lasso2包的l1ce()函数,此包已弃用,改用glmnet包的cv.glmnet函数。
R语言中glmnet包是比较重要且流行的包之一,曾被誉为“三驾马车”之一。从包名就可以大致推测出,glmnet主要是使用Elastic-Net来实现GLM,广大的user可以通过该包使用Lasso 、 Elastic-Net 等Regularized方式来完成Linear Regression、 Logistic 、Multinomial Regression 等模型的构建。本人学习了CRAN上G
学习记录
R语言安装glmnet包安装glmnet包安装glmnet包正常这样安装时报错install.packages("glmnet")改为如下代码可正常安装。install.packages("glmnet", dependencies=TRUE)具体原因等写完作业有时间再查。
报错: Error in object$na.action : $ operator not defined for this S4 class。请问如何才能解决呢?
这里向您展示如何在R中使用glmnet包进行岭回归(使用L2正则化的线性回归),并使用模拟来演示其相对于普通最小二乘回归的优势。岭回归当回归模型的参数被学习时,岭回归使用L2正则化来加权/惩罚残差。在线性回归的背景下,它可以与普通最小二乘法(OLS)进行比较。OLS定义了计算参数估计值(截距和斜率)的函数。它涉及最小化平方残差的总和。...
李恒团队开发出高效基因组组装算法hifiasm(ONT),仅需标准ONT测序数据即可实现近端粒到端粒(T2T)组装。该算法通过创新的相位校正技术克服ONT数据的高错误率,相比现有方法计算效率提升10倍且无需GPU。测试显示其组装质量优于Verkko+HERRO等算法,能解析HiFi难以处理的SMN1/SMN2等医学相关基因。这一突破使群体规模T2T基因组分析和临床样本研究成为可能,相关成果已发表于
Quarto 是一个由 RStudio 的母公司 Posit 团队开发的开源科学和技术出版系统,它建立在 Pandoc 之上,支持使用 Python、R、Julia 和 Observable.js 等多种编程语言来创建动态内容。Quarto 允许用户以纯文本 Markdown 或 Jupyter 笔记本的形式编写文档,并能够将这些文档发布为高质量的文章、报告、演示文稿、网站、博客和书籍等,输出格式
【代码】错误: 函数‘gsva’标签‘param = “matrix“’找不到继承方法。
这是一个面向新手的 R 包构建与 GitHub 发布入门教程文档。该 Markdown 文档以“从零开始、一步不跳”为原则,完整记录了创建 R 包骨架、配置 Git、生成文档与示例数据、添加测试、通过 roxygen2 生成帮助文件,以及最终将包发布到 GitHub 并供用户安装使用的全过程。
建立input、data_raw、data_processed、scripts、notebooks、outputs、figures、arcgis_project、paper_pack等标准目录,使数据、脚本、结果和论文材料有清晰位置。利用AI对文献标题、摘要、关键词和空间数据字段进行快速整理,识别研究热点、关键词组合、空间现象和潜在研究空白。制作研究区图、空间因子图、研究对象图、指标分布图、空间叠
② 复杂统计模型生成的零代码实现路径(续) 这种智能化的选型机制,让分析师无需成为算法专家也能获得高质量的模型输出。下面通过一个完整的案例演示这一流程: 实战案例:银行客户流失预测 1. 业务需求描述 "基于客户最近3个月的交易行为(交易次数、平均金额、最大单笔)、账户余额变化趋势、客服互动频率,预测未来30天内流失概率。需要输出模型评估报告和关键影响因素的可视化图表。" 2. 模拟数据集生成 l